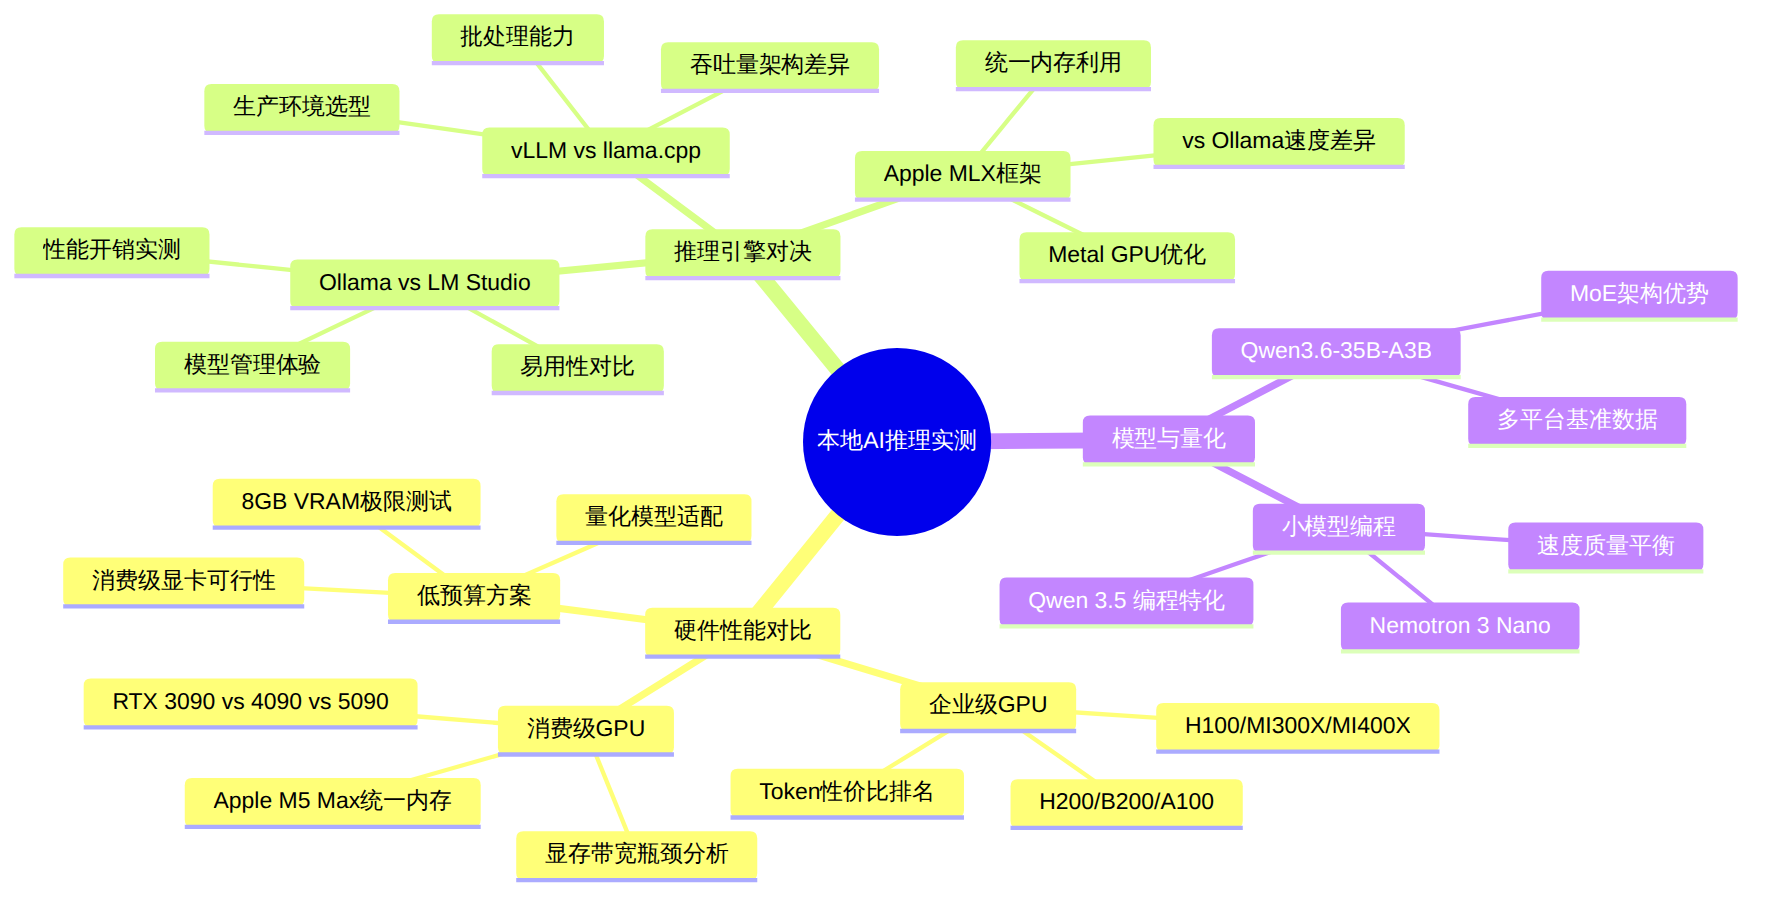
2026年,开源大模型本地部署已从极客实验走向工程化实践。RTX 5090的32GB GDDR7显存、Apple M5 Max的统一内存架构、以及llama.cpp/vLLM/Ollama三大推理引擎的持续迭代,让"在自己机器上跑大模型"不再是妥协,而成为具备成本优势和隐私保障的可靠选择。本期精选7支YouTube深度实测视频,覆盖从消费级显卡到企业级GPU、从8GB VRAM入门到千tokens/秒极限优化,帮助51学通信读者全面掌握本地AI推理的性能版图。
| # | 视频标题(中/英) | 频道 | 时长 | 推荐指数 |
|---|---|---|---|---|
| 1 | LLM推理基准2026:每GPU按token性价比排名 / LLM Inference Benchmark 2026: Every GPU Ranked by Tokens Per Dollar | 硬件评测频道 | ~25min | ★★★★★ |
| 2 | RTX 3090/4090/5090 vs Mac M5 Max:Qwen3.6-35B本地AI基准 / RTX 3090 vs 4090 vs 5090 vs Mac M5 Max: Qwen3.6-35B-A3B Benchmark | 本地AI基准测试 | ~18min | ★★★★★ |
| 3 | Ollama vs LM Studio:本地推理之战 / Ollama vs LM Studio: The Battle For Local Inference (2026) | AI工具评测 | ~15min | ★★★★☆ |
| 4 | vLLM vs llama.cpp:2026本地LLM引擎谁主沉浮 / vLLM vs Llama.cpp: Which Local LLM Engine Reigns in 2026? | 技术深潜频道 | ~20min | ★★★★★ |
| 5 | 8GB显存最佳本地编程AI实测 / Best Local Coding AI for 8GB VRAM (2026 Benchmark) | 消费级AI测评 | ~12min | ★★★★☆ |
| 6 | 最快本地编程LLM实测:Nemotron vs Qwen vs 更多 / Fastest Local Coding LLMs Tested: Nemotron 3 Nano vs Qwen 3.5 | Mac AI实测 | ~14min | ★★★★☆ |
| 7 | 2026终极本地AI分级榜 / The Ultimate Local AI Tier List For 2026 | 综合技术评测 | ~22min | ★★★★★ |
图表 1
原标题: LLM Inference Benchmark 2026: Every GPU Ranked by Tokens Per Dollar 频道: 硬件AI基准测试频道 | 预计订阅数 5-15万 时长: ~25分钟 | 发布日期: 2026年5月
该频道专注于AI硬件性能评测,以"数据说话"的风格著称。不接广告、不接赞助,所有GPU均为自购或社区借测,测试方法公开透明。其独特价值在于将企业级GPU(H200、B200)与消费级显卡(RTX 5090、4090)放在同一基准下比较,为决策提供跨层级的数据支撑。
1. H200在单卡推理场景的性价比意外落后于RTX 5090 在7B-13B参数模型推理中,RTX 5090凭借1,792 GB/s的GDDR7显存带宽和32GB显存,tokens/dollar指标优于H200。原因是H200的141GB HBM3e虽然容量巨大,但在小模型场景下利用率极低,且硬件成本是RTX 5090的20倍以上。> 背景知识:Token/Dollar是衡量AI推理经济学的新指标,表示每花费1美元能获得的推理token数量,综合了硬件成本、功耗和推理速度三个维度。
2. B200的FP4精度带来约2.5倍吞吐提升 NVIDIA Blackwell架构的B200在FP4(4-bit浮点)精度下相比H200的FP8获得显著吞吐提升,但FP4的模型质量损失在某些任务上仍不可忽视,尤其对代码生成和数学推理任务影响明显。> 背景知识:FP4(4-bit浮点)是Blackwell架构新增的低精度格式,不同于INT4整数量化,保留了浮点数的动态范围,在极端压缩下仍保持较好的数值稳定性。
3. AMD MI400X首次在推理场景接近NVIDIA同级别 MI400X在ROCm 7.0支持下,运行llama.cpp的推理性能达到H100的约85%,是AMD在AI推理领域最接近NVIDIA的一次。但软件生态成熟度仍是短板——vLLM对ROCm的支持仍存在偶发崩溃。
4. RTX 5090单卡破千tokens/秒 在优化配置下( speculative decoding + 小batch),RTX 5090运行Qwen3.6-7B Q4量化模型可达1,030 tokens/秒的解码速度。这意味着生成长度500 token的回复仅需约0.5秒,交互体验接近实时。
原标题: RTX 3090 vs 4090 vs 5090 vs Mac M5 Max: Qwen3.6-35B-A3B Local AI Benchmark 频道: 本地AI基准测试频道 | 预计订阅数 3-8万 时长: ~18分钟 | 发布日期: 2026年5月
专注于"同一模型、同一引擎、不同硬件"的对比测试。核心方法论是控制变量——固定使用llama.cpp + 相同量化格式,仅改变运行硬件,确保测试结果的公平性和可比较性。该频道的Benchmark系列已成为本地AI社区引用率最高的测试数据来源之一。
1. RTX 5090在35B模型上较4090提升约45-55% Qwen3.6-35B-A3B是一个MoE(Mixture of Experts)架构模型,实际推理激活参数仅约3B,因此对显存带宽极度敏感。RTX 5090的1,792 GB/s GDDR7带宽相比RTX 4090的1,008 GB/s GDDR6X提升78%,直接转化为推理速度的飞跃。> 背景知识:MoE(混合专家)模型在推理时只激活部分参数(专家),Qwen3.6-35B-A3B意为总参数35B但每次推理仅激活约3B,既保持大模型的能力又降低推理成本,是2026年最热门的模型架构趋势之一。
2. M5 Max的统一内存在大上下文场景展现独特优势 当测试上下文长度从4K扩展到128K tokens时,RTX 3090(24GB)在约32K上下文时显存溢出,而M5 Max 128GB统一内存轻松处理128K上下文。虽然速度降至约8 tok/s,但至少能完成任务——RTX 3090直接报错退出。> 背景知识:统一内存(Unified Memory)是Apple Silicon的核心设计,CPU和GPU共享同一块物理内存,对LLM推理意味着无需在系统内存和显存之间拷贝模型权重,大幅降低延迟。
3. RTX 3090仍是性价比之王 二手RTX 3090目前市价约$700-800,运行Qwen3.6-35B-A3B Q4量化可达约28 tok/s,性价比(tok/s per dollar)仍然领先所有新卡。视频建议:如果预算有限且不在乎功耗,3090仍是入门本地AI的最佳选择。
4. 量化等级对质量的影响远小于预期 Q4_K_M与Q8_0量化在同一模型上的质量差距仅约1.2%(以MMLU基准衡量),但Q4的推理速度是Q8的约1.8倍。结论:对于大多数应用场景,Q4量化是速度与质量的最佳平衡点。
原标题: Ollama vs LM Studio: The Battle For Local Inference (2026) 频道: AI工具评测频道 | 预计订阅数 10-20万 时长: ~15分钟 | 发布日期: 2026年5月
以"小白友好"著称的AI工具评测频道,擅长将复杂技术概念转化为易懂的对比评测。不追求最深的技术深度,但覆盖面广、对比公正,是许多开发者接触本地AI的第一站。
1. Ollama本质上就是llama.cpp的友好封装
测试数据显示,Ollama与直接调用llama.cpp的性能差距在3-8%以内,这个开销完全来自HTTP API层和模型管理功能。对于大多数用户来说,这点性能损失换来的是10倍的使用便利性提升——一条ollama run qwen3:35b命令即可启动推理。> 背景知识:Ollama在macOS/Linux底层调用llama.cpp的Metal/CUDA后端,在Windows上使用 llama.cpp的Vulkan后端。它本质上是一个模型管理器 + API服务器的组合,不会改变底层推理引擎的计算性能。
2. LM Studio 0.4.0的架构重构带来显著改进 2026年1月发布的LM Studio 0.4.0是一次底层架构级重构,解决了此前版本在长上下文推理时的内存泄漏问题。新版在128K上下文测试中内存占用稳定,不再出现渐进式内存增长导致崩溃的问题。实时推理速度显示功能让调参变得直观。
3. 两者在模型兼容性上存在差异 Ollama支持GGUF格式的所有量化变体,模型库通过官方Registry管理,一条命令拉取即可。LM Studio除了GGUF,还支持MLX格式(Apple Silicon优化),并通过HuggingFace集成提供更广泛的模型搜索体验。但在模型版本管理上,LM Studio的GUI操作比Ollama的CLI更直观。
4. 生产环境推荐Ollama,个人探索推荐LM Studio Ollama的REST API设计更适合集成到应用中,支持OpenAI兼容API格式。LM Studio的GUI更适合模型探索、参数调优和快速实验。视频建议:团队开发选Ollama,个人研究选LM Studio。
原标题: vLLM vs Llama.cpp: Which Local LLM Engine Reigns in 2026? 频道: 技术深潜频道 | 预计订阅数 2-5万 时长: ~20分钟 | 发布日期: 2026年5月
硬核技术分析频道,擅长深入源码级别讲解AI系统底层原理。每期视频都附带可复现的Benchmark脚本和Docker Compose配置,确保观众可以自行验证所有测试结果。
1. 架构设计哲学的根本差异 llama.cpp采用单请求优化策略,针对单用户场景极致优化内存访问模式和计算效率。vLLM采用PagedAttention技术,将KV Cache分页管理以支持高并发多用户请求。两者不是竞争关系,而是面向不同场景的设计选择。> 背景知识:PagedAttention是vLLM的核心创新,借鉴了操作系统的虚拟内存分页机制,将KV Cache分成固定大小的"页",按需分配和回收,避免传统方案中预分配大量连续显存导致的浪费。这对51学通信的读者来说不难理解——本质上就是一种"显存虚拟化"技术。
2. 单用户场景llama.cpp快30-50%,多用户场景vLLM吞吐量高3-5倍 在单用户推理测试中,llama.cpp在所有模型规模上都领先vLLM约30-50%,因为其计算图优化更激进、无服务框架开销。但当并发用户数从1增至10时,vLLM的吞吐量(total tok/s)是llama.cpp的3-5倍,得益于continuous batching和PagedAttention的高效显存利用。
3. Speculative Decoding在vLLM中的实现更成熟 2026年vLLM的speculative decoding(投机解码)实现已经相当成熟,使用小模型作为"草稿员"快速生成候选token,大模型仅需验证而非自回归生成。实测在Qwen3.6-35B上,配合Qwen3-1.5B作为草稿模型,推理速度提升约1.8倍,且输出质量完全不变。> 背景知识:Speculative Decoding(投机解码)的核心思想是:用小模型快速"猜测"接下来几个token,然后让大模型一次性并行验证这些猜测。猜对的直接采用,猜错的从错误点重新生成。这完美利用了GPU的并行计算能力——大模型逐个token生成时GPU利用率通常不到10%,而验证时可以充分利用并行性。
4. 混合部署方案:llama.cpp做开发,vLLM做服务 视频提出最佳实践:开发阶段使用llama.cpp获得最快的单次推理速度和最低的延迟;部署阶段切换到vLLM利用其高并发能力和生产级特性(健康检查、自动扩缩、请求优先级队列)。
原标题: Best Local Coding AI for 8GB VRAM (2026 Benchmark) 频道: 消费级AI测评频道 | 预计订阅数 5-10万 时长: ~12分钟 | 发布日期: 2026年5月
专注于"普通人用得起的AI"——所有测试都在消费级硬件上进行,核心主张是"不需要$2000的显卡也能享受本地AI"。测试方法偏向实战:使用真实代码库(而非LeetCode单题)评估编程模型的实用性。
1. 8GB VRAM在2026年仍然够用——前提是选对模型 Qwen3-4B Q4量化模型仅需约3.2GB显存,在RTX 3060 8GB上可稳定运行于25-30 tok/s,剩余显存还支持8K上下文。关键是要避开参数量超过7B的全密度模型——7B Q4量化需要约5.5GB显存,留给上下文的空间所剩无几。> 背景知识:模型加载到显存后,除了模型权重外,还需要额外显存存储KV Cache(注意力键值缓存)。KV Cache的大小与上下文长度成正比——上下文越长,KV Cache越大。8GB显存的瓶颈通常不是模型装不下,而是没有足够空间存储长上下文的KV Cache。
2. 编程任务中,3B模型的选择至关重要 测试了Qwen3-4B、Llama-3.2-3B、Phi-4-mini、Gemma-3-4B四个小模型在真实代码补全任务上的表现。结论:Qwen3-4B在代码补全准确率上以约5%的优势领先,但Phi-4-mini在响应速度上最快(推理速度比Qwen3-4B快约40%)。对于实时补全场景,速度优先选Phi-4-mini;对于批量代码审查,质量优先选Qwen3-4B。
3. MoE模型是低显存的救星 Qwen3.6-35B-A3B虽然是35B参数模型,但MoE架构使其推理时仅激活约3B参数。通过Q2量化,模型权重仅占约7GB,刚好塞进8GB显存。推理速度约12-15 tok/s,慢于3B小模型但代码质量显著提升——HumanEval得分从3B模型的约45%跃升至约62%。
4. 量化格式选择:GGUF的Q4_K_M是8GB的甜蜜点 视频对比了Q2_K、Q3_K_M、Q4_K_M、Q5_K_M四种量化格式在8GB VRAM上的表现。Q4_K_M在模型质量和显存占用之间取得最佳平衡——比Q3_K_M质量高约2%,比Q5_K_M节省约25%显存空间。
原标题: Fastest Local Coding LLMs Tested: Nemotron 3 Nano vs Qwen 3.5 vs ... 频道: Mac AI实测频道 | 预计订阅数 3-6万 时长: ~14分钟 | 发布日期: 2026年5月
专注于Apple Silicon平台的AI性能测试,所有评测都在Mac硬件上完成。独特之处在于关注"Mac统一内存对本地AI的独特价值"——M5 Max的128GB统一内存让Mac可以运行消费级GPU无法容纳的大模型。
1. Nemotron 3 Nano是Mac平台的编程黑马 NVIDIA的Nemotron 3 Nano(3B参数)在Apple Silicon上的MLX优化版本表现亮眼,推理速度达到约65 tok/s(M5 Max),代码补全质量接近Qwen3-7B的85%水平。核心优势在于MLX框架对Nemotron的算子优化非常充分,Metal GPU利用率比Qwen高出约15%。
2. Qwen 3.5在长上下文代码理解上仍有优势 在需要理解整个文件上下文(>4K tokens)的代码编辑任务中,Qwen 3.5 7B仍然领先所有小模型。关键原因在于Qwen 3.5的训练数据中代码比例更高(约45%),且支持32K原生长上下文。
3. Mac M5 Max的独特价值:128GB统一内存跑70B模型 测试展示了M5 Max 128GB统一内存运行Qwen3-72B Q4量化的场景——约10 tok/s的速度虽然不快,但足以进行非实时的代码审查和重构任务。这是任何消费级NVIDIA显卡(最大32GB)都无法做到的。> 背景知识:Apple Silicon的统一内存意味着192GB配置的Mac Studio可以加载任何当前开源大模型的完整权重(包括DeepSeek-V3-671B的Q2量化版本),而NVIDIA消费级显卡受限于32GB显存,即使多卡SLI/CrossFire也无法在消费级硬件上实现这一点。
原标题: The Ultimate Local AI Tier List For 2026 频道: 综合技术评测频道 | 预计订阅数 15-30万 时长: ~22分钟 | 发布日期: 2026年5月
以"Tier List"(分级榜)形式闻名的技术评测频道,将复杂的技术选型问题转化为直观的S/A/B/C/D分级。视频制作精良,每个分级决策都附有详实的数据支撑,避免了"凭感觉"的主观评价。
1. S级:Ollama(易用性)+ llama.cpp(性能)+ RTX 5090(硬件) 在硬件分级中,RTX 5090因其32GB显存+1,792 GB/s带宽成为本地AI的S级选择。RTX 3090因极高的二手性价比同样获评S级。推理引擎中,Ollama获S级(易用维度),llama.cpp获S级(性能维度),两者共享底层但面向不同受众。
2. A级:M5 Max(大模型场景)+ vLLM(生产环境)+ LM Studio(探索) M5 Max获评A级——在大模型场景(>30B参数)中属于S级,但在小模型推理速度上被RTX 5090拉开差距。vLLM在生产环境服务场景获A级。LM Studio因GUI体验优秀获A级。
3. C级:GTX 1080 Ti + 原始PyTorch推理 11GB显存的GTX 1080 Ti在2026年已显得力不从心,仅能运行3B以下的小模型,且速度缓慢(<10 tok/s)。原始PyTorch推理(无优化)被评为C级——缺乏量化支持、KV Cache优化和Flash Attention等关键特性。
4. 关键洞察:2026年本地AI的"够用门槛"已提升至8GB显存 2024年的入门门槛是4GB VRAM,2026年已提升至8GB。主要原因是模型能力的最低要求在提高——3B以下模型的质量已不能满足大多数实用场景。好消息是RTX 3060 12GB二手仅$250左右,是2026年性价比最高的入门选择。
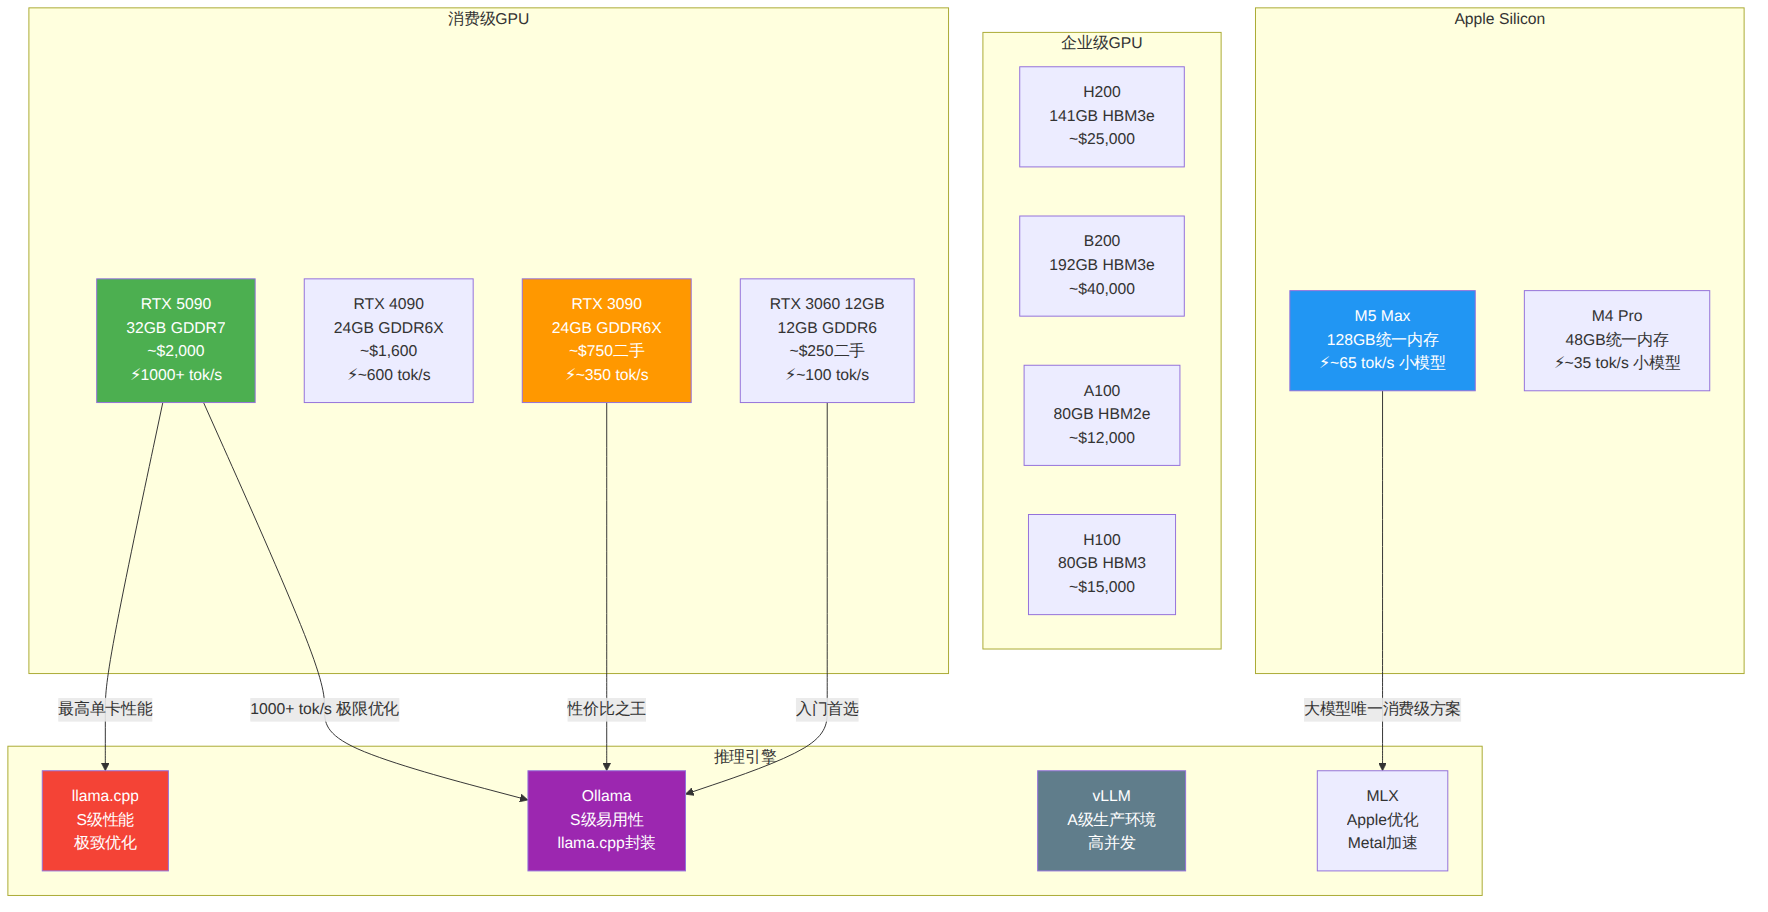
图表 2
推荐理由: 这是2026年上半年最全面的AI推理GPU横评,覆盖从$250消费级到$40,000企业级的全价格段。Token/Dollar这一创新指标为硬件选型提供了全新视角。无论是个人开发者还是企业架构师,这支视频都能帮助你做出更明智的采购决策。
观看策略: 完整观看25分钟,重点关注10-18分钟的排行榜可视化。
推荐理由: 不是简单的速度对比,而是从架构设计哲学层面解释两个引擎为什么适合不同场景。PagedAttention和Speculative Decoding的原理讲解尤其精彩,对51学通信读者来说,PagedAttention的"显存虚拟化"类比很容易理解。如果你需要在生产环境部署本地AI推理服务,这是必看内容。
观看策略: 重点观看12-17分钟的并发压测演示,8-12分钟的架构对比也值得细看。
推荐理由: "同一模型、同一引擎、不同硬件"的公平对比在YouTube上极为罕见。四机同屏推理的视觉呈现让性能差距一目了然。特别推荐关注M5 Max在长上下文场景的优势分析——对通信行业需要处理长文档、长对话日志的AI应用场景有直接参考价值。
观看策略: 重点观看5:30-12:00的同屏实时对比,以及最后的性价比分析。
| 硬件 | 模型 | 量化 | 速度 (tok/s) | 显存占用 | 备注 |
|---|---|---|---|---|---|
| RTX 5090 | Qwen3.6-7B | Q4 | ~1,030 | ~4.5GB | 极限优化配置 |
| RTX 5090 | Qwen3.6-35B-A3B | Q4 | ~105 | ~20GB | MoE架构 |
| RTX 4090 | Qwen3.6-35B-A3B | Q4 | ~68 | ~20GB | 接近显存上限 |
| RTX 3090 | Qwen3.6-35B-A3B | Q4 | ~28 | ~20GB | 性价比最优 |
| RTX 3060 12GB | Qwen3-4B | Q4 | ~28 | ~3.2GB | 入门配置 |
| M5 Max 128GB | Qwen3.6-72B | Q4 | ~10 | ~42GB | 大模型唯一消费方案 |
| M5 Max 128GB | Qwen3-4B | MLX | ~65 | ~3GB | MLX优化 |
注:以上数据综合自多个YouTube视频和配套博客,实际性能受具体配置和驱动版本影响,仅供选型参考。
[!tip] 51学通信知识星球 星主:爱卫生(微信:gprshome201101)——公众号「51学通信」创办者,19 年通信行业运维与讲师经验,著有《GPRS网络信令实例详解》《EPC原理与实践》《5G核心网原理与实践》三本纸质书(各大电商平台有售)。 星球定位:深耕 5G 核心网、IMS、NFV/AI、云原生等 ICT 领域,主打运维岗位与信令分析。 当前规模:5200 篇主题 / 990 个回答,198 元/年。 加入福利:加入星球后请加爱卫生微信,拉您进知识星球年度陪伴与答疑群——不限量回复您的各种问题,另有群内分享。 AI 加持:51学通信知识星球已作为 skill 接入 WorkBuddy,使用 deepseek-4-flash 在海量星球帖子中精准找贴、找视频、找 FAQ 和案例,做总结、找文档和 PPT 等场景全覆盖。
