概述:本教程面向已有Claude Code基础使用经验的开发者,深入讲解三大高阶主题:上下文窗口的精细化管理、多文件并行重构的Agent编排策略、以及Token消耗优化与模型选择技巧。掌握这些技能后,你将能在大型项目中实现更高效、更精准的AI辅助开发,同时显著降低使用成本。预计学习时间60-90分钟。
适用人群:已使用Claude Code超过2周、熟悉基本命令和CLAUDE.md配置的中高级开发者。
前置条件:
- 已安装Claude Code(npm install -g @anthropic-ai/claude-code)
- 熟悉基本操作(对话、文件编辑、Git集成)
- 了解CLAUDE.md的基础配置方式
- 拥有一个中等规模(50+文件)的真实项目用于实战
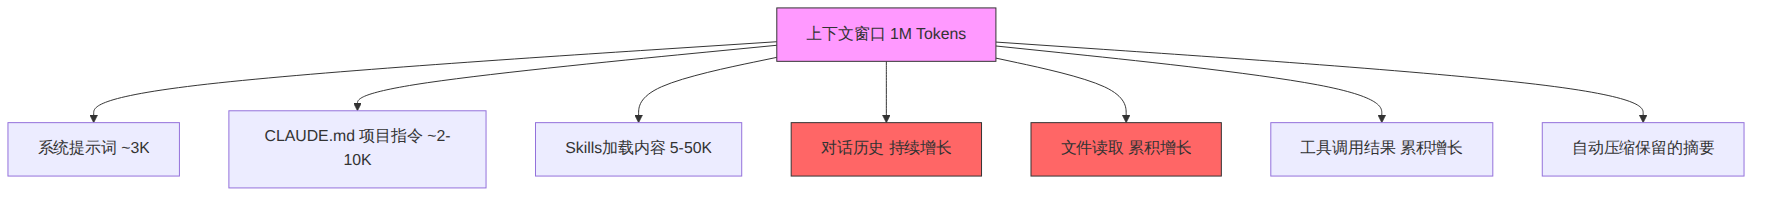
Claude Code的上下文窗口约100万Token,看起来很大,但实际使用中它会被以下内容快速填满:
图表 1
关键认知:上下文不是"用多少算多少"的线性消耗——它像磁盘空间一样会碎片化。当对话过长时,早期的重要决策会被压缩丢失,导致Agent"遗忘"之前的约定。
| 命令 | 作用 | 适用场景 | Token影响 |
|---|---|---|---|
/compact |
压缩对话历史为摘要 | 上下文使用超60%时 | 减少30-60%已用Token |
/clear |
清空全部对话历史 | 切换任务方向时 | 重置为0(保留CLAUDE.md) |
/rewind |
回退到之前某个状态 | Agent犯了错误需要回退 | 减少到目标点的Token |
/cost |
查看当前会话Token消耗 | 随时监控成本 | 无影响,只读 |
实战操作序列:
# 步骤1:开始一个复杂任务前,先检查当前状态
/cost

# 步骤2:如果已用超过60%,先压缩
/compact

# 步骤3:如果方向完全改变,彻底清空
/clear

# 步骤4:重新开始时,给Claude一个简洁的任务摘要
# 不要重复之前的完整历史,只说当前目标
/compact的黄金时机很多开发者在上下文快满(90%+)时才想起/compact,这是错误的。最佳实践是:

图表 2
为什么60%是黄金线? 因为/compact本身消耗Token来生成摘要。当使用率已经很高时,压缩操作本身可能触发上下文溢出,导致摘要质量下降。在60%时压缩,留有足够空间让Claude生成高质量的压缩摘要。
单一CLAUDE.md文件是Token浪费的常见源头。正确的做法是分层设计:
第一层:用户全局配置(~/.claude/CLAUDE.md)
# Global Preferences

## Language & Style
- 默认使用中文回复
- 回复简洁明了

## General Rules
- 不要自动commit
- 始终先读取文件再编辑
- 优先编辑现有文件而非创建新文件
第二层:项目级配置(项目根目录/CLAUDE.md)
# Project: My SaaS Backend

## Tech Stack
- Node.js 20 + TypeScript 5.x
- Express + Prisma ORM
- PostgreSQL 16

## Architecture
- src/routes/ - API路由定义
- src/services/ - 业务逻辑层
- src/models/ - Prisma数据模型
- src/middleware/ - 中间件

## Coding Conventions
- 使用Zod做输入验证
- Service层返回Result<T, E>类型
- 错误统一用AppError类
第三层:目录级配置(src/routes/AGENTS.md)
# Routes Module

## Patterns
- 每个路由文件对应一个resource
- 使用express.Router()
- 中间件顺序:auth -> validate -> handler
设计原则: - 全局配置只放跨项目通用的规则(约10-20行) - 项目配置只放不读代码就无法知道的信息(架构、约定) - 目录配置只放该模块特有的规则(模式、依赖) - 绝对不要放代码示例——让Claude读源码而非背诵模板
AGENTS.md是Claude Code中一个经常被忽视但极具价值的优化工具。它的工作原理是按需加载——只有当Agent进入特定目录时才读取该目录下的AGENTS.md,而非像CLAUDE.md那样在会话开始时就全部加载。
优化前后对比:
graph TB
    subgraph 优化前:单一CLAUDE.md
        A1[CLAUDE.md 200行] --> B1[所有内容每次都加载]
        B1 --> C1["~8K Tokens/次"]
    end

    subgraph 优化后:模块化AGENTS.md
        A2[CLAUDE.md 30行] --> B2["~1.2K Tokens/次"]
        A2 --> C2[AGENTS.md x5]
        C2 --> D2[按需加载 ~2K/模块]
        D2 --> E2["每次仅加载1-2个模块"]
        E2 --> F2["~3-4K Tokens/次"]
    end

    style C1 fill:#f66,stroke:#333
    style F2 fill:#6f6,stroke:#333
实操步骤:
# 1. 将CLAUDE.md精简到核心规则(<50行)
# 2. 在各模块目录创建AGENTS.md
mkdir -p src/auth src/billing src/notifications
cat > src/auth/AGENTS.md << 'EOF'
# Auth Module
- JWT + Refresh Token双令牌模式
- 密码用bcrypt cost=12
- 所有路由需要AuthMiddleware
- 测试用testcontainers运行真实PostgreSQL
EOF

cat > src/billing/AGENTS.md << 'EOF'
# Billing Module
- Stripe API集成
- 所有金额以分为整数存储
- 幂等键防止重复扣费
- Webhook需要签名验证
EOF

cat > src/notifications/AGENTS.md << 'EOF'
# Notifications Module
- 基于事件驱动架构
- 使用Bull队列异步处理
- 模板用Handlebars渲染
- 优先级:critical > high > normal > low
EOF
这样,当Claude Code在src/auth目录下工作时,只加载auth相关的指令,不会加载billing或notifications的规则。这可以减少50-70%的指令Token消耗。
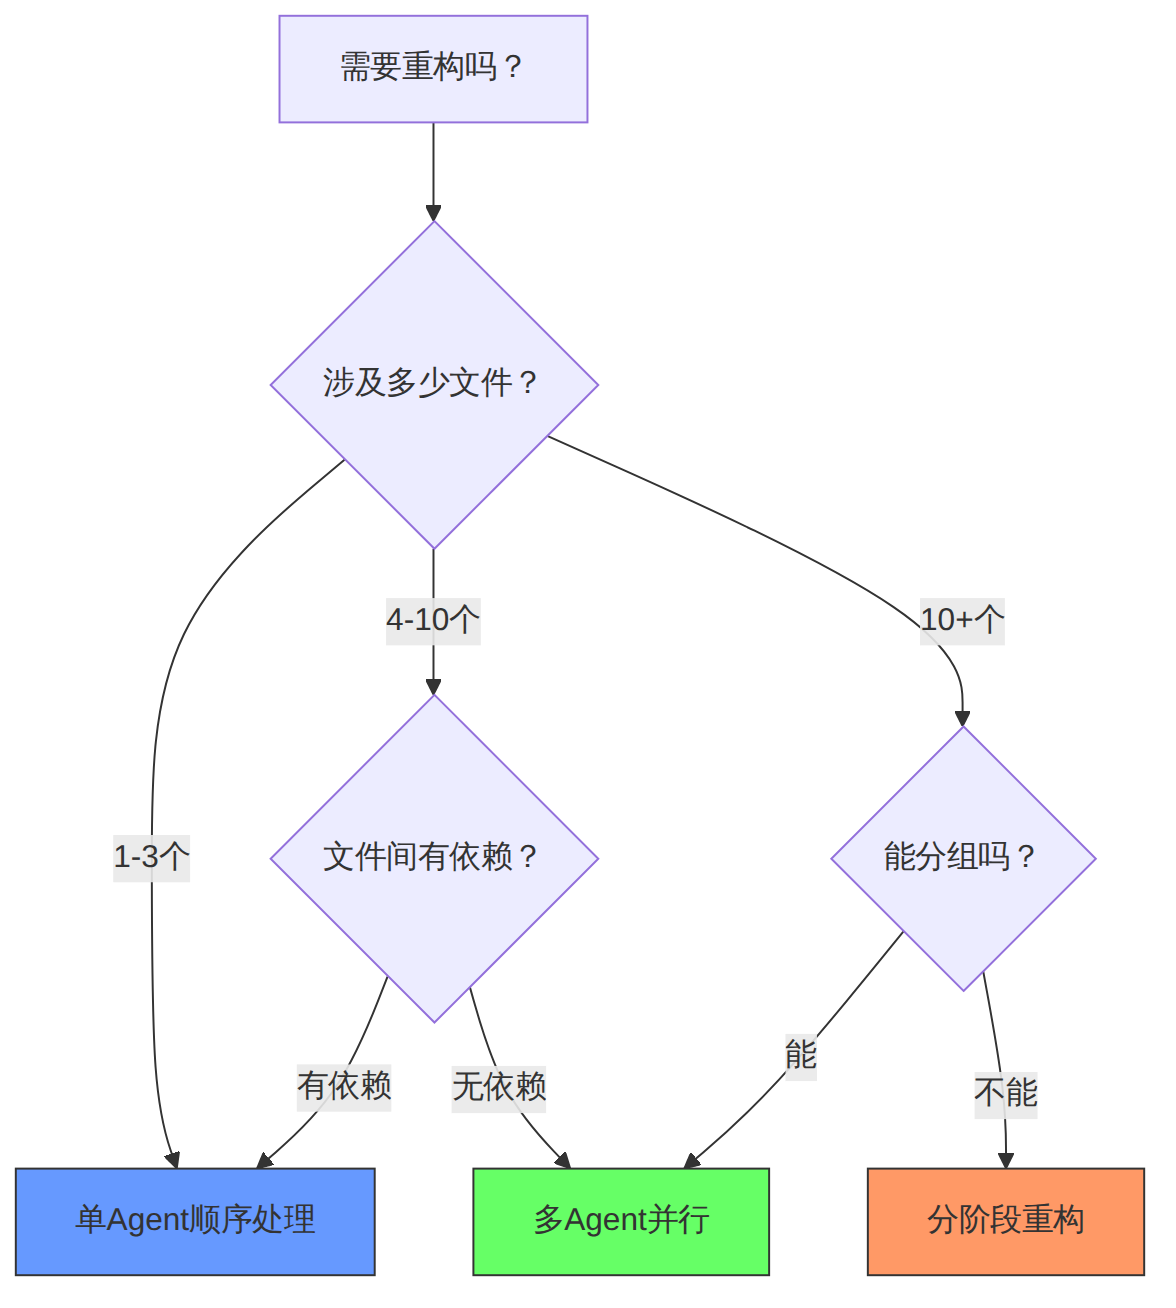
不是所有重构都适合并行化。决策树如下:
图表 4
Claude Code通过Task工具启动子Agent(subagent),每个子Agent拥有独立的上下文窗口,互不干扰。
基本语法:
使用Task工具,同时启动3个子Agent:
1. subagent_type=general-purpose:重构 src/auth/ 下的所有文件,将callback改为async/await
2. subagent_type=general-purpose:重构 src/billing/ 下的所有文件,将callback改为async/await
3. subagent_type=general-purpose:重构 src/notifications/ 下的所有文件,将callback改为async/await
关键参数:
| 参数 | 说明 | 推荐值 |
|---|---|---|
subagent_type |
Agent类型 | general-purpose(通用)、Explore(搜索) |
description |
简短描述(3-5词) | 用于追踪,如"refactor auth module" |
prompt |
详细任务描述 | 包含具体文件、目标、约束 |
run_in_background |
后台运行 | true(并行执行时建议开启) |
model |
模型选择 | haiku(简单任务)、sonnet(默认) |
isolation |
隔离模式 | "worktree"(避免文件冲突) |
场景:将一个Express REST API项目迁移到Hono框架,涉及15个路由文件、5个中间件、3个工具模块。
步骤一:分析依赖关系
请分析 src/ 目录下所有文件的import依赖关系,找出哪些文件
相互引用,哪些是完全独立的。输出一个依赖图。
步骤二:分组并行重构
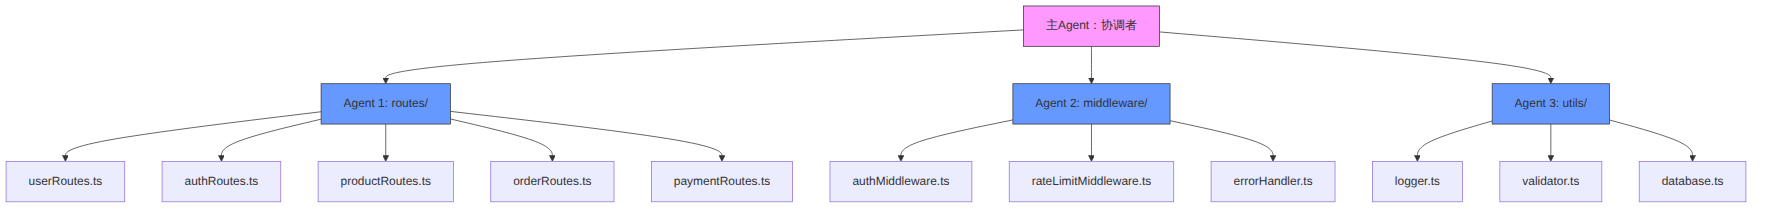
图表 5
向Claude Code下达的具体指令:
我需要将整个项目从Express迁移到Hono。请使用Task工具并行启动3个子Agent:

Agent 1(description: "migrate routes"):
- 搜索 src/routes/ 下所有 .ts 文件
- 将 express.Router() 改为 new Hono()
- 将 req/res/next 改为 c (Hono的Context对象)
- 将 router.get('/path', handler) 改为 app.get('/path', handler)
- 保持业务逻辑不变

Agent 2(description: "migrate middleware"):
- 搜索 src/middleware/ 下所有 .ts 文件
- 将 (req, res, next) => {} 改为 async (c, next) => {}
- 将 res.status(401).json() 改为 c.json({error}, 401)
- 将 next() 改为 await next()

Agent 3(description: "migrate utils"):
- 搜索 src/utils/ 下所有 .ts 文件
- 移除所有 express 类型导入
- 将 Request/Response 类型替换为 Context

每个Agent使用 isolation: "worktree" 运行,避免冲突。
完成后报告各自的修改文件列表。
步骤三:集成验证
所有子Agent完成后,在主Agent中执行集成:
所有Agent都完成了迁移。现在请:
1. 安装 hono 依赖:npm install hono
2. 更新 src/index.ts 作为Hono应用入口
3. 运行 TypeScript 编译检查:npx tsc --noEmit
4. 报告所有类型错误,逐个修复
当多个Agent同时修改不同文件时,Git worktree提供隔离保证:
# Claude Code内置worktree支持
# 在对话中直接使用 EnterWorktree 工具
# 或通过命令行:

# 创建隔离工作区
git worktree add ../feature-auth refactor/auth-module
git worktree add ../feature-billing refactor/billing-module

# 在两个终端分别启动Claude Code
cd ../feature-auth && claude
cd ../feature-billing && claude

# 完成后合并
git checkout main
git merge refactor/auth-module
git merge refactor/billing-module

# 清理worktree
git worktree remove ../feature-auth
git worktree remove ../feature-billing
Worktree vs 分支 vs 单会话对比:
| 维度 | 单会话 | 分支 | Worktree |
|---|---|---|---|
| 隔离性 | 无 | 代码隔离 | 完整文件系统隔离 |
| 上下文共享 | 完全共享 | 不共享 | 不共享 |
| 并行能力 | 顺序执行 | 需要多终端 | 原生支持 |
| 适合场景 | 小改动 | 中等项目 | 大规模并行 |
| 冲突风险 | 高 | 中 | 低 |
图表 6
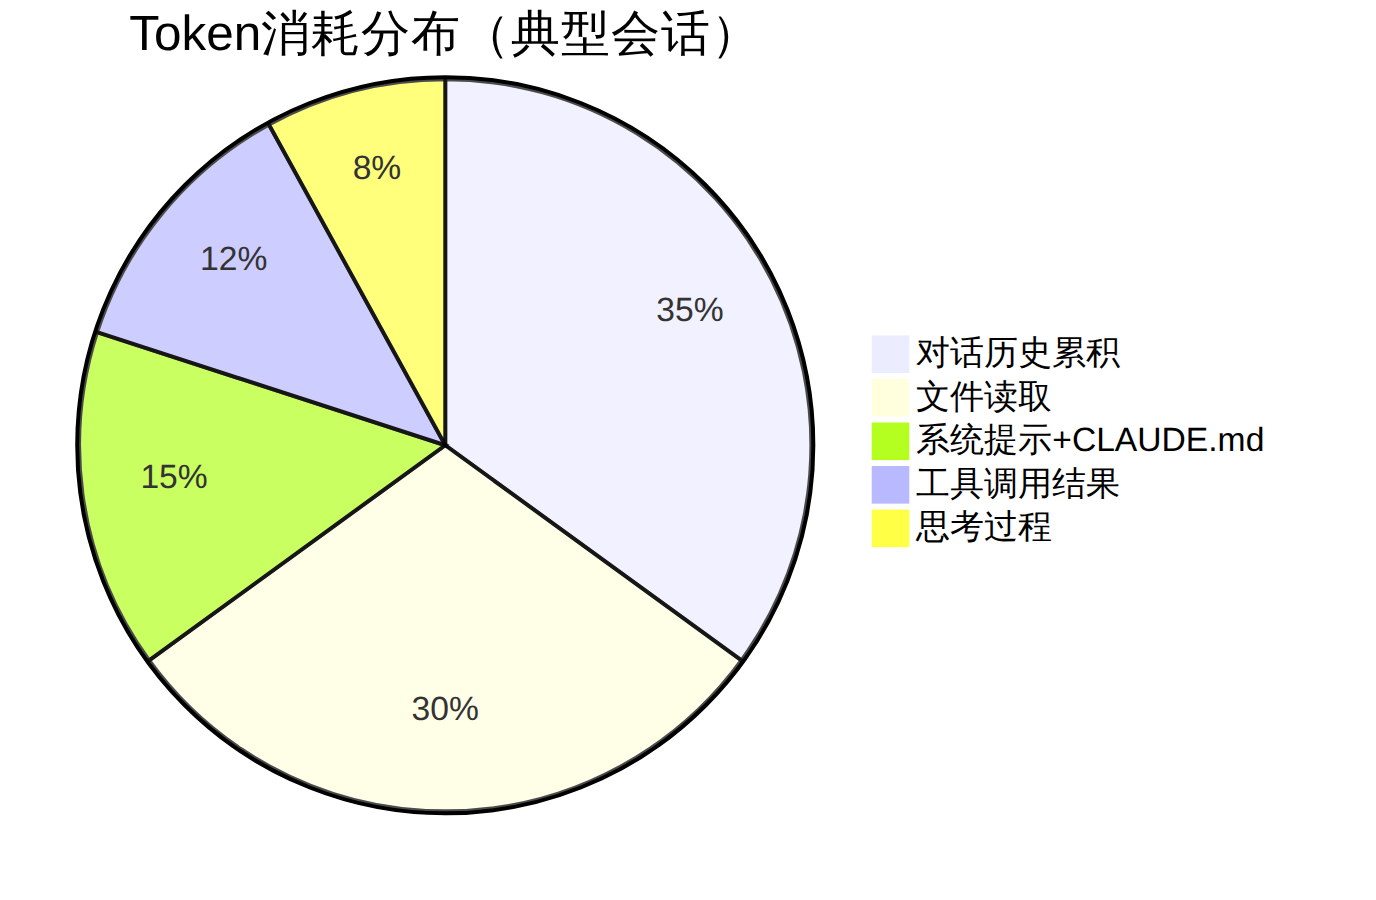
黑洞一:冗余文件读取
每次让Claude读取文件,完整内容都会进入上下文。一个500行的文件约消耗2000-3000 Token。
优化策略:
# 差:读取整个文件
请读取 src/services/userService.ts 并修改 createUser 方法

# 好:只读取相关部分
请读取 src/services/userService.ts 的第45-80行(createUser方法)并修改

# 更好:直接描述修改
在 src/services/userService.ts 的 createUser 方法中,
将第52行的 const user = await prisma.user.create({data})
改为 const user = await prisma.user.create({data, select: {id: true, email: true}})
黑洞二:过度详细的历史
Claude Code会自动压缩历史,但你可以加速这个过程:
# 不要等到上下文告急
# 在每个阶段性任务完成后主动压缩
/compact 已完成用户模块的重构,接下来处理订单模块

# 在压缩时给Claude一个摘要提示
# 这样压缩后的摘要会保留关键决策
黑洞三:不必要的Skill加载
每个被激活的Skill都会消耗上下文空间。一个复杂的Skill可能占用5K-50K Token。
# 查看(当前安装了哪些Skills)
ls ~/.claude/skills/

# 禁用不需要的Skills(在.claude/settings.json中)
{
  "skills": {
    "disabled": ["heavy-skill-you-dont-need"]
  }
}
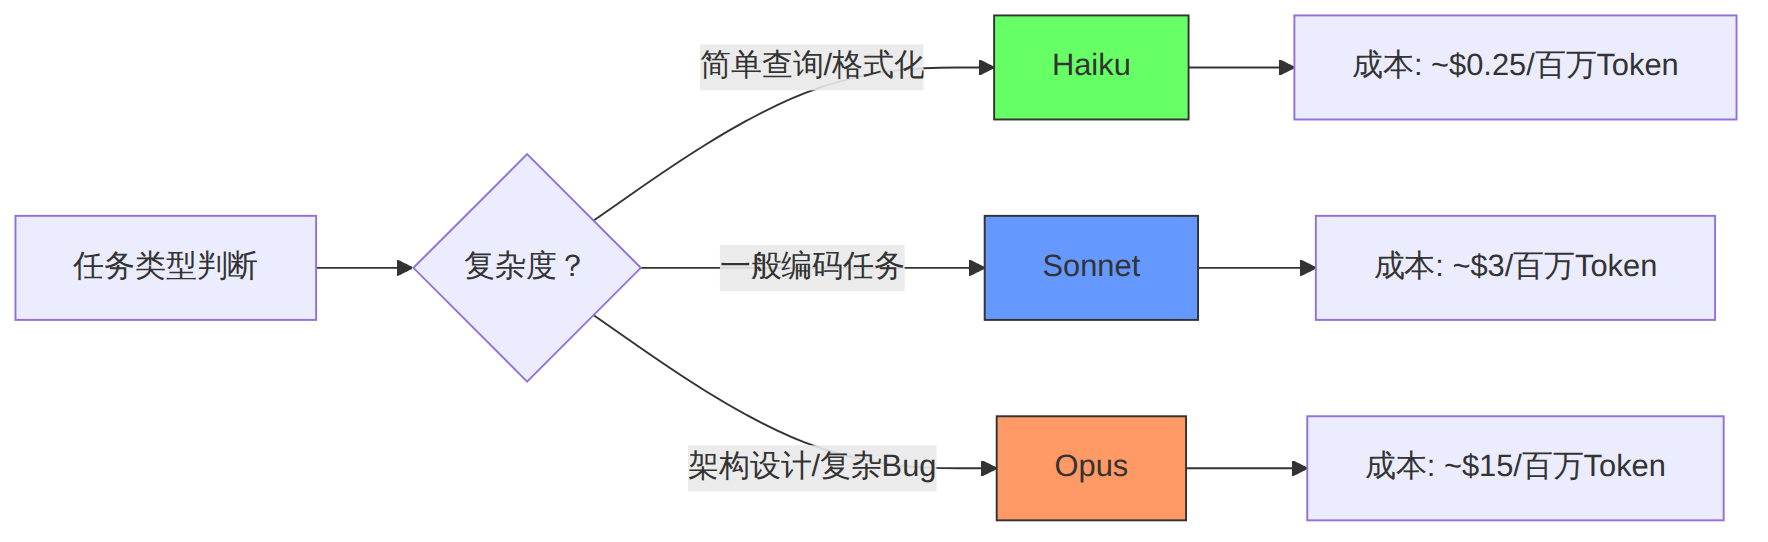
不同任务适合不同模型,选择错误会浪费大量Token和金钱:
图表 7
具体场景对照表:
| 任务类型 | 推荐模型 | 原因 |
|---|---|---|
| 代码格式化、简单重构 | Haiku | 足够准确,成本1/10 |
| 日常功能开发、Bug修复 | Sonnet | 性价比最优 |
| 跨模块架构重构 | Sonnet + worktree | 并行处理更高效 |
| 复杂Bug诊断(多系统交互) | Opus | 需要深度推理 |
| 代码审查 | Sonnet | 阅读理解能力强 |
| 生成测试用例 | Haiku | 模式化任务 |
| 性能优化分析 | Opus | 需要系统级思维 |
在Claude Code中切换模型:
# 方式一:通过/effort命令
/effort high    # 使用更强的推理(更多思考Token)
/effort medium  # 默认平衡
/effort low     # 快速响应(更少思考Token)

# 方式二:在Task工具中指定模型
# 对于子Agent,直接指定model参数
# model: "haiku" 用于简单搜索
# model: "sonnet" 用于编码任务
# model: "opus" 用于复杂推理

# 方式三:环境变量
export CLAUDE_MODEL=claude-haiku-4-5-20251001  # 全局切换
/effort命令控制Claude Code的"思考深度"。这不仅是快慢的区别,更直接影响Token消耗:

图表 8
关键技巧:在提示中使用"触发词"来临时提升思考深度,无需手动切换effort:
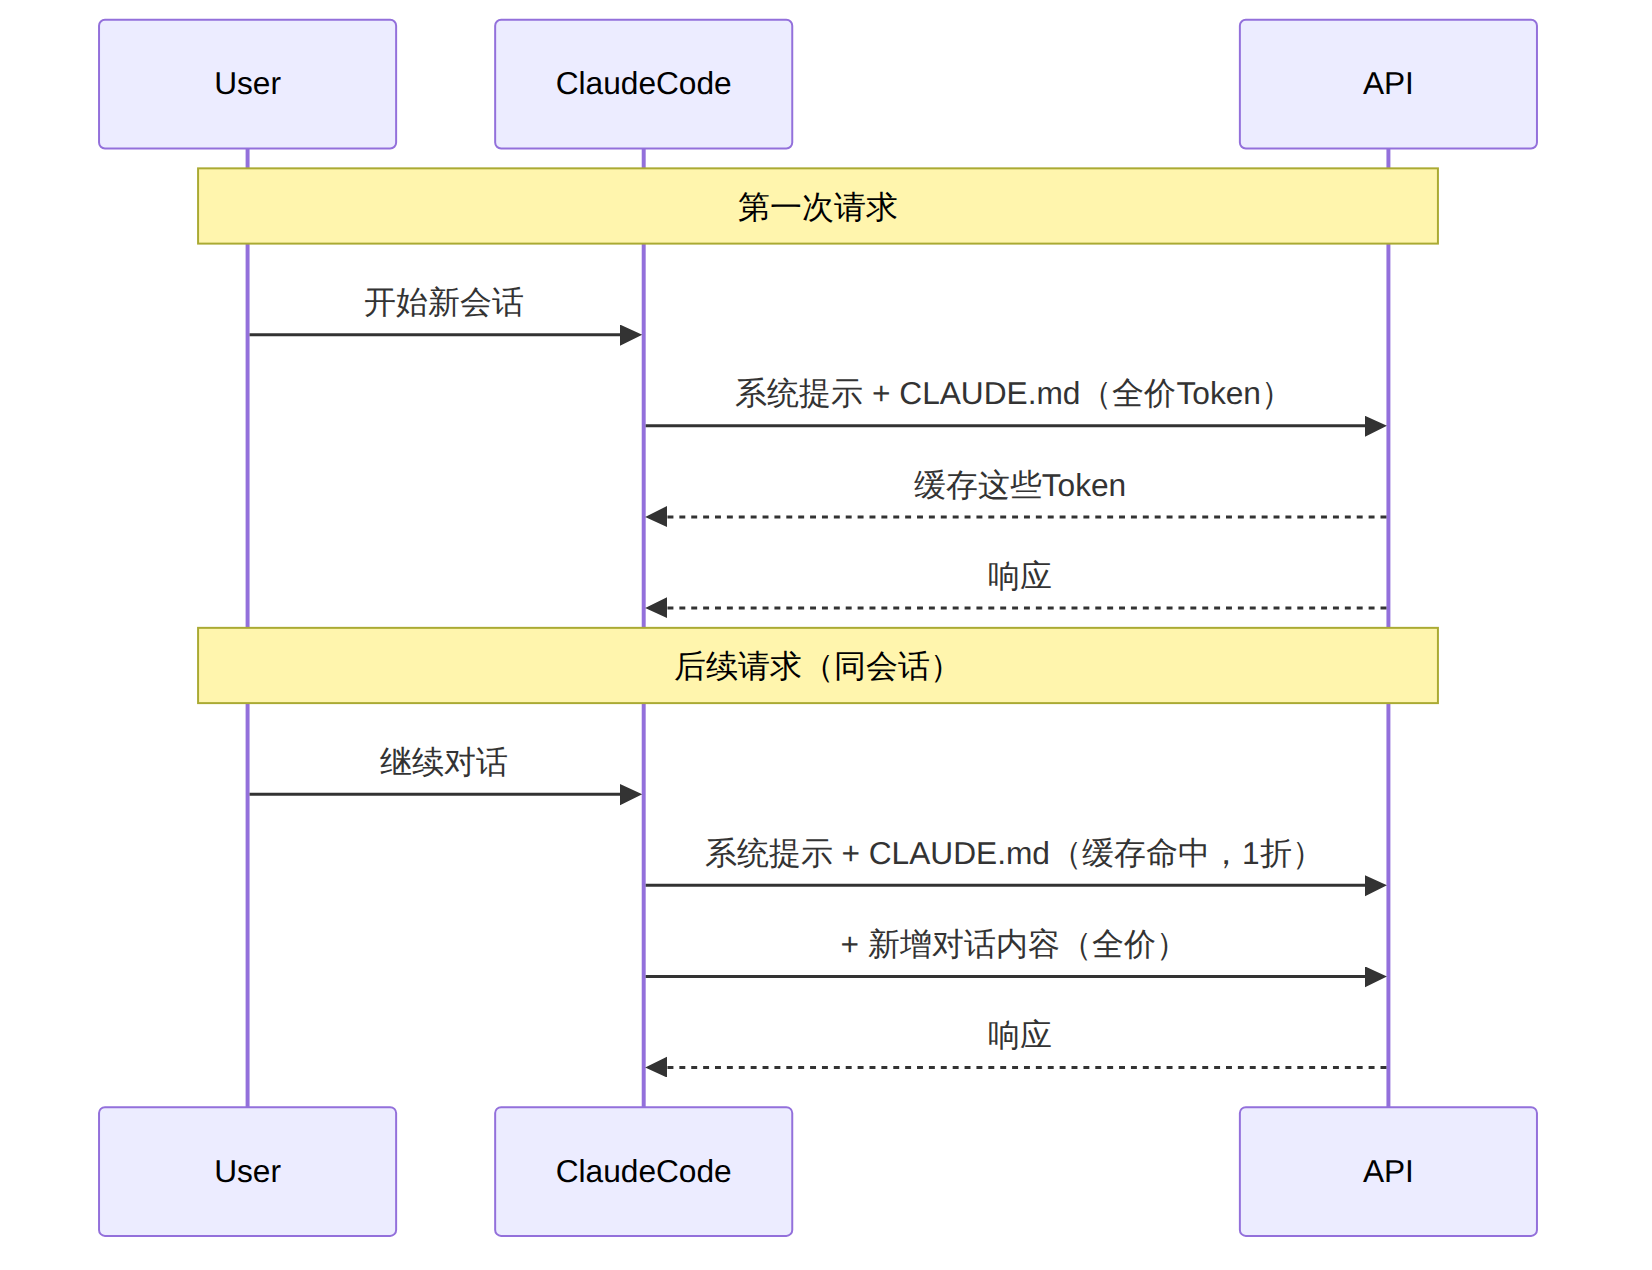
think harder → 提升到高努力级别ultrathink → 触发最大思考深度think step by step → 结构化推理Claude Code自动利用Prompt Caching机制。当你的系统提示(CLAUDE.md等)在多次请求中保持不变时,这些Token以缓存价格计费(正常价格的10%)。
最大化缓存命中的策略:
图表 9
假设我们有一个中等规模的电商后端项目,需要完成以下优化任务:
项目结构:
src/
├── routes/
│   ├── userRoutes.ts
│   ├── orderRoutes.ts
│   └── productRoutes.ts
├── services/
│   ├── userService.ts
│   ├── orderService.ts
│   └── productService.ts
├── middleware/
│   ├── auth.ts
│   └── errorHandler.ts
├── models/
│   └── index.ts
└── index.ts
首先创建模块化的指令文件,确保后续操作高效:
# 精简根目录CLAUDE.md(<30行)
cat > CLAUDE.md << 'EOF'
# E-Commerce Backend

## Stack
- TypeScript 5.x + Node.js 20
- Express 4.x + Prisma 6.x
- PostgreSQL 16

## Rules
- 使用中文回复
- 不要自动commit
- 先读文件再修改
- 保持现有业务逻辑不变
- 修改后运行 npx tsc --noEmit 验证类型
EOF

# 创建模块级AGENTS.md
cat > src/services/AGENTS.md << 'EOF'
# Services Module
- 所有方法必须返回 Promise
- 错误统一抛 AppError(code, message)
- 输入验证使用 Zod schema
- 数据库操作使用 Prisma client
EOF

cat > src/routes/AGENTS.md << 'EOF'
# Routes Module
- 每个 resource 一个路由文件
- 使用 express.Router()
- 中间件顺序:auth -> validate -> handler
- 响应格式统一 { success: boolean, data?, error? }
EOF
向Claude Code下达指令:
我需要重构 src/services/ 下的三个文件,将所有callback风格的
异步方法改为async/await。请使用Task工具并行处理:

Agent 1(description: "refactor userService"):
读取 src/services/userService.ts,将所有使用callback的函数
改为async/await模式。保持函数签名和返回类型不变。

Agent 2(description: "refactor orderService"):
同上,处理 src/services/orderService.ts

Agent 3(description: "refactor productService"):
同上,处理 src/services/productService.ts

所有Agent完成后,运行 npx tsc --noEmit 检查类型错误。
预期结果:三个Service文件同时被修改,总耗时接近单个文件的修改时间。
错误处理涉及所有模块,存在依赖关系,应顺序执行:
现在统一错误处理:
1. 创建 src/utils/AppError.ts,定义统一的错误类
2. 更新 src/middleware/errorHandler.ts 使用新的AppError
3. 更新所有Service文件中的错误抛出方式
4. 运行 npx tsc --noEmit 验证

完成后 /compact 保存进度
验证逻辑各Service独立,可以并行:
为所有Service的公共方法添加Zod输入验证。请并行处理:

Agent 1(description: "add user validation"):
在 src/services/userService.ts 中:
- 为 createUser 添加用户名/邮箱/密码的Zod schema
- 为 updateUser 添加部分更新的Zod schema
- 在方法开头调用 schema.parse(input)

Agent 2(description: "add order validation"):
在 src/services/orderService.ts 中添加对应的Zod验证

Agent 3(description: "add product validation"):
在 src/services/productService.ts 中添加对应的Zod验证

完成后运行 npx tsc --noEmit
请执行最终检查:
1. npx tsc --noEmit — 类型检查
2. npm test — 运行所有测试
3. 报告所有修改文件的列表和变更摘要
4. /compact 所有重构完成,项目从callback迁移到async/await,统一了错误处理和输入验证
| 陷阱 | 症状 | 解决方案 |
|---|---|---|
| CLAUDE.md膨胀 | 每次启动消耗大量Token | 精简到<50行,模块信息移到AGENTS.md |
| 过度文件读取 | 上下文快速填满 | 只读取需要的行范围,或直接描述修改 |
| 忽略/compact | Agent"遗忘"早期决策 | 每40%使用率压缩一次 |
| 单会话做所有事 | 后期质量下降 | 按任务阶段分多个会话 |
| Skill堆砌 | 系统提示过长 | 只启用当前任务需要的Skill |
| 不监控成本 | 月底账单惊人 | 定期使用/cost,设置预算上限 |
| 压缩时机过晚 | 压缩摘要质量差 | 在60%使用率时主动压缩 |
isolation: "worktree" 避免文件冲突model: "haiku"节省成本graph TD
START[启动新会话] --> CHECK[/cost 检查上下文]
CHECK --> PLAN[制定任务计划]
PLAN --> SPLIT{任务可并行?}
SPLIT -->|可以| PARALLEL[Task工具启动子Agent]
SPLIT -->|不可以| SEQUENTIAL[顺序执行]
PARALLEL --> MERGE[主Agent汇总结果]
SEQUENTIAL --> VERIFY[验证结果]
MERGE --> VERIFY
VERIFY --> TEST[运行测试]
TEST --> MORE{还有任务?}
MORE -->|有| COMPACT[/compact 压缩]
COMPACT --> CHECK
MORE -->|没有| DONE[完成]
DONE --> COST[/cost 最终报告]
style START fill:#69f,stroke:#333
style DONE fill:#6f6,stroke:#333
style COMPACT fill:#f96,stroke:#333
| 技巧 | 节省量 | 操作 |
|---|---|---|
| 精简CLAUDE.md | 3-8K Token/次 | 移除冗余示例和注释 |
| 使用AGENTS.md分模块 | 2-5K Token/次 | 按需加载代替全量加载 |
| 指定行范围读取 | 1-3K Token/次 | "读取第X-Y行" |
| 主动/compact | 30-60%已用 | 在60%使用率时压缩 |
| Haiku处理简单任务 | 80-90%成本 | model: "haiku" |
| Prompt缓存复用 | 90%系统提示成本 | 保持CLAUDE.md稳定 |
/cost          # 查看当前会话Token和费用
/compact       # 压缩对话历史(可附带摘要提示)
/clear         # 清空会话历史
/rewind        # 回退到之前的状态
/effort high   # 提升思考深度
/effort low    # 降低思考深度(节省Token)
/help          # 查看所有可用命令
CLAUDE_MODEL              # 默认模型
CLAUDE_CODE_MAX_TOKENS    # 最大输出Token数
CLAUDE_CODE_BUDGET_TOKENS # 上下文窗口大小
DISABLE_PROMPT_CACHING    # 禁用缓存(调试用)
训练营适用性评估:本教程适合进阶训练营(学员已有2周以上Claude Code使用经验),建议教学时长3小时(含1小时实操练习)。实操练习建议:学员在自己的项目中完成一次完整的上下文优化改造(精简CLAUDE.md + 创建AGENTS.md + 并行重构一个模块),并对比优化前后的/cost数据。
[!tip] 51学通信知识星球 星主:爱卫生(微信:gprshome201101)——公众号「51学通信」创办者,19 年通信行业运维与讲师经验,著有《GPRS网络信令实例详解》《EPC原理与实践》《5G核心网原理与实践》三本纸质书(各大电商平台有售)。 星球定位:深耕 5G 核心网、IMS、NFV/AI、云原生等 ICT 领域,主打运维岗位与信令分析。 当前规模:5200 篇主题 / 990 个回答,198 元/年。 加入福利:加入星球后请加爱卫生微信,拉您进知识星球年度陪伴与答疑群——不限量回复您的各种问题,另有群内分享。 AI 加持:51学通信知识星球已作为 skill 接入 WorkBuddy,使用 deepseek-4-flash 在海量星球帖子中精准找贴、找视频、找 FAQ 和案例,做总结、找文档和 PPT 等场景全覆盖。
