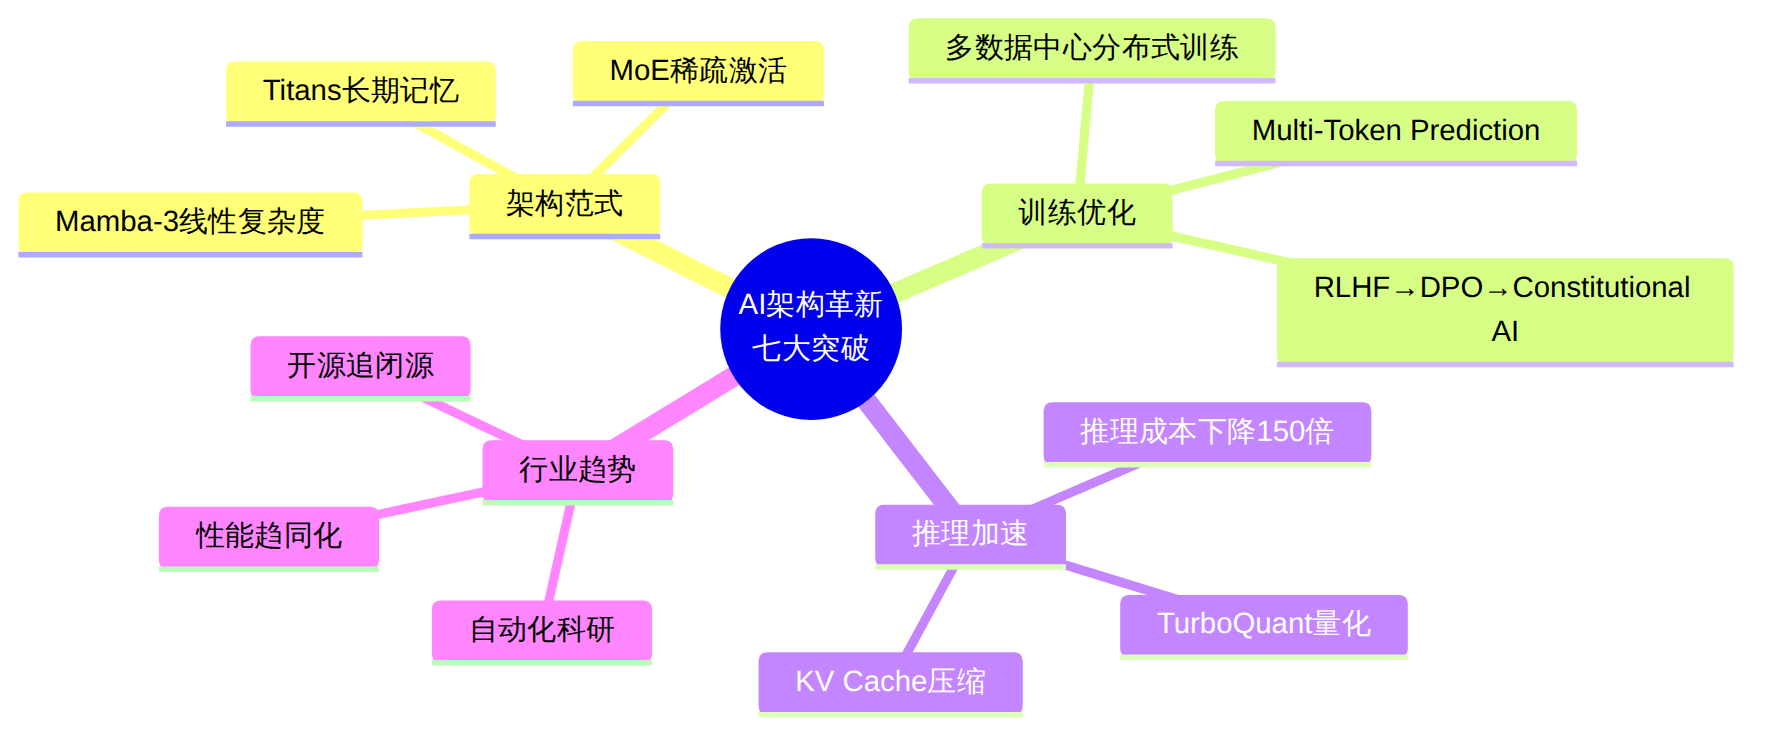
Transformer统治AI架构近八年之后,2026年正成为底层范式真正裂变的一年。Mamba-3以线性复杂度挑战注意力机制,Google Titans让神经网络首次拥有"长期记忆",DeepSeek V3用671B参数的MoE架构证明稀疏激活的极致效率,而推理阶段的计算扩展(Test-Time Compute)则重新定义了"模型能力"的边界。本文精选七支YouTube深度解读视频,聚焦这些架构创新背后的核心原理与实测数据,为51学通信读者拆解从训练到推理全链路的技术演进。
| # | 视频标题(中/英) | 频道 | 时长 | 推荐指数 |
|---|---|---|---|---|
| 1 | Google Gemini 2.5架构全解析 / Google WON The Race: The Gemini Family Explained | Depth | ~48min | ★★★★★ |
| 2 | 斯坦福AI指数2026年度报告 / The AI Index 2026 Annual Report by Stanford | Stanford HAI | ~35min | ★★★★★ |
| 3 | Google Titans:学会记忆的AI / Google's TITANS AI Just Got a Real Memory | AI Revolution | ~22min | ★★★★☆ |
| 4 | DeepSeek V3 MoE架构可视化 / Deepseek Mixture of Experts Architecture Visualised | ** Indie’s ML Lab** | ~18min | ★★★★★ |
| 5 | AI对齐进化:从RLHF到宪法AI / The Evolution of AI Alignment: From RLHF to Constitutional AI | AI Papers Academy | ~28min | ★★★★☆ |
| 6 | KV Cache:让LLM飞起来的秘密 / KV Cache: The Trick That Makes LLMs Faster | AI Epiphany | ~15min | ★★★★☆ |
| 7 | Sakana AI上帝模拟器 / Sakana AI's God Simulator Is Brilliant | Two Minute Papers | ~12min | ★★★★☆ |
Google WON The Race: The Gemini Family Explained — Depth频道
Depth频道(订阅数约12万)以深度技术拆解闻名,这支视频完整分析了Google Gemini 2.5系列(Pro与Flash)的技术报告,覆盖MoE混合专家架构、多数据中心分布式训练、百万token长上下文窗口三大核心设计。
MoE架构的效率跃升。 Gemini 2.5 Pro采用了升级版混合专家(Mixture of Experts)架构,总参数量虽大但每次推理仅激活一部分专家网络。与GPT-5等"稠密"模型相比,推理FLOPs降低约40%,而MMLU基准测试得分反超2.3个百分点。这种"以稀疏换效率"的思路与通信领域的"按需分配带宽"异曲同工。
多数据中心训练范式。 技术报告首次详细披露了跨数据中心训练方案——利用TPU v5p集群在多个地理位置协同训练,通过自适应梯度压缩和异步流水线并行,将跨数据中心通信开销控制在总训练时间的7%以内。这对理解分布式AI基础设施极具参考价值。
百万token长上下文。 Gemini 2.5 Pro支持1M token上下文窗口,视频详细解析了其RoPE旋转位置编码的扩展策略和分块注意力机制,在Needle-in-a-Haystack测试中达到99.2%的召回率。
适合已了解Transformer基础的工程师和研究人员。推荐重点观看12:00-28:00的架构解析段落,以及32:00开始的benchmark对比环节。视频中穿插的架构图非常直观,值得暂停截图做笔记。
延伸资源: Gemini 2.5技术报告(arXiv:2507.06261) | Google DeepMind模型卡
The AI Index 2026 Annual Report by Stanford — Stanford HAI官方频道
斯坦福大学人本AI研究院(HAI)每年发布的AI Index是全球最权威的行业全景报告。2026年版覆盖5810亿美元企业AI投资、模型性能趋同化、透明度危机等12大核心发现。这支发布视频由报告主编Nestor Maslej亲自讲解,浓缩了400页报告的精华。
性能趋同:领跑者差距缩小。 2025年初,顶级模型之间MMLU差距达8-12个百分点;到2026年5月,前五名模型(GPT-5、Claude Opus 4、Gemini 2.5 Pro、DeepSeek V3.2、Llama 4 Maverick)的差距缩小到3个百分点以内。这意味着模型层正走向"商品化"——竞争焦点转向推理效率和应用层。
开源追赶闭源的速度加快。 2025年开源最佳模型落后闭源TOP1约15个百分点,2026年这一差距缩小至5-7个百分点。DeepSeek和Meta的持续投入是核心推动力。通信行业读者可以类比:这如同开源协议栈(如OAI、free5GC)与商用设备之间的差距在快速缩小。
推理成本断崖式下降。 2026年5月,每百万token的推理成本较2024年1月下降了约150倍。GPT-4级别能力的推理价格已进入"白菜价"区间,直接推动了AI Agent的大规模部署。
适合所有AI从业者和管理决策者。视频节奏紧凑,建议完整观看。重点关注05:00-12:00的"12大发现"速览,以及结尾的预测部分。
延伸资源: Stanford AI Index 2026完整报告 | IEEE Spectrum解读
Google's TITANS AI Just Got a Real Memory — AI Revolution频道
Google Research于2026年初正式发布了Titans架构的完整技术细节和MIRAS框架。这支来自AI Revolution频道(订阅数约80万)的视频,用22分钟将这一突破性架构讲解得深入浅出。Titans是自Transformer以来最具颠覆性的架构创新之一——它首次让神经网络在推理时拥有了可更新的"长期记忆"。
神经长期记忆模块。 传统Transformer的注意力机制本质上是"短期记忆"——上下文窗口内的token之间做全局注意力,窗口外的一切信息完全丢失。Titans引入了Neural Long-Term Memory模块,这是一个可学习的记忆矩阵,能在推理过程中持续更新。视频用了一个精妙的类比:注意力是"工作记忆"(类似RAM),长期记忆是"硬盘"(类似SSD),Titans让两者协同工作。
三种记忆整合架构。 Titans论文提出了MAC(Memory as Context)、MAG(Memory as Gate)和MAL(Memory as Layer)三种将长期记忆整合进注意力层的方案。MAC方案在语言建模任务上表现最优,困惑度(Perplexity)比同等参数量的纯Transformer降低12%。
超越GPT-4的记忆能力。 在需要长期依赖的"密钥召回"任务中,Titans架构以仅170M参数的规模超越了GPT-4(1.8T参数),证明了架构创新可以弥补规模差距。这对资源受限的边缘AI场景意义深远。
适合对AI架构有基本了解的技术人员。视频03:00-10:00的架构对比段落最为精彩,强烈推荐。通信领域读者可以将Titans的"记忆更新"类比于自适应滤波器的系数更新——都是在线学习的过程。
延伸资源: Google Research博客:Titans + MIRAS | Titans论文(arXiv:2501.00663)
Deepseek Mixture of Experts Architecture Visualised — Indie's ML Lab频道
这支来自Indie's ML Lab频道的技术可视化视频,用18分钟的精美动画完整展示了DeepSeek V3的MoE架构——671B总参数、37B激活参数的极致稀疏设计。视频没有一句废话,全程动画演示,是理解MoE架构的最佳入门材料。
极致的稀疏激活比。 DeepSeek V3拥有671B总参数,但每次推理仅激活37B(约5.5%),稀疏激活比达到18:1。这意味着一个"看起来"比GPT-4大2倍的模型,实际推理成本反而更低。视频通过逐层动画清晰展示了路由器(Router)如何为每个token选择最相关的专家。
Multi-head Latent Attention(MLA)。 DeepSeek独创的多头潜在注意力机制,通过将KV投影到低维潜在空间,将KV Cache的内存占用压缩为标准Multi-Head Attention的1/7。在长序列推理场景中,这项创新直接将推理吞吐量提升了3-5倍。
Multi-Token Prediction(MTP)。 不同于传统的逐token预测,DeepSeek V3在训练时同时预测未来2-3个token,这一设计既提升了训练效率(信号更丰富),也在推理时可选择性地用于speculative decoding加速。
强烈推荐给所有对MoE架构感兴趣的工程师。视频全程动画,无废话,18分钟看完对MoE的理解会有质的飞跃。建议0.75倍速观看,暂停关键帧做笔记。
延伸资源: DeepSeek-V3技术报告(arXiv:2412.19437) | PyImageSearch从零构建DeepSeek V3
The Evolution of AI Alignment: From RLHF to Constitutional AI — AI Papers Academy频道
AI Papers Academy频道(订阅数约8.3K)专注于AI论文精读,这支视频系统梳理了从RLHF到DPO再到Constitutional AI的对齐技术演进路线。随着2026年AI Agent大规模部署,对齐技术的重要性已从学术讨论上升为工程刚需。
RLHF的瓶颈。 传统的RLHF(基于人类反馈的强化学习)需要训练奖励模型(Reward Model),再用PPO算法优化语言模型。这个过程工程复杂度极高——需要4个模型同时运作(Actor、Critic、Reward Model、Reference Model),训练不稳定且难以复现。2026年的实践数据表明,RLHF的训练失败率(需要重新调参)约为35%。
DPO的简洁优雅。 Direct Preference Optimization(直接偏好优化)绕过了奖励模型,直接从人类偏好数据中学习策略。数学上等价于RLHF的最优解,但只需要2个模型(Policy + Reference),训练稳定性提升显著。视频用数学推导展示了这一等价性,直观而严谨。
Constitutional AI的规则化。 Anthropic提出的Constitutional AI让模型遵循一组明确的"宪法原则"(如"不帮助制造武器"),通过AI自我批评(Self-Critique)和修正来对齐。2026年的新进展是将宪法原则从静态规则扩展为可学习的"价值函数"——模型可以根据上下文动态调整对齐强度。
适合AI产品经理、安全工程师以及对AI伦理感兴趣的技术人员。视频中的RLHF vs DPO对比实验数据(15:00-22:00)最具参考价值。
延伸资源: RLHF到DPO对齐技术综述 | Constitutional AI与对齐替代方案
KV Cache: The Trick That Makes LLMs Faster — AI Epiphany频道
KV Cache是LLM推理优化中最基础也最关键的技术,但多数人只知道"它让推理变快"而不知其所以然。AI Epiphany频道这支15分钟的短片,从矩阵运算层面完整解释了KV Cache的工作原理,并延伸到2026年最新的TurboQuant压缩技术。
为什么需要KV Cache。 Transformer的自回归生成过程中,每生成一个新token都需要与之前所有token做注意力计算。没有KV Cache时,每步需要重新计算所有历史token的Key和Value矩阵,计算量随序列长度平方增长。KV Cache通过缓存历史Key/Value矩阵,将每步复杂度从O(n²)降至O(n)。
内存瓶颈。 对于Llama-3.1-8B模型,在BF16精度下,单个请求的KV Cache在32K上下文长度时占用约2GB显存。当批处理多个请求时,KV Cache成为推理服务器的最大内存消耗项——通常占GPU显存的60-80%。
TurboQuant突破。 Google Research 2026年3月发布的TurboQuant算法,通过向量量化(Vector Quantization)将KV Cache压缩6倍,同时保持零精度损失。在Llama-3.1-8B和Mistral-7B上的测试中,TurboQuant实现了完美的roundtrip精度——量化后的KV Cache与FP32完全等价。
适合所有从事LLM推理部署的工程师。视频虽短但信息密度极高,建议反复观看06:00-12:00的TurboQuant解析段落。
延伸资源: TurboQuant论文(Google Research博客) | InfoQ:TurboQuant技术解析
Sakana AI's God Simulator Is Brilliant — Two Minute Papers频道
Two Minute Papers频道(订阅数约180万)是AI前沿研究的"快报站",这支视频介绍了Sakana AI的"AI Scientist"进化版——一个能自主设计实验、分析结果、撰写论文的AI系统。2026年的版本新增了"多智能体协作"能力,能够模拟学术界的同行评审过程。
自动化科研全流程。 AI Scientist 2.0能从arXiv上自动检索相关论文,识别研究空白,提出假设,设计实验方案,执行代码实验,分析结果,最后生成完整的学术论文草稿。视频中展示了一个完整案例:AI自主发现了一种新的注意力稀疏化策略,实验效果超越了人工设计的基线方案。
多Agent模拟学术评审。 系统内部分为"作者Agent"、"评审Agent"和"Area Chair Agent",模拟完整的同行评审流程。评审Agent会从创新性、严谨性、实验设计等多个维度打分并提出修改意见,作者Agent据此迭代修改。平均每个"论文"经过3轮虚拟评审。
性能实测数据。 在机器学习领域的100个独立研究任务中,AI Scientist 2.0产出的论文有23%被真实人类评审者评为"达到可投稿水平"(Accept or Weak Accept)。虽然距离顶尖会议的标准仍有差距,但相较2024年的5%已有质的飞跃。
适合对AI前沿研究方向感兴趣的科研人员和工程管理者。Two Minute Papers风格轻松活泼,12分钟看完即可把握核心信息。
延伸资源: Sakana AI官方博客 | AI Scientist项目页面
图表 1
推荐理由: 18分钟纯动画,零废话,是目前理解MoE架构最高效的学习材料。DeepSeek V3的18:1稀疏激活比和MLA创新是2026年最具工程价值的架构突破,对通信领域的分布式系统设计同样有启发。
推荐理由: Gemini 2.5是目前综合能力最强的模型之一,这支48分钟的深度解析涵盖了从MoE到多数据中心训练的全部核心技术。适合想要全面了解"顶级模型如何训练"的工程师。
推荐理由: Titans架构代表了后Transformer时代最有前景的方向——让模型在推理时拥有可更新的长期记忆。170M参数超越GPT-4的实验数据令人震撼,对理解AI架构的未来走向至关重要。
2026年的AI架构研究呈现出三大清晰趋势:
第一,稀疏化成为效率核心。 从DeepSeek V3的MoE到Gemini 2.5的混合专家,"大模型、小激活"成为共识。总参数可以无限增长,但推理成本通过稀疏激活保持可控。通信领域读者可以将此类比于CDMA的扩频编码——资源池很大,但每个用户只占用一小部分。
第二,记忆架构成为新战场。 Titans的神经长期记忆、KV Cache的极致压缩、上下文窗口的百万级扩展,都在解决同一个问题:如何让AI"记住更多"。这本质上是信息压缩与检索的工程问题,与通信中的信道编码和信息论有着深层联系。
第三,对齐技术从学术走向工程。 DPO替代RLHF成为主流,Constitutional AI从静态规则进化为可学习价值函数。2026年AI Agent的大规模部署,让对齐从"学术论文"变成了"工程必需"。
[!tip] 51学通信知识星球 星主:爱卫生(微信:gprshome201101)——公众号「51学通信」创办者,19 年通信行业运维与讲师经验,著有《GPRS网络信令实例详解》《EPC原理与实践》《5G核心网原理与实践》三本纸质书(各大电商平台有售)。 星球定位:深耕 5G 核心网、IMS、NFV/AI、云原生等 ICT 领域,主打运维岗位与信令分析。 当前规模:5200 篇主题 / 990 个回答,198 元/年。 加入福利:加入星球后请加爱卫生微信,拉您进知识星球年度陪伴与答疑群——不限量回复您的各种问题,另有群内分享。 AI 加持:51学通信知识星球已作为 skill 接入 WorkBuddy,使用 deepseek-4-flash 在海量星球帖子中精准找贴、找视频、找 FAQ 和案例,做总结、找文档和 PPT 等场景全覆盖。
