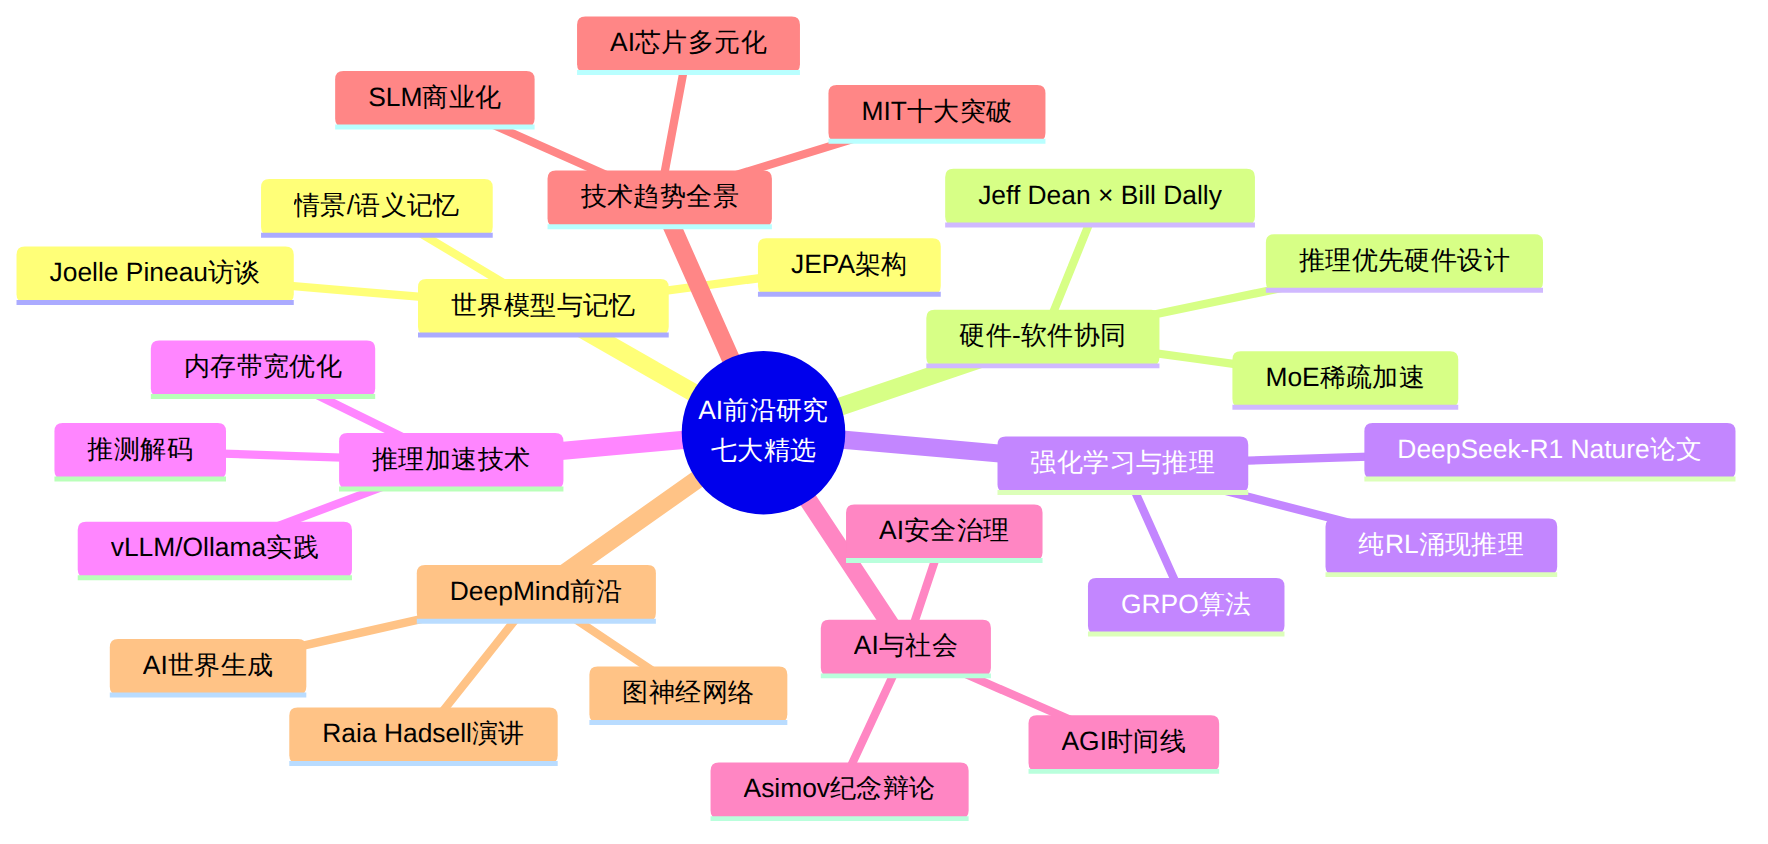
2026年上半年的AI前沿研究呈现出两条清晰的主线:世界模型正在从概念走向工程原型,推理能力正从暴力堆算力转向更高效的训练范式。本期的七支精选视频覆盖了GTC 2026峰会对话、Nature封面论文解读、MIT技术突破榜单,以及谷歌DeepMind和Cohere等头部机构的最新研究路线。内容横跨硬件-软件协同设计、强化学习驱动的推理能力涌现、推测解码等推理加速技术,以及Chinchilla缩放定律对训练经济学的深远影响。对通信行业技术人员而言,这些研究揭示了AI基础设施需求的真实走向——不仅仅是"买更多GPU",而是如何在有限算力预算下实现最优推理性能。
| # | 视频标题 | 频道 | 时长 | 推荐指数 |
|---|---|---|---|---|
| 1 | AI's Research Frontier: Memory, World Models, & Planning — Joelle Pineau | Big Technology Podcast | ~60min | ★★★★★ |
| 2 | Advancing to AI's Next Frontier: Jeff Dean & Bill Dally (GTC 2026) | NVIDIA GTC | 60min | ★★★★★ |
| 3 | Frontier AI and the Future of Intelligence — Raia Hadsell | AI Engineer | ~45min | ★★★★☆ |
| 4 | DeepSeek-R1: How Pure RL Unlocks Reasoning | Umar Jamil / AI Coffee Break | 30-45min | ★★★★★ |
| 5 | The Rise and Reckoning of AI — 2026 Asimov Debate | AMNH / Hayden Planetarium | ~120min | ★★★★☆ |
| 6 | Speculative Decoding: 3× Faster LLM Inference | Umar Jamil | ~25min | ★★★★☆ |
| 7 | MIT's 10 Breakthrough Technologies 2026 | Kurzgesagt / AI Search | ~20min | ★★★★☆ |
原标题: AI's Research Frontier: Memory, World Models, & Planning — With Joelle Pineau
频道: Big Technology Podcast(Alex Kantrowitz主持)
发布时间: 2026年5月
Joelle Pineau是Cohere首席AI官,此前在Meta AI领导FAIR实验室多年。这支视频并非普通的技术访谈,而是对AI研究下一个十年的路线图级对话。Pineau从三个维度勾勒了AI研究的核心前沿。
核心要点:
记忆架构:当前LLM的上下文窗口虽然在扩展(Gemini已支持百万token),但真正的"记忆"远不止于上下文长度。Pineau讨论了情景记忆(Episodic Memory)和语义记忆(Semantic Memory)在AI系统中的不同实现方式——前者让AI记住具体交互经历,后者让AI形成可泛化的知识表征。这对通信领域的AI应用(如网络故障诊断助手)意义重大:AI需要"记住"历史上每种故障模式的具体表现,而非仅依赖通用知识推理。
世界模型:Pineau认为2026年是世界模型从研究走向工程的关键一年。所谓世界模型(World Model),是指AI系统能够对物理世界或信息世界建立内部模拟,预测行动后果。Yann LeCun的JEPA架构(Joint Embedding Predictive Architecture)是当前最具代表性的路线,其核心思想是不在像素层面重建世界,而是在抽象表征层面预测未来状态——训练效率比传统方法提升1.5-6倍。
规划能力:LLM的Chain-of-Thought本质上是一种"伪规划",真正的规划需要树搜索+回溯+状态评估的组合。Pineau强调了AlphaGo式的MCTS(蒙特卡洛树搜索)与LLM推理的融合趋势——这也正是DeepSeek-R1和OpenAI o系列的技术基础。
关键技术概念:
世界模型(World Model):AI系统对环境的内部表征。不同于LLM的文本预测,世界模型旨在理解"如果我做X,环境会怎样变化"。类比通信领域,可以理解为AI不仅知道协议规范,还能模拟"如果这个网元配置变更,整条信令链路会如何级联响应"。
观看建议: 适合所有AI从业者,尤其是需要理解AI研究走向的技术管理者。推荐从第15分钟开始听关于世界模型的部分,到第40分钟结束即可抓住核心观点。
延伸资源: - Yann LeCun JEPA论文:arxiv.org/abs/2302.02632 - Cohere官方博客关于RAG+记忆架构的最新文章
原标题: Advancing to AI's Next Frontier: Insights From Jeff Dean and Bill Dally
频道: NVIDIA GTC(GTC 2026官方频道)
发布时间: 2026年3月(GTC 2026大会期间)
这是GTC 2026最受关注的对话之一。Google首席科学家Jeff Dean与NVIDIA首席科学家兼GPU架构师Bill Dally围绕"硬件-软件协同设计"展开了60分钟的深度对谈。这不是一场营销演讲,而是两位真正塑造AI基础设施的技术领袖的思想碰撞。
核心要点:
推理优先的时代到来:Jeff Dean明确指出,AI正在从"训练为王"转向"推理为王"。Google内部的推理算力消耗已经超过训练,这一趋势对芯片设计产生了根本影响——推理延迟(Latency)正在取代训练吞吐量(Throughput)成为硬件优化的首要目标。这对通信行业的启示是:部署AI的网络边缘设备,其芯片选型逻辑需要从"峰值算力"转向"推理能效比"。
定制互连的重要性:Bill Dally详细讨论了NVLink 5和NVSwitch在多节点推理中的作用。当模型参数达到万亿级别时,节点间的通信带宽成为瓶颈,而不仅是GPU本身的计算能力。类比通信网络,这实质上是一个"数据中心内部的高速信令网络"设计问题。
稀疏激活与MoE的硬件支持:Dean提到Google内部正在为Mixture of Experts(MoE)架构设计专用的硬件加速路径。MoE模型(如DeepSeek-V3)虽然参数总量巨大,但每次推理只激活一小部分专家,实际计算量远小于同等规模的密集模型。硬件层面利用这种稀疏性,可以实现3-5倍的推理效率提升。
关键技术概念:
MoE(Mixture of Experts,混合专家模型):一种模型架构,将多个"专家网络"组合在一起,通过门控机制(Gating)在推理时动态选择最相关的专家。DeepSeek-V3使用256个路由专家,每次激活8个,等效计算量仅为密集模型的1/32。
观看建议: 强烈推荐完整观看。如果时间有限,第20-45分钟关于推理硬件和互连设计的讨论最为精华。
延伸资源: - NVIDIA GTC 2026官方回放页 - Jeff Dean推特讨论:@JeffDean
原标题: Frontier AI and the Future of Intelligence — Raia Hadsell, VP of Research, Google DeepMind
频道: AI Engineer(AI Engineer Europe 2026大会)
发布时间: 2026年4月
Raia Hadsell是Google DeepMind研究副总裁,在强化学习、表征学习和机器人领域有超过15年的研究经历。这场演讲的独特价值在于:她不是在讲Gemini的产品功能,而是在讲Gemini背后的科学研究方法论。
核心要点:
超越语言的AI:Hadsell明确指出,LLM(大语言模型)只是AI的一种形态。DeepMind的研究路线正在向多模态世界理解扩展——包括视觉-语言-行动的联合建模。她展示了Gemini如何从单纯的文本理解进化到理解物理场景的空间关系。
图神经网络(GNN)的商业化:DeepMind在GNN(Graph Neural Network)领域的积累正在加速商业化。GNN天然适合建模关系型数据——社交网络、分子结构、通信网络拓扑都是典型场景。Hadsell提到DeepMind正在将GNN与LLM结合,让AI既能处理非结构化文本,又能理解结构化的关系图。
AI驱动的世界生成:DeepMind在AI世界生成(AI-powered World Generation)方面取得了突破,这不仅是游戏场景的应用,更是对"AI能否理解物理世界因果规律"的验证。其核心技术是条件扩散模型(Conditional Diffusion Models),能在给定约束下生成物理上合理的环境。
关键技术概念:
图神经网络(GNN):一种直接在图结构数据上运行的神经网络。与传统神经网络处理固定大小输入不同,GNN能处理任意拓扑结构的图。在通信领域,GNN可用于网络拓扑优化、路由决策、故障传播预测等任务——因为它天然适合建模"节点-链路"关系。
观看建议: 适合希望了解Google DeepMind研究路线图的技术人员。第25-40分钟关于GNN和世界生成的部分最为精彩。
延伸资源: - Raia Hadsell个人主页:raiahadsell.com - AI Engineer Europe 2026议程
原标题: DeepSeek-R1 Deep Dive: How Pure Reinforcement Learning Unlocks Reasoning
频道: Umar Jamil / AI Coffee Break with Letitia(多个频道有深度解读)
关联论文: DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning(发表于Nature)
发布时间: 2025年底至2026年初
DeepSeek-R1登上Nature封面,这是中国AI团队在顶级学术期刊上的里程碑事件。其核心贡献是证明了一件事:不需要人类示范数据,纯强化学习就能让LLM涌现出复杂的推理能力。多个YouTube频道对这篇论文进行了深度解读。
核心要点:
R1-Zero的意外发现:研究团队首先训练了DeepSeek-R1-Zero,这是一个仅通过GRPO(Group Relative Policy Optimization)强化学习训练的模型,没有任何监督微调(SFT)或人类标注数据。令人震惊的是,R1-Zero自发涌现了Chain-of-Thought推理、自我验证、甚至反思纠错等高级行为。这意味着推理能力可能"内含"在语言模型的预训练表征中,只需正确的激励信号就能被激活。
从R1-Zero到R1的多阶段管道:由于R1-Zero存在可读性差、语言混杂等问题,研究团队设计了多阶段训练管道:冷启动SFT → RL训练 → 拒绝采样 → 二次RL。最终DeepSeek-R1在数学、编程、科学推理等任务上达到与OpenAI o1相当的水平,但训练成本仅为后者的一小部分。
蒸馏的威力:研究团队将R1的推理能力蒸馏到1.5B-70B参数的小模型上,这些蒸馏模型在同级别模型中表现最优。这证明了一个关键商业洞察:推理能力可以高效迁移,不需要每个小模型都经历昂贵的RL训练。
关键技术概念:
GRPO(Group Relative Policy Optimization):DeepSeek团队提出的强化学习算法,是对传统PPO的改进。核心思想是将同一问题的多个采样回答进行组内比较,用相对排名而非绝对评分作为奖励信号。这消除了对额外奖励模型(Critic)的需求,大幅降低了RL训练的计算开销。
观看建议: 推荐Umar Jamil的Paper Walkthrough版本(约30分钟),技术讲解最为清晰。如果你更偏好中文解读,B站"跟李沐学AI"也有高质量的R1论文精读。
延伸资源: - Nature论文原文:nature.com/articles/s41586-025-09422-z - arXiv预印本:arxiv.org/abs/2501.12948
原标题: The Rise and Reckoning of AI | 2026 Isaac Asimov Memorial Debate
频道: AMNH(美国自然历史博物馆)
发布时间: 2026年3月26日
这是第25届Isaac Asimov纪念辩论,由Neil deGrasse Tyson主持。辩题为"AI的崛起与清算"(The Rise and Reckoning of AI),参与者包括Eric Schmidt(前Google CEO)、多位AI学术界领袖和政策专家。这不是技术演讲,而是一场关于AI对社会、经济和科学研究影响的深度对话。
核心要点:
AGI时间线的分歧:辩论中最激烈的分歧在于AGI何时到来。乐观派认为2028-2030年即可实现,悲观派则认为当前架构(Transformer+RL)存在根本瓶颈,需要全新的范式突破。Eric Schmidt持中间立场,认为"我们不应该纠结于AGI的定义,而应该关注AI是否能在更多实际任务中超越人类专家"。
AI对科学研究的加速:与会者一致认同AI已经从根本上改变了科学研究的速度。从蛋白质结构预测到新材料发现,AI不是替代科学家,而是将科学家的生产力提升了一个数量级。2026年的关键突破包括AI辅助药物设计和AI驱动的气候模型优化。
安全与治理的现实挑战:辩论触及了AI安全的现实困境——不是"终结者"式的科幻场景,而是更紧迫的问题:深度伪造、AI偏见、以及AI系统在高风险场景(医疗、自动驾驶、军事)中的可靠性保证。
关键技术概念:
AGI(Artificial General Intelligence,通用人工智能):能在任何智力任务上达到或超越人类水平的AI系统。当前共识是,即使GPT-5级别的模型也并非AGI——它们在语言和推理方面强大,但在物理世界理解、长期规划和自主学习方面仍存在根本缺陷。
观看建议: 全长约120分钟,适合周末完整观看。如果时间有限,推荐观看第30-70分钟关于AGI时间线和科学影响的讨论。
延伸资源: - AMNH官方回放页 - 完整文字转录:scribehawk.com
原标题: Speculative Decoding: 3× Faster LLM Inference with Zero Quality Loss
频道: Umar Jamil
发布时间: 2025年底-2026年
这是一支纯技术论文解读视频,讲解了LLM推理加速领域最重要的技术之一——推测解码(Speculative Decoding)。视频从标准自回归解码的瓶颈出发,逐步推导出推测解码的完整算法。
核心要点:
自回归解码的根本瓶颈:标准LLM推理是严格串行的——每生成一个token都需要一次完整的前向传播。在70B参数模型上,每次前向传播约30ms,意味着生成速度被锁定在约33 token/秒的理论上限。这个瓶颈的本质不是计算慢,而是内存带宽瓶颈(Memory Bandwidth Bound)——GPU的HBM带宽远低于其计算能力。
推测解码的核心思想:使用一个小型草稿模型(Draft Model)快速生成多个候选token,然后用目标模型并行验证这些token。关键数学保证:如果草稿模型的预测与目标模型一致,则接受该token(零质量损失);如果不一致,则拒绝并重新采样。这本质上是将自回归生成的"串行等待"转化为"并行投机+验证"。
实际加速效果:在vLLM、Ollama等框架中,推测解码通常能实现2-3倍的推理加速。对于通信行业的AI部署场景,这意味着在相同硬件上服务2-3倍的并发用户,直接降低单位推理成本。
关键技术概念:
推测解码(Speculative Decoding):类比通信协议中的ARQ(自动重传请求)机制——发送方(草稿模型)连续发送多个数据帧(候选token),接收方(目标模型)批量确认或拒绝。正确传输的帧无需重传(接受),错误的帧通过NACK触发重传(重新采样)。通信工程师应该对这个思路非常熟悉。
观看建议: 25分钟的视频,技术密度极高。推荐完整观看,配合纸笔推导算法步骤。适合有LLM推理部署经验的工程师。
延伸资源: - Google Research回顾文章:research.google/blog/looking-back-at-speculative-decoding - LLM推理优化完整指南:youngju.dev/blog/ai/2026-03-17-llm-inference-optimization-guide
原标题: Top 15 New Breakthrough Technologies of 2026 (According to MIT)
频道: 多个科普频道解读(Kurzgesagt风格)
发布时间: 2026年1-5月
MIT Technology Review每年发布的"十大突破性技术"榜单是科技行业最具权威性的技术趋势判断之一。2026年的榜单中,AI相关技术占据了半壁江山,本视频对其进行了可视化解读。
核心要点:
AI驱动的科学发现首次独立入选——AI不再只是"工具",而是作为科学发现的主体。2025-2026年,AI独立发现(或主导发现)的新材料、新药物分子、新数学定理数量呈指数增长。
小语言模型(SLM)的商业化突破:3B-8B参数的小模型在特定任务上已经达到甚至超越GPT-4级别的表现,且推理成本降低两个数量级。这对边缘AI部署(包括通信基站的AI推理)是重大利好。
AI芯片多元化:NVIDIA虽然仍是主导者,但Google TPU v6、AMD MI400、以及中国的昇腾920正在形成真正的竞争格局。竞争带来的价格下降对AI基础设施的商业可持续性至关重要。
关键技术概念:
小语言模型(SLM, Small Language Model):参数量在1B-10B之间的语言模型。通过高质量数据筛选、知识蒸馏和专项微调,SLM在垂直领域可以达到接近大模型的效果,但推理成本仅为其1/10-1/100。对通信行业而言,SLM是在网元级设备上部署AI的最可行路径。
观看建议: 20分钟的概览式视频,适合所有技术人员作为技术趋势参考。推荐作为"晨间通勤"视频快速浏览。
延伸资源: - MIT Technology Review官方榜单:technologyreview.com/2026/01/12/1130697/10-breakthrough-technologies-2026
图表 1
TOP 1:Jeff Dean & Bill Dally GTC 2026对话
如果只看一支视频,看这支。两位AI基础设施领域最具影响力的技术领袖,直接讨论了推理优先时代下的硬件设计哲学。对任何关心AI算力成本和部署效率的人来说,这是2026年最权威的一次技术方向对话。关键收获:推理算力需求已超训练,互连带宽是下一个瓶颈。
TOP 2:DeepSeek-R1论文深度解读
DeepSeek-R1登上Nature封面本身就是一个信号:纯强化学习可以让LLM涌现推理能力。这对理解AI推理的经济性至关重要——如果推理能力可以通过低成本RL训练而非昂贵的人工标注获得,那么推理模型的成本曲线将被彻底改写。
TOP 3:Joelle Pineau关于AI研究前沿的对话
Pineau作为Cohere首席AI官和前Meta FAIR负责人,她的判断代表了一线研究机构对AI下一个十年的押注方向。记忆、世界模型、规划——这三个关键词定义了AI从"语言处理"走向"世界理解"的技术路线。
[!tip] 51学通信知识星球 星主:爱卫生(微信:gprshome201101)——公众号「51学通信」创办者,19 年通信行业运维与讲师经验,著有《GPRS网络信令实例详解》《EPC原理与实践》《5G核心网原理与实践》三本纸质书(各大电商平台有售)。 星球定位:深耕 5G 核心网、IMS、NFV/AI、云原生等 ICT 领域,主打运维岗位与信令分析。 当前规模:5200 篇主题 / 990 个回答,198 元/年。 加入福利:加入星球后请加爱卫生微信,拉您进知识星球年度陪伴与答疑群——不限量回复您的各种问题,另有群内分享。 AI 加持:51学通信知识星球已作为 skill 接入 WorkBuddy,使用 deepseek-4-flash 在海量星球帖子中精准找贴、找视频、找 FAQ 和案例,做总结、找文档和 PPT 等场景全覆盖。
