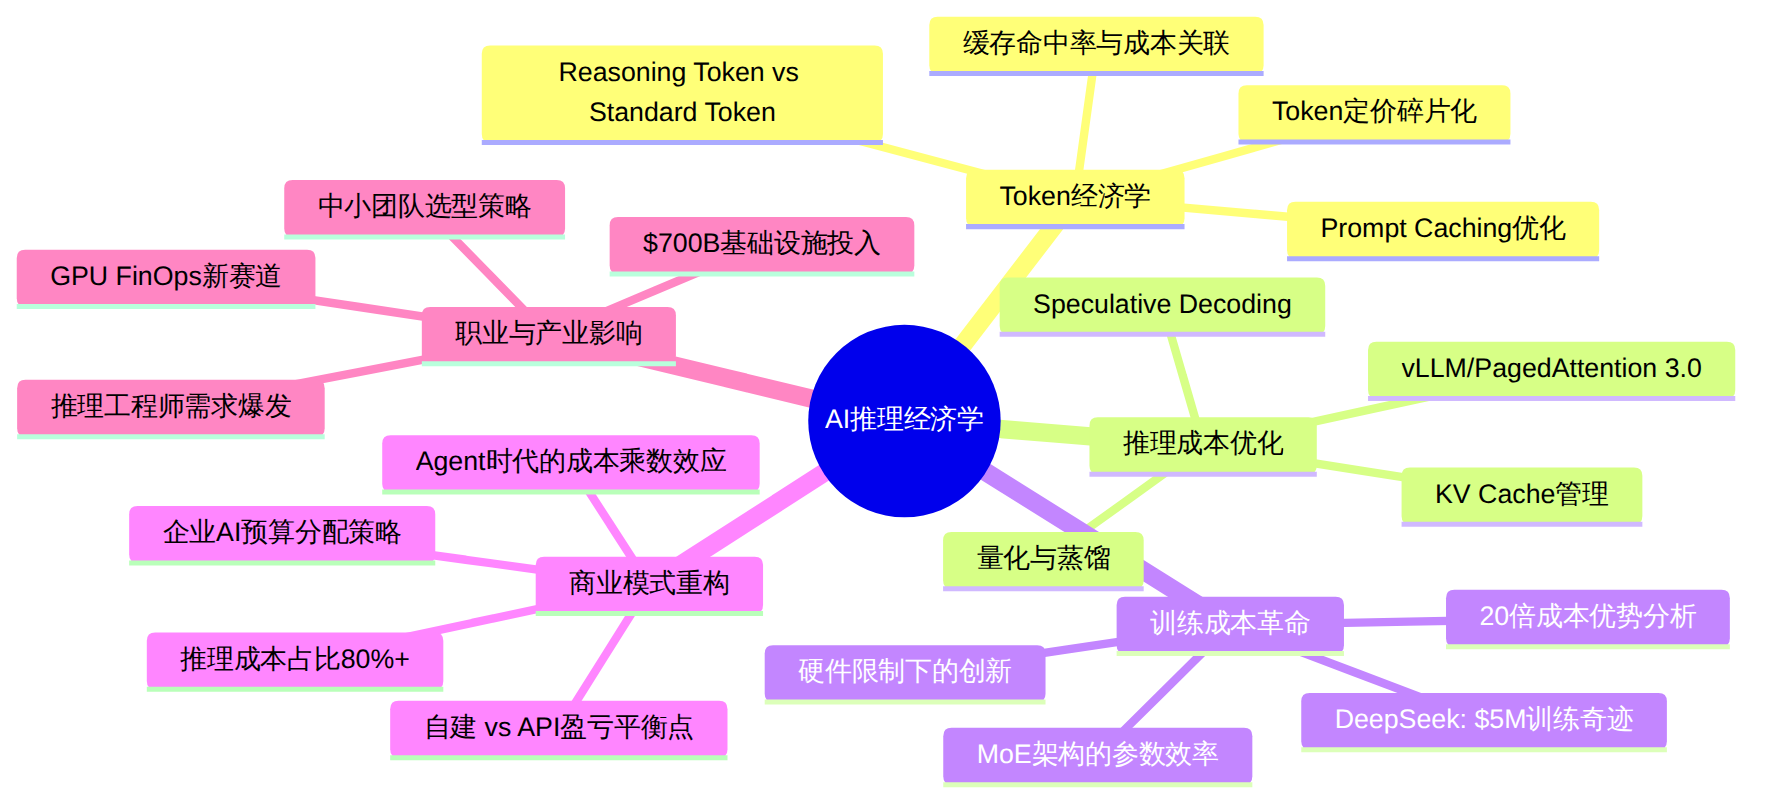
2026年,AI行业正经历一场无声的经济学革命。当所有人还在讨论千亿参数模型的训练成本时,一个更关键的趋势已经悄然改变行业格局——推理成本(Inference Cost)已取代训练成本,成为AI企业最大的开支项。据多个权威来源交叉验证,2026年AI推理成本占总计算支出的比例已从2024年的不足40%飙升至80%以上。LLM推理成本在过去18个月内下降了约1000倍,但使用量的指数级增长使总支出不降反升。本期精选8个YouTube深度视频,从Token经济学、推理优化架构、DeepSeek成本奇迹到Agent时代的隐藏成本,为你拆解这场正在重塑AI商业模式的成本革命。
| # | 视频标题 | 频道 | 时长 | 推荐指数 |
|---|---|---|---|---|
| 1 | AI Token Economics: Real Costs of Running Models in 2026 | Liftoff With Keith | ~45min | ★★★★★ |
| 2 | AI Inference: The Billion Dollar Problem Big Tech is Racing to Solve | AI Economics | ~30min | ★★★★★ |
| 3 | The Hidden Cost of AI Agents in 2026 | AI Grid | ~25min | ★★★★☆ |
| 4 | The New Economics of AI: Managing Token Costs, Margins, and Model Selection | AI Business | ~40min | ★★★★★ |
| 5 | AI Token Economics and Prompt Caching Optimization | SemiAnalysis x Wei Zhou | ~55min | ★★★★★ |
| 6 | Token Taxonomy 2026: AI Bill Surge Alert | AI Frontier | ~20min | ★★★★☆ |
| 7 | DeepSeek's Cost-Efficient Model Training ($5M vs Hundreds of Millions) | AI Breakdown | ~35min | ★★★★☆ |
| 8 | The AI Transformation: $700B, Inference Costs, and Your Career | AI Infrastructure | ~50min | ★★★★☆ |
图表 1
频道: Liftoff With Keith | 订阅数: ~15K
发布日期: 2026年5月 | 时长: 约45分钟
核心要点:
95%的AI项目正在失败——不是因为技术不行,而是因为没有人认真算过Token账。Keith Newman与WEKA的Val Bercovici对谈,揭示了2026年AI项目失败率居高不下的经济学根源。许多企业在POC阶段忽视了Token消耗的边际成本递增效应,导致上线后成本失控。
Token定价的三层蛋糕模型:标准输入Token、推理Token(Reasoning Token)和缓存Token三种定价正在形成。推理模型的Token消耗通常是标准模型的5-10倍,而大多数企业还在用2024年的Token单价做预算。
推理成本>训练成本的拐点:当一个模型服务超过100万用户时,累计推理成本将在3-6个月内超过训练成本。这对"训练一次、永远赚钱"的商业假设构成了根本性挑战。
GPU利用率陷阱:多数企业的GPU利用率不足40%,但云厂商按100%计费。Prompt Caching和Batch优化可以将有效利用率提升至70%以上。
关键技术概念:
Token经济学(Token Economics):指LLM每次生成文本时消耗的Token数量及其对应的计费模型。1个Token约等于4个英文字符或0.75个英文单词。中文场景下,1个汉字约等于1.5-2个Token。理解Token计费是控制AI运营成本的基础。
观看建议: 适合CTO、技术负责人和产品经理。推荐重点观看15:00-30:00段关于Token定价三层模型的讲解,以及35:00后关于成本优化策略的实战建议。
频道: AI Economics | 订阅数: ~8K
发布日期: 2026年4月 | 时长: 约30分钟
核心要点:
推理成本才是真正的预算杀手。本视频用数据驱动的方式证明了:2026年,AI推理成本已经超过了训练成本。以GPT-5级别的模型为例,训练成本约$1-5亿,但年度推理成本可达$10亿以上(按1亿日活用户计算)。
推理成本的四大优化层:硬件层(GPU/TPU选型)、模型层(量化/蒸馏/剪枝)、系统层(KV Cache/批处理/调度)和应用层(Prompt优化/缓存策略)。每一层都有10倍以上的优化空间,但多数企业只关注了其中一层。
1000倍成本塌方:LLM推理成本在18个月内下降约1000倍,速度远超摩尔定律。但使用量的爆炸式增长使总推理支出仍在以每年2-3倍的速度增长。
Big Tech的推理军备竞赛:Google(TPU v6)、NVIDIA(Blackwell Ultra)、Amazon(Trainium3)都在押注推理专用芯片。推理市场的TAM(总可达市场)预计2027年将达到$2000亿。
关键技术概念:
推理(Inference):模型训练完成后,使用模型对新输入进行预测/生成的过程。每个ChatGPT用户的每次提问都触发一次推理。推理成本与用户量成正比,而训练成本是一次性的——这正是推理经济学如此重要的原因。
KV Cache:Transformer模型推理中的关键优化技术。在自回归生成中,已计算的Key-Value对可以被缓存复用,避免重复计算。KV Cache管理的效率直接决定了推理的吞吐量和成本。
观看建议: 适合所有AI从业者。视频结构清晰,技术深度适中,推荐全片观看。特别关注10:00-20:00段的四大优化层分析,是架构师做技术选型的绝佳参考。
频道: AI Grid | 订阅数: ~50K
发布日期: 2026年5月 | 时长: 约25分钟
核心要点:
Agent的成本乘数效应:一个AI Agent完成一个看似简单的任务(如"帮我调研竞品并生成报告"),可能需要20-50次LLM调用。每次调用都消耗Token,累计成本可能是单次问答的50-100倍。这是2026年企业AI预算超支的第一大原因。
Reasoning模型的隐藏税:使用o3/DeepThink等推理模型时,系统会生成大量用户不可见的"思维链"Token。这些Token同样计费,但用户只能看到最终答案。一个看似简单的数学题,背后可能消耗了10,000+个隐藏Token。
多Agent系统的成本爆炸:当多个Agent协同工作时(如AutoGen、CrewAI框架),Token消耗呈指数级增长。一个5-Agent系统完成一个中等复杂度任务的成本,可能是单Agent的8-15倍。
成本治理框架:视频提出了"Token Budget"概念——为每个Agent工作流设定Token消耗上限,超出时自动降级到更便宜的模型。这种"分级服务"策略可将成本降低60-80%。
关键技术概念:
Agent成本乘数(Agent Cost Multiplier):AI Agent执行复杂任务时,需要将任务分解为多个子步骤,每个子步骤可能涉及独立的LLM调用。假设一个任务需要N次调用,每次调用的平均Token消耗为T,则总成本 = N × T × 单价。当Agent之间还有通信和协调时,成本进一步放大。
观看建议: 适合正在构建AI Agent产品的开发者和技术管理者。重点观看5:00-15:00段关于Reasoning Token隐藏成本的揭露,以及18:00后的Token Budget实践方案。
频道: AI Business | 订阅数: ~12K
发布日期: 2026年4月 | 时长: 约40分钟
核心要点:
AI软件进入高边际成本时代:传统SaaS的边际成本趋近于零(多一个用户几乎不增加成本),但AI-native应用的边际成本显著为正——每多一个用户,就多一份Token消耗。这从根本上改变了SaaS的经济学模型。
AI工作流中的隐藏成本驱动器:上下文窗口大小(Context Window)对成本的影响被严重低估。一个128K上下文窗口的请求,其输入Token成本是4K窗口的32倍。Reasoning模型在处理长上下文时的Token消耗更是普通模型的3-5倍。
毛利率计算新范式:视频给出了一个AI产品的毛利率计算框架:毛利率 = (订阅收入 - Token成本 - 基础设施成本) / 订阅收入。许多AI创业公司的毛利率只有20-30%,远低于传统SaaS的70-80%。
模型选择的成本-性能权衡:不是所有任务都需要最强的模型。视频提出了"模型路由"(Model Routing)策略——简单任务用小模型(如Claude Haiku),复杂任务用大模型(如Claude Opus),可以将整体成本降低50-70%。
关键技术概念:
模型路由(Model Routing):一种成本优化策略,通过分类器判断用户请求的复杂度,自动将简单请求路由到轻量模型、复杂请求路由到重量模型。类似于"能用自行车就不用坦克",在保证用户体验的前提下大幅降低推理成本。
AI毛利率挤压(Margin Squeeze):指AI产品随着用户增长,Token成本同步增长,导致毛利率无法随规模扩大而提升的现象。这是2026年AI创业公司面临的最大商业挑战之一。
观看建议: 适合AI创业公司CEO、产品负责人和投资人。全片推荐观看,特别是20:00-30:00段的毛利率计算框架和模型路由策略,直接可用于商业计划书。
频道: SemiAnalysis | 订阅数: ~25K
发布日期: 2026年3月 | 时长: 约55分钟
核心要点:
Prompt Caching是2026年最被低估的成本优化手段:SemiAnalysis首席分析师Wei Zhou深度拆解了Prompt Caching的技术原理和经济价值。当系统提示(System Prompt)和上下文被缓存后,重复请求的Token成本可降低80-90%。
Token成本的"千层蛋糕":视频提出了Token成本的多层结构——从原始Token单价、到Reasoning溢价、到Context窗口溢价、到Agent协调开销。每一层都可能让最终成本翻倍,而多数企业只看到了最表面的一层。
各云厂商的Token定价策略对比:详细对比了OpenAI、Anthropic、Google、AWS Bedrock、Azure AI的Token定价差异。同样使用GPT-4级别的模型,不同平台的成本差异可达2-3倍。
缓存命中率的经济学:Prompt Caching的缓存命中率直接决定了成本优化的上限。在客服场景中,缓存命中率可达70%+(因为系统提示和常见问答高度重复),而在创意写作场景中可能不足20%。
关键技术概念:
Prompt Caching(提示缓存):LLM推理优化技术。当多个请求共享相同的系统提示或前缀时,可以复用已计算的KV Cache,避免重复编码。Anthropic的Prompt Caching可降低缓存部分Token价格90%。这对高频调用场景(如客服、代码补全)意义重大。
观看建议: 这是本批次技术深度最高的视频。适合架构师和后端工程师。推荐全片观看,Wei Zhou的分析框架在行业内具有很高的参考价值。SemiAnalysis是AI基础设施领域最受尊重的分析机构之一。
频道: AI Frontier | 订阅数: ~6K
发布日期: 2026年5月 | 时长: 约20分钟
核心要点:
Token定价碎片化是新风险:2024年只有"输入Token"和"输出Token"两种价格,到2026年已经碎片化为Standard Token、Reasoning Token、Cached Token、Speculative Token、Embedding Token等多种类别。企业如果不理解这个分类体系,很容易被账单震惊。
推理Token是"沉默的成本杀手":当你使用o3、DeepThink等推理模型时,系统内部的"思考过程"Token按更高价格计费,但这些Token对用户不可见。一个$0.05的API调用,可能包含$0.04的隐藏推理Token。
企业Token治理三步法:(1)建立Token消耗的实时监控仪表板;(2)为不同业务场景设定Token预算上限;(3)实施自动化的模型降级策略。没有这三步,AI账单将在3个月内失控。
2026年Q2定价趋势:Standard Token价格继续下降(季度环比-15%),但Reasoning Token价格保持稳定。这意味着使用推理模型的总成本占比在上升。
关键技术概念:
Token分类学(Token Taxonomy):2026年Token计费的多维分类体系。Standard Token用于普通对话,Reasoning Token用于模型内部推理链,Cached Token用于被缓存的重复内容,Speculative Token用于推测解码的中间结果。理解这个分类是控制AI成本的前提。
观看建议: 适合财务负责人、FinOps团队和项目经理。视频简洁有力,20分钟就能掌握Token定价的最新全貌。推荐全片观看,信息密度极高。
频道: AI Breakdown | 订阅数: ~100K
发布日期: 2026年初 | 时长: 约35分钟
核心要点:
$5.6M训练出GPT-4级别模型:DeepSeek V3用仅$560万的训练成本,达到了接近GPT-4o的性能水平。作为对比,OpenAI训练GPT-4的估计成本为$1-5亿。这个20倍的成本差距是AI行业近年来的最大震撼之一。
MoE架构是成本效率的核心:DeepSeek V3采用Mixture-of-Experts架构,6710亿总参数中每次推理只激活约370亿参数。这意味着训练和推理的计算量远低于同等规模的Dense模型。MoE的"稀疏激活"特性是低成本的秘密武器。
硬件限制倒逼创新:DeepSeek团队受限于美国芯片出口管制,只能使用NVIDIA H800(A100的降级版)进行训练。这种限制反而催生了极具创意的工程优化——包括自定义的FP8混合精度训练框架、优化的All-to-All通信策略、以及创新的辅助损失无关负载均衡方案。
对AI商业模式的冲击:如果$560万就能训练出顶级模型,那么"烧钱训练壁垒"的护城河是否还存在?视频分析了这对OpenAI、Google等公司的战略影响。
关键技术概念:
MoE(Mixture of Experts,混合专家模型):一种神经网络架构,将模型分为多个"专家"子网络,每次推理只激活其中一小部分。DeepSeek V3有256个路由专家,每次只激活8个。这使得671B参数的模型实际推理计算量仅相当于一个37B参数的Dense模型——性能不减,成本大幅下降。
FP8混合精度训练:使用8位浮点数(而非传统的16位或32位)进行模型训练,可将显存占用和计算量减半,同时通过混合精度策略保持训练稳定性。DeepSeek V3是最早在超大规模训练中成功应用FP8的模型之一。
观看建议: 适合所有对AI前沿技术感兴趣的观众。DeepSeek的故事既是技术突破,也是地缘政治和资源约束下的工程创新典范。推荐全片观看,10:00-25:00段关于MoE架构和FP8训练的讲解尤为精彩。
频道: AI Infrastructure | 订阅数: ~10K
发布日期: 2026年4月 | 时长: 约50分钟
核心要点:
$7000亿AI基础设施投入:Big 4(Microsoft、Google、Amazon、Meta)在2026年的AI基础设施总投入预计超过$7000亿,其中推理基础设施占比从2024年的30%上升至2026年的65%。这笔巨额投资正在重塑全球芯片、数据中心和网络设备的产业链。
推理工程师是2026年最热门的新职业:专门负责优化LLM推理效率的工程师,年薪已经达到$25-50万。核心技能包括:CUDA编程、模型量化、KV Cache优化、分布式推理调度。这个岗位的需求增速是传统ML工程师的3倍。
GPU FinOps:新赛道:随着推理成本成为最大开支,"GPU财务运营"(GPU FinOps)成为一个新兴领域。类似于云时代的Cloud FinOps,GPU FinOps专注于优化GPU资源利用率、降低推理成本、提高ROI。
从训练到推理的职业转型路径:视频给出了一个清晰的技能迁移路线图——从模型训练工程师到推理优化工程师需要补充的核心知识领域,包括系统编程、网络优化、硬件架构理解等。
关键技术概念:
GPU FinOps(GPU财务运营):将云财务管理的最佳实践应用于GPU资源的管理和优化。包括:GPU利用率监控、推理成本归因、Spot实例策略、预留容量规划等。2026年,GPU FinOps工具市场规模估计达到$20亿。
观看建议: 适合正在规划职业发展的工程师和技术管理者。视频提供了从宏观产业到个人职业的完整视角。重点推荐25:00-40:00段关于推理工程师技能要求和薪资水平的分析。
理由: SemiAnalysis是AI基础设施分析领域的权威,Wei Zhou对Token经济学和Prompt Caching的深度拆解是目前YouTube上技术深度最高、信息密度最大的内容。55分钟的信息量相当于一篇高质量的白皮书。对任何正在构建或运营AI产品的人来说都是必看。
理由: 用数据驱动的方式系统分析了推理成本的四大优化层,适合需要快速建立全局认知的技术决策者。30分钟的时长控制得当,信息密度和可操作性兼备。
理由: DeepSeek的$560万训练奇迹是2026年AI行业最具标志性的技术事件之一。这个视频不仅解读了技术细节(MoE、FP8),还分析了其对整个AI竞争格局的深远影响。对理解AI行业的未来走向至关重要。
| 优化手段 | 成本降低幅度 | 实施难度 | 适用场景 |
|---|---|---|---|
| Prompt Caching | 80-90%(缓存部分) | 低 | 客服、代码补全、固定工作流 |
| 模型量化(INT4/INT8) | 50-75% | 中 | 推理密集型应用 |
| 模型路由(Model Routing) | 50-70% | 中 | 多任务场景 |
| KV Cache优化 | 30-50% | 高 | 长上下文场景 |
| Speculative Decoding | 2-3倍加速 | 高 | 低延迟要求场景 |
| 自建vs API切换 | 盈亏平衡点约680万token/月 | 高 | 高调用量场景 |
| Agent Token Budget | 60-80% | 中 | AI Agent工作流 |
┌─────────────────────────────────────────────┐
│  2026年AI推理经济学核心数字                       │
├─────────────────────────────────────────────┤
│  推理占总AI计算支出:     >80%                 │
│  LLM推理成本18个月降幅:  ~1000×               │
│  Big 4 AI基础设施投入:    $7000亿              │
│  DeepSeek V3训练成本:     $560万              │
│  GPT-4级模型训练成本:     $1-5亿              │
│  推理工程师年薪:          $25-50万             │
│  Agent成本乘数:           50-100×              │
│  Reasoning Token溢价:     5-10×               │
│  Prompt Caching节省:      80-90%              │
│  自建/API盈亏平衡点:      ~680万token/月       │
└─────────────────────────────────────────────┘
这场从训练到推理的经济学范式转移,正在重塑整个AI产业链。训练成本的数量级突破(如DeepSeek)让顶级模型的门槛大幅降低,但推理成本的指数级增长让运营效率成为新的竞争焦点。未来的AI赢家,不是训练出最强模型的公司,而是用最经济的推理架构服务最多用户的公司。对于通信行业的从业者来说,这场革命意味着:当AI推理成为全球最大的计算负载时,支撑推理的基础设施——数据中心网络、边缘计算节点、高速互联——将成为通信产业最重要的增长引擎。
[!tip] 51学通信知识星球 星主:爱卫生(微信:gprshome201101)——公众号「51学通信」创办者,19 年通信行业运维与讲师经验,著有《GPRS网络信令实例详解》《EPC原理与实践》《5G核心网原理与实践》三本纸质书(各大电商平台有售)。 星球定位:深耕 5G 核心网、IMS、NFV/AI、云原生等 ICT 领域,主打运维岗位与信令分析。 当前规模:5200 篇主题 / 990 个回答,198 元/年。 加入福利:加入星球后请加爱卫生微信,拉您进知识星球年度陪伴与答疑群——不限量回复您的各种问题,另有群内分享。 AI 加持:51学通信知识星球已作为 skill 接入 WorkBuddy,使用 deepseek-4-flash 在海量星球帖子中精准找贴、找视频、找 FAQ 和案例,做总结、找文档和 PPT 等场景全覆盖。
