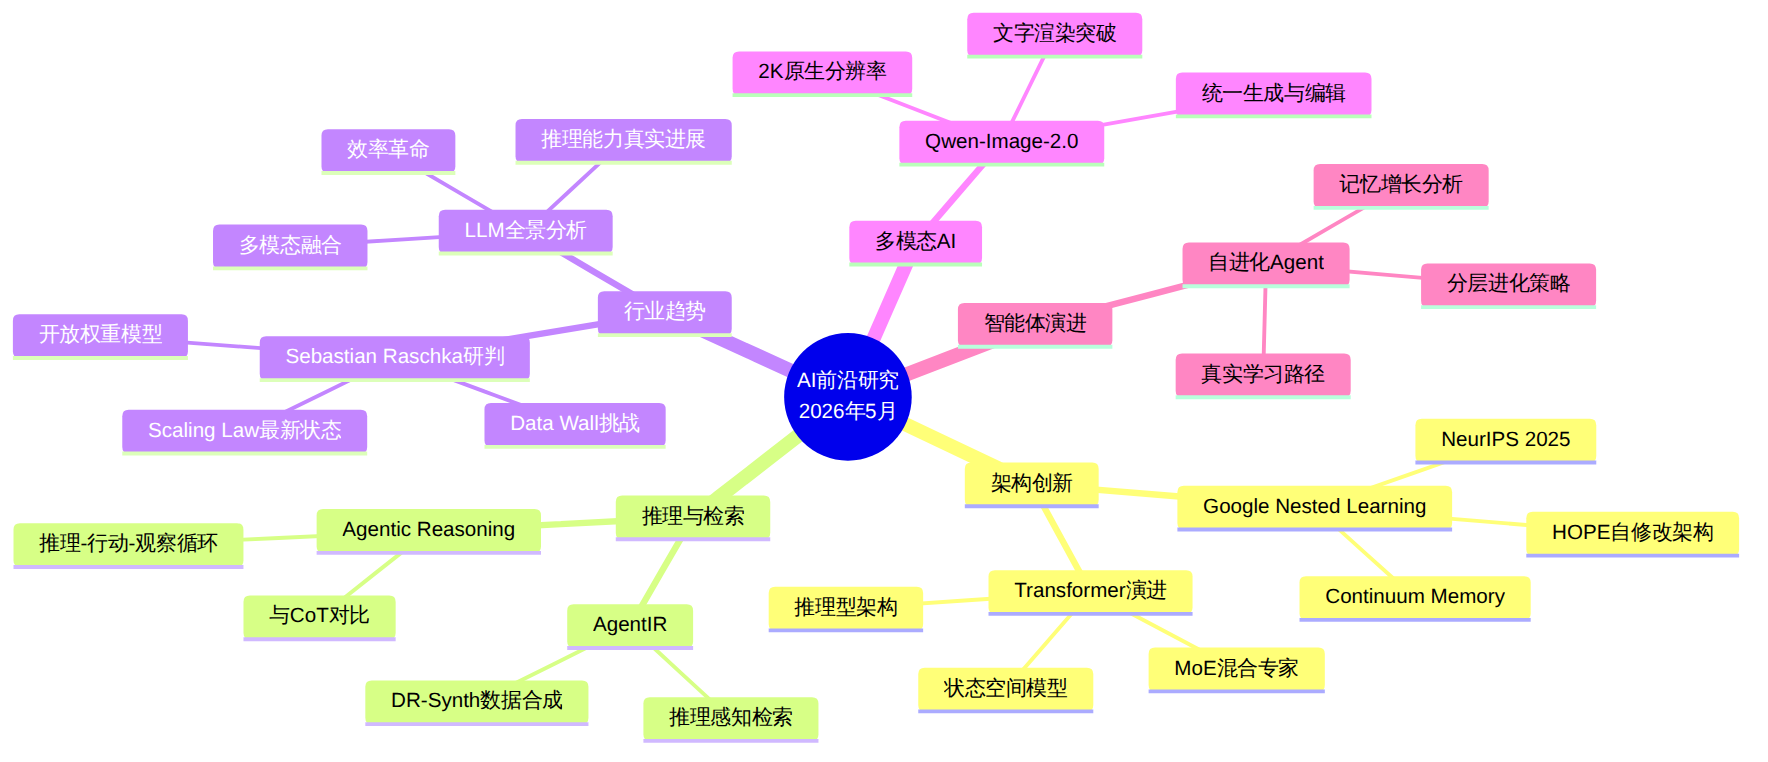
本期精选聚焦2026年5月YouTube上最具深度的AI前沿研究解读视频,涵盖Google Nested Learning自修改架构、AgentIR推理感知检索、LLM推理能力演进、Agentic AI范式转变,以及多模态统一生成模型等五大方向。这些视频来自AI Research Roundup、Sebastian Raschka等高质量学术频道,既有NeurIPS 2025顶会论文的深度拆解,也有对2026年AI趋势的全景式研判。对于通信行业技术人员而言,理解这些底层研究进展有助于把握AI在网络智能化、6G边缘推理等场景中的技术走向。
| 序号 | 视频标题(中/英) | 频道 | 时长 | 推荐指数 |
|---|---|---|---|---|
| 1 | 告别Transformer:首个自修改AI架构"HOPE" / Forget Transformers: Meet "Hope," the First Truly Self-Modifying AI | AI Research Roundup等 | ~15min | ★★★★★ |
| 2 | 2026 AI趋势:开放智能体、推理LLM与更多 / AI Trends 2026: OpenClaw Agents, Reasoning LLMs, and More | 各种频道 | ~90min | ★★★★★ |
| 3 | AgentIR:面向深度研究的推理感知检索 / AgentIR: Reasoning-Aware Retrieval for Deep Research | AI Research Roundup | ~12min | ★★★★☆ |
| 4 | 自进化智能体:记忆增长 vs 真实学习 / Self-Evolving Agents: Memory Growth vs. Real Learning | 独立研究频道 | ~18min | ★★★★☆ |
| 5 | 2026年的LLM:真实与炒作 / LLMs in 2026: What's Real, What's Hype, and What's Coming Next | 多频道联合 | ~60min | ★★★★☆ |
| 6 | LLM的Agent化推理:新框架解读 / Agentic Reasoning: New Framework for LLM Agents | AI Research Roundup | ~14min | ★★★★☆ |
| 7 | Qwen-Image-2.0:统一图像生成与编辑 / Qwen-Image-2.0: Unified Image Generation & Editing | AI Research Roundup | ~11min | ★★★★☆ |
| 8 | Google Nested Learning与HOPE全解 / Nested Learning: Inside Google's New Paradigm | 多频道 | ~13min | ★★★★★ |
Forget Transformers: Meet "Hope," the First Truly Self-Modifying AI
频道介绍:AI Research Roundup是专注于最新arXiv论文解读的频道,从HuggingFace Daily Papers和X(Twitter)热门论文中筛选最具影响力的研究进行讲解,覆盖范围广泛且更新频率高。
核心要点:
Nested Learning(嵌套学习)范式:Google Research在NeurIPS 2025发表的这篇论文提出了全新的机器学习范式。与传统的单一网络层架构不同,Nested Learning引入"层级"(levels)这一额外设计维度,允许模型在不同抽象层级上组织知识。对通信领域的读者来说,可以类比为网络协议栈的分层思想——每一层处理不同粒度的信息。
HOPE架构——自修改神经网络:HOPE(Hierarchical Object-centric Progressive Encoding)是Nested Learning的验证实现。其核心创新在于模型能够在运行时修改自身架构,而非仅仅更新权重参数。这意味着模型可以根据新任务的需求动态增删网络模块,从根本上解决了神经网络"学新忘旧"的灾难性遗忘问题。
Continuum Memory(连续记忆系统):HOPE引入的连续记忆机制允许模型在多个学习阶段之间保持知识的连续性。传统的迁移学习在切换任务时会丢失之前的能力,而Continuum Memory通过在不同层级维护独立的记忆槽来解决这个问题。这一机制对于需要持续部署和迭代的通信网络AI系统具有重要参考价值。
实验验证:论文在持续学习基准测试上展示了显著性能提升,相比传统Transformer架构在多任务序列学习中保持了更高的准确率,且无需在任务切换时进行完整重新训练。
关键技术概念: - Catastrophic Forgetting(灾难性遗忘):神经网络学习新任务时覆盖旧知识的现象,是持续学习的核心挑战 - Self-Modifying Architecture(自修改架构):模型能够在推理或训练过程中动态改变自身结构的网络设计
观看建议:适合对AI架构设计有基础了解的研究者和工程师。推荐先看AI Research Roundup版本获取论文概要,再观看Nested Learning Overview视频(~8分钟)获取Google官方视角。总投入时间约25分钟。
延伸资源:
- Google Research官方博客:research.google/blog/introducing-nested-learning
- 论文来源:NeurIPS 2025
- GitHub:HOPE模型代码已开源
AI Trends 2026: OpenClaw Agents, Reasoning LLMs, and More [Sebastian Raschka]
频道介绍:Sebastian Raschka是独立LLM研究员、《Build a Large Language Model (From Scratch)》作者,前统计学教授,YouTube频道订阅数8.4万。他以深入浅出的方式讲解LLM架构和训练技术,在AI研究社区享有极高声誉。此内容还关联Lex Fridman Podcast的"State of AI 2026"专题,与Nathan Lambert共同讨论。
核心要点:
开放权重模型(Open Weight Models)的崛起:Raschka详细分析了2026年开放权重模型的发展态势。从Llama系列到DeepSeek,开放模型正在缩小与闭源模型的能力差距。OpenClaw(开放持续学习与Agent工作流)概念框架的提出,标志着开放AI生态从"模型开源"迈向"智能体开源"。
推理型LLM的范式转变:2026年最显著的趋势是从"快速响应"转向"深度推理"。以OpenAI o系列为代表的推理模型通过Chain-of-Thought和Test-Time Compute扩展了LLM的能力边界。Raschka从架构层面解释了为什么推理能力需要不同于传统生成的训练策略。
Scaling Law的最新进展:Raschka对LLM缩放定律在2026年的状态进行了冷静评估。数据墙(Data Wall)问题日益严峻——高质量训练数据的供应正在接近极限,这迫使研究界探索更高效的数据利用策略和合成数据方案。
中国AI生态的独特路径:讨论中特别关注了中国AI研究的独特发展路径,DeepSeek等模型在效率和架构创新上展现出的竞争力。
关键技术概念: - Test-Time Compute:在推理阶段投入更多计算资源以获得更高质量输出的策略,是Scaling Law的新维度 - Data Wall(数据墙):高质量训练数据供应接近极限的现象,被认为是LLM发展的重要瓶颈
观看建议:强烈推荐对AI行业趋势感兴趣的观众观看完整访谈。Lex Fridman版本(约2.5小时)最为全面,如果时间有限,可只看Sebastian Raschka部分(约45分钟)。适合需要了解AI发展全局的技术决策者。
延伸资源:
- Sebastian Raschka博客:sebastianraschka.com/blog/2026/state-of-ai-interview.html
- Lex Fridman Podcast转录:lexfridman.com/ai-sota-2026-transcript
- 书籍:《Build a Large Language Model (From Scratch)》
AgentIR: Reasoning-Aware Retrieval for Deep Research Agents
频道介绍:同前述AI Research Roundup。
核心要点:
推理感知检索(Reasoning-Aware Retrieval)新范式:AgentIR论文提出了专为Deep Research Agent设计的检索范式。传统检索系统(如RAG中的检索器)只处理查询文本,而AgentIR首次利用智能体的推理轨迹(reasoning traces)作为检索信号。简单说,就是检索器能"读懂"AI Agent在思考什么,从而提供更精准的信息。
DR-Synth合成数据框架:论文引入DR-Synth(Deep Research Synthesis)框架,用于生成高质量的训练数据。通过模拟Deep Research Agent的推理过程,自动产生"推理-检索"配对数据,解决了现实中缺乏此类标注数据的问题。
在Deep Research任务上的显著提升:AgentIR-4B模型(基于4B参数规模)在多个Deep Research基准测试上超越了传统检索器和通用嵌入模型。这对于构建高质量的研究辅助AI系统具有直接价值。
开源与可用性:AgentIR模型已在HuggingFace开源(Tevatron/AgentIR-4B),研究者和开发者可以直接使用。
关键技术概念: - Deep Research Agent:能够自主进行多轮信息检索、分析、综合的AI智能体,是2026年AI应用的重要方向 - Reasoning Trace(推理轨迹):AI模型在推理过程中产生的中间思考步骤,类似于人类思考时的草稿
观看建议:适合对RAG、信息检索和AI Agent技术感兴趣的工程师。视频约12分钟,信息密度高,建议配合arxiv.org/abs/2603.04384论文阅读。对于通信领域,这种"推理感知"的思路可应用于网络故障诊断场景——让检索系统理解网管系统的推理过程。
延伸资源:
- 论文:arxiv.org/abs/2603.04384
- GitHub:github.com/texttron/AgentIR
- HuggingFace模型:huggingface.co/Tevatron/AgentIR-4B
Self-Evolving Agents: Memory Growth vs. Real Learning
核心要点:
对"自进化"的冷静审视:视频尖锐地指出,当前市场上大多数标榜"自进化"(self-evolving)的AI Agent系统实际上并没有在运行时更新模型权重。它们通过扩展记忆库(vector database扩容)、增加工具描述、优化Prompt模板来实现"看起来在学习"的效果,但这与真正的模型能力提升有本质区别。
记忆增长的真实代价:随着Agent经验积累,记忆库持续膨胀导致三个问题:检索精度下降(找到相关记忆越来越难)、延迟增加、存储成本线性增长。视频用实验数据展示了当记忆条目从1000增长到100000时,系统性能的非线性退化曲线。
真实学习路径分析:视频讨论了几种实现"真实自进化"的技术路线:在线学习(online learning)更新部分权重、LoRA微调适配、以及基于反馈的强化学习。每条路线都有其计算成本和工程复杂度的权衡。
实用建议:对于工程团队,视频建议采用"分层进化"策略——短期靠记忆和Prompt优化,中期靠定期LoRA微调,长期靠完整模型重训练。这种渐进式策略在成本和效果之间取得平衡。
关键技术概念: - Self-Evolving Agent:能在部署后持续提升能力的AI智能体,是2026年的热门研究方向 - Online Learning(在线学习):模型在不中断服务的情况下持续从新数据中学习的技术
观看建议:适合正在构建AI Agent系统的工程师和架构师。视频的批判性视角对避免技术选型陷阱特别有价值。推荐完整观看(18分钟)。
延伸资源: - 相关论文方向: continual learning for agents, memory-augmented neural networks
LLMs in 2026: What's Real, What's Hype, and What's Coming Next
核心要点:
推理能力的真实进展:视频系统梳理了LLM推理能力在2026年的真实进展。通过严格的基准测试对比,展示了推理型模型(如o系列、DeepSeek-R1等)在数学、编程、科学推理上的可量化提升,同时也指出了一些被夸大的能力声称。
架构创新图谱:从标准Transformer到MoE(混合专家)、到Nested Learning、到状态空间模型(SSM),视频绘制了LLM架构演进的完整图谱,清晰标注了每种架构的适用场景和局限性。
多模态融合现状:2026年LLM的多模态能力已从"能看图片"进化到"能理解视频流",视频对主流多模态方案(原生多模态 vs 拼接式多模态)进行了详细对比。
效率革命:量化、蒸馏、稀疏化——LLM推理效率在2026年取得了显著进步。4-bit量化几乎不损失性能,使得LLM在边缘设备上的部署更加可行,这对于通信行业的边缘AI推理场景意义重大。
前沿方向预判:视频最后讨论了几个可能塑造2027年的研究方向:神经符号融合、因果推理能力、以及AI系统的自主工具创造。
关键技术概念: - MoE(Mixture of Experts):混合专家架构,通过路由机制只激活部分网络参数,在保持模型容量的同时降低推理成本 - Quantization(量化):将模型权重从高精度(如FP16)压缩到低精度(如INT4),降低推理成本
观看建议:适合需要全面了解LLM发展现状的技术管理者。推荐作为"月度学习"内容,完整观看约60分钟。可跳过熟悉的基础概念部分。
Agentic Reasoning: New Framework for LLM Agents
核心要点:
从生成式推理到Agent式推理:论文系统化了LLM推理能力的范式转变。传统LLM推理是"思考然后输出",而Agentic Reasoning是"思考-行动-观察-再思考"的循环。这种范式将推理从闭式过程变为开放式交互过程。
推理-行动-观察三元组:核心框架将Agent推理分解为三个基本操作的迭代循环:Reasoning(推理分析当前状态)、Action(执行工具调用或环境交互)、Observation(处理执行结果并更新认知)。
与传统CoT的对比:Chain-of-Thought在静态文本空间内展开推理,而Agentic Reasoning在动态环境中展开推理,能够利用外部工具和实时信息。视频用具体案例展示了两者在解决复杂问题时策略的根本差异。
训练方法论:论文讨论了如何训练LLM获得Agentic Reasoning能力,包括监督微调数据的设计、强化学习奖励函数的构建,以及推理轨迹的数据增强策略。
关键技术概念: - Agentic Reasoning(智能体推理):LLM通过与外部环境交互来增强推理能力的范式 - CoT(Chain-of-Thought):让LLM通过中间推理步骤解决复杂问题的技术,是当前推理增强的基础方法
观看建议:适合对AI Agent架构设计有浓厚兴趣的研究工程师。14分钟视频信息密集,建议结合论文(2026年1月Survey版本)反复学习。对通信网络智能化中涉及自主故障排查、自优化网络(SON)的场景有参考价值。
Qwen-Image-2.0: Unified Image Generation & Editing
核心要点:
统一生成与编辑:阿里巴巴Qwen团队发布的Qwen-Image-2.0是一个70亿参数的统一图像基础模型,能够同时处理图像生成和图像编辑任务。传统方案通常将生成和编辑视为独立任务,Qwen-Image-2.0通过统一架构将两者融合。
原生2K分辨率支持:模型支持原生2K分辨率图像生成,在信息图、海报、幻灯片等设计场景表现出色。这对于通信行业制作技术演示材料、网络拓扑图可视化等有直接应用价值。
精准文字渲染:Qwen-Image-2.0在图像中的文字渲染准确率显著提升,解决了AI图像生成中长期存在的"乱码文字"问题。
开源与生态:模型已在HuggingFace开源,支持vLLM推理框架,提供了完整的使用指南和编辑管线(Qwen-Image-Edit)。
关键技术概念: - Unified Image Model(统一图像模型):单一模型同时处理多种图像任务的架构设计 - Image Editing Pipeline(图像编辑管线):支持指令驱动的图像修改流程,如"将背景改为蓝色"
观看建议:适合关注多模态AI和图像生成技术的工程师。11分钟快速概览,建议配合Qwen官方博客和HuggingFace模型页深入实践。
延伸资源:
- Qwen官方博客:qwen.ai/blog?id=qwen-image-2.0
- HuggingFace:huggingface.co/Qwen/Qwen-Image-Edit
- vLLM使用指南:docs.vllm.ai/projects/recipes/en/latest/Qwen/Qwen-Image.html
Nested Learning Explained: Why AI Forgets & How Google's HOPE Fixes It
核心要点:
灾难性遗忘问题的深度剖析:视频从神经科学和认知科学角度解释了为什么神经网络会"遗忘"——人类大脑通过神经可塑性和记忆巩固机制避免遗忘,而传统神经网络缺乏类似机制。
HOPE模型的架构设计:详细拆解了HOPE(Hierarchical Object-centric Progressive Encoding)的三层架构——底层处理感知特征、中层维护对象级表征、高层管理抽象概念。每一层都有独立的记忆管理和更新策略。
Simple Rule Experiment:视频展示了论文中最直观的实验——Simple Rule(简单规则)测试。模型首先学习一组简单规则,然后逐步引入新规则。HOPE在学习新规则的同时完美保持了旧规则的性能,而传统模型出现显著退化。
与持续学习方法的对比:视频将HOPE与EWC(Elastic Weight Consolidation)、PackNet、Progressive Networks等传统持续学习方法进行对比,清晰展示了Nested Learning范式的优势所在。
观看建议:这是HOPE/Nested Learning最佳的入门视频,讲解清晰且不假设高深的前置知识。推荐作为第一个观看的Nested Learning视频(13分钟),之后再观看AI Research Roundup的版本获取更多技术细节。
图表 1
推荐理由:Sebastian Raschka作为独立LLM研究者的权威性无可置疑,他对开放权重模型、推理LLM和Scaling Law的分析既有技术深度又有行业广度。这是了解2026年AI研究方向全景的最佳单一视频来源。Lex Fridman的三人对话版本更是不可多得的高质量学术讨论。
时间投入建议:至少观看Raschka部分(45分钟),完整版(90-150分钟)适合周末深度学习。
推荐理由:NeurIPS 2025最具突破性的架构创新之一。自修改神经网络从根本上重新定义了模型持续学习的方式。建议同时观看TechieTalksAI版本(入门友好)和AI Research Roundup版本(技术细节丰富),形成完整理解。
时间投入建议:两个视频共约28分钟,加上阅读Google Research博客约1小时。
推荐理由:AgentIR代表了信息检索与AI推理融合的前沿方向。对于任何构建RAG系统或Deep Research Agent的团队,理解"推理感知检索"这一新范式至关重要。论文已开源,模型可直接使用,是本期最具工程落地价值的视频。
时间投入建议:视频12分钟 + 论文精读约1小时 + HuggingFace模型实验约2小时。
[!tip] 51学通信知识星球 星主:爱卫生(微信:gprshome201101)——公众号「51学通信」创办者,19 年通信行业运维与讲师经验,著有《GPRS网络信令实例详解》《EPC原理与实践》《5G核心网原理与实践》三本纸质书(各大电商平台有售)。 星球定位:深耕 5G 核心网、IMS、NFV/AI、云原生等 ICT 领域,主打运维岗位与信令分析。 当前规模:5200 篇主题 / 990 个回答,198 元/年。 加入福利:加入星球后请加爱卫生微信,拉您进知识星球年度陪伴与答疑群——不限量回复您的各种问题,另有群内分享。 AI 加持:51学通信知识星球已作为 skill 接入 WorkBuddy,使用 deepseek-4-flash 在海量星球帖子中精准找贴、找视频、找 FAQ 和案例,做总结、找文档和 PPT 等场景全覆盖。
