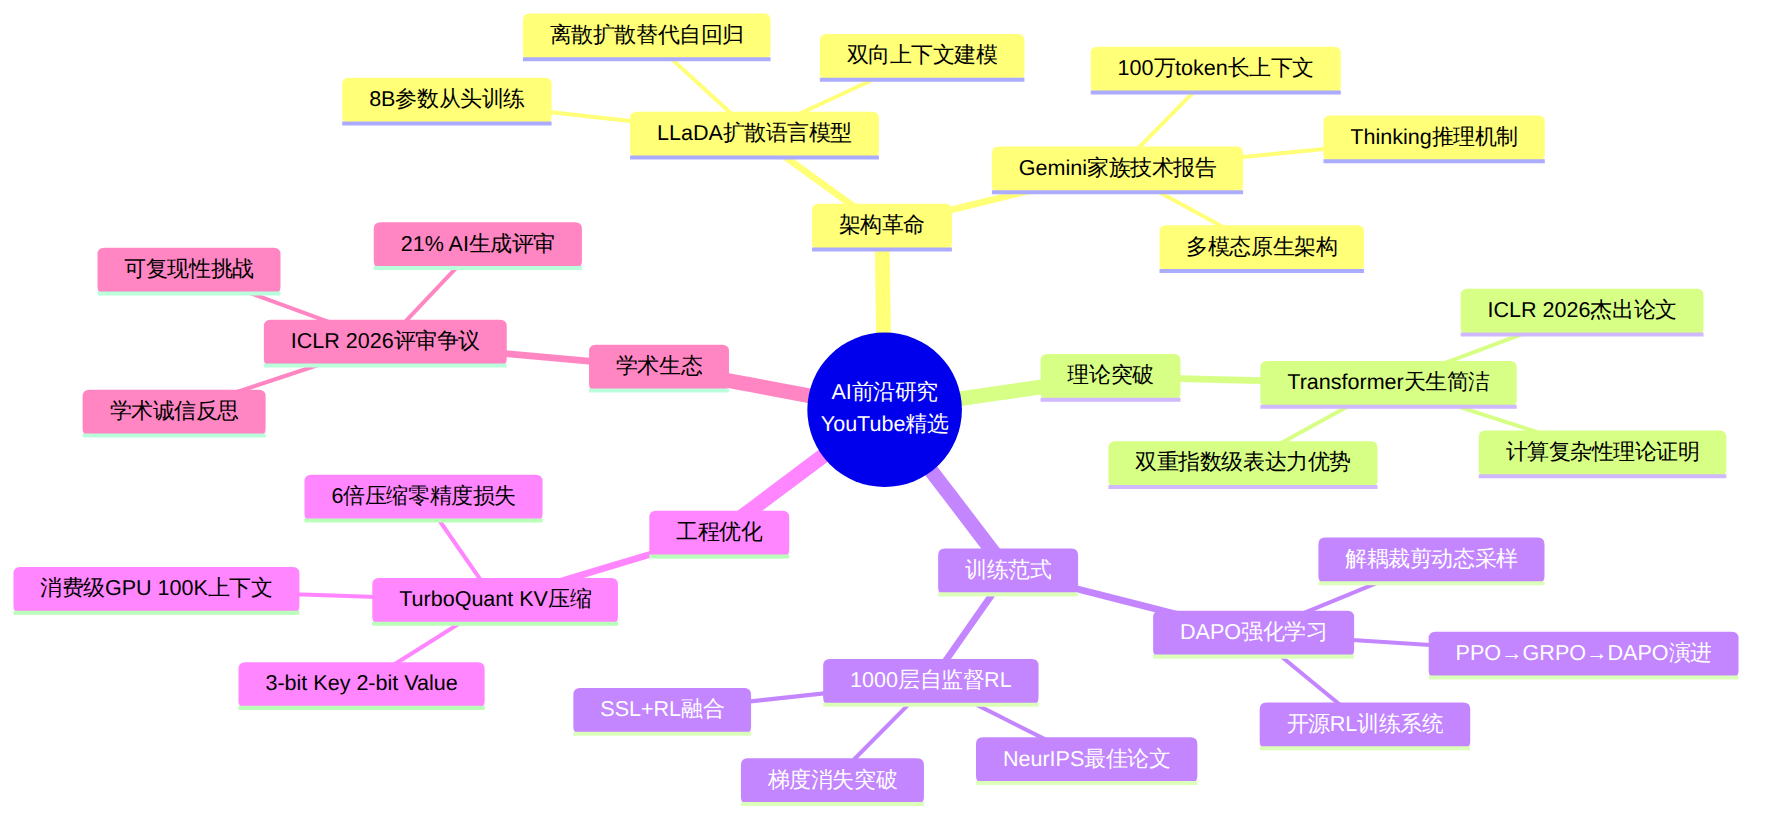
2026年AI研究正经历多重范式变革:扩散模型不再局限于图像生成,开始挑战自回归语言模型的垄断地位;ICLR 2026在巴西里约热内卢以19,525篇投稿、5,355篇录用的创纪录规模收官,Transformer理论的数学基础取得突破性进展;后训练技术从RLHF全面转向GRPO/DAPO/RLVR等新型强化学习范式;Google TurboQuant让消费级GPU跑100K上下文成为现实。本期精选8个前沿研究解读视频,覆盖架构革命、训练范式、推理优化、学术会议四大维度,为通信行业技术人员构建AI前沿研究的认知地图。
| # | 视频标题(中/英) | 频道 | 时长 | 推荐指数 |
|---|---|---|---|---|
| 1 | 大语言扩散模型:扩散LLM的新纪元 / Large Language Diffusion Models | AI Bites | ~10分钟 | ★★★★★ |
| 2 | ICLR 2026杰出论文:Transformer天生简洁 / Transformers are Inherently Succinct | Vinh Nguyen | ~15分钟 | ★★★★★ |
| 3 | TurboQuant详解:Google如何将AI记忆压缩6倍 / TurboQuant Explained | 多频道 | ~12分钟 | ★★★★☆ |
| 4 | GRPO 2.0?DAPO LLM强化学习深度解读 / DAPO LLM RL Explained | AI Papers Academy | ~20分钟 | ★★★★★ |
| 5 | Google赢了竞赛:Gemini家族技术报告全解析 / Gemini Family Explained | 技术深潜频道 | ~45分钟 | ★★★★☆ |
| 6 | NeurIPS最佳论文:1000层自监督强化学习网络 / 1000 Layer Networks for RL | 论文解读频道 | ~25分钟 | ★★★★☆ |
| 7 | 闯入前沿AI研究2026 / Break Into Frontier AI Research 2026 | 职业发展频道 | ~30分钟 | ★★★★☆ |
| 8 | KCHL:ICLR评审决策、ICML实验与NeurIPS幻觉 / ICLR/ICML/NeurIPS回顾 | KCHL | ~60分钟 | ★★★★☆ |
视频标题: LLaDA - Large Language Diffusion Models (Paper Explained) 频道: AI Bites | 订阅数 ~15K 时长: ~10分钟 | 发布: 2025-2026
核心要点:
颠覆自回归范式:LLaDA提出用离散扩散模型(Discrete Diffusion)替代传统自回归(Autoregressive)方式进行语言生成。传统GPT类模型从左到右逐token生成,而LLaDA从完全被遮蔽(masked)的序列出发,通过迭代去噪(denoising)逐步恢复完整文本。这意味着模型可以同时关注全局上下文,而非仅依赖历史token。
8B参数从头训练:LLaDA以80亿参数规模从头训练(非微调),在多项基准测试上达到与同级别自回归模型相当的性能。训练目标是对模型分布的负对数似然的上界(upper bound),理论框架严谨。
双向上下文建模优势:自回归模型天然只能利用单向上下文(已生成token),LLaDA的扩散去噪过程允许每个位置同时考虑左右两侧信息,这对需要全局理解的文本生成任务(如摘要、翻译)具有潜在优势。
推理加速潜力:扩散模型天然支持并行解码(parallel decoding),可以在更少的推理步数内生成完整序列。Mercury Coder等商业产品已验证这一路线的推理速度优势——批量token同时生成而非逐个输出。
关键技术概念解释:
自回归模型(Autoregressive Model):每次只预测下一个token的语言模型。就像说话时一个字一个字蹦出来。GPT系列、Claude、Gemini均属此类。
扩散模型(Diffusion Model):灵感来自物理学中的热力学扩散过程。先给数据"加噪"(逐渐破坏结构),然后学习如何从噪声中"恢复"原始数据。在图像生成(如Stable Diffusion、DALL-E)中已获巨大成功。
离散扩散(Discrete Diffusion):与传统扩散模型处理连续数据(像素值)不同,文本是离散的符号(token)。LLaDA将扩散过程适配到离散空间,通过对token序列施加遮蔽(masking)和恢复操作实现。
观看建议:适合所有对AI架构演进感兴趣的观众。10分钟时长信息密度极高,建议0.75倍速观看并做笔记。如果你是NLP从业者,这个视频代表了可能颠覆现有范式的方向。
延伸资源: - 论文:arxiv.org/abs/2502.09992 - GitHub:github.com/ML-GSAI/LLaDA - 补充阅读:LLaDA 2.0-Uni(arxiv.org/abs/2604.20796)已扩展到多模态理解
视频标题: ICLR 2026 Outstanding Papers: Transformers are Succinct 频道: Vinh Nguyen | 订阅数 ~853 时长: ~15分钟 | 发布: 2026年4月
核心要点:
简洁性(Succinctness)作为表达力度量:来自苏黎世联邦理工(ETH Zurich)的团队提出了用"简洁性"来衡量Transformer的表达能力——即描述一个概念/函数需要多短的程序。论文从计算复杂性理论角度证明,Transformer在描述复杂函数时比RNN和有限状态自动机(Finite Automata)更加紧凑。
双重指数级优势:论文给出了严格的数学证明——Transformer可以比有限自动机双重指数级(doubly exponentially)更简洁地表示某些函数类别。这意味着对于某些任务,Transformer只需要极短的序列就能"编码"自动机需要天文数字状态才能表示的模式。
架构优势的理论根基:这项工作为"Transformer为什么这么强"提供了新的理论解释——不仅仅是注意力机制带来的长距离依赖建模能力,更是Transformer架构本身在信息压缩方面具有内在优势。
ICLR 2026最高荣誉:从19,525篇投稿中脱颖而出获得Outstanding Paper奖,代表了学术界对Transformer理论基础的认可。
关键技术概念解释:
简洁性(Succinctness):来自理论计算机科学的概念。如果模型A用100个参数就能表示模型B需要10000个参数才能表示的函数,那么模型A更"简洁"。这类似于数据压缩——更短的程序描述等价于更强的表达能力。
双重指数级(Doubly Exponential):即 2^(2^n) 量级的增长。这意味着差距随问题规模急剧扩大——n=10时,差距可达2^1024,一个远超宇宙原子数量的数字。
有限状态自动机(Finite Automata):最经典的计算模型之一,由有限个状态和状态转移规则组成。RNN在理论上等价于有限状态自动机。
观看建议:适合有算法和计算理论基础的技术人员。视频用可视化方式降低了理论门槛。对于通信行业读者,可以将此理解为——Transformer架构在"信道编码"效率上具有理论上的根本优势。
延伸资源: - 论文:arxiv.org/abs/2510.19315 - ICLR 2026官方公告:blog.iclr.cc/2026/04/23/announcing-the-iclr-2026-outstanding-papers - 中文解读视频:Transformer 太強了,連數學家都驗證不了
视频标题: TurboQuant Explained in Plain English - How Google Shrunk AI Memory by 6x 频道: 多频道覆盖 | 时长: ~12分钟 | 发布: 2026年3月
核心要点:
KV缓存是推理的内存瓶颈:大语言模型推理时需要缓存注意力机制中的Key-Value矩阵(KV Cache),随着上下文长度线性增长。100K上下文的KV缓存可能占用数十GB显存,这是消费级GPU无法承受的。TurboQuant直击这一痛点。
3-bit Key + 2-bit Value量化:TurboQuant将KV缓存从FP16(16位浮点)压缩到Key仅3位、Value仅2位,实现约6倍压缩。关键是——精度损失几乎为零。这不是简单的截断,而是基于对KV矩阵分布特性的深入分析设计的专用量化方案。
无需重训练:与模型量化(如INT8/INT4权重量化)不同,TurboQuant是纯推理时的KV缓存压缩,不需要修改模型权重或重新训练。这意味着可以直接应用于GPT-4、Llama等现有模型。
消费级GPU的100K上下文:TurboQuant让RTX 3090(24GB显存)能够运行100K上下文,RTX 4070(12GB)支持64K上下文。这对边缘部署和成本优化意义重大。
关键技术概念解释:
KV缓存(KV Cache):Transformer推理时的缓存机制。生成第N个token时,需要计算它与前面N-1个token的注意力。为了避免重复计算,模型会将前面所有token的Key和Value矩阵缓存下来。上下文越长,KV缓存越大。
量化(Quantization):将高精度数值表示压缩为低精度。例如FP16→INT4就是将16位浮点压缩为4位整数。挑战在于如何在不损失精度的前提下实现。
ICLR 2026收录:TurboQuant作为Google Research的工作被ICLR 2026接收,提供了三种互补的压缩算法。
观看建议:所有关注LLM推理优化、边缘部署的技术人员必看。12分钟时长完美适配午休时间。对于通信行业读者,可以将此类比为信号处理中的高效信源编码。
延伸资源: - Google Research博客:research.google/blog/turboquant - 实用指南:huggingface.co/spaces/ai-engineering-at/llama-cpp-turboquant-guide - GitHub:github.com/0xSero/turboquant
视频标题: GRPO 2.0? DAPO LLM Reinforcement Learning Explained 频道: AI Papers Academy | 订阅数 ~15K 时长: ~20分钟 | 发布: 2025-2026
核心要点:
后训练技术栈的代际更替:2026年的主流后训练pipeline已经从传统的"RLHF"转向三阶段方案:监督微调(SFT)→ GRPO/DAPO强化学习 → RLVR工具使用强化。DAPO代表了这一趋势的最新进展。
解耦裁剪与动态采样:DAPO全称"Decoupled Clip and Dynamic Sampling Policy Optimization",其核心创新是将策略裁剪(clip)与奖励信号解耦,同时引入动态采样策略来提升训练稳定性。相比GRPO,DAPO在大规模训练中表现出更好的收敛性。
开源强化学习系统:DAPO提供了完全开源的LLM强化学习训练系统,支持从零开始复现推理模型的强化学习训练过程。这降低了进入推理模型研发的门槛。
从PPO到GRPO到DAPO的演进脉络:PPO(Proximal Policy Optimization)→ GRPO(Group Relative Policy Optimization,DeepSeek提出)→ DAPO,每一代都在简化训练流程的同时提升效果。GRPO去除了Critic网络,DAPO进一步优化了采样策略。
关键技术概念解释:
RLHF(Reinforcement Learning from Human Feedback):让人类对模型输出打分,训练奖励模型,再用强化学习优化大模型。ChatGPT的核心训练技术之一。
GRPO(Group Relative Policy Optimization):DeepSeek提出的替代PPO的方案。核心思想是——不需要单独训练Critic(价值网络),而是在一组采样输出中用相对排名来估计优势函数。大大简化了训练。
DAPO(Decoupled Clip and Dynamic Sampling PO):进一步优化——将PPO中的裁剪机制(防止策略变化过大)解耦为独立模块,并根据训练状态动态调整采样策略。
RLVR(RL from Verifiable Rewards):用可验证的奖励(如数学题的正确答案、代码的测试结果)替代人类偏好,实现自动化的强化学习训练。
观看建议:适合有机器学习基础、想理解推理模型训练全流程的观众。建议先了解基本的强化学习概念(策略梯度、PPO)。20分钟时长覆盖了完整的技术演进脉络。
延伸资源: - 后训练技术综述:llm-stats.com/blog/research/post-training-techniques-2026 - DAPO论文与代码:可通过AI Papers Academy频道描述获取 - 补充视频:GRPO's new variants (GSPO)
视频标题: Google WON The Race: The Gemini Family Explained - Depth Technical Deep Dive 频道: 技术教程频道 时长: ~45分钟 | 发布: 2025-2026
核心要点:
Gemini 2.X家族全景图:视频基于Google官方技术报告,系统拆解了Gemini 2.5 Pro、2.5 Flash以及更早版本的架构设计。报告公开了模型规模、训练数据构成、多模态融合方式等关键信息。
推理能力的工程实现:Gemini 2.5系列引入了"thinking"能力——在生成最终回答前进行内部推理链计算。视频详细解释了这一机制如何通过改进的训练策略(推测包含类似GRPO的强化学习阶段)和推理时的compute scaling实现。
原生多模态架构:与"拼接式"多模态(图像编码器+语言模型拼接)不同,Gemini从设计之初就是多模态原生架构——文本、图像、音频、视频共享同一套Transformer参数。视频解析了这种设计的优势与权衡。
长上下文技术栈:Gemini 2.5 Pro支持100万token上下文窗口,视频分析了Google实现这一目标的技术路径:高效的注意力变体、分块KV缓存管理、以及可能的稀疏注意力机制。
关键技术概念解释:
技术报告(Technical Report):AI公司发布模型时配套的详细文档,包含模型架构、训练方法、评估结果等。类似于通信领域的设备技术白皮书。Google的Gemini技术报告是最透明的之一。
Thinking模型:在输出前先进行内部"思考"(生成隐藏的推理token),然后再给出最终答案。类似于人类"先想清楚再说"。OpenAI o系列、DeepSeek-R1均采用此模式。
多模态原生架构(Native Multimodal):用一个统一的模型同时处理文本、图像、音频等多种输入。对比方案是分别训练多个专家模型然后拼接。
观看建议:45分钟的长视频,适合周末深度学习。推荐先快速浏览Gemini 2.5技术报告的摘要部分再看视频,效果更佳。对通信行业读者而言,Google在模型规模化部署方面的工程实践值得参考。
延伸资源: - Gemini 2.5技术报告:arxiv.org/abs/2507.06261 - Google DeepMind官方博客:blog.google/innovation-and-ai/models-and-research - 补充视频:Gemini 2.5 Pro深度评测
视频标题: [NeurIPS Best Paper] 1000 Layer Networks for Self-Supervised RL 频道: 论文解读频道 时长: ~25分钟 | 发布: 2025-2026
核心要点:
从本科研讨课到最佳论文:这篇论文的起源故事本身就是激励——从普林斯顿大学本科生研究研讨会开始,最终赢得NeurIPS最佳论文奖。Kevin(作者)通过系统性的实验发现了一个反直觉的结论。
1000层网络训练的关键突破:深度网络训练中长期存在"梯度消失"问题——网络越深,反向传播的信号越弱。这篇论文在强化学习场景下证明,通过特定的架构设计和训练策略,可以稳定训练1000层以上的网络,并且更深意味着更好的表征学习。
自监督学习与强化学习的结合:论文将自监督学习(Self-Supervised Learning,SSL)的表征学习能力引入强化学习,让智能体在没有外部奖励信号的情况下也能学到有用的世界表征。这解决了RL中长期存在的"样本效率低"问题。
深层网络与表征质量的正向关系:实验表明,网络深度从标准的几十层增加到1000层,学习到的表征质量持续提升,并且这种提升直接转化为下游RL任务中更高的奖励。
关键技术概念解释:
梯度消失(Vanishing Gradients):深度学习训练时,误差信号通过反向传播从输出层传到输入层。每经过一层,信号可能被缩小一点。1000层后,信号可能几乎消失为零,导致底层参数无法有效更新。
自监督学习(SSL):不需要人工标注的学习方法。模型从数据本身构造训练信号(例如遮蔽部分输入让模型预测)。在NLP(BERT)和CV(MAE)中已非常成功。
表征学习(Representation Learning):让模型自动学习数据的有用特征表示,而非依赖人工特征工程。越好的表征→越高效的下游学习。
观看建议:适合关注深度学习基础研究和RL应用的技术人员。25分钟的论文解读涵盖了背景知识,即使不熟悉RL也能跟上核心思路。
延伸资源: - NeurIPS 2025最佳论文集:通过NeurIPS官网获取 - 相关方向:Latent Particle World Models(ICLR 2026 Oral)延续了这个研究方向
视频标题: Break Into Frontier AI Research in 2026 频道: 职业发展/ML频道 时长: ~30分钟 | 发布: 2026年
核心要点:
软件工程师转AI研究的路径规划:视频针对有编程背景但数学基础薄弱的工程师,提供了从软件工程转向ML研究的系统性路线图。强调不需要先拿一个ML博士学位才能做研究。
数学基础的高效补课策略:不是从教科书第一页开始啃,而是基于项目驱动的方式——遇到需要用到的数学概念(线性代数、概率论、优化理论)时再针对性学习。推荐了与AI直接相关的数学资源。
自学研究的实践框架:如何阅读论文(先读摘要和结论→看图表→细读方法)、如何复现论文实验、如何找到研究问题。特别强调了"论文复现"作为学习核心手段的价值。
2026年前沿研究方向:视频梳理了当前最活跃的研究领域——推理模型(Reasoning Models)、扩散LLM、AI Agent、世界模型等,帮助转型者选择聚焦方向。
关键技术概念解释:
前沿AI研究(Frontier AI Research):指推动AI能力边界的原创性研究,区别于应用AI(将现有模型应用于具体场景)。涉及新架构设计、训练范式创新、理论分析等。
论文复现(Paper Reproduction):根据论文描述重新实现其算法和实验。这是检验理解深度和培养研究能力的最佳方式。
观看建议:强烈推荐给有意转向AI研究方向的通信行业工程师。30分钟的视频提供了可操作的转型路径,后续可根据推荐方向深入探索。
延伸资源: - Andrej Karpathy博客:karpathy.ai - Karpathy Sequoia Ascent 2026对谈:karpathy.bearblog.dev/sequoia-ascent-2026 - Stanford CS25课程录像:web.stanford.edu/class/cs25/recordings
视频标题: KCHL - ICLR decisions, ICML experiments, NeurIPS hallucinations 频道: KCHL 时长: ~60分钟 | 发布: 2026年4月
核心要点:
ICLR 2026的评审争议:ICLR 2026在巴西里约举办,收到19,525篇投稿,录用5,355篇。视频讨论了一个引发热议的现象——约21%的同行评审(peer review)被发现完全由AI生成。Nature也对此进行了报道,引发了对AI时代学术评审机制的深刻反思。
ICML实验的可复现性挑战:讨论了机器学习实验中常见的"选择性报告"问题——研究者可能只报告最好的随机种子结果,而非完整的统计分布。这对论文的可复现性(Reproducibility)构成了严重挑战。
NeurIPS评审中的"幻觉":评审者有时会给出与论文内容不符的评论——引用论文中不存在的实验、批评不存在的方法。这种"评审幻觉"(Review Hallucination)在AI生成评审增多的背景下变得更加普遍。
学术生态的系统性观察:KCHL频道以顶会Time-of-Time Award预测和评审分析著称,提供了学术界少有的系统性元分析(meta-analysis)视角。这期视频对ICLR 2026 Test of Time Award的预测也值得关注。
关键技术概念解释:
同行评审(Peer Review):学术论文发表前由同领域专家匿名评审的制度。AI领域顶会(NeurIPS/ICML/ICLR)的审稿量巨大,2026年每篇论文通常需要3-4位评审者。
AI生成评审:研究者使用LLM辅助甚至自动生成论文评审。这引发了严重争议——AI可能无法真正理解论文贡献,且评审质量无法保证。
Time-of-Time Award:授予10年前发表但对当前仍有重大影响的论文。是学术界最高荣誉之一。
观看建议:适合对学术生态和AI研究趋势感兴趣的所有人。这不仅是技术讨论,更是对AI时代的学术诚信、评审机制的深度反思。推荐在了解ICLR 2026论文之后再观看,作为"元视角"的补充。
延伸资源: - Nature报道:AI conference flooded with AI-generated reviews - ICLR 2026预测视频:KCHL - predictions for ICLR 2026 test of time awards - ICLR 2026 Outstanding Papers完整列表:blog.iclr.cc
图表 1
理由:如果扩散模型路线被验证成功,它将从根本上改变语言模型的架构方向——就像当年Transformer取代LSTM一样。这是目前AI研究中最具"范式转换"潜力的方向之一。10分钟的紧凑时长让它成为性价比最高的入门视频。
理由:为Transformer的成功提供了全新的理论解释。对于工程师而言,理解"为什么Transformer这么强"的数学本质,有助于在实际应用中做出更好的架构选择。ICLR 2026最高荣誉背书,权威性毋庸置疑。
理由:后训练技术是2026年AI领域最活跃的方向之一。从ChatGPT的RLHF到DeepSeek-R1的GRPO,再到DAPO,理解这一演进脉络是把握推理模型发展趋势的必修课。20分钟的视频覆盖了完整的技术栈变迁。
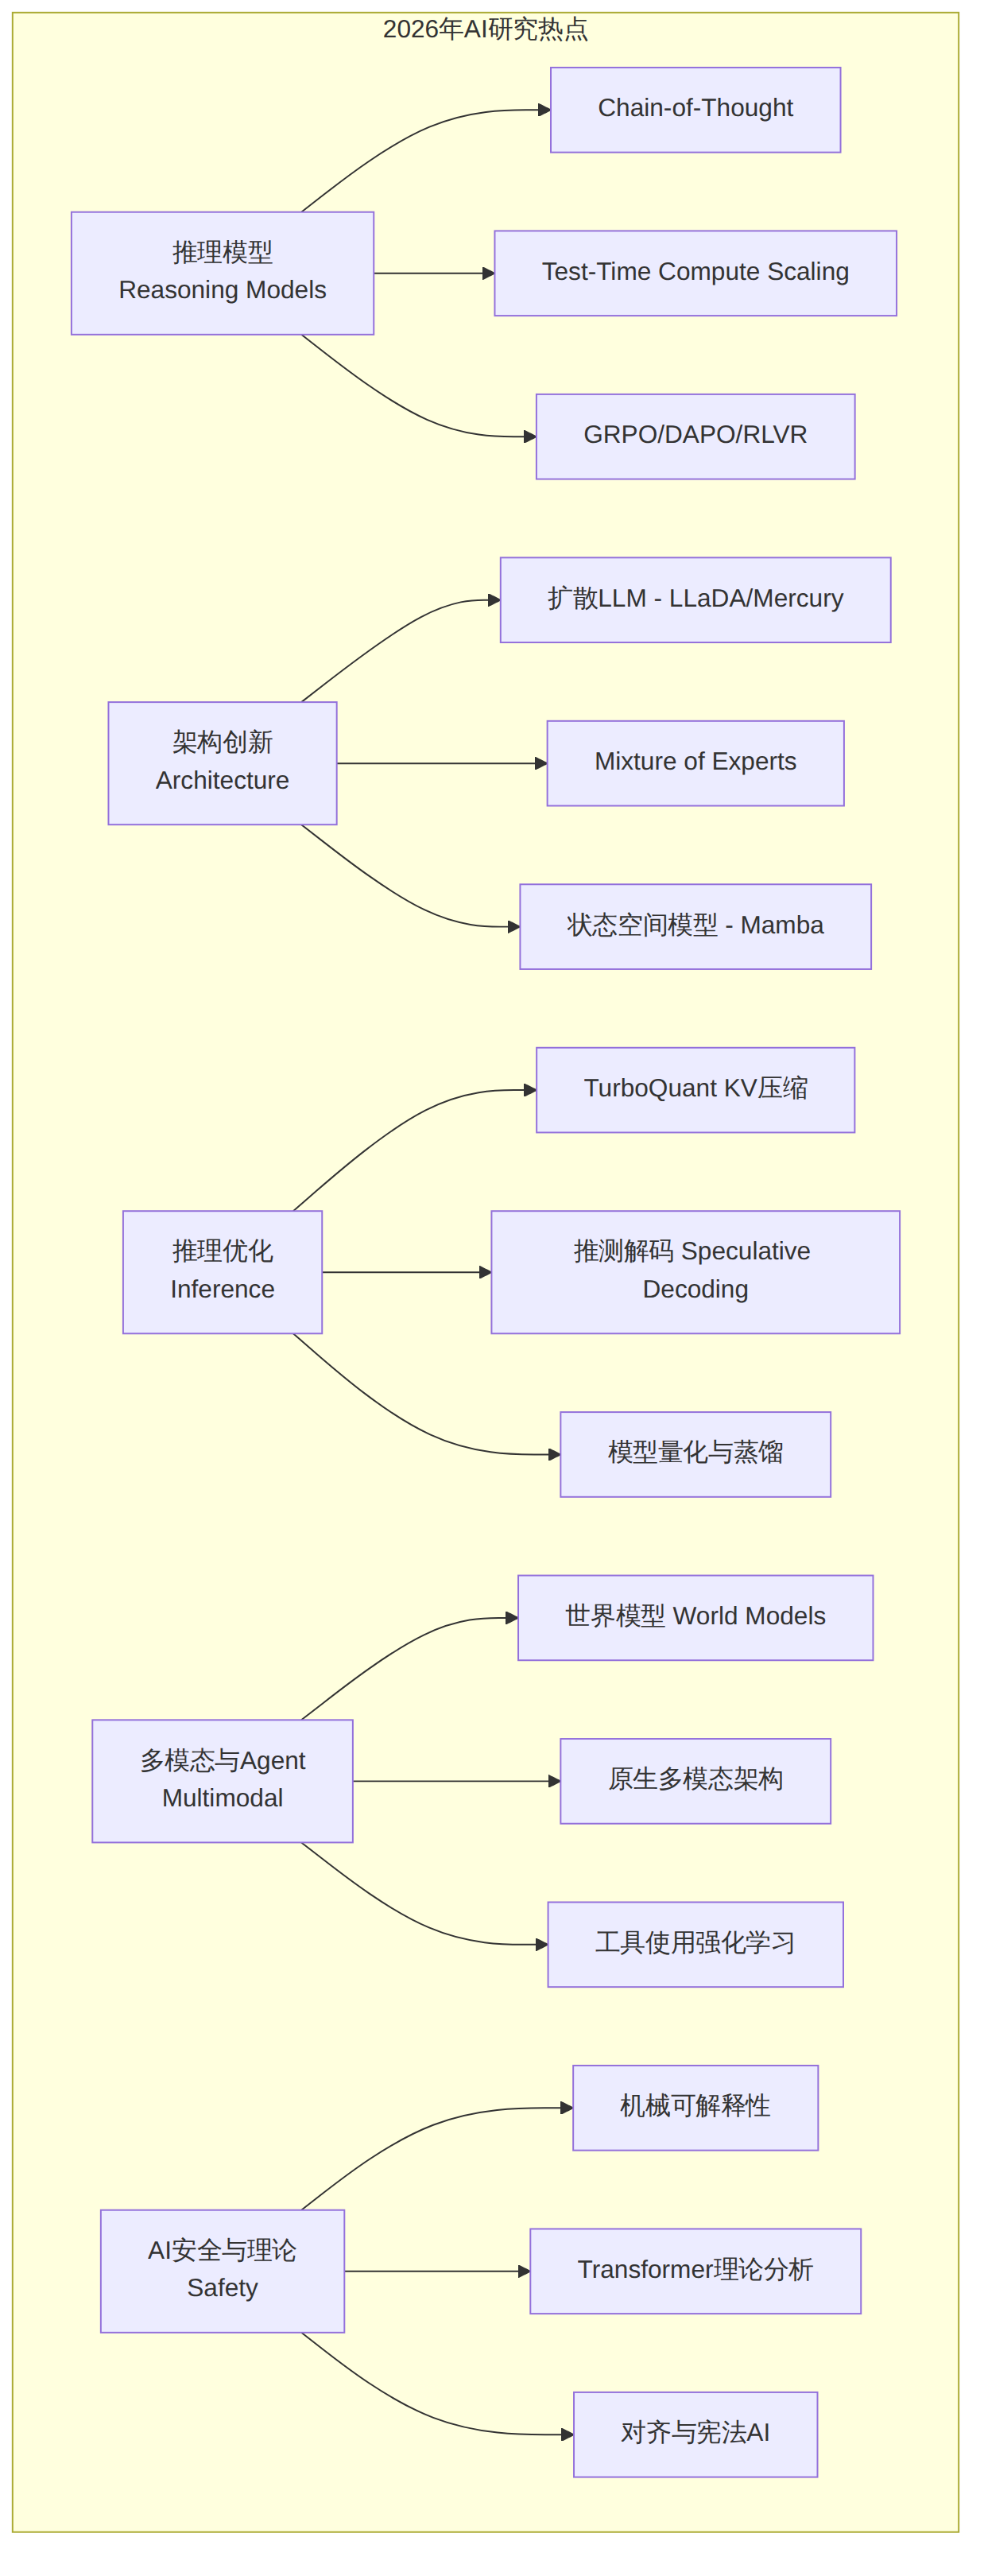
图表 2
本期精选视频涵盖的研究方向与通信行业的关联:扩散模型的迭代去噪机制与通信中的迭代译码(如Turbo码、LDPC码)存在深层数学联系;KV缓存压缩与信源编码思想一脉相承;GRPO/DAPO的强化学习范式与网络资源调度的优化方法有共通之处。AI前沿研究正在快速演进,保持对论文和顶会的跟踪是技术人员的必修课。
[!tip] 51学通信知识星球 星主:爱卫生(微信:gprshome201101)——公众号「51学通信」创办者,19 年通信行业运维与讲师经验,著有《GPRS网络信令实例详解》《EPC原理与实践》《5G核心网原理与实践》三本纸质书(各大电商平台有售)。 星球定位:深耕 5G 核心网、IMS、NFV/AI、云原生等 ICT 领域,主打运维岗位与信令分析。 当前规模:5200 篇主题 / 990 个回答,198 元/年。 加入福利:加入星球后请加爱卫生微信,拉您进知识星球年度陪伴与答疑群——不限量回复您的各种问题,另有群内分享。 AI 加持:51学通信知识星球已作为 skill 接入 WorkBuddy,使用 deepseek-4-flash 在海量星球帖子中精准找贴、找视频、找 FAQ 和案例,做总结、找文档和 PPT 等场景全覆盖。
