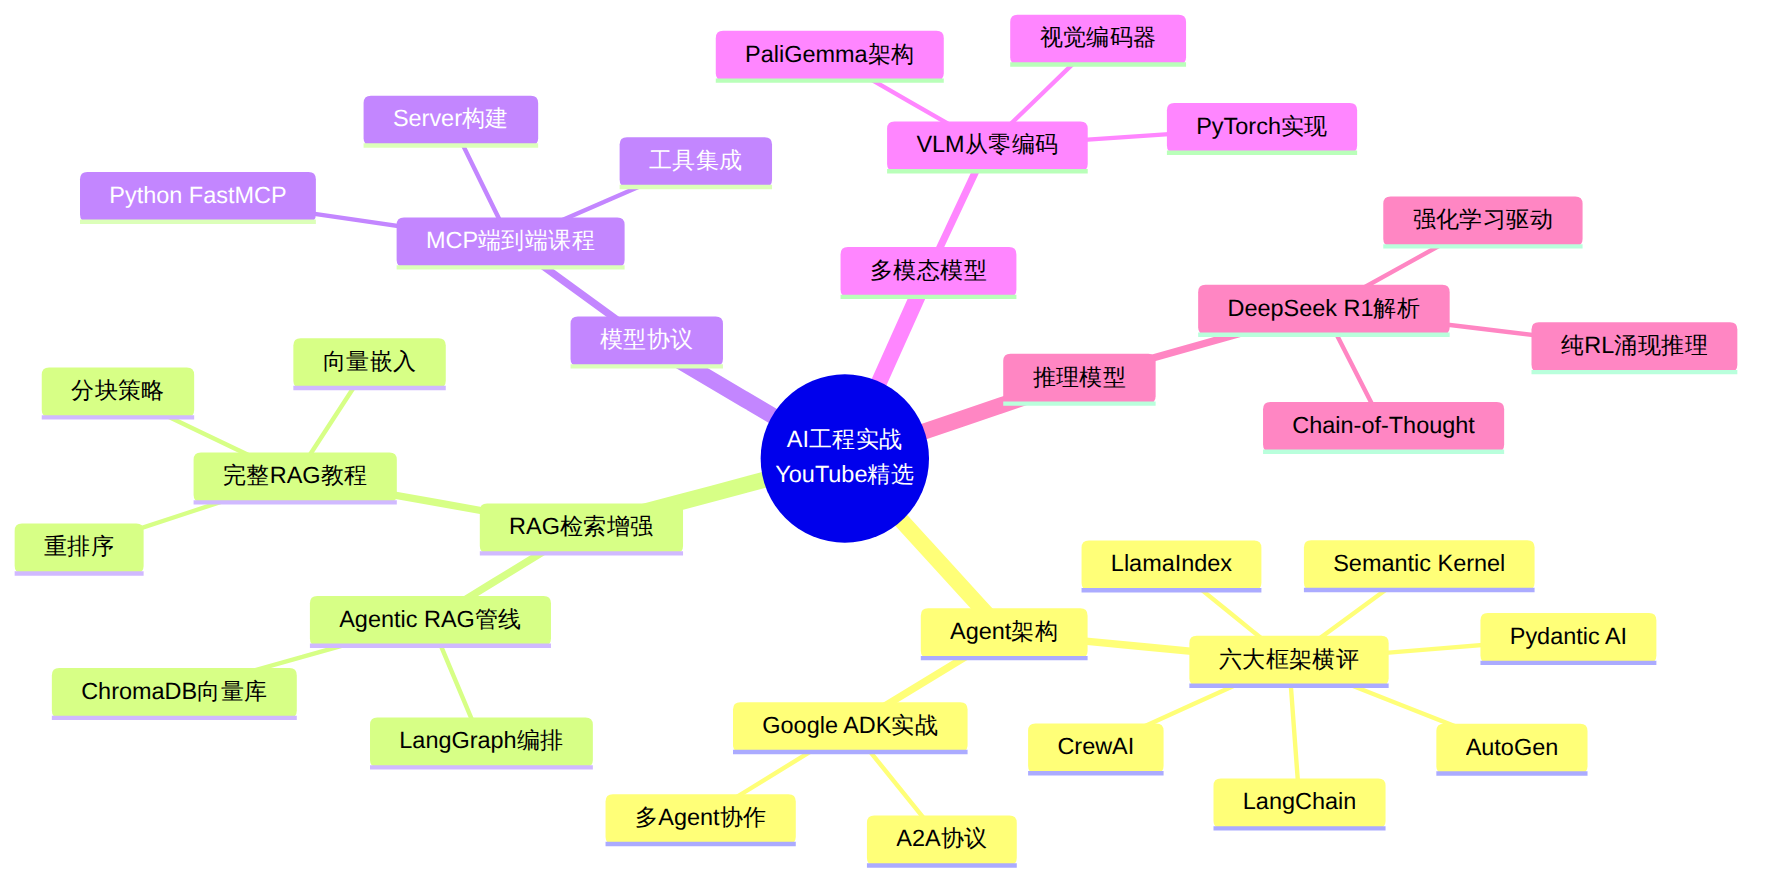
2026年5月的AI技术视频生态中,一批聚焦底层原理与工程实践的高质量教程正在YouTube上获得大量关注。与以往以工具推荐、功能演示为主的轻量级内容不同,这批视频直指AI工程的核心难题:Agent框架如何选型、RAG管线如何落地、MCP协议如何构建服务、多模态模型如何从零训练。本期精选覆盖Agent架构、检索增强生成、模型上下文协议、视觉语言模型、推理模型原理五大技术方向,精选7个值得投入时间深度学习的硬核教程视频。
| # | 视频标题(中/英) | 频道 | 时长 | 推荐指数 |
|---|---|---|---|---|
| 1 | 六大AI Agent框架横评 / Which AI Agent Framework Should You Use? 6 Frameworks | Dave Ebbeka | ~45min | ★★★★★ |
| 2 | 用Google ADK从零构建AI Agent / Build AI Agents from Scratch with Google ADK | Google Cloud Tech | ~60min | ★★★★★ |
| 3 | Agentic RAG管线实战 / Build an Agentic RAG Pipeline with LangGraph + ChromaDB | LangChain | ~50min | ★★★★☆ |
| 4 | 2026完整RAG教程(含实验) / Complete RAG Tutorial 2026 (Free Labs) | freeCodeCamp | ~180min | ★★★★☆ |
| 5 | 用PyTorch从零编码多模态VLM / Coding a Multimodal VLM from Scratch in PyTorch | HK @ Umar Jamil | ~120min | ★★★★★ |
| 6 | MCP协议端到端课程 / MCP Model Context Protocol End-To-End Course 2026 | 多频道合集 | 播放列表 | ★★★★☆ |
| 7 | DeepSeek R1推理原理详解 / DeepSeek R1 Explained: A Breakthrough in AI Reasoning | AI Search | ~25min | ★★★★☆ |
图表 1
视频标题:Which AI Agent Framework Should You Use? 6 Frameworks Tested 频道:Dave Ebbeka · AI工程类频道,聚焦Agent与LLM开发实战 视频链接:https://www.youtube.com/watch?v=x2LlifJUN7c
1. 六框架全景对比方法论:作者没有简单罗列功能列表,而是用同一个任务("研究一个主题并生成结构化报告")在六个框架中分别实现,从代码量、调试难度、扩展性三个维度进行量化评估。这种"控制变量"的对比方法在YouTube教程中相当少见。
2. LangChain/LangGraph的灵活性与复杂度权衡:LangGraph作为LangChain生态的Agent编排层,提供了最细粒度的状态机控制能力。对于需要复杂工作流(如条件分支、循环纠错、人工审批节点)的场景,LangGraph的图结构编排远优于线性链式调用。但学习曲线陡峭——仅状态定义和节点连接就需要理解约20个核心概念。
关键技术概念:Agent编排(Agent Orchestration) — 指多个AI Agent之间如何分配任务、传递上下文、处理失败的协调机制。类似微服务架构中的服务编排,但Agent编排还需处理LLM输出的不确定性。
3. CrewAI的角色分工模式:CrewAI的设计哲学是"角色扮演"——每个Agent定义一个角色(如"研究员"、"编辑"、"审校"),通过任务链完成复杂工作。作者指出CrewAI在快速原型验证中表现优异(30分钟可搭建三Agent协作系统),但在生产环境中的错误恢复和超时控制机制偏弱。
4. Pydantic AI的类型安全优势:Pydantic AI利用Python的类型注解系统,让Agent的输入输出都有严格的Schema校验。对于需要与现有API集成的企业场景,这种"编译期就能发现格式错误"的能力大幅降低了运行时调试成本。
5. 框架选型决策树:作者给出了一个实用决策路径——需要最大灵活性选LangGraph;快速原型选CrewAI;微软生态选AutoGen;企业集成选Semantic Kernel;类型安全优先选Pydantic AI;检索增强场景选LlamaIndex。
视频标题:How to Build AI Agents from Scratch with Google ADK (2026 Tutorial) 频道:Google Cloud Tech(Google Cloud官方频道)· 订阅者200万+ 视频链接:https://www.youtube.com/watch?v=g-Fa1GQeCRc
1. Google ADK的定位与核心架构:Google Agent Development Kit(ADK)是2025年末发布的开源框架,定位为"Agent开发的Android SDK"。其核心设计理念是"声明式Agent定义"——开发者用Python类描述Agent的能力(Tools)、记忆(Memory)、和协作方式(A2A Protocol),框架自动处理调度和状态管理。
2. A2A协议深度集成:视频重点演示了ADK对Agent-to-Agent(A2A)协议的原生支持。A2A是Google推出的开放标准,定义了不同框架(甚至不同厂商)构建的Agent之间如何发现彼此、协商能力、交换任务。这解决了当前Agent生态最棘手的"孤岛问题"——CrewAI的Agent无法直接调用AutoGen的Agent。
关键技术概念:A2A协议(Agent-to-Agent Protocol) — Google推出的开放通信标准,类似于HTTP对于Web的意义。A2A定义了Agent之间的发现、认证、任务委派、结果返回的标准化消息格式。与Anthropic的MCP协议互补——MCP解决"Agent到工具"的连接,A2A解决"Agent到Agent"的连接。
3. 多Agent协作的实战演示:视频构建了一个金融分析Agent系统:一个"研究员Agent"负责数据收集、一个"分析师Agent"负责趋势解读、一个"报告Agent"负责输出可视化报告。三个Agent通过A2A协议自动发现和协调,无需硬编码调用关系。
4. 与MCP的协同设计:ADK同时支持MCP协议——Agent可以通过MCP连接外部工具(如数据库查询API、文件系统),同时通过A2A与其他Agent协作。视频展示了一个Agent同时使用MCP工具和A2A协作的完整工作流。
5. 部署到Google Cloud的路径:教程后半段演示了将开发好的Agent部署到Cloud Run的完整流程,包括环境配置、密钥管理、监控告警。对于需要从原型走向生产的团队,这部分内容极具参考价值。
视频标题:Build an Agentic RAG Pipeline with LangGraph + ChromaDB (Step by Step) 频道:LangChain官方教程生态 视频链接:https://www.youtube.com/watch?v=oo4OeE3yVBI
1. 从"朴素RAG"到"Agentic RAG"的进化:视频首先清晰区分了两种RAG架构。朴素RAG(Naive RAG)是固定的"查询→检索→生成"管线,而Agentic RAG引入了Agent的自主决策能力——Agent可以决定是否需要检索、检索哪些数据源、检索结果是否足够回答问题、是否需要多次检索。这种"反思-行动"循环显著提升了复杂查询的准确率。
2. LangGraph状态机编排RAG流程:教程使用LangGraph的StateGraph构建RAG Agent。核心节点包括:问题分析节点(判断查询类型)、检索策略选择节点(决定使用向量搜索还是关键词搜索)、文档评估节点(判断检索结果质量)、回答生成节点。节点之间的条件转移(Conditional Edge)实现了动态流程控制。
关键技术概念:混合检索(Hybrid Search) — 同时使用向量语义搜索和传统关键词搜索(BM25),然后将两路结果融合排序。向量搜索擅长语义相似度匹配(如"如何部署"匹配"安装指南"),关键词搜索擅长精确术语匹配(如"TS 38.331"匹配规范文档编号)。生产级RAG几乎必须使用混合检索。
3. ChromaDB向量库实战配置:视频详细演示了ChromaDB的集合创建、嵌入模型选型(使用all-MiniLM-L6-v2作为默认嵌入器)、持久化存储配置。特别讲解了元数据过滤(Metadata Filtering)——为每个文档打上来源、日期、类别等标签,检索时可以先按标签过滤再进行向量匹配,大幅提升精确度。
4. 分块策略的工程选择:视频对比了三种主流分块方法——固定长度分块(每块512 token)、递归字符分块(按段落→句子→字符层级切分)、语义分块(按语义边界切分)。实测数据显示,对于技术文档,递归字符分块在召回率和上下文完整性之间取得了最佳平衡。
视频标题:Complete RAG Tutorial 2026 (Free Labs) 频道:freeCodeCamp · 订阅者1000万+,全球最大免费编程教育平台 视频链接:https://www.youtube.com/watch?v=vT-DpLvf29Q
1. 三小时全面覆盖RAG知识体系:这是freeCodeCamp罕见的超长深度教程,从向量嵌入的基本数学原理(余弦相似度、点积、欧氏距离的区别)讲起,逐步深入到生产级RAG系统的完整架构。课程设计遵循"原理→代码→实验"三段式结构,每个知识点都配有可直接运行的Colab Notebook。
2. 嵌入模型的选型与对比:教程实测了五种主流嵌入模型在同一个文档集上的检索效果——OpenAI text-embedding-3-small、text-embedding-3-large、Cohere embed-v3、BGE-large-en-v1.5、E5-large-v2。关键发现:对于技术文档检索,BGE和E5这类专门训练的检索嵌入模型在MRR(平均倒数排名)指标上优于通用嵌入模型约15-20%。
关键技术概念:重排序(Reranking) — 初次检索返回Top-K文档后,使用一个更精确(但更慢)的交叉编码器模型对这些文档与查询的相关性进行重新评分。典型做法是先用双编码器快速检索Top-50,再用交叉编码器精排取Top-5。这是提升RAG准确率性价比最高的技术手段。
3. 分块策略的系统性实验:教程设计了对照实验——同一份100页技术文档,分别使用不同的分块大小(128/256/512/1024 token)和重叠策略(0%/10%/20%),在20个测试查询上评估召回率。实验结果表明:512 token分块 + 10%重叠是最稳健的选择,过小的分块丢失上下文,过大的分块引入噪声。
4. 免费实验环境:课程提供完整的Google Colab Notebook,包含预配置的数据集、API密钥(免费额度)、和自动评分脚本。这是该教程最大的差异化价值——不需要本地环境配置,直接在浏览器中完成所有实验。
视频标题:Coding a Multimodal (Vision) Language Model from Scratch in PyTorch 频道:Umar Jamil(@hkproj)· AI研究型频道,专注Transformer架构深度拆解 视频链接:https://www.youtube.com/watch?v=vAmKB7iPkWw
1. 从零实现PaliGemma架构:这不是调用Hugging Face API的教程,而是用纯PyTorch从张量操作级别实现一个完整的视觉语言模型。作者以Google的PaliGemma为参考架构,逐一编码SigLIP视觉编码器、Gemma语言模型、和连接二者的多模态投影层。这种"从零编码"的教学方式在YouTube上极为稀缺。
2. 视觉编码器的内部实现:SigLIP(Sigmoid Language-Image Pre-training)是CLIP的改进版本,使用sigmoid损失函数替代softmax对比损失。视频逐步实现了Patch Embedding(将图像切分为16×16像素块)、Transformer编码器(处理空间关系)、和图像-文本对齐层。每一层都配有数学公式推导和代码对照。
关键技术概念:视觉-语言对齐(Vision-Language Alignment) — 多模态模型的核心挑战是将图像特征映射到语言模型的语义空间。主流方法有两种:(1) 线性投影:用简单的线性变换将视觉特征映射到语言空间,PaliGemma采用此方法;(2) 交叉注意力:让语言模型通过注意力机制直接"看"图像特征,LLaVA采用此方法。前者计算效率高,后者语义理解更精细。
3. 多模态投影层的设计:视频详细讲解了如何将SigLIP输出的视觉Token(256个768维向量)投影到Gemma的词嵌入空间(2048维)。关键是引入了一个可训练的"软提示"(Soft Prompt)机制——视觉Token不是直接拼接到文本Token之前,而是作为特殊的注意力前缀参与语言模型的生成过程。
4. 推理流程的完整实现:从图像预处理(缩放、归一化、Patch切分)到视觉编码,再到与文本Prompt的拼接,最终通过自回归生成输出回答。视频最后用一个实际案例演示:输入一张街景图片和问题"图中有几辆车",模型输出正确的计数结果。
5. 配套GitHub仓库完整可复现:作者提供了完整的代码仓库(hkproj/pytorch-paligemma),包含模型定义、训练脚本、预训练权重加载、和推理代码。代码质量达到学术论文开源项目的标准。
视频标题:MCP - Model Context Protocol End-To-End Course 2026 频道:YouTube播放列表合集(多频道贡献) 视频链接:https://www.youtube.com/playlist?list=PL6tW9BrhiPTCDteflzehKS6Cn3a79-iCs
1. MCP协议的全面解读:这个播放列表课程从MCP协议的背景和动机讲起——2024年11月Anthropic发布MCP规范,到2026年已成为AI工具连接的事实标准。MCP解决了"每个AI应用都要为每个工具写专用集成"的N×M问题,统一为一套标准化的工具描述和调用协议。
2. 从零构建MCP Server:课程的核心模块是手把手构建一个完整的MCP Server。使用Python的FastMCP库,定义Tools(可调用的函数)、Resources(可读取的数据)、和Prompts(预定义的提示模板)。一个最小MCP Server仅需约50行Python代码。
关键技术概念:MCP三种原语(Primitives) — MCP协议定义了三种核心交互模式:(1) Tools:Agent可以调用的函数(如"查询数据库"、"发送邮件");(2) Resources:Agent可以读取的数据(如"项目文件"、"用户配置");(3) Prompts:预定义的提示模板(如"代码审查模板")。这三种原语覆盖了Agent与外部世界交互的绝大部分场景。
3. MCP与Claude/GPT的集成:教程演示了如何将自建MCP Server连接到Claude Desktop和VS Code中的GitHub Copilot。连接后,AI助手可以自动发现和使用你定义的工具——不需要任何额外的API对接代码。
4. 安全模型与权限控制:课程专门用一节讲解MCP的安全设计——每个Tool调用都需要用户明确授权、支持细粒度的读写权限控制、传输层使用标准SSE/Stdio协议。这对于在企业环境中部署MCP服务至关重要。
视频标题:DeepSeek R1 Explained: A Breakthrough in AI Reasoning | How It Works 频道:AI Search · AI技术解读类频道 视频链接:https://www.youtube.com/watch?v=CbyK67ruybI
1. DeepSeek R1的技术路线革命:视频清晰讲述了DeepSeek R1最令人震惊的发现——通过对Base Model(非指令微调版)直接应用强化学习(GRPO算法),模型自发涌现了Chain-of-Thought推理能力,无需任何人工标注的推理数据。这个"纯RL涌现推理"的结果对整个AI研究社区产生了深远影响。
2. R1-Zero到R1的进化路径:DeepSeek先训练了R1-Zero(纯RL,无SFT),发现虽然推理能力强但输出格式混乱(中英文混杂、推理步骤不清晰)。然后通过冷启动SFT(用少量高质量推理样本微调)+ 多阶段RL训练得到R1,既保留了推理能力又获得了规范输出格式。
关键技术概念:GRPO(Group Relative Policy Optimization) — DeepSeek创新的强化学习算法,是PPO的简化版本。关键创新:不需要训练一个独立的Value Model(价值函数),而是用同一批采样的多个回答之间的相对排名来估计优势函数。这大幅降低了RL训练的计算成本——PPO需要4个模型(Actor、Critic、Ref、Reward),GRPO只需2个(Actor、Ref)。
3. 推理蒸馏(Reasoning Distillation):R1的推理能力可以通过知识蒸馏传递给更小的模型。DeepSeek发布的R1-Distill系列(基于Llama-8B/70B、Qwen-7B/32B等)在推理任务上接近甚至超过了这些基础模型经过大量SFT训练后的表现。这意味着"推理能力"可以作为一种可迁移的技能。
4. 与OpenAI o1/o3的对比:视频客观比较了R1和o1的技术路线差异——o1依赖大量的隐藏推理Token(可能数千个),而R1的推理过程是透明可见的。在开源性和成本方面R1有绝对优势,但在某些极端复杂推理任务上o3仍略领先。
理由:Agent框架选型是2026年AI工程最关键的架构决策之一。这个视频用统一任务对比6个框架,提供了罕见的横向视角和量化数据,避免了"每个框架都说自己最好"的信息茧房。45分钟的投资回报率极高——看完后再做框架选型决策,至少能节省一周的调研时间。
理由:Umar Jamil的教程代表了YouTube上AI技术深度教学的最高水平。纯PyTorch从零实现一个视觉语言模型,不是调API而是写张量运算——这种内容在付费课程中都少见,何况是免费的YouTube视频。对于想真正理解多模态模型内部机制的工程师,这是不可错过的学习资源。
理由:A2A协议是Google在Agent领域的战略级布局,定义了Agent之间通信的开放标准。这个官方教程不仅讲解了ADK的使用方法,更重要的是展示了A2A协议如何解决"Agent孤岛"问题。对于关注Agent生态演进方向的架构师,这个视频提供了来自协议设计者的第一手视角。
本期精选的七个视频揭示了一个清晰的行业趋势:2026年的AI工程正在从"调用API"走向"理解原理"。无论是Agent框架选型需要理解状态机编排原理,还是RAG系统优化需要理解嵌入模型和检索算法的数学基础,抑或是构建MCP服务需要理解协议设计哲学——表面的工具使用已经不够了,真正的工程竞争力来自对底层机制的理解深度。
另一个值得关注的信号是Google在Agent协议层面的布局:A2A(Agent-to-Agent)、A2UI(Agent-to-UI)、AP2(Agent-to-Agent Payment)构成了完整的"A2Family"协议族。如果这些协议被行业广泛采纳,Google将在Agent互操作性层面获得类似Android在移动互联网时代的生态位。
[!tip] 51学通信知识星球 星主:爱卫生(微信:gprshome201101)——公众号「51学通信」创办者,19 年通信行业运维与讲师经验,著有《GPRS网络信令实例详解》《EPC原理与实践》《5G核心网原理与实践》三本纸质书(各大电商平台有售)。 星球定位:深耕 5G 核心网、IMS、NFV/AI、云原生等 ICT 领域,主打运维岗位与信令分析。 当前规模:5200 篇主题 / 990 个回答,198 元/年。 加入福利:加入星球后请加爱卫生微信,拉您进知识星球年度陪伴与答疑群——不限量回复您的各种问题,另有群内分享。 AI 加持:51学通信知识星球已作为 skill 接入 WorkBuddy,使用 deepseek-4-flash 在海量星球帖子中精准找贴、找视频、找 FAQ 和案例,做总结、找文档和 PPT 等场景全覆盖。
