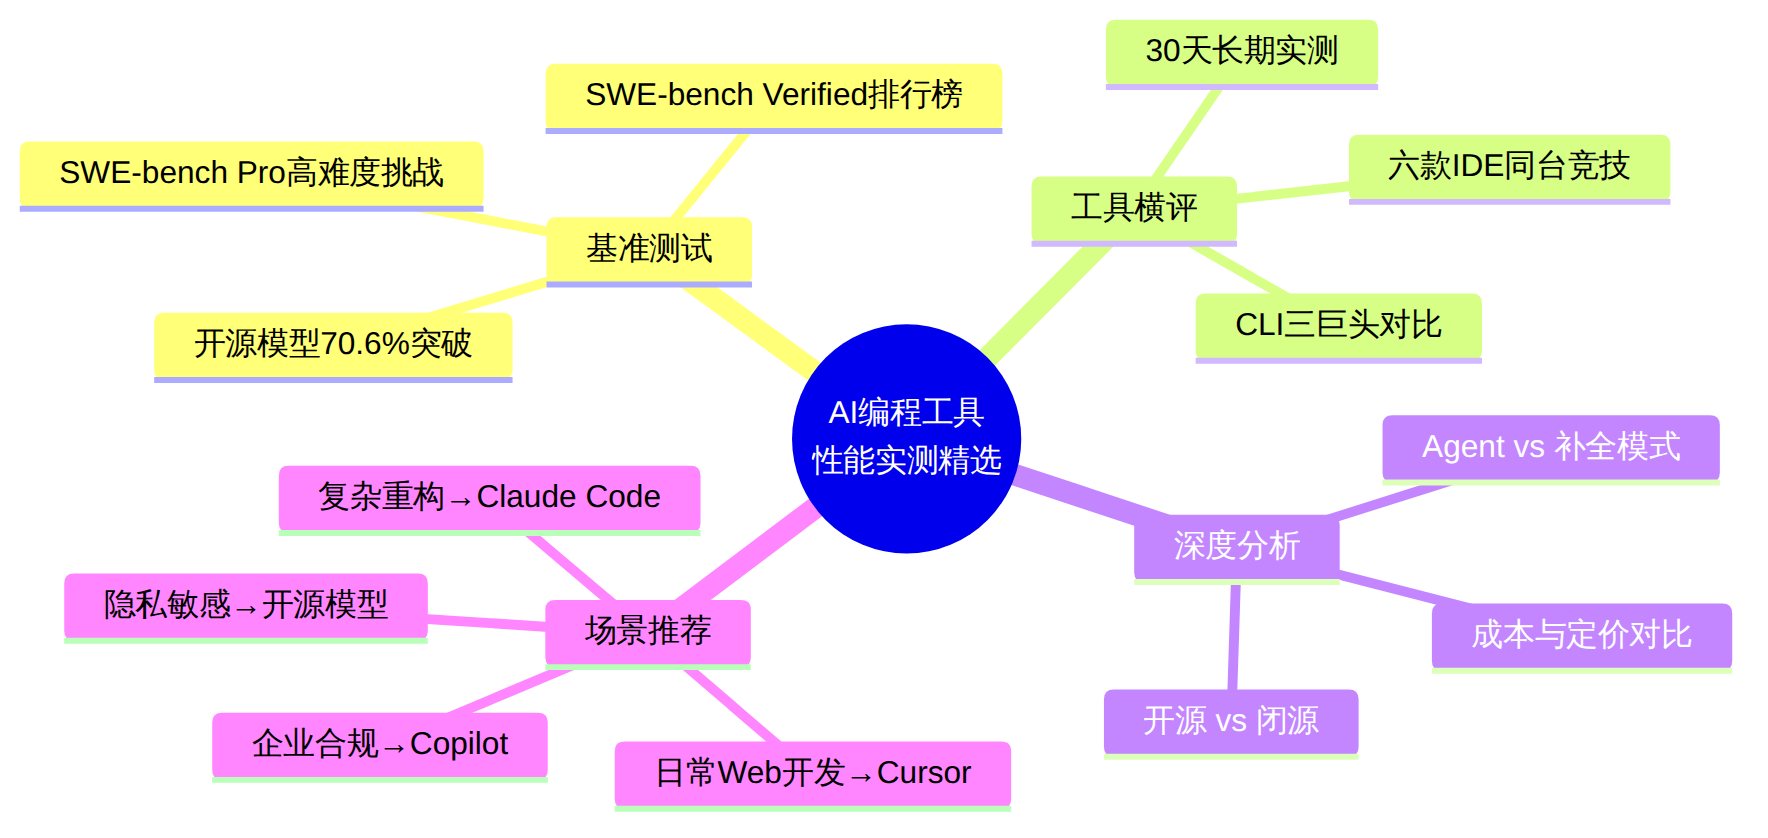
AI编程工具赛道在2026年进入白热化阶段,Cursor、Claude Code、GitHub Copilot三足鼎立,Windsurf、OpenAI Codex、Gemini CLI等新锐不断冲击格局。本期精选7个以性能实测与基准对比为核心视角的YouTube深度视频,涵盖SWE-bench基准测试解读、30天真实项目长期测试、CLI工具横评、六款IDE同台竞技等多个维度。从SWE-bench Verified排行榜到50K行代码库实战测试,从GPT-5与Claude在高难度基准上的"翻车"分析到开源模型突破70%准确率的里程碑——这些视频用数据说话,帮助开发者跳出营销话术,找到真正适合自己的AI编程工具。
| # | 视频标题(中/英) | 频道 | 时长 | 发布日期 | 推荐指数 |
|---|---|---|---|---|---|
| 1 | 六款AI编程工具终极实测 / Cursor VS Claude Code VS Codex VS Antigravity VS Windsurf VS Github Copilot | Andov | ~35min | 2026.03 | ★★★★★ |
| 2 | CLI三大编程助手对比 / Gemini CLI vs Claude Code vs Codex Compared | Codex Community | ~18min | 2025.07 | ★★★★★ |
| 3 | 30天实测三巨头 / Copilot vs Claude Code vs Cursor: I Tested All 3 | AI Terminal | ~20min | 2026.03 | ★★★★☆ |
| 4 | SWE-bench揭秘AI编程代理 / SWE-bench: The Benchmark That Exposes Every AI Coding Agent | Ninad Pathak | ~15min | 2026.05 | ★★★★☆ |
| 5 | GPT-5与Claude在SWE-bench Pro上为何翻车 / Why GPT 5 and Claude Flop on SWE Bench Pro | Binary Verse AI | ~22min | 2025.09 | ★★★★☆ |
| 6 | 三款AI编程工具诚实评测 / Claude Code vs GitHub Copilot vs Cursor - The HONEST Truth | Gheware DevOps AI | ~25min | 2025.12 | ★★★★☆ |
| 7 | 开源AI编程代理SWE-bench 70.6%突破 / This FREE AI Coding Agent Just Hit 70.6% on SWE-Bench | AISoftScope | ~12min | 2026.02 | ★★★★☆ |
视频链接: youtube.com/watch?v=9J4idStlqmc
频道: Andov(9.63K订阅)— 专注于AI编程工具评测的技术YouTuber,以"实测所有工具"著称,视频风格直接、数据驱动。
核心要点:
关键技术概念: - Agent模式 vs 补全模式:Cursor和Copilot主要提供行内补全(Inline Completion),而Claude Code和Codex更偏向自主Agent模式(Autonomous Agent),即接收到任务后自行规划、编写和测试代码。两种模式适合不同场景:补全模式适合日常编码提效,Agent模式适合批量生成和复杂重构。 - Antigravity:新兴的AI编程IDE,主打"零配置"体验,内置多种LLM路由,可根据任务类型自动选择最优模型。
观看建议:适合正在选型AI编程工具的开发者。推荐从10:00开始观看"同类任务对比"环节,这是视频最有价值的部分。全片约35分钟,建议1.25倍速观看。
延伸资源: - Cursor官方文档 - Claude Code GitHub仓库
视频链接: youtube.com/watch?v=7fQcsPOm8ys
频道: Codex Community(215K订阅)— 大型AI编程社区频道,覆盖AI编码工具教程、新闻和深度对比,是AI编程领域订阅量最高的YouTube频道之一。本视频播放量达17.6万次。
核心要点:
关键技术概念: - MCP(Model Context Protocol):Anthropic推出的开放协议,允许AI编程工具与外部系统(数据库、API、文件系统等)进行标准化交互。例如,通过MCP,Claude Code可以直接读取你的数据库Schema来生成更准确的ORM代码。这是区别于简单代码补全的关键能力。 - CLI vs IDE:CLI工具(如Claude Code)在终端中运行,适合服务器环境、CI/CD管道和偏好键盘操作的高级开发者。IDE工具(如Cursor)提供图形界面和可视化交互,适合大多数开发者。两者并非替代关系,而是互补。
观看建议:17.6万播放量验证了内容质量。全片约18分钟,适合所有对AI CLI工具感兴趣的开发者。如果你正在Claude Code和Gemini CLI之间犹豫,这个视频会给出明确答案。
延伸资源: - Gemini CLI GitHub仓库 - MCP协议官方文档 - OpenAI Codex CLI文档
视频链接: youtube.com/watch?v=1UPDl9jSp2Q
频道: AI Terminal(228订阅)— 新兴AI编程评测频道,主打"长期实测"风格,不做短期快速评测,而是用真实项目花数周时间深度体验。
核心要点:
关键技术概念: - 首次建议准确率(First Suggestion Acceptance Rate):衡量AI编程工具有用的核心指标——AI给出的第一个代码建议被开发者直接采用的比例。Copilot在这一指标上长期领先(约30-40%的接受率),Claude Code在Agent任务中表现更好但补全接受率偏低。 - 30天测试方法论:与单次benchmark不同,长期测试能暴露工具的"疲劳问题"——某些工具在初期表现惊艳但后续遇到上下文窗口限制、API成本累积等问题。
观看建议:适合需要做工具选型决策的技术管理者。全片约20分钟,前5分钟是测试方法介绍,中间10分钟是核心数据对比,最后5分钟是结论推荐。
延伸资源: - GitHub Copilot官方页面 - Cursor vs Copilot SWE-bench对比
视频链接: youtube.com/watch?v=6zx64cQ3JGM
频道: Ninad Pathak(17订阅)— 技术深度解析频道,专注于AI编程基准测试和评估方法论。虽然订阅数少,但内容专业度极高。
核心要点:
关键技术概念: - SWE-bench评估流程:AI代理接收一个GitHub Issue → 分析代码仓库 → 生成修复补丁 → 在隔离环境中运行测试 → 检查补丁是否解决问题。整个过程禁止人工干预,完全自动化评分。 - Agent框架的作用:SWE-bench测试的不是裸模型,而是"模型+Agent框架"的组合。同一个Claude模型,搭配不同的Agent框架(如SWE-Agent、OpenHands),得分可能差异巨大。这就是为什么纯模型排行榜和SWE-bench排行榜不完全对应。
观看建议:适合想深入理解"AI编程工具到底强不强"背后方法论的技术人员。全片约15分钟,信息密度极高,建议做笔记。这是理解整个AI编程评测生态的基础视频。
延伸资源: - SWE-bench官方网站 - SWE-bench Verified排行榜 - SWE-Agent论文
视频链接: youtube.com/watch?v=nrclDEvLdT0
频道: Binary Verse AI(855订阅)— 专注AI基准测试深度分析的技术频道,善于用数据和实验揭示模型宣传与实际表现之间的差距。
核心要点:
关键技术概念: - SWE-bench Pro vs Verified:Pro版本从完整SWE-bench中筛选了最难的实例——通常是涉及3个以上文件修改、需要理解复杂业务逻辑的Issue。如果说Verified测试的是"AI能不能修简单Bug",那Pro测试的是"AI能不能处理真正的工程难题"。 - Agent框架的重要性:同一个底层模型,在SWE-bench Pro上搭配不同Agent框架的得分差异可达15-20个百分点。这表明"模型能力"和"工具工程能力"是两个独立的维度。
观看建议:适合AI工程师和技术决策者。视频约22分钟,信息密度高,适合对AI编程上限感兴趣的研究型开发者。建议先看视频#4了解SWE-bench基础,再看本视频。
延伸资源: - SWE-bench Pro介绍视频 - Blitzy SWE-bench Pro 66.5%报告 - AI编码评测现状分析
视频链接: youtube.com/watch?v=EUmSTacO1Mo
频道: Gheware DevOps AI(226订阅)— DevOps与AI交叉领域的技术频道,以"不讲好话只讲真话"为风格,从实际工程角度审视AI工具。
核心要点:
关键技术概念: - API成本测算:Claude Code使用Anthropic API,按输入/输出Token计费。一个中等复杂度的文件重构任务可能消耗50K-200K Token,按Opus模型定价约$0.15-$0.60/次。一天做10次这样的操作就是$1.5-$6。月度成本取决于使用频率。 - Composer模式:Cursor独有的功能,允许AI在多个文件间同时编辑。这是Cursor区别于传统"单文件补全"工具的核心差异化能力。
观看建议:适合"三选一"决策中的开发者。全片约25分钟,信息量适中,结论清晰务实。如果你已经被各种"最强AI编程工具"的标题党搞得选择困难,这个视频值得一看。
延伸资源: - Claude Code定价 - Cursor定价 - GitHub Copilot定价
视频链接: youtube.com/watch?v=2Vw7ZVpgg80
频道: AISoftScope(678订阅)— 关注开源AI编程工具的技术频道,善于发现"被低估的开源项目"。
核心要点:
关键技术概念: - MoE(Mixture of Experts,混合专家):一种神经网络架构,模型包含多个"专家"子网络,每次推理时只激活其中少数几个。类比一个公司有80个部门,但处理任何单个项目只需要3个部门参与。这大幅降低了计算成本,同时保持了模型的知识广度。 - Apache 2.0许可:最宽松的开源许可之一,允许商业使用、修改、分发,无传染性要求。企业可以基于此模型构建自己的内部编程工具而无需开源自己的代码。 - 本地部署 vs API调用:本地部署的优势是数据不出境、无API费用、无速率限制。劣势是需要GPU硬件、模型更新需要手动操作、初始配置较复杂。
观看建议:适合关注开源AI和代码隐私的企业开发者。全片约12分钟,信息密度高。如果你想在自己的服务器上运行AI编程工具,这是必看视频。
延伸资源: - SWE-bench排行榜 - Devstral (Mistral开源编程模型) - 开源MoE模型趋势分析
图表 1
Codex Community | 17.6万播放 | 观看链接
推荐理由:播放量碾压同类视频(17.6万 vs 平均几百),覆盖三款主流CLI工具的全方位对比。无论你选哪个CLI工具,这个视频提供的信息都足够做出决策。MCP协议的讲解尤其清晰。
Andov | 5955播放 | 观看链接
推荐理由:YouTube上罕见的六款工具同场实测,测试条件统一、维度全面。如果你需要在多个AI编程工具之间做最终选择,这是信息量最大的单一视频源。
Ninad Pathak | 2026年5月最新发布 | 观看链接
推荐理由:理解AI编程评测体系的入门必看。SWE-bench是整个行业的"度量衡"——不了解SWE-bench,就无法真正理解各种"XX工具击败YY"的营销话术背后到底测的是什么。发布于2026年5月5日,数据最新鲜。
[!tip] 51学通信知识星球 星主:爱卫生(微信:gprshome201101)——公众号「51学通信」创办者,19 年通信行业运维与讲师经验,著有《GPRS网络信令实例详解》《EPC原理与实践》《5G核心网原理与实践》三本纸质书(各大电商平台有售)。 星球定位:深耕 5G 核心网、IMS、NFV/AI、云原生等 ICT 领域,主打运维岗位与信令分析。 当前规模:5200 篇主题 / 990 个回答,198 元/年。 加入福利:加入星球后请加爱卫生微信,拉您进知识星球年度陪伴与答疑群——不限量回复您的各种问题,另有群内分享。 AI 加持:51学通信知识星球已作为 skill 接入 WorkBuddy,使用 deepseek-4-flash 在海量星球帖子中精准找贴、找视频、找 FAQ 和案例,做总结、找文档和 PPT 等场景全覆盖。
