主题:论文解读 × 技术突破 × 学术会议精华
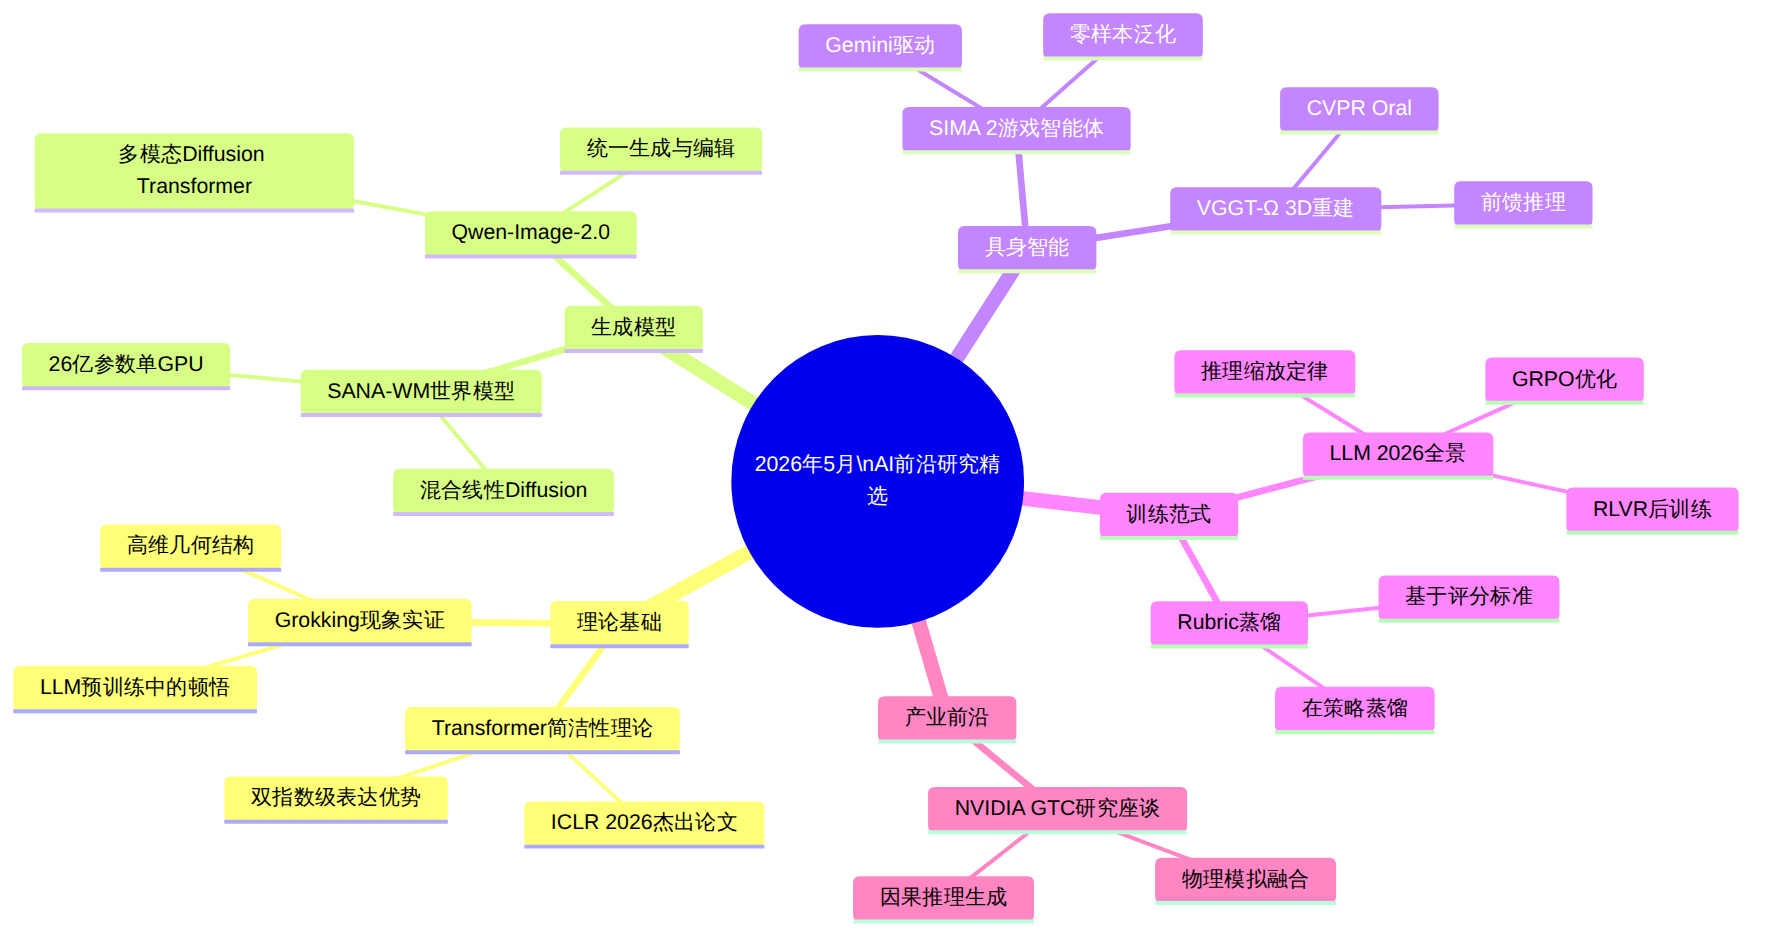
本期精选聚焦2026年5月最值得关注的AI前沿研究视频,涵盖ICLR 2026获奖论文解读、世界模型新范式、LLM推理缩放定律、3D视觉重建突破、Grokking现象实证研究等七大方向。以下视频均来自YouTube上高质量的学术内容创作者,为通信行业技术人员提供理解AI前沿的最佳入口。
| # | 视频标题(中/英) | 频道 | 时长 | 推荐指数 |
|---|---|---|---|---|
| 1 | Transformer天生简洁 / ICLR 2026 Outstanding Papers: Transformers are Succinct | AI Papers Explained | ~20min | ★★★★★ |
| 2 | 单GPU生成分钟级视频 / SANA-WM: Minute-Scale World Modeling on a Single GPU | AI Research Roundup | ~15min | ★★★★★ |
| 3 | 2026年LLM全景:RLVR、GRPO与推理缩放 / State of LLMs 2026: RLVR, GRPO, Inference Scaling | 多位研究者 | ~60min | ★★★★☆ |
| 4 | 3D视觉重建新巅峰VGGT-Ω / VGGT-Ω (May 2026) | AI Paper Channel | ~12min | ★★★★☆ |
| 5 | AI如何「顿悟」现实 / How AI "Grokks" Reality: Geometry of Insight | Richard Aragon | ~25min | ★★★★☆ |
| 6 | NVIDIA研究突破全员座谈 / AI Research Breakthroughs from NVIDIA Research (GTC Panel) | NVIDIA GTC / TwoMinutePapers | ~55min | ★★★★☆ |
| 7 | DeepMind SIMA 2:Gemini驱动的游戏智能体 / DeepMind Releases SIMA 2 | AI News/研究解读频道 | ~15min | ★★★★☆ |
原标题: ICLR 2026 Outstanding Papers: Transformers are Succinct
论文: Transformers are Inherently Succinct — Pascal Bergsträßer, Ryan Cotterell, Anthropic团队 | ICLR 2026 Outstanding Paper Award
频道介绍: AI Papers Explained 是YouTube上专注于最新arXiv论文解读的频道,以"最快速度跟上AI前沿突破"为口号,覆盖论文从动机到结论的完整逻辑链。
1. 全新表达能力度量标准——简洁性(Succinctness)
传统评估Transformer表达能力的方式是"能否计算某个函数"(图灵完备性),但这太粗粒度了。本文提出了"简洁性"这一度量——用Transformer描述一个概念/函数需要多少参数和计算步骤。核心发现:Transformer在描述复杂概念时,可以比传统有限状态自动机(FSA)双指数级(doubly exponentially)更简洁。
关键技术概念:简洁性(Succinctness) — 衡量的是"描述效率"而非"计算能力"。类比到通信领域,就像信源编码中的最优码长——同样的信息,Transformer能用更短的"程序"来表达。这对理解为什么LLM能高效压缩世界知识具有根本意义。
2. 注意力机制的信息压缩本质
论文从形式语言理论出发,证明自注意力机制天然具有将长程依赖压缩到固定维度表示的能力。多头注意力中的每个"头"可以独立编码不同的依赖模式,形成一种并行化的信息压缩。
3. 对LLM规模化的理论支撑
这一发现为"为什么更大的Transformer更好"提供了理论解释:参数增加不仅提升了可计算函数的范围,更重要的是成倍提升了描述复杂模式的效率。这解释了缩放定律(Scaling Laws)的底层机理。
4. ICLR 2026的标杆意义
ICLR 2026在新加坡举办,共收到19,525篇投稿,录取5,355篇。本文获得仅两篇杰出论文奖之一,被评审委员会评价为"为Transformer架构的理论理解开辟了全新方向"。
原标题: SANA-WM: Minute-Scale World Modeling on a Single GPU
论文: SANA-WM: Efficient Minute-Scale World Modeling with Hybrid Linear Diffusion Transformer — Haoyi Zhu等, NVIDIA | arXiv:2605.15178(2026年5月)
频道介绍: AI Research Roundup由研究者Alex主持,每期精选一篇前沿AI论文进行深度技术解读,尤其关注计算机视觉和生成模型领域。
1. 26亿参数生成60秒720p视频
NVIDIA推出的SANA-WM(SANA World Model)仅有2.6B参数,却在单个GPU上实现了分钟级视频生成——质量可媲美百亿参数级的工业基线(如LingBot-World)。这在算力效率和生成质量之间取得了令人瞩目的平衡。
关键技术概念:世界模型(World Model) — 不是简单的视频生成器,而是学习环境动态规律的模型。给定当前状态和动作,预测未来状态的演变。在通信网络仿真、自动驾驶、游戏等领域有广泛应用。可以理解为"学会物理规律的视频生成器"。
2. 混合线性Diffusion Transformer架构
核心创新是将线性注意力(Linear Attention)与传统Diffusion Transformer结合。线性注意力将注意力的计算复杂度从O(n²)降至O(n),使长序列(长视频)的生成成为可能,同时通过混合架构保留了标准注意力在局部细节上的优势。
3. 开源且可复现
模型基于SANA-Video代码库,完全开源。这意味着研究者和工程师可以在本地复现并进行二次开发,对于需要自定义世界模型的应用场景(如通信网络仿真)极具价值。
4. 动作跟随精度优于基线
在1分钟世界模型基准测试中,SANA-WM在动作跟随准确性(action-following accuracy)上优于更大规模的模型,说明参数效率的优化方向是正确的。
原标题: State of LLMs 2026: RLVR, GRPO, Inference Scaling
主讲人: 多位AI研究者联合出品
视频概述: 这是一期全面回顾2026年上半年大语言模型技术演进的深度视频,从架构选择到训练范式,再到推理阶段优化,构建了完整的LLM技术全景图。
1. Transformer仍然是赢家吗?
视频开篇即讨论了2026年最核心的架构问题——虽然有Mamba、RWKV等新架构的挑战,Transformer依然在综合性能上占据主导。但关键变化是:Transformer内部的注意力机制正在被重新设计,包括线性注意力、稀疏注意力、滑动窗口注意力等变体的广泛采用。
2. RLVR——后训练的新范式
RLVR(Reinforcement Learning from Verifiable Rewards)已成为2026年最主流的后训练方法。不同于传统RLHF依赖人类偏好标注,RLVR利用可验证的奖励信号(如数学题的对错、代码的测试通过率)进行强化学习,大幅降低了标注成本并提高了训练信号质量。
关键技术概念:GRPO(Group Relative Policy Optimization) — DeepSeek提出的组相对策略优化算法,是PPO的替代方案。核心思想是在一组候选回答中进行相对比较,而非逐个打绝对分。这在实践中更稳定,计算效率更高。对通信领域的RL应用(如网络调度优化)也有参考价值。
3. 推理缩放(Inference Scaling)成为新轴
传统的缩放定律关注训练阶段(更多参数、更多数据、更多算力),而2026年的前沿是将缩放思想延伸到推理阶段——通过增加推理时的计算量(如更长的思维链、更多的搜索步骤),在固定模型大小下获得更好的性能。这被称为"推理缩放定律"。
4. 中国AI生态的快速追赶
视频特别分析了中国AI研究在LLM领域的进展,包括DeepSeek、Qwen等模型在国际基准上的竞争力,以及开源生态的蓬勃发展。
原标题: VGGT-Ω (May 2026)
论文: VGGT-Ω — Meta/Facebook Research | CVPR 2026 Oral | arXiv:2605.15195
视频概述: VGGT-Ω是CVPR 2025最佳论文奖得主VGGT的升级版,在3D场景重建领域再次实现重大突破,获得CVPR 2026 Oral展示资格。
1. 前馈模型超越传统优化流水线
传统的3D重建依赖多阶段优化流水线(特征提取→匹配→三角化→稠密重建),VGGT-Ω采用纯前馈神经网络,直接从图像序列推理出场景的所有3D属性(深度、相机位姿、点云),速度和精度均超越传统方法。
2. Visual Geometry Grounded的设计哲学
"视觉几何接地"(Visual Geometry Grounded)意味着模型不是在抽象空间中学习3D表示,而是将几何约束(如对极几何、多视角一致性)直接嵌入到Transformer的注意力计算中,使网络天然具备3D几何推理能力。
关键技术概念:前馈3D重建 — 传统方法(如COLMAP)通过迭代优化求解,需要数小时。前馈方法用神经网络一次性推断,将时间缩短到秒级。这对实时3D通信(如全息通信、AR/VR)具有重大意义——想象手机拍几张照片就能在毫秒级生成完整的3D场景。
3. CVPR双年连冠
VGGT获CVPR 2025最佳论文奖,VGGT-Ω获CVPR 2026 Oral,体现了这一研究方向的持续影响力。Meta开源了代码和预训练模型。
原标题: How AI "Grokks" Reality | Geometry of Insight Explained (LLM Research Paper)
频道: Richard Aragon | ~2.1K观看 | 约1个月前发布
相关论文: Grokking in LLM Pretraining? Monitor Memorization-to-Generalization without Test — University of Maryland | arXiv:2506.21551
1. Grokking——从死记硬背到真正理解
Grokking是AI领域最迷人的现象之一:模型在训练loss不再下降很久之后,突然"顿悟"了问题的底层规律,泛化能力急剧提升。本视频首次系统性地将这一现象从toy实验(小规模算法任务)扩展到了实际的LLM预训练场景。
2. 高维空间中的几何结构
视频深入解释了LLM如何在参数空间中表示概念——不同的概念在高维空间中形成特定的几何结构(如簇、环、流形)。Grokking发生时,这些表示从杂乱无序的"记忆态"重组为结构化的"理解态"。
关键技术概念:Grokking — 词源来自Robert Heinlein的科幻小说《异乡异客》,意为"深刻到与之融为一体的理解"。在ML中指训练loss饱和后突然出现的泛化能力飞跃。这一现象暗示当前的训练方法可能严重低估了模型的潜在能力——我们可能只需要更耐心地训练。
3. 实用意义:监控预训练中的Grokking
论文提出了无需测试集即可监控Grokking是否正在发生的方法论——通过观察训练过程中权重矩阵的特定统计指标变化,可以判断模型是处于"记忆阶段"还是正在"顿悟"。这对大规模预训练的成本优化具有重要价值。
原标题: AI Research Breakthroughs from NVIDIA Research (Hosted by Karoly of TwoMinutePapers)
来源: NVIDIA GTC 2026 | 主持人:Károly Zsolnai-Fehér(Two Minute Papers创始人)
视频概述: 这是GTC 2026上最受关注的学术panel之一。Two Minute Papers的Károly作为主持人,与NVIDIA顶级研究员进行了一场高能量的圆桌讨论,涵盖了NVIDIA近期最前沿的研究成果。
1. Two Minute Papers × NVIDIA的碰撞
Károly以他标志性的热情和深入浅出的解说风格,引导NVIDIA研究员们从研究动机到技术细节再到未来展望,逐一剖析突破性成果。这种"科普者×研究者"的对话模式,使原本高深的技术内容变得异常可理解。
2. 世界模型与物理模拟的融合
NVIDIA展示了将世界模型与物理引擎结合的研究方向——不是纯数据驱动的黑箱模型,而是将物理先验知识(如流体力学、刚体动力学)融入神经网络,实现更高效、更准确的物理世界模拟。
3. 生成式AI的新范式
讨论了从"生成"到"推理+生成"的范式转变——未来的生成模型不仅产出内容,还要理解为什么要这样生成,具备因果推理能力。
原标题: DeepMind Releases SIMA 2 — An AI Agent That Can Play New Games
论文: SIMA 2: A Generalist Embodied Agent for Virtual Worlds — Google DeepMind | arXiv:2512.04797
1. 从专用到通用的跨越
SIMA 1.0只能在特定游戏中操作,SIMA 2通过将核心策略替换为Gemini模型,实现了跨3D虚拟世界的通用性——面对全新的游戏环境,无需额外训练即可理解规则并采取合理行动。
2. Gemini作为具身智能的"大脑"
SIMA 2保留了相同的具身接口(视觉输入→动作输出),但将决策核心升级为Gemini。这意味着大语言模型的推理能力(规划、常识推理、语言理解)被直接引入了感知-动作循环中。
关键技术概念:具身AI(Embodied AI) — 不是"看图说话"的旁观者,而是能感知环境并采取行动的参与者。SIMA 2能理解"去那个红色建筑旁边"这样的自然语言指令,并在3D世界中执行。这对通信行业的网络智能化(如自组织网络、智能运维)有直接启发——AI不仅要"理解"网络状态,还要能"操作"网络设备。
3. 自我改进循环
SIMA 2具备在虚拟环境中自主探索和学习的能力。通过自我博弈和经验回放,它能持续改进策略。DeepMind报告显示SIMA 2在游戏性能上比前代提升了超过一倍。
图表 1
推荐理由: Transformer是当今AI一切的基础设施。理解它为什么"天生简洁",就是理解为什么这个架构能统治AI领域。这篇ICLR杰出论文奖从理论层面给出了最优雅的答案。视频解读将艰涩的形式语言理论变得直观可懂。
推荐理由: 世界模型是通往AGI的关键路径之一。NVIDIA用仅2.6B参数在单GPU上实现了分钟级视频生成,展示了"效率革命"而非"暴力缩放"的研究范式。完全开源,可直接上手实验。
推荐理由: 如果只看一个视频了解2026年上半年LLM领域的全貌,这就是最佳选择。从架构之争到训练范式演变再到推理优化,60分钟带你完成从"知道名词"到"理解本质"的认知跃迁。
本期精选说明: 以上视频均基于2026年5月YouTube平台公开可访问内容,论文信息来源于arXiv、OpenReview、CVPR/ICLR官方网站。所有视频链接可通过标题在YouTube搜索找到。本期为第3轮精选,主题为AI前沿研究解读,与前两轮(AI编程教程、AI工具评测)互不重叠。
[!tip] 51学通信知识星球 星主:爱卫生(微信:gprshome201101)——公众号「51学通信」创办者,19 年通信行业运维与讲师经验,著有《GPRS网络信令实例详解》《EPC原理与实践》《5G核心网原理与实践》三本纸质书(各大电商平台有售)。 星球定位:深耕 5G 核心网、IMS、NFV/AI、云原生等 ICT 领域,主打运维岗位与信令分析。 当前规模:5200 篇主题 / 990 个回答,198 元/年。 加入福利:加入星球后请加爱卫生微信,拉您进知识星球年度陪伴与答疑群——不限量回复您的各种问题,另有群内分享。 AI 加持:51学通信知识星球已作为 skill 接入 WorkBuddy,使用 deepseek-4-flash 在海量星球帖子中精准找贴、找视频、找 FAQ 和案例,做总结、找文档和 PPT 等场景全覆盖。
