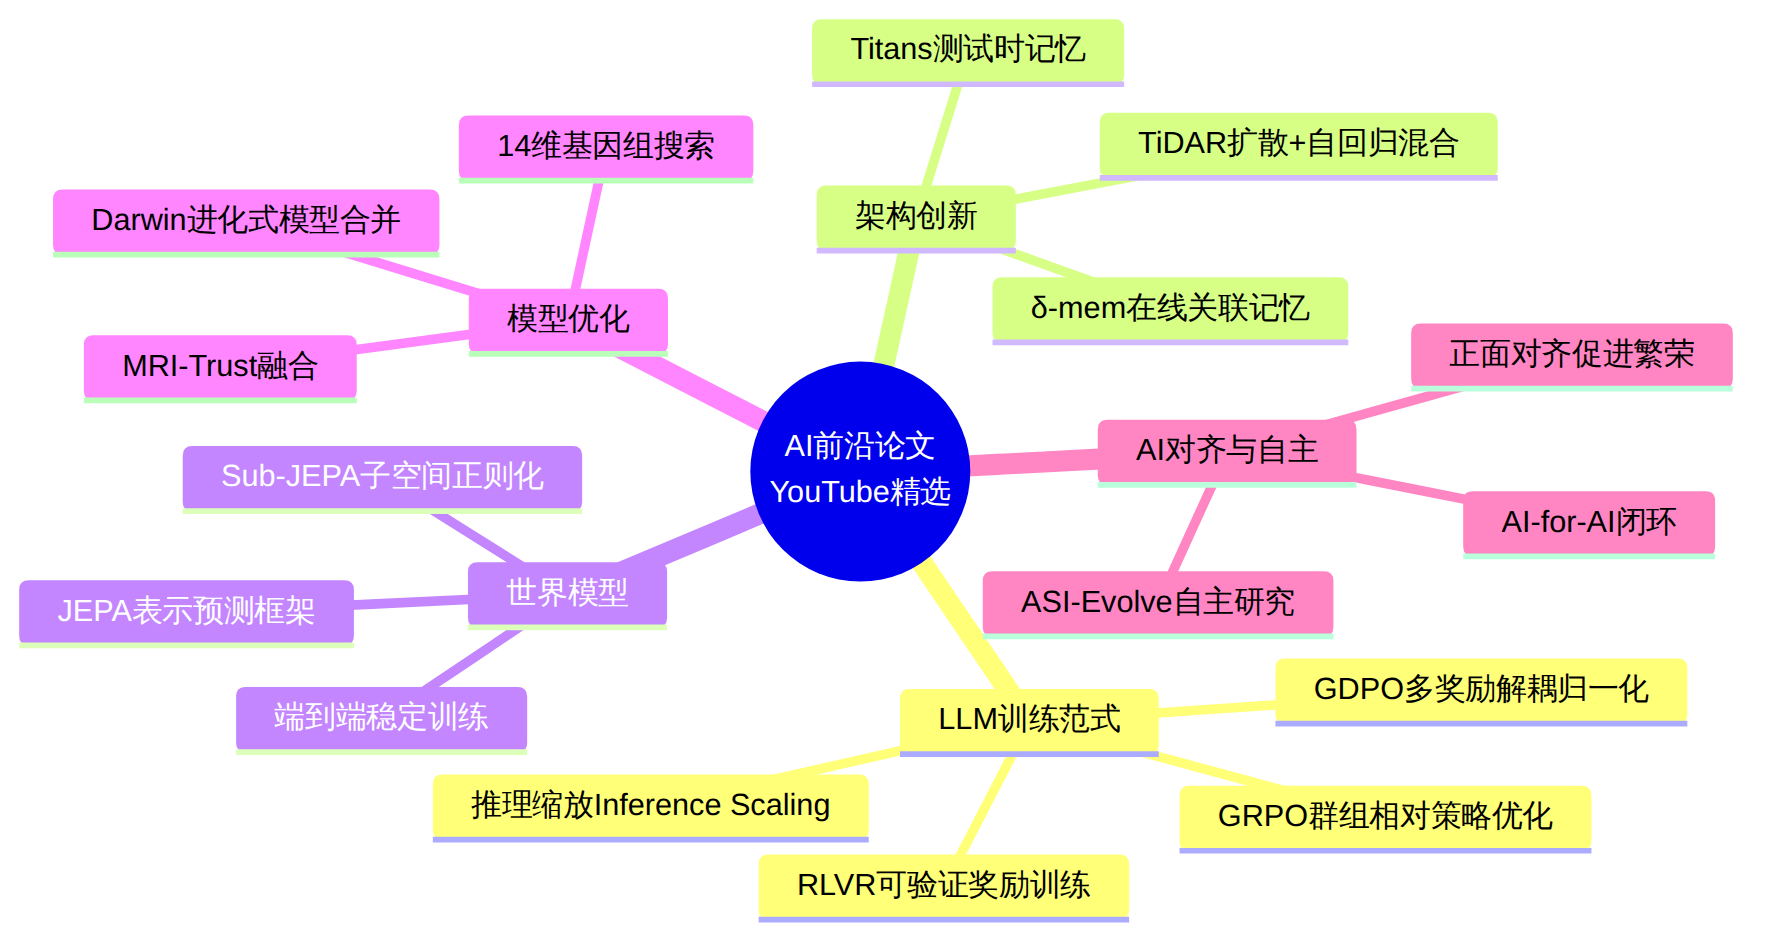
2026年5月,AI学术研究视频生态迎来爆发期——从NVIDIA的GDPO多奖励强化学习优化,到Google的Titans测试时记忆架构,再到上海交大的ASI-Evolve自主AI研究框架,前沿论文的YouTube解读正成为跟踪学术进展的第一窗口。本期精选8个高质量视频,覆盖LLM训练范式革新、世界模型稳定性、视觉推理强化学习、模型合并进化、AI对齐新范式五大方向。无论是通信行业从业者想理解6G智能化的底层算法逻辑,还是AI工程师追踪最新技术突破,这份精选都能帮你高效锁定最值得投入时间的内容。
| 序号 | 标题(中/英) | 频道 | 时长 | 推荐指数 |
|---|---|---|---|---|
| 1 | 2026年LLM现状:RLVR、GRPO与推理缩放 / State of LLMs 2026: RLVR, GRPO, Inference Scaling | MAD Podcast (with Matt Turck) | ~60min | ★★★★★ |
| 2 | GDPO详解:NVIDIA修复GRPO用于LLM强化学习 / GDPO Explained: NVIDIA Fixes GRPO for LLM RL | AI Papers Academy | ~20min | ★★★★★ |
| 3 | ASI-Evolve:AI加速AI / ASI-EVOLVE: Autonomous LLM Research Framework | AI Research Roundup | ~15min | ★★★★☆ |
| 4 | TiDAR:扩散中思考,自回归中表达 / TiDAR: Think in Diffusion, Talk in Autoregression | Yannic Kilcher | ~30min | ★★★★★ |
| 5 | δ-mem:LLM的高效在线记忆 / δ-mem: Efficient Online Memory for LLMs | AI Research Roundup | ~12min | ★★★★☆ |
| 6 | Sub-JEPA:稳定端到端世界模型 / Sub-JEPA: Stable World Models with Subspace Gaussian | AI Research Roundup | ~14min | ★★★★☆ |
| 7 | Darwin家族:无训练LLM推理能力合并 / Darwin: Evolutionary Merging for LLM Reasoning | AI Research Roundup | ~13min | ★★★★☆ |
| 8 | 正面对齐:AI促进人类繁荣 / Positive Alignment: LLMs for Human Flourishing | AI Research Roundup | ~11min | ★★★★☆ |
频道介绍:The MAD Podcast with Matt Turck,聚焦数据驱动创业与AI技术的深度访谈播客。本期嘉宾Sebastian Raschka是知名独立AI研究员、《Build a Large Language Model From Scratch》作者,在LLM领域拥有极高的技术公信力。
核心要点:
RLVR(Reinforcement Learning from Verifiable Rewards)正取代传统RLHF:传统RLHF依赖人类标注偏好,成本高且信号模糊。RLVR利用可验证奖励(如数学答案的正误、代码的测试通过率),让LLM推理训练的奖励信号精确且可规模化。对通信领域而言,这意味着协议一致性验证、信令流程正确性判断都可以转化为RLVR的奖励信号。
GRPO正在成为训练推理LLM的标准方法:Group Relative Policy Optimization(群组相对策略优化)由DeepSeek团队提出,核心思想是:同一组采样回答中,用组内相对排名而非绝对分数来指导策略更新。避免了传统PPO需要单独训练Critic网络的额外开销。2026年已成为开源LLM推理训练的事实标准。
推理缩放(Inference Scaling)的重要性被低估:传统观点认为训练时缩放(更多数据、更大模型)是提升能力的唯一路径。但推理缩放——通过搜索策略(如Best-of-N采样、树搜索、思维链延长)在推理时投入更多计算——被证明能以更低成本获得显著性能提升。这对资源有限的通信设备端AI部署尤为关键。
观看建议:适合有基础ML知识的工程师和研究者。推荐完整观看,Raschka的讲解逻辑清晰。如果时间有限,前30分钟覆盖架构趋势和训练范式变迁,最为精华。
延伸资源: - 论文:Sebastian Raschka 个人博客 sebastianraschka.com - 相关:GRPO原论文,DeepSeek-R1技术报告 - 视频链接:YouTube
频道介绍:AI Papers Academy,加拿大频道,34.5K订阅,专注于将复杂AI论文转化为清晰易懂的视频讲解,已有82个视频覆盖LLM研究论文的核心概念。
核心要点:
多奖励RL训练的核心矛盾:实际LLM训练中,我们往往同时追求多个目标——准确性、安全性、有用性、格式规范等。标准GRPO将多个奖励简单求和,导致不同奖励信号相互干扰,某个奖励的方差可能淹没其他奖励的有效信号。
GDPO的解耦归一化方案:Group reward-Decoupled Normalization Policy Optimization 的核心创新是对每个奖励维度独立进行组内归一化(Group Normalization),再组合。这确保了每个奖励信号的相对强度被正确保留,不会因量纲差异而被吞没。
无额外计算开销的性能提升:GDPO在NVIDIA的实验中,以8B参数模型配合GRPO+GDPO训练后,性能可比肩甚至超越GPT-5级别模型在部分基准上的表现,且不增加训练计算量。
关键技术概念:
奖励崩溃(Reward Collapse):当多个奖励信号被简单相加时,如果某个奖励方差很大(如安全性评分0或1),它会压制方差较小的奖励(如流畅性评分0.7-0.9),导致模型实际上只优化了那个高方差奖励,忽略了其他维度。GDPO通过独立归一化解决了这一问题。
观看建议:适合正在做LLM微调或RL训练的工程师。视频约20分钟,技术密度高,建议配合论文一起看。对通信行业,如果需要训练领域专用LLM同时兼顾协议准确性和回复有用性,GDPO提供了直接可用的方法论。
延伸资源: - 论文:GDPO (arXiv:2601.05242) - 代码:github.com/NVlabs/GDPO - 视频链接:YouTube
频道介绍:AI Research Roundup,6.15K订阅,由Alex主持,系统性地解读arXiv热门AI论文,每周更新多个视频,是跟踪学术前沿的高效渠道。
核心要点:
AI驱动AI研究的闭环:上海交通大学提出的ASI-Evolve是首个在三个核心AI研究任务上实现AI自主驱动的统一框架:训练数据合成、奖励模型设计、训练配方优化。这意味着AI不再只是辅助工具,而是在自主完成"提出假设→实验→分析→改进"的完整科研循环。
进化式搜索策略:框架采用进化算法(Evolutionary Search),将AI训练方案编码为"基因组",通过变异、交叉、选择操作在方案空间中搜索最优配置。类比通信网络中的参数优化,这种进化搜索可以自动化找到最优的模型训练超参数组合。
实验验证的突破性成果:在多个基准上,ASI-Evolve发现的训练配方超越了人类专家手工设计的方案。特别是在长推理链任务上,进化搜索找到的数据合成策略使模型性能提升了显著幅度。
关键技术概念:
AI-for-AI:用AI系统来加速和改进AI自身的研究与开发。这不是简单的超参数搜索,而是让AI系统理解研究问题、设计解决方案、执行实验、分析结果,形成一个自主改进的闭环。对通信行业的启示是:类似的自动化框架可以用于网络协议优化、参数调优等场景。
观看建议:约15分钟的浓缩讲解,适合所有人快速了解前沿。如果对自动化研究框架感兴趣,推荐进一步阅读论文。
延伸资源: - 论文:ASI-Evolve (arXiv:2603.29640) - HuggingFace论文页:papers/2603.29640 - 视频链接:YouTube
频道介绍:Yannic Kilcher,313K+订阅,AI论文解读领域的标杆频道。以深度技术分析和独到见解著称,每个视频都是对论文的逐层解剖,而非简单摘要。
核心要点:
混合架构的突破:TiDAR是NVIDIA提出的序列级混合架构——在"思考"阶段使用扩散模型(Diffusion)并行生成token草稿,在"表达"阶段使用自回归(Autoregression)精炼输出。这打破了此前"要么全自回归、要么全扩散"的二选一困局。
4.71x-5.43x的加速比:TiDAR在保持与纯自回归模型质量持平的前提下,实现了近5倍的推理加速。关键在于扩散阶段的并行token生成:传统自回归一次只生成一个token,而扩散可以同时生成整个序列块的草稿。
MLSys 2026收录:该论文已被MLSys 2026接收,说明系统社区对其工程价值的认可。对通信行业而言,这种"扩散草稿+自回归精炼"的思路可以类比为:先快速广播一个粗略的网络配置方案,再逐节点精确调整。
关键技术概念:
扩散语言模型 vs 自回归模型:自回归模型(如GPT系列)从左到右逐token生成,每个token依赖前面所有token,推理时无法并行。扩散语言模型借鉴图像生成的扩散过程,从噪声出发,通过多步去噪同时生成整个序列。速度快但质量曾不如自回归。TiDAR将两者结合:扩散负责"快思考",自回归负责"精表达"。
观看建议:Yannic的视频通常30分钟左右,技术分析深入。建议有一定Transformer基础后再看。该视频值得完整观看,他对扩散模型用于语言生成的可行性分析非常精彩。
延伸资源: - 论文:TiDAR (arXiv:2511.08923) - MLSys 2026 Poster:mlsys.org/virtual/2026/poster/3528 - 视频链接:YouTube
频道介绍:AI Research Roundup,同前述。本期解读2026年5月12日发布的最新论文,是目前LLM记忆机制领域最前沿的工作之一。
核心要点:
"塞上下文不是记忆"的核心洞察:当前LLM处理长对话的方式是把历史消息塞进上下文窗口,但这不是真正的记忆——它既不高效(计算量随长度二次增长),也不持久(超出窗口就遗忘)。δ-mem引入了一个轻量级的在线关联记忆模块。
8×8关联记忆矩阵:δ-mem在冻结的LLM骨干网络上附加一个仅8×8维度的关联记忆矩阵,通过delta规则(经典的Hebbian学习变体)在线更新。这个极小的附加模块让LLM能够"记住"跨对话的长期信息,而参数量增加几乎可以忽略。
在线学习的范式创新:与需要大量离线训练的记忆方案不同,δ-mem在推理时实时更新记忆——每处理一条新信息,就用delta规则调整记忆矩阵。这类似于人类在对话中自然记住关键事实,无需专门的"复习"过程。
关键技术概念:
Delta学习规则:一种经典神经网络学习规则,核心公式为 Δw = η(t - y)x,其中t是目标输出,y是实际输出,x是输入。δ-mem将其改造为适用于Transformer注意力机制的在线记忆更新,使LLM在不重新训练的情况下持续积累知识。对通信行业而言,这种在线学习范式可用于网络状态记忆、用户行为建模等场景。
观看建议:约12分钟,信息密度高。适合关注LLM Agent和长期记忆的工程师。论文发布于2026年5月,属于极新工作。
延伸资源: - 论文:δ-mem (arXiv:2605.12357) - 代码:github.com/declare-lab/delta-Mem - 视频链接:YouTube
频道介绍:AI Research Roundup。本期解读Joint-Embedding Predictive Architecture(JEPA)家族的最新进展,与Yann LeCun主张的世界模型路线直接相关。
核心要点:
JEPA的模型坍塌问题:JEPA框架(Yann LeCun力推的架构)通过预测潜在表示而非像素来学习世界模型,但训练中容易出现表示坍塌——模型学会输出常数表示,完全丢失信息。Sub-JEPA通过子空间高斯正则化解决了这一稳定性问题。
从特征空间到子空间的正则化迁移:传统方法在特征空间施加高斯噪声进行正则化,但这会破坏学到的表示结构。Sub-JEPA将正则化迁移到子空间中,只对表示的不重要维度添加约束,保留关键语义信息。类比通信中的信号处理:只对噪声子空间进行抑制,保护信号子空间。
端到端训练的世界模型:解决了稳定性问题后,Sub-JEPA可以实现真正端到端的世界模型训练——从感知到预测一体化,无需分阶段训练。这对机器人控制、自动驾驶等需要预测环境动态的场景意义重大。
关键技术概念:
世界模型(World Model):AI系统内部对外部环境的内部模拟器。JEPA(Joint-Embedding Predictive Architecture)是Meta AI首席科学家Yann LeCun提出的学习框架:不预测原始输入(如像素),而是在抽象表示空间中预测未来状态。这更接近人类认知方式——我们不预测眼前的每个像素,而是理解场景的抽象结构。
观看建议:约14分钟。建议先了解JEPA基本概念(可参考Yann LeCun的公开演讲),再观看此视频。对理解Yann LeCun"预测表示而非像素"的学术路线非常有帮助。
延伸资源: - 论文:Sub-JEPA (arXiv:2605.09241) - 代码:github.com/intcomp/Sub-JEPA - 视频链接:YouTube
频道介绍:AI Research Roundup。本期解读一种无需训练的LLM推理能力提升方法——通过进化算法合并多个已有模型。
核心要点:
无训练的推理能力提升:Darwin Family的核心思想是:不需要从头训练或微调,通过智能合并多个已有的专业模型(如数学推理、代码生成、逻辑推理的专家模型),就可以获得推理能力的跃升。合并过程使用进化算法搜索最优参数组合。
14维自适应合并基因组:框架将模型合并问题编码为一个14维的"基因组",每个维度控制不同层、不同组件的参数混合比例。进化算法通过变异和交叉操作在基因组空间中搜索最优合并方案。
MRI-Trust融合机制:MRI(Model-layer Response Importance,模型层响应重要性)诊断每一层对推理任务的贡献度,Trust权重自适应平衡MRI诊断信号与进化搜索信号。简单说:不是所有层都同等重要,需要根据任务动态调整。
关键技术概念:
模型合并(Model Merging):将多个已训练模型的参数按一定比例混合,生成一个新模型。无需额外训练数据或计算资源。代表性方法包括Spherical Linear Interpolation(SLERP)、Task Arithmetic等。Darwin的创新在于用进化算法自动搜索最优合并方案,替代人工调参。
观看建议:约13分钟。适合关注模型压缩、知识蒸馏或资源高效AI部署的工程师。通信行业在边缘部署AI时,模型合并提供了一种"多能力集成"的高效路径。
延伸资源: - 论文:Darwin Family (arXiv:2605.14386) - ICLR 2026收录 - 视频链接:YouTube
频道介绍:AI Research Roundup。本期解读的论文由Google DeepMind、OpenAI、Anthropic的研究者联合撰写,代表了对AI对齐研究的范式转换。
核心要点:
从"避免伤害"到"促进繁荣":现有AI对齐研究几乎全部聚焦于安全——防止有害输出、拒绝危险请求。这篇论文提出"正面对齐"(Positive Alignment)范式:AI不应仅仅"不做坏事",而应该主动促进人类福祉、创造力发展和能力增强。
类比心理学的范式转换:论文将当前AI对齐类比于早期心理学只关注精神疾病的阶段——必要但不完整。正如积极心理学补充了病理心理学,正面对齐补充了安全对齐。AI系统应该帮助用户变得更有创造力、更高效、更有洞察力。
跨机构联合研究的意义:Google DeepMind、OpenAI、Anthropic三大AI实验室联合发表这篇论文,暗示业界在对齐研究方向上正在形成新共识——安全性是底线,但AI的终极目标应该是增强人类。
关键技术概念:
AI对齐(AI Alignment):确保AI系统的行为符合人类意图和价值观。传统对齐关注"负面对齐"(防止伤害),包括RLHF、Constitutional AI等方法。正面对齐(Positive Alignment)提出新维度:AI不仅要避免有害行为,还应该主动识别并支持有利于人类发展的行为模式。
观看建议:约11分钟。适合所有对AI伦理和未来发展方向感兴趣的观众。论文的跨机构联合署名使其具有行业风向标意义。
延伸资源: - 论文:Positive Alignment (arXiv:2605.10310) - 报道:The AI Insider - 视频链接:YouTube
图表 1
理由:Sebastian Raschka以一己之力讲清了2026年LLM领域从架构到训练到推理的全景图。RLVR、GRPO、推理缩放三个概念的理解,是跟上2026年AI技术对话的基础门票。60分钟的投资回报率极高——看完这个视频,你对当前LLM技术栈的理解将超越90%的从业者。
理由:GRPO是2026年LLM推理训练的基石方法,但标准GRPO在多奖励场景下的缺陷一直是工程实践中的痛点。GDPO给出了优雅的解决方案,且已开源。20分钟的讲解将一个看似复杂的数学方案拆解得清晰可操作。如果你正在做任何形式的LLM RL训练,这是必看内容。
理由:扩散模型用于语言生成一直存在质量差距,TiDAR是首个通过混合架构(扩散草稿+自回归精炼)实现质量与速度双赢的方案。Yannic Kilcher的深度分析不仅解读了论文,更探讨了"扩散是否真的适合语言"这一根本性问题。近5倍的加速比暗示着LLM推理成本可能迎来量级下降,这对所有人都有直接影响。
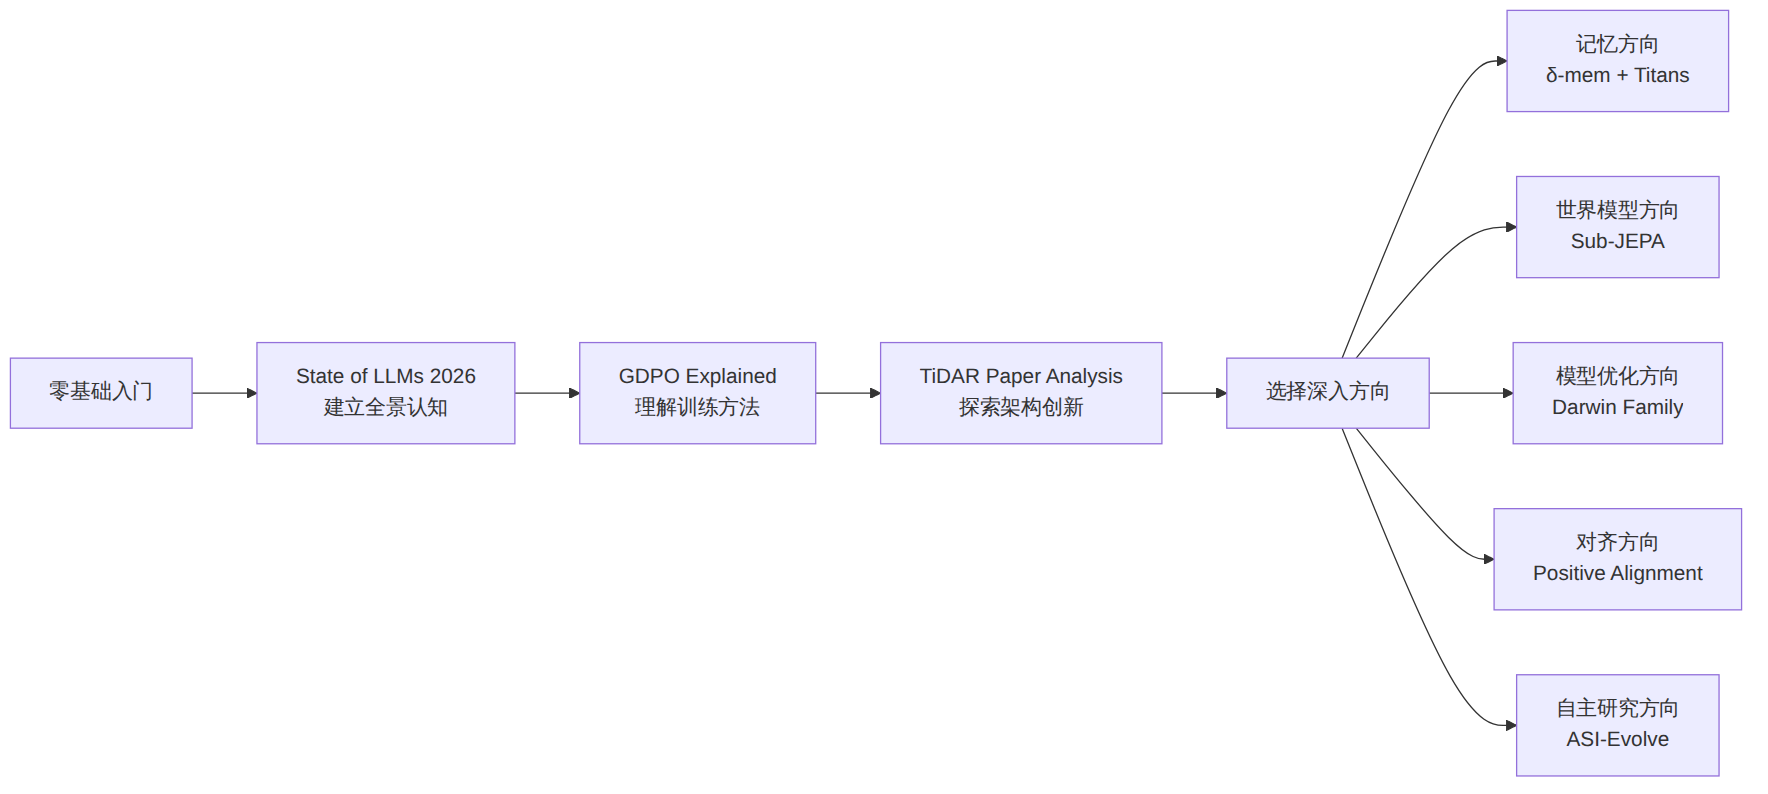
图表 2
如果你只有30分钟,看GDPO视频;如果只有60分钟,看Sebastian Raschka的全景访谈;如果有一整个周末,按上述路径逐个观看,你将对2026年5月的AI前沿研究有全面而深入的理解。
[!tip] 51学通信知识星球 星主:爱卫生(微信:gprshome201101)——公众号「51学通信」创办者,19 年通信行业运维与讲师经验,著有《GPRS网络信令实例详解》《EPC原理与实践》《5G核心网原理与实践》三本纸质书(各大电商平台有售)。 星球定位:深耕 5G 核心网、IMS、NFV/AI、云原生等 ICT 领域,主打运维岗位与信令分析。 当前规模:5200 篇主题 / 990 个回答,198 元/年。 加入福利:加入星球后请加爱卫生微信,拉您进知识星球年度陪伴与答疑群——不限量回复您的各种问题,另有群内分享。 AI 加持:51学通信知识星球已作为 skill 接入 WorkBuddy,使用 deepseek-4-flash 在海量星球帖子中精准找贴、找视频、找 FAQ 和案例,做总结、找文档和 PPT 等场景全覆盖。
