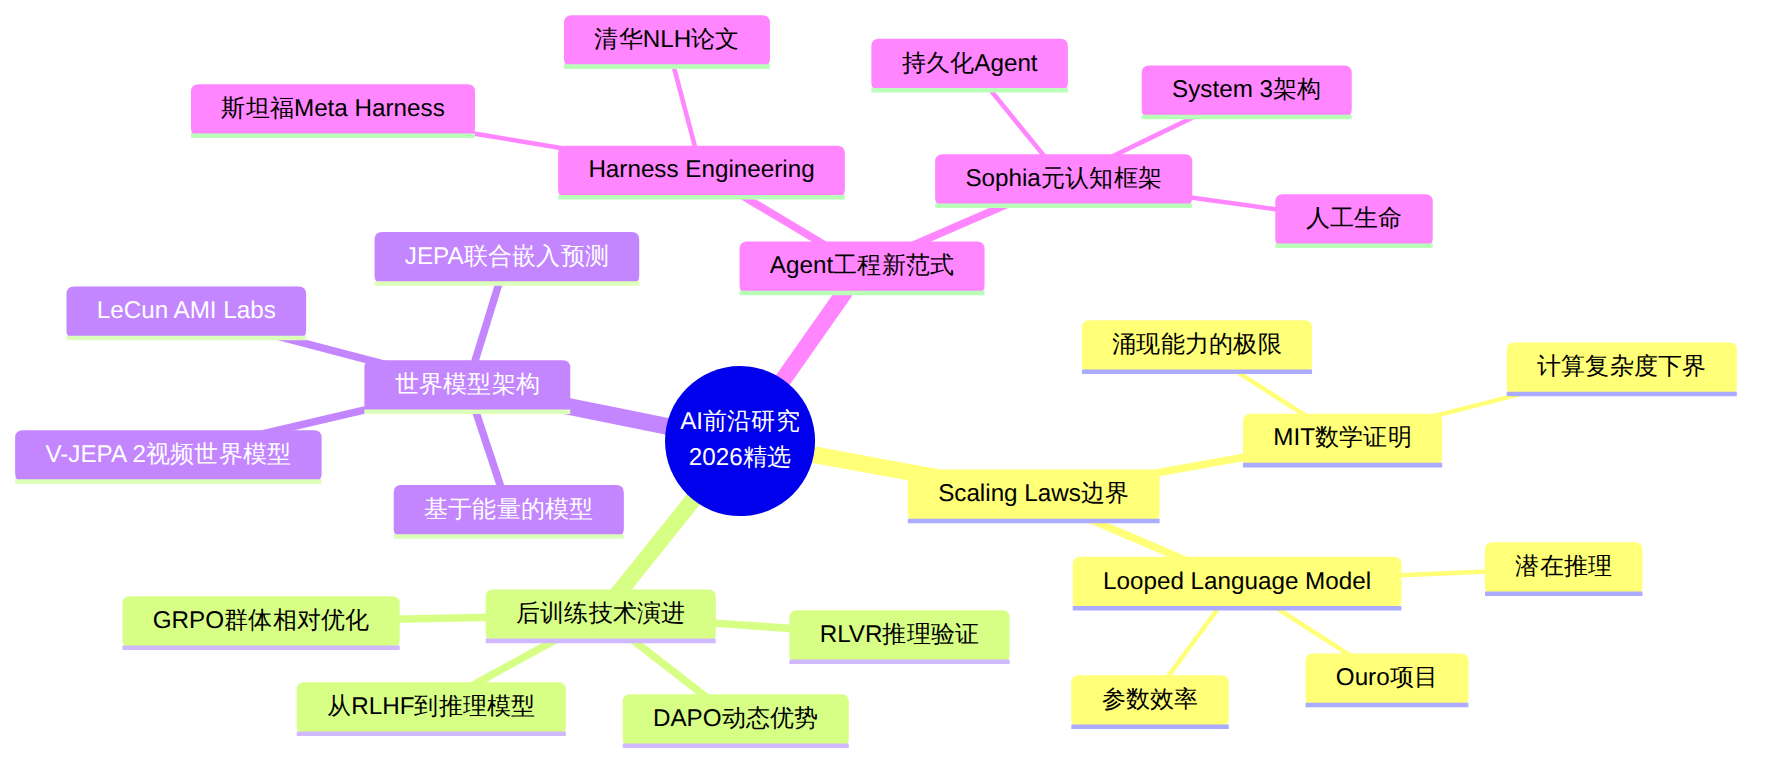
2026年上半年,AI学术界迎来了一波密集的范式挑战。MIT用严格的数学证明揭示了LLM Scaling Laws面临的天花板,Google DeepMind和Meta在World Model方向上展开激烈竞赛,清华大学和斯坦福分别提出了"Harness Engineering"这一全新工程学科,而Yann LeCun更是在离开Meta后创立AMI Labs获得10亿美元融资,押注JEPA架构。与此同时,Ouro项目提出的Looped Language Model为推理能力开辟了不依赖参数扩展的新路径。本期精选7个深度解读视频,覆盖Scaling Laws边界、后训练技术演进、世界模型架构、元认知Agent框架四大前沿方向,为通信行业技术人员梳理2026年AI研究最关键的认知升级。
| 序号 | 视频标题(中/英) | 频道 | 时长 | 推荐指数 |
|---|---|---|---|---|
| 1 | 为什么LLM将撞墙 / Why LLMs Will Hit a Wall (MIT Proved It) | Parthknowsai | ~18min | ★★★★★ |
| 2 | LLM不需要更多参数,需要循环 / LLMs Don't Need More Parameters. They Need Loops | Vizuara AI | ~15min | ★★★★★ |
| 3 | 2026年LLM状态:RLVR、GRPO、推理扩展 / State of LLMs 2026: RLVR, GRPO, Inference Scaling | MAD Podcast × Sebastian Raschka | ~65min | ★★★★★ |
| 4 | 世界模型解读:JEPA与基于能量的学习 / World Models Explained: JEPA, Energy-Based Learning and the Limits of LLMs | deepsense.ai | ~45min | ★★★★☆ |
| 5 | NVIDIA GTC 2026 AI研究突破 / AI Research Breakthroughs from NVIDIA Research | NVIDIA × Two Minute Papers | ~55min | ★★★★☆ |
| 6 | 重新思考AI Agent:Harness工程学的崛起 / Rethinking AI Agents: The Rise of Harness Engineering | 多频道解读 | ~20min | ★★★★☆ |
| 7 | Sophia解读:持久化人工生命的元认知框架 / Sophia: A Meta-Cognitive Framework for Persistent AI | SciPulse | ~25min | ★★★★☆ |
图表 1
Why LLMs Will Hit a Wall (MIT Proved It)
Parthknowsai专注于AI前沿论文的通俗解读,以清晰的数学推导和直觉解释见长,在AI研究者社区有较高影响力。
1. Scaling Laws的数学天花板
MIT研究人员于2026年1月发表了一篇关于Scaling Laws的论文,从信息论和计算复杂度角度严格证明了:LLM的性能提升随着参数规模增长将遭遇递减边际收益。这并非经验观察,而是数学上的必然结论。论文指出,模型规模每增加10倍,某些涌现能力的提升幅度呈对数衰减,最终趋近于平台期。
Scaling Laws(缩放定律):指模型性能与参数量、数据量、计算量之间的幂律关系。Kaplan等人在2020年首次系统提出,是过去几年推动大模型"越大越好"策略的理论基础。MIT论文的核心挑战在于:这种幂律关系在特定能力维度上存在数学上可证明的边界。
2. 涌现能力的计算下界
论文给出了LLM在特定推理任务上的计算复杂度下界证明——某些任务(如多层逻辑推理、数学证明验证)本质上需要模型具备超越前馈计算的架构能力,单纯堆叠参数无法突破这一障碍。这与通信领域的Shannon极限有异曲同工之处:信道容量存在理论上限,同样地,特定计算范式下的模型能力也存在不可逾越的边界。
3. 递减收益的实证数据
视频结合MIT论文的实验数据,展示了当模型参数从100B扩展到1T、10T时,在标准基准测试上的提升曲线逐渐平坦。尤其值得关注的是,在需要多步推理的数学和编程任务上,收益递减趋势最为明显。
4. 替代路径讨论
论文并未否定AI的发展潜力,而是指出需要架构创新而非单纯规模扩展。这为Looped Transformer、世界模型、神经符号系统等替代方向提供了理论支撑。
LLMs Don't Need More Parameters. They Need Loops.
Vizuara AI是一家AI研究教育频道,专注于前沿论文的技术深度解读,尤其擅长将复杂的算法原理拆解为可理解的步骤。本视频由论文作者亲自讲解。
1. LoopLM——循环语言模型的核心思想
传统LLM通过增加Transformer层数和参数量来提升能力。Ouro项目(论文"Scaling Latent Reasoning via Looped Language Models")提出了一个根本不同的思路:让同一组Transformer层反复执行多次,通过"循环"而非"堆叠"来实现更深的推理。这类似于通信中的迭代译码(Iterative Decoding)思想——用有限硬件资源通过多次迭代逼近最优解。
Looped Language Model(循环语言模型):将标准Transformer的一组层视为可重复调用的模块,在推理时循环执行N次。每次循环都在"潜在空间"中进行推理(Latent Reasoning),不生成中间文本token,而是在隐藏状态中持续精炼推理链。这与Chain-of-Thought(CoT)的显式推理不同——LoopLM在"脑子里思考"而非"嘴上说出来"。
2. 潜在推理(Latent Reasoning)
论文最关键的贡献在于"潜在推理"机制。标准CoT需要模型输出完整的推理步骤文本,而LoopLM在隐藏状态空间中直接进行多轮信息精炼。这意味着: - 推理过程不消耗输出token带宽 - 计算量可控(通过调整循环次数) - 在参数量固定的前提下,推理能力随循环次数提升
3. Scaling新维度——计算深度替代参数宽度
Ouro论文定义了一条全新的Scaling轴:推理时的计算深度。传统Scaling Laws沿"参数量"维度扩展,而LoopLM沿"循环次数"维度扩展。实验证明,一个循环8次的350M参数模型,在某些推理任务上可以媲美不循环的3B参数模型。
4. Ouroboros的隐喻
项目以"衔尾蛇"(Ouroboros)命名,寓意模型自我递归、不断精炼的特性。论文已开源模型权重和训练代码,社区可以复现实验结果。
State of LLMs 2026: RLVR, GRPO, Inference Scaling
Sebastian Raschka是《Build a Large Language Model (From Scratch)》和《Build a Reasoning Model From Scratch》作者,威斯康星大学统计学教授,在ML教育和研究社区享有极高声誉。MAD Podcast聚焦数据与AI产业的深度访谈。
1. 从RLHF到GRPO的后训练演进
Raschka系统梳理了2024-2026年后训练技术的代际演进: - RLHF(2023):基于人类反馈的强化学习,需要训练Reward Model,流程复杂且不稳定 - DPO(2024):直接偏好优化,省去Reward Model,将偏好学习转化为分类问题 - GRPO(2025-2026):群体相对策略优化,DeepSeek R1的核心技术,用同一问题的多个采样答案互相对比来训练,无需额外Reward Model,训练效率大幅提升
GRPO(Group Relative Policy Optimization):对同一个prompt采样多个回答,组内互相对比评分,用相对排名来优化策略。类比通信中的信噪比——不是绝对测量信号强度,而是比较不同信号之间的相对质量。
2. RLVR——推理验证的新范式
Raschka特别强调了RLVR(Reinforcement Learning with Verifiable Rewards)的突破性意义。传统RLHF依赖人类标注的偏好数据,RLVR则让模型在数学、编程等可验证领域通过自动验证器获得奖励信号。这解决了训练数据瓶颈问题——数学题的对错可以程序化判定,不需要人类标注。
3. Inference Scaling——推理时计算的扩展
不同于训练时的Scaling,Inference Scaling关注的是:模型在推理时投入更多计算能获得多大性能提升。这包括: - 多次采样 + 选择最佳答案(Best-of-N) - 更长的CoT推理链 - 自我验证与修正
这一范式与通信中的"自适应调制编码"(AMC)有相似之处——根据任务难度动态分配计算资源。
4. DeepSeek R1的成本效率启示
Raschka详细分析了DeepSeek R1如何以极低成本对标OpenAI o1——核心在于GRPO + RLVR的组合使得推理能力的训练不再需要昂贵的RLHF管线。
World Models Explained: JEPA, Energy-Based Learning and the Limits of LLMs
deepsense.ai是一家AI咨询公司,其YouTube频道以高质量的技术教育内容著称,尤其在深度学习和计算机视觉领域。本视频由Michał主讲,系统性梳理了世界模型的理论谱系。
1. Yann LeCun的JEPA架构
视频详细解读了JEPA(Joint Embedding Predictive Architecture,联合嵌入预测架构)的设计哲学: - 传统生成模型(如GAN、扩散模型)在像素/Token空间预测未来状态 - JEPA在表征空间(Representation Space)中预测,只关注抽象特征层面的预测准确性 - 这种设计天然避免了重建无关细节的计算浪费,同时提供了更强的泛化能力
JEPA(联合嵌入预测架构):LeCun于2022年提出的学习范式。核心思想是:AI不应试图预测世界的每一个像素细节(如视频帧中每片树叶的精确位置),而应学习世界的抽象表征并在这个空间中进行预测。类比通信:我们不需要传输原始信号的所有细节,而是在压缩域中进行信息传递——这与信源编码的思想高度一致。
2. V-JEPA 2——Meta的视频世界模型
视频介绍了Meta于2025-2026年发布的V-JEPA 2,这是首个通过视频训练的世界模型,能够实现: - 视频理解与物理世界预测 - 机器人控制的能量最小化规划 - 基于视觉输入的行动规划
3. 基于能量的模型(Energy-Based Models)
视频清晰讲解了能量函数如何定义"合理的"世界状态:能量低的状态是合理的、可预测的;能量高的状态是异常的、不太可能的。规划过程就是搜索使能量最低的行动序列。这与通信中的最大似然译码在数学框架上有深刻联系。
4. LLM的根本局限性
视频从架构层面论证了为什么LLM(自回归Token预测)无法成为通用世界模型: - LLM在离散Token空间操作,无法自然处理连续的物理世界 - 自回归训练目标是"预测下一个Token",而非"理解世界运行规律" - 缺乏对物理约束(重力、碰撞、因果关系)的内在建模
AI Research Breakthroughs from NVIDIA Research (Hosted by Karoly of Two Minute Papers)
Two Minute Papers(Károly Zsolnai-Fehér)是AI研究领域最受欢迎的YouTube频道之一,以快速精准的论文解读闻名。本视频是GTC 2026的特别环节,由Károly主持,邀请多位NVIDIA顶级研究员进行圆桌讨论。
1. 预训练强化学习(RLP)
Yejin Choi教授介绍了RLP(Reinforcement Learning during Pre-training)概念——在预训练阶段引入自主探索目标,使模型在获取知识的同时发展推理能力。这改变了传统"先预训练、后对齐"的两阶段范式,将RL信号前置到预训练过程中。
2. 具身智能(Embodied AI)的新进展
多位研究员分享了NVIDIA在具身智能领域的突破,包括通过合成数据训练机器人操作策略、Sim-to-Real迁移的最新进展,以及OpenClaw和NemoClaw等Agentic AI平台的发布。
具身智能(Embodied AI):将AI集成到能够感知、推理和行动的物理系统中。这需要AI同时处理视觉、力觉、空间理解等多模态信息。对于通信行业,具身智能的发展意味着网络运维机器人、自动化基站维护等场景的技术基础正在成熟。
3. 推理时计算的优化
讨论了如何在推理时通过动态计算分配提升效率——简单问题用少量计算、复杂问题投入更多资源。NVIDIA展示了其硬件如何支持这种动态调度。
4. 多模态世界模型
NVIDIA分享了其多模态世界模型的研究进展,能够从视觉、语言、动作等多个维度理解和预测物理世界。
Rethinking AI Agents: The Rise of Harness Engineering
2026年3月,清华大学和斯坦福大学分别发表了两篇开创性论文,将"Harness Engineering"(缰绳工程学)正式定义为一门新的工程学科。多频道对此进行了深度解读。
1. 从Prompt Engineering到Harness Engineering
传统做法是精心设计Prompt来引导AI Agent。两篇论文指出,Agent性能越来越依赖于Harness——即包裹在LLM外部的基础设施层,包括工具定义、记忆管理、安全护栏、错误恢复机制等。Harness设计才是决定Agent可靠性的关键因素,而非Prompt措辞。
Harness(缰绳):指围绕LLM核心构建的工程基础设施,包括工具接口定义、上下文管理、错误处理、状态跟踪、安全约束等。类比通信协议栈——LLM是物理层(提供基础能力),Harness是上层的MAC/RLC/PDCP等协议层(将基础能力转化为可靠的端到端服务)。
2. 清华大学NLH论文
清华团队的"Natural-Language Agent Harnesses"(NLH)论文首次系统化定义了Harness的设计原则,提出了可度量的Harness质量评估框架。
3. 斯坦福Meta Harness论文
斯坦福团队的"Meta Harness"论文进一步提出:Harness本身也应该能够自适应调整——即用AI来优化AI Agent的外部基础设施。这种"元层面"的优化将Harness设计从手工工程推向自动化。
4. 工程意义
两篇论文的核心理念对通信行业的AI应用有直接指导意义:构建可靠的AI网络运维Agent,关键不在Prompt,而在构建健壮的Harness层——包括网络拓扑感知、故障诊断工具链、回滚机制等。
Sophia: A Meta-Cognitive Framework for Persistent Artificial Life
SciPulse专注于AI学术前沿论文的视频解读,以逻辑清晰、层层递进的讲解风格见长,覆盖从理论基础到工程实践的完整链条。
1. "System 3"——超越快慢双系统的元认知层
Sophia框架提出在人类认知的"System 1"(快速直觉)和"System 2"(慢速推理)之上,构建"System 3"——一个元认知架构层,能够监控、评估和调节自身认知过程。这不是简单的自我反思,而是一个持续运行的认知管理系统。
System 1/2/3认知模型:Kahneman的经典双系统理论中,System 1是快速直觉反应,System 2是深思熟虑的推理。Sophia提出的System 3是一个全新的元认知层——它监控System 1和2的运行状态,决定何时切换认知模式、何时需要更多推理资源、何时该信任直觉。类比通信网络管理:System 1是数据面(快速转发),System 2是控制面(策略计算),System 3是管理面(全局监控与策略优化)。
2. 持久化Agent的设计哲学
Sophia强调Agent的持久性——不是一次性任务执行器,而是能够持续存在、积累经验、发展个性的自主实体。论文将心理学构念映射为具体的计算模块,包括: - 情绪模型:影响决策权重 - 记忆分层:短期工作记忆 + 长期情景记忆 - 自我模型:Agent对自身能力的评估
3. 人工生命的视角
Sophia不将AI视为工具,而是从人工生命(Artificial Life)的视角设计Agent——追求自主性、适应性和持续进化。这是一个大胆的理论框架,虽然离工程落地还有距离,但为未来Agent设计提供了重要的理论参照。
4. 可靠性与透明性
论文论证了元认知架构如何提升Agent的可靠性:通过System 3的自我监控,Agent能够识别自身的不确定性、主动寻求帮助、避免过度自信的错误决策。
Sebastian Raschka用65分钟系统梳理了从RLHF到GRPO的后训练技术演进,是理解2026年LLM训练范式的最佳单一资源。对通信行业技术人员而言,理解GRPO和RLVR的技术原理,有助于评估未来AI在网络优化、故障诊断等场景中的能力边界。如果你只有时间看一个视频,看这个。
MIT论文提供了2026年AI领域最重要的理论贡献之一——用数学证明Scaling Laws存在天花板。这个结论将深刻影响整个AI产业的战略方向。对于通信行业,这意味着不能指望"等更大的模型来解决一切问题",而需要在领域知识、数据质量、工程架构上下功夫。
Ouro项目提出的Looped Language Model为"Scaling Laws天花板"问题提供了一个优雅的工程解——通过循环而非扩展来增加推理深度。对通信行业技术人员而言,这种"用有限资源通过迭代逼近最优"的思路与迭代译码、Turbo码的哲学一脉相承,理解门槛低、启发价值高。
本期精选的AI前沿研究对通信行业有几层直接的认知启示:
Scaling Laws的边界 → 网络智能化的务实路径:MIT证明了单纯扩大模型不能解决所有问题。通信网络中的AI应用同样如此——与其追求超大规模通用模型,不如构建领域专用的小模型 + 强Harness的工程架构。
LoopLM的循环推理 → 迭代优化范式的共性:LoopLM用循环替代堆叠的思路,与通信中的迭代译码、迭代信道估计等经典技术共享同一哲学——在有限计算预算下通过精炼逼近最优。
Harness Engineering → 网络运维Agent的设计方法论:清华和斯坦福的论文为构建可靠的AI网络运维系统提供了直接可用的框架——重点投资Harness层(工具链、安全护栏、回滚机制),而非过度优化Prompt。
World Model → 6G网络数字孪生:JEPA和世界模型的发展方向与6G网络的数字孪生愿景高度契合——在表征空间中预测和规划,而非模拟每个物理细节。
[!tip] 51学通信知识星球 星主:爱卫生(微信:gprshome201101)——公众号「51学通信」创办者,19 年通信行业运维与讲师经验,著有《GPRS网络信令实例详解》《EPC原理与实践》《5G核心网原理与实践》三本纸质书(各大电商平台有售)。 星球定位:深耕 5G 核心网、IMS、NFV/AI、云原生等 ICT 领域,主打运维岗位与信令分析。 当前规模:5200 篇主题 / 990 个回答,198 元/年。 加入福利:加入星球后请加爱卫生微信,拉您进知识星球年度陪伴与答疑群——不限量回复您的各种问题,另有群内分享。 AI 加持:51学通信知识星球已作为 skill 接入 WorkBuddy,使用 deepseek-4-flash 在海量星球帖子中精准找贴、找视频、找 FAQ 和案例,做总结、找文档和 PPT 等场景全覆盖。
