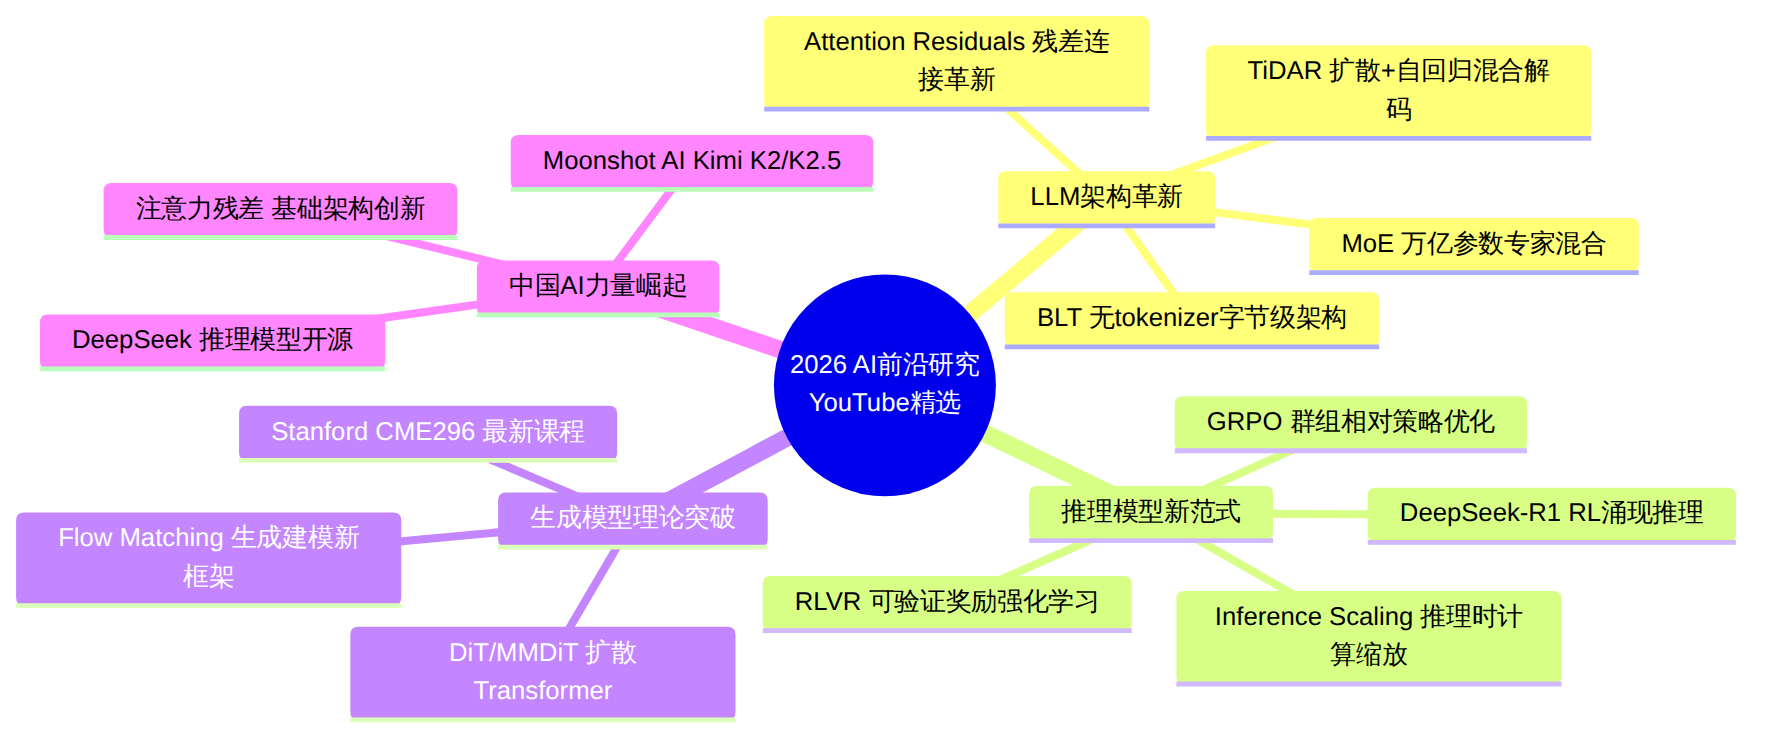
本轮精选聚焦YouTube上最值得观看的AI前沿研究解读视频,覆盖LLM架构革新、推理模型新范式、生成模型理论突破三大方向。从NVIDIA的TiDAR混合架构到Moonshot AI的Attention Residuals,从Meta的无tokenizer LLM到斯坦福最新的Diffusion课程,每一部都代表了2026年AI研究的最前沿。这些视频的创作者既包括Yannic Kilcher、Sebastian Raschka这样的顶级研究者/教育者,也有Stanford Online这样的官方学术频道,适合具有一定技术背景的观众深入学习。
| 序号 | 视频标题(中文) | 视频标题(英文) | 频道 | 时长 | 推荐指数 |
|---|---|---|---|---|---|
| 1 | TiDAR:扩散思考,自回归说话 | TiDAR: Think in Diffusion, Talk in Autoregression | Yannic Kilcher | ~25min | ★★★★★ |
| 2 | 字节级潜在Transformer:Patch胜过Token | Byte Latent Transformer: Patches Scale Better Than Tokens | Yannic Kilcher | ~30min | ★★★★★ |
| 3 | 注意力残差:Transformer以来最大升级? | Attention Residuals Explained | AI Savvy / 多频道 | ~15-20min | ★★★★☆ |
| 4 | 2026 LLM状态:RLVR、GRPO与推理缩放 | State of LLMs 2026: RLVR, GRPO, Inference Scaling | MAD Podcast × Sebastian Raschka | ~90min | ★★★★★ |
| 5 | DeepSeek-R1论文解读:RL开启推理新时代 | DeepSeek-R1 Paper Explained | AI Papers Academy | ~35min | ★★★★☆ |
| 6 | 斯坦福CS25:Transformer在扩散模型中的革命 | Stanford CS25: Transformers in Diffusion Models | Stanford Online | ~80min | ★★★★☆ |
| 7 | Flow Matching:生成建模的新范式 | Flow Matching for Generative Modeling | Yannic Kilcher | ~35min | ★★★★☆ |
| 8 | Kimi K2.5深度解析:万亿参数MoE如何工作 | How Moonshot AI Built the Best Multimodal Model — Kimi K2.5 | 技术深潜频道 | ~25min | ★★★★☆ |
视频链接: youtube.com/watch?v=taCVT5vDAk0
频道: Yannic Kilcher | 订阅数: 318K | 发布: 2025年末-2026年初
Yannic Kilcher是AI论文解读领域的标杆级创作者,拥有计算机视觉博士学位。他以逐公式推导、逐架构剖析的深度讲解风格闻名,是技术人员理解前沿论文的首选频道。
1. 混合解码架构的核心思想
TiDAR由NVIDIA提出,打破了LLM解码必须纯自回归(逐token生成)的传统。它引入了一个两阶段流程:先用扩散模型在"潜在空间"并行起草一段token序列("Think in Diffusion"),然后用自回归方式精细采样输出("Talk in Autoregression")。这种设计在保持生成质量的同时,显著提升了推理吞吐量。
2. 为什么扩散+自回归是可行的?
传统自回归模型(如GPT系列)每次只能生成一个token,序列越长延迟越高。TiDAR利用扩散模型可以并行生成多个token的特性,先快速"起草"一段草稿,再由AR模型精确化。关键创新在于两种解码方式共享同一个Transformer骨干网络,通过不同的注意力掩码(attention mask)切换模式。
3. 超越投机解码的性能
与传统的投机解码(Speculative Decoding)相比,TiDAR在吞吐量上实现了显著超越。投机解码依赖小模型猜测大模型的输出,而TiDAR通过扩散过程天然支持并行生成,在效率和生成质量之间取得了更优的平衡点。
4. 技术概念补充
视频链接: youtube.com/watch?v=loaTGpqfctI
频道: Yannic Kilcher | 订阅数: 318K
1. 告别Tokenizer的时代
Meta(Facebook AI Research)提出了Byte Latent Transformer(BLT),一种完全不需要tokenizer的LLM架构。传统LLM依赖BPE(Byte Pair Encoding)等tokenizer将文本分割为token,BLT直接在原始字节(byte)层面操作,消除了tokenizer带来的固定词汇表、多语言处理不均、对抗性输入脆弱等问题。
2. 动态Patch编码的精妙设计
BLT不直接处理每个字节(那样序列太长),而是根据信息熵将字节动态分组为"Patch"。高熵区域(如拼写变化多的词)分配更多计算资源,低熵区域(如常见前缀)则压缩为更少的Patch。这种"信息熵驱动"的编码方式让BLT在不同语言和任务间实现了自然的计算分配。
3. Patch Scale Better Than Tokens的实证
论文标题的"Patches Scale Better Than Tokens"并非噱头。在相同FLOPS预算下,BLT在多个基准测试中超越了使用tokenizer的模型。这意味着BLT在扩展性上具有结构性优势——随着计算量增加,Patch-based架构的效率增益比Token-based架构更显著。
4. 技术概念补充
视频链接: youtube.com/watch?v=znmNDoQm034
频道: AI Savvy / 多频道覆盖(包括Elon Musk Impressed话题视频、多个技术解读频道)
1. 残差连接的首次重大革新
自2015年ResNet提出、2017年Transformer采用残差连接(Residual Connection)以来,这一组件几乎未被质疑过。Moonshot AI(Kimi团队)发布的"Attention Residuals"论文首次系统性地指出:标准PreNorm残差连接通过固定权重累加所有层的输出,会导致深层网络信息衰减,并提出用softmax注意力机制替代固定权重累加。
2. 即插即用的架构改进
AttnRes(Attention Residuals的缩写)是一个drop-in replacement——只需替换现有Transformer中的残差连接模块,无需改变其他任何组件。这意味着已有的LLM可以在不重新设计架构的情况下,通过AttnRes获得性能提升。Moonshot AI已将其集成到Kimi Linear(48B参数的MoE模型)中。
3. 支持更深层网络训练
标准残差连接在层数极深时会出现梯度信号退化问题。AttnRes通过学习动态权重分配,使每一层都能获得有意义的梯度信号,从而支持训练更深的网络。这对于追求更大模型规模的团队具有重要意义。
4. 技术概念补充
视频链接: youtube.com/watch?v=K5WPr5dtne0
频道: MAD Podcast × Sebastian Raschka | 时长: ~90min
Sebastian Raschka是机器学习领域最知名的研究者-教育者之一,著有《Machine Learning with PyTorch and Scikit-Learn》等畅销书。他目前在独立进行LLM研究,同时是PyTorch Conference、PyCon等顶级会议的keynote演讲者。
1. RLVR——强化学习与可验证奖励的结合
RLVR(Reinforcement Learning with Verifiable Rewards)是2026年LLM训练最重要的范式之一。与传统的RLHF(人类反馈强化学习)不同,RLVR使用可自动验证的信号(如数学题的最终答案是否正确、代码是否通过测试)作为奖励信号,无需人类标注。这一方法由DeepSeek-R1率先大规模验证,随后被广泛采用。
2. GRPO——群组相对策略优化
GRPO(Group Relative Policy Optimization)是DeepSeek提出的强化学习算法,用于替代传统的PPO(Proximal Policy Optimization)。GRPO的核心改进在于:对同一问题生成多个回答,通过群组内的相对排名来计算优势函数(advantage),而非依赖绝对的价值函数估计。这大大简化了训练流程——不需要单独训练Value Network。
3. 推理时计算缩放(Inference-Time Compute Scaling)
这是2026年最热门的研究方向之一。核心洞察是:与其投入更多算力训练更大的模型(训练时缩放),不如让模型在推理时"想得更久"(推理时缩放)。通过增加推理时的token预算、链式思维步骤、自我验证轮次等,较小的模型可以超越大模型的表现。
4. Transformer是否仍是赢家?
Raschka对当前LLM架构格局进行了冷静评估:尽管Mamba等SSM架构在特定场景展现了优势,Transformer在通用LLM领域仍然占据主导。MoE(Mixture of Experts)成为大模型的标准配置,Kimi K2、DeepSeek-V3等均采用MoE架构。
5. 技术概念补充
视频链接: youtube.com/watch?v=DCqqCLlsIBU
频道: AI Papers Academy | 时长: ~35min
1. 纯RL训练的惊人发现
DeepSeek-R1-Zero是该论文最令人震惊的实验:一个基座模型仅通过大规模强化学习训练(无任何监督微调SFT),自发涌现出复杂的推理行为——包括自我反思、纠错、多步规划。这一发现挑战了"推理能力必须通过精心设计的训练数据灌输"的传统观点。
2. DeepSeek-R1的实用训练流程
R1-Zero虽展现了涌现推理能力,但存在输出格式不一致等问题。DeepSeek-R1通过"冷启动SFT → RL训练 → 拒绝采样 → 二次RL"的四阶段流程,在保持推理能力的同时确保了输出质量。这一流程已成为开源推理模型训练的事实标准。
3. 知识蒸馏到小模型
论文还展示了将R1的推理能力蒸馏到1.5B-70B参数小模型的方法,蒸馏后的小模型在数学推理等任务上超越了同尺寸的非蒸馏模型。这为资源有限的研究团队提供了可行的推理模型构建路径。
4. 技术概念补充
视频链接: youtube.com/watch?v=vXtapCFctTI
频道: Stanford Online | 时长: ~80min
Stanford CS25是斯坦福大学最热门的研讨会式课程之一,邀请业界顶尖研究者分享Transformer及其应用的最前沿进展。本讲由Hugging Face的Sayak Paul主讲。
1. DiT——从U-Net到Transformer的范式转移
Stable Diffusion早期版本使用U-Net作为扩散骨干网络。DiT(Diffusion Transformer)证明Transformer同样可以作为扩散模型的骨干,且具有更好的扩展性。这一发现直接催生了Sora、Stable Diffusion 3、FLUX等里程碑式模型。
2. MMDiT——多模态扩散Transformer
MMDiT(Multimodal Diffusion Transformer)是DiT的多模态进化版本,同时处理文本和图像两种模态。通过在Transformer内部设置双分支(文本流和图像流),通过注意力层实现跨模态信息交互。这是Stable Diffusion 3的核心架构。
3. 从DiT到FLUX的演进路线
讲座系统梳理了从原始DiT到AuraFlow、FuseDiT、FLUX的架构演进路线。关键趋势包括:更大的模型规模、更高效的注意力机制、更丰富的条件注入方式(如文本、布局、深度图等)。
4. 技术概念补充
视频链接: youtube.com/watch?v=7NNxK3CqaDk
频道: Yannic Kilcher | 订阅数: 318K | 时长: ~35min
1. 超越扩散模型的新框架
Flow Matching提出了一个统一且更简洁的生成建模框架。传统扩散模型需要定义前向加噪过程和反向去噪过程,数学推导复杂。Flow Matching直接在连续正则化流(Continuous Normalizing Flows, CNFs)上定义训练目标,绕过了扩散过程的复杂概率路径约束。
2. 条件Flow Matching的数学优雅性
论文的核心贡献是条件Flow Matching(Conditional Flow Matching, CFM)目标函数。与直接最大化数据似然的困难相比,CFM通过条件概率路径上的回归损失,提供了一个无偏的、方差更低的训练目标。这种"简单路径+简单目标"的设计使得训练更加稳定高效。
3. 实际影响:Stable Diffusion 3和FLUX的底层技术
Flow Matching不仅是理论突破,已经被工业界大规模采用。Stable Diffusion 3、FLUX、AWS的生成模型等均基于Flow Matching框架。它正在取代传统扩散模型的训练方法,成为生成模型领域的新标准。
4. 技术概念补充
视频链接: youtube.com/watch?v=n7dliZWzy2c
频道: 技术深潜频道 | 时长: ~25min
1. 万亿参数MoE架构揭秘
Kimi K2是Moonshot AI推出的万亿参数开源MoE模型。MoE架构的核心思想是"大而智能地懒"——虽然总参数达到万亿级别,但每次推理只激活约10%的参数(活跃参数约100B级别),大幅降低了推理成本。每个token由路由器(Router)动态分配给最相关的专家处理。
2. MoBA——注意力混合的新突破
MoBA(Mixture of Block Attention)是Kimi团队为超长上下文设计的注意力机制。在处理200万token上下文时,标准的全注意力机制计算量巨大。MoBA将上下文分块,通过路由机制选择性地关注最相关的块,将计算复杂度从O(n²)降低到接近线性。
3. 从K2到K2.5的快速迭代
K2.5在K2基础上增加了多模态能力(视觉理解)和Agent框架。K2 Thinking版本增加了推理时"思考"能力,在Agent任务评测中表现出色。K2.6(2026年4月发布)进一步优化,以76%的成本达到了Claude级别编码能力。
4. 技术概念补充
图表 1
Sebastian Raschka的系统化讲解覆盖了2026年LLM研究的所有关键方向。如果你只看一个视频了解当前LLM技术全貌,这就是那个视频。90分钟的深度对话,信息密度极高,建议分段观看。
扩散模型与自回归模型的融合是LLM架构领域最具想象力的方向之一。Yannic Kilcher的讲解一如既往地深入透彻。这一架构如果被大规模验证,可能改变LLM推理加速的技术路线。
来自Moonshot AI的这项工作看似微小("只是改了残差连接"),但影响深远。它证明了Transformer架构中"最不起眼"的组件仍有巨大改进空间。对于从事LLM训练的工程师来说,这是最可能立即应用到实践中的研究成果。
| 资源 | 类型 | 链接 |
|---|---|---|
| Stanford CME296: Diffusion & Large Vision Models | 完整课程 | cme296.stanford.edu |
| Stanford CS25 课程录像合集 | 课程系列 | web.stanford.edu/class/cs25 |
| Sebastian Raschka 博客 | 技术博客 | sebastianraschka.com |
| Yannic Kilcher 频道 | YouTube | youtube.com/@YannicKilcher |
| Attention Residuals 论文 | arXiv | arxiv.org/abs/2603.15031 |
| DeepSeek-R1 论文 | arXiv | arxiv.org/abs/2501.12948 |
| Kimi K2 技术解析 | 技术博客 | intuitionlabs.ai |
| 推理缩放综合分析 | 技术文章 | zylos.ai |
| Flow Matching 论文解读 | 视频笔记 | digest.getnotable.ai |
[!tip] 51学通信知识星球 星主:爱卫生(微信:gprshome201101)——公众号「51学通信」创办者,19 年通信行业运维与讲师经验,著有《GPRS网络信令实例详解》《EPC原理与实践》《5G核心网原理与实践》三本纸质书(各大电商平台有售)。 星球定位:深耕 5G 核心网、IMS、NFV/AI、云原生等 ICT 领域,主打运维岗位与信令分析。 当前规模:5200 篇主题 / 990 个回答,198 元/年。 加入福利:加入星球后请加爱卫生微信,拉您进知识星球年度陪伴与答疑群——不限量回复您的各种问题,另有群内分享。 AI 加持:51学通信知识星球已作为 skill 接入 WorkBuddy,使用 deepseek-4-flash 在海量星球帖子中精准找贴、找视频、找 FAQ 和案例,做总结、找文档和 PPT 等场景全覆盖。
