传统移动通信系统的设计哲学是模型驱动——先用数学模型描述信道特征(如瑞利衰落、多径时延扩展),再基于这些模型推导最优算法(如MMSE信道估计、固定码本波束选择)。这种范式的致命弱点在于:真实信道的复杂度远超任何解析模型的能力边界。
当Massive MIMO的天线规模从4T4R演进到64T64R甚至128T128R,波束空间从数十维扩展到数百维,传统的穷举式波束扫描和固定码本反馈机制面临"维度灾难"。当载波频率迈向毫米波甚至太赫兹,信道的时间相关性骤降,基于统计平稳假设的估计算法在高速移动场景中几乎失效。
AI原生通信的核心命题是:不再将AI视为通信系统的外挂优化工具,而是将AI能力内嵌于空口协议栈的设计基座。从3GPP Release 18开始,这一范式转变正式进入标准化轨道——AI/ML不再仅仅是OAM域的"锦上添花",而是深入物理层(PHY)、MAC层、RRC层的核心功能模块。
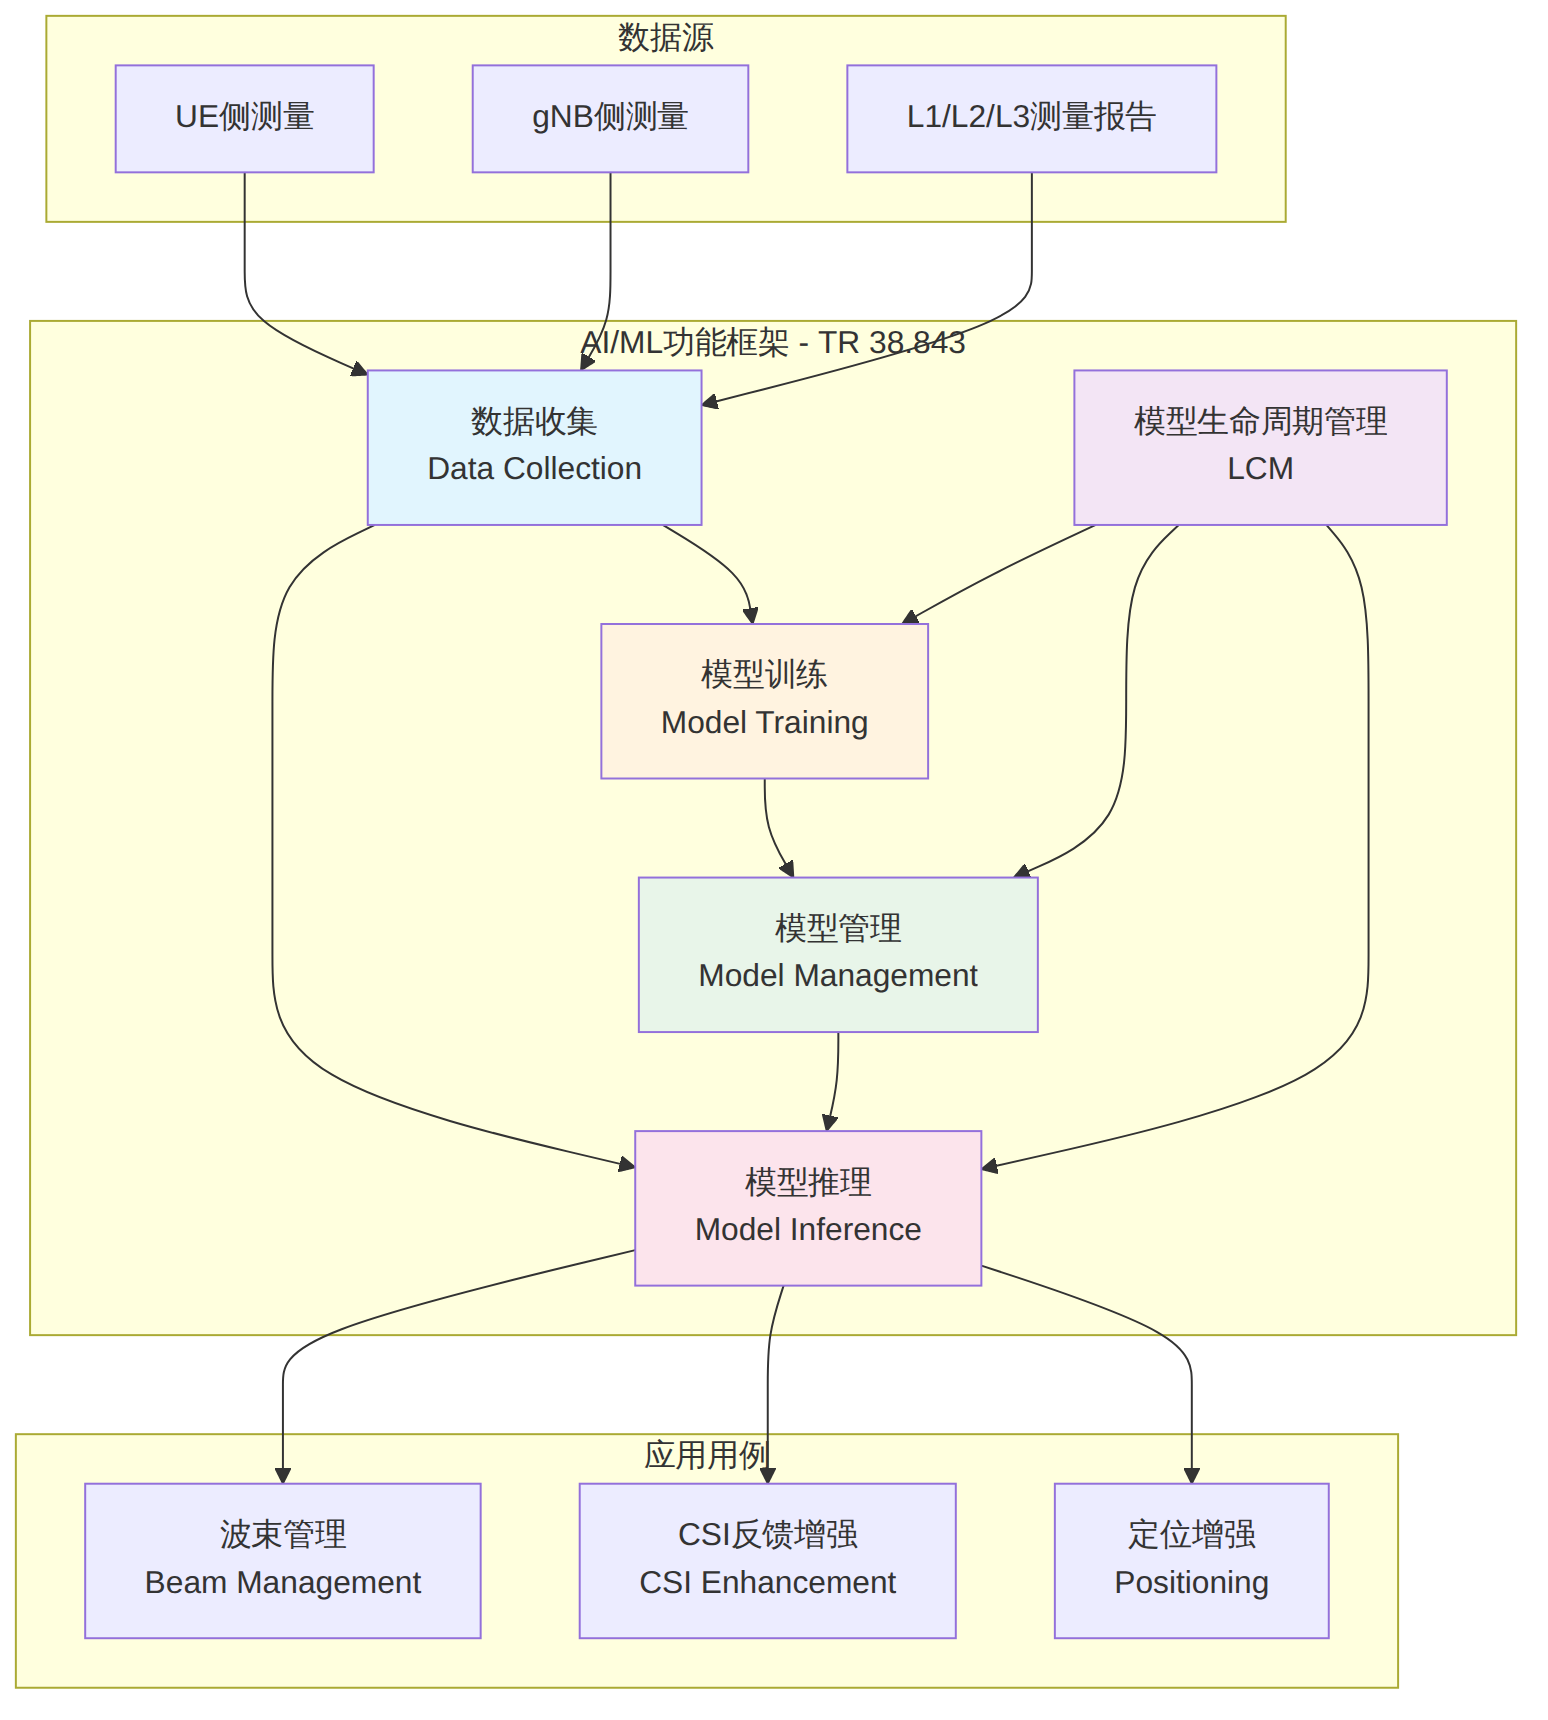
3GPP在TR 38.843中定义了NR空口AI/ML的统一功能框架,这是理解整个AI原生空口的起点。该框架包含以下核心逻辑功能块:
图表 1
数据收集(Data Collection):框架的输入端,从UE和gNB两侧收集L1-RSRP测量、CSI-RS/SSB测量报告、波束质量指标等原始数据。与传统测量报告的关键区别在于——AI模型需要的不是统计平均后的KPI,而是高维原始特征向量,包括时域信道冲激响应、频域CSI矩阵的实部/虚部、波束赋形权重等。
模型训练(Model Training):可以部署在网络侧(gNB/CU)或终端侧(UE),支持在线学习(Online Learning)和离线训练两种模式。3GPP定义了两种模型部署架构:
| 部署架构 | 说明 | 典型用例 |
|---|---|---|
| 单侧模型(One-side Model) | AI模型仅在UE侧或gNB侧运行,对侧不感知AI的存在 | 波束预测(仅UE侧)、定位(仅UE侧) |
| 双侧模型(Two-side Model) | AI模型在UE和gNB两侧协同运行,需要模型参数同步 | CSI反馈压缩(UE编码+gNB解码) |
模型推理(Model Inference):运行已训练模型,产生实际输出——如最优波束索引、压缩后的CSI码字、位置坐标估计值。推理的实时性要求极高,CSI反馈增强场景中推理时延需控制在符号级(微秒量级)。
模型生命周期管理(LCM):这是3GPP AI/ML框架最独特的设计。包括模型注册/注销、激活/去激活、性能监控、模型更新、回退机制等子功能。LCM的存在意味着AI模型不是"一次训练终身使用",而是持续演进的动态实体。
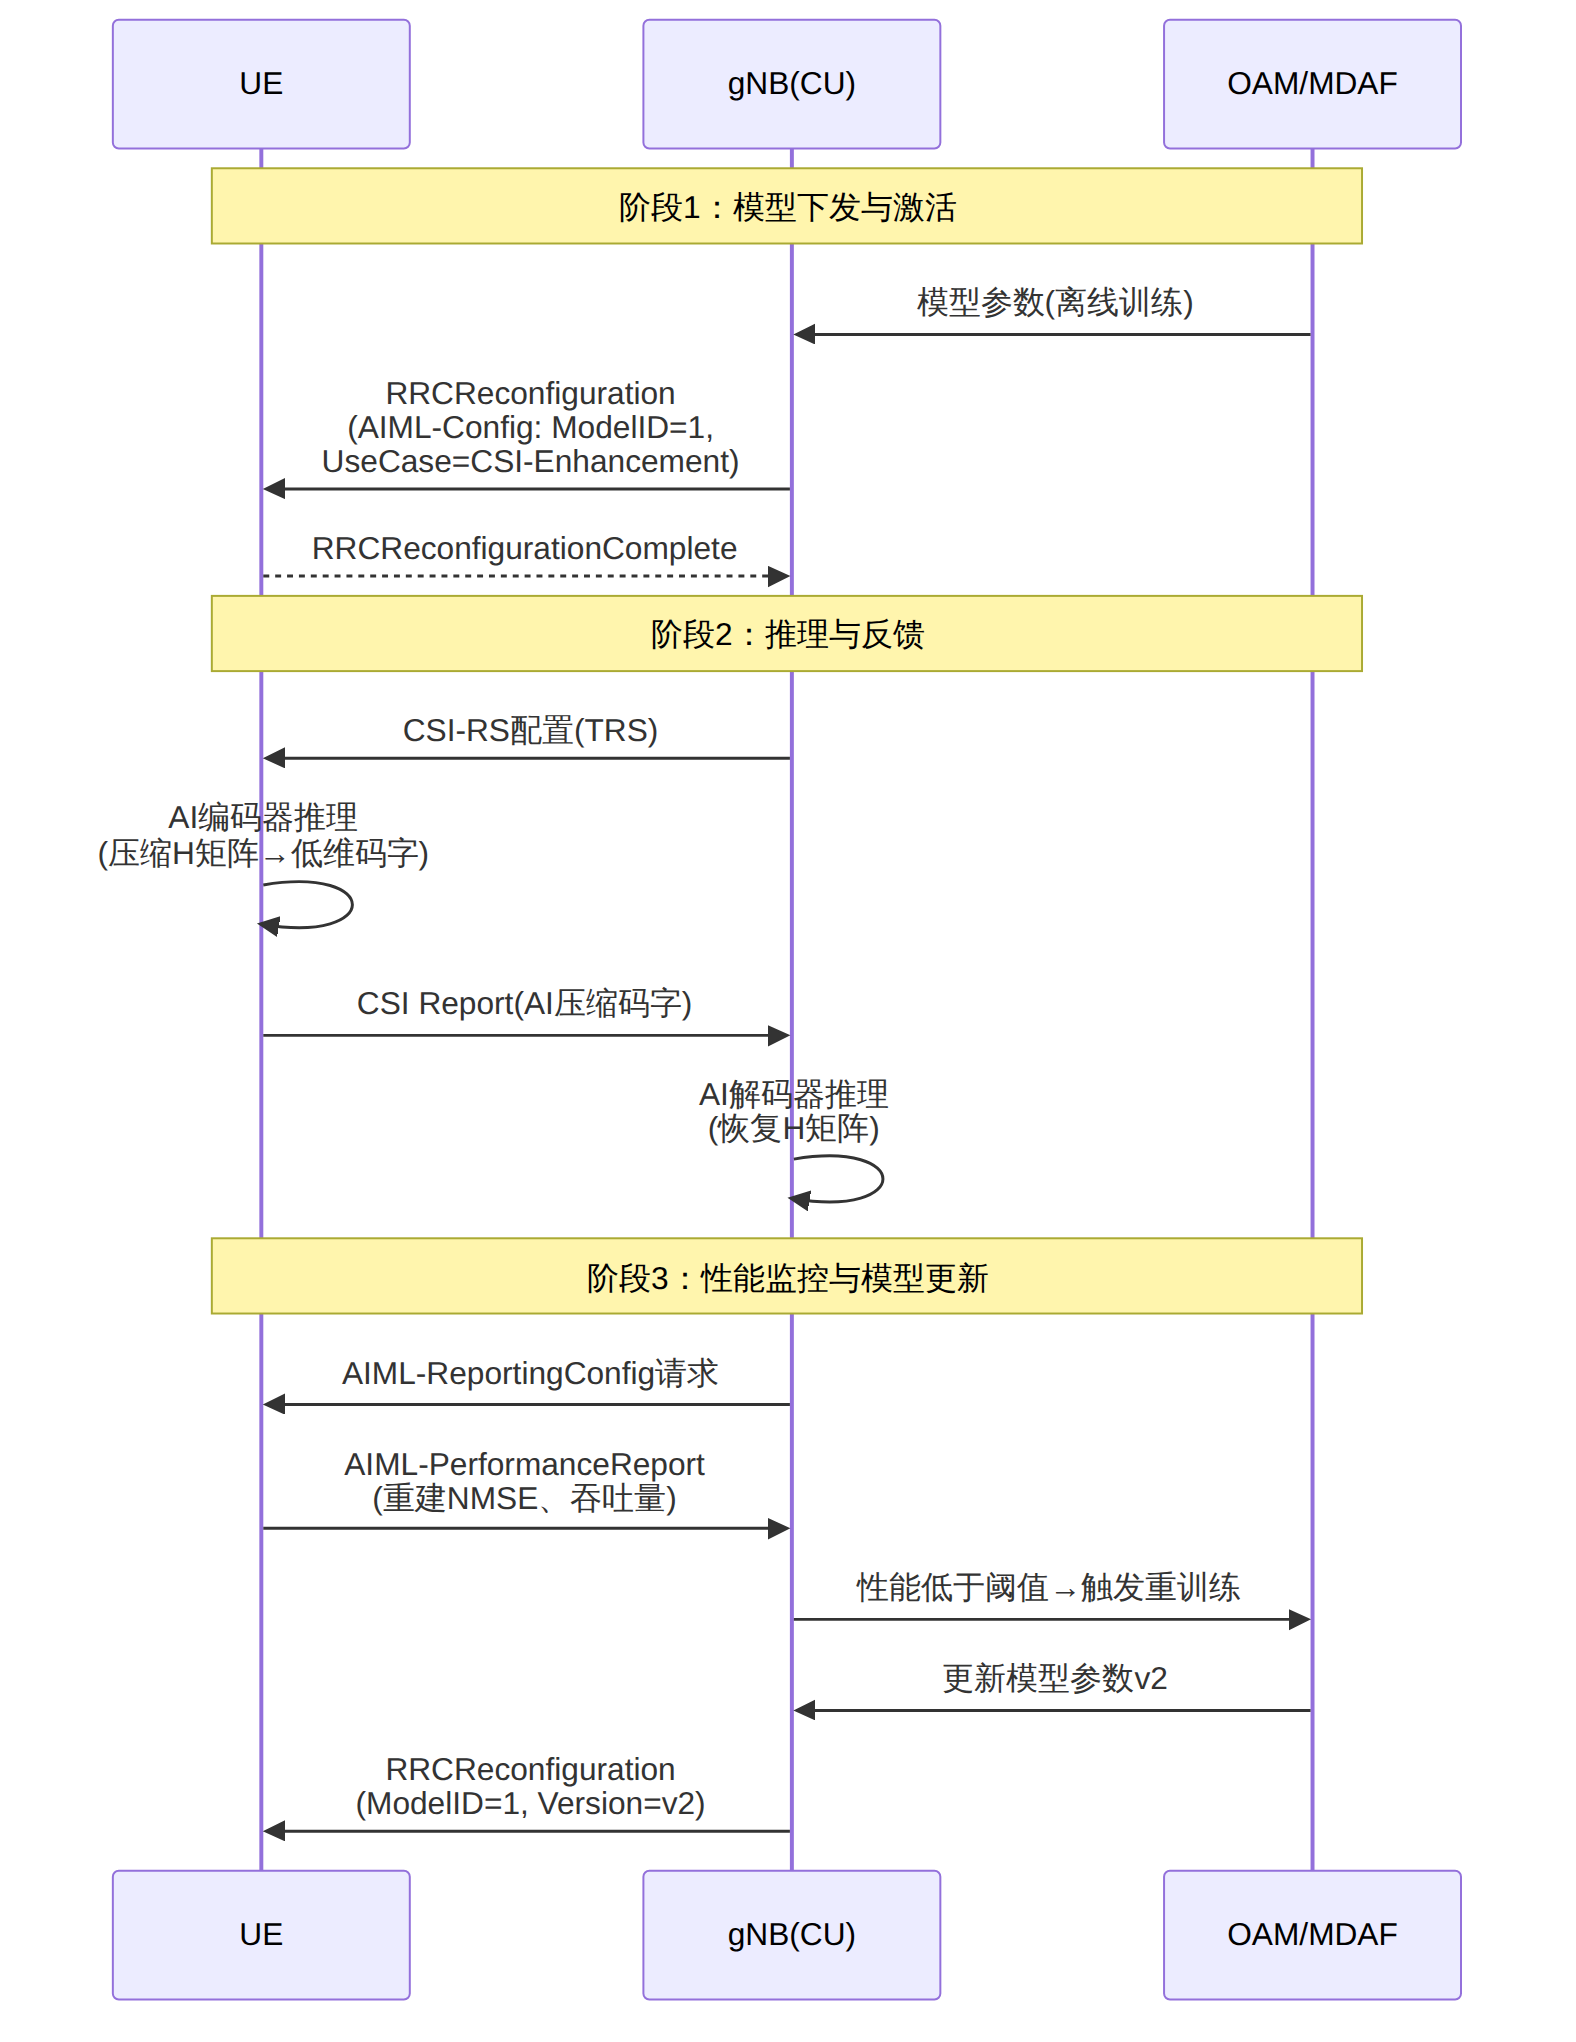
Release 18在TS 38.331(RRC协议)中引入了新的IE(Information Element)来支持AI/ML功能的配置和控制:
图表 2
在NR系统中,下行信道估计的基本流程是:gNB发送已知导频信号(CSI-RS或DM-RS),UE接收后基于导频位置处的已知信号估计算出信道响应,再通过插值获得全带宽的信道矩阵H。
经典算法包括:
LMMSE的核心问题在于需要预知信道协方差矩阵 $R_H$ 和噪声方差 $\sigma^2$——这两个统计量在实际系统中要么需要大量样本估计(引入额外时延),要么基于理想假设(失配导致性能退化)。在高速移动场景(350km/h+)下,信道的时间非平稳性使得 $R_H$ 在一个时隙内就发生显著变化,LMMSE的"最优线性估计"前提不复存在。
AI信道估计的本质是用神经网络 $f_\theta$ 替代传统估计算法中的解析函数:
$$\hat{H}{AI} = f\theta(Y_{pilot}, X_{pilot}, \rho_{snr})$$
其中 $\theta$ 是网络参数,$Y_{pilot}$ 是导频接收信号,$X_{pilot}$ 是已知导频信号,$\rho_{snr}$ 是信噪比辅助输入。
3GPP在Rel-18中重点关注的是CSI反馈增强,而非直接替代物理层的实时信道估计。其核心思路是:
| 维度 | 传统Type II CSI反馈 | AI/ML CSI反馈增强 |
|---|---|---|
| 压缩方法 | 固定码本投影(DFT变换+幅度/相位量化) | 神经网络编码器学习最优压缩映射 |
| 反馈开销 | 4-64 bits per RB组(取决于配置) | 降低50%-80%(实测数据) |
| 重建精度 | 码本量化误差,高秩信道性能差 | NMSE降低3-10dB |
| 适用场景 | 低中速移动、中低频段 | 高速移动、毫米波、Massive MIMO |
| 标准化状态 | Rel-15引入,成熟商用 | Rel-18/19标准化,2026年开始商用验证 |
双侧CSI压缩模型的工作原理:
UE侧编码器 $E_\theta$:将高维CSI矩阵 $\mathbf{H} \in \mathbb{C}^{N_r \times N_t}$ 压缩为低维码字 $\mathbf{z} = E_\theta(\mathbf{H}) \in \mathbb{R}^k$,其中 $k \ll N_r \times N_t$。
gNB侧解码器 $D_\phi$:从码字重建信道矩阵 $\hat{\mathbf{H}} = D_\phi(\mathbf{z})$。
训练目标函数:
$$\mathcal{L} = \mathbb{E}\left[|\mathbf{H} - D_\phi(E_\theta(\mathbf{H}))|F^2\right] + \lambda \cdot R)$$}(\mathbf{z
其中 $R_{rate}$ 是码率约束项,$\lambda$ 是拉格朗日乘子,用于平衡重建精度与反馈开销。
单侧CSI预测模型(Rel-19新增方向)则仅在网络侧运行,利用历史CSI数据预测未来时刻的信道状态:
$$\hat{\mathbf{H}}{t+1} = f\theta(\mathbf{H}t, \mathbf{H})$$}, \ldots, \mathbf{H}_{t-N
这种方式不需要修改UE,通过gNB侧的时序预测模型(如LSTM/Transformer)实现CSI预测,有效降低反馈频率。
| 参数 | 推荐配置 | 说明 |
|---|---|---|
| CSI-RS密度 | 1 RE/PRB(AI模式可降至0.5) | AI模型可以在更稀疏的导频上工作 |
| 反馈周期 | 10-20ms(传统5ms) | AI预测能力允许降低反馈频率 |
| 压缩比 | 1/8 ~ 1/16 | 在NMSE < -15dB约束下优化 |
| 模型复杂度 | 编码器<50K参数 | UE侧算力受限,需轻量化 |
| 推理时延 | <50μs | 需在PUSCH准备时间内完成 |
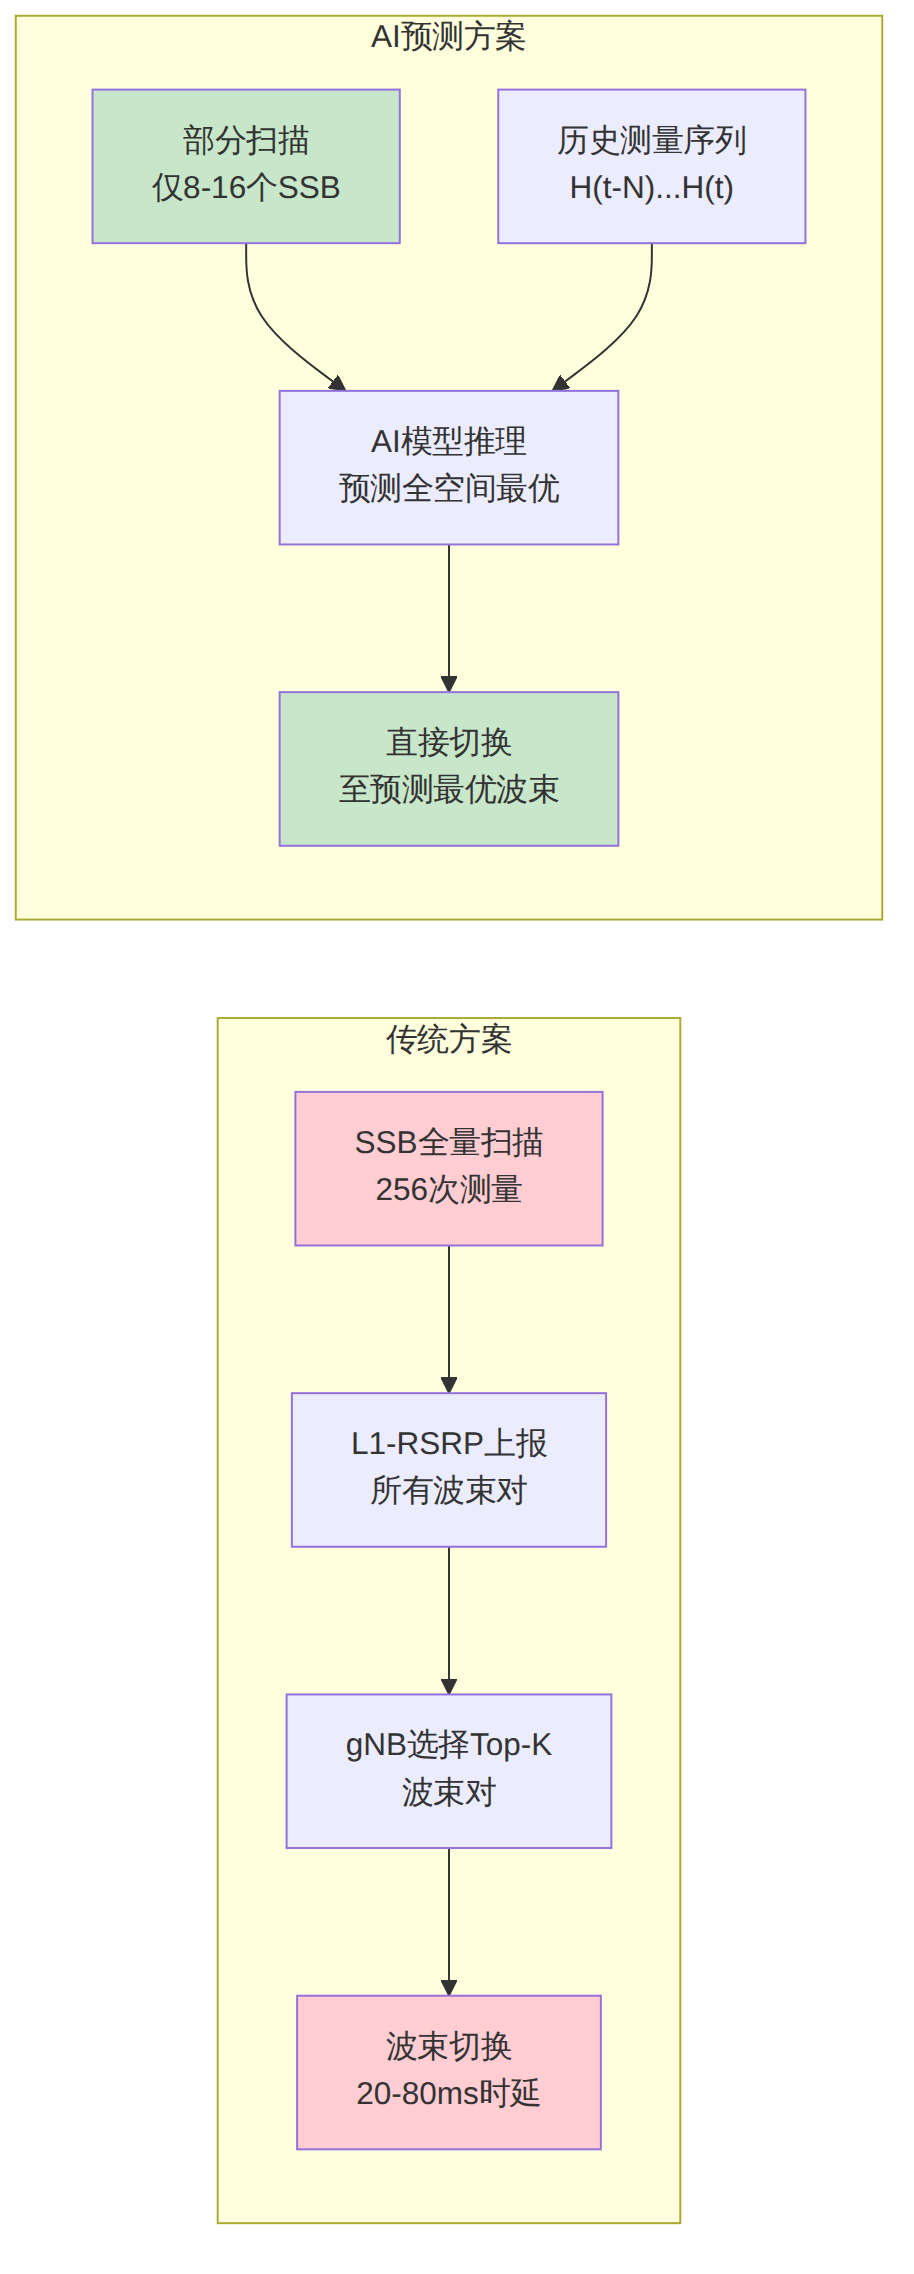
NR毫米波系统中,波束管理通过SSB或CSI-RS波束扫描实现。以FR2(24-52GHz)为例,典型配置下gNB有64个TX波束、UE有4个RX波束,完整的波束配对搜索需要 $64 \times 4 = 256$ 次测量。
每次波束测量需要至少1个SSB时隙(SSB周期默认20ms),完成全量扫描需要的时间远远超过了信道相干时间。这意味着当扫描完成时,最优波束可能已经不再是"最优"的了。
传统码本方案的另一个问题是:DFT码本只能生成均匀网格的波束方向,无法自适应匹配实际的用户分布和散射环境。在实际城区场景中,用户集中分布在几个主要方向上,但码本仍需全向扫描。
3GPP TR 38.843定义的AI/ML波束管理包含两个子用例:
子用例1:波束预测(Beam Prediction)
利用历史波束测量数据预测未来时刻的最优波束对,避免频繁的全量扫描。
图表 3
数学形式化表述:给定过去 $N$ 个时刻的波束测量向量 ${\mathbf{r}{t-N}, \ldots, \mathbf{r}_t = [RSRP_1, RSRP_2, \ldots, RSRP_M]$ 为 $M$ 个波束的参考信号接收功率,预测未来时刻的最优波束索引:}}$,其中 $\mathbf{r
$$\hat{b}^*{t+1} = \arg\max}} f_\theta(\mathbf{r{t-N}, \ldots, \mathbf{r}; b)$$
子用例2:波束增强(Beam Enhancement)
通过AI模型从部分带宽的CSI-RS测量中推断全带宽的波束质量,减少CSI-RS开销。这在FR2的CA(载波聚合)场景中尤其有价值——只需在一个CC上发送CSI-RS,AI模型即可推断其他CC的波束质量。
| 特性 | Rel-15/16波束管理 | Rel-18 AI波束管理 |
|---|---|---|
| 波束搜索范围 | 全码本空间 | AI预测的子空间 |
| SSB开销 | 全量发送 | 减少40%-70% |
| 波束切换时延 | 20-80ms | 5-15ms |
| 适用场景 | 低中速移动 | 中高速移动(≤120km/h) |
| UE影响 | 无 | 需支持AIML-Config信令 |
| 回退机制 | N/A | 模型失效时回退至传统码本 |
| 规范依据 | TS 38.300/38.214 | TR 38.843 + TS 38.331增强 |
AI-RAN联盟(由NVIDIA、诺基亚、微软、三星等于2024年成立)提出的AI-RAN参考架构将RAN功能重新划分为三个平面:
RAN平面:传统的CU/DU/RU功能,但在DU层引入GPU加速的L1处理。NVIDIA的Aerial SDK已将LDPC编解码、FFT/IFFT、波束赋形等L1运算卸载到GPU,为AI模型推理预留算力空间。
AI-on-RAN平面:在RAN基础设施上运行AI推理任务,包括: - 实时波束预测推理(时延要求<1ms) - CSI压缩/解压推理 - 功率控制优化 - 负载均衡决策
AI-and-RAN平面:AI训练任务与RAN信号处理共享同一GPU集群的算力。在业务低峰期(凌晨),GPU集群资源向模型训练倾斜;在业务高峰期,资源优先保障RAN L1实时处理。
根据NVIDIA和诺基亚在MWC 2026上发布的联合测试结果:
| 指标 | CPU-only DU | GPU加速DU (Aerial) |
|---|---|---|
| L1处理时延 | 800-1200μs | 200-400μs |
| 单服务器小区容量 | 4-8个4T4R小区 | 12-16个64T64R小区 |
| 功耗效率 | 基线 | 提升2.5倍(每比特) |
| AI推理可用算力 | 不可用 | GPU内预留15-20%算力 |
| CSI压缩推理时延 | N/A | 30-80μs |
图表 4
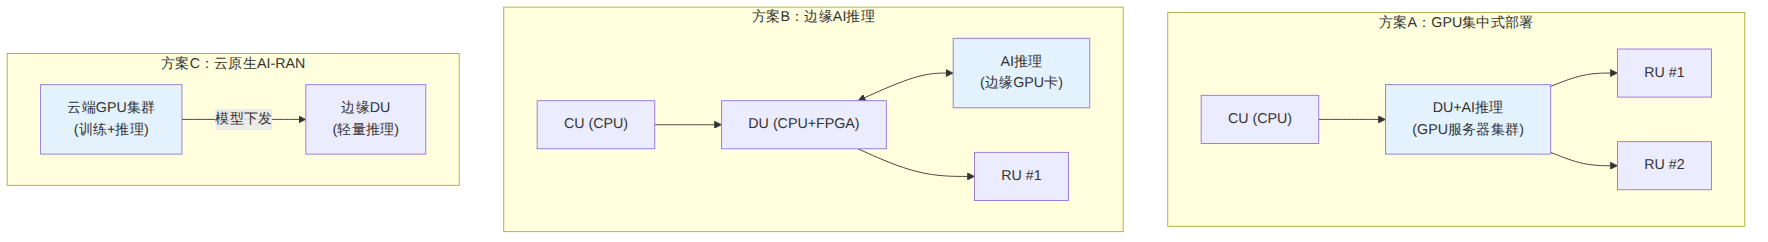
方案选择建议: - 密集城区Massive MIMO场景:方案A最优,GPU集群集中处理多小区的波束赋形和CSI重建 - 郊区/广域覆盖场景:方案B更经济,边缘GPU卡仅用于关键AI推理 - 运营商云化程度高的场景:方案C长期TCO最优,但需要F1/E2接口的低时延保障
TM Forum定义的自智网络(Autonomous Network)分为6个等级:
| 等级 | 名称 | 特征 | 通信行业当前进展 |
|---|---|---|---|
| L0 | 手动管理 | 全部人工操作 | 已淘汰 |
| L1 | 辅助管理 | 工具辅助人工决策 | 已淘汰 |
| L2 | 部分自治 | 部分任务自动化 | 当前主流 |
| L3 | 条件自治 | 特定域内闭环自动化 | 领先运营商已达到 |
| L4 | 高度自治 | 全域自动化,人机协同监督 | 2026年开始试点 |
| L5 | 完全自治 | 端到端无人干预 | 2030+愿景 |
从L3到L4的跃迁,核心是从规则驱动的自动化转向意图驱动的自智化。L3系统依赖预定义规则(如"若PRB利用率>80%则触发负载均衡"),而L4系统能理解高层的意图描述(如"确保CBD区域用户体验速率>100Mbps"),自动分解为具体的网络配置操作。
Agentic AI架构是L4级自智网络的实现范式:
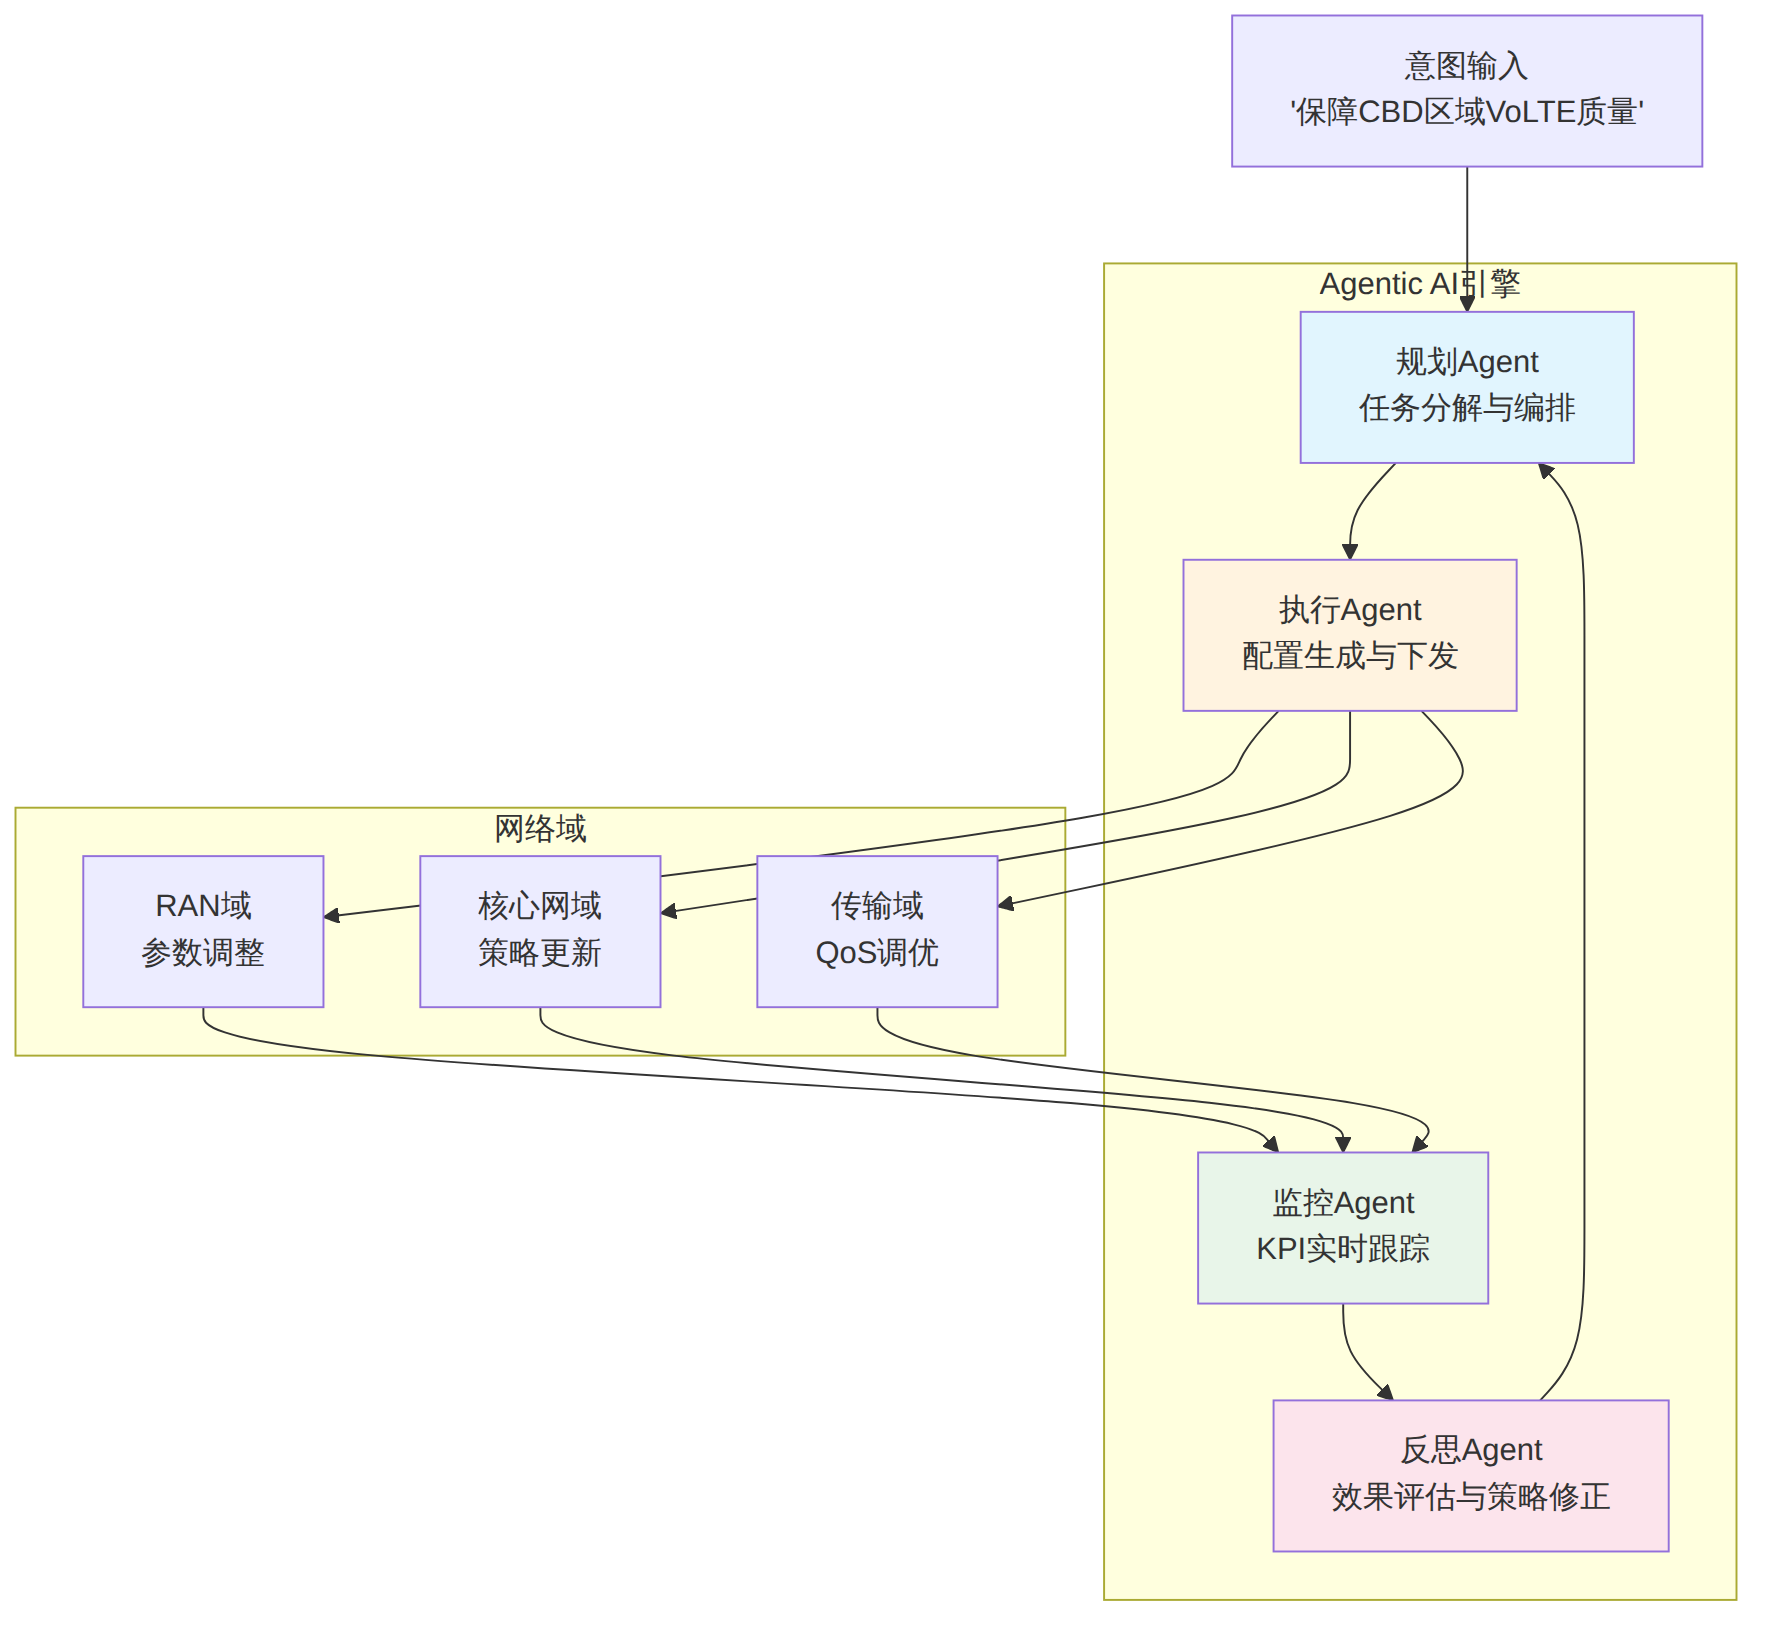
图表 5
关键差异点:L3 vs L4
| 维度 | L3(条件自治) | L4(高度自治) |
|---|---|---|
| 决策模式 | 基于阈值的规则引擎 | 基于LLM的意图理解+强化学习 |
| 优化范围 | 单域(RAN或CN或TN) | 跨域联合优化 |
| 故障处理 | 预定义故障恢复脚本 | 根因分析+自动生成修复方案 |
| 参数调优 | 固定参数集优化 | 参数空间自动探索 |
| 人工介入 | 异常告警后人确认 | 人仅监督审计,系统自主执行 |
| 标准接口 | O-RAN O1/O2 | TMF OpenAPI + O-RAN A1/O1 |
L5级自智网络的核心理念是网络即智能体(Network-as-Agent)——整个通信网络被视为一个具有感知、决策、执行、学习能力的超级智能体。
关键特征: - 零触配置(Zero-Touch Provisioning):新基站上电后自动完成邻区发现、参数自配、PCI分配、Xn/N2接口建立 - 预测性运维(Predictive O&M):基于时序预测模型在故障发生前48小时触发预防性维护 - 自适应切片编排:根据业务流量预测自动创建/调整/释放网络切片,包括SLA指标的动态调整 - 端到端自愈:从无线链路失败到核心网网元故障的全链路自动恢复,目标MTTR < 30秒
Ericsson和AWS在2025年联合发表的Agentic AI for RAN优化白皮书中,提出了从"Talk-to-Network"到"Network-as-Agent"的三阶段演进路线,预计L5级商用部署的时间窗口在2030-2032年。
AI模型在训练环境中表现优异,但在部署环境中的性能退化(Domain Shift)是最大的工程挑战。具体表现:
缓解策略: - 采用Domain Adaptation技术,在模型推理时动态调整批归一化参数 - gNB侧维护多套模型版本,根据UE能力报告(UECapabilityInformation)选择匹配模型 - 设置性能监控阈值,当AIML-PerformanceReport显示NMSE超过-10dB时自动回退到传统算法
AI模型在UE侧运行面临严格的功耗和算力限制: - 推理功耗预算:< 50mW(避免显著影响电池续航) - 模型参数量:编码器 < 100K参数(对应约400KB FP16存储) - 推理时延:CSI压缩 < 100μs,波束预测 < 500μs
这要求模型设计必须极致轻量化。业界实践表明,深度可分离卷积(Depthwise Separable Convolution)和通道剪枝(Channel Pruning)可以在精度损失<1dB的条件下将参数量压缩至原始模型的1/5。
在现网中,AI模型的OTA更新需要考虑: - 兼容性:新版本模型与旧版本UE的互操作 - 回退机制:模型更新失败时快速回退到传统算法(需保证回退时延 < 100ms) - 验证周期:新模型上线前需经过充分的小范围灰度验证
3GPP在Rel-19中进一步明确了模型LCM的标准化流程,包括模型注册(Model Registration)、模型激活(Model Activation)、性能验证(Performance Validation)、模型去激活(Model Deactivation)四个阶段。
Q: AI/ML CSI反馈增强和传统Type II CSI反馈可以同时使用吗?
A: 不可以。3GPP Rel-18中规定,当AIML-Config中激活了CSI-Enhancement用例时,对应的CSI报告配置必须使用AI/ML模式,不能与传统Type II混合。但不同的CSI报告配置(ReportConfig ID不同)可以使用不同的模式——例如周期性CSI用传统Type II,非周期性CSI用AI压缩。
Q: 在现网中如何部署AI-RAN?需要更换现有设备吗?
A: 分阶段部署。阶段一(纯网络侧):在gNB CU部署AI推理服务器(x86+GPU),运行CSI预测、波束预测等单侧模型,不需要升级UE。阶段二(双侧协同):UE芯片支持AI推理能力后(预计2027年商用SoC),激活双侧CSI压缩模型。阶段一不需要更换RU,但需要增加GPU服务器。阶段二需要新一代UE芯片支持。
Q: AI模型的训练数据从哪里来?需要标注吗?
A: 波束管理和CSI增强用例主要采用自监督学习——以真实的信道测量数据作为标签,不需要人工标注。例如CSI压缩模型的训练标签就是原始的高维CSI矩阵本身。模型训练一般在OAM域的数据分析功能(MDAF)中完成,使用过去7-30天的历史测量数据。
Q: AI波束管理和传统LMR(L1-MAC RRC)波束管理有什么区别?
A: 传统LMR波束管理通过L1-RSRP测量触发MAC CE上报,再由网络通过RRC重配完成波束切换,全程基于固定规则。AI波束管理的核心差异是:(1)UE侧AI模型可以从部分扫描中预测全局最优波束,减少扫描开销;(2)gNB侧AI模型可以基于历史趋势预测波束切换时机,提前准备;(3)波束选择不再受限于固定码本,AI可以输出非码本方向的波束赋形权重。
Q: 自智网络L4级在5G网络中能实现哪些具体能力?
A: 2026年可预期的L4级能力包括:(1)RAN域跨厂商参数自优化(通过O-RAN rApp闭环);(2)核心网网元故障的自动根因定位与自愈(MTTR从小时级降至分钟级);(3)网络切片SLA的实时监控与自动调优;(4)基于业务预测的能耗管理(AI预测低谷时段自动关断载波)。需要注意的是,L4级仍然需要人工监督和审批关键决策。
本文由「51学通信」技术团队出品。51学通信由通信行业18年老兵爱卫生(微信ID: gprshome201101)维护,聚焦5G/6G核心网、3GPP标准解读、通信前沿技术深度分析。 出版作品有《5G核心网原理与实践》《IMS原理与实践》等4本通信专业书籍。知识星球「51学通信」提供深度技术答疑和行业洞察。
[!tip] 51学通信知识星球 星主:爱卫生(微信:gprshome201101)——公众号「51学通信」创办者,19 年通信行业运维与讲师经验,著有《GPRS网络信令实例详解》《EPC原理与实践》《5G核心网原理与实践》三本纸质书(各大电商平台有售)。 星球定位:深耕 5G 核心网、IMS、NFV/AI、云原生等 ICT 领域,主打运维岗位与信令分析。 当前规模:5200 篇主题 / 990 个回答,198 元/年。 加入福利:加入星球后请加爱卫生微信,拉您进知识星球年度陪伴与答疑群——不限量回复您的各种问题,另有群内分享。 AI 加持:51学通信知识星球已作为 skill 接入 WorkBuddy,使用 deepseek-4-flash 在海量星球帖子中精准找贴、找视频、找 FAQ 和案例,做总结、找文档和 PPT 等场景全覆盖。
