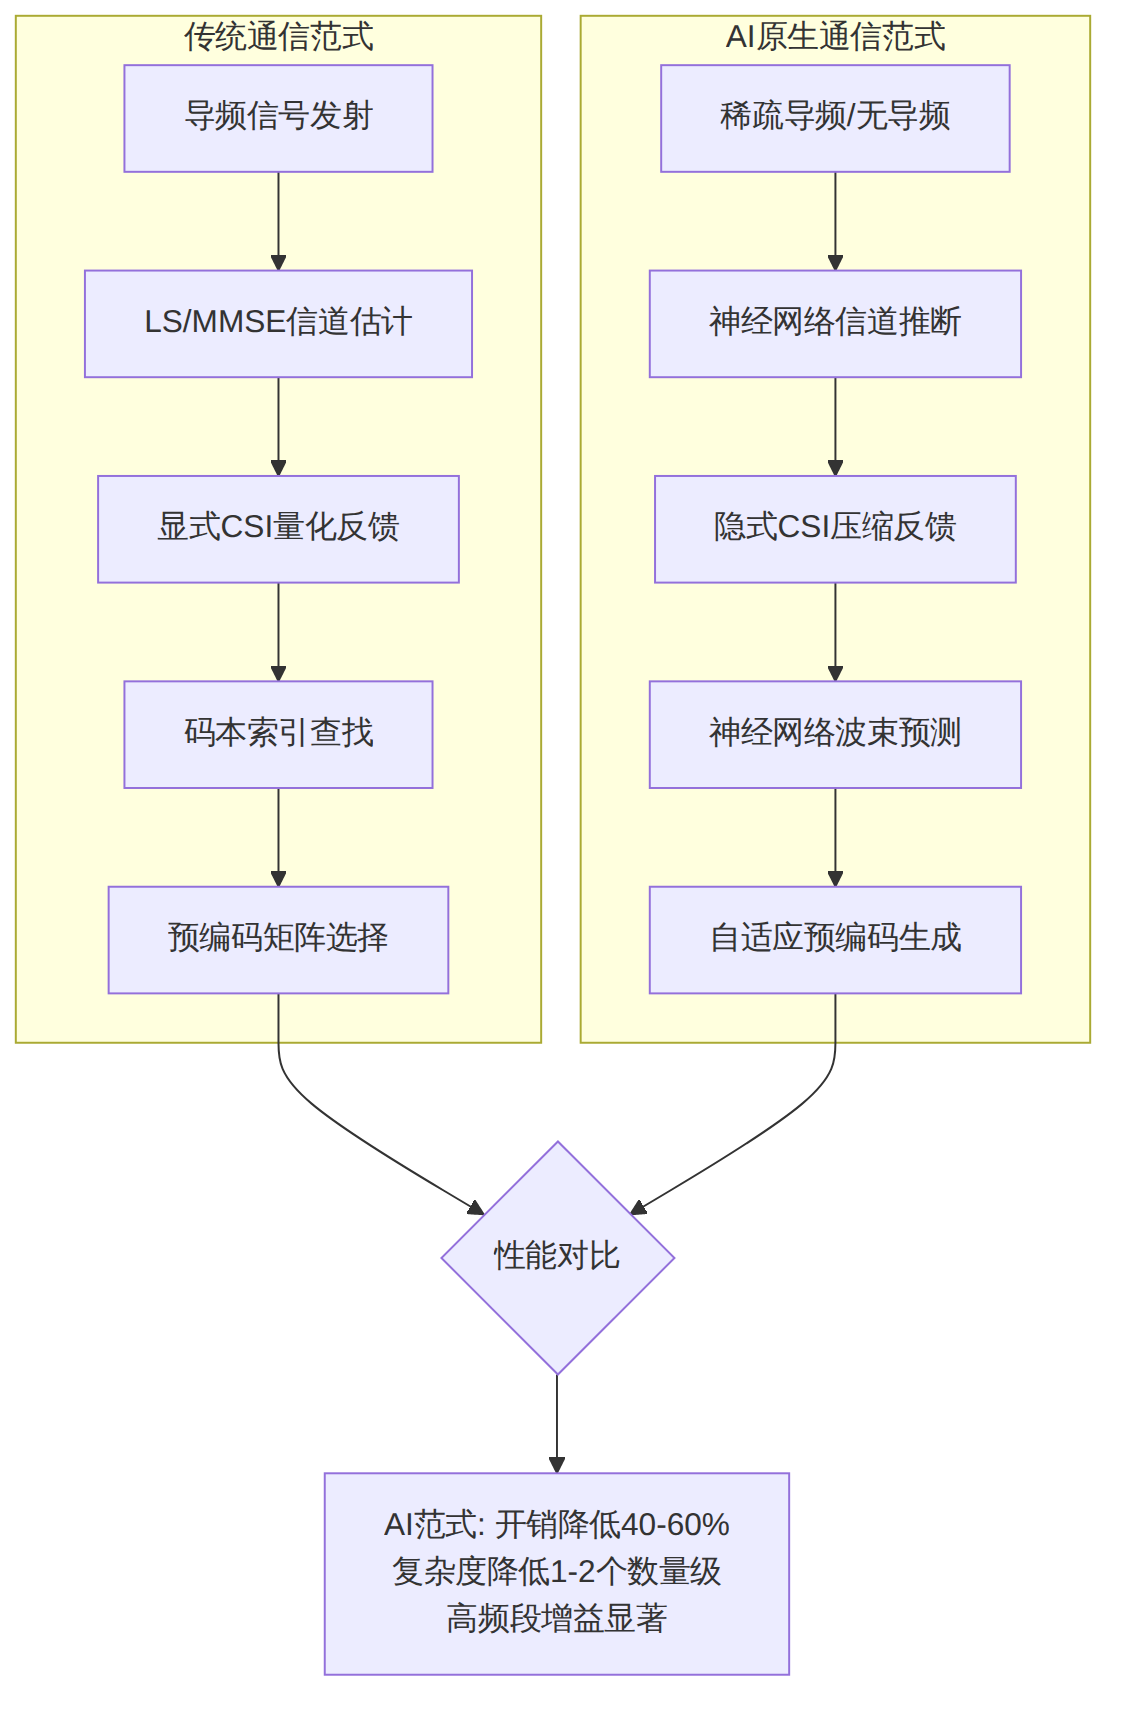
通信行业正经历一次深刻的范式迁移——从"AI辅助通信"到"AI原生通信"。这一迁移的本质区别在于:前者将AI作为优化工具叠加在传统协议栈之上,后者则将AI/ML作为空口设计的基础范式,与物理层信号处理、MAC层调度、网络层管理深度耦合。
3GPP从Rel-18开始,在TR 38.843中首次系统性地定义了AI/ML for NR空口的功能框架。Rel-19(2025年3月冻结Stage 3)将AI/ML从研究阶段推进到规范性工作阶段,覆盖CSI反馈增强、波束管理、定位三大用例。而正在进行的Rel-20/6G早期研究,则把"AI-Native"确立为6G四大支柱之一。
这一演进路径的核心驱动力可以用一个简单的数学事实来理解:传统通信系统中的最优解(如MMSE信道估计、最优码本选择)往往需要完整的信道状态信息和穷举搜索,在Massive MIMO、毫米波、太赫兹等高频段场景下,获取完整CSI的开销和计算复杂度已经超越了工程可行性的边界。AI/ML提供了一条绕过这一瓶颈的路径——用数据驱动替代模型驱动,用泛化近似替代精确求解。
图表 1
3GPP TR 38.843定义的AI/ML功能框架是理解整个AI-RAN架构的起点。该框架包含以下核心功能模块:
| 功能模块 | 功能描述 | 部署位置 |
|---|---|---|
| 数据收集 | 收集训练/推理所需的测量数据(L1-RSRP、CSI-RS测量等) | UE侧 + gNB侧 |
| 模型训练 | 离线/在线训练AI/ML模型,支持联邦学习框架 | gNB侧/云端 |
| 模型推理 | 使用已训练模型进行实时推断(波束预测、CSI重构等) | UE侧和/或gNB侧 |
| 性能监控 | 持续监测AI/ML模型输出质量,触发模型回退或更新 | gNB侧 |
| 模型生命周期管理(LCM) | 模型的加载、激活、切换、回退、卸载全流程管理 | UE侧 + gNB侧 |
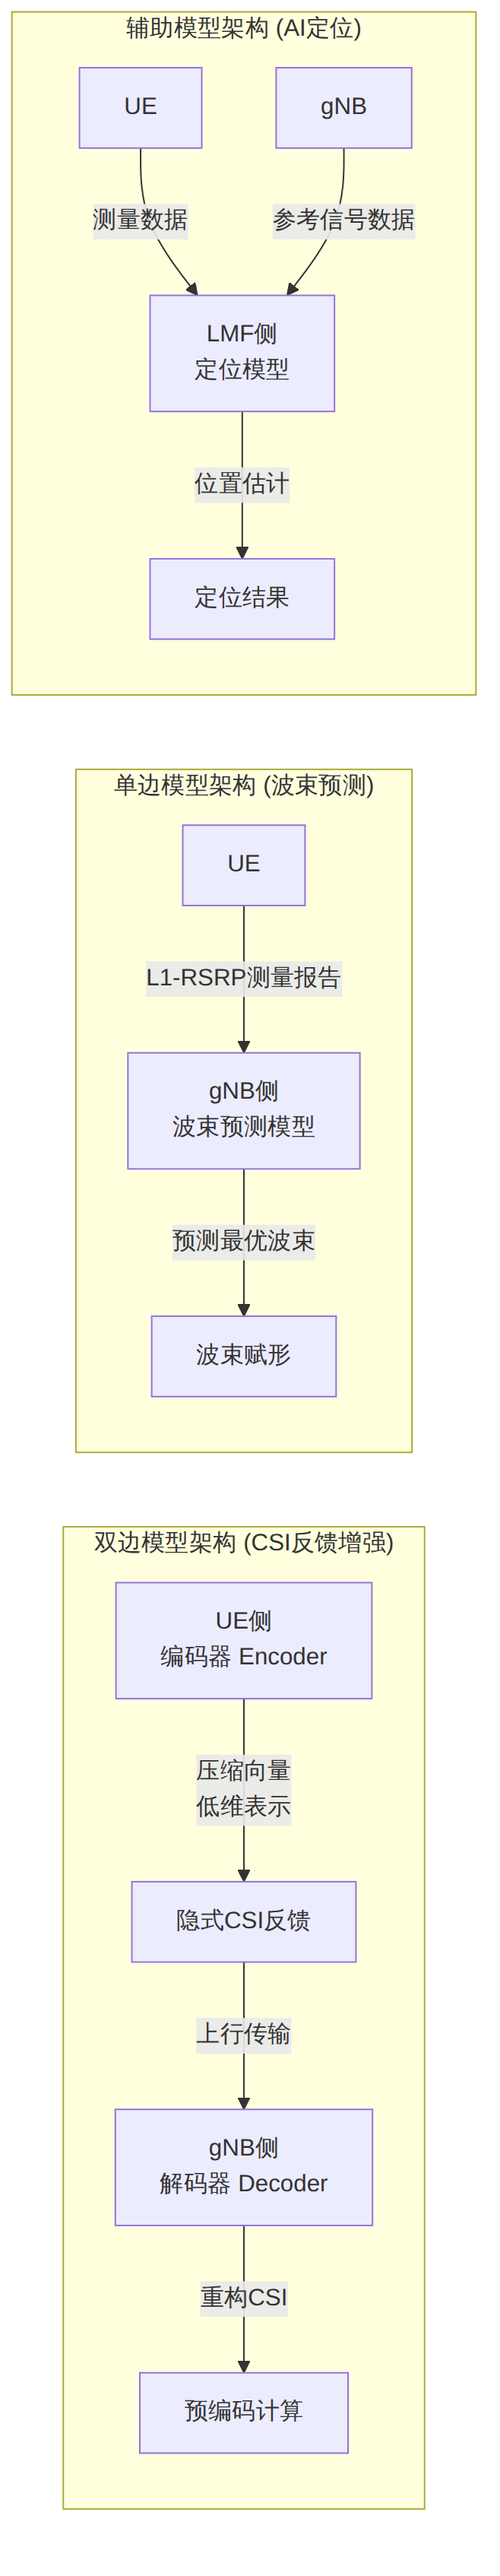
3GPP定义了三种AI/ML模型的部署架构:
单边模型(One-side Model):模型仅部署在UE侧或gNB侧。典型的如gNB侧波束预测模型——gNB基于历史L1-RSRP数据预测最优波束,无需UE侧部署推理模块。
双边模型(Two-side Model):模型拆分为编码器和解码器,分别部署在UE和gNB。这是CSI反馈增强的核心架构——UE侧编码器将高维CSI压缩为低维向量,gNB侧解码器重构CSI。
辅助模型(Network-assisted Model):模型部署在LMF(定位管理功能)或其他网络节点,从UE和gNB获取输入数据进行推理。
图表 2
AI模型不是一劳永逸的。信道环境的变化(如新建筑物、季节性 foliage变化、用户密度变化)会导致模型性能退化(Model Drift)。3GPP在Rel-19中标准化了LCM框架,其核心流程包括:
一个关键的工程约束是:LCM过程不能中断正在进行的通信服务。这意味着模型切换必须是无缝的——在新模型激活之前,旧模型必须仍然可用,且切换窗口要足够短(毫秒级)。
在Massive MIMO系统中,下行CSI获取是闭环MIMO预编码的前提。传统方案基于Type II码本的CSI反馈流程如下:
这一方案的瓶颈在于:对于32端口以上的Massive MIMO,Type II码本反馈开销可达数百比特/子帧,且码本量化误差导致预编码精度受限。特别是在FR2(24.25-52.6 GHz)毫米波频段,信道的稀疏性和角度分辨率要求使得传统码本难以有效捕捉信道特征。
3GPP Rel-18/19研究的AI-CSI反馈增强方案,核心思想是用自编码器(Autoencoder)替代传统码本量化:
UE侧编码器 $f_\theta(\cdot)$: $$\mathbf{s} = f_\theta(\hat{H}) \in \mathbb{R}^{d}, \quad d \ll N_r \times N_t$$
gNB侧解码器 $g_\phi(\cdot)$: $$\tilde{H} = g_\phi(\mathbf{s}) \approx \hat{H}$$
其中 $\theta$ 和 $\phi$ 分别是编码器和解码器的参数,$d$ 是压缩后的向量维度。训练目标是最小化重构误差:
$$\mathcal{L} = \mathbb{E}\left[|\hat{H} - g_\phi(f_\theta(\hat{H}))|_F^2\right]$$
在实际系统设计中,考虑到空口信道的时频二维特性,3GPP研究中的主流方案采用空-频域联合压缩架构:
输入: H ∈ C^(N_ant × N_sc)  (天线数 × 子载波数)
     ↓
空间域压缩: Conv2D/Spatial Transformer → C^(K × N_sc), K << N_ant
     ↓
频率域压缩: 1D Conv / GRU → C^(K × L), L << N_sc
     ↓
量化 + 编码: 可微分量化 → 比特流 b ∈ {0,1}^(M)
     ↓
上行反馈: M bits (M远小于传统码本开销)
关键参数配置:
| 参数 | 传统Type II码本 | AI-CSI反馈 | 压缩比 |
|---|---|---|---|
| 反馈比特数(32端口) | ~256 bits/subframe | ~64 bits/subframe | 4:1 |
| CSI-RS密度 | 每4个PRB | 可扩展到每8-16个PRB | 2-4x |
| 信道重构NMSE | -10 ~ -15 dB | -18 ~ -22 dB | 显著改善 |
| 推理时延 | <0.1ms(查表) | 0.5-2ms(神经网络) | 需优化 |
Rel-19中一个重要的架构决策是"灰盒"而非"黑盒"的设计哲学。具体体现在:
这一决策背后的工程逻辑是:纯黑盒AI模型在极端场景下(如高速移动、罕见的信道衰落事件)可能产生不可预测的行为,而通信系统对可靠性有严格的要求(如URLLC场景的99.999%可靠性)。灰盒设计在AI的灵活性和通信系统的确定性之间取得了平衡。
5G NR在FR2频段采用模拟波束赋形,波束管理流程包括P-1(初始波束建立)、P-2(波束精炼)、P-3(波束跟踪)三个阶段。传统方案依赖周期性CSI-RS/SSB发送和UE的L1-RSRP测量报告:
在高移动性场景下(如 vehicular @ 120km/h),波束方向的相干时间约5-10ms,传统扫描周期往往跟不上信道变化速度,导致波束失配和吞吐量骤降。
3GPP Rel-18/19研究了两类AI波束管理用例:
用例1:空间域波束预测(Spatial-domain Beam Prediction)
给定当前时刻 $t$ 的部分波束测量结果(仅扫描 $K$ 个候选波束,$K \ll N_{tx}$),预测所有 $N_{tx}$ 个波束的L1-RSRP排名,从而避免全量扫描:
$$[\hat{r}1, \hat{r}_2, ..., \hat{r}([r_1, r_2, ..., r_K])$$}}] = f_{\theta
这一方案的收益直接取决于 $K/N_{tx}$ 的比值。3GPP评估中,$K=8$ 对 $N_{tx}=64$ 的配置下,Top-1波束预测准确率可达85-90%,波束扫描开销降低约87%。
用例2:时域波束预测(Temporal Beam Prediction)
给定历史 $T$ 个时刻的波束测量序列,预测未来 $\Delta t$ 时刻的最优波束:
$$[\hat{r}(t+\Delta t), \hat{b}(t+\Delta t)] = f_{\theta}([r(t-T), ..., r(t)])$$
其中 $b(t)$ 是波束索引,$r(t)$ 是对应的RSRP值。这一方案的关键挑战是预测窗口和准确率的权衡——预测窗口越长,准确率越低。3GPP评估结果显示:
| 预测窗口 | 准确率(Top-1) | 适用场景 |
|---|---|---|
| 1 slot (0.5ms) | >95% | 低速移动 |
| 4 slots (2ms) | >90% | 中速移动 (30km/h) |
| 10 slots (5ms) | >80% | 高速移动 (60km/h) |
| 20 slots (10ms) | >65% | 极高速 (120km/h) |
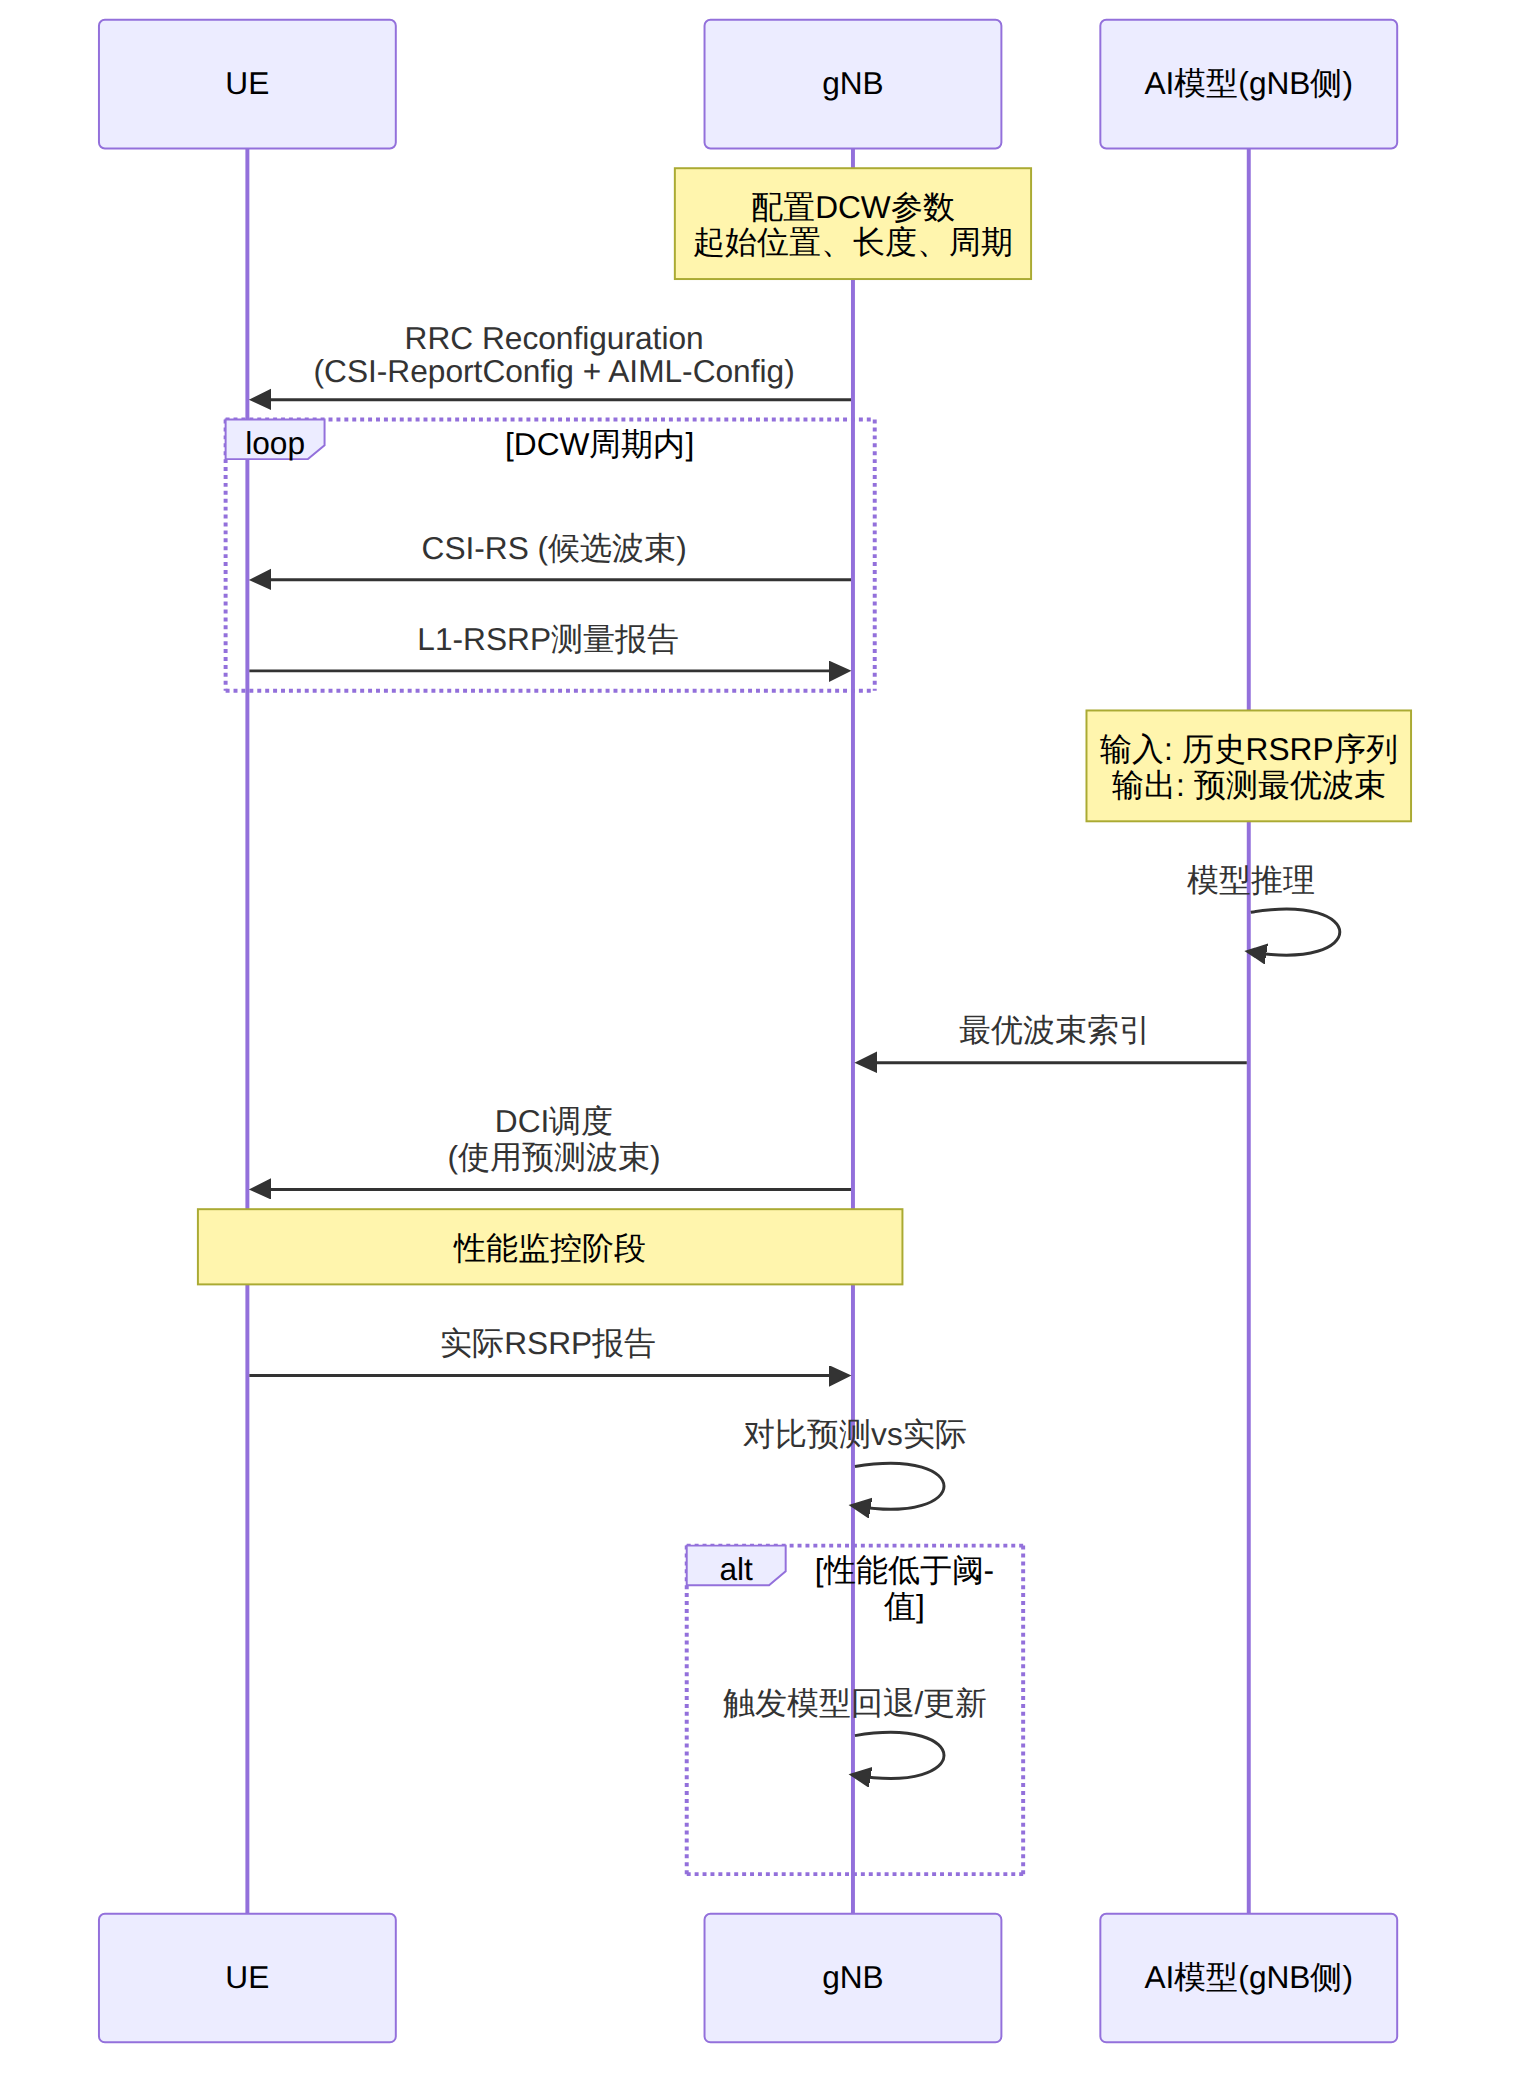
AI波束预测的性能高度依赖于输入数据的质量。3GPP RAN1的一个重要讨论焦点是数据收集时间窗(Data Collection Time Window, DCW)的设计:
图表 3
DCW的核心设计权衡是:窗口太短→输入数据不足以捕捉信道时变特征;窗口太长→引入过时的历史数据,反而降低预测精度。3GPP最终的标准化方案允许gNB通过RRC信令动态配置DCW参数,包括:
TM Forum定义了自智网络(Autonomous Network)的6个等级:
| 等级 | 名称 | 特征 | 当前行业水平 |
|---|---|---|---|
| L0 | 手动管理 | 全人工操作 | 已淘汰 |
| L1 | 辅助管理 | 系统提供数据,人工决策 | 传统2G/3G网络 |
| L2 | 部分自动化 | 预定义规则自动执行 | 大部分4G/5G网络 |
| L3 | 条件自动化 | AI辅助决策,人工审批 | 先进运营商2024-2025 |
| L4 | 高度自动化 | AI自主决策,人工监督 | 头部运营商2026-2027 |
| L5 | 完全自动化 | 全自主运营,无需人工干预 | 研究阶段 |
当前行业正处于L2向L3过渡的关键时期,部分领先运营商在特定领域(如网络节能、故障根因分析)已达到L3水平。L4/L5的实现需要解决的核心问题是:从单任务AI优化到多任务、多域协同的Agentic AI架构。
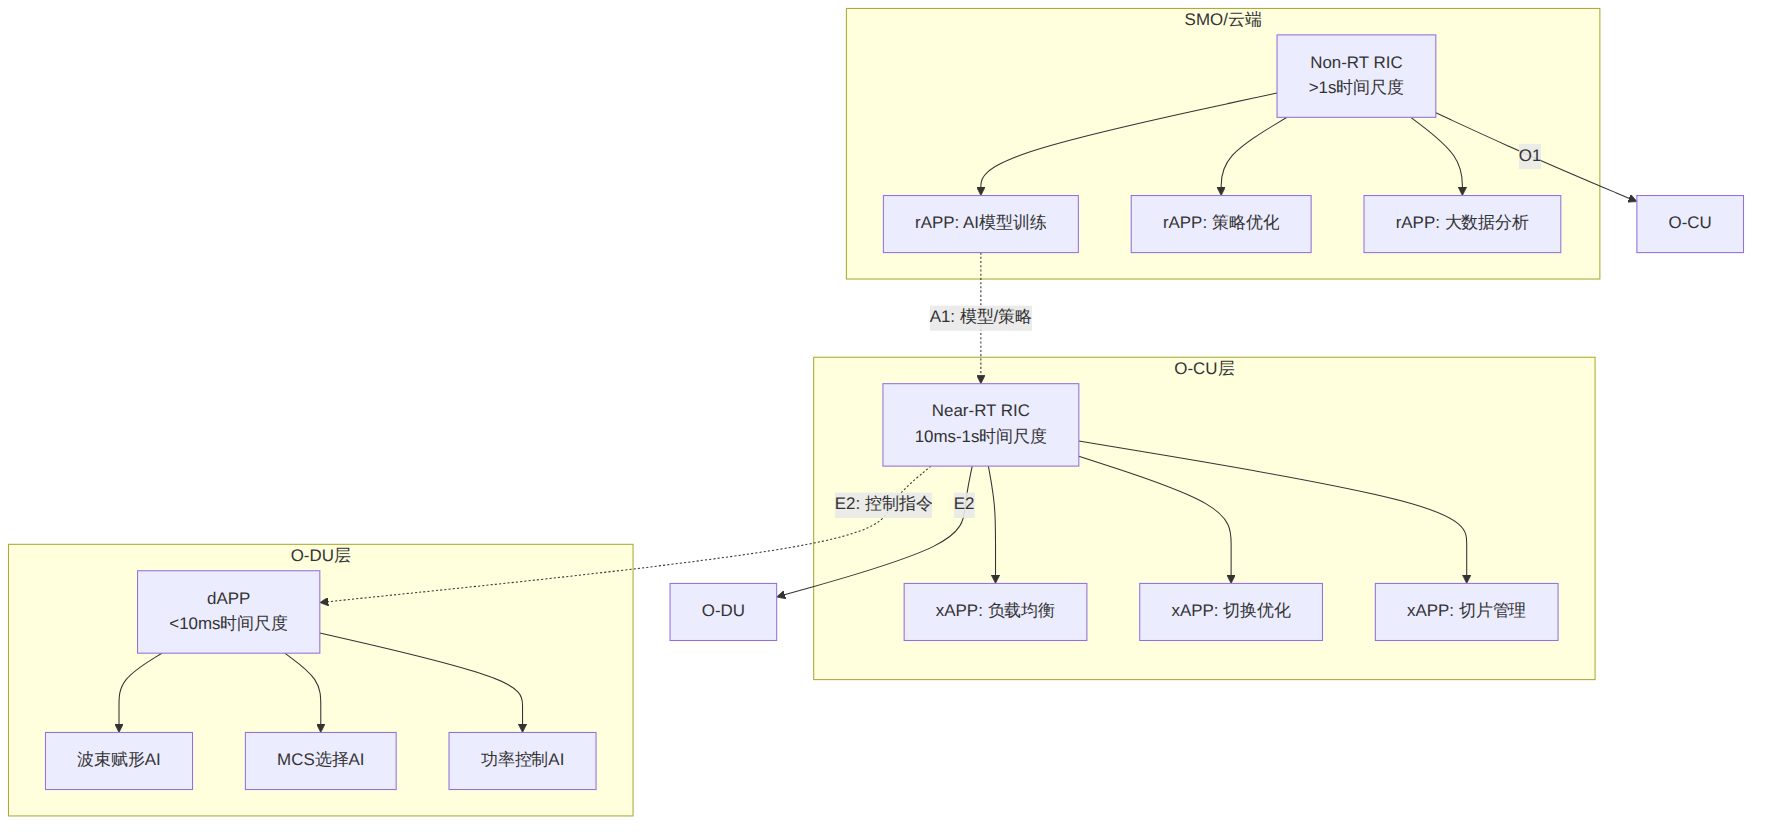
O-RAN联盟定义的RAN智能控制器(RIC)架构是实现自智网络L3-L5的核心框架:
非实时RIC(Non-RT RIC): - 部署在SMO(Service Management and Orchestration)中 - 时间尺度:>1秒 - 功能:rAPP(RIC Application)—— 策略制定、模型训练、大数据分析 - 接口:A1接口(策略下发)、O1接口(网元管理)
近实时RIC(Near-RT RIC): - 部署在O-CU中或独立部署 - 时间尺度:10ms-1秒 - 功能:xAPP—— 实时调度优化、负载均衡、干扰管理 - 接口:E2接口(与O-CU/O-DU交互)
dAPP(新演进方向): - 部署在O-DU内部 - 时间尺度:<10ms(甚至微秒级) - 功能:L1/L2物理层AI—— 实时波束赋形、MCS选择、功率控制 - 这是2025年O-RAN新引入的概念,弥补了xAPP在物理层实时控制方面的空白
图表 4
2025-2026年,行业共识正在形成:实现L5完全自智网络需要从"工具型AI"(单一模型执行单一任务)演进到"智能体AI"(Agentic AI),其核心特征是:
多Agent协同:将网络运营分解为多个专业Agent——监控Agent、诊断Agent、决策Agent、执行Agent。各Agent通过标准化接口协同工作。
自主规划能力:Agent能够根据高层目标(如"将网络能耗降低20%")自主分解为子任务序列,制定执行计划,动态调整策略。
工具调用(Tool Use):Agent能够调用多种工具——网络仿真器、配置管理系统、KPI数据库——来获取信息并执行操作。
安全约束:所有Agent操作在预定义的安全边界内执行。对于高风险操作(如大规模参数变更、网元重启),仍需人工确认。
Agentic AI RAN优化工作流示例:

目标: "优化片区A的网络能效,保持用户体验不变"

Agent规划:
  1. 监控Agent → 收集片区A过去7天的流量、能耗、用户体验数据
  2. 诊断Agent → 识别高能耗基站,分析低负载时段
  3. 策略Agent → 生成节能策略(符号关闭、载波关闭、深度休眠)
  4. 验证Agent → 在数字孪生环境中仿真策略影响
  5. 执行Agent → 分阶段执行策略,持续监控KPI
  6. 回退机制 → 若KPI下降超阈值,自动回退
爱立信和AWS在2025年联合发表的Agentic AI for RAN优化白皮书中,展示了基于多Agent架构的RAN自优化系统,在仿真中将网络能耗降低15-25%的同时保持用户体验指标(吞吐量、时延)不劣化。
将AI模型部署到UE侧面临严峻的硬件约束。3GPP在标准化过程中考虑了以下关键限制:
| 约束维度 | 典型限制 | 对AI模型的影响 |
|---|---|---|
| 内存 | CPE设备通常<50MB可用 | 模型参数量需<1M(约4MB FP32) |
| 算力 | ARM Cortex-A级CPU或轻量NPU | 推理时延需<2ms |
| 功耗 | 移动终端电池约束 | 每次推理功耗需<mW级 |
| 互操作 | 多厂商UE-gNB互通 | 模型接口需标准化 |
这意味着UE侧AI模型必须是轻量级的——通常采用深度可分离卷积、知识蒸馏、量化(INT8/INT4)等技术压缩模型。3GPP标准化中,模型的推理接口(输入输出格式)是标准化的,但模型内部结构留给实现——这是一个关键的工程妥协。
实际部署中最棘手的问题是模型漂移(Model Drift)——训练数据分布与实际信道环境不匹配。可能的原因包括:
解决方案是在线学习(Online Learning),但3GPP Rel-19对此持谨慎态度——目前的标准化仅支持离线训练+在线推理模式,模型的更新通过完整的LCM流程完成(新模型下载、验证、切换),而非在UE侧实时更新模型参数。这一限制出于安全考虑:在线学习可能导致模型行为的不可预测变化。
AI-RAN的标准化涉及3GPP和O-RAN两个组织的协作分工:
一个常见的混淆是:3GPP的AI/ML空口框架和O-RAN的RIC架构不是替代关系,而是互补关系。3GPP定义了AI在空口协议中的信令和流程(如UE如何激活/使用AI模型),O-RAN定义了AI在RAN运营层面的管理架构(如xAPP如何通过E2接口控制DU行为)。
Q: AI-CSI反馈和传统Type II码本反馈能否共存? A: 可以。3GPP标准化中,AI-CSI反馈和传统码本反馈通过不同的CSI-ReportConfig区分。gNB通过RRC信令指示UE使用哪种反馈模式。在AI模型性能不满足要求时,系统自动回退到传统码本反馈。共存期间,两种模式的测量报告可以在不同时间窗中交替上报。
Q: AI波束管理对终端有什么硬件要求? A: 对于gNB侧单边模型(如波束预测),UE无需额外硬件——UE仅需上报传统的L1-RSRP测量结果,AI推理在gNB完成。对于双边模型(如CSI反馈增强),UE需要支持神经网络推理能力,这可能需要NPU加速器或支持INT8推理的DSP。预计2026年后商用的5G-Advanced芯片将普遍集成AI推理加速单元。
Q: O-RAN RIC的xAPP和rAPP区别是什么? A: xAPP部署在Near-RT RIC中,控制周期10ms-1s,适用于实时性要求较高的优化(如负载均衡、切换参数调整)。rAPP部署在Non-RT RIC中,控制周期>1s,适用于非实时性任务(如模型训练、策略制定、大数据分析)。简单类比:xAPP是"条件反射",rAPP是"深思熟虑"。
Q: 自智网络L4/L5什么时候能真正商用? A: L4(高度自动化)预计2026-2027年在特定场景(网络节能、故障自愈)率先商用。L5(完全自动化)的实现需要突破多域协同、安全验证、法规合规等非技术瓶颈,业内普遍认为需要到2030年前后。目前最现实的路径是:选择高价值、低风险的垂直场景逐步推进L4,积累经验后再扩展到全网范围的L5。
Q: AI模型的鲁棒性如何保障?对抗攻击风险大吗? A: 3GPP在AI模型安全方面采取了多层防护:(1) 模型输入数据经过校验和过滤,异常数据触发回退;(2) 性能监控机制持续评估模型输出合理性;(3) 模型回退到传统方案的机制始终可用。对抗攻击风险在当前标准中主要考虑的是无意干扰(如恶意UE伪造CSI报告),而非针对AI模型的精心设计攻击。6G阶段将引入更系统的AI安全框架。
本文由「51学通信」技术团队出品。51学通信由通信行业18年老兵爱卫生(微信ID: gprshome201101)维护,聚焦5G/6G核心网、3GPP标准解读、通信前沿技术深度分析。 出版作品有《5G核心网原理与实践》《IMS原理与实践》等4本通信专业书籍。知识星球「51学通信」提供深度技术答疑和行业洞察。
[!tip] 51学通信知识星球 星主:爱卫生(微信:gprshome201101)——公众号「51学通信」创办者,19 年通信行业运维与讲师经验,著有《GPRS网络信令实例详解》《EPC原理与实践》《5G核心网原理与实践》三本纸质书(各大电商平台有售)。 星球定位:深耕 5G 核心网、IMS、NFV/AI、云原生等 ICT 领域,主打运维岗位与信令分析。 当前规模:5200 篇主题 / 990 个回答,198 元/年。 加入福利:加入星球后请加爱卫生微信,拉您进知识星球年度陪伴与答疑群——不限量回复您的各种问题,另有群内分享。 AI 加持:51学通信知识星球已作为 skill 接入 WorkBuddy,使用 deepseek-4-flash 在海量星球帖子中精准找贴、找视频、找 FAQ 和案例,做总结、找文档和 PPT 等场景全覆盖。
