
从傅里叶变换到LDPC/Polar码,理解通信系统中最核心的数学工具
想象你在听一场交响乐演出。舞台上有一百件乐器同时演奏——小提琴、大提琴、长笛、圆号……这些声音混合在一起,传到你耳朵里只是一团复杂的声波。但你的大脑能分辨出每一件乐器的声音。这就是傅里叶变换在做的事情:从一团混合信号中,分离出每个频率分量。
再想象你要给远方的朋友寄一封重要信件,但邮路不太可靠,信件可能被雨水打湿、部分字迹模糊。聪明的做法是:在信里加入一些冗余信息,比如关键段落重复写两遍,或者加一串校验码。即使部分内容损坏,收信人也能还原出完整信息。这就是信道编码的精髓。
这两项技术——频域变换和前向纠错编码——构成了现代通信系统信号处理的两大支柱。本文将从工程直觉出发,逐一拆解它们的原理。
在深入每个模块之前,先看一张全景图。一个典型的5G下行数据传输链路如下:
图表 1
这张图里有两个关键处理环节:
下面我们分别深入。
时域和频域是观察同一个信号的两种视角。就像看一幅画——你可以一笔一笔地看它的线条(时域),也可以分析它用了哪些颜色的颜料(频域)。
在通信中,我们更习惯在频域设计和操作系统。原因很直观:
| 维度 | 时域视角 | 频域视角 |
|---|---|---|
| 带宽 | 看信号持续时间和波形变化 | 直接看到占用哪些频率 |
| 多用户 | 时分复用,分配时隙 | 频分复用,分配子载波 |
| 干扰分析 | 波形叠加,难以区分 | 各频率分量独立清晰 |
| 滤波 | 需要卷积运算 | 简单的频率选择 |
离散傅里叶变换(DFT)的定义:
$$X[k] = \sum_{n=0}^{N-1} x[n] \cdot e^{-j\frac{2\pi}{N}nk}, \quad k = 0, 1, \ldots, N-1$$
直接计算DFT,每个输出点需要N次复数乘法,总共N个点就是 $N^2$ 次。当N=4096时,需要约1678万次复数乘法。
快速傅里叶变换(FFT)利用了旋转因子 $W_N^{nk} = e^{-j\frac{2\pi}{N}nk}$ 的对称性和周期性,将计算量降到:
$$\text{FFT计算量} = \frac{N}{2} \log_2 N$$
同样N=4096时,只需要约24576次复数乘法——效率提升了683倍。
| 参数 | DFT直接计算 | FFT算法 |
|---|---|---|
| N=64 | 4,096次 | 192次 |
| N=256 | 65,536次 | 1,024次 |
| N=1024 | 1,048,576次 | 5,120次 |
| N=4096 | 16,777,216次 | 24,576次 |
| 复杂度 | $O(N^2)$ | $O(N\log_2 N)$ |
FFT的关键是蝶形运算(Butterfly Operation)。以基2 FFT为例,每一级将N个数据两两配对,执行一次简单的加减运算:
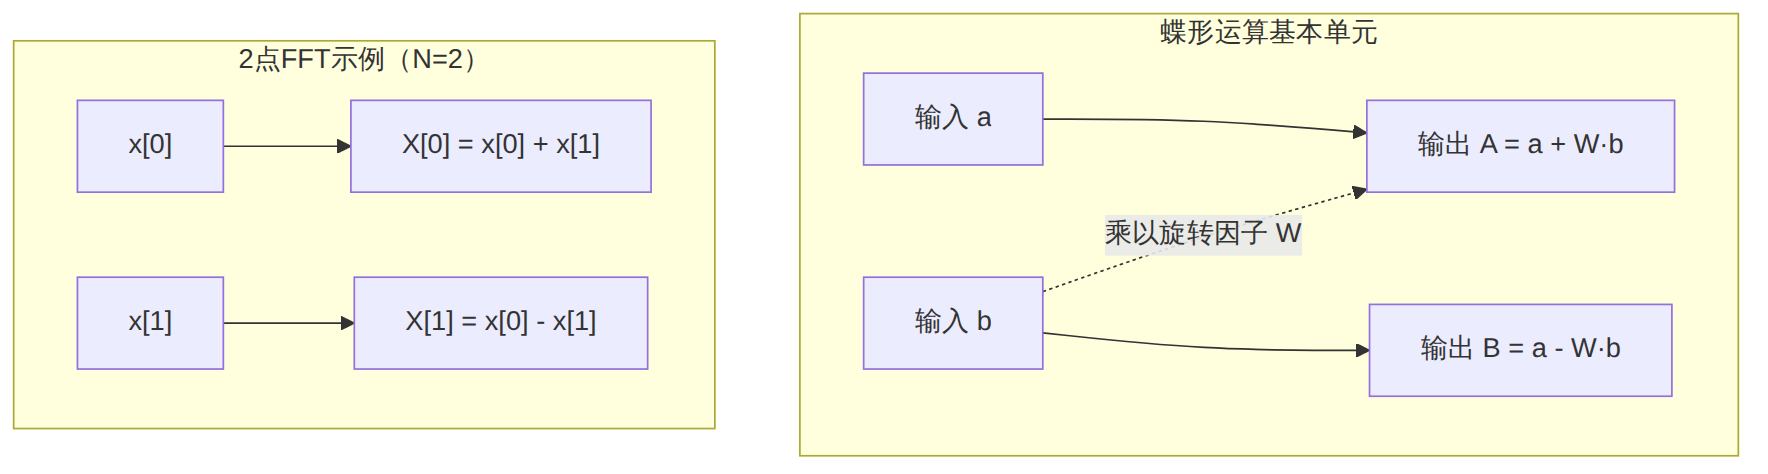
图表 2
对于N=8的FFT,需要3级蝶形运算,每级4个蝶形:
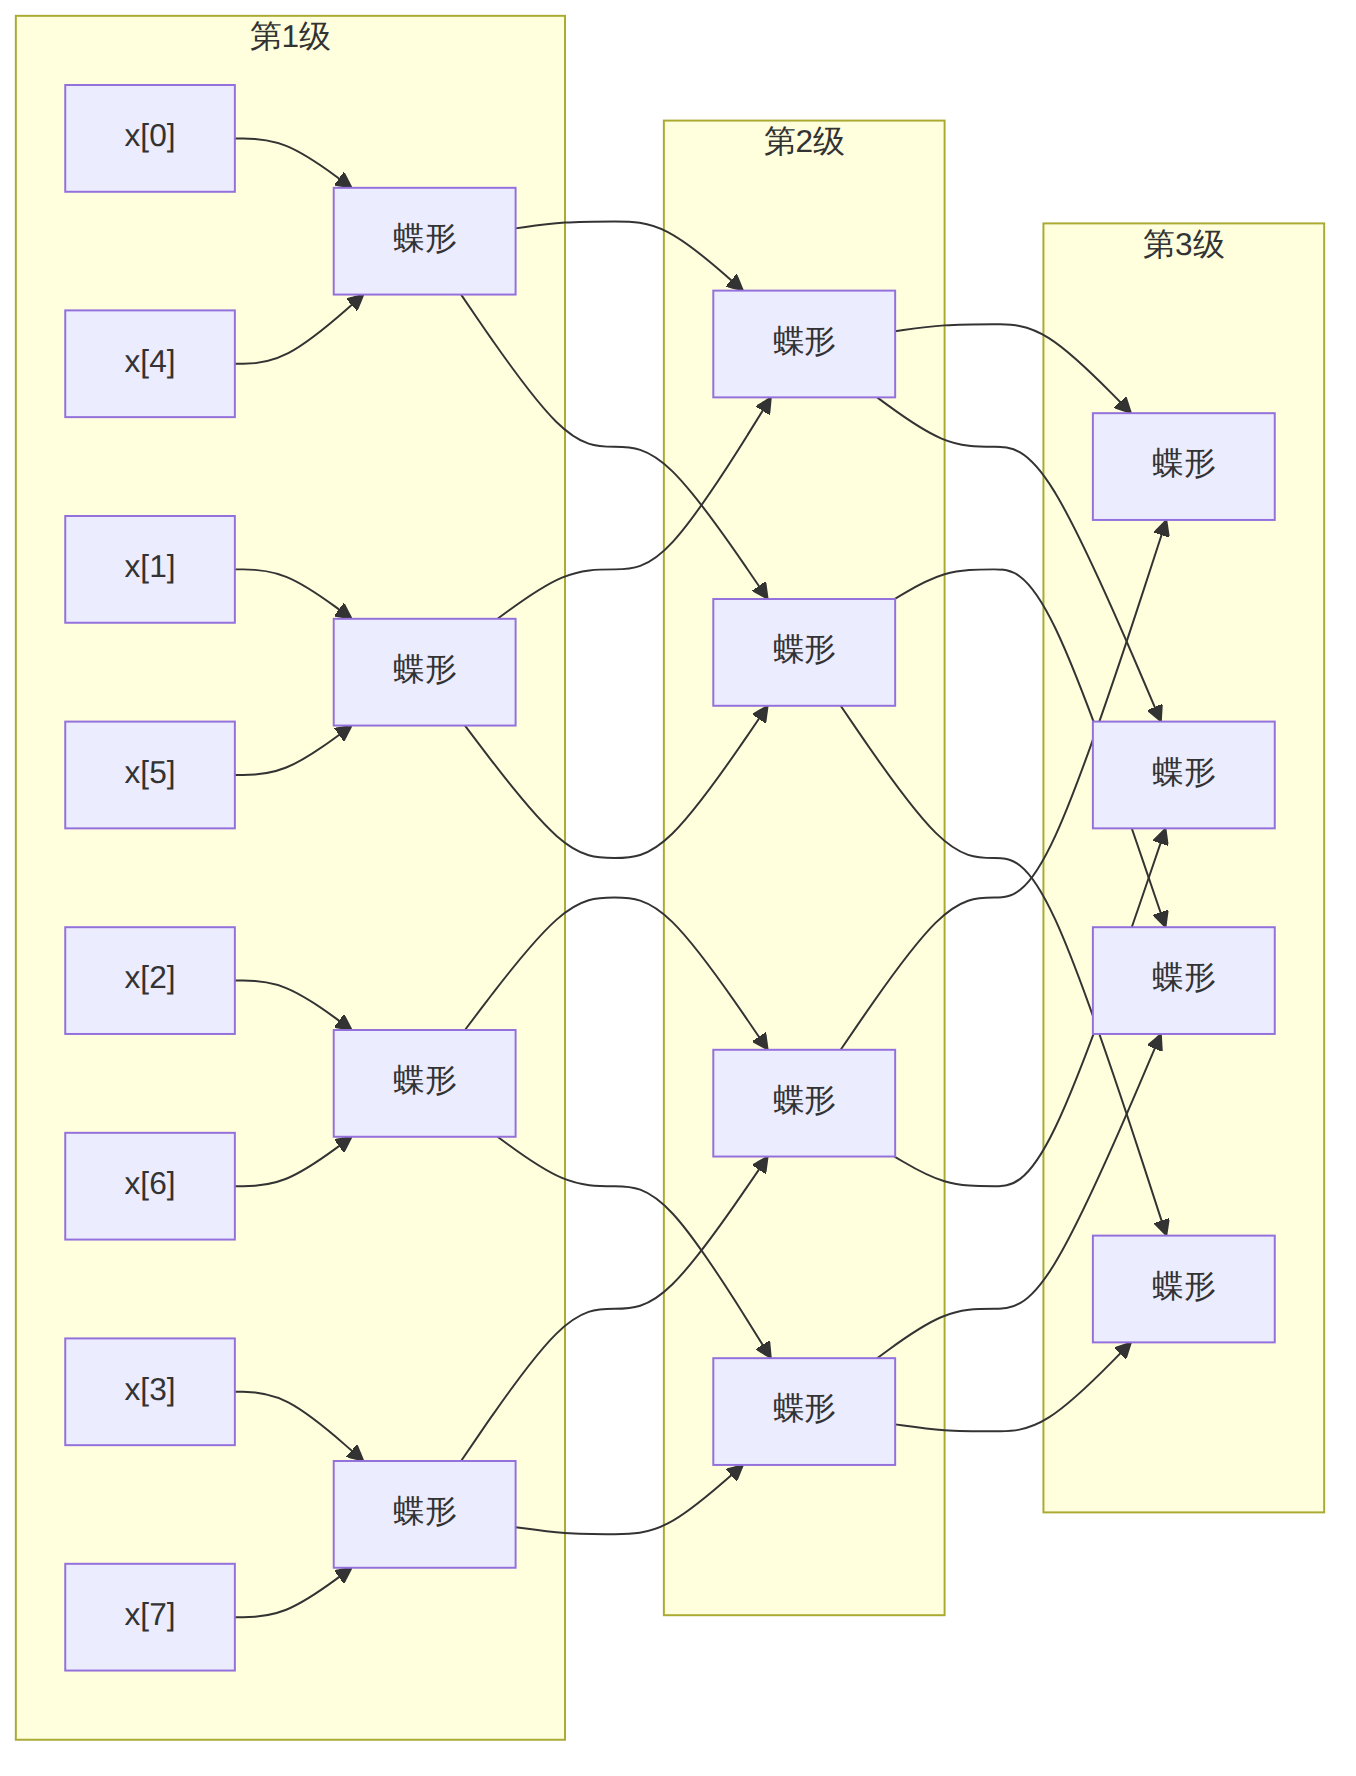
图表 3
工程直觉:FFT蝶形结构的最大价值在于天然适合硬件并行。每个蝶形运算独立,FPGA/ASIC可以同时执行多个蝶形。这也是为什么5G基站能在微秒级完成4096点FFT——数百个蝶形运算单元并行工作。
在OFDM系统中,IFFT是调制器,FFT是解调器。为什么是IFFT而不是FFT用于发送端?
回想DFT公式。IFFT的数学定义:
$$x[n] = \frac{1}{N} \sum_{k=0}^{N-1} X[k] \cdot e^{j\frac{2\pi}{N}nk}$$
在OFDM中: - $X[k]$ 是第k个子载波上承载的数据符号(QAM符号) - $x[n]$ 是合成的时域OFDM符号 - 每个复指数 $e^{j\frac{2\pi}{N}nk}$ 就是一个子载波
用类比理解:IFFT就像一个混音器。每个子载波是一件乐器的声音,IFFT把所有乐器的声音混合成一首完整的交响乐(时域信号)。接收端的FFT则是把交响乐拆解回每件乐器的独奏。
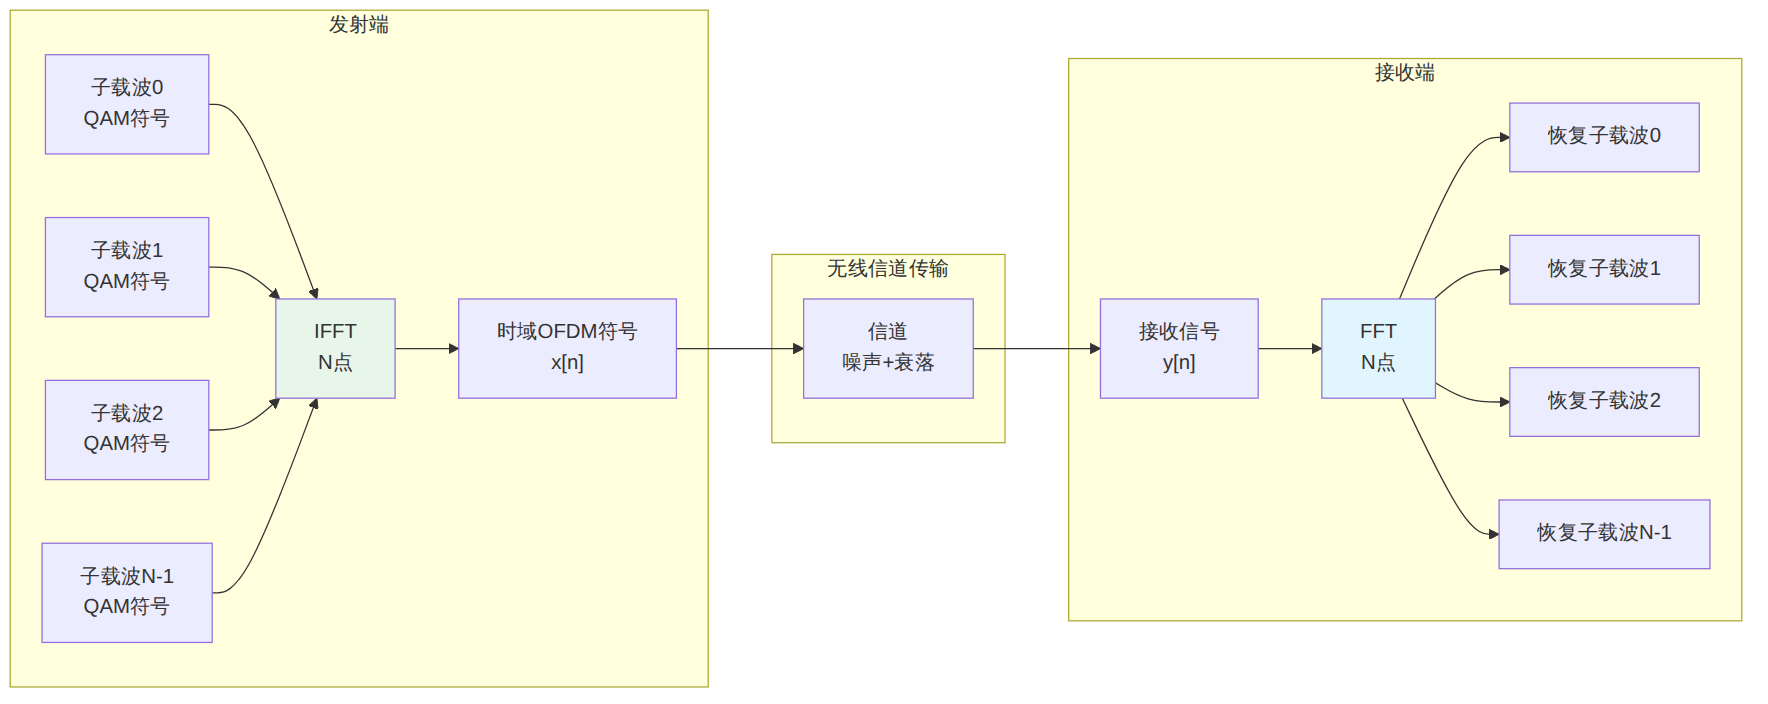
图表 4
IFFT生成的OFDM符号在通过多径信道后,会产生符号间干扰(ISI)。解决方法是复制OFDM符号尾部的信号,粘贴到前面作为循环前缀(CP)。
为什么不是简单补零? 因为循环前缀使得OFDM符号与信道之间的线性卷积变成了循环卷积。循环卷积在频域对应于简单的逐点乘法:$Y[k] = H[k] \cdot X[k]$。这大大简化了接收端的信道均衡——只需一次除法就能恢复数据。
5G NR中定义了两种CP:
| CP类型 | 长度(相对符号长度) | 适用场景 |
|---|---|---|
| Normal CP | ~7% | 常规场景,频谱效率高 |
| Extended CP | ~25% | 大时延扩展场景(如MBMS单频网) |
1948年,香农证明了划时代的信道编码定理:只要传输速率低于信道容量,就一定存在某种编码方式,使得误码率可以任意小。
$$C = B \cdot \log_2\left(1 + \frac{S}{N}\right)$$
其中 $C$ 是信道容量(bps),$B$ 是带宽(Hz),$S/N$ 是信噪比。
但香农只证明了存在性,没有给出具体怎么构造这样的码。此后几十年,通信工程师们一直在寻找逼近香农限的实用编码方案。
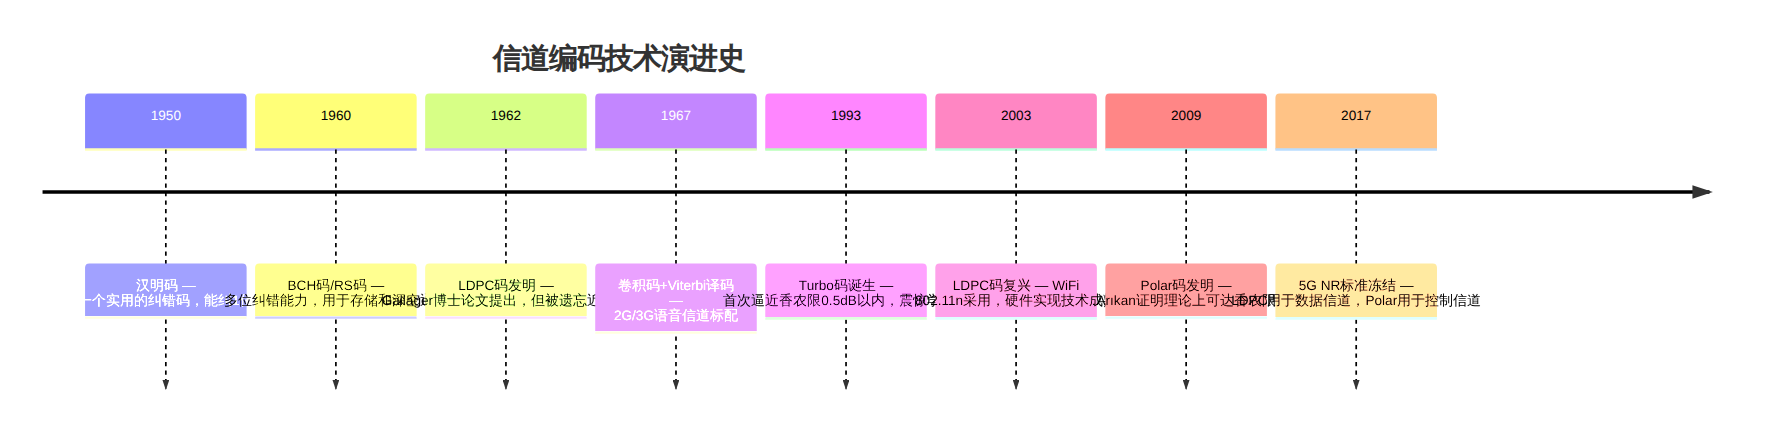
图表 5
这张时间线解释了为什么5G没有沿用4G的Turbo码——不是因为Turbo码不好,而是因为不同场景需要不同的最优解。
| 信道类型 | 编码方案 | 典型载荷大小 | 选择理由 |
|---|---|---|---|
| PDSCH/PUSCH(数据) | LDPC码 | 数百~数万比特 | 长码性能优、并行吞吐高 |
| PDCCH/PUCCH(控制) | Polar码 | 数十~数百比特 | 短码性能优、构造确定 |
| PBCH(广播) | Polar码 | 固定32比特 | 短码场景 |
| DCI/UCI | Polar码 | 20~140比特 | 可靠性优先 |
LDPC(Low-Density Parity-Check)码的核心是一个稀疏的校验矩阵H。所谓"低密度",是指矩阵中1的个数远少于0的个数。
用比喻理解:想象一个工厂有100个工人(信息比特)和50个质检员(校验方程)。每个质检员只检查少数几个工人的工作(稀疏连接),每个工人也只被少数几个质检员检查。通过质检员之间反复交换信息(迭代),最终能精确定位哪些工人出了错。
这种结构用Tanner图表示最直观:
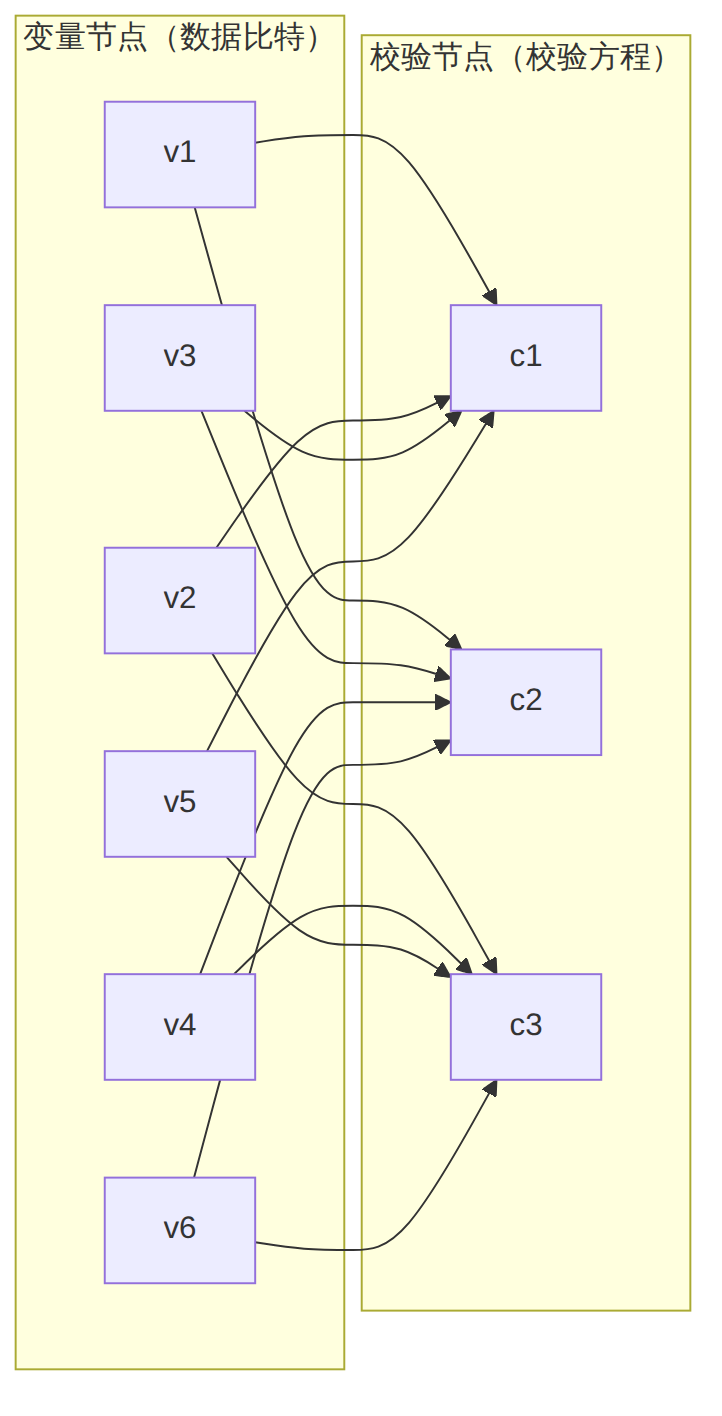
图表 6
LDPC译码采用置信度传播(Belief Propagation, BP)算法,也称为和积算法(Sum-Product Algorithm)。核心步骤:
工程直觉:BP算法的每一次迭代,就像质检员们开一轮会。第1轮可能只有60%的置信度,经过几轮信息交换后,置信度可能提升到99.9%。实际5G系统中通常5~20次迭代就能收敛。
5G标准为LDPC码定义了两张基图(Base Graph):
| 参数 | BG1 | BG2 |
|---|---|---|
| 适用码长 | 较长(≥3840比特偏好) | 较短(<3840比特偏好) |
| 适用码率 | 中高码率(0.33~0.93) | 低码率(0.03~0.67) |
| 基图大小 | 46×68 | 42×52 |
| 典型场景 | eMBB大数据传输 | 小包/物联网数据 |
提升结构(Lifting):基图中的每个非零元素被一个 $Z \times Z$ 的循环置换矩阵替代。$Z$ 称为提升值,范围从2到384。这种结构使得硬件实现可以用循环移位寄存器高效完成,大幅降低存储和计算开销。
调试LDPC译码器时的常见问题:
2009年,土耳其比尔肯特大学的Erdal Arıkan教授发现了一个令人惊叹的数学现象——信道极化。
将N个相同的二进制对称信道经过特定的递归变换后,信道容量会发生极化:一部分信道的容量趋近于1(完美信道),另一部分趋近于0(完全不可靠)。当N趋近无穷大时,极化效果越彻底。
$$\text{信道极化}:W \xrightarrow{\text{变换}} {W_N^{(i)}}, \quad i = 0, 1, \ldots, N-1$$
其中部分 $I(W_N^{(i)}) \to 1$(好信道),部分 $I(W_N^{(i)}) \to 0$(坏信道),且:
$$\sum_{i=0}^{N-1} I(W_N^{(i)}) = N \cdot I(W)$$
总容量守恒,只是重新分配了。
用比喻理解:想象你有一箱苹果(N个信道),有些新鲜有些有点烂。通过一种特殊的分拣方法(极化变换),你能把这箱苹果分成两堆——一堆全是好苹果(信息比特放这里),一堆全是烂苹果(固定比特放这里)。分拣方法越精细(N越大),分得越彻底。
Polar码的编码用一个简洁的矩阵乘法完成:
$$\mathbf{x} = \mathbf{u} \cdot G_N$$
其中 $G_N$ 是生成矩阵,由基本核矩阵递归构造:
$$G_2 = \begin{bmatrix} 1 & 0 \ 1 & 1 \end{bmatrix}, \quad G_N = G_2^{\otimes n} \quad (N = 2^n)$$
编码的关键是比特分配: - 选择可靠性最高的K个信道位置,放置信息比特 - 剩余N-K个位置放置冻结比特(通常设为0)
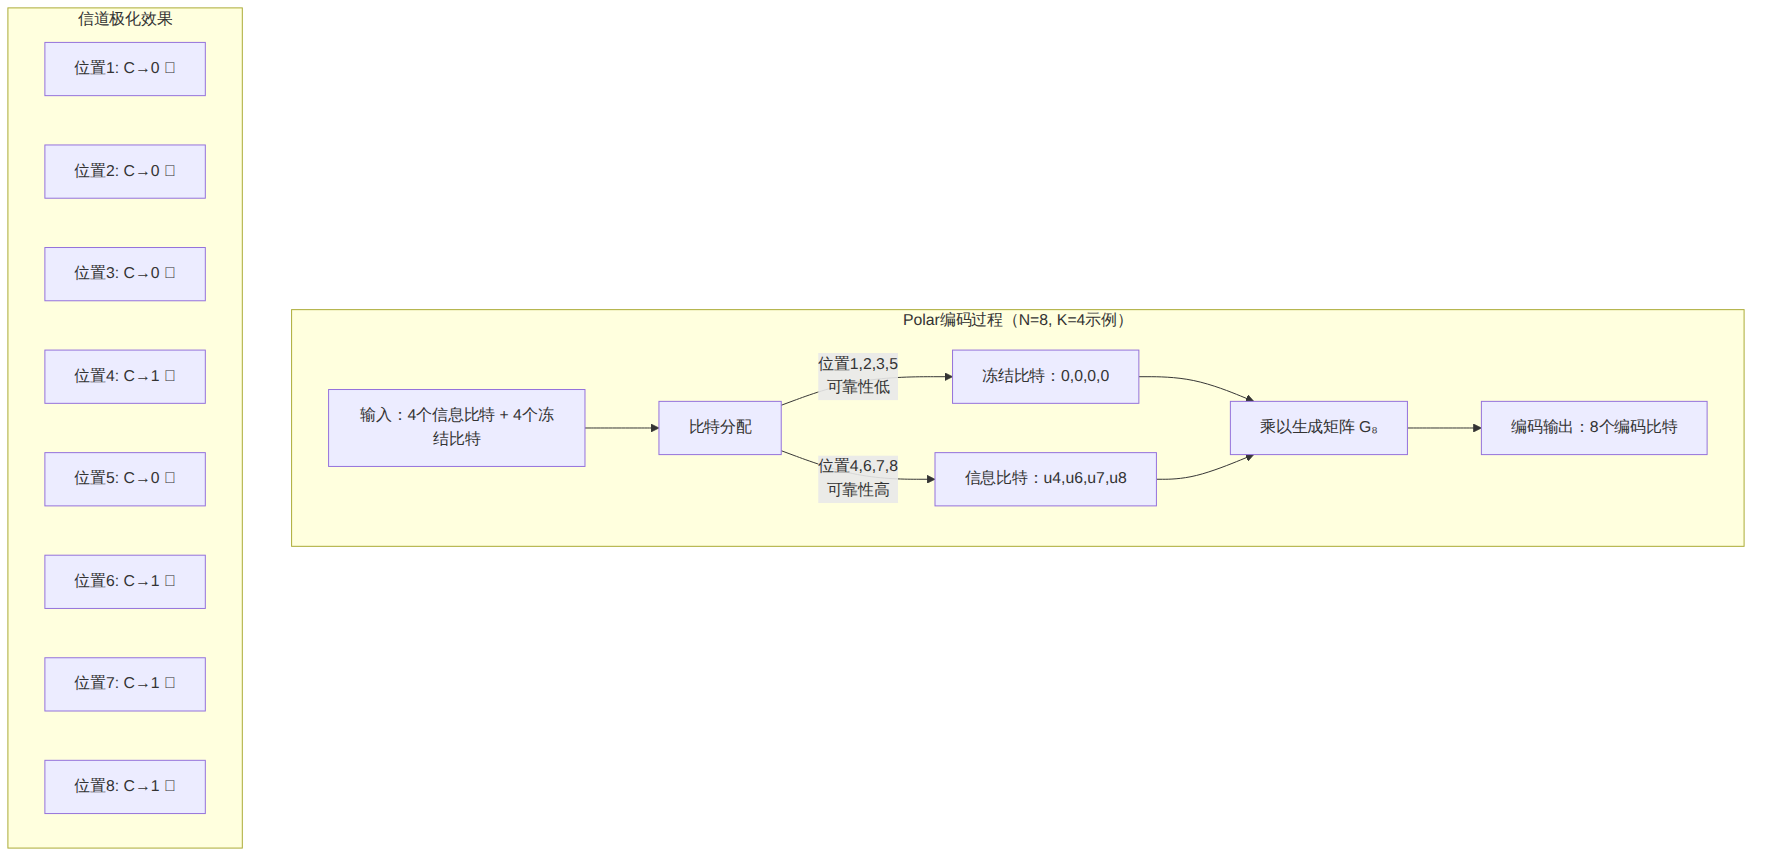
图表 7
Polar码最经典的译码算法是逐次消除(Successive Cancellation, SC)译码。其核心思想是:按顺序逐个判断每个比特的值,已判断的比特作为已知条件辅助后续判断。
SC译码的数学表达:
$$\hat{u}_i = \begin{cases} h_i(y, \hat{u}_0^{i-1}) & \text{if } i \in \mathcal{A} \text{(信息位)} \ 0 & \text{if } i \in \mathcal{A}^c \text{(冻结位)} \end{cases}$$
其中 $h_i$ 是判决函数,$\mathcal{A}$ 是信息位集合。
SC译码的问题:一旦某个比特判错了,错误会传播到后续所有比特。为了解决这个问题,5G NR采用了CRC辅助的SC列表译码(CA-SCL):
| 译码算法 | 原理 | 复杂度 | 性能 |
|---|---|---|---|
| SC | 逐比特硬判决 | $O(N\log N)$ | 一般 |
| SCL | 保留L条候选路径 | $O(LN\log N)$ | 较好 |
| CA-SCL | SCL + CRC校验选最优 | $O(LN\log N)$ | 非常好 |
CA-SCL的巧妙之处在于:同时维护L条(通常L=8或16)候选译码路径,最后用CRC校验来选择正确的那条。这就像迷宫搜索时同时探索L条路,最后选择能到达出口的那一条。
这个问题是3GPP标准化会议上的核心争议。最终选择Polar的原因:
回到开头的全景图,让我们用一个完整的数值案例串联所有环节:
假设一个1000字节的TB需要通过PDSCH传输:
| 处理步骤 | 输入 | 操作 | 输出 |
|---|---|---|---|
| 1. CRC附加 | 8000比特 | 加24bit CRC | 8024比特 |
| 2. 码块分段 | 8024比特 | 分成2个CB | CB1: 4012, CB2: 4012 |
| 3. CB级CRC | 4012×2 | 每个CB加24bit CRC | 4036×2 |
| 4. LDPC编码 | 4036×2 | BG1编码,码率0.5 | 8072×2编码比特 |
| 5. 速率匹配 | 8072×2 | 打孔/重复到目标长度 | 匹配后编码比特 |
| 6. 比特交织 | 匹配后比特 | 交织抗突发错误 | 交织后比特 |
| 7. QAM调制 | 交织后比特 | 256QAM映射 | QAM符号 |
| 8. RE映射 | QAM符号 | 映射到资源网格 | 频域信号 |
| 9. IFFT | 频域信号 | 4096点IFFT | 时域OFDM符号 |
| 10. 加CP | OFDM符号 | 复制尾部到前端 | 完整发射信号 |
当基站出现高BLER(块错误率)时,工程师需要判断是哪个环节出了问题:
| 平均迭代次数 | 含义 | 建议动作 |
|---|---|---|
| 1~3次 | 信道质量极好 | 可提升MCS(更高阶调制) |
| 4~8次 | 正常工作范围 | 保持当前配置 |
| 9~15次 | 信道质量恶化 | 考虑降MCS或增大发射功率 |
| 接近上限 | 严重恶化,可能译码失败 | 检查RF前端、干扰源 |
| 对比维度 | LDPC码 | Polar码 | Turbo码(4G) |
|---|---|---|---|
| 发明时间 | 1962年(Gallager) | 2009年(Arıkan) | 1993年(Berrou) |
| 理论最优性 | 长码逼近香农限 | 理论证明可达香农限 | 长码逼近香农限 |
| 5G应用 | 数据信道 | 控制信道 | 不使用 |
| 4G应用 | 不使用 | 不使用 | 数据+控制信道 |
| 最优码长 | 中长码(>500bit) | 中短码(<500bit) | 中码(~1000bit) |
| 译码并行度 | 高(BP迭代) | 低(SC串行) | 中(迭代但串行约束) |
| 吞吐量 | 极高(>20Gbps) | 中等 | 受限(~1Gbps瓶颈) |
| 实现灵活度 | 码率/码长灵活 | 码长必须为2的幂次 | 固定多项式 |
| 错误平层 | 可能存在 | 不存在 | 可能存在 |
很多初学者把FFT理解为"显示频谱的工具"。在通信系统中,FFT/IFFT是信号生成的核心模块。发射端用IFFT把频域数据变为时域波形,接收端用FFT把时域波形还原为频域数据。没有FFT/IFFT,OFDM的数百个子载波需要数百个独立的振荡器,这在成本和体积上不可接受。
信道编码(LDPC/Polar)和加密是完全不同的功能。信道编码的目的是对抗信道噪声,增加冗余使接收端能纠正错误。任何人拿到编码后的数据,只要知道编码参数,就能还原原始信息。加密则是为了防止未授权访问。
使用LDPC编码后,在相同误码率下可以降低约7~9dB的发射功率。这意味着: - 基站覆盖范围可以扩大(约2倍半径) - 终端电池续航可以延长 - 或者在不增加功率的前提下提升传输速率
这7~9dB就是编码增益——不额外占用频谱资源,纯靠算法获得的性能提升。
Q1: 为什么5G不统一用一种编码方案?
A: 因为没有一种编码在所有场景下都是最优的。LDPC在长码、高吞吐场景下表现优异;Polar在短码、高可靠性场景下更有优势。这就像越野车和跑车——各有所长,混搭使用效果最好。
Q2: FFT点数越大越好吗?
A: 不是。FFT点数增大带来更高的频率分辨率,但也增加了CP开销和时延。5G NR中FFT点数与子载波间隔和带宽相关。120kHz子载波间隔下100MHz带宽需要4096点FFT;而15kHz子载波间隔下5MHz带宽只需512点。选择要匹配实际信道条件和业务需求。
Q3: LDPC和Turbo码的本质区别是什么?
A: LDPC基于图模型(Tanner图),译码通过节点间消息传递实现,天然并行;Turbo码基于级联卷积码+交织器,译码是两个分量译码器之间迭代交换外信息。LDPC的并行性使其在5G高速数据传输中吞吐量远超Turbo。
Q4: Polar码的"冻结比特"有什么实际意义?
A: 冻结比特是放在极化后"坏信道"上的固定值(通常为0)。它们不携带信息,但为"好信道"上的信息比特提供了已知的参考点,帮助译码器更准确地推算信息比特。可以理解为牺牲一部分传输效率,换取更高的可靠性。
Q5: 实际设备中FFT是软件实现的吗?
A: 基站和手机中的FFT/IFFT通常由专用硬件(硬件加速器)完成,不是软件在CPU上运行。因为FFT需要极高的实时性(微秒级完成数千点运算),通用CPU无法满足时延要求。基带芯片中通常有独立的FFT/IFFT硬核模块。
本文由「51学通信」技术团队出品。51学通信由通信行业18年老兵爱卫生(微信ID: gprshome201101)维护,聚焦5G/6G核心网、3GPP标准解读、通信前沿技术深度分析。 出版作品有《5G核心网原理与实践》《IMS原理与实践》等4本通信专业书籍。知识星球「51学通信」提供深度技术答疑和行业洞察。
[!tip] 51学通信知识星球 星主:爱卫生(微信:gprshome201101)——公众号「51学通信」创办者,19 年通信行业运维与讲师经验,著有《GPRS网络信令实例详解》《EPC原理与实践》《5G核心网原理与实践》三本纸质书(各大电商平台有售)。 星球定位:深耕 5G 核心网、IMS、NFV/AI、云原生等 ICT 领域,主打运维岗位与信令分析。 当前规模:5200 篇主题 / 990 个回答,198 元/年。 加入福利:加入星球后请加爱卫生微信,拉您进知识星球年度陪伴与答疑群——不限量回复您的各种问题,另有群内分享。 AI 加持:51学通信知识星球已作为 skill 接入 WorkBuddy,使用 deepseek-4-flash 在海量星球帖子中精准找贴、找视频、找 FAQ 和案例,做总结、找文档和 PPT 等场景全覆盖。
