传统移动通信系统的设计哲学是"先建模、再优化"——工程师通过数学建模(如信道模型、调度算法)来设计系统,然后在实践中调参。这种范式在5G时代已接近瓶颈:Massive MIMO的天线维度从4×4扩展到64×64甚至128×128,波束组合空间呈指数增长;信道状态信息(CSI)的反馈开销在FR2频段高达上行容量的30%-40%;异构网络中的干扰协调需要考虑数千个小区的联合优化。这些问题已经超出了传统解析方法的处理能力。
AI原生通信的核心理念是:不再将AI作为优化工具"外挂"到现有系统中,而是从架构层面将AI/ML作为系统的基本构建单元。这标志着从"AI-for-Communication"到"AI-Native Communication"的范式转变。
3GPP在Release 18中首次系统性地将AI/ML引入NR空接口(TR 38.843),Release 19将研究阶段推进到标准化阶段,Release 20/21则瞄准6G全面AI原生化。与此同时,O-RAN联盟定义了RIC(RAN智能控制器)架构,NVIDIA主导的AI-RAN联盟提出了GPU加速RAN的三位一体架构,TM Forum发布了自智网络L4产业蓝图——整个产业正在从多个维度推进AI原生化的落地。
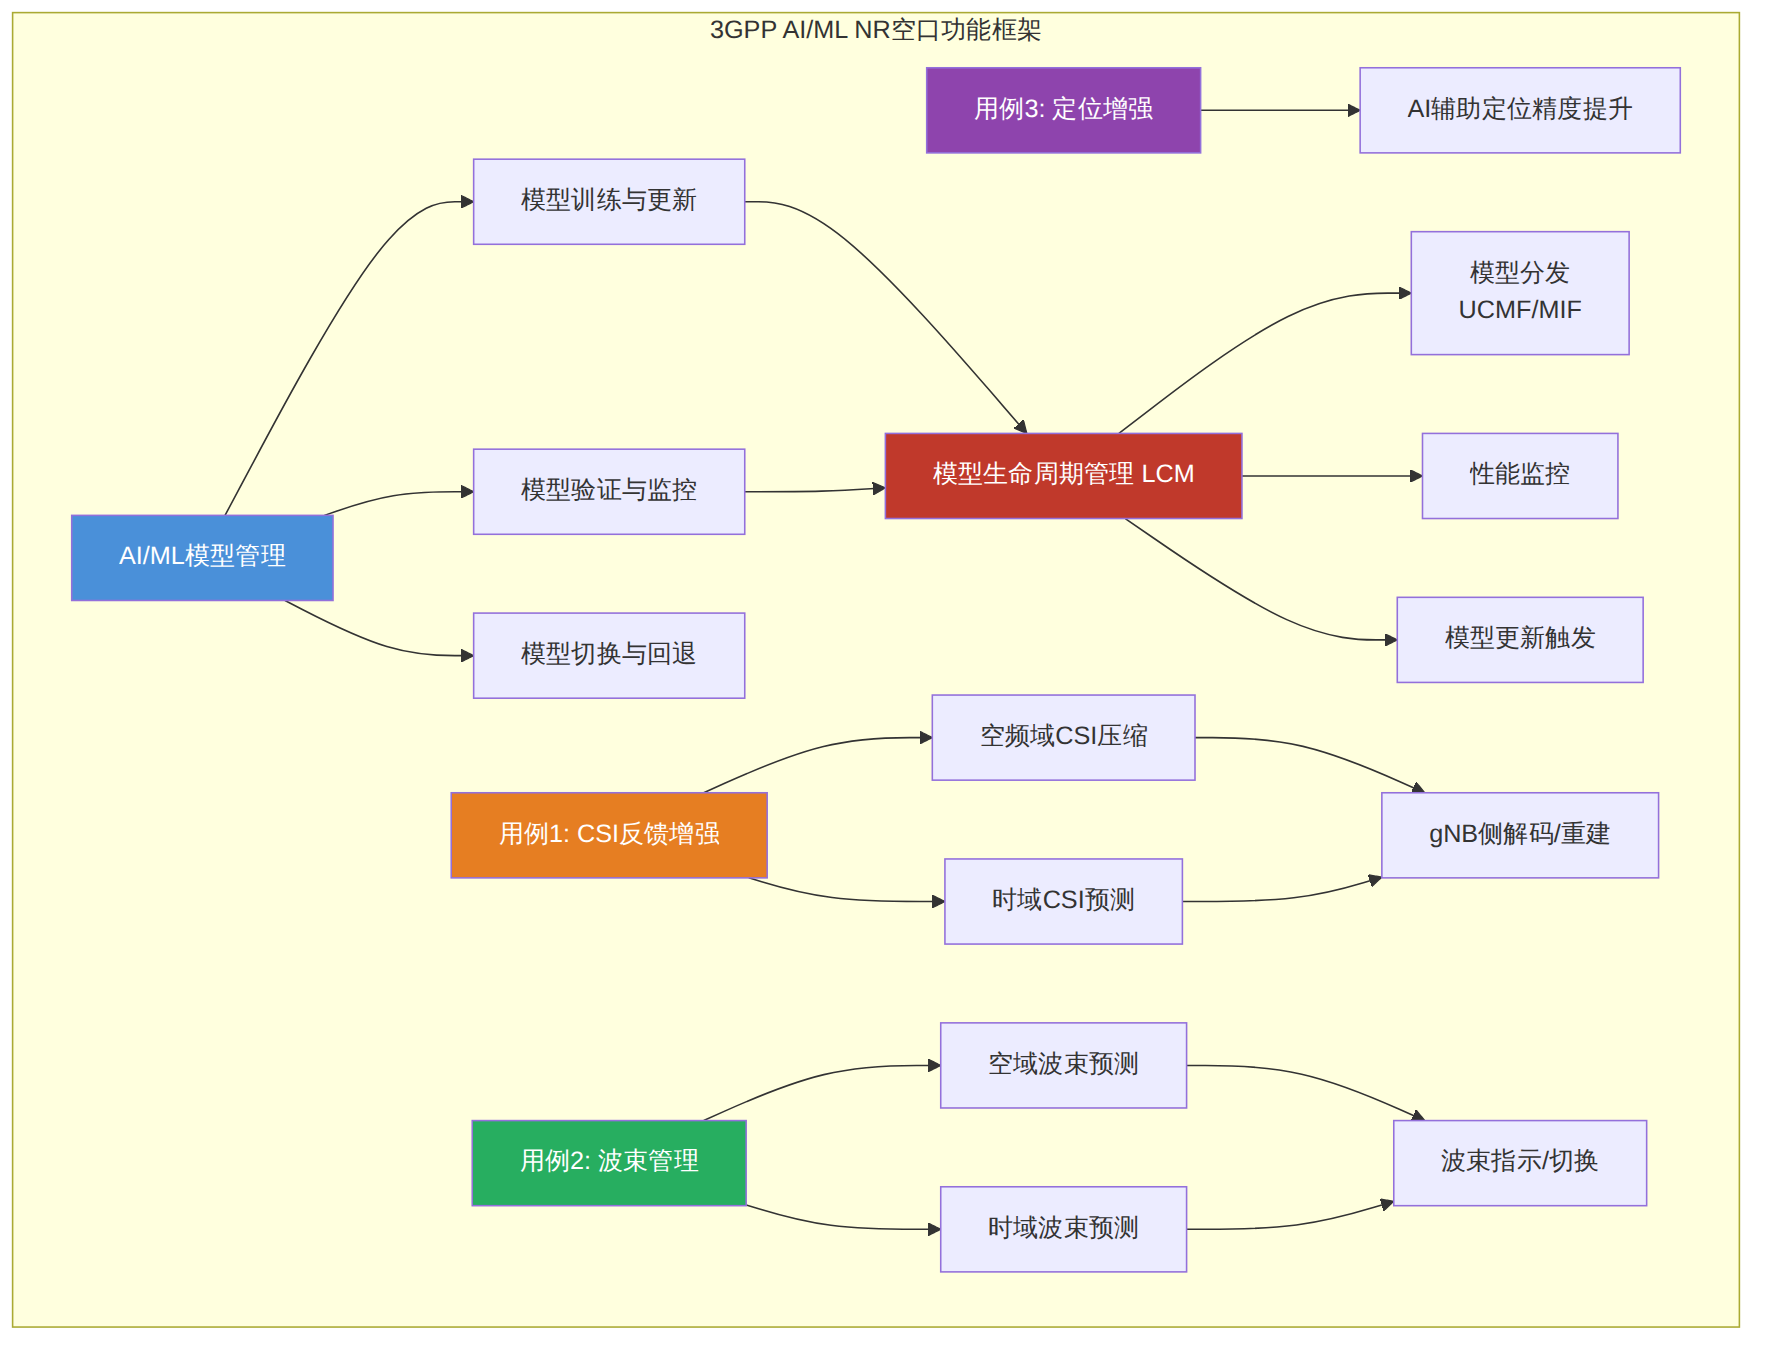
3GPP TR 38.843定义了AI/ML在NR空口的功能框架,包含以下核心功能模块:
图表 1
该框架定义了单侧模型(UE侧或gNB侧独立运行)和双侧模型(UE和gNB协同工作)两种部署模式。对于CSI反馈增强,双侧模型是最典型的场景:UE侧运行编码器压缩CSI,gNB侧运行解码器重建CSI。
传统5G NR的CSI反馈机制基于码本(Codebook)设计:
以32×32的Massive MIMO系统为例,FR2频段下完整的CSI矩阵维度为 $N_c \times N_s \times N_r \times N_t$,其中 $N_c$ 为子载波数(可能数千个),$N_s$ 为空间流数,$N_r$ 为接收天线数,$N_t$ 为发射天线数。直接反馈的overhead不可接受。
3GPP TR 38.843中定义的AI/ML CSI压缩方案,其核心思想可以用以下数学框架描述:
编码器(UE侧): $$\mathbf{z} = f_\theta(\mathbf{H}) \in \mathbb{R}^{d}, \quad d \ll \dim(\mathbf{H})$$
解码器(gNB侧): $$\hat{\mathbf{H}} = g_\phi(\mathbf{z})$$
训练目标: $$\min_{\theta, \phi} \mathbb{E}\left[|\mathbf{H} - g_\phi(f_\theta(\mathbf{H}))|^2_F\right]$$
其中 $f_\theta$ 和 $g_\phi$ 分别为编码器和解码器神经网络,$\mathbf{H}$ 为信道矩阵,$d$ 为压缩后的维度。
| CSI反馈方案 | 反馈开销(比特) | 重建精度(NMSE) | 适用场景 | 标准化状态 |
|---|---|---|---|---|
| Type I Codebook | ~20-50 | -15~-20 dB | SU-MIMO, 低复杂度 | Rel-15已标准化 |
| Type II Codebook | ~100-300 | -25~-30 dB | MU-MIMO, 中等精度 | Rel-15/16标准化 |
| Type II Port Selection | ~80-200 | -22~-28 dB | 灵活天线配置 | Rel-16标准化 |
| AI/ML CSI压缩(单侧) | ~30-80 | -28~-35 dB | UE侧独立模型 | Rel-19标准化 |
| AI/ML CSI压缩(双侧) | ~20-60 | -32~-40 dB | UE-gNB联合优化 | Rel-19标准化 |
| Enhanced AI/ML(R20预期) | ~15-50 | -35~-45 dB | 6G空口 | Rel-20研究 |
关键突破点:R&S与Qualcomm在2025年联合验证了ML增强的CSI反馈在商用终端形态设备上的互操作性,这是AI/ML空口技术从实验室走向商用的里程碑事件。
在FR2(24.25-52.6 GHz)毫米波频段,波束管理是系统性能的关键瓶颈。传统波束管理流程(SSB/CSI-RS based beam sweeping)面临以下问题:
3GPP TR 38.843定义了两种AI/ML波束管理子用例:
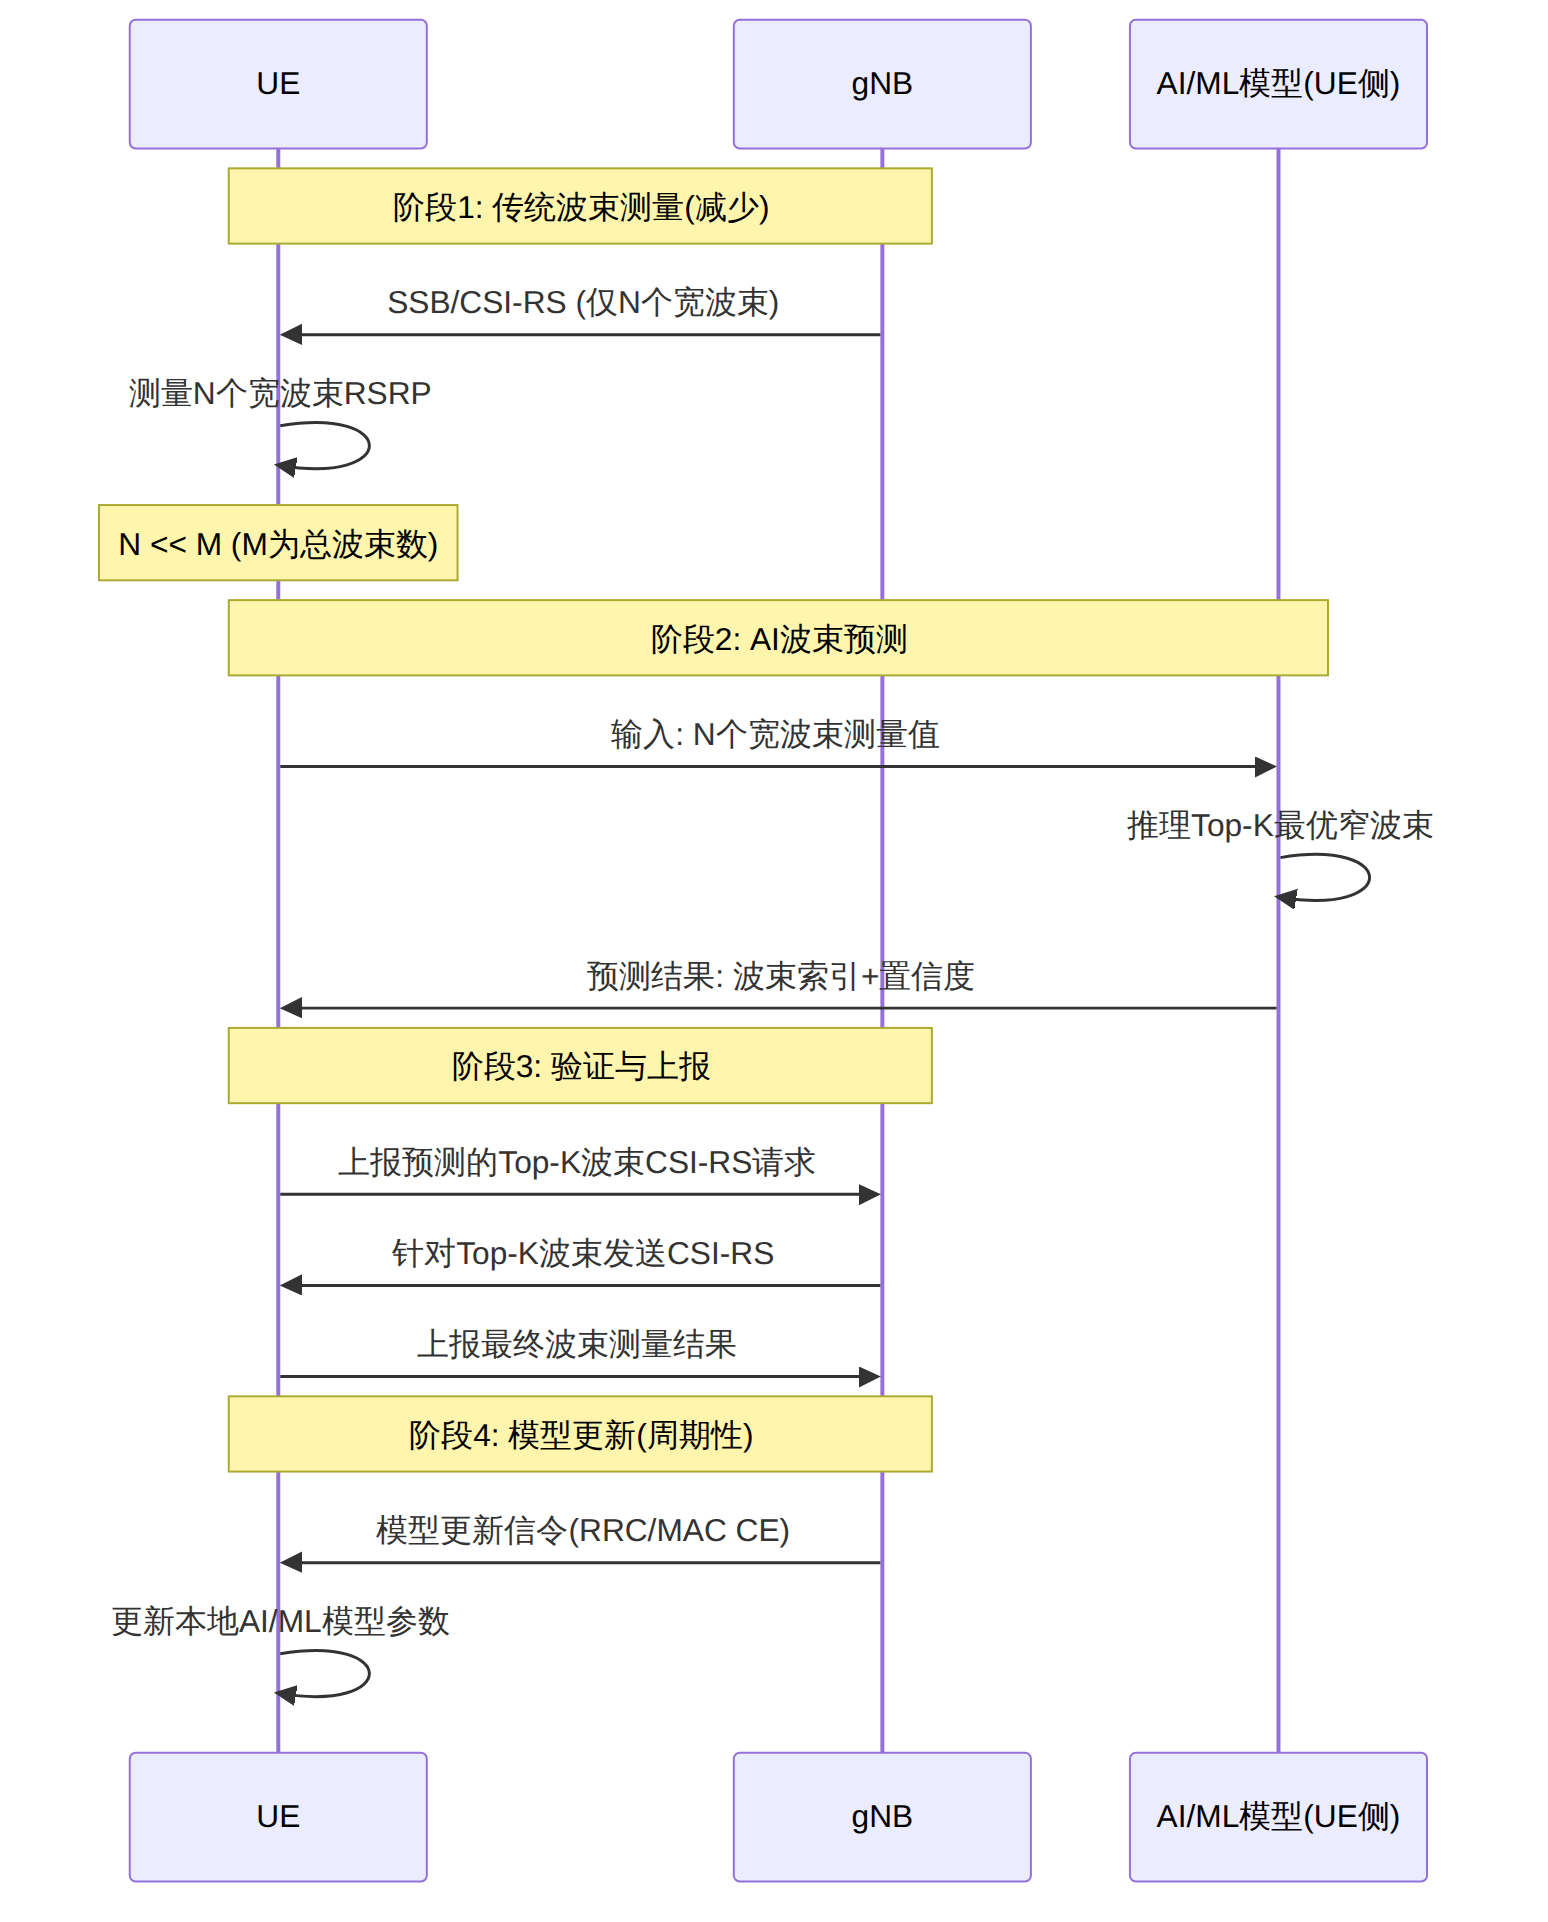
图表 2
波束预测的神经网络架构通常采用轻量级设计。一个典型的空域波束预测模型结构如下:
输入层: N个宽波束RSRP测量值 (N=4~8)
  ↓
全连接层1: 64 neurons + ReLU
  ↓
全连接层2: 128 neurons + ReLU
  ↓
输出层: M个窄波束的RSRP预测值 (M=64)
  ↓
后处理: Top-K选择 + 置信度评估
在实际部署中,模型参数量需控制在10KB以内,以满足UE侧存储和计算约束。推理时延目标为<1ms(单个子帧内完成)。
3GPP Release 19中AI/ML模型的生命周期管理(LCM)是标准化的核心难点。TR 38.843定义了以下LCM功能:
| LCM阶段 | 功能描述 | 信令载体 | 关键参数 |
|---|---|---|---|
| 模型分发 | 将模型参数从网络侧传递给UE | RRC重配 / UCS(UE Capability Update) | 模型ID、版本号、参数集 |
| 模型激活 | 指示UE启用特定AI/ML模型 | MAC CE / DCI | 模型ID、激活时间 |
| 性能监控 | 持续监控模型推理质量 | MAC CE上报 / CSI报告 | NMSE、波束命中率 |
| 模型切换 | 从AI/ML模式切换回传统模式 | MAC CE / DCI | 回退触发条件 |
| 模型更新 | 更新模型参数(增量或全量) | RRC重配 | 新模型参数、更新条件 |
| 模型去激活 | 停止使用AI/ML模型 | MAC CE / DCI | 去激活原因 |
关键设计原则: - 互操作性:不同芯片厂商的UE与不同设备商的gNB之间的AI/ML模型必须互通 - 后向兼容:AI/ML模式与传统模式之间必须能无缝切换 - 安全传输:模型参数通过加密通道传输,防止篡改
2024年成立的AI-RAN联盟(由NVIDIA、AWS、Arm、SoftBank、Ericsson、Nokia等发起)提出了AI-RAN的三大工作负载模型:
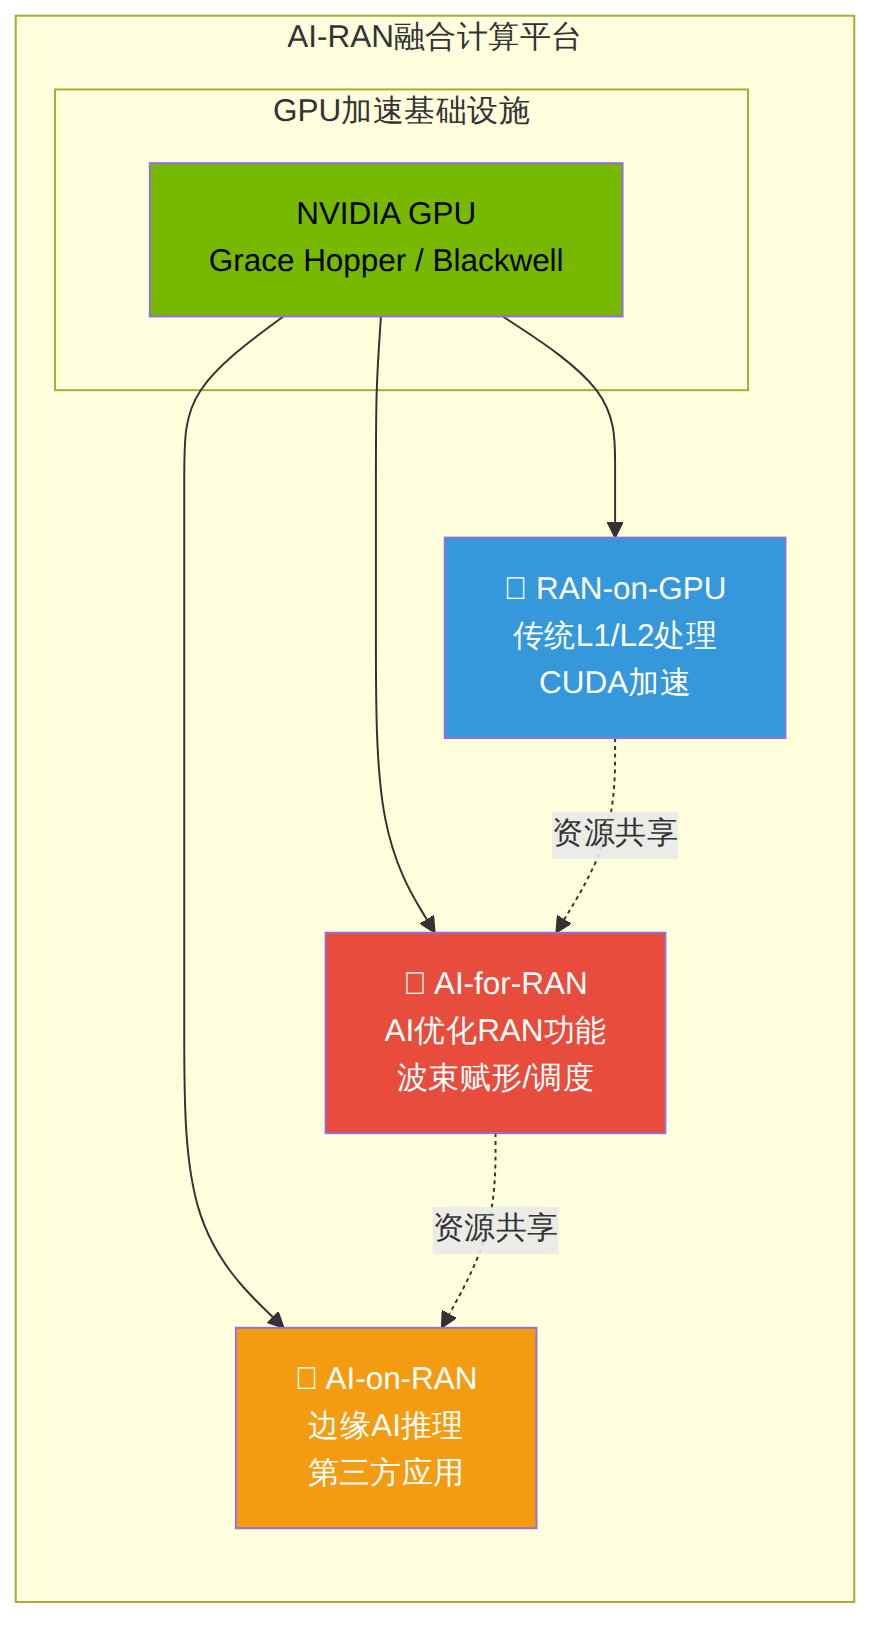
图表 3
三种工作负载详解:
RAN-on-GPU:将传统RAN的PHY/MAC层处理(FFT、信道估计、LDPC/Polar编解码、波束赋形权重计算)迁移到GPU上运行。NVIDIA Aerial SDK提供了cuBB(CUDA Baseband)库,实现Layer 1的GPU加速。关键指标:单卡支持64 TRX @ 100MHz带宽的实时处理。
AI-for-RAN:利用AI/ML模型优化RAN自身功能。典型用例包括: - 基于深度强化学习的动态频谱共享 - 基于图神经网络(GNN)的小区间干扰协调 - 基于Transformer的流量预测与资源预分配 - AI驱动的Massive MIMO预编码优化
AI-on-RAN:在RAN基础设施上运行第三方AI推理应用。将基站站点转变为边缘AI计算节点,为运营商创造新的收入来源。典型场景:自动驾驶车辆的实时感知、AR/VR的边缘渲染、工业质检的实时推理。
O-RAN架构中的RIC(RAN Intelligent Controller)是AI-RAN理念在开放架构中的具体实现:
| 组件 | 延迟范围 | AI/ML能力 | 部署位置 | 典型应用 |
|---|---|---|---|---|
| Non-RT RIC | >1s | 训练、策略优化 | SMO/云端 | rAPP: 网络规划、策略生成 |
| Near-RT RIC | 10ms-1s | 推理、在线优化 | 边缘/数据中心 | xAPP: 负载均衡、切换优化 |
| O-CU/DU | <10ms | 嵌入式AI | 基站站点 | 实时调度、功率控制 |
| AI-RAN GPU | <1ms | 全部(训练+推理) | 基站站点 | PHY层AI、边缘推理 |
Non-RT RIC通过A1接口向Near-RT RIC下发策略,Near-RT RIC通过E2接口控制O-CU/O-DU。AI-RAN架构在此基础上增加了GPU计算层,使得原来只能在云端完成的AI训练可以在基站侧就近完成。
挑战1:实时性保证
传统RAN的L1处理严格遵循TTI(Transmission Time Interval)时序,5G NR中一个slot仅为0.125ms(30kHz SCS)。GPU的推理延迟必须满足:
$$t_{inference} + t_{transfer} < t_{deadline} - t_{margin}$$
其中 $t_{deadline}$ 为协议规定的处理截止时间,$t_{margin}$ 为安全裕量。NVIDIA通过以下技术应对: - GPUDirect RDMA:GPU与网卡之间零拷贝数据传输 - CUDA Stream优先级调度:高优先级RAN任务抢占低优先级AI任务 - 多实例GPU(MIG):物理隔离RAN和AI工作负载
挑战2:功耗与散热
GPU的典型功耗(300-700W)远高于传统基带处理器(50-100W)。在室外基站部署中,散热是硬约束。产业界的解决方案包括: - 采用Grace Hopper等高能效GPU架构(能效比提升3-5x) - 动态功耗管理:根据业务负载动态调整GPU运行频率 - 液冷方案在室内/机房场景的应用
挑战3:软件生态与互操作性
NVIDIA Aerial SDK虽然开源了部分组件,但核心的cuBB库仍为闭源。运营商面临vendor lock-in风险。产业界正在推动: - O-RAN ALLIANCE的开放前传接口标准化 - 3GPP定义AI/ML模型的互操作框架 - 替代GPU方案(AMD、Intel的GPU/FPGA方案)的成熟
TM Forum定义的自智网络(Autonomous Network)分为6个等级:
| 等级 | 名称 | 核心特征 | 典型能力 | 产业现状(2026) |
|---|---|---|---|---|
| L0 | 手动运维 | 全人工操作 | 人工监控、手动配置 | 已淘汰 |
| L1 | 辅助运维 | 工具化辅助 | 自动采集、告警聚合 | 基本淘汰 |
| L2 | 部分自治 | 规则自动化 | 自动巡检、脚本执行 | 大多数运营商 |
| L3 | 条件自治 | 闭环自动化 | 自动故障定位、自愈 | 领先运营商 |
| L4 | 高度自治 | 跨域协同自智 | 端到端自动编排、意图驱动 | 目标阶段 |
| L5 | 完全自治 | 全自主决策 | 零人工干预、自进化 | 远期愿景 |
2025年MWC巴塞罗那的AN峰会上,TM Forum联合75家产业伙伴发布了自智网络白皮书7.0,首次定义了以AN Agent(自智网络智能体)为核心的Agentic功能架构。2026年3月,华为在MWC上首发了AN L4二阶段解决方案,标志着L4进入规模化部署攻坚阶段。
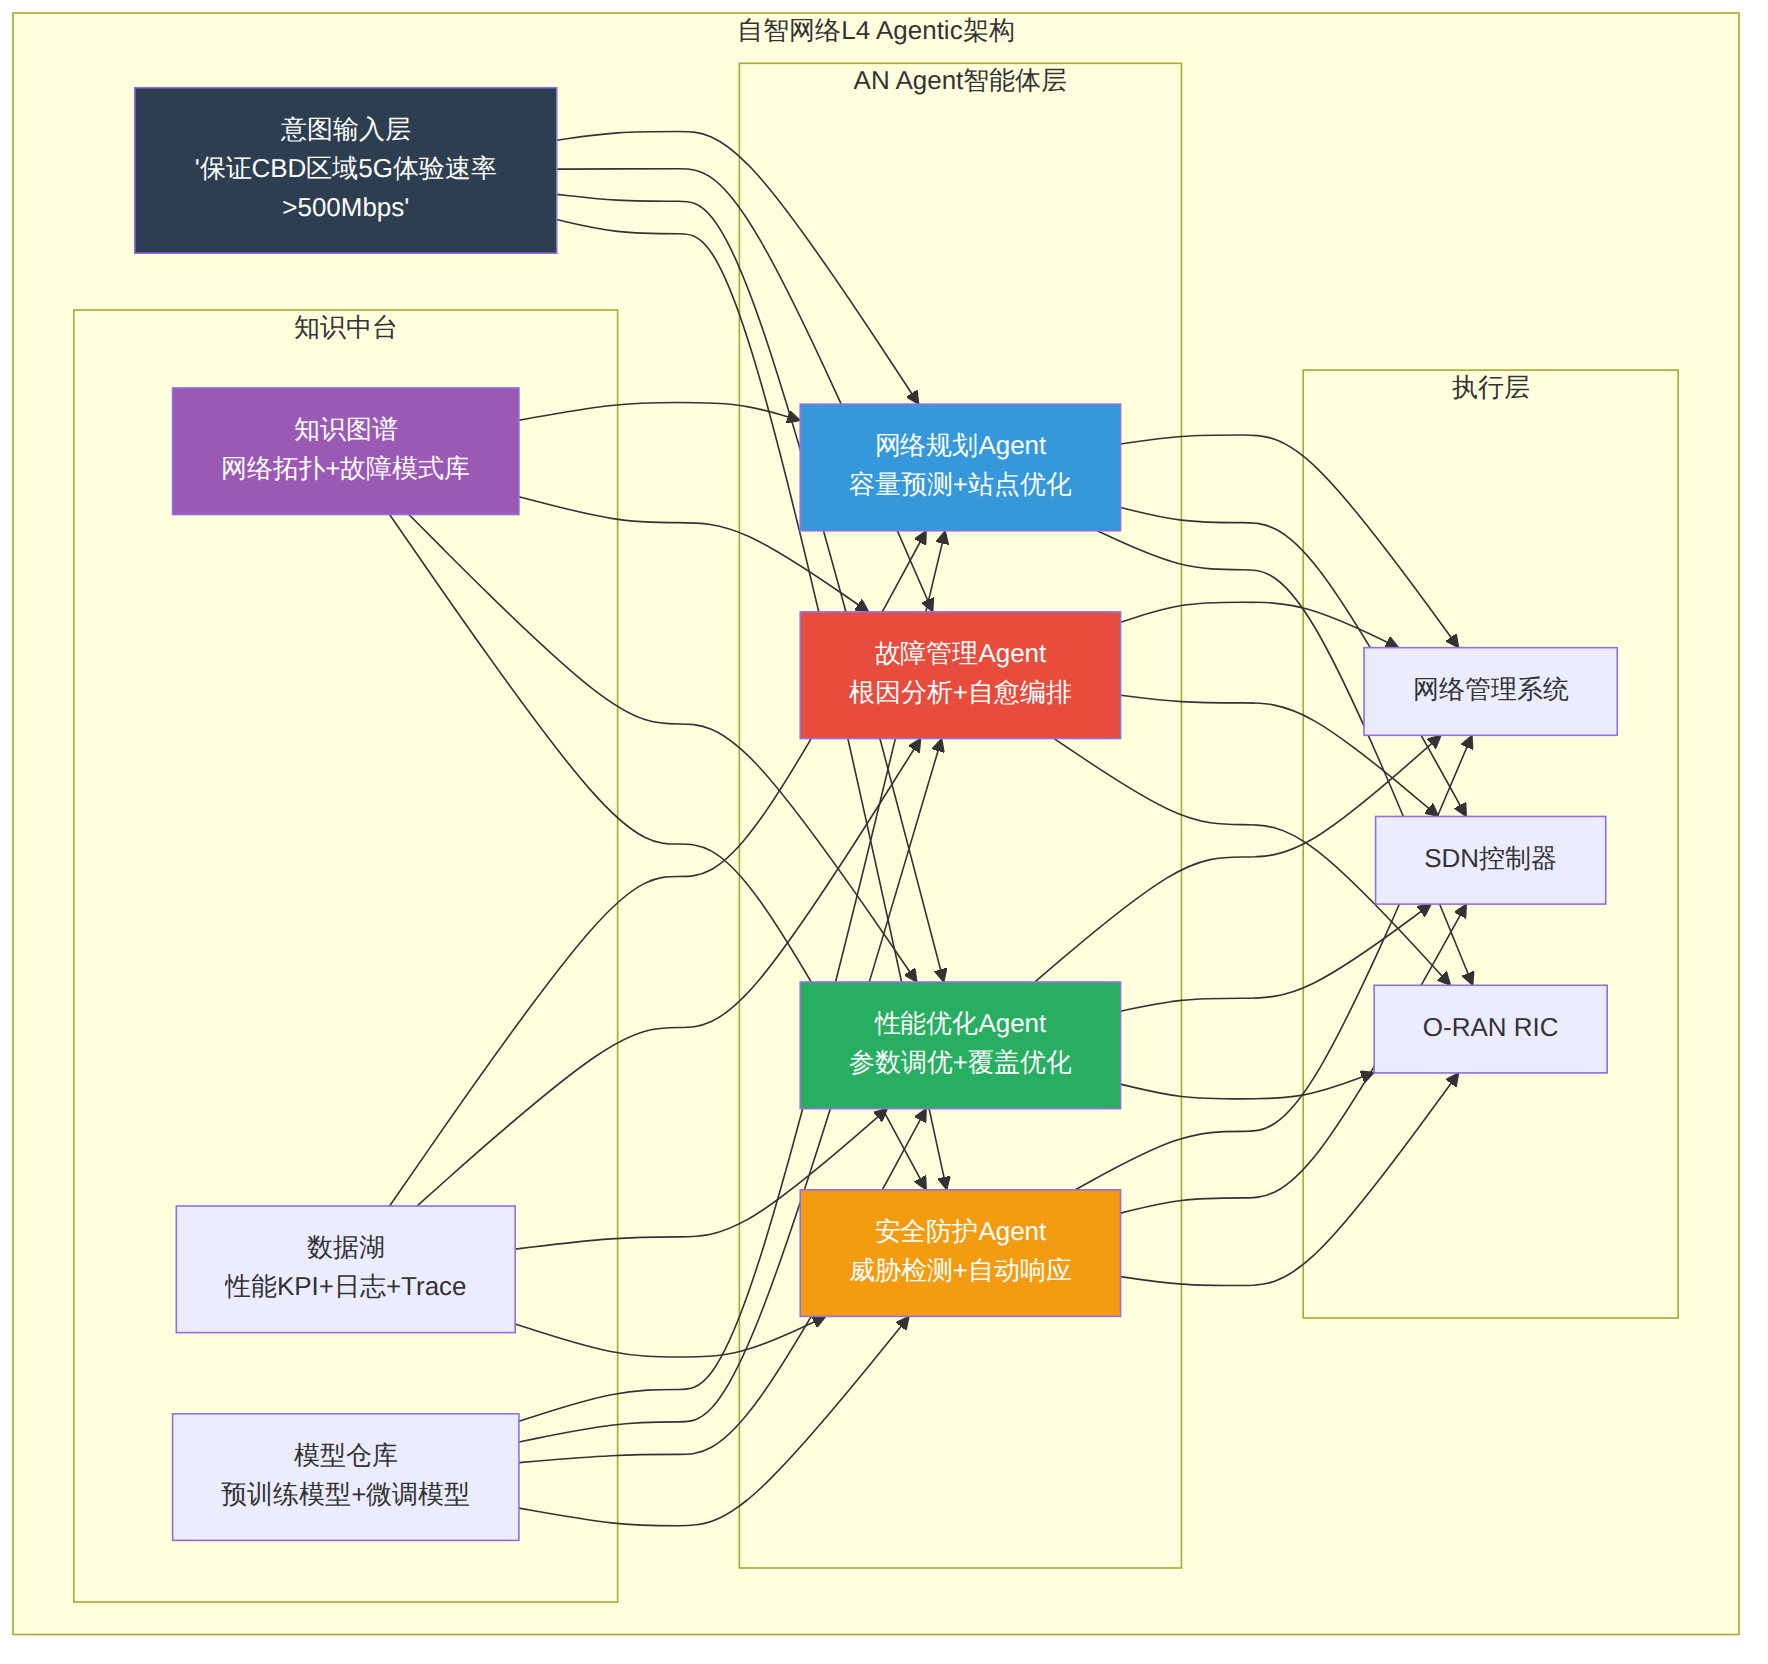
图表 4
意图驱动(Intent-Driven)是L4级自智网络的核心范式。运营商通过声明式语言描述业务目标(如"保证VIP用户体验速率>1Gbps"),AN Agent自动完成从意图解析、策略生成、配置下发到效果验证的全闭环。
以5G网络参数自优化为例,L4级自智网络的决策流程如下:
1. 意图接收: "优化CBD区域5G网络KPI"
2. 意图解析: → 覆盖率>95%, 接通率>99.5%, 掉话率<0.1%
3. 现状评估: 当前覆盖率92%, 接通率98.8%, 掉话率0.15%
4. 差异分析: 识别12个弱覆盖小区, 3个高干扰邻区对
5. 策略生成:
   - 调整8个小区的下倾角 (-1°~-3°)
   - 修改5个邻区关系的切换参数 (TTT: 320ms→160ms)
   - 激活3个小区的异频负载均衡
6. 预影响评估: 基于数字孪生仿真预测效果
7. 分步执行: 逐步下发配置, 每步监控KPI变化
8. 效果验证: 覆盖率→95.3%, 接通率→99.6%, 掉话率→0.08%
9. 知识沉淀: 记录成功案例到知识图谱
数字孪生网络(Digital Twin Network, DTN)是实现L4级自智网络的使能技术。它通过在数字空间构建物理网络的实时镜像,提供"先仿真后执行"的决策验证能力。
数字孪生的核心数学模型:
设物理网络状态为 $S_t$,数字孪生状态为 $\hat{S}_t$,孪生保真度定义为:
$$Fidelity(t) = 1 - \frac{|S_t - \hat{S}_t|}{|S_t|}$$
L4级要求保真度 $Fidelity > 0.95$,即数字孪生与物理网络的偏差小于5%。
通信行业大模型在2025-2026年快速发展。典型方案包括:
| 模型 | 参数量 | 核心能力 | 部署方式 |
|---|---|---|---|
| 华为通信大模型 | 数十亿级 | 故障诊断、参数优化、意图理解 | 私有化部署 |
| 中兴uSmartNet | 十亿级 | 网络运维Agent、知识问答 | 边缘+云 |
| 业界通用方案 | 7B-70B | 代码生成、日志分析、报告生成 | 混合部署 |
这些大模型并非直接替代传统网管系统,而是作为AN Agent的"大脑"层,提供自然语言理解、推理决策和知识检索能力。
3GPP Release 19于2025年12月冻结,在AI/ML空口方面完成了以下标准化工作:
| Work Item | 内容 | 状态 | 对应规范 |
|---|---|---|---|
| NR AI/ML Air Interface (CSI) | CSI反馈AI压缩标准化 | 已冻结 | TS 38.214/215 |
| NR AI/ML Air Interface (Beam) | 波束管理AI预测标准化 | 已冻结 | TS 38.300/321 |
| AI/ML Model LCM for NR | 模型生命周期管理信令 | 已冻结 | TS 38.331(RRC) |
| AI/ML for NG-RAN | RAN节点间AI协同 | 已冻结 | TS 38.401/410 |
| Energy Saving with AI | AI节能增强 | 已冻结 | TS 38.300 |
| AI/ML for MDT | Minimization of Drive Test增强 | 已冻结 | TS 37.320 |
R19相较于R18的关键进步: - R18仅完成了研究阶段(TR 38.843),定义了AI/ML框架和评估方法论 - R19完成了首次标准化,定义了UE-gNB之间AI/ML模型交互的具体信令流程 - R19明确了模型互操作性要求:不同厂商的UE和gNB必须能协同工作
3GPP Release 20预计于2027-2028年冻结,将正式启动6G标准化研究。AI原生化的演进方向包括:
AI原生空口设计:不再以"增强现有空口"为目标,而是从零开始设计AI驱动的空口。可能的方向包括: - 端到端学习的收发机设计(替代传统模块化收发链路) - AI驱动的自适应波形和调制 - 语义通信(Semantic Communication)的标准化
分布式AI架构:联邦学习(Federated Learning)用于保护UE隐私的模型训练: $$\theta_{t+1} = \theta_t + \eta \sum_{k=1}^{K} \frac{n_k}{n} \nabla L_k(\theta_t)$$ 其中 $K$ 为参与UE数量,$n_k$ 为第 $k$ 个UE的数据量,$n = \sum n_k$。
AI原生网络编排:6G网络从设计之初就支持AI工作负载的调度、迁移和弹性伸缩。
场景1:城区Massive MIMO站点AI化
推荐配置:
- CSI反馈模式: AI/ML双侧模型 (R19)
- 波束管理: 空域预测模式, Top-4波束
- 模型更新周期: 24小时(低移动性)/ 1小时(高移动性)
- 性能监控阈值: NMSE < -30dB, 波束命中率 > 90%
- 回退策略: 连续3次NMSE超限 → 切换至Type II Codebook
场景2:AI-RAN边缘推理站点
推荐配置:
- GPU资源分配: RAN 60% / AI-inference 30% / 系统预留 10%
- AI推理优先级: 低于RAN L1处理(确保无线性能不受影响)
- 本地模型缓存: Top-5高频推理模型
- 上行回传带宽预留: >100Mbps(模型同步+数据上传)
AI/ML模型泛化性问题:实验室环境训练的模型在实际网络中性能可能显著下降。建议在商用前至少完成2周的真实网络数据采集和模型微调(Fine-tuning)。
模型版本管理:gNB软件升级时必须同步更新AI/ML模型版本。建议建立"模型+软件版本"的联合管理机制,避免版本不匹配导致的性能退化。
AI-RAN GPU资源争抢:在高峰时段,RAN处理负载增大可能导致AI推理任务被延迟。建议设置严格的QoS隔离策略,RAN工作负载始终享有最高优先级。
自智网络L4的"过度自治"风险:L4级自智网络可能做出次优决策。建议初期采用"人-in-the-loop"模式,所有自动优化操作先在数字孪生中验证,人工审批后执行。逐步积累信任后再过渡到全自动模式。
数据隐私与合规:AI/ML模型训练需要的UE级数据可能涉及用户隐私。联邦学习和差分隐私是主要应对方案,但也增加了模型训练的复杂度。
Q: AI-RAN和传统vRAN的本质区别是什么?
A: 传统vRAN(virtualized RAN)是将基站软件化运行在通用硬件上,核心处理逻辑与传统基站相同,只是载体从专用芯片变成了x86/GPP。AI-RAN在此基础上增加了两层能力:(1) GPU加速的L1处理,使得同一硬件可以同时运行RAN和AI负载;(2) AI/ML模型深度嵌入RAN功能(如CSI反馈、波束管理),从根本上改变了信号处理的方式。简言之,vRAN是"软件化的RAN",AI-RAN是"AI驱动的RAN"。
Q: 3GPP标准化的AI/ML模型和厂商私有的AI模型如何共存?
A: 3GPP标准化的是AI/ML模型的框架和信令交互(如模型分发、激活、监控的协议流程),以及输入输出的接口定义(如CSI反馈的输入格式和输出格式),但并不标准化模型本身的内部结构。这意味着各芯片厂商可以在标准框架内实现自己的神经网络架构。3GPP通过定义统一的性能评估指标(如NMSE阈值)和互操作性测试规范来确保不同厂商产品能够协同工作。
Q: 运营商如何在现网中升级到AI-RAN?
A: 建议分阶段演进:(1) 先在O-RAN架构中部署Non-RT RIC和Near-RT RIC,实现AI-for-RAN的rAPP/xAPP部署;(2) 在新增站点引入GPU加速的基带处理单元(如NVIDIA Aerial),支持RAN和AI混合负载;(3) 待3GPP R19终端大规模商用后,激活空口AI/ML功能(CSI反馈和波束管理)。整个过程不需要一次性替换所有设备,可以按站点/区域逐步升级。
Q: 自智网络L4何时能大规模商用?
A: 根据TM Forum 2025年的调研,85%的运营商计划在2030年前达到L4级别。2026年被定位为L4规模化部署的攻坚之年,中国运营商在L4商用方面处于全球领先位置。L4商用的关键前提条件包括:数字孪生网络的精度达标、AN Agent的决策可靠性验证通过、以及跨域集成的标准化完成。预计2027-2028年L4将进入规模商用阶段。
Q: AI/ML空口技术对终端有什么要求?
A: 终端需要支持AI/ML模型的存储和推理能力。具体包括:(1) 存储空间:约50-100KB用于存储CSI和波束预测模型参数;(2) 计算能力:支持轻量级神经网络推理(<1ms延迟),新一代旗舰SoC已集成NPU可满足需求;(3) 软件升级:需要R19协议栈支持AI/ML相关的RRC/MAC CE信令。实际上,2025-2026年发布的高端智能手机(搭载骁龙8 Gen 4/天玑9400+等)已具备基础AI推理能力,关键在于3GPP R19的商用时间表。
本文由「51学通信」技术团队出品。51学通信由通信行业18年老兵爱卫生(微信ID: gprshome201101)维护,聚焦5G/6G核心网、3GPP标准解读、通信前沿技术深度分析。 出版作品有《5G核心网原理与实践》《IMS原理与实践》等4本通信专业书籍。知识星球「51学通信」提供深度技术答疑和行业洞察。
[!tip] 51学通信知识星球 星主:爱卫生(微信:gprshome201101)——公众号「51学通信」创办者,19 年通信行业运维与讲师经验,著有《GPRS网络信令实例详解》《EPC原理与实践》《5G核心网原理与实践》三本纸质书(各大电商平台有售)。 星球定位:深耕 5G 核心网、IMS、NFV/AI、云原生等 ICT 领域,主打运维岗位与信令分析。 当前规模:5200 篇主题 / 990 个回答,198 元/年。 加入福利:加入星球后请加爱卫生微信,拉您进知识星球年度陪伴与答疑群——不限量回复您的各种问题,另有群内分享。 AI 加持:51学通信知识星球已作为 skill 接入 WorkBuddy,使用 deepseek-4-flash 在海量星球帖子中精准找贴、找视频、找 FAQ 和案例,做总结、找文档和 PPT 等场景全覆盖。
