
3GPP在Release 18启动了NR空接口AI/ML的可行性研究(TR 38.843),在Release 19正式进入规范化阶段(Work Item: NR_AIML_air)。这标志着无线接入网从"AI辅助优化"正式迈入"AI原生设计"时代。但AI-RAN的内涵远不止于3GPP标准——NVIDIA的Aerial CUDA加速RAN、AI-RAN Alliance的产业联盟、O-RAN的xApp/rApp框架,共同构成了一场从芯片架构到协议栈的系统性重构。
传统RAN的物理层(PHY)和媒体访问控制层(MAC)完全由确定性算法驱动——信道估计依赖导频信号和线性插值,波束管理依赖SSB/CSI-RS的周期性测量,调度依赖固定的QoS映射规则。这种设计在Sub-6GHz频段、有限天线数的场景下工作良好,但在毫米波大规模MIMO、超密集组网、高移动性场景中暴露出三大结构性瓶颈:
AI-RAN的本质是将神经网络模型嵌入到PHY/MAC的关键功能模块中,用数据驱动的非线性映射替代部分确定性算法,实现精度-开销-时延的联合优化。
图表 1
NVIDIA提出的AI-RAN架构将传统基带的DSP/FPGA处理替换为GPU并行计算。核心思想是:将L1物理层信号处理(FFT、信道估计、预编码)和AI推理(神经网络前向传播)统一在同一个GPU上运行。
其架构可以表示为:
┌─────────────────────────────────────────────┐
│         GPU-Accelerated Baseband Unit        │
├─────────────┬───────────────┬───────────────┤
│ 传统PHY处理  │  AI推理引擎    │  RAN智能调度   │
│ (CUDA Core) │ (Tensor Core) │ (AI Scheduler)│
│             │               │               │
│ • FFT/IFFT  │ • CSI压缩解码  │ • 负载预测     │
│ • LDPC/Polar│ • 波束预测     │ • 切换决策     │
│ • 速率匹配  │ • 信道重建     │ • 功耗优化     │
└─────────────┴───────────────┴───────────────┘
SoftBank与NVIDIA的联合验证已在GPU上实现了16层MU-MIMO处理,证明了GPU基带在实际负载下的可行性。Nokia也在2025年宣布全面拥抱AI-RAN路线,计划在NVIDIA GPU上运行全部基站处理。
3GPP在TR 38.843中定义了一个通用的AI/ML框架,涵盖三个核心用例:
| 用例 | AI/ML功能部署位置 | 核心改进 | 对应规范 |
|---|---|---|---|
| CSI反馈增强 | UE侧Encoder + gNB侧Decoder | 反馈开销降低50%-80% | TS 38.214 |
| 波束管理 | UE侧和/或gNB侧 | 减少SSB/CSI-RS测量开销,提升波束预测精度 | TS 38.321 |
| 定位增强 | UE侧和/或LMF侧 | 基于AI的定位精度提升,无需额外参考信号 | TS 38.305 |
3GPP定义了一个关键概念——AI/ML模型的生命周期管理(LCM):
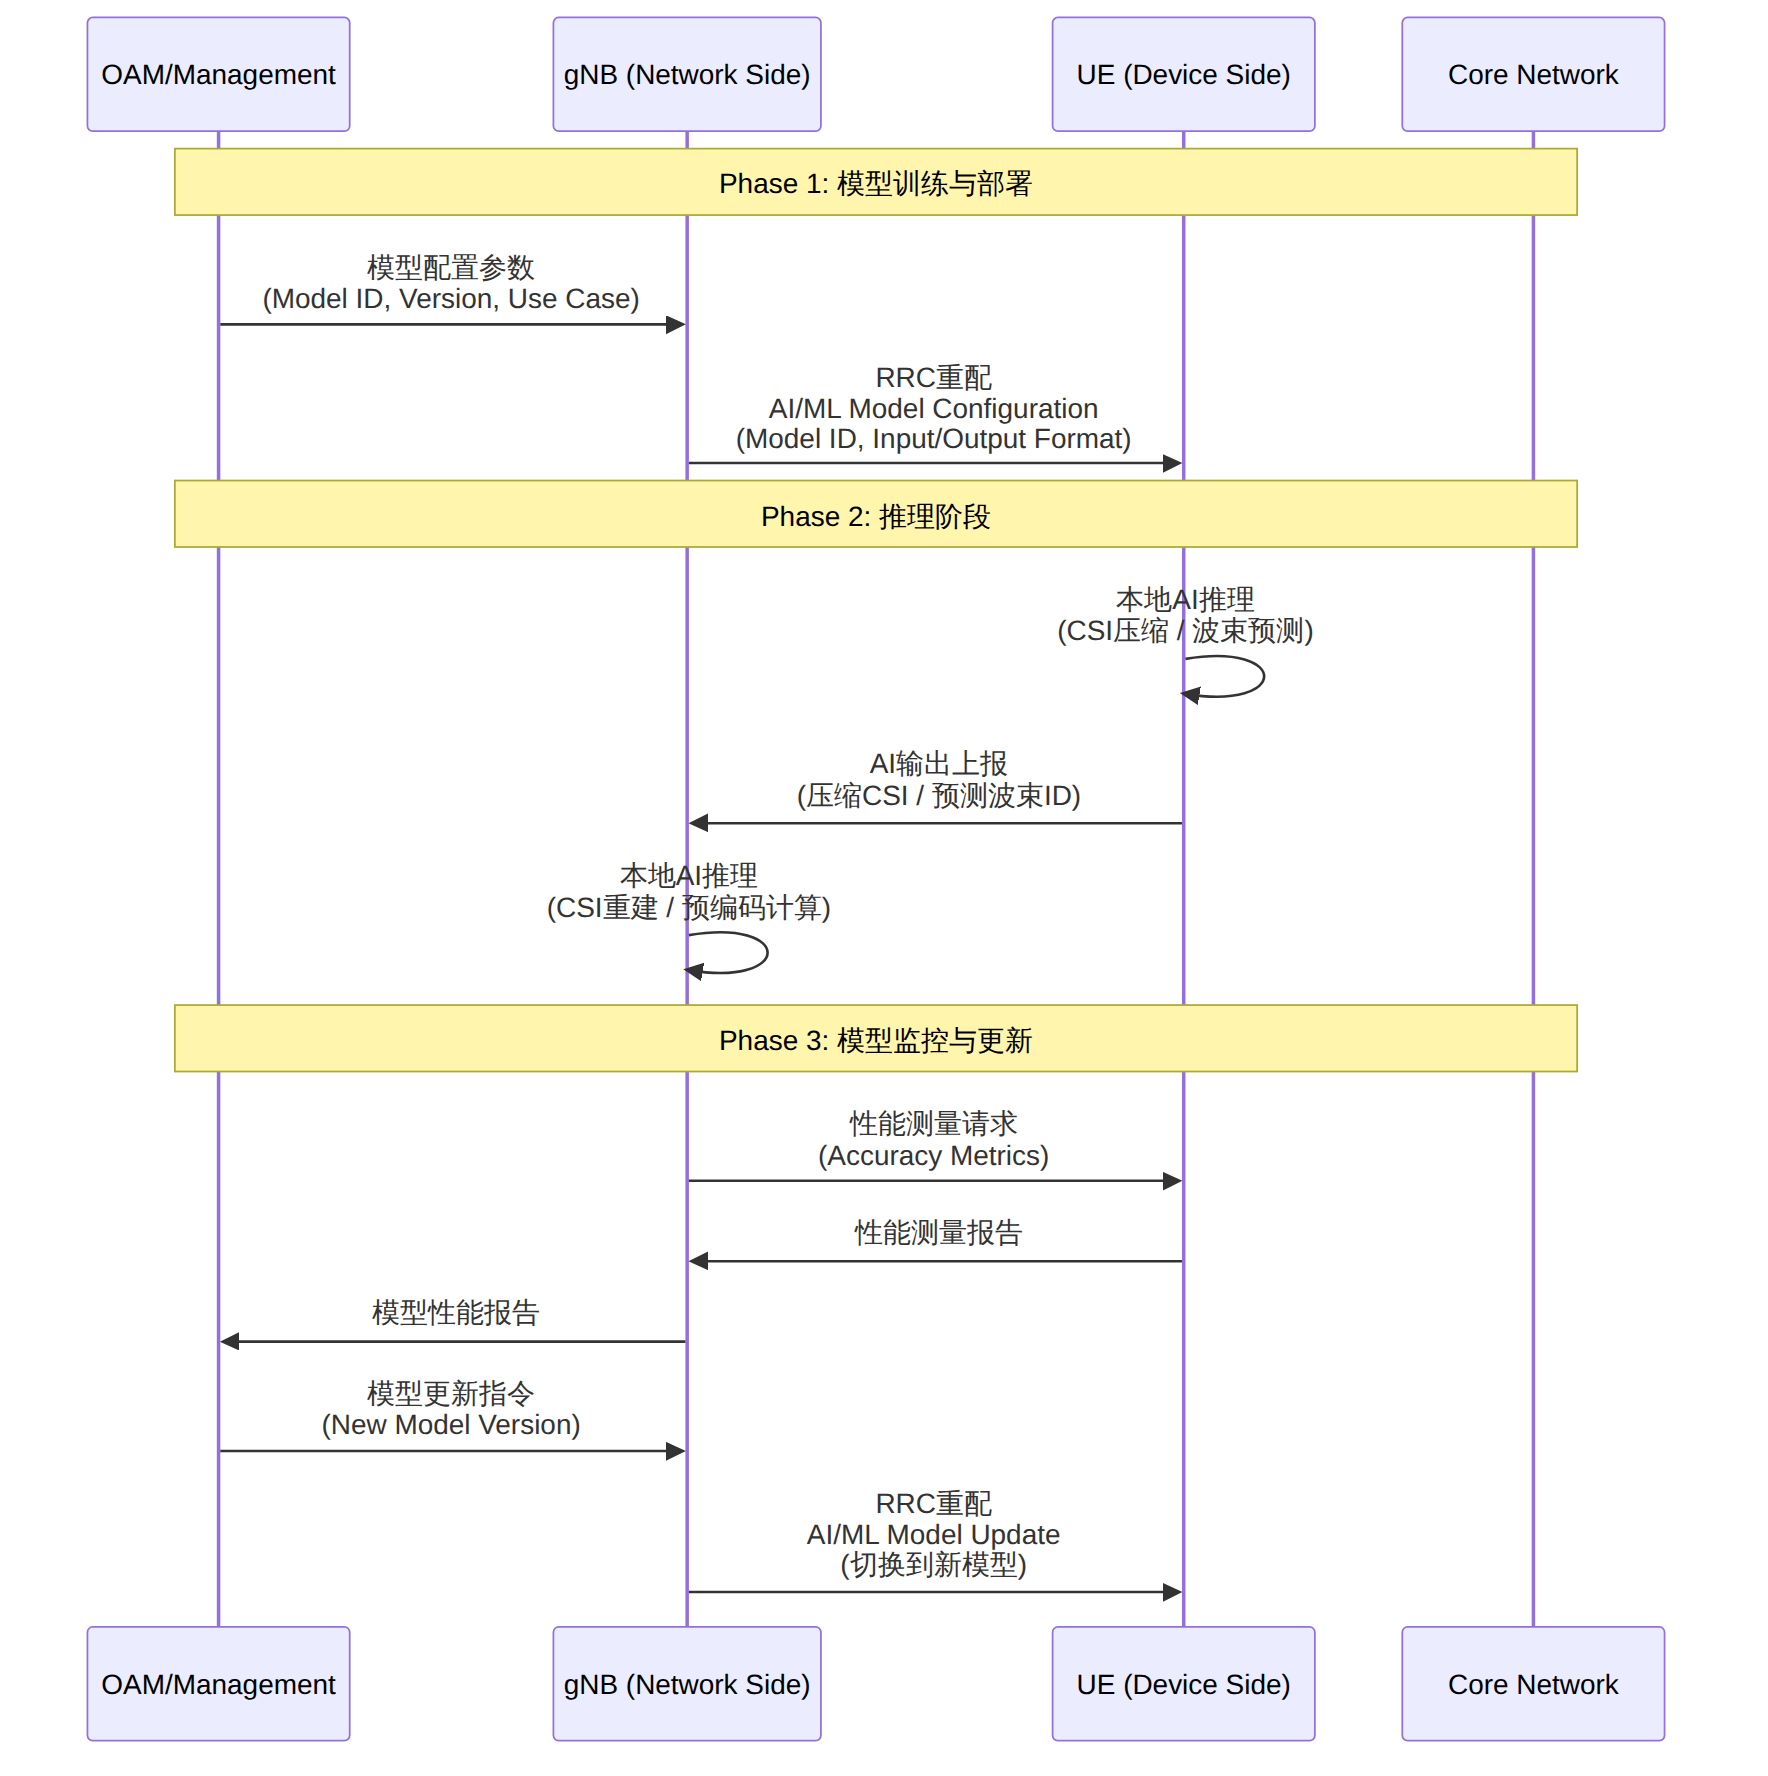
图表 2
传统CSI反馈流程中,UE需要对 $N_t \times N_r$ 的信道矩阵 $\mathbf{H}$ 进行量化。在Massive MIMO场景下,$\mathbf{H} \in \mathbb{C}^{N_r \times N_t}$ 的维度极大。传统方法使用预定义码本 $\mathcal{C}$ 寻找最优预编码矩阵指示(PMI):
$$\text{PMI}^* = \arg\min_{\mathbf{W} \in \mathcal{C}} |\mathbf{H} - \hat{\mathbf{H}}(\mathbf{W})|_F^2$$
其中 $|\cdot|_F$ 是Frobenius范数。码本大小随天线数指数增长,Type II码本的反馈开销高达数百比特。
AI/ML方法的核心是将CSI反馈建模为一个自编码器(Autoencoder)问题:
UE侧(Encoder): $$\mathbf{c} = f_\theta(\mathbf{H})$$
其中 $f_\theta$ 是参数为 $\theta$ 的神经网络,$\mathbf{c} \in \mathbb{R}^d$ 是低维压缩表示,$d \ll N_r \times N_t$。
gNB侧(Decoder): $$\hat{\mathbf{H}} = g_\phi(\mathbf{c})$$
其中 $g_\phi$ 是参数为 $\phi$ 的解码神经网络。
联合训练目标: $$\min_{\theta, \phi} \mathbb{E}\left[|\mathbf{H} - g_\phi(f_\theta(\mathbf{H}))|_F^2\right] + \lambda \cdot R(\mathbf{c})$$
其中 $R(\mathbf{c})$ 是压缩码字的正则化项(如鼓励低熵编码),$\lambda$ 是平衡系数。
3GPP Rel-19定义了两种CSI增强方案:
| 方案 | 描述 | 反馈开销 | 适用场景 |
|---|---|---|---|
| 方案1:基于AI的空域压缩 | 用AI替代Type II码本的空域基压缩(Panels × Ports → 低维向量) | 降低约60% | FR2频段、大规模天线阵列 |
| 方案2:端到端AI CSI | 完全替代传统CSI反馈,从原始信道到压缩码字端到端训练 | 降低约80% | 需UE和gNB联合支持AI/ML |
方案1是向后兼容的渐进式增强——AI只替代空域压缩部分,时频域压缩和CQI计算仍用传统方法。方案2是完全颠覆性的端到端方案,但需要UE具备神经网络推理能力。
3GPP TR 38.843中对可用的神经网络架构类型保持了开放态度,但在实际标准化讨论中形成了以下共识:
推荐架构(根据用例不同):

CSI反馈增强:
  - Encoder: 1D-CNN + FC (空域特征提取)
  - Decoder: Transformer (信道重建中的全局关联)
  - 典型参数量: 50K-200K

波束管理:
  - CNN-LSTM混合架构 (空域特征 + 时序预测)
  - 或轻量Transformer (Attention-based beam scoring)
  - 典型参数量: 20K-100K

定位增强:
  - MLP + Feature Engineering (基于参考信号测量)
  - 典型参数量: 10K-50K
关键约束是UE侧的推理时延和功耗。3GPP要求AI推理不能增加超过1ms的处理时延,且模型参数量需要控制在UE NPU(Neural Processing Unit)可承受的范围内。这排除了大型语言模型级别的架构,更适合轻量化的CNN/MLP方案。
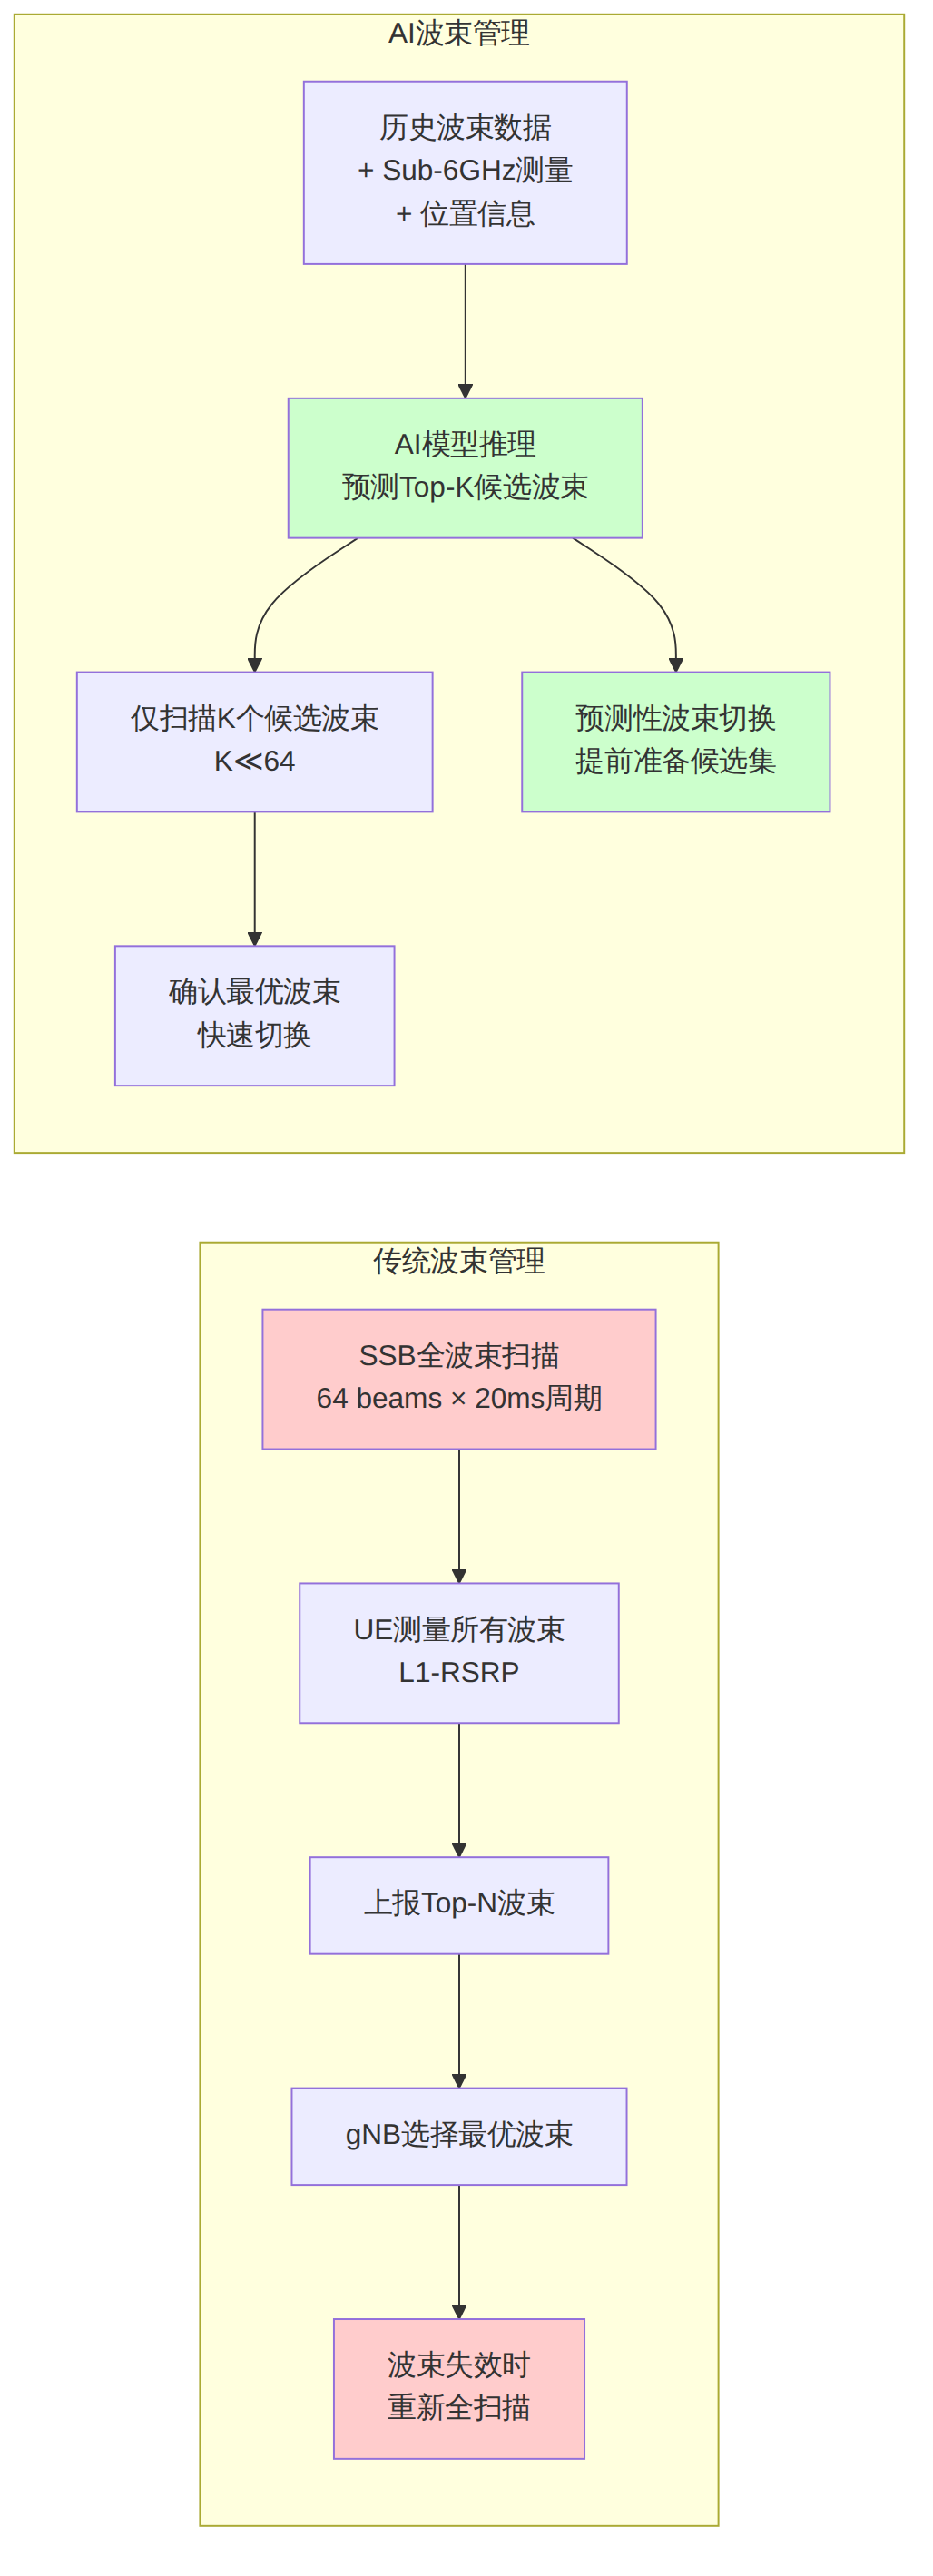
5G NR的波束管理(TS 38.321, TS 38.331)分为三个阶段:
在毫米波频段(FR2: 24.25-52.6GHz),波束宽度极窄(典型3-10°),一个小区可能需要管理数百个窄波束。传统穷举扫描的问题:
AI波束管理的核心思想是利用历史波束测量数据预测未来最优波束,从而减少甚至消除周期性的全波束扫描。
方法1:基于时序预测的波束跟踪
设 $b(t)$ 为时刻 $t$ 的最优波束索引,历史观测序列为 ${b(t-k), b(t-k+1), \ldots, b(t)}$。AI模型学习映射:
$$\hat{b}(t+\Delta t) = f_\theta\big(b(t-k), \ldots, b(t), \text{RSRP}(t-k), \ldots, \text{RSRP}(t)\big)$$
其中 $\Delta t$ 是预测时延。通过LSTM/GRU捕获波束变化的时序模式,可以在不进行实际扫描的情况下预测未来 $N$ 个时隙的最优波束。
方法2:基于侧信息(Side Information)的波束预测
3GPP TR 38.843引入了一个极具创新性的方向——利用UE的位置信息或低频段测量结果辅助毫米波波束预测:
$$P(\hat{b} | \mathbf{x}{\text{pos}}, \mathbf{H})$$}
其中 $\mathbf{x}{\text{pos}}$ 是UE位置坐标(来自GPS或定位服务),$\mathbf{H}$ 是Sub-6GHz频段的信道测量。由于低频段信道与毫米波信道存在空间相关性(同一传播路径在不同频段的到达角相似),低频测量可以作为毫米波波束选择的先验信息。}
图表 3
3GPP Rel-19在RRC层(TS 38.331)引入了新的信令参数来支持AI波束管理:
| RRC IE字段 | 功能 | 取值范围 |
|---|---|---|
AI-BM-Config |
AI波束管理配置 | 包含模型ID、输入输出格式 |
BeamPredictionEnabled |
是否启用波束预测 | Boolean |
SideInfoConfig |
侧信息辅助配置 | 位置信息/Sub-6GHz测量 |
AI-PerformanceMonitor |
AI模型性能监控配置 | 精度阈值、监控周期 |
ModelSwitchConfig |
AI/传统模式切换配置 | 回退条件定义 |
一个关键的协议设计是AI/传统双模回退机制。当AI模型性能降级(如预测准确率低于阈值)时,系统自动回退到传统波束管理流程。这通过MAC CE信令实现快速切换(< 1ms),而RRC重配用于模型更新等慢速操作。
AI-RAN并非凭空出现,而是vRAN(虚拟化RAN)和O-RAN架构的自然演进:
| 演进阶段 | 架构特征 | 计算平台 | AI能力 |
|---|---|---|---|
| 传统RAN | 专用硬件(DSP/ASIC) | 厂商专有芯片 | 无 |
| vRAN | 软件化L1/L2/L3 | 通用x86/ARM | 外部优化 |
| O-RAN | 开放接口 + xApp/rApp | COTS服务器 + GPU | 外部AI(Non-RT/ Near-RT RIC) |
| AI-RAN | AI原生L1/L2/L3 | GPU统一计算 | 嵌入式AI(PHY内 + RIC) |
AI-RAN与前代架构的核心区别在于:AI不是附加在外部的优化层,而是物理层本身的组成部分。
基带处理的实时性要求极为严苛:L1物理层的HARQ ACK/NACK响应时延要求在1个slot内完成(Sub-6GHz约0.5ms,FR2约0.125ms)。GPU传统上不是为硬实时设计。
NVIDIA的解决方案包含三个关键层次:
1. GPU Direct RDMA + DPDK
Radio Unit (RU) → GPU Direct RDMA → GPU显存
                                ↓
                    CUDA Kernel处理 (FFT/预编码/AI推理)
                                ↓
                    GPU Direct RDMA → RU → 天线发射
避免了GPU显存与CPU内存之间的数据拷贝,将空口数据到GPU处理的端到端时延控制在50μs以内。
2. 实时调度器(RT Scheduler) CUDA Stream的优先级调度确保L1处理(高优先级)抢占AI推理(低优先级)的GPU资源,保证空口时序不被违反。
3. 确定性计算时间 通过固定网络架构(无动态图)和Tensor Core的确定性矩阵运算,确保每次推理的时间抖动< 10μs。
GPU基带的功耗是业界争议最大的话题。传统ASIC基站的功耗约为500W-1kW,而NVIDIA Grace Hopper Superchip的TDP高达1kW。AI-RAN的经济可行性依赖于计算复用:
TM Forum定义的自智网络(Autonomous Networks, AN)分为六个等级:
| 等级 | 名称 | 特征 | 典型能力 | 通信行业当前状态(2026) |
|---|---|---|---|---|
| L0 | 手动管理 | 全人工操作 | 无自动化 | 已淘汰 |
| L1 | 辅助管理 | 工具辅助 | 告警监控、日志采集 | 已淘汰 |
| L2 | 部分自治 | 特定场景自动闭环 | 自动故障恢复(单域) | 大多数运营商 |
| L3 | 条件自治 | 跨域自动化 | 端到端业务编排 | 头部运营商(2024-2025) |
| L4 | 高度自治 | 意图驱动、预测性 | 主动预防、多域协同 | 2026年开始试点 |
| L5 | 完全自治 | 零人工干预 | 自进化网络 | 2030+远期目标 |
L4的核心标志是从"告诉网络怎么做"到"告诉网络想要什么"。运营人员不再编写具体的配置脚本,而是以声明式意图(Intent)描述网络目标:
// 传统方式(L2/L3)
configure cell A power = 23dBm
configure cell B power = 20dBm
set handover threshold = -100dBm

// 意图驱动方式(L4)
intent: "确保体育场馆区域的用户体验速率≥50Mbps,"
        "同时整体网络能耗不超过基准的110%"
AI系统自动将意图翻译为具体的网络配置参数,并持续监控实际效果是否满足意图要求。
Huawei在MWC 2026发布的AN L4 Phase 2解决方案中,已经实现了以下意图驱动场景: - 覆盖优化意图:自动调整天线倾角、功率、波束权值 - 节能意图:在满足SLA的前提下最大化网络能效 - 切片SLA意图:自动分配PRB、QoS参数、传输资源
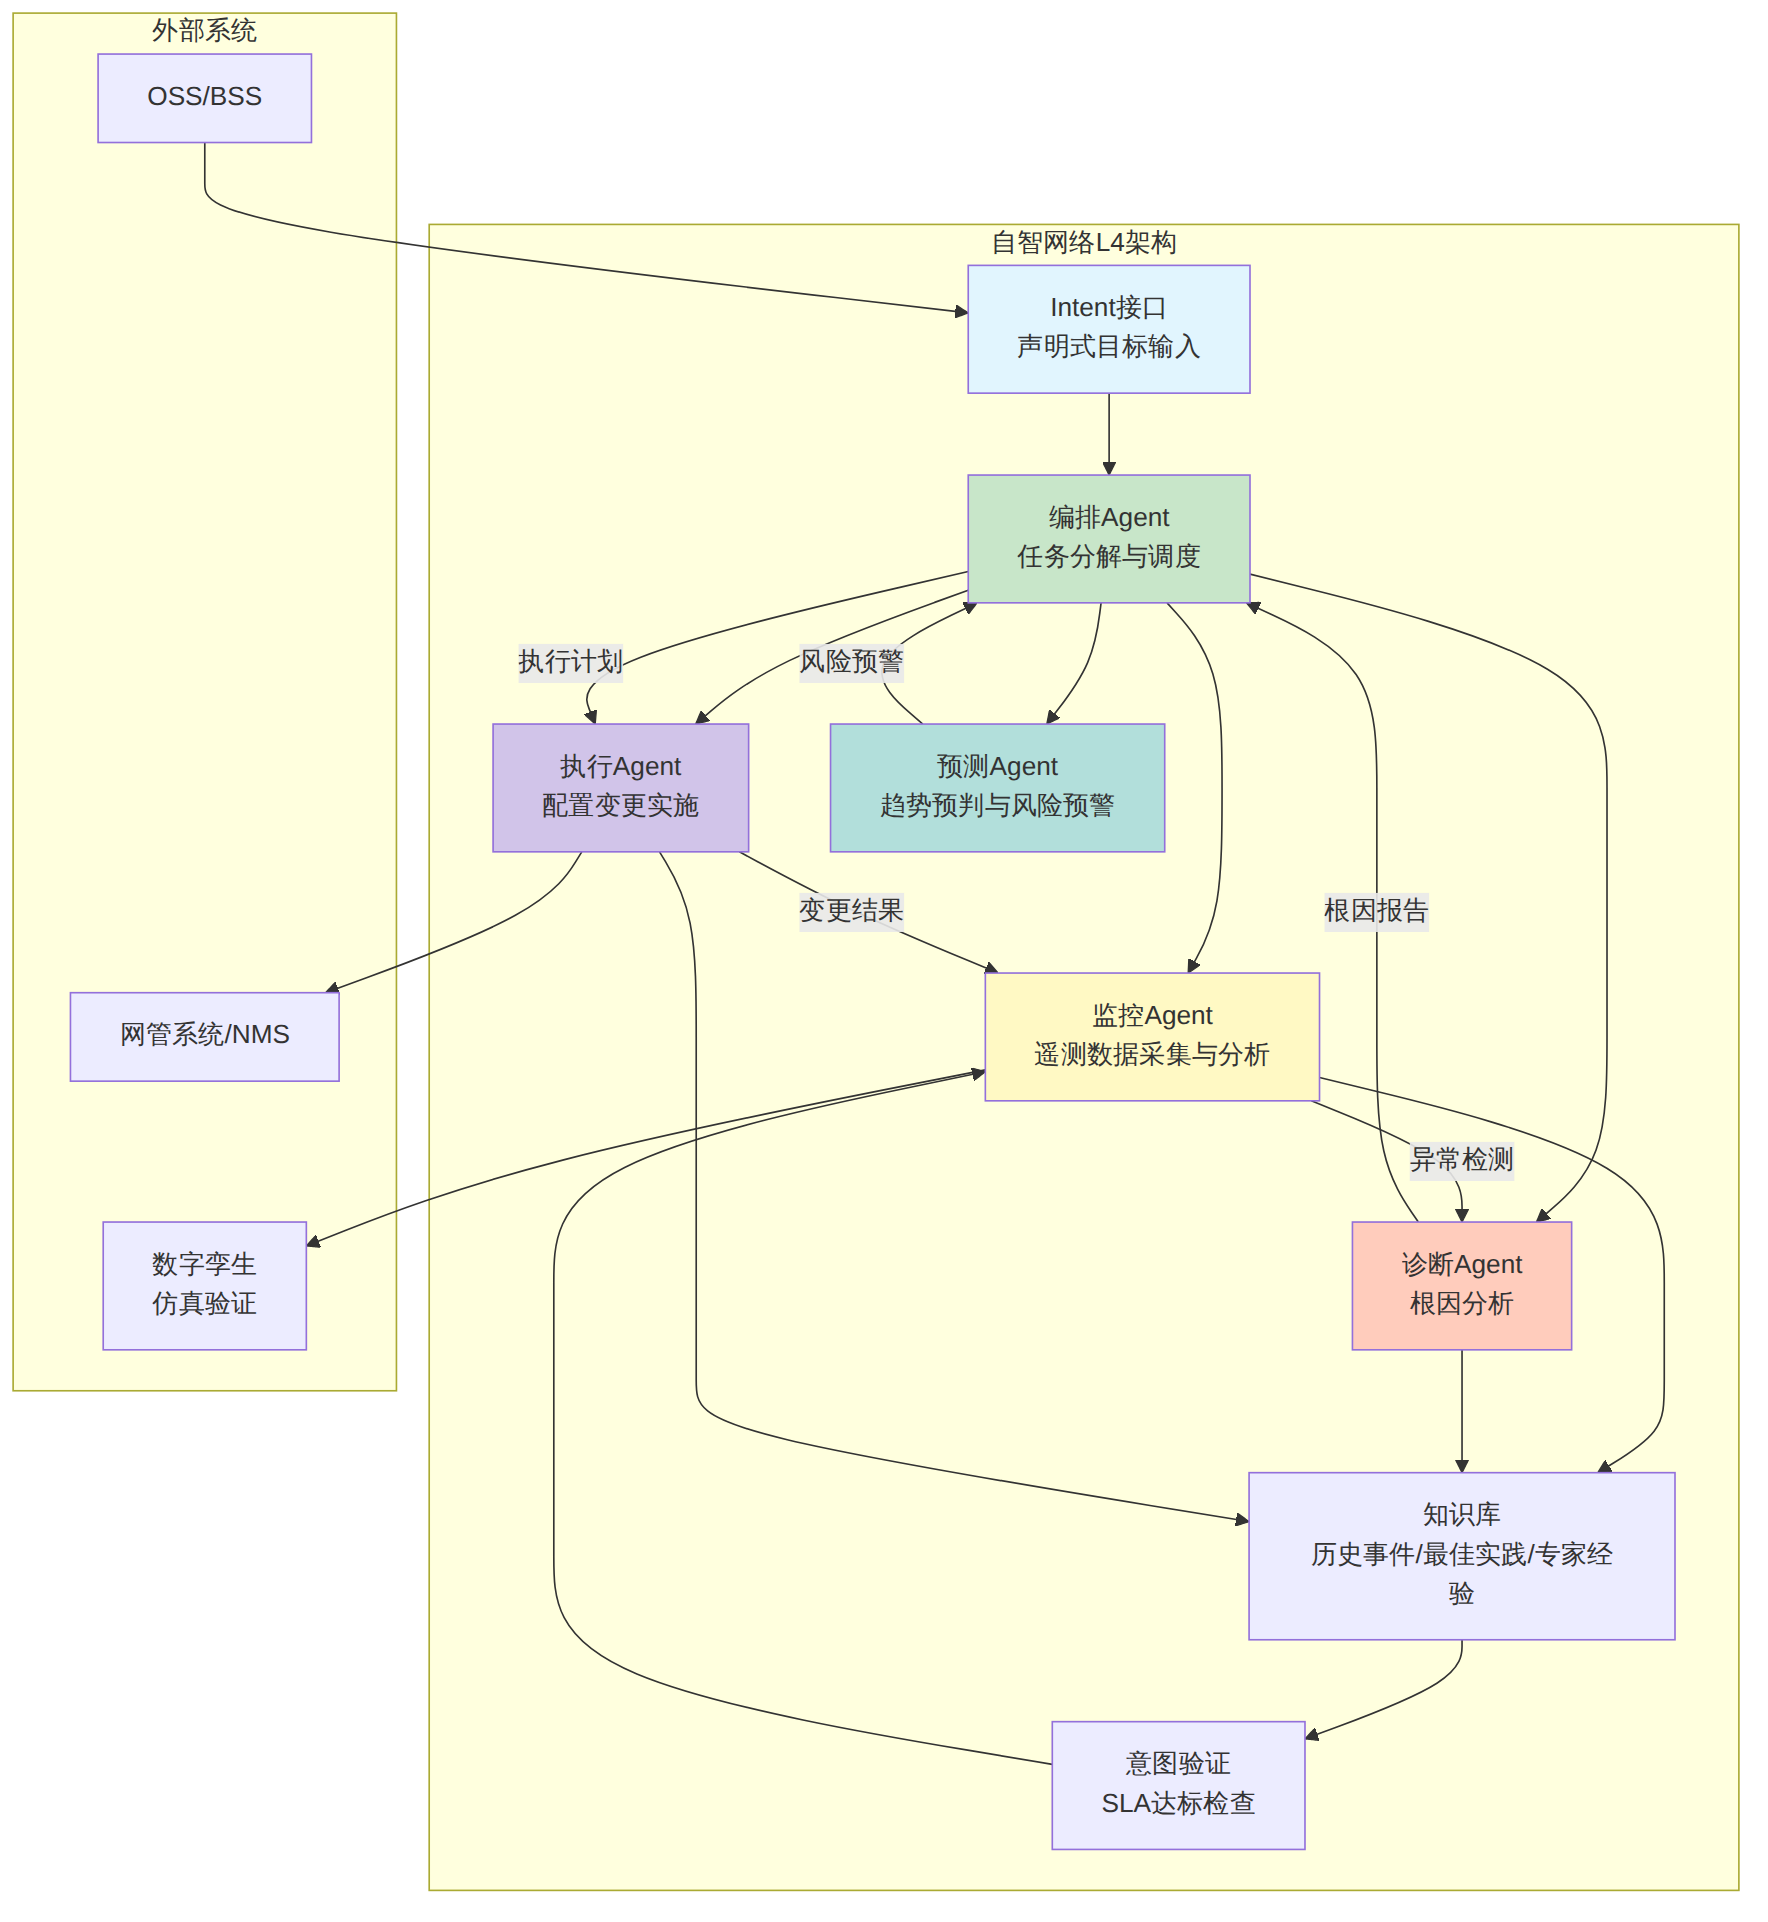
L4自智网络的实现依赖于Agentic AI(代理式AI)架构,由多个专业化AI代理协同工作:
图表 4
每个Agent的核心技术栈:
| Agent | AI技术 | 输入 | 输出 | 关键挑战 |
|---|---|---|---|---|
| 监控Agent | 时序异常检测(Transformer + VAE) | KPI遥测流(秒级粒度) | 异常事件告警 | 误报率控制 |
| 诊断Agent | 知识图谱 + 因果推理 | 拓扑数据、告警关联 | 根因链路 | 多因素耦合 |
| 预测Agent | 多变量时序预测(Informer/PatchTST) | 历史KPI + 外部事件 | 未来趋势 + 置信区间 | 长尾事件预测 |
| 执行Agent | 强化学习(RL) + 安全约束 | 诊断结果 + 意图 | 配置变更指令 | 安全边界保证 |
| 编排Agent | LLM + 任务规划(ReAct/Plan-and-Solve) | 意图文本 + 状态摘要 | 任务分解方案 | 幻觉控制 |
挑战1:安全边界(Safety Bound)
L4允许AI自动执行网络配置变更,但必须确保变更不会导致灾难性后果。解决方案是数字孪生预验证——所有AI生成的变更方案先在数字孪生环境中仿真,验证不影响关键SLA后再下发到物理网络。
ETSI在2025年发布的白皮书"AI in the evolution of Autonomous Networks"中明确指出:L4的核心挑战不是AI能力,而是可解释性和安全边界。
挑战2:跨域协同
端到端业务涉及RAN、传输、核心网三个域,每个域的AI代理需要信息共享和联合决策。TM Forum的IG1338标准定义了跨域Intent的分解和验证框架,但实际部署中不同厂商设备的互操作性仍是瓶颈。
挑战3:从L3到L4的跃迁成本
Google Cloud在MWC 2026发布的调研显示,运营商从L3升级到L4需要: - 数据基础设施升级:引入实时数据湖(如Apache Kafka + ClickHouse),替代传统NMS的分钟级轮询 - AI平台建设:模型训练/推理基础设施(GPU集群 + MLOps平台) - 组织变革:从"运维团队"到"AI运维团队"的技能转型
基于3GPP TR 38.843的评估结果和当前产业实践,以下为AI/ML空接口的推荐部署参数:
| 参数 | 推荐值 | 说明 |
|---|---|---|
| CSI压缩模型输入维度 | $N_r \times N_t$ 实测信道矩阵 | 端到端方案;方案1使用预压缩的空域基向量 |
| 压缩码字长度 | 32-128 bits | 相比Type II码本(512-1024 bits)降低4-8倍 |
| 推理时延预算 | ≤ 0.5ms(UE侧) | 需在PUSCH传输前完成编码 |
| 模型更新周期 | 100-500ms | 根据信道时变特性动态调整 |
| 波束预测窗口 | 5-20 slots | 根据UE移动速度调整 |
| AI/传统模式切换阈值 | 预测准确率 < 85% | 触发回退到传统方案 |
坑1:模型泛化性不足
实验室训练的CSI压缩模型在实际部署中性能急剧下降——不同基站的天线校准误差、不同的传播环境都会导致分布偏移(Distribution Shift)。
应对:采用在线学习+联邦学习的混合策略。gNB收集推理误差统计,在OAM侧聚合训练更新后的模型,通过RRC重配下发。3GPP定义了AI-PerformanceMonitor IE用于监控模型退化。
坑2:UE AI能力碎片化
不同芯片平台的NPU能力差异巨大——高通X75集成Hexagon NPU可运行数十万参数模型,而入门级芯片可能只支持MLP。
应对:3GPP定义了AI能力分级(AI Capability Class),UE通过UECapabilityInformation上报支持的AI功能列表。gNB根据UE能力选择合适的AI方案等级。
坑3:GPU基带的散热与可靠性
GPU在高负载下结温可达85°C以上,影响长期可靠性。基站部署环境(室外机柜)的温度范围远比数据中心恶劣。
应对:降频运行(如从2.5GHz降至1.8GHz)换取散热裕度;利用AI推理的灵活性,在高温时段切换到轻量级模型降低计算负载。
| 维度 | 传统方案 | AI-RAN方案 | 改进幅度 | 标准化状态 |
|---|---|---|---|---|
| CSI反馈开销 | Type II码本:512-1024 bits | AI压缩:64-128 bits | 降低75-85% | Rel-19 WI进行中 |
| 波束扫描开销 | 全SSB扫描:64 beams/20ms | AI预测候选集:4-8 beams | 降低85-95% | Rel-19 WI进行中 |
| 波束切换时延 | 10-20ms(BFR流程) | 1-3ms(预测性切换) | 降低80% | Rel-19 WI进行中 |
| 预编码复杂度 | ZF/MMSE:O(N_t³) | AI非线性映射:O(N_t·d) | 降低1-2个数量级 | 研究阶段 |
| 网络运维 | 人工/规则驱动 | 意图驱动(L4) | OpEx降低40-60% | TM Forum IG1338 |
Q: AI-RAN和O-RAN是什么关系?AI-RAN会替代O-RAN吗?
A: 两者是互补关系,不是替代关系。O-RAN定义了RAN的开放接口架构(O-CU/O-DU/O-RU分离、RIC平台),而AI-RAN是将AI计算原生嵌入到RAN处理链中。实际上,AI-RAN可以建立在O-RAN架构之上——O-RAN的RIC(无线智能控制器)负责Non-RT和Near-RT的AI决策,而AI-RAN的GPU基带负责L1内部的AI推理(如CSI压缩解码)。两者的关系可以类比"操作系统"(O-RAN提供开放平台)和"应用加速器"(AI-RAN提供AI原生计算)。
Q: UE侧运行AI模型会不会大幅增加终端功耗?
A: 这是3GPP标准化中最受关注的问题之一。Rel-19的AI/ML设计原则是"轻量化"——UE侧模型参数量控制在50K-200K,推理计算量约0.5-2 MMAC(百万次乘加),在集成NPU的现代基带芯片上仅增加约5-10%的功耗。作为对比,CSI-RS测量和传统PMI计算本身的功耗远高于AI推理。但终端散热是实际挑战——手机形态的UE中持续运行AI推理的温升需要热管理策略。
Q: 在现网中如何部署AI/ML空接口?需要升级哪些设备?
A: 部署分三个阶段:阶段1(仅gNB升级):gNB升级软件支持AI模型(如AI预编码),UE继续使用传统CSI反馈。这种方式不需要新终端,但AI增益有限。阶段2(UE+gNB联合升级):新终端支持AI CSI压缩/波束预测,需要芯片平台支持NPU和3GPP Rel-19协议。阶段3(AI-RAN硬件升级):替换为GPU基带,实现AI原生物理层。阶段1可在现有vRAN平台上通过软件更新实现,阶段2需要2027年以后的新一代终端芯片,阶段3需要GPU基站硬件换代。
Q: 自智网络L4和L3的核心区别是什么?运营商现在应该做什么准备?
A: L3是"规则驱动的自动化"——预定义的闭环控制(如自动功率调整、自动邻区关系),AI用于优化参数但决策逻辑是人工定义的。L4是"意图驱动的自治"——AI理解高层意图(如"保证这块区域的用户体验"),自主规划并执行具体的网络操作,AI参与决策逻辑本身。运营商现在应该做三件事:(1) 建设实时数据基础设施(秒级KPI采集),这是L4的数据基础;(2) 建立网络数字孪生平台,用于AI决策的安全验证;(3) 在非关键域(如网络节能)试点L4能力,积累经验后再扩展到关键业务。
Q: 3GPP Rel-19的AI/ML规范什么时候冻结?对未来6G有什么影响?
A: Rel-19的AI/ML空接口规范计划在2026年3月达到功能冻结(Stage 3),2027年中完成ASN.1冻结。这是NR空接口首次引入AI/ML的规范性标准,将定义模型管理框架、UE能力上报、信令流程等基础设施。对6G的影响深远——6G的AI原生空接口(ITU IMT-2030框架中的"AI-native air interface")将直接建立在Rel-18/19的标准化成果之上,预计6G的物理层将全面采用AI/ML替代传统信号处理算法。
本文由「51学通信」技术团队出品。51学通信由通信行业18年老兵爱卫生(微信ID: gprshome201101)维护,聚焦5G/6G核心网、3GPP标准解读、通信前沿技术深度分析。 出版作品有《5G核心网原理与实践》《IMS原理与实践》等4本通信专业书籍。知识星球「51学通信」提供深度技术答疑和行业洞察。
[!tip] 51学通信知识星球 星主:爱卫生(微信:gprshome201101)——公众号「51学通信」创办者,19 年通信行业运维与讲师经验,著有《GPRS网络信令实例详解》《EPC原理与实践》《5G核心网原理与实践》三本纸质书(各大电商平台有售)。 星球定位:深耕 5G 核心网、IMS、NFV/AI、云原生等 ICT 领域,主打运维岗位与信令分析。 当前规模:5200 篇主题 / 990 个回答,198 元/年。 加入福利:加入星球后请加爱卫生微信,拉您进知识星球年度陪伴与答疑群——不限量回复您的各种问题,另有群内分享。 AI 加持:51学通信知识星球已作为 skill 接入 WorkBuddy,使用 deepseek-4-flash 在海量星球帖子中精准找贴、找视频、找 FAQ 和案例,做总结、找文档和 PPT 等场景全覆盖。
