3GPP在Release 18中首次将AI/ML引入NR空口标准化流程,标志着移动通信从"AI辅助优化"迈入"AI原生设计"时代。Release 19在此基础上进一步深化,TR 38.843(Study on AI/ML for NR Air Interface, Rel-19)将研究范围扩展至CSI反馈增强、波束管理、定位三大核心用例,同时定义了完整的AI/ML模型生命周期管理(LCM)框架。
本文将从物理层原理出发,深度解读AI/ML如何在NR空口中替代传统信号处理算法,分析AI-RAN的架构演进路径,并探讨基于O-RAN RIC和TM Forum AN框架的自智网络L4/L5实现路径。
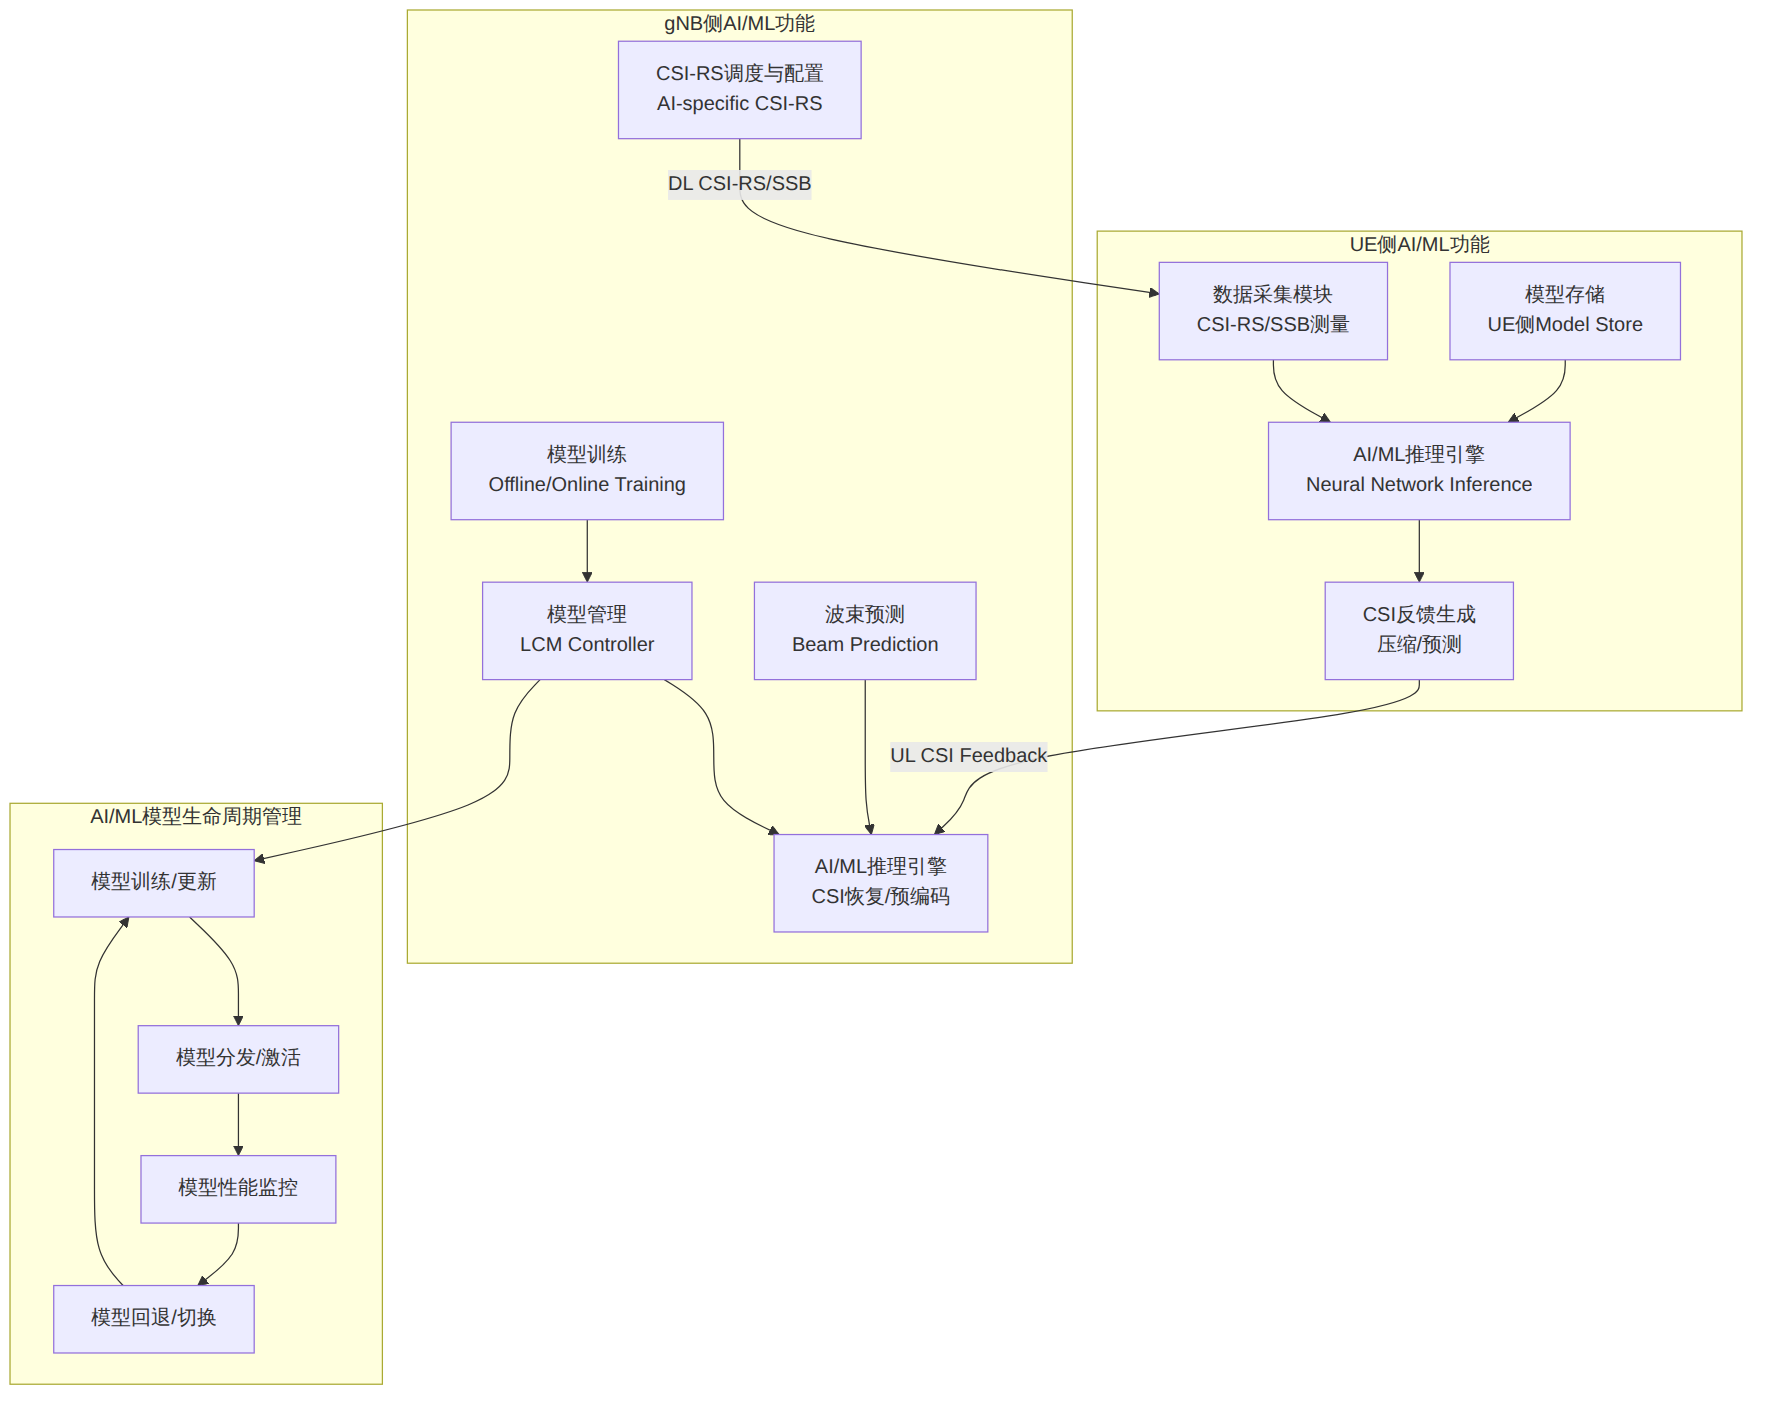
3GPP在TR 38.843中定义了AI/ML功能框架,其核心逻辑如下图所示:
图表 1
3GPP定义了三种AI/ML模型部署方式,这是理解整个框架的关键:
| 部署模式 | 描述 | 典型用例 | 延迟要求 |
|---|---|---|---|
| Side-link模式 | 模型同时在UE和gNB部署,两端协同推理 | CSI压缩反馈(UE编码,gNB解码) | URLLC级,<1ms |
| UE-only模式 | 模型仅在UE侧部署 | CSI预测、波束预测 | 取决于UE处理能力 |
| gNB-only模式 | 模型仅在gNB侧部署 | 负载均衡、节能调度 | 非实时,秒级~分钟级 |
Side-link模式是3GPP标准化的重点和难点。以CSI压缩为例,UE侧用编码器网络将高维CSI矩阵压缩为低维码本索引,gNB侧用解码器网络恢复原始CSI。这种"自编码器"架构要求UE和gNB必须使用配对的模型,引入了模型版本同步的复杂问题。
在Massive MIMO系统中,基站需要精确的CSI来计算预编码矩阵。传统方案基于码本量化:
$$\text{PMI} = \arg\max_{\mathbf{w} \in \mathcal{C}} |\mathbf{H}\mathbf{w}|^2$$
其中 $\mathcal{C}$ 是预定义码本集合,$\mathbf{H}$ 是信道矩阵,$\mathbf{w}$ 是码本向量。
传统方案的固有缺陷: - 码本有限导致量化误差,尤其在高维MIMO(如64T64R)时性能恶化 - Type II码本虽然精度高,但开销巨大(数百比特/CSI报告) - 时变信道中,CSI报告存在固有时延,导致"信道老化"效应
3GPP TR 38.843定义的AI/ML CSI压缩方案本质上是一个自编码器(Autoencoder)架构:
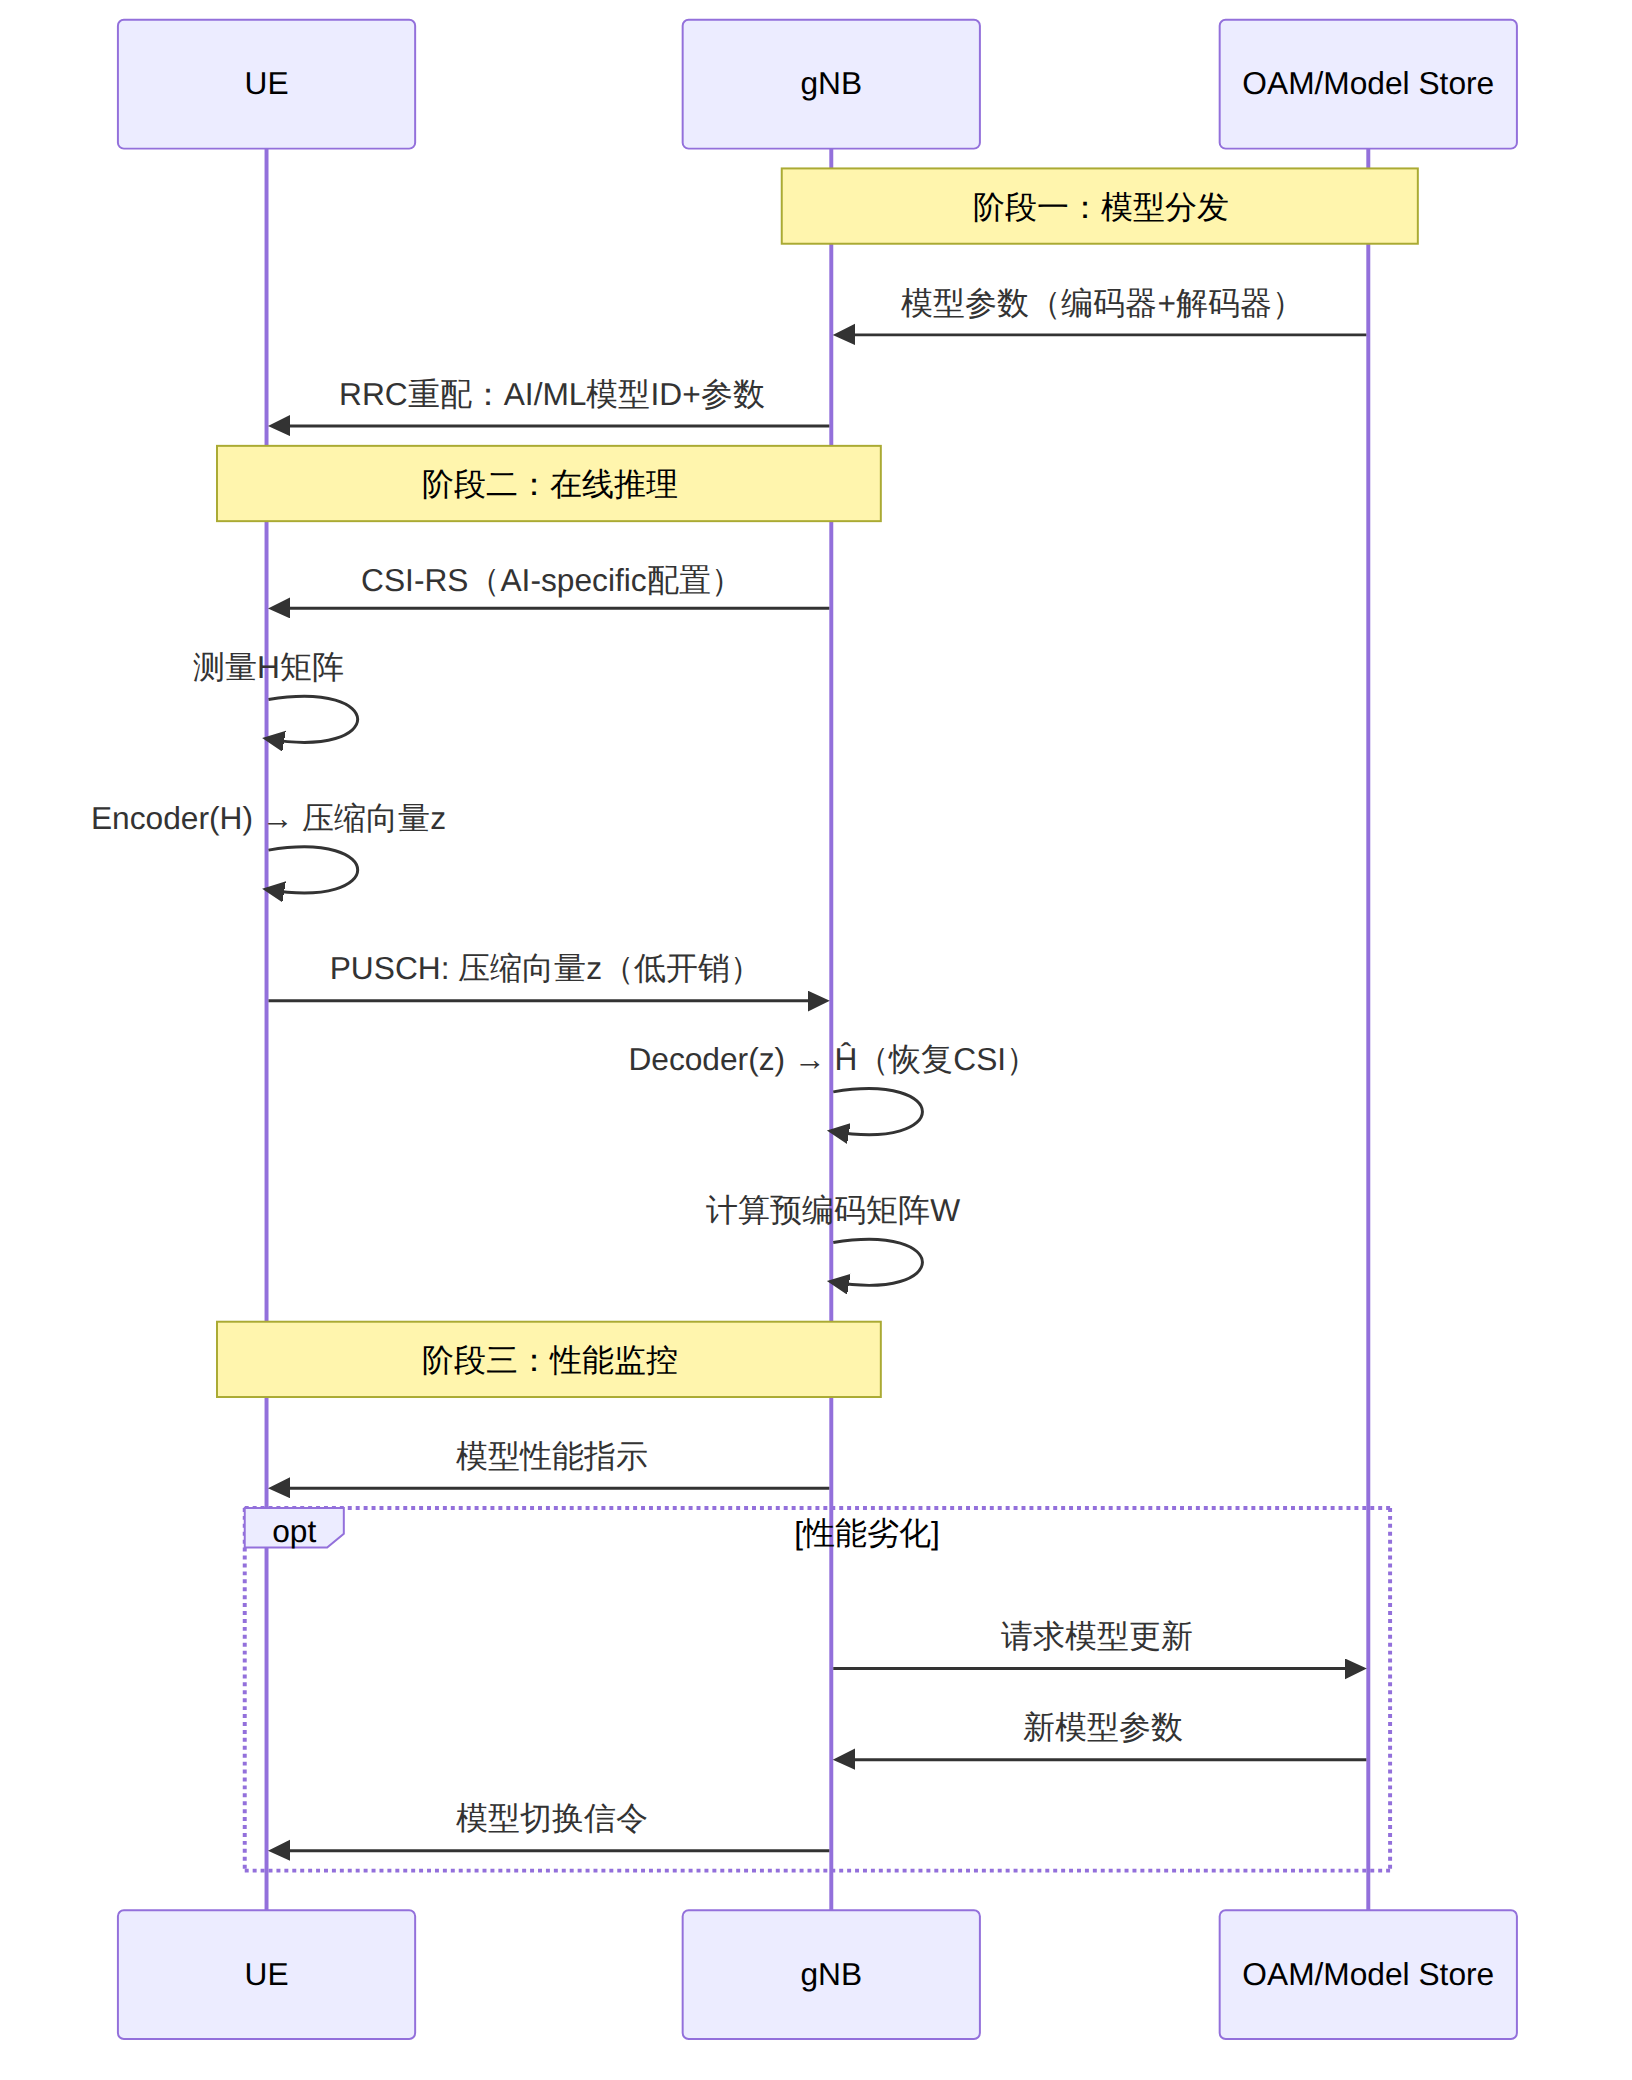
图表 2
编码器侧(UE) 的核心操作:
$$\mathbf{z} = f_{\theta_{\text{enc}}}(\mathbf{H}_{\text{meas}}), \quad \mathbf{z} \in \mathbb{R}^{d}, \quad d \ll N_r \times N_t$$
解码器侧(gNB) 的恢复操作:
$$\hat{\mathbf{H}} = g_{\theta_{\text{dec}}}(\mathbf{z})$$
目标函数(训练损失):
$$\mathcal{L} = \mathbb{E}\left[|\mathbf{H} - \hat{\mathbf{H}}|_F^2\right] + \lambda \cdot R(\mathbf{z})$$
其中 $R(\mathbf{z})$ 是正则化项,控制压缩向量的信息熵。
根据3GPP RAN1评估结果(TR 38.843 Clause 6),AI/ML CSI压缩相对传统Type II码本的性能提升:
| 指标 | 传统Type II码本 | AI/ML CSI压缩 | 提升幅度 |
|---|---|---|---|
| CSI反馈开销 | 100-512 bits | 20-64 bits | 降低70-85% |
| 信道恢复NMSE | -10 ~ -15 dB | -18 ~ -25 dB | 提升8-10 dB |
| 吞吐量(MU-MIMO) | 基准 | +15% ~ +30% | 显著提升 |
| 适应性(高速场景) | 信道老化严重 | 可预测补偿 | 质变 |
| UE计算复杂度 | 低(查表) | 中(NN推理) | 增加 |
核心洞察: AI/ML CSI压缩的本质优势在于它摆脱了码本的"离散化"约束,直接在连续空间中学习信道的低维流形表示。对于FDD系统(上下行信道不对等)和高速移动场景(信道快变),这种优势尤为突出。
Release 19新增的CSI预测能力是AI/ML的又一亮点。传统方案中,CSI报告从测量到应用存在 $T_{\text{delay}}$ 的固有时延:
$$\mathbf{H}[n+T_{\text{delay}}] \neq \mathbf{H}[n]$$
AI/ML通过时间序列预测模型(如LSTM、Transformer),利用历史CSI序列预测未来信道状态:
$$\hat{\mathbf{H}}[n+T_{\text{delay}}] = \text{Predictor}(\mathbf{H}[n-k:n])$$
3GPP评估显示,在120 km/h移动速度下,AI/ML CSI预测可将MU-MIMO吞吐量提升20-40%,这相当于免费获得了一个额外的MIMO层。
5G NR的波束管理流程(TS 38.300 Section 9.2)包含P-1/P-2/P-3三个阶段:
传统方案的根本问题在于:波束搜索是穷举式的,时间复杂度 $O(N_{\text{beam}})$ 随天线数线性增长。 在256天线面板下,CSI-RS开销可能占据下行资源的15-20%。
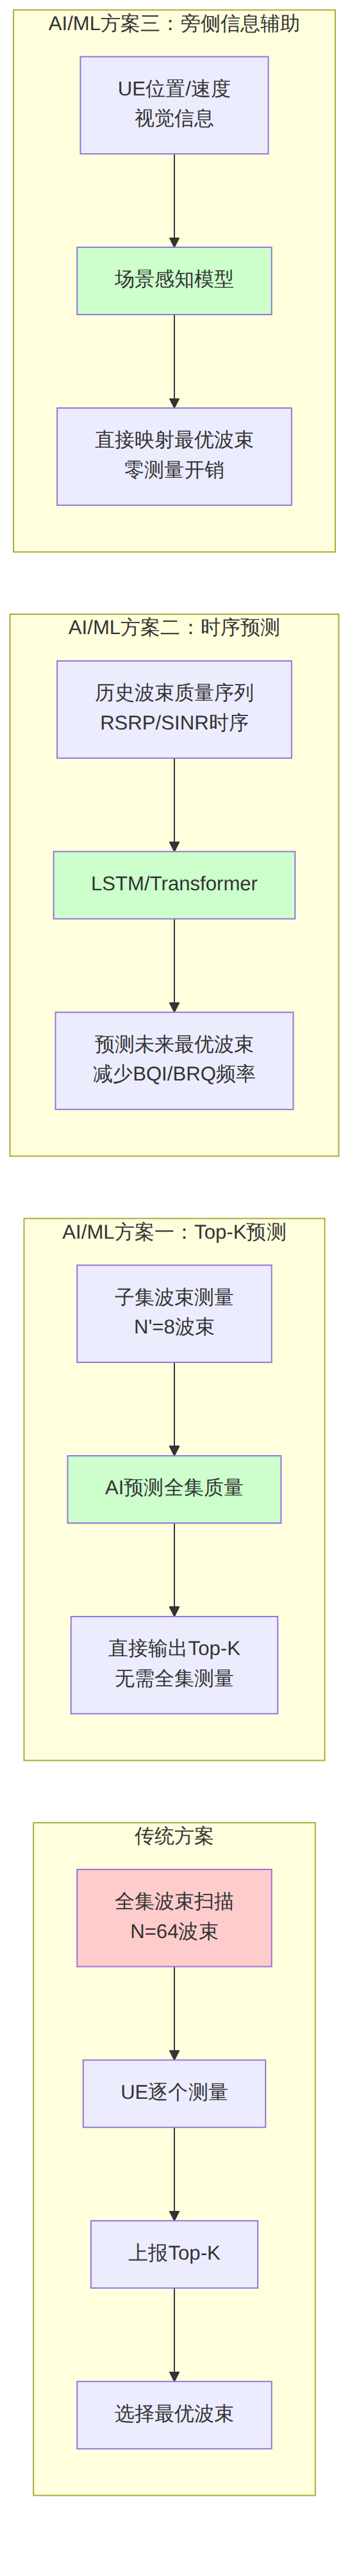
图表 3
策略一:Top-K波束预测(3GPP重点评估) - 仅测量 $N'$ 个代表性波束($N' \ll N$) - AI模型从子集测量结果推断全集波束质量 - 3GPP评估结果:仅测量16个波束即可预测64波束中Top-4的准确率 > 90% - CSI-RS开销降低约 75%
策略二:时序波束预测 - 输入:过去 $K$ 个时隙的波束RSRP序列 - 输出:未来 $T$ 个时隙的最优波束索引 - 典型架构:1D-CNN + Attention或轻量级LSTM - 应用场景:高铁、车载等高移动性场景,减少L1-RSRP上报频率
策略三:旁侧信息辅助 - 利用UE的GPS坐标、IMU数据、甚至摄像头信息 - 构建从环境特征到最优波束的直接映射 - 需要额外的UE能力上报(UECapabilityInformation中的AI/ML能力信元)
Release 19为AI/ML波束管理新增了关键RRC信元:
// AI/ML Beam Management配置(简化)
BeamManagementAIML-Config ::= SEQUENCE {
    aiml-ModelID                  INTEGER (0..65535),
    beamPredictionType            ENUMERATED {top-K, temporal, sideInfo},
    subsetBeamSet                 SEQUENCE OF INTEGER (0..63),
    predictionWindow              INTEGER (1..32),    -- 时隙数
    modelPerformanceThreshold     INTEGER (0..100),   -- 百分比
    fallbackBeamSet               SEQUENCE OF INTEGER (0..63)
}
fallbackBeamSet 是安全机制的关键:当AI模型性能劣化(如UE进入未训练过的传播环境),系统自动回退到传统波束扫描模式,确保不因AI模型失效导致服务中断。
O-RAN架构通过RIC(RAN Intelligent Controller)实现了AI/ML的标准化部署平台:
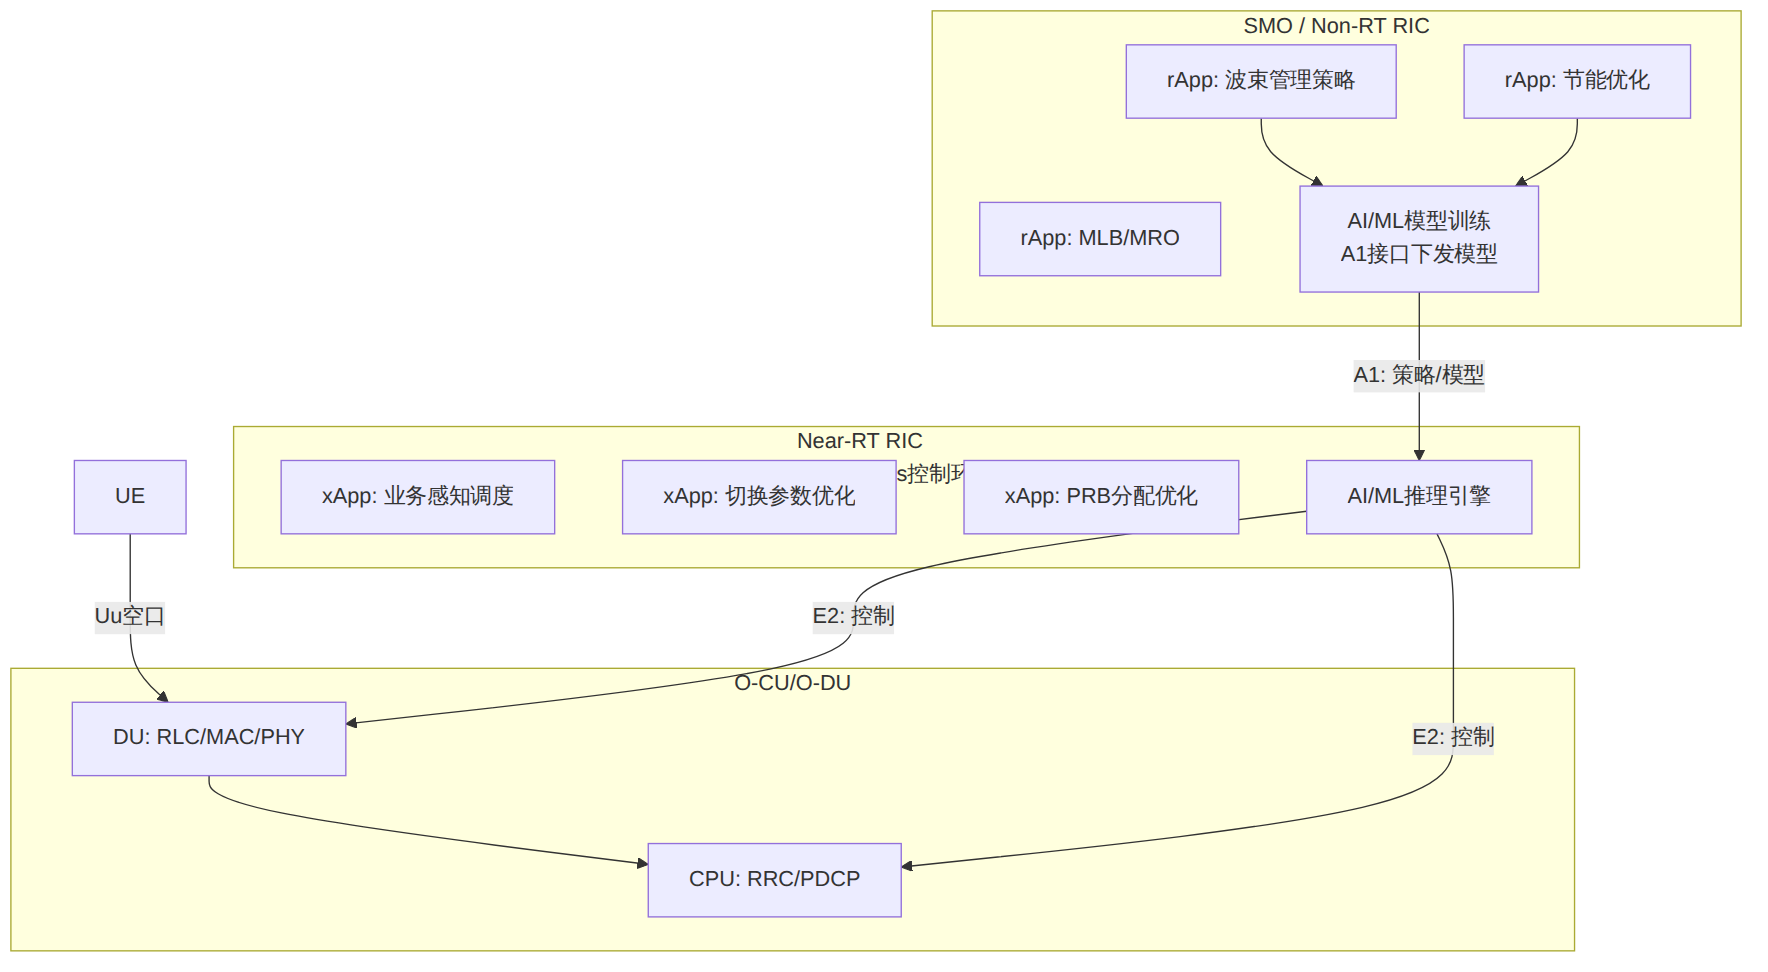
图表 4
| 组件 | 时延范围 | 部署形态 | AI/ML能力 |
|---|---|---|---|
| Non-RT RIC | >1s | 云端 | 模型训练、策略生成、大数据分析 |
| Near-RT RIC | 10ms-1s | 边缘云 | 实时推理、参数微调 |
| O-DU/L1 | <1ms | 基站本地 | ASIC/FPGA加速的PHY层AI |
NVIDIA提出的AI-RAN架构(基于Aerial CUDA-Accelerated RAN)代表了一种更激进的路径:用GPU同时承载传统L1信号处理和AI推理。
其核心架构分为三层:
| 层次 | 功能 | 技术实现 |
|---|---|---|
| cuBB(CUDA Baseband) | 5G NR L1物理层处理 | GPU CUDA核加速FFT、LDPC解码 |
| AI推理层 | CSI压缩/恢复、波束预测 | Tensor Core加速NN推理 |
| AI-on-RAN层 | 边缘AI应用(计算机视觉等) | 共享GPU资源,多租户隔离 |
关键创新点: 传统vRAN使用专用FPGA/ASIC处理L1,NVIDIA方案将L1全部软件化到GPU上。这样做的代价是功耗和成本,但好处是: 1. L1信号处理和AI推理在同一GPU上,消除了数据搬移开销 2. 可通过软件更新快速部署新AI算法,无需更换硬件 3. SoftBank的PoC验证了16层MU-MIMO(16-UE配对)在GPU上的可行性
| 维度 | O-RAN路线 | NVIDIA AI-RAN路线 |
|---|---|---|
| 架构理念 | 在现有RAN上叠加AI控制层 | 用GPU重构整个L1 |
| 标准化程度 | 高(O-RAN联盟标准) | 中(产业联盟推动) |
| 实时性 | Near-RT RIC为10ms级 | GPU L1可达μs级 |
| 部署成本 | 渐进式,可叠加 | 需要GPU服务器,初期高 |
| AI深度 | RRM/调度层面优化 | PHY层原生AI |
| 产业链 | 多厂商开放生态 | NVIDIA主导 |
TM Forum定义的自智网络等级已从理论框架走向产业认证。2025年6月,TDC NET与Ericsson获得了全球首个L4级自智网络认证:
| 等级 | 名称 | 特征 | 人机关系 |
|---|---|---|---|
| L0 | 手动运维 | 全人工操作 | 人做一切 |
| L1 | 辅助运维 | 工具辅助,人决策 | 人为主 |
| L2 | 部分自治 | 特定场景自动化 | 人监督 |
| L3 | 条件自治 | 单域自治,跨域人工 | 系统为主,人审批 |
| L4 | 高度自治 | 跨域意图驱动,异常人工干预 | 系统自治,人极少干预 |
| L5 | 完全自治 | 端到端零接触,自进化 | 人设目标,系统自治 |
L4的关键跃升在于从"规则驱动"到"意图驱动"。运营商不再定义具体的KPI阈值和动作策略,而是声明高层意图:
// 意图声明示例(TM Forum IETF Intent概念)
Intent: "保障CBD区域在9:00-18:00的5G上行速率≥100Mbps,
         同时将能耗控制在基准值的80%以下"

系统自动分解为:
├── 覆盖意图 → 调整下倾角/波束权重(O-RAN rApp)
├── 容量意图 → 载波聚合/小区分裂策略(Near-RT RIC xApp)
├── 节能意图 → 符号关断/载波关断策略(Non-RT RIC rApp)
└── 协调策略 → 多目标优化(强化学习)
意图驱动的技术栈:
以小区故障自愈为例,说明L4级自智网络的完整闭环:
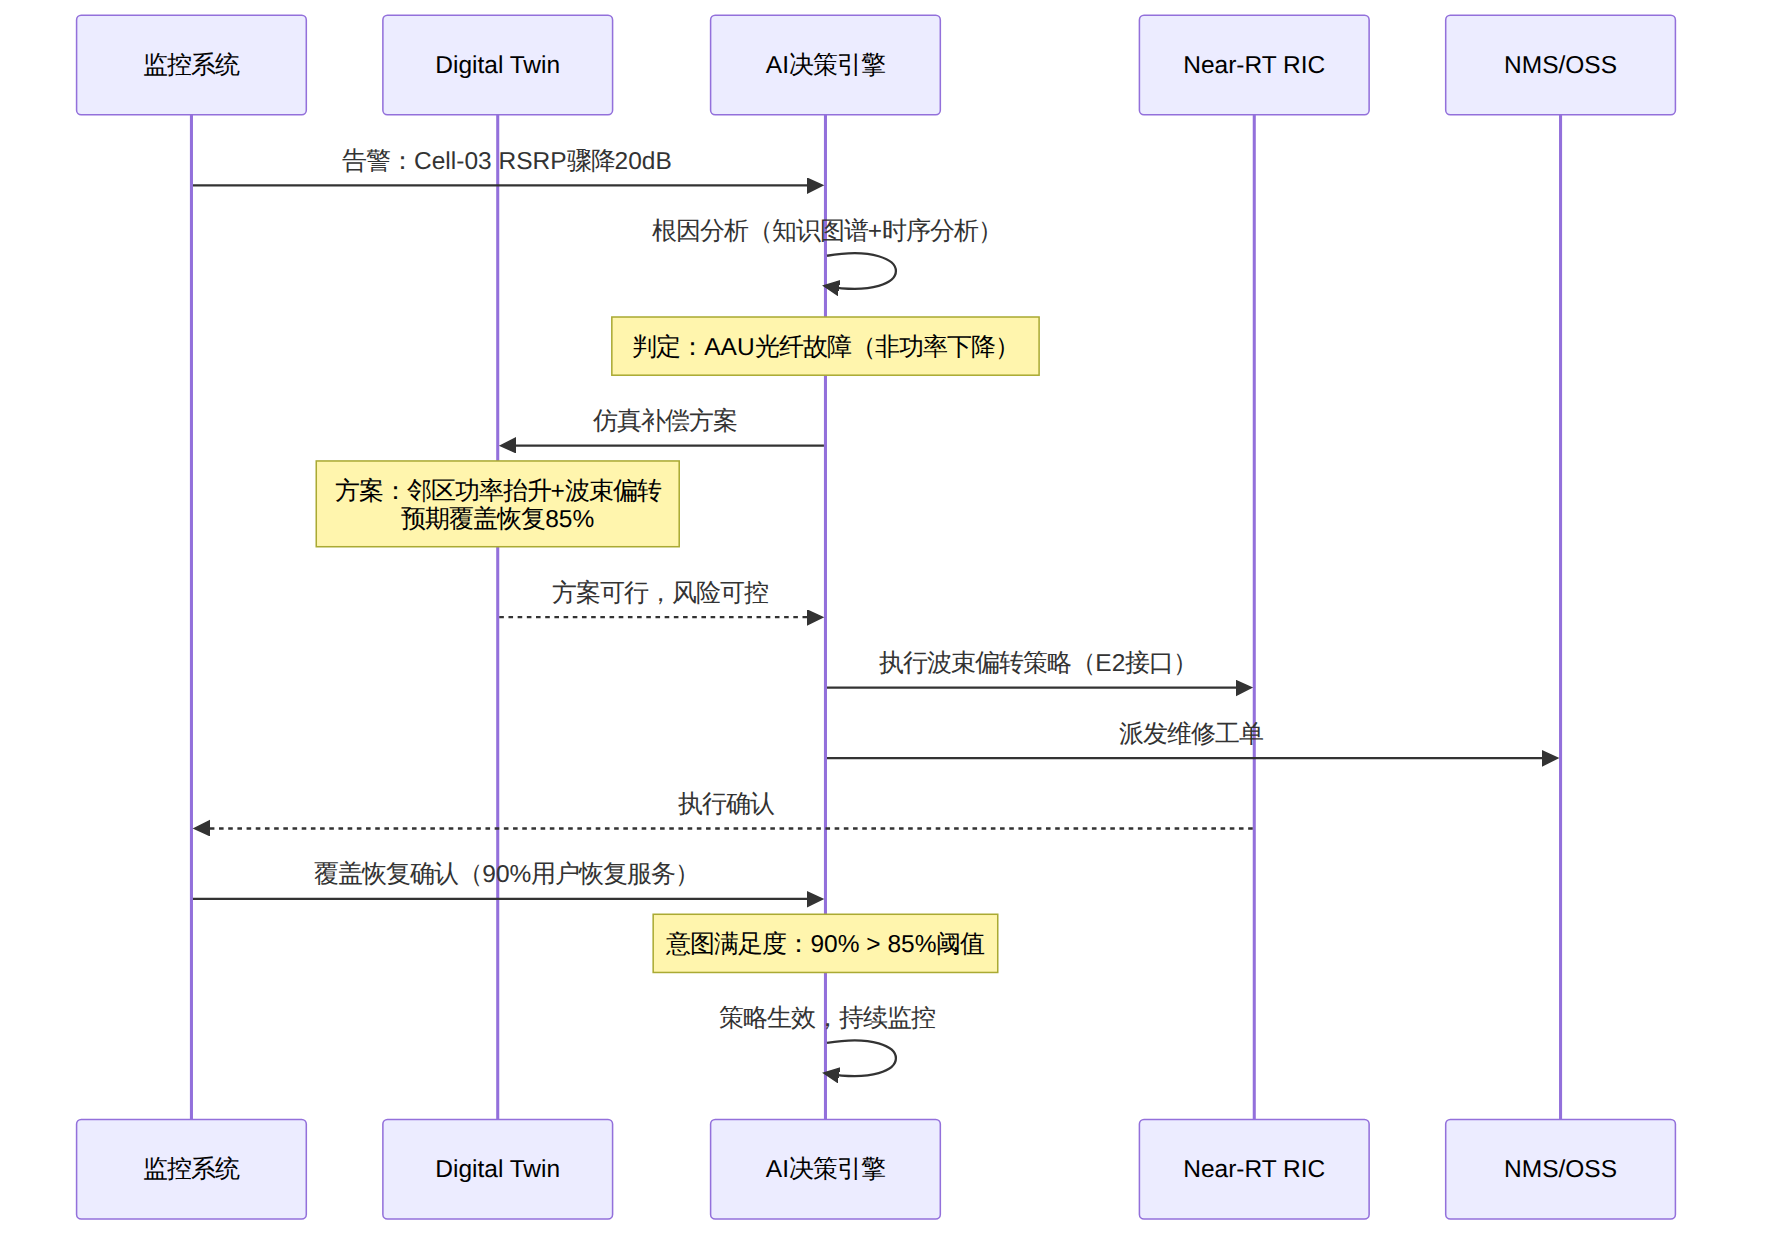
图表 5
关键数据流: 从故障检测到补偿策略执行,L4的目标是在 30秒内 完成闭环(L3通常需要5-15分钟的人工确认环节)。
L5"完全自治"在当前技术条件下仍面临根本性挑战:
| 挑战 | 具体描述 | 当前状态 |
|---|---|---|
| AI可解释性 | 网络运维需要可审计的决策逻辑,黑箱模型难以被运营商接受 | 研究阶段 |
| 跨域编排 | RAN/CN/Transport/IT的联合优化需要跨域数据共享和统一编排 | 标准化中 |
| 安全边界 | AI决策的错误边界难以界定,可能导致大面积服务中断 | 产业讨论中 |
| 模型泛化 | 训练环境与现网环境的gap(Sim-to-Real) | 持续改进 |
| 监管合规 | 电信法规要求关键决策可追溯、可审计 | 政策未跟上 |
TR 38.843定义的AI/ML模型生命周期包含五个阶段:
模型性能监控的核心信元:
AIML-PerformanceMetrics ::= SEQUENCE {
    nmse-threshold          FLOAT (0.001..1.0),
    throughput-degradation  INTEGER (0..100),  -- 百分比
    prediction-accuracy     INTEGER (0..100),  -- 百分比
    monitoring-window       INTEGER (10..1000), -- 毫秒
    fallback-trigger-count  INTEGER (1..10)
}
当连续 $N$ 次推理的性能低于阈值时,gNB触发fallback至传统方案,同时请求模型更新。
3GPP在UECapabilityInformation中新增了AI/ML能力上报:
UE-AIML-Capability ::= SEQUENCE {
    supportedAIML-Functions   BIT STRING {
        csiCompression (0),
        csiPrediction (1),
        beamPrediction (2),
        positioning (3)
    },
    maxModelSize             INTEGER,     -- 最大可存储模型参数量
    supportedNN-Architecture  ENUMERATED {fullyConnected, cnn, transformer},
    maxInferenceLatency      INTEGER,     -- 微秒
    onDeviceTraining         BOOLEAN      -- 是否支持UE侧训练
}
实战要点: 不同UE的AI能力差异巨大。旗舰SoC可能支持Transformer架构的CSI压缩,而低端RedCap终端可能仅支持小型全连接网络。gNB必须根据UE能力选择合适的模型,这增加了调度器的复杂度。
| 参数 | 推荐配置 | 说明 |
|---|---|---|
| CSI压缩比 | 8:1~16:1 | 过高压缩比导致恢复精度劣化 |
| 波束预测子集 | 总数的25% | 在开销和精度间取得平衡 |
| 模型更新周期 | 7-14天 | 取决于信道环境变化速度 |
| 性能监控窗口 | 100ms | 短窗口快速检测劣化 |
| Fallback阈值 | NMSE > -12dB | 根据业务QoS要求调整 |
模型版本碎片化: 现网中存在不同芯片平台的UE(Qualcomm/MediaTek/海思),它们的AI推理引擎兼容性不同。建议在模型分发阶段就区分UE平台类型。
训练数据偏差: DT/TDD模式下采集的训练数据可能与实际FDD UE的信道特征不匹配。需要定期用真实UE数据在线微调。
GPU功耗: AI-RAN的GPU TDP可达300-700W/O-RU,密集城区部署时需评估机房供电和散热能力。
Fallback时延: 从AI方案回退到传统方案需要1-2个CSI报告周期(约10-20ms),期间吞吐量可能短暂下降。建议采用"软切换"策略:传统方案和AI方案并行运行,仅在AI结果验证可靠后才切换。
Q: AI/ML CSI压缩和传统Type II码本的本质区别是什么?
A: Type II码本是预定义的离散码本集合,量化精度受码本大小限制。AI/ML压缩是数据驱动的连续空间映射,通过学习信道的低维流形结构实现更高效的表示。本质上,传统码本是"先验设计",AI/ML是"数据驱动",后者在复杂信道环境下(如UMa/NLOS)优势更大。
Q: 现网中如何升级支持AI/ML空口功能?
A: 分三步走:(1) gNB软件升级支持AI/ML框架和模型管理;(2) OTA向支持AI/ML的UE推送模型参数;(3) 先在低负载小区验证,再逐步推广。UE侧无需硬件更换,只需要基带SoC支持NN推理(2024年后的旗舰芯片基本支持)。
Q: AI-RAN的GPU方案功耗太高,是否适合广域覆盖场景?
A: GPU方案目前更适合高容量热点场景(体育场、CBD)。广域覆盖场景建议采用传统ASIC/FPGA方案+Near-RT RIC的混合模式。NVIDIA也在推出低功耗GPU(如基于Blackwell架构的电信专用卡),功耗在持续优化。
Q: L4自智网络需要怎样的数据基础设施?
A: 核心要求三点:(1) 实时数据湖——支持亚秒级数据采集(telemetry流式上报);(2) 知识图谱——构建网络拓扑、告警关联、历史处置经验的语义网络;(3) Digital Twin——1:1网络仿真环境,用于策略预验证。数据质量比AI算法更重要。
Q: AI/ML模型的公平性如何保障?不同UE是否会被差别对待?
A: 3GPP在模型性能评估中要求对不同信道条件下的UE进行均衡测试。运营商在部署时应设置最低性能基线,确保所有UE(包括不支持AI/ML的旧终端)的基本服务不受影响。不支持AI/ML的UE继续使用传统码本方案。
本文由「51学通信」技术团队出品。51学通信由通信行业18年老兵爱卫生(微信ID: gprshome201101)维护,聚焦5G/6G核心网、3GPP标准解读、通信前沿技术深度分析。 出版作品有《5G核心网原理与实践》《IMS原理与实践》等4本通信专业书籍。知识星球「51学通信」提供深度技术答疑和行业洞察。
[!tip] 51学通信知识星球 星主:爱卫生(微信:gprshome201101)——公众号「51学通信」创办者,19 年通信行业运维与讲师经验,著有《GPRS网络信令实例详解》《EPC原理与实践》《5G核心网原理与实践》三本纸质书(各大电商平台有售)。 星球定位:深耕 5G 核心网、IMS、NFV/AI、云原生等 ICT 领域,主打运维岗位与信令分析。 当前规模:5200 篇主题 / 990 个回答,198 元/年。 加入福利:加入星球后请加爱卫生微信,拉您进知识星球年度陪伴与答疑群——不限量回复您的各种问题,另有群内分享。 AI 加持:51学通信知识星球已作为 skill 接入 WorkBuddy,使用 deepseek-4-flash 在海量星球帖子中精准找贴、找视频、找 FAQ 和案例,做总结、找文档和 PPT 等场景全覆盖。
