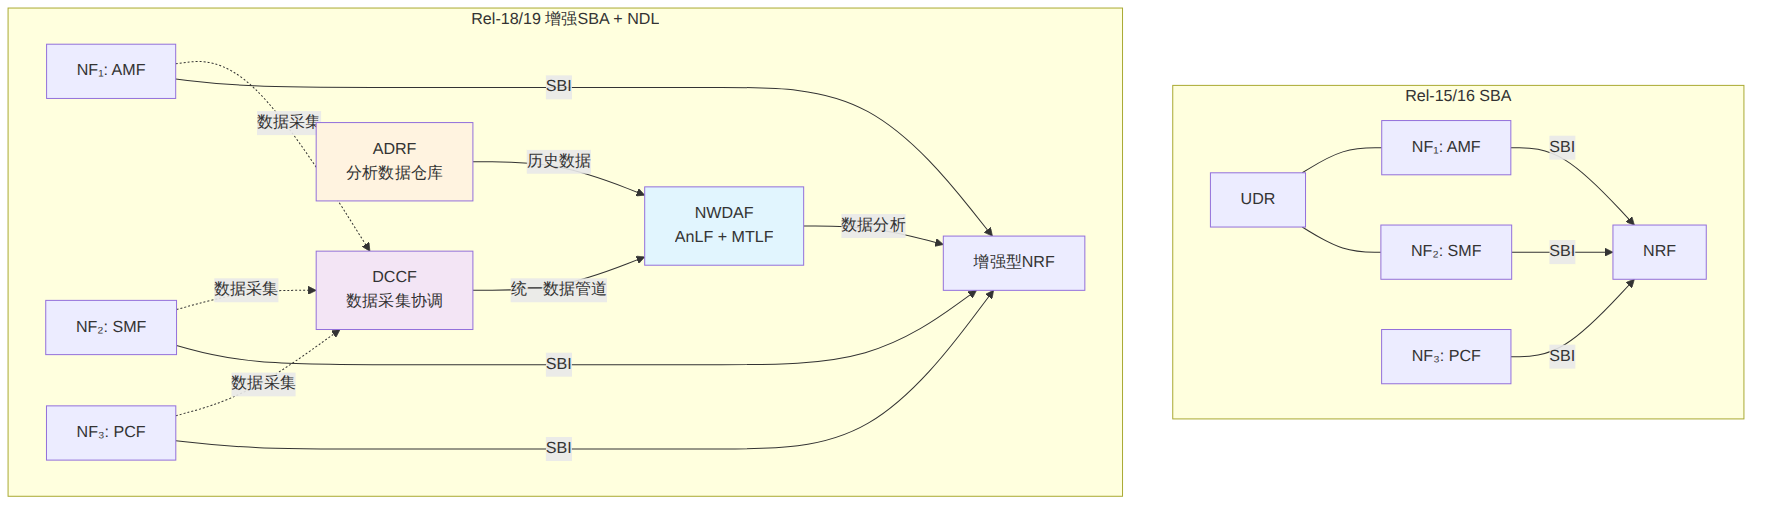
3GPP Release 18(5G-Advanced Phase 1)与 Release 19(5G-Advanced Phase 2)对5G核心网(5GC)进行了体系级的重构。演进的三大驱动力包括:
本文将围绕 SBA架构增强、网络数据层(NDL) 和 能量感知核心网 三大主题展开深度分析,涵盖3GPP TS 23.288、TS 23.501/23.502、TS 29.520/29.519、TS 28.310等核心规范的技术细节。
Rel-15定义的SBA以NF(Network Function)为基本单元,通过SBI(Service-Based Interface)使用HTTP/2 RESTful API实现NF间通信。其核心组成包括:
然而,Rel-15/16 SBA存在明显局限:
| 维度 | Rel-15/16 现状 | 局限性分析 |
|---|---|---|
| 数据采集 | 各NF直接从UDR/OAM获取 | 无统一数据协调机制,重复采集严重 |
| 分析能力 | 依赖OAM/MDT | 缺乏实时分析框架,延迟高 |
| 服务发现 | NRF基于NF Type | 无法基于能力/负载进行精细化发现 |
| 接口协议 | HTTP/2 + JSON | 大数据量场景下序列化开销大 |
Rel-18对SBA进行了关键增强(参见TS 23.501 V18.x):
(1)增强型NRF服务发现
引入NF Profile中的能力标签(Capability Label)和负载信息,NRF支持基于能力的精细化服务发现:
// NF Profile扩展(TS 23.501 Clause 6.2.6)
NFProfile {
    nfType: AMF
    nfInstanceId: "550e8400-e29b-41d4-a716-446655440000"
    capabilityList: ["N2-interface", "non3gpp-access", "mmTel"]
    loadLevelAverage: 65       // 负载百分比
    capacity: 100              // 相对容量指标
    allowedNfType: [SMF, SMSF]
    customAttribute: {...}      // Rel-18新增扩展字段
}
(2)SBI协议优化
针对大数据量传输场景,Rel-18引入了对HTTP/3(QUIC)的初步支持研究(FS_5GS_HTTP3),并在TS 29.500中定义了更高效的序列化机制:
$$ \text{Serialization Overhead Reduction} = 1 - \frac{\text{Payload}{\text{Compact}}}{\text{Payload} \approx 40\% \sim 60\% $$}}
(3)服务化数据架构(SDA)概念
Rel-19引入了"数据即服务"(Data-as-a-Service)的概念,将数据层从各NF中抽象出来,形成统一的网络数据层(NDL)。这标志着SBA从"服务化接口"向"服务化数据"的演进。
图表 1
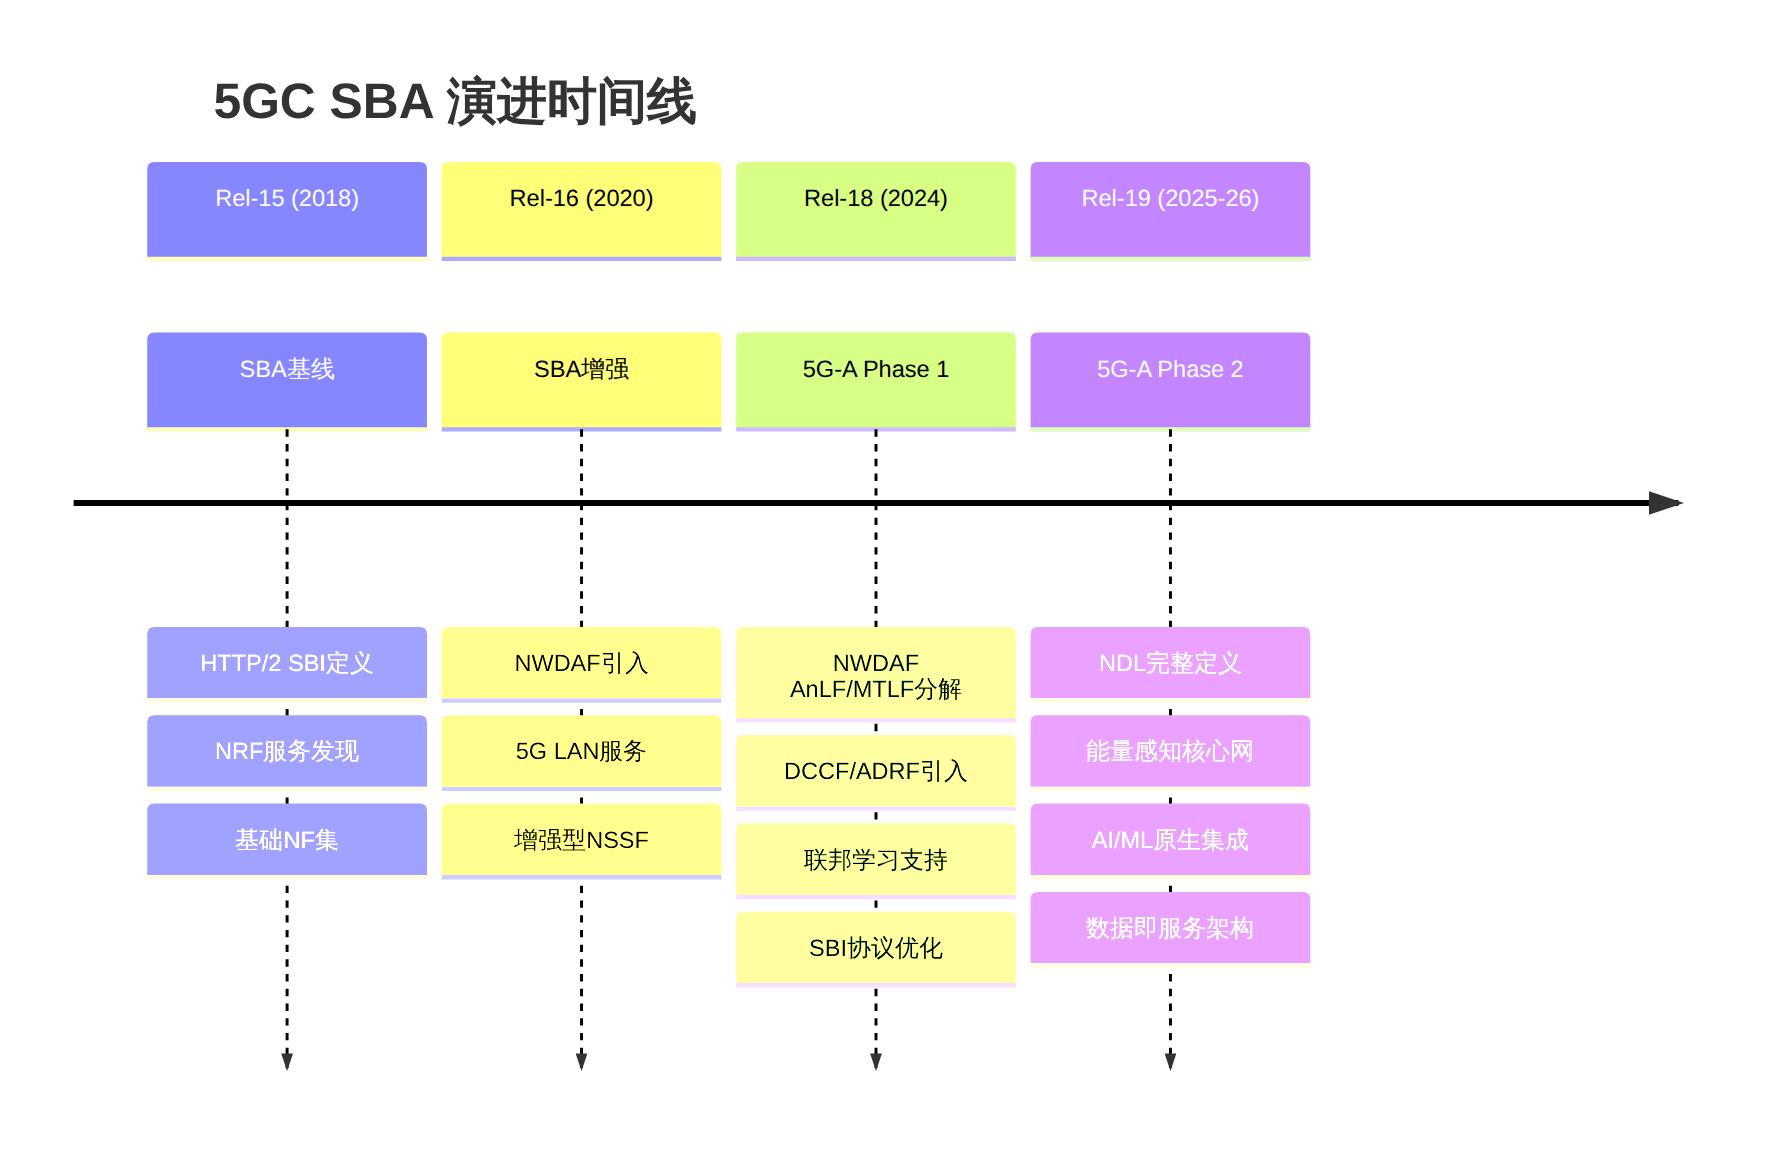
图表 2
网络数据层(Network Data Layer, NDL)是Rel-18引入并在Rel-19完善的架构概念,旨在为核心网提供统一的数据采集、处理、分析与暴露框架。其核心组成包括:
NDL的架构设计遵循以下原则:
$$ \text{NDL} = \underbrace{\text{Data Collection}}{\text{DCCF}} + \underbrace{\text{Analytics Engine}}}} + \underbrace{\text{Data Storage}{\text{ADRF}} + \underbrace{\text{Data Exposure}} $$}
Rel-18对NWDAF进行了功能分解(参见TS 23.288 V18.x),将原先的单一NWDAF实例拆分为两个逻辑功能:
AnLF(Analytics Logical Function)— 分析逻辑功能 - 负责推理(Inference):基于已有模型执行实时分析 - 生成Analytics信息并通知消费者 - 从MTLF获取模型或使用预置模型
MTLF(Model Training Logical Function)— 模型训练逻辑功能 - 负责训练(Training):基于采集数据训练ML模型 - 管理模型生命周期(版本、精度、过期) - 支持联邦学习(Federated Learning)
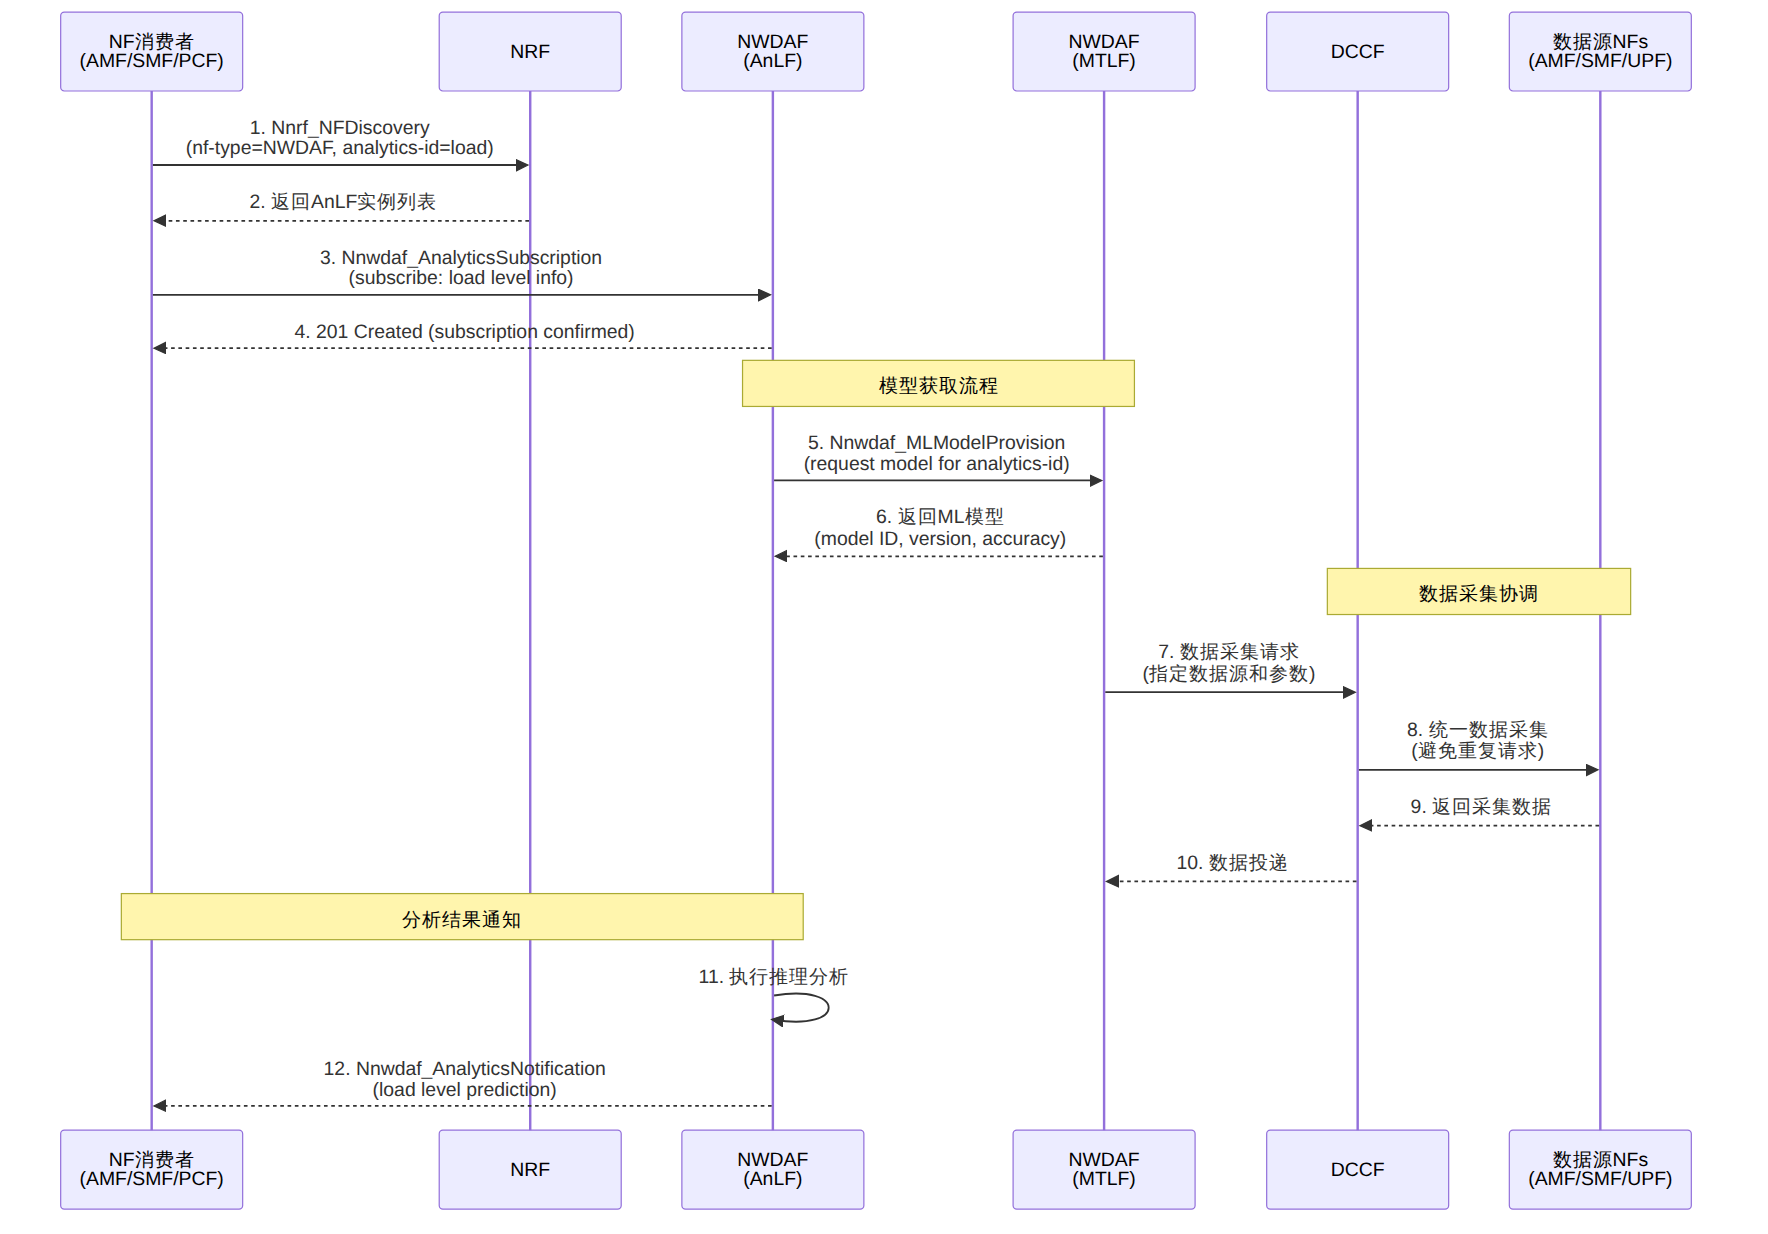
图表 3
根据TS 29.520(Nnwdaf服务定义)和TS 29.519(Nnwdaf数据模型),NWDAF分析服务的关键参数如下:
| 参数名称 | 类型 | 说明 | 典型配置值 |
|---|---|---|---|
analyticsId |
Enum | 分析类型标识 | LOAD_LEVEL, NW_PERFORMANCE, UE_MOBILITY, UE_COMM |
analyticFilter |
Struct | 过滤条件 | {targetNF: "AMF-1", tai: [PLMN+TAC], snssai: S-NSSAI} |
accuracyTarget |
Float | 精度目标(0~1) | 0.85~0.95 |
analyticsGranularity |
Enum | 时间粒度 | MINUTE(1/5/15), HOUR(1), DAY(1) |
outputStrategy |
Enum | 输出策略 | BINARY_THRESHOLD, PERCENTILE, EXACT_VALUE |
modelId |
String | ML模型标识 | 由MTLF生成的UUID |
modelVersion |
String | 模型版本号 | v2.1.3 |
validityPeriod |
Integer | 模型有效期(秒) | 3600~86400 |
分析精度与数据量的关系模型:
$$ \text{Accuracy}(n) = \alpha \cdot \left(1 - e^{-\beta \cdot n}\right) + \gamma $$
其中 $n$ 为训练样本数量,$\alpha$ 为理论上限,$\beta$ 为学习速率因子,$\gamma$ 为基线精度。实际部署中,$\alpha$ 通常取0.92~0.97,$\beta$ 取0.001~0.01。
DCCF(Data Collection Coordination Function)是NDL的关键组件,解决多个NWDAF实例重复采集同一NF数据的效率问题。
核心机制:
算法伪代码:DCCF数据采集协调
━━━━━━━━━━━━━━━━━━━━━━━━━━━━━
Input: collection_requests[]  // 来自多个NWDAF实例的请求列表
Output: coordinated_plan

1. FOR each req IN collection_requests:
2.     key ← hash(req.nf_type, req.target_nf_id, req.data_filter)
3.     IF key IN active_sessions:
4.         // 合并到已有会话
5.         session ← active_sessions[key]
6.         session.subscribers.add(req.consumer_id)
7.         session.max_rate ← max(session.max_rate, req.sampling_rate)
8.     ELSE:
9.         // 创建新采集会话
10.        new_session ← create_session(req)
11.        active_sessions[key] ← new_session
12.    END IF
13. END FOR
14.
15. FOR each session IN active_sessions:
16.    IF session.max_rate > nf_load_threshold(session.target_nf):
17.        session.actual_rate ← adapt_rate(session, nf_load)
18.    END IF
19.    distribute_data(session)  // 分发采集数据
20. END FOR
━━━━━━━━━━━━━━━━━━━━━━━━━━━━━
DCCF性能增益评估:
$$ \text{Reduction}{\text{collection}} = 1 - \frac{\sum $$} \max_{i}(r_{i,k})}{\sum_{i}\sum_{k} r_{i,k}
其中 $r_{i,k}$ 表示第 $i$ 个消费者对第 $k$ 个数据源的请求频率。在大规模网络中(100+ NWDAF实例),DCCF可减少约 60%~75% 的重复数据采集。
ADRF(Analytics Data Repository Function)为NDL提供持久化存储能力:
ADRF的数据模型(参见TS 29.519 Clause 6):
| 数据对象 | 存储周期 | 数据量估算(每百万用户) | 访问模式 |
|---|---|---|---|
| Analytics Snapshot | 7~30天 | ~50 GB/天 | 实时读写 |
| Training Dataset | 90~365天 | ~200 GB/天 | 批量读写 |
| Model Metadata | 模型生命周期 | ~1 GB | 低频访问 |
| Audit Log | 1~7年 | ~10 GB/天 | 顺序追加 |
Rel-18引入了跨NWDAF实例的联邦学习机制(TS 23.288 Clause 6.3A),在保护数据隐私的前提下实现跨域模型协同训练:
$$ \theta_{global}^{t+1} = \sum_{i=1}^{N} \frac{|D_i|}{\sum_{j}|D_j|} \cdot \theta_{i}^{t} $$
其中 $\theta_i^t$ 为第 $i$ 个NWDAF实例在轮次 $t$ 的本地模型参数,$|D_i|$ 为其本地数据集大小。联邦平均(FedAvg)策略通过数据量加权聚合,确保数据量大的域贡献更大。
部署考量:
3GPP在Rel-19中启动了FS_ENCORE(Study on Energy Saving for Core Network)研究项目,聚焦核心网层面的节能机制。相关规范包括:
NF_LOAD, NF_ENERGY)能量感知核心网的核心理念是将能耗作为与负载、时延、可靠性并列的第四维优化目标:
$$ \text{Optimization Objective} = \min_{\mathbf{x}} \left[ \alpha \cdot L(\mathbf{x}) + \beta \cdot D(\mathbf{x}) + \gamma \cdot E(\mathbf{x}) \right] $$
其中 $L$ 为负载均衡度,$D$ 为端到端时延,$E$ 为能耗,$\alpha, \beta, \gamma$ 为权重系数(由运营商策略配置)。
核心网NF的能耗可分解为:
$$ P_{\text{NF}} = P_{\text{base}} + P_{\text{compute}} + P_{\text{storage}} + P_{\text{network}} $$
各分量的模型:
| 能耗分量 | 模型 | 典型占比 |
|---|---|---|
| 基础功耗 $P_{\text{base}}$ | 常数(进程保活、OS开销) | 15%~25% |
| 计算功耗 $P_{\text{compute}}$ | $k_1 \cdot \text{CPU}{\text{util}} + k_2 \cdot \text{GPU}$} | 40%~55% |
| 存储功耗 $P_{\text{storage}}$ | $k_3 \cdot \text{IOPS} + k_4 \cdot \text{Capacity}$ | 10%~20% |
| 网络功耗 $P_{\text{network}}$ | $k_5 \cdot \text{BW} + k_6 \cdot \text{PPS}$ | 10%~20% |
Bits-per-Joule效率指标(TS 28.310定义):
$$ \eta_{\text{energy}} = \frac{\text{Throughput}{\text{data}} \text{ (bits)}}{P $$}} \cdot T \text{ (Joules)}} = \frac{\sum_{i} R_i \cdot T}{P_{\text{total}} \cdot T} = \frac{\sum_{i} R_i}{P_{\text{total}}
NWDAF为能量感知核心网提供关键的分析能力:
(1)负载预测分析(Analytics ID: NF_LOAD)
NWDAF基于历史负载模式预测NF未来负载,为缩容决策提供依据:
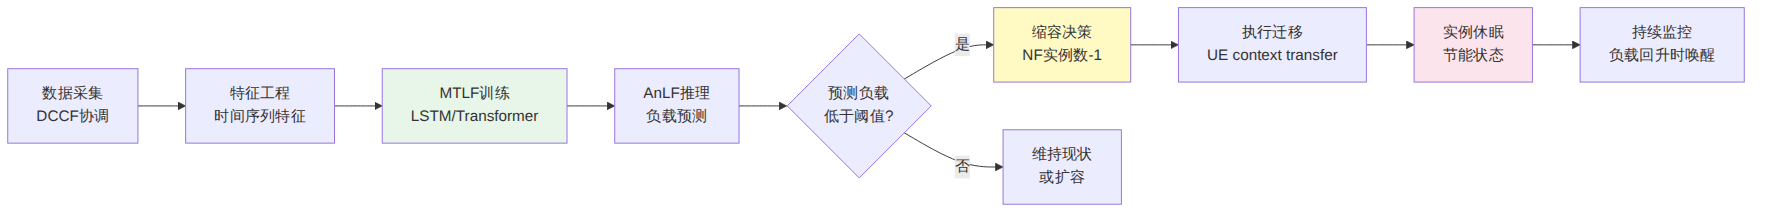
图表 4
(2)节能分析(Analytics ID: NF_ENERGY,Rel-19新增)
TS 23.288 Rel-19版本新增NF_ENERGY分析ID,提供以下分析输出:
| 分析输出 | 数据类型 | 说明 |
|---|---|---|
energySavingState |
Enum | ACTIVE / INACTIVE / NOT_SUPPORTED |
energySavingPotential |
Float (0~1) | 当前可节省能耗的比例 |
recommendedAction |
Struct | 推荐操作及预期节能效果 |
energyEfficiencyMetric |
Float | Bits-per-Joule指标 |
peakLoadPeriod |
TimeWindow | 预测的高峰负载时段 |
机制一:NF实例动态缩放(Dynamic NF Scaling)
基于NWDAF负载预测,核心网可在低负载时段动态减少NF实例数量:
节能决策算法
━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━
Input:
    predicted_load[t+Δt]  // NWDAF预测的t+Δt时刻负载
    current_instances     // 当前NF实例数
    min_instances         // 最小实例数(冗余约束)
    scale_threshold_low   // 缩容阈值
    scale_threshold_high  // 扩容阈值

Process:
1. target_instances ← ceil(predicted_load / per_instance_capacity)
2. target_instances ← max(target_instances, min_instances)
3. IF target_instances < current_instances:
4.     // 缩容流程
5.     FOR each instance_to_remove:
6.         drain_connections(instance)  // 排空连接
7.         migrate_contexts(instance)   // 迁移UE上下文
8.         suspend_or_terminate(instance)
9.     END FOR
10.    estimated_saving ← (current - target) × P_per_instance
11. ELSE IF target_instances > current_instances:
12.    // 扩容流程
13.    instantiate_new_instances(target - current)
14.    register_with_NRF(new_instances)
15. END IF
━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━
关键参数配置建议:
| 参数 | 推荐值 | 说明 |
|---|---|---|
Δt(预测窗口) |
15~60分钟 | 过短导致频繁操作,过长降低节能效果 |
min_instances |
N+1冗余 | 最少保留N+1个实例确保高可用 |
scale_threshold_low |
30%~40% | 低于此阈值触发缩容评估 |
drain_timeout |
5~15分钟 | 连接排空超时,超时后强制迁移 |
wake_up_time |
30~120秒 | 实例唤醒时间,影响扩容响应速度 |
机制二:SMF/UPF节能路由
在UPF选择过程中,PCF策略可结合NWDAF的能耗分析,将流量集中到少数UPF上,从而允许其他UPF进入休眠状态:
$$ \text{UPF}{\text{selected}} = \arg\min \left[ w_1 \cdot D(u) + w_2 \cdot L(u) - w_3 \cdot S(u) \right] $$}_{\text{active}}
其中 $S(u)$ 为集中流量到UPF $u$ 带来的节能收益。该机制在TS 23.502的UPF选择流程(Clause 4.3.2.2)中通过PCF策略增强实现。
机制三:AMF Set负载再均衡
AMF Set内的UE可在低负载时段被集中迁移到部分AMF,释放其余AMF进入休眠:
场景一:昼夜模式(Day-Night Pattern)
适用于有明显潮汐效应的商业区网络:
场景二:事件驱动节能
适用于体育场馆、会展中心等场景:
wake_up_time 缓冲场景三:多切片协同节能
不同切片的负载峰值时段可能不同(eMBB vs URLLC vs mMTC):
$$ \text{Total Instances}{\text{required}} = \max_s(t) $$} \sum_{s \in \mathcal{S}} \text{Instances
通过切片间资源共享和错峰调度,可减少总NF实例需求。
| 节能机制 | 适用NF类型 | 节能潜力 | 实现复杂度 | 标准化状态 |
|---|---|---|---|---|
| NF动态缩放 | AMF, SMF, PCF | 20%~35% | 中 | Rel-19研究 |
| UPF节能路由 | UPF | 15%~25% | 中-高 | Rel-19研究 |
| AMF Set再均衡 | AMF | 10%~20% | 中 | Rel-18/19 |
| NWDAF分析驱动 | 所有NF | 间接增益 | 低-中 | Rel-18已标准化 |
| 休眠/唤醒策略 | 所有NF | 取决于负载模式 | 低 | Rel-19研究 |
将NDL的分析能力与能量感知机制结合,形成感知-分析-决策-执行的闭环系统:
$$ \underbrace{\text{Sense}}{\text{DCCF采集}} \xrightarrow{\text{data}} \underbrace{\text{Analyze}}}} \xrightarrow{\text{insight}} \underbrace{\text{Decide}{\text{PCF/OAM}} \xrightarrow{\text{action}} \underbrace{\text{Execute}} $$}} \xrightarrow{\text{feedback}} \text{Sense
闭环关键指标:
| 指标 | 定义 | 目标值 |
|---|---|---|
| 采集延迟 | 从NF事件到DCCF收到数据的延迟 | < 1秒 |
| 分析延迟 | 从数据到达到AnLF输出结果的延迟 | < 5秒 |
| 决策延迟 | 从收到分析到PCF生成策略的延迟 | < 10秒 |
| 执行延迟 | 从策略下发到NF完成缩放的延迟 | < 120秒 |
| 节能准确率 | 实际节能效果与预测的比率 | > 85% |
Rel-19作为5G-Advanced的最终版本,为Rel-20(6G桥接版本)奠定了以下基础:
Q1:NWDAF的AnLF和MTLF必须部署在不同的物理节点上吗?
不是。AnLF和MTLF是逻辑功能分解,可以共部署在同一NWDAF实例中,也可以分别部署在不同实例上。分离部署的优势在于:MTLF可以集中部署在有GPU算力的数据中心,而AnLF可以分布式部署在边缘。当需要跨PLMN联邦学习时,MTLF分离部署是必要的。
Q2:DCCF和NWDAF的数据采集有什么区别?NWDAF能否直接采集数据?
Rel-18之前,NWDAF可以直接从NF采集数据。Rel-18引入DCCF后,建议通过DCCF协调所有数据采集。NWDAF仍保留直接采集能力(向后兼容),但在多NWDAF实例场景下,DCCF能显著减少重复采集。单NWDAF实例的小型网络可暂不部署DCCF。
Q3:能量感知核心网的节能效果如何验证?
建议分三个阶段验证:(1)基线测量——在未启用节能机制时记录7天能耗数据;(2)灰度启用——选择非关键切片启用NWDAF负载预测和动态缩放,记录节能效果;(3)全面部署——基于灰度结果调优参数后全网推广。关键度量指标为 Bits-per-Joule 和 kWh/用户/月。
Q4:NWDAF联邦学习在跨运营商场景下如何处理数据合规问题?
联邦学习的核心优势是"数据不动模型动"——各运营商的原始数据不离开本地,只交换模型参数(梯度)。但仍需注意:(1)模型参数可能隐含数据特征,建议结合差分隐私(DP)添加噪声;(2)跨PLMN传输需通过N32安全通道;(3)需确保训练数据的合法性基础满足GDPR等法规要求。
Q5:核心网节能缩容是否会影响SLA?
存在风险,但可通过以下机制缓解:(1)设置 min_instances 确保冗余度;(2)NWDAF负载预测的置信度低于阈值时不触发缩容;(3)保留快速扩容通道(wake_up_time < 120秒);(4)对URLLC等高可靠性切片禁用自动缩容。实际部署建议先从eMBB切片开始验证。
📖 本文由51学通信技术团队撰写,聚焦5G-Advanced核心网演进的前沿技术解析。关注我们,获取更多3GPP协议深度解读与网络架构实战经验。
51学通信 —— 让通信技术学习更高效
[!tip] 51学通信知识星球 星主:爱卫生(微信:gprshome201101)——公众号「51学通信」创办者,19 年通信行业运维与讲师经验,著有《GPRS网络信令实例详解》《EPC原理与实践》《5G核心网原理与实践》三本纸质书(各大电商平台有售)。 星球定位:深耕 5G 核心网、IMS、NFV/AI、云原生等 ICT 领域,主打运维岗位与信令分析。 当前规模:5200 篇主题 / 990 个回答,198 元/年。 加入福利:加入星球后请加爱卫生微信,拉您进知识星球年度陪伴与答疑群——不限量回复您的各种问题,另有群内分享。 AI 加持:51学通信知识星球已作为 skill 接入 WorkBuddy,使用 deepseek-4-flash 在海量星球帖子中精准找贴、找视频、找 FAQ 和案例,做总结、找文档和 PPT 等场景全覆盖。
