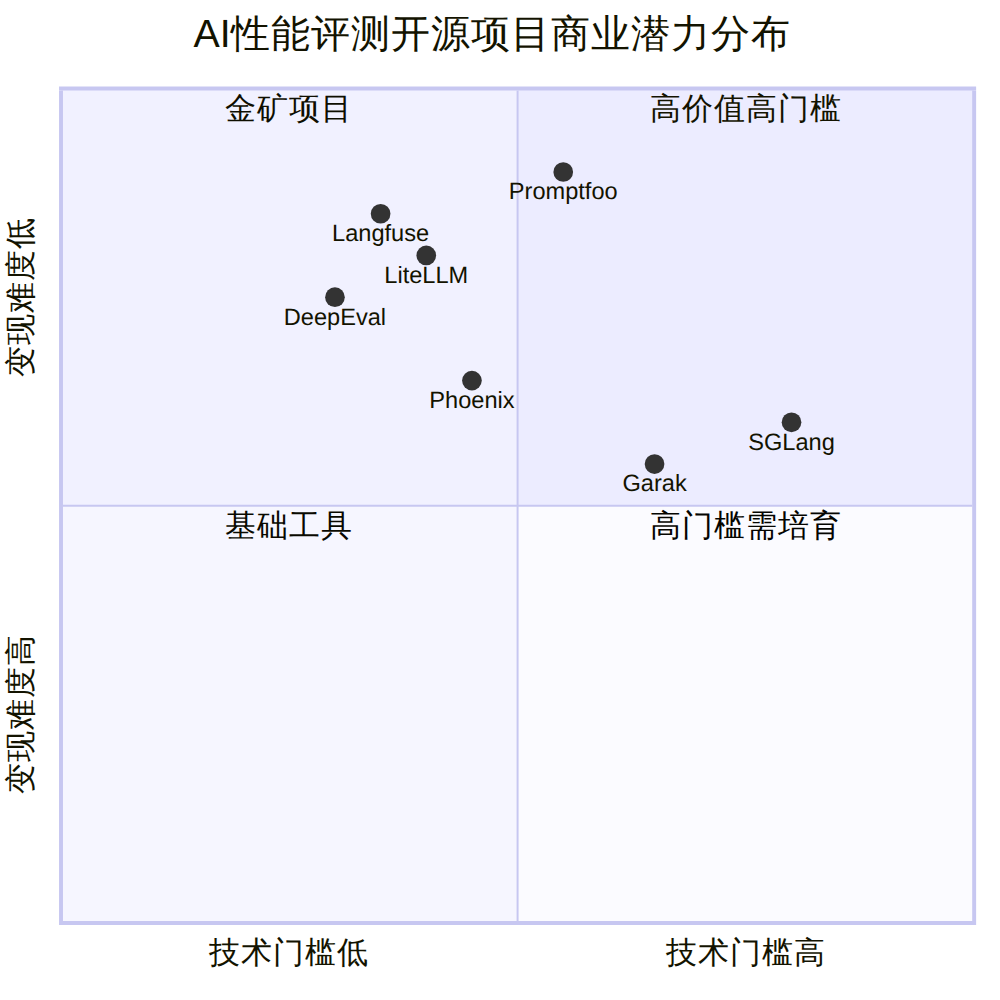
2026年5月第三周,LLM推理引擎实测数据爆发式增长——SGLang在H100上以16,200 tok/s吞吐量碾压vLLM的12,500 tok/s(差距29%),Promptfoo被OpenAI收购震动全行业,Langfuse以Freemium模式月入百万美元跑通商业化闭环。这标志着AI基础设施从"能用"进入"好用且能赚钱"的新阶段。本文深度拆解7个聚焦性能实测与评测的开源项目,从实测数据出发,分析其商业变现潜力、训练营适用性和技术差异化。
| 维度 | 权重 | 说明 |
|---|---|---|
| 变现潜力 | 40% | 能否包装成付费产品?目标用户是谁?定价空间? |
| 训练营适用性 | 25% | 能否在2-4小时内教会学员?学员能做出什么成果? |
| 技术新颖度 | 20% | 是否代表前沿方向?是否有差异化优势? |
| 维护活跃度 | 15% | 最近一周是否有commit?Issue响应速度? |
项目地址: github.com/sgl-project/sglang | Stars: 25K+ | 最近更新: 2026年5月
核心功能: 伯克利团队开源的高性能LLM推理引擎,通过RadixAttention技术和编译器优化实现极致吞吐。
上手难度: ⭐⭐⭐⭐
实测数据亮点: - H100 GPU上吞吐量达 16,200 tokens/s,vLLM为12,500 tok/s,领先29% - 在GB300 NVL72上较H200实现 25倍性能提升 - 多轮对话场景下prefix caching带来 6.4x 延迟降低 - 结构化输出场景下较vLLM快 3.8倍
变现评估: 直接对标vLLM的商业模式。可推出企业级SGLang托管服务,按推理量计费。目标用户为AI应用开发商和GPU云服务商。定价空间:托管服务¥0.5-2/百万token,企业技术支持¥5-20万/年。目前SGLang团队已成立商业公司,提供企业版推理优化和部署咨询。
训练营评估: 适合"LLM推理优化实战营"课程,教学时长4小时。学员可掌握从裸机部署到性能调优的完整链路,产出:在自有GPU上跑出性能测试报告,对比不同引擎的吞吐/延迟数据。
竞品分析: vLLM(社区最大、生态完善但性能落后)、TensorRT-LLM(NVIDIA官方、硬件绑定强)、llama.cpp(边缘设备首选、但不适合高并发)。SGLang的差异化在于学术前沿技术快速产品化,RadixAttention是独有的KV Cache复用机制。
项目地址: github.com/promptfoo/promptfoo | Stars: 18K+ | 最近更新: 2026年5月
核心功能: 开源CLI工具,自动化测试Prompt、Agent和RAG系统,内置红队攻击向量库,覆盖越狱、注入、信息泄露等安全场景。
上手难度: ⭐⭐⭐
变现评估: 已被OpenAI收购——这是最直接的变现验证。被收购前,Promptfoo已服务127家财富500强公司的25%+,企业版定价为按需定制。收购后,核心框架保持开源,商业价值体现在:(1) AI安全合规咨询,¥2-10万/次审计;(2) 企业级AI安全训练营,¥999-2,999/人;(3) 定制化红队测试服务,年费¥10-50万。EU AI Act合规需求推动下,AI安全测试正在成为刚需。
训练营评估: 极其适合"AI安全红队实战营",教学时长3-4小时。学员产出:对自有LLM应用完成一套完整的安全评估报告,包含30+攻击向量测试结果。课程卖点明确、可量化。
竞品分析: Garak(NVIDIA出品、更偏学术扫描)、DeepEval(偏质量评估而非安全)。Promptfoo的独特定位是"安全+质量双修",且提供Web UI和CI/CD集成。
项目地址: github.com/confident-ai/deepeval | Stars: 8K+ | 最近更新: 2026年5月
核心功能: 开源LLM评估框架,提供14+内置评估指标(幻觉检测、回答相关性、毒性检测等),支持"LLM-as-Judge"和确定性度量双模式。
上手难度: ⭐⭐
实测数据亮点: - 内置指标覆盖:幻觉率(Groundedness)、回答相关性(Answer Relevance)、RAG精度(Contextual Precision/Recall)、毒性(Toxicity)、偏见(Bias)等 - 支持同步评估1000+测试用例,生成结构化报告 - 与Pytest无缝集成,可直接嵌入CI流水线
变现评估: Confident AI采用经典Open-Core模式。开源版免费提供核心评估能力,企业版增加:团队协作仪表盘、自定义基准线、历史趋势追踪、合规报告生成。定价:Pro版$49/月/用户,Enterprise版按需定价$500+/月。目标用户:AI产品团队、QA工程师。国内可包装为"AI质量检测平台",定价¥299-999/月/团队。
训练营评估: 适合"LLM应用质量保障训练营",教学时长2-3小时。学员可产出:对RAG应用完成端到端评估pipeline,输出自动化测试报告。非常适合MLOps方向学员。
竞品分析: RAGAS(专注RAG评估,更窄更深)、Promptfoo(偏安全测试)。DeepEval的优势是评估维度最全面、API设计最简洁(@metric装饰器风格)。
项目地址: github.com/langfuse/langfuse | Stars: 12K+ | 最近更新: 2026年5月
核心功能: 开源LLM工程平台,提供Tracing、Prompt Management、评估和指标看板四大核心能力,帮助团队监控和优化LLM应用。
上手难度: ⭐⭐
变现评估: Langfuse是本批项目中商业化最成功的开源项目。定价模型:Hobby免费(5万Observations/月)、Core $29/月(20万Observations)、Team $99/月、Enterprise $2,499/月。2026年预计ARR超$500万。变现路径清晰:开源引流 → 云托管付费 → 企业级功能/支持。国内可复制该模式做"LLM可观测性SaaS",但需注意数据合规。
训练营评估: 适合"LLM应用可观测性实战"课程,教学时长2小时。学员产出:为自己的LLM应用搭建完整的监控体系,包含请求追踪、Token消耗分析、质量趋势看板。
竞品分析: LangSmith(LangChain官方出品、闭源、$39/月起)、Arize Phoenix(同为开源竞对)、Phoenix在技术架构上更新,但Langfuse的商业化成熟度远超对手。核心差异:Langfuse的Prompt版本管理功能独树一帜。
项目地址: github.com/Arize-ai/phoenix | Stars: 7K+ | 最近更新: 2026年5月
核心功能: 基于OpenTelemetry标准构建的AI可观测性平台,专注于LLM应用的Tracing、评估和实验管理,以笔记本内嵌入(Notebook-first)为设计理念。
上手难度: ⭐⭐
实测数据亮点: - 基于OpenTelemetry标准,与现有可观测性栈(Jaeger、Grafana)无缝对接 - 支持300+ LLM Provider自动Instrumentation - 内置Embedding可视化(t-SNE/UMAP),直观展示RAG检索质量 - 响应时间追踪精度到毫秒级,Token吞吐率实时监控
变现评估: Arize采用分层策略。Phoenix开源版免费,提供核心Tracing和评估。Arize Cloud提供托管服务:Free-$50/用户/月,Enterprise版$1,000/月起。目标用户:ML工程师、数据科学家。关键差异化:OpenTelemetry标准意味着企业现有监控体系可以零成本接入,这对大型企业极具吸引力。可包装为"AI全链路可观测性方案",国内定价¥5,000-20,000/月。
训练营评估: 适合"AI应用全链路监控实战",教学时长2.5小时。学员产出:搭建完整的LLM应用Tracing系统,实现请求级追踪和性能瓶颈定位。对有运维背景的学员尤其友好。
竞品分析: Langfuse(功能更全面但非OTel标准)、LangSmith(闭源)。Phoenix的优势是"标准先行",在大型企业IT环境中更容易推广。
项目地址: github.com/BerriAI/litellm | Stars: 22K+ | 最近更新: 2026年5月
核心功能: 开源AI网关,统一100+ LLM提供商的API调用为OpenAI标准格式,内置负载均衡、Fallback策略、速率限制和成本追踪。
上手难度: ⭐⭐
实测数据亮点: - 支持140+提供商、2500+模型的统一接口 - 内置Router实现跨Provider负载均衡,实测可将API调用成本降低40-60% - Fallback策略在Provider故障时实现<100ms切换 - 并发请求管理支持10,000+ QPS的场景
变现评估: BerriAI的商业模式为Open-Core。开源Proxy Server免费使用,企业版增加:SSO/SAML、RBAC权限、审计日志、自定义SLA、专属部署支持。近期爆出CVE-2026-42208(SQL注入漏洞)虽是负面新闻,但反向证明了企业安全需求的真实存在。定价:Pro $50/月,Enterprise按需。可包装为"AI API统一管理平台",目标用户为使用多模型的企业AI团队,国内定价¥999-4,999/月。
训练营评估: 适合"多模型AI架构实战",教学时长3小时。学员产出:搭建统一AI网关,配置多Provider负载均衡、成本追踪和Fallback策略。实操性极强。
竞品分析: OpenRouter(托管路由服务、非开源)、Portkey(闭源AI网关)。LiteLLM的开源自部署特性对数据敏感型企业(金融、医疗)极具吸引力。
项目地址: github.com/NVIDIA/garak | Stars: 5K+ | 最近更新: 2026年5月
核心功能: NVIDIA AI红队出品的LLM漏洞扫描器,内置90+探测器(Probe)和数千个攻击提示,覆盖幻觉、偏见、越狱、数据泄露、编码安全等漏洞类型。
上手难度: ⭐⭐⭐
实测数据亮点: - 90+内置探测器,覆盖14个漏洞类别 - 支持扫描任何LLM(OpenAI、Anthropic、本地模型等) - 每次扫描自动生成结构化报告,含漏洞严重等级和修复建议 - 单次全量扫描可在30分钟内完成(针对70B参数模型)
变现评估: NVIDIA背书意味着学术声望极高。可包装为"AI安全合规审计服务":单次扫描¥5,000-20,000,年度审计¥10-50万/年。在EU AI Act和中国生成式AI管理办法双重合规压力下,AI安全评估正在成为刚需市场。此外,可开设"AI安全工程师认证"培训,定价¥2,999-5,999/人。
训练营评估: 适合"AI安全漏洞扫描实战",教学时长3小时。学员产出:使用Garak完成对自部署LLM的完整安全扫描,输出漏洞报告和修复建议。对企业安全团队尤其有吸引力。
竞品分析: Promptfoo(偏Prompt测试、已商业化)、AIRedTeam(闭源)。Garak的优势是NVIDIA品牌背书+探测覆盖面最广+持续更新漏洞库。
图表 1
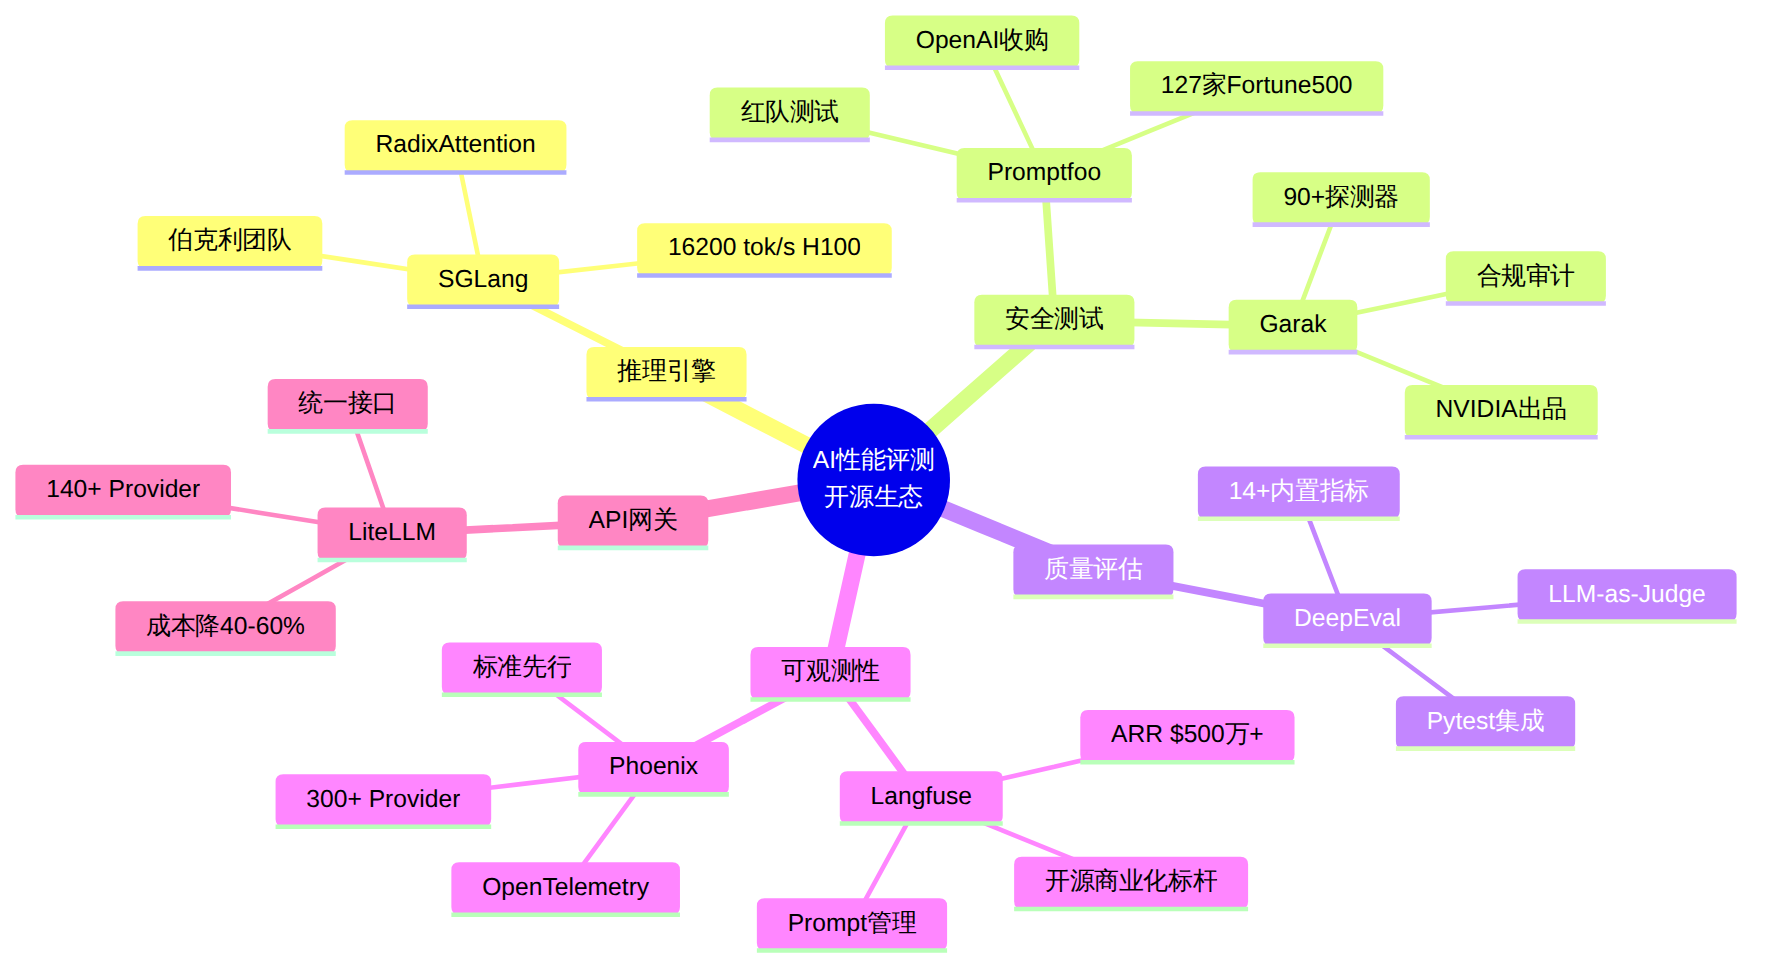
图表 2
| 排名 | 项目 | 变现方向 | 预估定价 | 核心逻辑 |
|---|---|---|---|---|
| 1 | Langfuse | LLM可观测性SaaS | ¥299-2,999/月 | 已跑通Freemium模式,ARR超$500万,开源引流+云托管变现路径清晰 |
| 2 | Promptfoo | AI安全合规服务 | ¥999-50,000/次 | OpenAI收购验证价值,EU AI Act合规推动刚需市场爆发 |
| 3 | LiteLLM | AI API管理平台 | ¥999-4,999/月 | 企业多模型管理刚需,成本优化ROI可量化,22K Stars社区基础大 |
| 4 | SGLang | 推理引擎托管/优化 | ¥0.5-2/百万token | 性能碾压竞品29%,推理成本优化空间巨大,25K Stars |
| 5 | DeepEval | AI质量检测平台 | ¥299-999/月 | 评估维度最全面,API设计最简洁,适合包装为团队工具 |
趋势一:实测数据成为新的技术营销货币。 2026年Q1-Q2,几乎所有AI基础设施项目都开始在README中放置benchmark图表。"16,200 vs 12,500 tok/s"这类数据点成为技术选型的首要依据。这种趋势为中国开发者提供了机会——面向国内硬件环境(华为昇腾、寒武纪)做专项benchmark,本身就是一个可商业化的信息差。
趋势二:AI安全从"Nice-to-have"变成"Must-have"。 Promptfoo被OpenAI收购、NVIDIA推出Garak,两家巨头同时下注AI安全测试赛道。EU AI Act已于2026年2月全面生效,中国生成式AI监管也在持续收紧。这意味着AI安全评估将像网络安全渗透测试一样,成为每个AI项目的标配环节。
趋势三:OpenTelemetry标准正在统一AI可观测性。 Arize Phoenix基于OTel标准的做法代表了行业方向。未来AI应用的监控将与现有云原生监控体系(Prometheus + Grafana)深度融合,而非独立存在。掌握OTel+AI的组合技能,将成为MLOps工程师的核心竞争力。
[!tip] 51学通信知识星球 星主:爱卫生(微信:gprshome201101)——公众号「51学通信」创办者,19 年通信行业运维与讲师经验,著有《GPRS网络信令实例详解》《EPC原理与实践》《5G核心网原理与实践》三本纸质书(各大电商平台有售)。 星球定位:深耕 5G 核心网、IMS、NFV/AI、云原生等 ICT 领域,主打运维岗位与信令分析。 当前规模:5200 篇主题 / 990 个回答,198 元/年。 加入福利:加入星球后请加爱卫生微信,拉您进知识星球年度陪伴与答疑群——不限量回复您的各种问题,另有群内分享。 AI 加持:51学通信知识星球已作为 skill 接入 WorkBuddy,使用 deepseek-4-flash 在海量星球帖子中精准找贴、找视频、找 FAQ 和案例,做总结、找文档和 PPT 等场景全覆盖。
