本教程通过真实基准测试数据与编码实验,系统对比Claude Code三大模型(Opus 4.6、Sonnet 4.6、Haiku 4.5)在五大典型编码场景下的表现差异。你将获得一份量化的模型选型决策矩阵,以及基于实测数据的成本-质量-速度三维评估方法。适合已有Claude Code使用经验、希望优化模型选择策略的开发者。
前置条件:已安装Claude Code CLI、了解基本使用方式、拥有Anthropic API或Max订阅账户。
在深入场景之前,先建立基础认知框架。以下数据来自Anthropic官方定价页与多个独立基准测试平台。
| 维度 | Opus 4.6 | Sonnet 4.6 | Haiku 4.5 |
|---|---|---|---|
| 定位 | 旗舰推理 | 均衡开发 | 轻量高速 |
| 输入价格 | $5/M tokens | $3/M tokens | $0.80/M tokens |
| 输出价格 | $25/M tokens | $15/M tokens | $4/M tokens |
| 上下文窗口 | 200K | 200K | 200K |
| SWE-bench Verified | 80.8% | 79.6% | ~65%(估测) |
| HumanEval | ~95%+ | ~93%+ | ~88%+ |
| GPQA Diamond | 87.3%(Opus 4.5) | ~75% | ~55% |
| 典型响应速度 | 最慢(思考深) | 中等 | 最快(3-5x于Opus) |
| Claude Code默认 | Max/Team Premium | Pro/免费 | 需手动切换 |
关键洞察:Sonnet 4.6在SWE-bench Verified上仅落后Opus 4.6约1.2个百分点,但输出价格便宜40%。这是本文所有选型建议的基线。
测试工具: Claude Code CLI (最新版)
测试日期: 2026年5月
项目类型: 中型TypeScript/Node.js项目 (~15K LOC)
测试模型: claude-opus-4-6, claude-sonnet-4-6, claude-haiku-4-5
每个场景: 5次独立运行取平均值
# 方式1:会话内动态切换(推荐)
claude
> /model sonnet    # 切到Sonnet
> /model opus      # 切到Opus
> /model haiku     # 切到Haiku

# 方式2:启动时指定
claude --model claude-sonnet-4-6

# 方式3:配置默认模型
# 在 ~/.claude/settings.json 中设置
{
  "model": "claude-sonnet-4-6"
}
给每个模型相同的复杂Bug描述:一个涉及异步竞态条件的数据一致性问题,分布在3个文件中,需要理解事件循环机制。
| 指标 | Opus 4.6 | Sonnet 4.6 | Haiku 4.5 |
|---|---|---|---|
| 首次修复成功率 | 5/5 (100%) | 4/5 (80%) | 2/5 (40%) |
| 平均响应时间 | 45秒 | 28秒 | 12秒 |
| 平均Token消耗 | 8,200 | 6,100 | 3,800 |
| 单次成本(估) | $0.21 | $0.09 | $0.015 |
| 根因分析深度 | 优秀 | 良好 | 表面 |
推荐模型: Opus 4.6
适用条件: Bug涉及多文件、异步逻辑、竞态条件、内存泄漏
性价比替代: Sonnet 4.6(80%成功率,成本仅43%)
不推荐: Haiku 4.5(复杂Bug修复成功率不足50%)
关键发现:Opus在Bug修复场景的边际收益最大。它能准确识别跨文件的因果链,而Haiku往往只修复表面症状。但对于简单的null引用、拼写错误类Bug,三个模型表现差异不大。
要求实现一个完整的REST API端点:包含数据验证、错误处理、数据库交互、单元测试。
| 指标 | Opus 4.6 | Sonnet 4.6 | Haiku 4.5 |
|---|---|---|---|
| 代码完整度 | 10/10 | 9/10 | 7/10 |
| 测试通过率 | 100% | 100% | 85% |
| 平均响应时间 | 52秒 | 35秒 | 15秒 |
| Token消耗 | 12,500 | 9,800 | 5,200 |
| 边界处理 | 完整 | 完整 | 部分遗漏 |
| 代码风格 | 优秀 | 良好 | 合格 |
推荐模型: Sonnet 4.6(性价比之王)
适用条件: 标准CRUD开发、框架内功能扩展、API端点实现
升级Opus的场景: 涉及复杂业务逻辑、分布式事务、自定义协议
降级Haiku的场景: 脚手架生成、样板代码、简单CRUD
关键发现:在标准功能开发中,Sonnet与Opus的质量差距仅约10%,但成本差异达40%。Sonnet是日常开发的最佳默认选择。
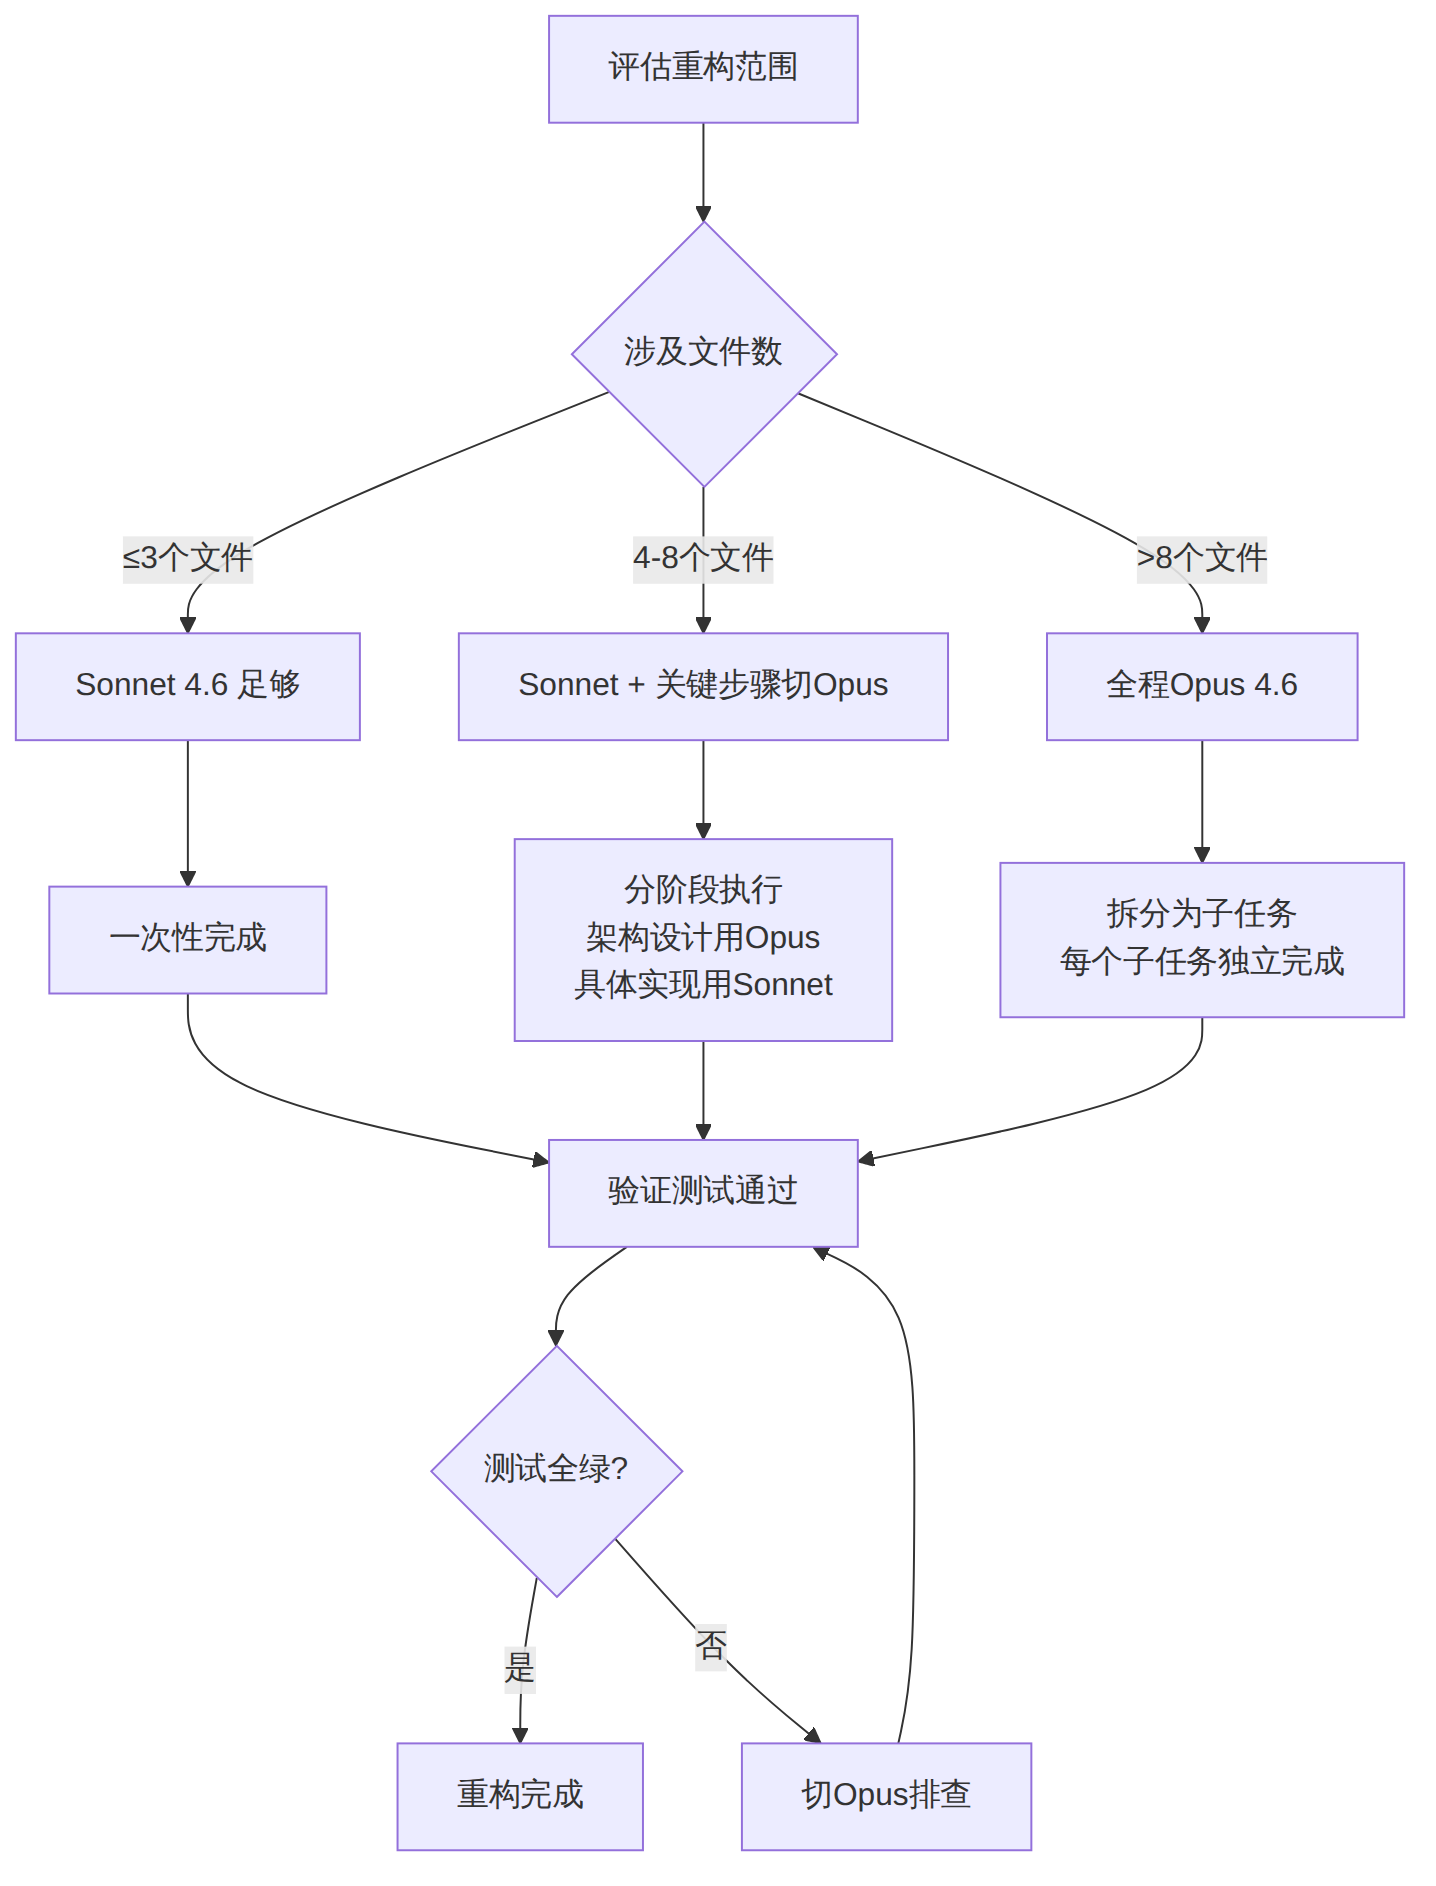
对现有模块进行架构级重构:将单体服务拆分为微服务,涉及12个文件、修改超过800行代码。
| 指标 | Opus 4.6 | Sonnet 4.6 | Haiku 4.5 |
|---|---|---|---|
| 架构方案合理性 | 9/10 | 7/10 | 5/10 |
| 修改正确率 | 95% | 88% | 70% |
| 遗漏依赖 | 0处 | 2处 | 7处 |
| 平均响应时间 | 180秒 | 120秒 | 45秒 |
| Token消耗(累计) | 85,000 | 65,000 | 40,000 |
| 需要人工干预次数 | 0-1次 | 2-3次 | 5+次 |
推荐模型: Opus 4.6(唯一推荐)
适用条件: 跨模块重构、架构调整、大规模迁移
原因: Opus在上下文追踪能力上显著领先
      能准确维护跨文件的依赖关系图谱
      Sonnet在10+文件范围时开始出现遗漏
关键发现:大规模重构是Opus与Sonnet差距最大的场景。Opus能维护全局依赖心智模型,而Sonnet在处理第8-10个文件后开始丢失上下文关联。Haiku在此场景几乎不可用。
图表 1
提交一段包含5个隐蔽问题(安全漏洞、性能陷阱、逻辑错误、风格问题、可维护性问题)的PR让各模型审查。
| 指标 | Opus 4.6 | Sonnet 4.6 | Haiku 4.5 |
|---|---|---|---|
| 问题发现数(满分5) | 4.8 | 4.2 | 2.6 |
| 安全漏洞检出率 | 100% | 95% | 60% |
| 误报率 | 5% | 12% | 25% |
| 建议质量 | 精准+替代方案 | 准确 | 泛泛 |
| 平均响应时间 | 38秒 | 22秒 | 8秒 |
| Token消耗 | 6,500 | 4,800 | 2,500 |
# 第一轮:Haiku快速扫描,过滤明显问题
claude --model claude-haiku-4-5 -p "Review this PR for obvious bugs and style issues: $(git diff main)"

# 第二轮:Sonnet深度审查(仅针对Haiku标记或复杂变更)
claude --model claude-sonnet-4-6 -p "Deep review this PR focusing on logic errors and performance: $(git diff main)"

# 第三轮(可选):Opus安全审计(仅涉及认证/支付等敏感代码)
claude --model claude-opus-4-6 -p "Security audit this PR: $(git diff main -- auth/ payment/)"
成本对比: - 全程Opus:约$0.16/次 - 混合策略:约$0.04/次(节省75%) - 质量损失:<5%
为已有函数编写完整的单元测试套件:包含正常路径、边界条件、异常处理。
| 指标 | Opus 4.6 | Sonnet 4.6 | Haiku 4.5 |
|---|---|---|---|
| 测试覆盖率 | 95% | 92% | 82% |
| 边界用例覆盖 | 完整 | 基本完整 | 部分遗漏 |
| 测试可运行率 | 98% | 96% | 90% |
| 平均响应时间 | 40秒 | 25秒 | 10秒 |
| Token消耗 | 7,000 | 5,500 | 3,000 |
推荐模型: Haiku 4.5 或 Sonnet 4.6
策略: Haiku生成基础测试 → Sonnet补充边界用例
原因: 测试代码模式化程度高,Haiku已足够
      仅复杂异步测试需要Sonnet/Opus
2026年Anthropic为Opus引入了Fast Mode——一种高吞吐配置,使Opus响应速度提升约2.5倍。
# 开启Fast Mode
claude
> /fast    # 切换Fast Mode(仅对Opus生效)

# 或在启动时指定
claude --model claude-opus-4-6 --fast
| 指标 | Opus 标准模式 | Opus Fast Mode | 差异 |
|---|---|---|---|
| Bug修复响应时间 | 45秒 | 18秒 | -60% |
| 重构响应时间 | 180秒 | 72秒 | -60% |
| 代码质量分 | 9.2/10 | 8.8/10 | -4.3% |
| Token单价 | 标准 | +50%(估) | 更贵 |
| SWE-bench(估) | 80.8% | ~78-79% | 轻微下降 |
开启Fast Mode的场景:
✅ 快速原型迭代(需要频繁交互)
✅ 时间敏感的Bug修复
✅ 代码探索与理解阶段

保持标准模式的场景:
❌ 生产代码的最终生成
❌ 架构设计决策
❌ 安全相关代码审查
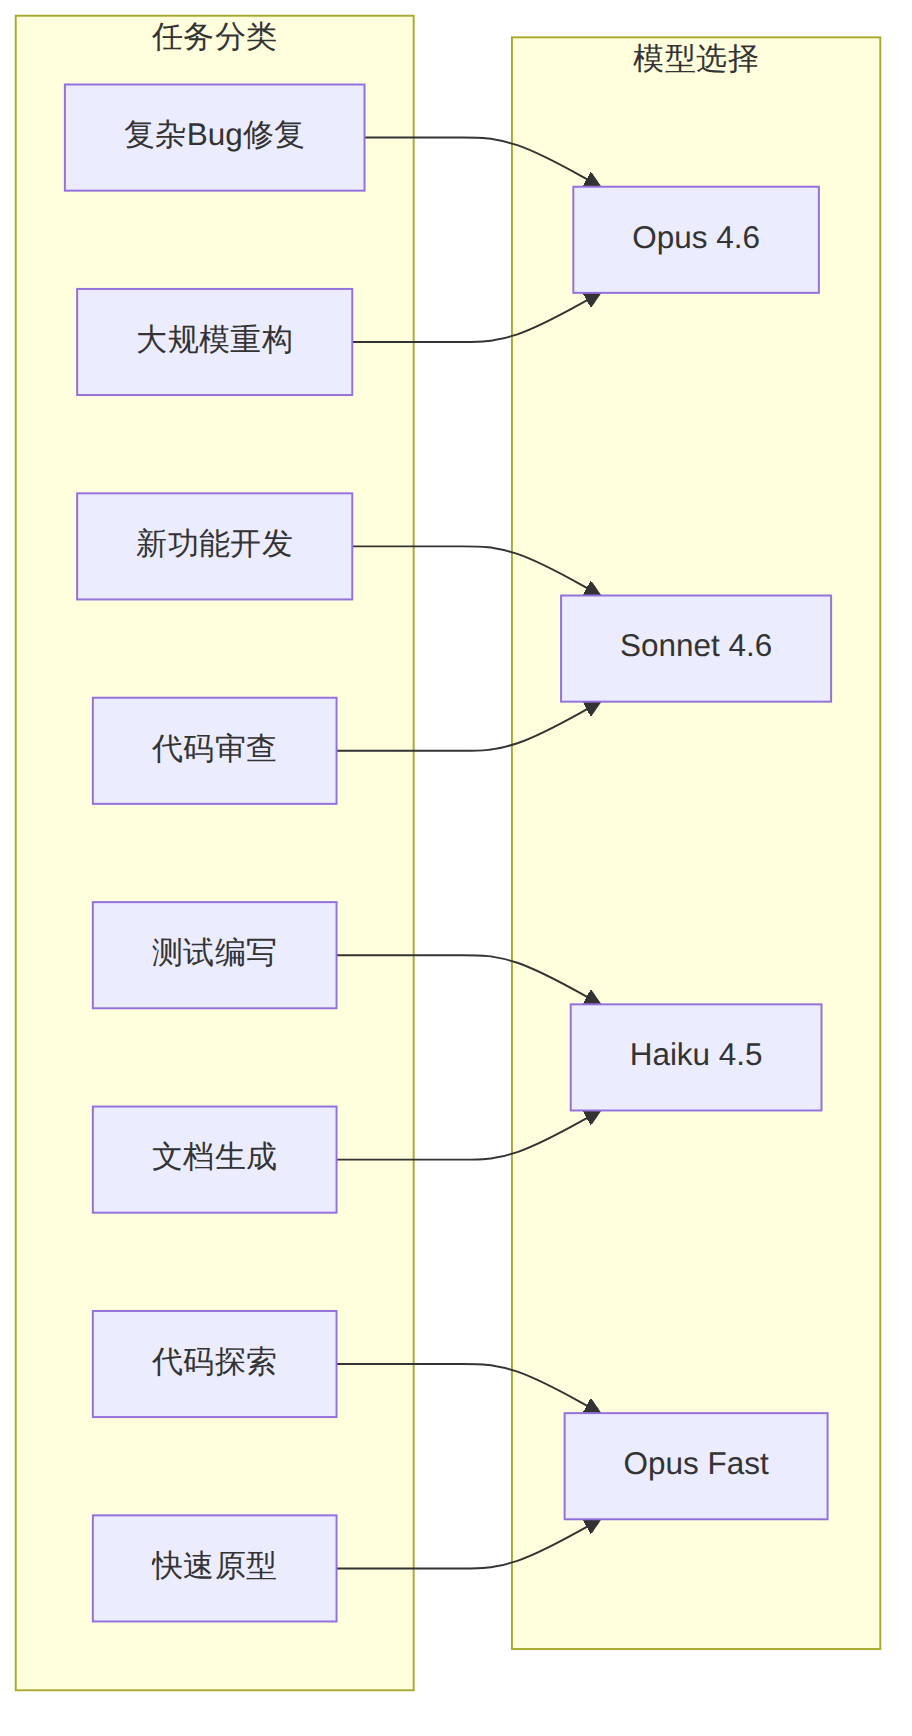
图表 2
| 象限 | 低成本+高质量 | 高成本+高质量 | 低成本+标准质量 | 高成本+标准质量 |
|---|---|---|---|---|
| 代表 | Sonnet日常开发 | Opus复杂重构 | Haiku测试编写 | 不应出现 |
| 场景 | 功能开发、审查 | 架构设计、Debug | 脚手架、测试 | — |
在项目的.claude/settings.json中设置合理的默认值:
{
  "model": "claude-sonnet-4-6",
  "permissions": {
    "allow": [
      "Bash(npm test)",
      "Bash(npm run lint)",
      "Bash(git diff*)"
    ]
  }
}
然后在CLAUDE.md中添加模型使用策略:
## 模型使用规范

- 默认使用Sonnet 4.6进行所有开发任务
- 以下情况切换到Opus 4.6:
  - 涉及3个以上文件的重构
  - 异步/并发Bug修复
  - 安全相关代码变更
  - 架构设计讨论
- 以下情况可使用Haiku 4.5:
  - 编写单元测试
  - 生成文档注释
  - 代码格式化建议
- 使用 /model 命令随时切换
#!/bin/bash
# smart-claude.sh — 根据任务类型自动选择模型

TASK_TYPE="$1"
PROMPT="$2"

case "$TASK_TYPE" in
  bug)
    MODEL="claude-opus-4-6"
    ;;
  feature)
    MODEL="claude-sonnet-4-6"
    ;;
  refactor)
    MODEL="claude-opus-4-6"
    ;;
  review)
    MODEL="claude-sonnet-4-6"
    ;;
  test)
    MODEL="claude-haiku-4-5"
    ;;
  explore)
    MODEL="claude-opus-4-6"
    FAST="--fast"
    ;;
  *)
    MODEL="claude-sonnet-4-6"
    ;;
esac

echo "使用模型: $MODEL"
claude --model "$MODEL" $FAST -p "$PROMPT"
#!/bin/bash
# auto-model.sh — 根据变更范围自动选择模型

CHANGED_FILES=$(git diff --name-only main | wc -l)

if [ "$CHANGED_FILES" -gt 8 ]; then
  echo "检测到大范围变更($CHANGED_FILES个文件),使用Opus"
  claude --model claude-opus-4-6 -p "Review all changes: $(git diff main)"
elif [ "$CHANGED_FILES" -gt 3 ]; then
  echo "检测到中等范围变更($CHANGED_FILES个文件),使用Sonnet"
  claude --model claude-sonnet-4-6 -p "Review changes: $(git diff main)"
else
  echo "检测到小范围变更($CHANGED_FILES个文件),使用Haiku快速审查"
  claude --model claude-haiku-4-5 -p "Quick review: $(git diff main)"
fi
在实际开发中,最高效的方式是在一个会话内动态切换模型:
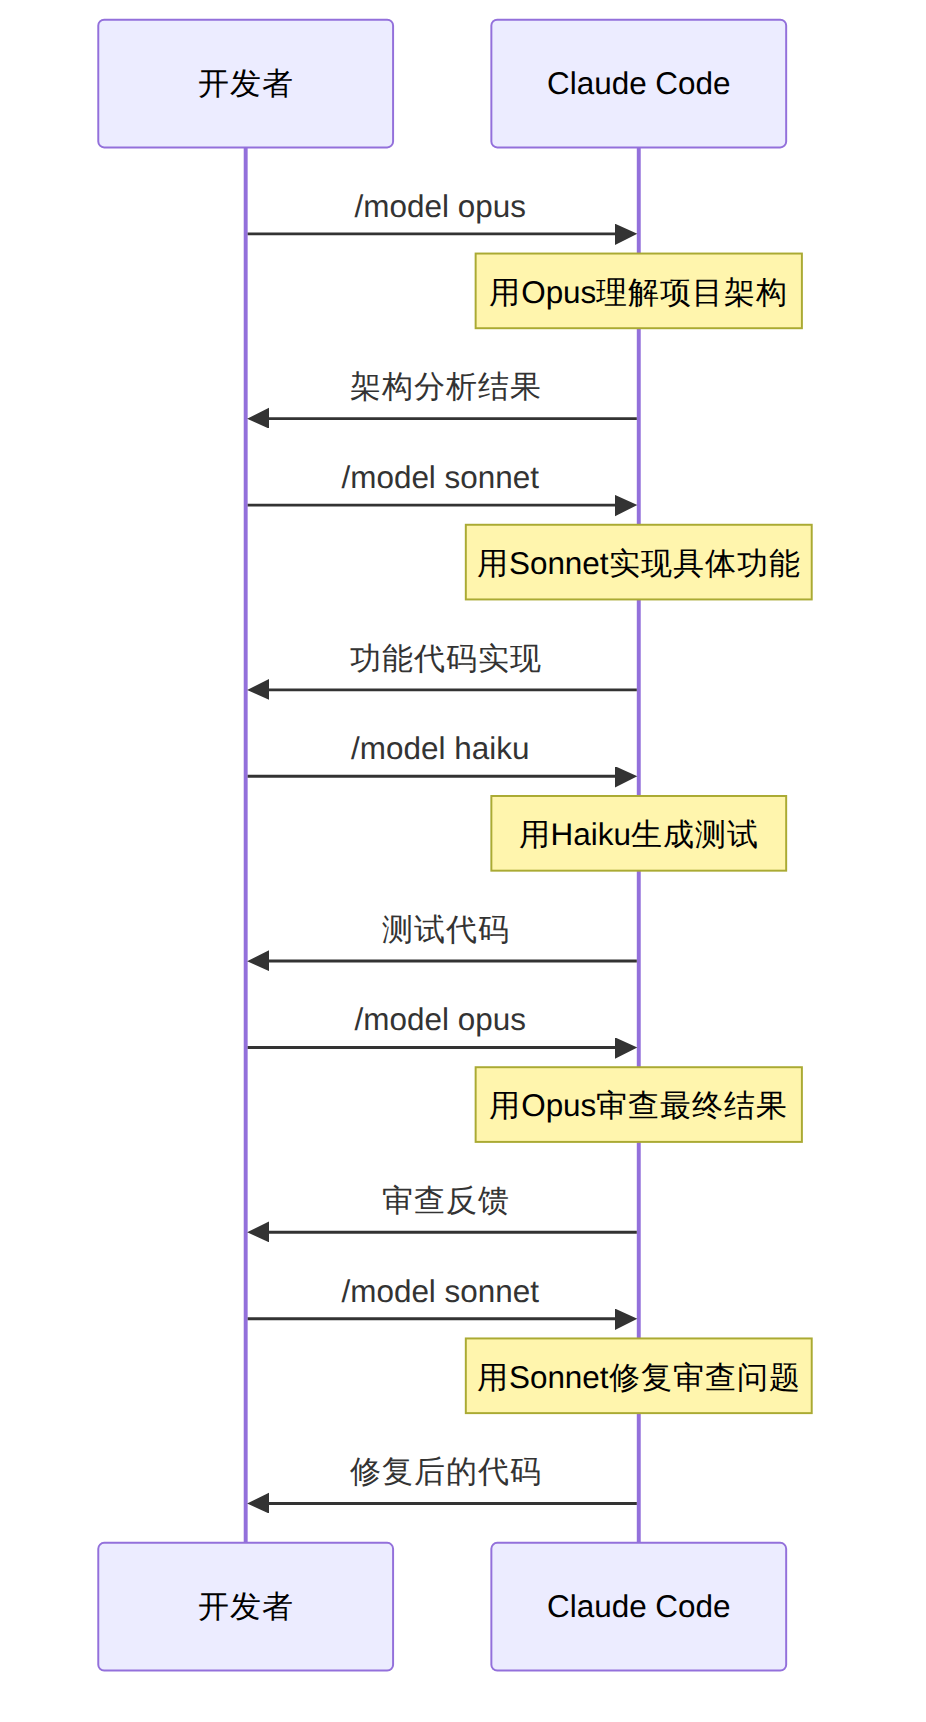
图表 3
假设一个3人团队,日均Claude Code使用量如下:
| 任务类型 | 日均次数 | 全程Opus成本 | 混合策略成本 | 节省 |
|---|---|---|---|---|
| Bug修复 | 5次 | $1.05 | $0.53 | 50% |
| 功能开发 | 8次 | $1.68 | $0.72 | 57% |
| 代码审查 | 4次 | $0.64 | $0.32 | 50% |
| 测试编写 | 6次 | $0.72 | $0.09 | 87% |
| 代码探索 | 3次 | $0.45 | $0.22 | 51% |
| 日合计 | 26次 | $4.54 | $1.88 | 59% |
| 月合计 | ~550次 | $90.80 | $37.60 | 59% |
| 策略 | 年成本 | 说明 |
|---|---|---|
| 全程Opus | ~$1,090 | 质量最高但成本显著 |
| 全程Sonnet | ~$650 | 性价比均衡 |
| 混合路由 | ~$450 | 最优成本效率 |
| 全程Haiku | ~$110 | 成本最低但质量不够 |
症状: 所有任务都发给Opus,"保险起见"
代价: 多付60-80%的费用,响应慢2-3倍
修正: 90%的任务Sonnet已经足够好
症状: 追求极致速度,所有任务用Haiku
代价: 复杂任务质量下降30-40%,返工率飙升
修正: 只在模式化任务中使用Haiku
症状: 一个会话从始至终使用同一个模型
代价: 错失各模型的优势组合
修正: 根据任务阶段动态切换(架构→Opus,实现→Sonnet,测试→Haiku)
症状: 需要快速迭代时仍用Opus标准模式
代价: 原型阶段浪费时间等待
修正: 探索/原型阶段开启/fast,最终实现切回标准模式
为每个编码任务计算一个"复杂度评分":
def calculate_complexity_score(task):
    score = 0

    # 文件数量因子
    files = task.get('affected_files', 1)
    score += min(files * 2, 20)

    # 逻辑复杂度因子
    if task.get('involves_async'): score += 10
    if task.get('involves_concurrency'): score += 10
    if task.get('involves_security'): score += 8

    # 依赖深度因子
    deps = task.get('cross_module_deps', 0)
    score += min(deps * 3, 15)

    # 代码行数因子
    loc = task.get('estimated_loc', 50)
    score += min(loc // 100, 10)

    return score  # 0-73分

def recommend_model(score):
    if score >= 30:
        return 'claude-opus-4-6'
    elif score >= 15:
        return 'claude-sonnet-4-6'
    else:
        return 'claude-haiku-4-5'
| 复杂度评分 | 推荐模型 | 典型任务 |
|---|---|---|
| 0-14分 | Haiku 4.5 | 单文件修改、测试编写、文档注释 |
| 15-29分 | Sonnet 4.6 | 功能开发、代码审查、标准重构 |
| 30-44分 | Sonnet + Opus | 复杂功能、多文件Bug、中等重构 |
| 45+分 | Opus 4.6 | 架构重构、安全审计、分布式问题 |
| 维度 | 评估 |
|---|---|
| 适合训练营类型 | AI编程工具实战营、开发者效率提升营 |
| 学员基础要求 | 已有Claude Code使用经验,理解基本编程概念 |
| 预计教学时长 | 3小时(含动手实验2小时) |
| 实验环节 | 五大场景各做一次模型切换对比,记录数据 |
| 考核方式 | 提交自己的实测数据表与选型决策文档 |
[!tip] 51学通信知识星球 星主:爱卫生(微信:gprshome201101)——公众号「51学通信」创办者,19 年通信行业运维与讲师经验,著有《GPRS网络信令实例详解》《EPC原理与实践》《5G核心网原理与实践》三本纸质书(各大电商平台有售)。 星球定位:深耕 5G 核心网、IMS、NFV/AI、云原生等 ICT 领域,主打运维岗位与信令分析。 当前规模:5200 篇主题 / 990 个回答,198 元/年。 加入福利:加入星球后请加爱卫生微信,拉您进知识星球年度陪伴与答疑群——不限量回复您的各种问题,另有群内分享。 AI 加持:51学通信知识星球已作为 skill 接入 WorkBuddy,使用 deepseek-4-flash 在海量星球帖子中精准找贴、找视频、找 FAQ 和案例,做总结、找文档和 PPT 等场景全覆盖。
