本教程系统讲解如何将Claude Code融入软件开发生命周期(SDLC)的每一个阶段,从需求分析、架构设计到编码实现、测试验证和生产部署。不同于零散的技巧分享,本文建立一套可复用的工程化方法论,帮助开发者将Claude Code从"聊天助手"升级为"全流程开发引擎"。适合有一定Claude Code基础、希望在实际项目中系统化运用AI编程的全栈开发者、技术负责人和工程团队。
npm install -g @anthropic-ai/claude-code)传统SDLC模型中,开发者承担需求拆解、技术选型、编码实现、测试部署等全部环节。引入Claude Code后,开发者的角色从"执行者"转变为"架构师+指挥官"——你负责定义方向和约束,Claude Code负责高速执行。
flowchart LR
    subgraph 传统SDLC
        A1[需求分析] --> A2[架构设计]
        A2 --> A3[编码实现]
        A3 --> A4[测试验证]
        A4 --> A5[部署上线]
        A5 --> A6[运维监控]
    end

    subgraph Claude Code增强SDLC
        B1[CLAUDE.md项目画像] --> B2[架构决策文档]
        B2 --> B3[分阶段Agent执行]
        B3 --> B4[自动化测试流水线]
        B4 --> B5[部署配置生成]
        B5 --> B6[监控与迭代反馈]
    end

    传统SDLC -.->|AI增强| Claude Code增强SDLC
核心转变在于三个维度:
| 维度 | 传统方式 | Claude Code增强方式 |
|---|---|---|
| 需求处理 | 人工拆解,文档驱动 | 自然语言描述,AI理解上下文并拆解为任务 |
| 编码速度 | 手动编写,逐文件推进 | 分阶段执行,子Agent并行开发 |
| 质量保障 | 事后测试,人工审查 | TDD驱动,实时测试反馈,代码审查嵌入流程 |
工程化的第一步不是写代码,而是为Claude Code建立项目"画像"。CLAUDE.md是Claude Code理解项目上下文的核心机制——Anthropic官方将其定位为"naively dropped into context"的基础配置层。
my-project/
├── CLAUDE.md              # 全局层:项目概览、技术栈、通用规则
├── src/
│   ├── CLAUDE.md          # 源码层:编码规范、目录结构说明
│   ├── api/
│   │   └── CLAUDE.md      # 模块层:API设计规范、错误处理策略
│   └── components/
│       └── CLAUDE.md      # 模块层:组件规范、样式约定
├── tests/
│   └── CLAUDE.md          # 测试层:测试策略、覆盖率要求
└── infra/
    └── CLAUDE.md          # 基础设施层:部署配置、环境变量
# Project: TaskFlow - 任务管理SaaS平台

## 技术栈
- Backend: Node.js 20 + Fastify + TypeScript
- Frontend: Next.js 14 (App Router) + Tailwind CSS
- Database: PostgreSQL 16 + Prisma ORM
- Auth: NextAuth.js v5
- Cache: Redis 7

## 项目结构
- `/src/api/` — RESTful API路由和业务逻辑
- `/src/web/` — Next.js前端应用
- `/src/shared/` — 共享类型定义和工具函数
- `/prisma/` — 数据库Schema和迁移
- `/tests/` — 测试文件(按模块镜像源码结构)

## 编码规范
- TypeScript strict mode,禁止any类型
- 函数必须有JSDoc注释(仅导出函数)
- API响应统一使用 `{ success: boolean; data?: T; error?: string }` 格式
- 组件使用函数式组件 + hooks,禁止class组件
- 提交信息遵循Conventional Commits规范

## 构建与测试命令
- `pnpm dev` — 启动开发服务器
- `pnpm build` — 生产构建
- `pnpm test` — 运行所有测试
- `pnpm test:e2e` — 端到端测试
- `pnpm lint` — 代码检查
- `pnpm db:migrate` — 执行数据库迁移

## 架构决策
- 采用Repository模式隔离数据访问层
- 使用CQRS分离读写操作(任务查询频率远高于写入)
- Redis缓存热点查询结果,TTL设置为5分钟

## 关键约束
- 所有API端点必须包含认证中间件
- 数据库查询禁止N+1问题
- 前端包体积预算:首屏JS < 100KB(gzip后)
- 禁止修改 `/prisma/migrations/` 中已执行的迁移文件
src/api/CLAUDE.md:
# API模块规范

## 路由定义
- 每个资源一个路由文件:`routes/users.ts`, `routes/tasks.ts`
- 路由注册在 `index.ts` 中统一管理
- 使用Fastify schema validation定义请求/响应格式

## 错误处理
- 业务错误使用自定义 `AppError` 类
- 全局错误handler统一格式化响应
- HTTP状态码规范:200成功、201创建、400参数错误、401未认证、403无权限、404不存在、500服务器错误

## 性能要求
- 列表API必须支持分页(默认每页20条)
- 所有数据库查询必须在100ms内完成(EXPLAIN ANALYZE验证)
为什么需要分层? 根据Anthropic官方的上下文工程建议,Claude Code会自动加载当前工作目录及其父级目录的CLAUDE.md。分层配置意味着当你在src/api/目录下工作时,Claude Code会同时获得全局规则和API模块的专属规则,而不会被前端组件规范污染上下文。
Claude Code对结构化需求的理解能力远优于模糊描述。以下是一个"用户故事"的工程化模板:
## Feature: 任务批量导入

### 用户故事
作为项目经理,我希望通过上传CSV文件批量创建任务,
以便快速初始化新项目的任务列表。

### 验收标准
1. 支持CSV格式(UTF-8编码,最大5MB)
2. CSV列映射:标题(必填)、描述(可选)、优先级(可选:高/中/低)、截止日期(可选)
3. 导入前显示预览(前10行),用户确认后执行
4. 部分失败不影响成功记录,返回失败明细
5. 导入完成后发送通知给项目负责人

### 技术约束
- 使用流式解析避免内存溢出(文件可能包含10万+行)
- 导入操作记录审计日志
- 导入频率限制:每用户每小时不超过10次
将上述需求文档保存为docs/features/batch-import.md,然后在Claude Code中执行:
claude "请阅读 docs/features/batch-import.md 和 CLAUDE.md,
       将这个Feature拆解为具体的开发任务列表,
       按照依赖关系排序,输出为Markdown格式的任务清单"
预期输出结构:
## 开发任务清单

### Phase 1: 数据层(预计3个任务)
- [ ] T1: Prisma Schema添加ImportJob模型(存储导入任务状态)
- [ ] T2: CSV解析服务(流式处理 + 列映射验证)
- [ ] T3: 批量导入事务处理(部分失败容忍)

### Phase 2: API层(预计2个任务)
- [ ] T4: POST /api/imports 上传接口(文件验证 + 创建ImportJob)
- [ ] T5: GET /api/imports/:id 预览接口(返回前10行解析结果 + 统计)
- [ ] T6: POST /api/imports/:id/confirm 确认执行接口

### Phase 3: 前端层(预计3个任务)
- [ ] T7: CSV上传组件(拖拽 + 进度条)
- [ ] T8: 预览表格组件(展示解析结果 + 错误高亮)
- [ ] T9: 导入结果反馈组件(成功/失败统计 + 失败明细下载)

### Phase 4: 横切关注点(预计2个任务)
- [ ] T10: 审计日志记录(导入操作追踪)
- [ ] T11: 频率限制中间件(每用户每小时10次)
将架构决策以ADR格式写入项目文档,Claude Code在后续开发中会参考这些决策:
<!-- docs/adr/001-repository-pattern.md -->
# ADR-001: 采用Repository模式

## 状态
已采纳

## 上下文
TaskFlow需要支持多种数据源(PostgreSQL主库 + Redis缓存)。
直接在业务逻辑中编写数据库查询会导致:
- 数据访问逻辑散布在各处
- 切换或增加数据源时改动面大
- 单元测试需要mock整个数据库

## 决策
采用Repository模式,每个聚合根对应一个Repository类。
Repository接口定义在domain层,实现在infrastructure层。

## 影响
- 新增数据表必须创建对应Repository
- 禁止在Service层直接使用Prisma Client
- 测试可通过Mock Repository隔离数据库依赖
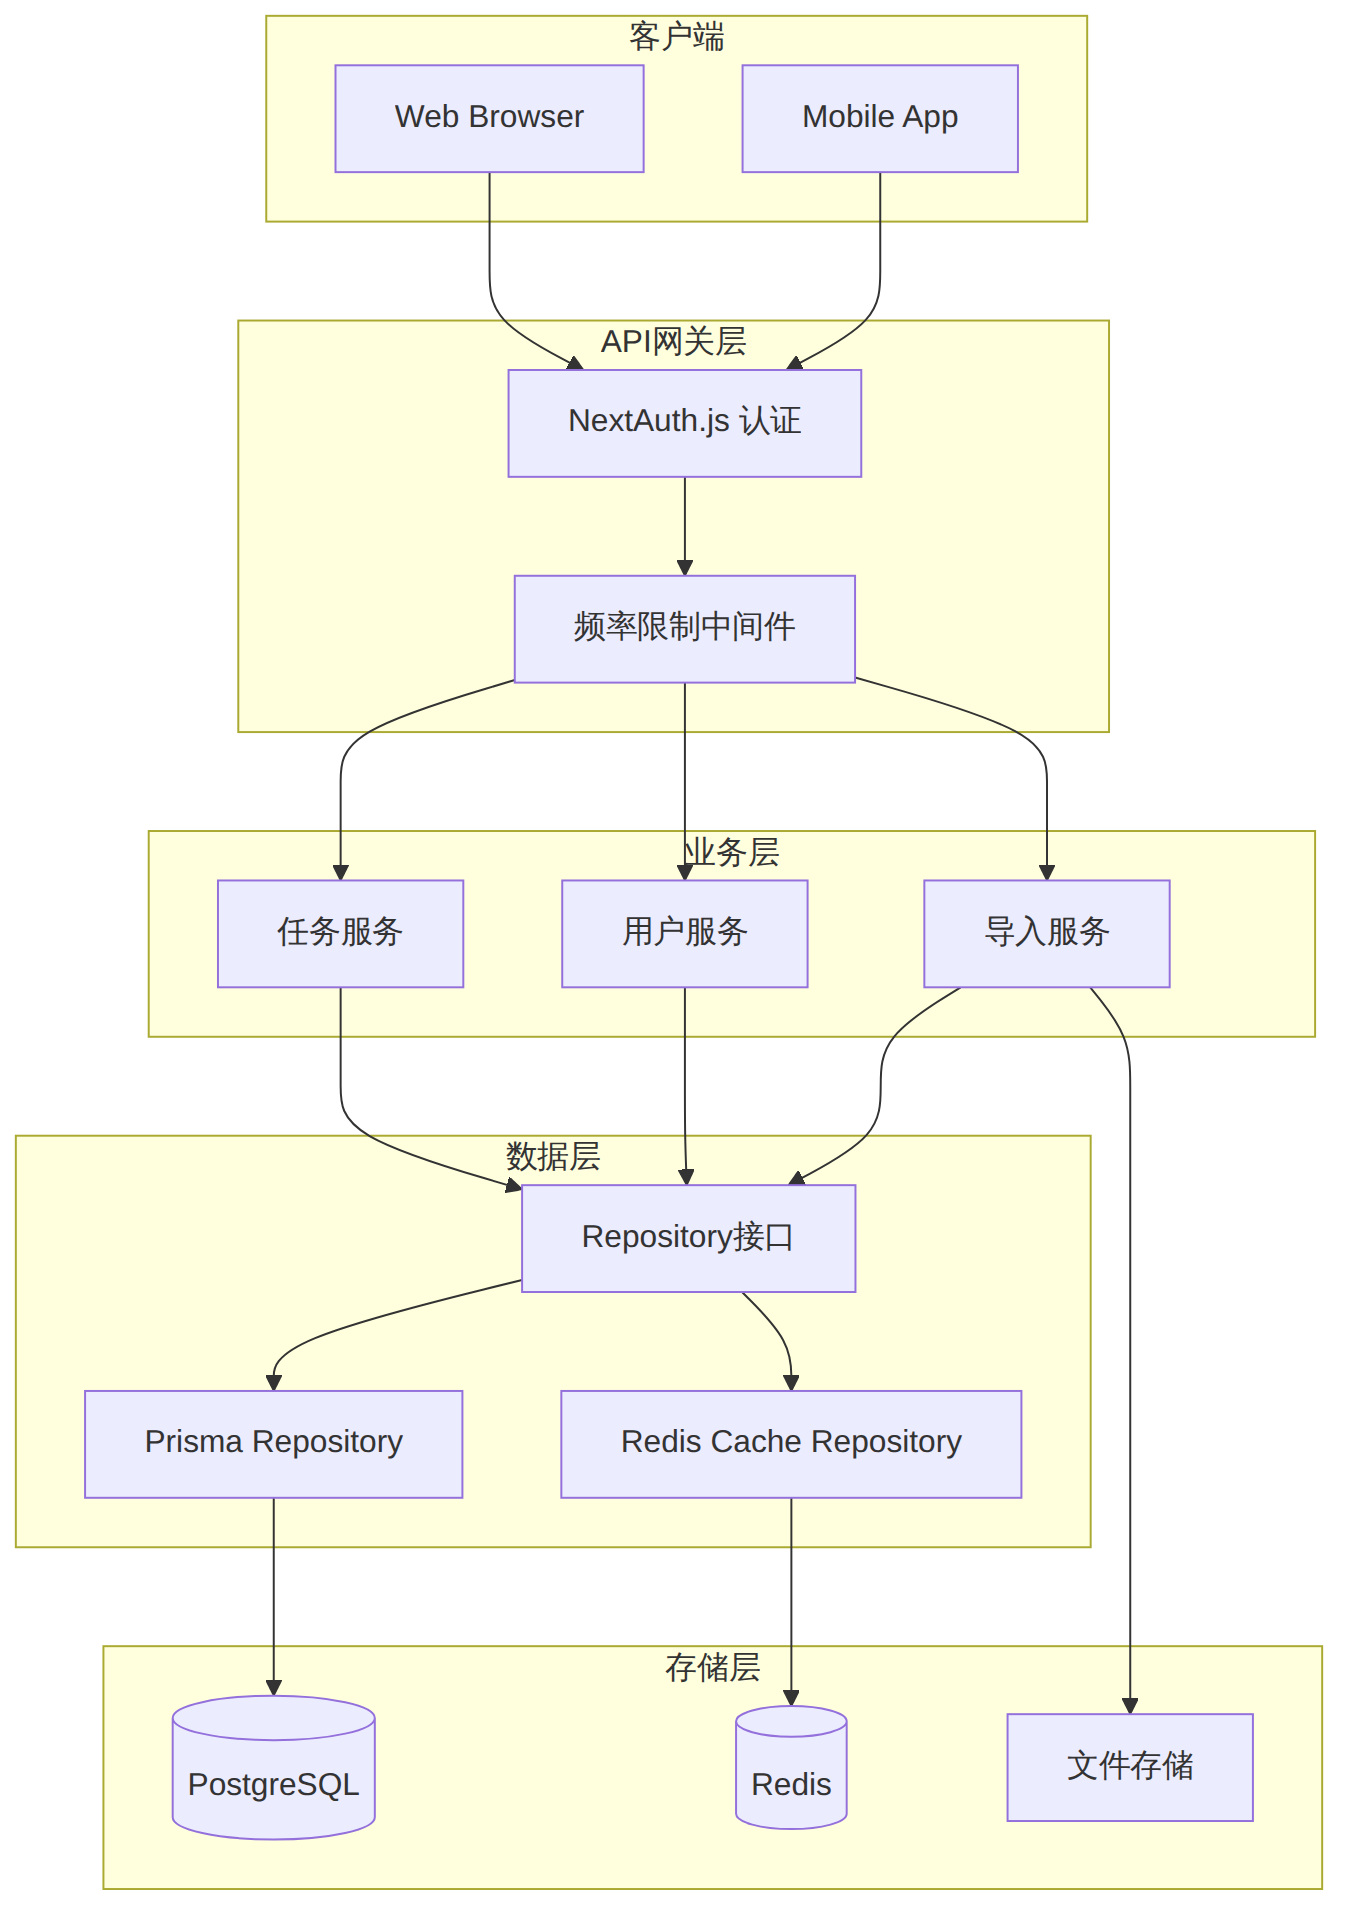
在Claude Code中使用Mermaid生成架构图,帮助你和AI对齐系统认知:
claude "根据CLAUDE.md和docs/adr/目录中的架构决策,
       生成TaskFlow的系统架构Mermaid图,
       包含数据流方向和关键组件之间的交互"
图表 2
这是工程化SDLC中最核心的环节。根据aiorg.dev对6个生产项目的最佳实践总结,"分阶段执行"(phased execution)是Claude Code最有效的开发模式。
核心原则:每次Claude Code会话只处理一个明确范围的任务。
# 错误做法:一次会话做太多事
claude "帮我实现用户注册、登录、任务创建、任务列表、批量导入这五个功能"

# 正确做法:分阶段、单任务
claude "实现用户注册API,参考 CLAUDE.md 中的API规范和 /src/api/CLAUDE.md"
根据Anthropic官方上下文工程指南,Claude Code的有效性更多取决于提供的上下文质量,而非prompt的措辞技巧。
# 低效:纯指令驱动
claude "写一个用户注册API"

# 高效:上下文驱动
claude "请阅读以下文件后实现用户注册API:
- CLAUDE.md(项目规范)
- src/api/CLAUDE.md(API模块规范)
- prisma/schema.prisma(数据模型)
- src/api/routes/users.ts(现有用户路由,新路由需保持一致风格)"
对于独立模块,使用Claude Code的Task工具启动并行子Agent是最高效的方式。根据Retriga Gazette的分析,子Agent在隔离的上下文窗口中运行,避免了"上下文腐烂"(context rot)问题。
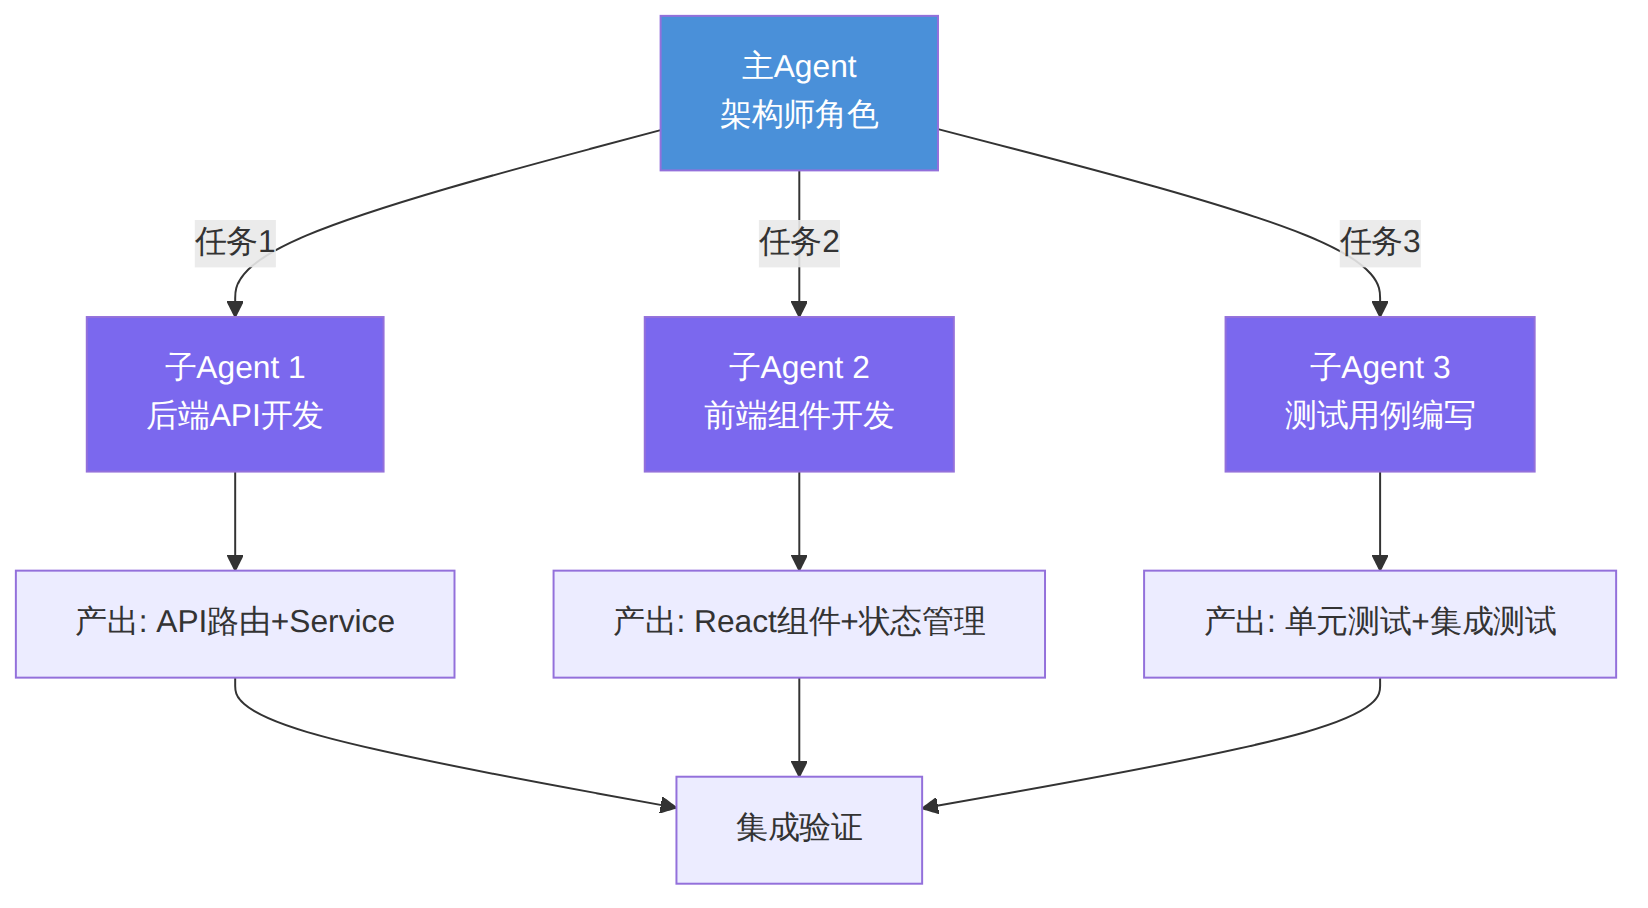
图表 3
实际操作流程:
步骤1:主Agent完成架构设计和接口定义
claude "基于CLAUDE.md和ADR-001,为任务管理模块设计:
1. TaskService接口定义
2. TaskRepository接口定义
3. API路由规范(RESTful)
输出到 docs/interfaces/task-module.ts"
步骤2:基于接口定义,启动并行开发
# 终端1:后端实现
claude "根据 docs/interfaces/task-module.ts 的接口定义,
       在 src/api/ 下实现TaskService和TaskRepository。
       遵循 src/api/CLAUDE.md 的规范,
       参考已有的 src/api/routes/users.ts 的代码风格"

# 终端2:前端实现(独立会话)
claude "根据 docs/interfaces/task-module.ts 的接口定义,
       在 src/web/components/tasks/ 下实现任务列表和创建组件。
       遵循 src/components/CLAUDE.md 的规范,
       使用Tailwind CSS,参考现有组件风格"

# 终端3:测试编写(独立会话)
claude "根据 docs/interfaces/task-module.ts 的接口定义,
       为TaskService和TaskRepository编写单元测试。
       遵循 tests/CLAUDE.md 的测试规范,
       覆盖正常流程、边界条件和错误场景"
根据Claude Code的架构设计,上下文窗口是有限资源。长时间开发会话中,需要主动管理上下文:
策略1:定期压缩
# 当会话变长时,执行压缩
/compact
/compact命令会触发Claude Code对当前会话上下文进行摘要压缩,保留关键信息,丢弃已处理的中间结果。
策略2:频繁提交
# 每完成一个独立功能点,立即提交
claude "将刚才完成的TaskService实现提交到git,
       使用feat(task)前缀的commit message"
策略3:文件级上下文引导
# 不让Claude Code自己搜索,直接指定关键文件
claude "实现任务分配功能。你需要阅读以下文件:
@src/api/services/task.service.ts — 现有任务服务
@src/api/repositories/task.repository.ts — 数据访问层
@prisma/schema.prisma — 数据模型
不要阅读其他文件,仅基于这些文件实现。"
在CLAUDE.md中定义测试策略后,Claude Code可以按照TDD模式工作:
# 第一步:定义测试
claude "根据 docs/features/batch-import.md 的验收标准,
       为CSV批量导入功能编写测试用例。
       参考 tests/CLAUDE.md 的测试规范。
       先写测试,不写实现。"

# 第二步:运行测试(应该全部失败)
claude "运行 pnpm test -- tests/services/import.test.ts,
       确认所有测试都按预期失败"

# 第三步:逐步实现
claude "运行 pnpm test -- tests/services/import.test.ts --watch,
       然后逐步实现 src/api/services/import.service.ts,
       每实现一个功能点观察测试通过情况"
        /\
       /  \
      / E2E \           ← 少量,Claude Code生成Playwright脚本
     /------\
    /集成测试 \          ← 适量,API级别测试
   /----------\
  /  单元测试   \        ← 大量,Service和Repository层测试
 /--------------\
在tests/CLAUDE.md中定义清晰的测试规范:
# 测试规范

## 测试框架
- 单元测试:Vitest + Testing Library
- API集成测试:Supertest + Vitest
- E2E测试:Playwright

## 命名规范
- 测试文件:`{source-file}.test.ts`
- describe块:使用 "当...时" 格式
- it块:使用 "应该..." 格式

## 覆盖率要求
- Service层:≥ 90%
- Repository层:≥ 80%
- API路由:≥ 70%
- 总体:≥ 80%

## Mock策略
- 单元测试:Mock Repository和外部依赖
- 集成测试:使用真实数据库(Docker测试容器)
- E2E测试:完整环境
Claude Code可以帮助生成和管理不同环境的配置:
claude "根据项目结构和CLAUDE.md中的技术栈,
       创建以下环境配置模板:
1. .env.example — 所有需要的环境变量列表(含注释说明)
2. docker-compose.yml — 本地开发环境(PostgreSQL + Redis)
3. docker-compose.prod.yml — 生产环境配置
4. .github/workflows/deploy.yml — 部署工作流(参考docs/adr/中的部署决策)"
用Claude Code执行生产就绪审查:
claude "对项目进行生产就绪审查,检查以下方面:
1. 所有TODO/FIXME是否已处理
2. console.log是否已清理
3. 错误处理是否完善(无unhandled rejection)
4. 环境变量是否都有fallback值
5. 数据库查询是否使用了参数化(防SQL注入)
6. API是否都有认证和频率限制
7. 前端是否有XSS防护
输出检查结果和修复建议"
| 项目属性 | 说明 |
|---|---|
| 名称 | TaskFlow |
| 类型 | SaaS任务管理平台 |
| 技术栈 | Next.js 14 + Fastify + PostgreSQL + Redis |
| 规模 | 约15个API端点、20个前端组件 |
| 开发方式 | 单开发者 + Claude Code |
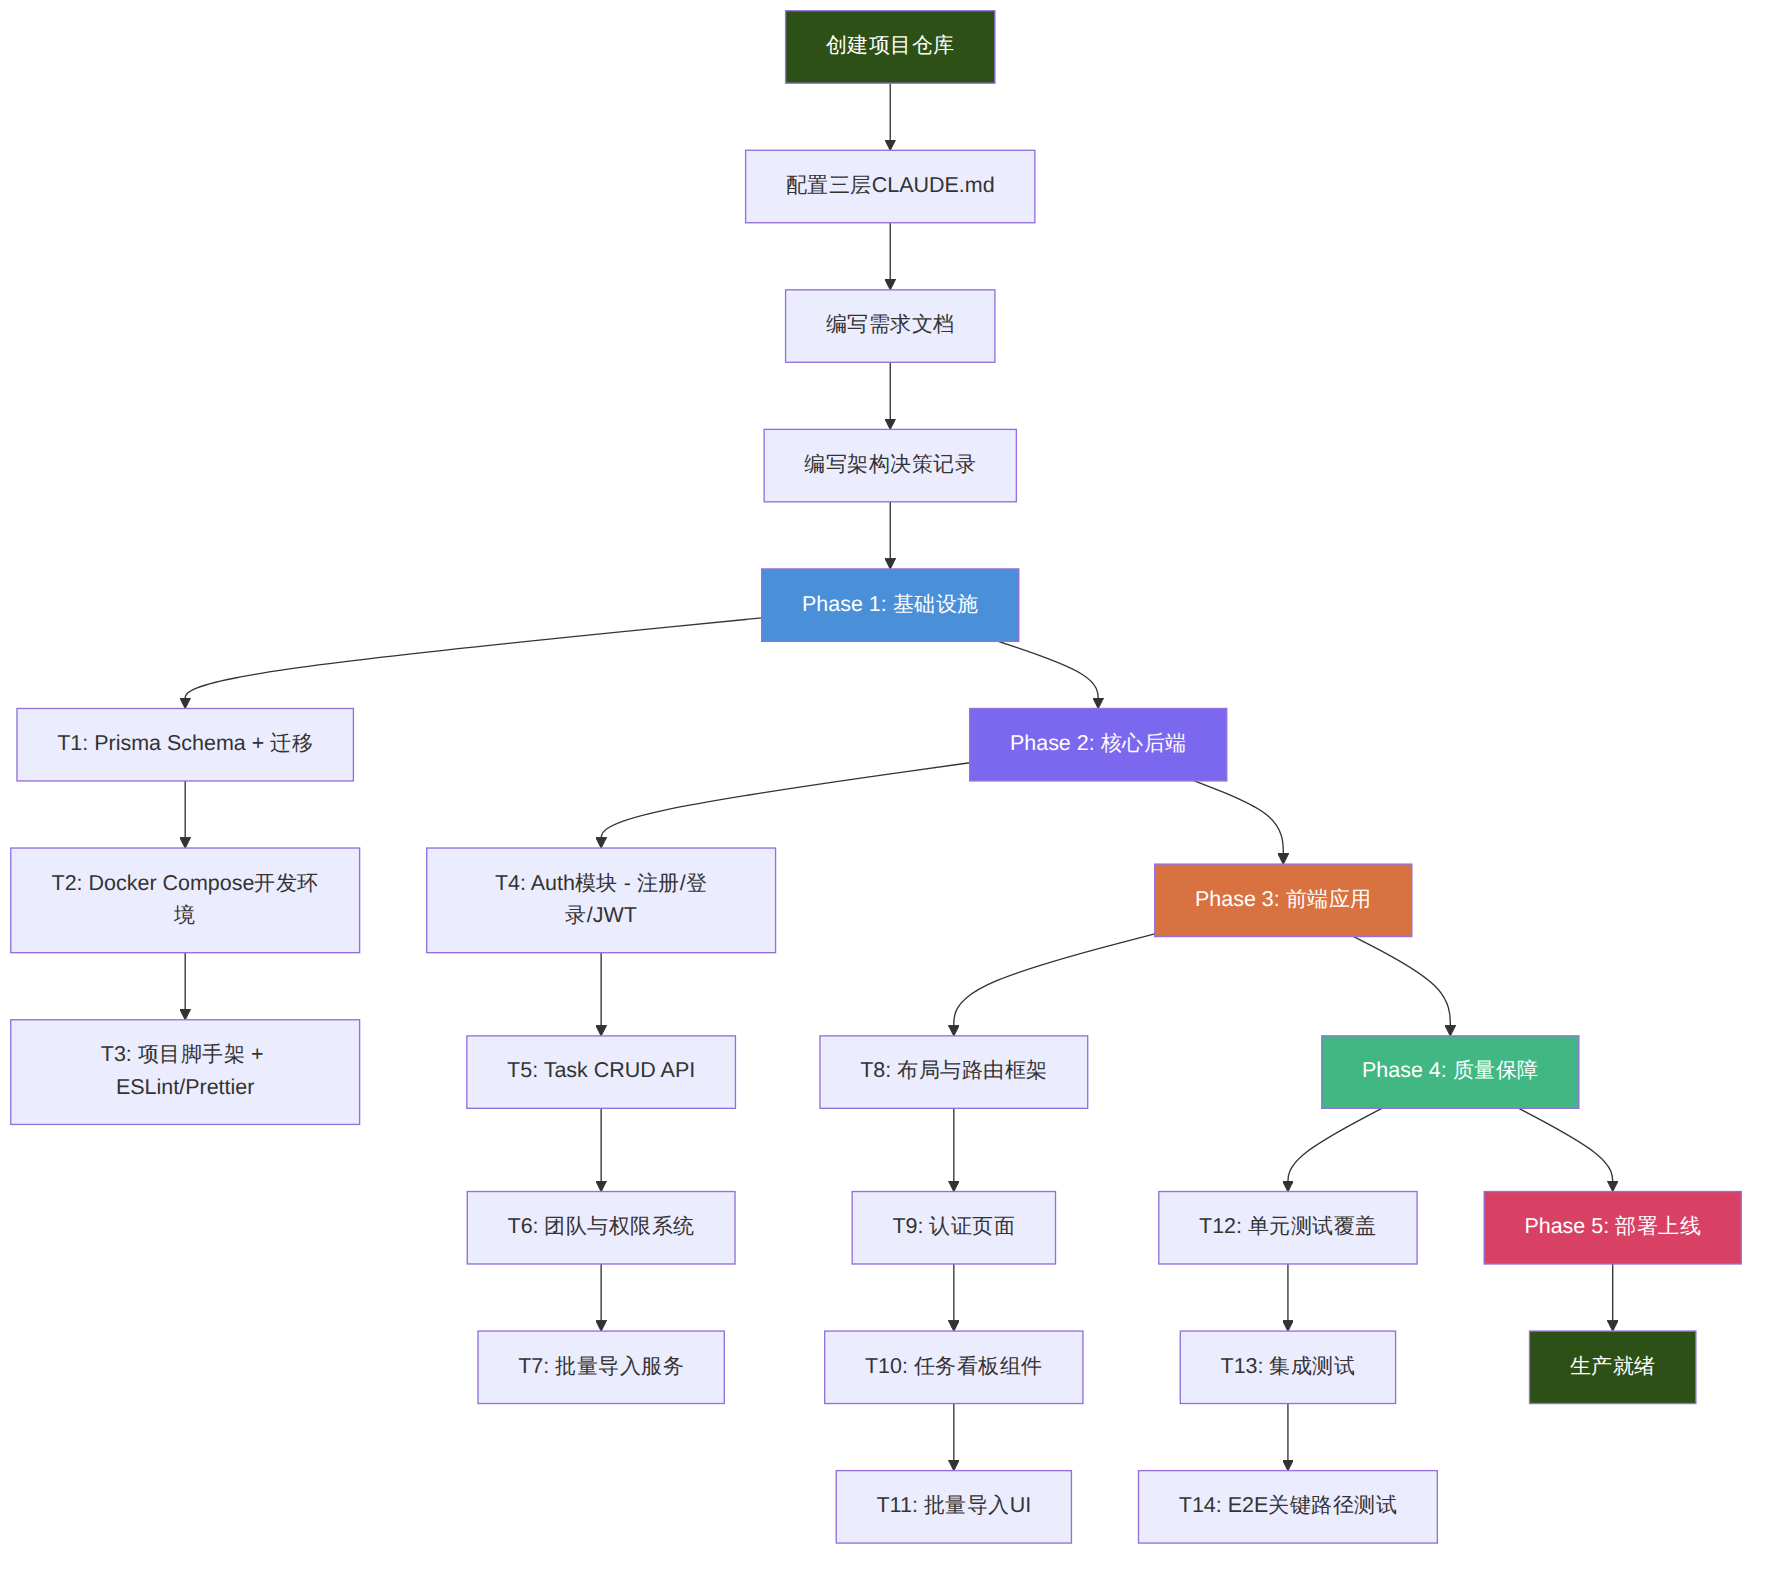
图表 4
# 步骤1:创建项目并初始化
mkdir taskflow && cd taskflow
git init
claude /init  # Claude Code自动分析目录并生成初始CLAUDE.md

# 步骤2:完善CLAUDE.md(参考前面章节的模板)
claude "根据我要构建的TaskFlow项目需求,
       完善CLAUDE.md文件,包含完整的技术栈说明、
       项目结构、编码规范和构建命令"

# 步骤3:生成基础设施代码
claude "基于CLAUDE.md中的技术栈,创建:
1. package.json(含所有依赖)
2. tsconfig.json(strict模式)
3. docker-compose.yml(PostgreSQL 16 + Redis 7)
4. Prisma初始Schema(User, Task, Team三个核心模型)
5. ESLint + Prettier配置"

# 步骤4:验证基础设施
docker compose up -d
pnpm install
pnpm db:migrate
pnpm dev  # 确认开发服务器正常启动
# 独立会话:专注Auth模块
claude "实现用户认证模块,包括:
1. POST /api/auth/register — 注册(邮箱+密码,密码bcrypt加密)
2. POST /api/auth/login — 登录(返回JWT)
3. GET /api/auth/me — 获取当前用户信息
4. auth中间件 — 验证JWT并注入用户信息到请求上下文

参考文件:
- CLAUDE.md(全局规范)
- src/api/CLAUDE.md(API模块规范)
- prisma/schema.prisma(User模型)
- docs/adr/001-repository-pattern.md(Repository模式)

要求:
- 使用Repository模式
- 先写测试再写实现
- 错误处理遵循API模块规范中的HTTP状态码约定"
Commit纪律:每完成一个任务点,使用Claude Code生成规范的commit:
claude "查看git diff,将当前改动拆分为逻辑清晰的多个commit。
每个commit遵循Conventional Commits:
- feat(scope): 新功能
- fix(scope): Bug修复
- refactor(scope): 重构
- test(scope): 测试
- docs(scope): 文档"
定期压缩与总结:每完成一个Phase后:
claude "总结Phase 2完成的所有工作,包括:
1. 新增的API端点列表
2. 数据模型变更
3. 待解决的技术债
4. 下一Phase的前置依赖
输出到 docs/phase-reports/phase-2.md"
基于6个生产项目的实战经验,提炼出15条核心实践:
| # | 实践 | 说明 |
|---|---|---|
| 1 | 创建CLAUDE.md | 最高优先级,单这一项就能显著提升输出质量 |
| 2 | 分层CLAUDE.md | 全局+模块级配置,避免无关上下文污染 |
| 3 | 定义明确命令 | 在CLAUDE.md中列出build/test/lint命令 |
| 4 | 记录架构决策 | ADR文档帮助Claude Code理解设计意图 |
| 5 | 使用.claudeignore | 排除node_modules、dist、.env等文件 |
| # | 实践 | 说明 |
|---|---|---|
| 6 | 单任务单会话 | 每次会话只做一件事,做完提交再开新会话 |
| 7 | 上下文优先 | 指定相关文件而非描述需求,让Claude Code读代码 |
| 8 | 分阶段执行 | 需求→架构→实现→测试→审查,逐层推进 |
| 9 | 频繁提交 | 每个功能点完成后立即提交,避免丢失进度 |
| 10 | 定期压缩 | 长会话中使用/compact管理上下文窗口 |
| # | 实践 | 说明 |
|---|---|---|
| 11 | TDD模式 | 先定义测试再实现,Claude Code可以同时生成两者 |
| 12 | 代码审查 | 完成后让Claude Code自我审查:"检查刚才生成的代码是否有安全隐患" |
| 13 | 一致性检查 | "对比新代码和现有代码风格是否一致" |
| 14 | 边界条件 | 明确要求处理空值、并发、大数据量等边界场景 |
| 15 | 生产就绪审查 | 部署前执行全面的检查清单 |
根因:CLAUDE.md中的编码规范不够具体。
解决:在模块级CLAUDE.md中添加代码示例:
## 代码风格参考
参考 src/api/routes/users.ts 的代码风格。
所有新API路由必须保持与其一致的结构:
1. 路由定义在文件顶部
2. Schema验证紧随路由定义
3. 业务逻辑调用Service方法
4. 错误处理统一使用try-catch + AppError
根因:上下文窗口溢出,早期信息被压缩或丢弃。
解决:
1. 使用/compact命令定期压缩
2. 将关键约束写入CLAUDE.md(持久化到文件而非仅存在会话记忆中)
3. 拆分为多个短会话,每个会话通过文件传递上下文
根因:多个Claude Code会话可能修改相同文件。
解决:
1. 使用Git分支隔离:每个模块一个feature分支
2. 在CLAUDE.md中明确文件归属:"任务模块的开发者只应修改 src/api/routes/tasks.ts 和 src/api/services/task.service.ts"
3. 定义清晰的接口契约(TypeScript interface),各模块通过接口解耦
根因:测试规范不够明确,或验收标准未转化为具体测试场景。
解决:在tests/CLAUDE.md中定义测试矩阵:
## 测试矩阵模板
每个API端点必须覆盖以下场景:
- 正常流程(happy path)
- 参数验证失败(缺少必填字段、类型错误、格式错误)
- 权限验证(未认证、无权限)
- 业务规则违反(重复创建、超过限制)
- 并发场景(乐观锁冲突)
- 边界值(空列表、最大值、特殊字符)
| 维度 | 评估 |
|---|---|
| 适合训练营类型 | 全栈开发训练营、AI辅助编程训练营、工程化实战训练营 |
| 学员基础要求 | 有至少一个完整项目经验,了解前后端分离架构 |
| 预计教学时长 | 6-8小时(含实操练习),建议分2天完成 |
| 实操占比 | 70%实操 + 30%理论 |
| 最佳分组方式 | 2-3人小组,每组选择不同项目类型进行实战 |
| 考核方式 | 提交使用Claude Code完成的项目仓库(含CLAUDE.md、ADR文档、测试覆盖报告) |
[!tip] 51学通信知识星球 星主:爱卫生(微信:gprshome201101)——公众号「51学通信」创办者,19 年通信行业运维与讲师经验,著有《GPRS网络信令实例详解》《EPC原理与实践》《5G核心网原理与实践》三本纸质书(各大电商平台有售)。 星球定位:深耕 5G 核心网、IMS、NFV/AI、云原生等 ICT 领域,主打运维岗位与信令分析。 当前规模:5200 篇主题 / 990 个回答,198 元/年。 加入福利:加入星球后请加爱卫生微信,拉您进知识星球年度陪伴与答疑群——不限量回复您的各种问题,另有群内分享。 AI 加持:51学通信知识星球已作为 skill 接入 WorkBuddy,使用 deepseek-4-flash 在海量星球帖子中精准找贴、找视频、找 FAQ 和案例,做总结、找文档和 PPT 等场景全覆盖。
