本教程深入解析Claude Code的六层记忆架构体系,覆盖从全局配置到自动记忆的完整技术栈。你将掌握CLAUDE.md多层文件体系、.claude/rules/模块化规则、@import语法、路径限定规则、Auto Memory自动学习系统,以及三者协同工作的工程最佳实践。适合已使用Claude Code至少一周、希望提升AI协作一致性和效率的中高级开发者。
npm install -g @anthropic-ai/claude-code)很多开发者把Claude Code当作"更聪明的搜索引擎"来用——每次会话重复解释技术栈、代码风格、架构约束。这是对Claude Code最大的浪费。
Claude Code的记忆系统本质是一套上下文注入协议:每次会话启动时,系统自动读取一组Markdown文件,将内容注入到Claude的上下文窗口中。这个过程发生在你输入第一条消息之前。
会话启动 → 加载记忆文件(全局/项目/规则) → 注入上下文 → Claude开始推理 → 用户发送第一条消息
关键认知:Claude的"记忆"不是数据库,不是持久化学习,而是每次重新阅读指令文本。这意味着记忆文件的质量直接决定了Claude的行为质量。简短、结构化、指令明确的文件远胜于冗长、描述性的文档。
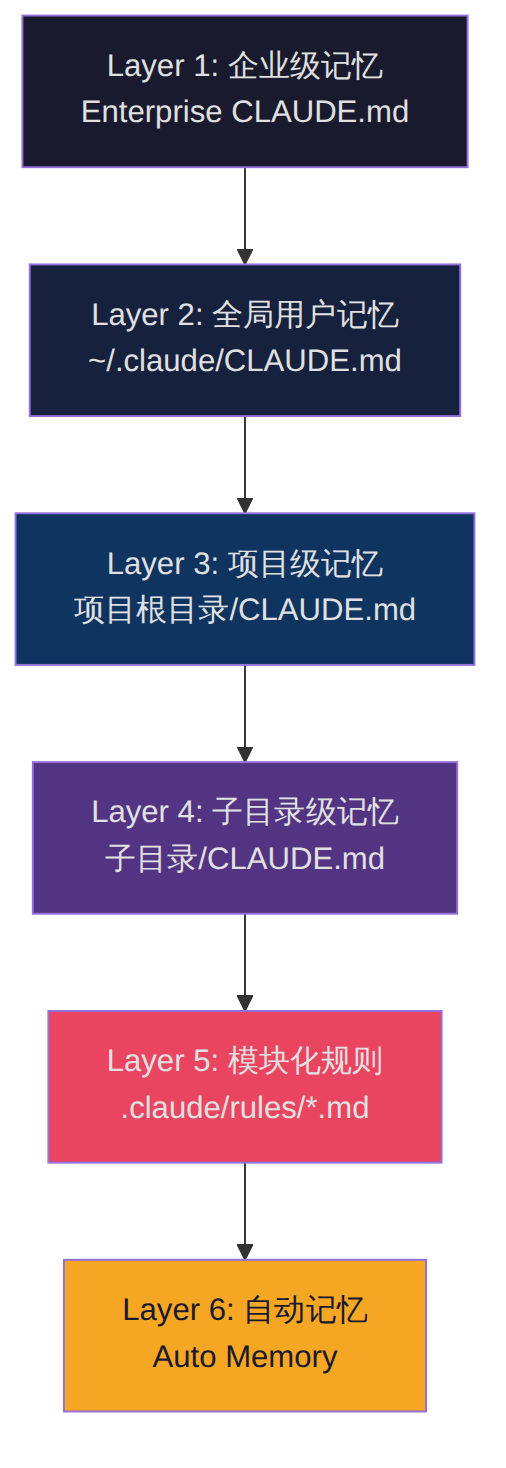
Claude Code目前提供六层记忆,每一层有不同的作用域、优先级和使用场景:
图表 1
文件位置:~/.claude/CLAUDE.md
这是你的个人全局配置,对所有项目生效。适合放跨项目通用的行为偏好,而非特定项目的技术细节。
# 全局偏好

## 语言与风格
- 默认使用中文回复,代码注释用英文
- 回复简洁明了,避免冗长解释

## 代码风格
- 优先使用 TypeScript,避免 any 类型
- 使用函数式编程风格,减少可变状态
- 变量命名使用 camelCase,常量使用 UPPER_SNAKE_CASE

## 通用规则
- 始终先读取文件再编辑,不要盲目修改
- 不要自动 commit,只在明确要求时执行
- 修改代码后主动运行测试验证
最佳实践:全局文件控制在50行以内。 全局记忆是"默认行为",项目记忆才是"具体规则"。如果全局文件超过100行,说明你在其中放了本应属于项目的内容。
部分企业部署支持企业级CLAUDE.md,由组织管理员统一配置,通常包含安全策略、合规要求等。个人用户无需关注这一层。
文件位置:项目根目录的CLAUDE.md
这是最核心的记忆文件,应提交到Git仓库,让整个团队共享。内容应聚焦于Claude如果不被告知就会猜错的信息。
# 项目指令

## 技术栈
- Node.js 22, TypeScript 5.4, PostgreSQL 16
- 使用 ESM 模块,不用 CommonJS
- ORM 使用 Drizzle,不用 Prisma
- 包管理器:pnpm

## 代码架构
- Controller 层:`/src/controllers/`
- Service 层:`/src/services/` — 所有业务逻辑在这里
- 禁止在 Controller 中直接写数据库查询
- 所有 API 响应使用统一格式 `{ code, data, message }`

## 测试
- 使用 Vitest,不用 Jest
- 测试文件放在源文件旁边:`*.test.ts`
- 每个 exported 函数至少一个单元测试
- Mock 所有外部 HTTP 调用

## Git 规范
- commit message 格式:`type(scope): description`
- 类型:feat, fix, refactor, test, docs, chore
在monorepo或大型项目中,不同模块可能有不同的技术栈和规范。子目录级记忆解决了这个问题。
my-monorepo/
├── CLAUDE.md              # 全项目通用规则
├── packages/
│   ├── frontend/
│   │   └── CLAUDE.md      # 前端专属规则
│   ├── backend/
│   │   └── CLAUDE.md      # 后端专属规则
│   └── shared/
│       └── CLAUDE.md      # 共享库规则
前端子目录示例 (packages/frontend/CLAUDE.md):
# 前端模块规则

## 框架与工具
- Next.js 15 App Router
- Tailwind CSS v4,禁止使用 inline style
- 状态管理使用 Zustand

## 组件规范
- 所有组件使用 `"use client"` 或 `"use server"` 显式标记
- Props 使用 TypeScript interface 定义
- 组件文件名使用 PascalCase
关键规则: 子目录记忆仅在操作该目录下的文件时加载。如果你让Claude修改packages/frontend/下的文件,Claude会同时加载根目录和前端子目录的规则。
文件位置:项目根目录的CLAUDE.local.md
与CLAUDE.md类似,但不提交到Git(应加入.gitignore)。用于存放个人偏好:
# 本地个人配置

- 我prefer详细的错误处理和日志
- 调试时使用 console.log 而非 debugger
- 优先使用 vim 键位操作的编辑器模式
.claude/rules/单个CLAUDE.md在小型项目中足够用。但当项目规模增长,把代码风格、测试规范、安全策略、架构约束全部塞进一个文件会导致:
解决方案是使用@import语法和.claude/rules/目录。
项目结构:
my-project/
├── CLAUDE.md                  # 入口文件,只做导入
├── .claude/
│   ├── code-style.md          # 代码风格规则
│   ├── architecture.md        # 架构规则
│   ├── testing.md             # 测试规范
│   └── security.md            # 安全策略
├── src/
└── tests/
入口文件 CLAUDE.md——变为简洁的目录索引:
# 项目指令

@.claude/code-style.md
@.claude/architecture.md
@.claude/testing.md
@.claude/security.md
代码风格规则 .claude/code-style.md:
# 代码风格

- TypeScript strict mode,零 any
- 使用 const 优先于 let,禁止 var
- 函数必须包含 JSDoc 注释
- 单文件不超过 300 行
- import 排序:内置模块 → 第三方 → 项目内部
安全策略 .claude/security.md:
# 安全规则

- 禁止日志输出敏感用户数据
- 所有用户输入必须验证和消毒
- SQL 查询必须使用参数化,禁止字符串拼接
- 密钥只从环境变量读取,永远不硬编码
- API 接口必须实现 rate limiting
这是Claude Code最精细的记忆控制机制。你可以让规则仅在对特定路径的文件操作时生效。
在.claude/rules/下创建的规则文件,可以通过YAML frontmatter的paths:字段限定作用范围:
.claude/rules/python-testing.md:
---
paths:
  - "tests/**/*.py"
  - "test_*.py"
---

# Python 测试规范

- 使用 pytest,不用 unittest
- 测试函数名以 `test_` 开头
- 使用 `@pytest.fixture` 管理测试依赖
- Mock 使用 `unittest.mock.patch`
.claude/rules/frontend-components.md:
---
paths:
  - "src/components/**/*.tsx"
  - "src/app/**/*.tsx"
---

# 前端组件规范

- 使用 Server Components 为默认
- 只有需要交互的组件才标记 `"use client"`
- Props 通过 interface 定义,导出类型
- 使用 `cn()` 工具函数合并 Tailwind 类名
当Claude编辑tests/test_auth.py时,它会加载python-testing.md;当编辑src/components/Button.tsx时,加载frontend-components.md。两者不会互相干扰。
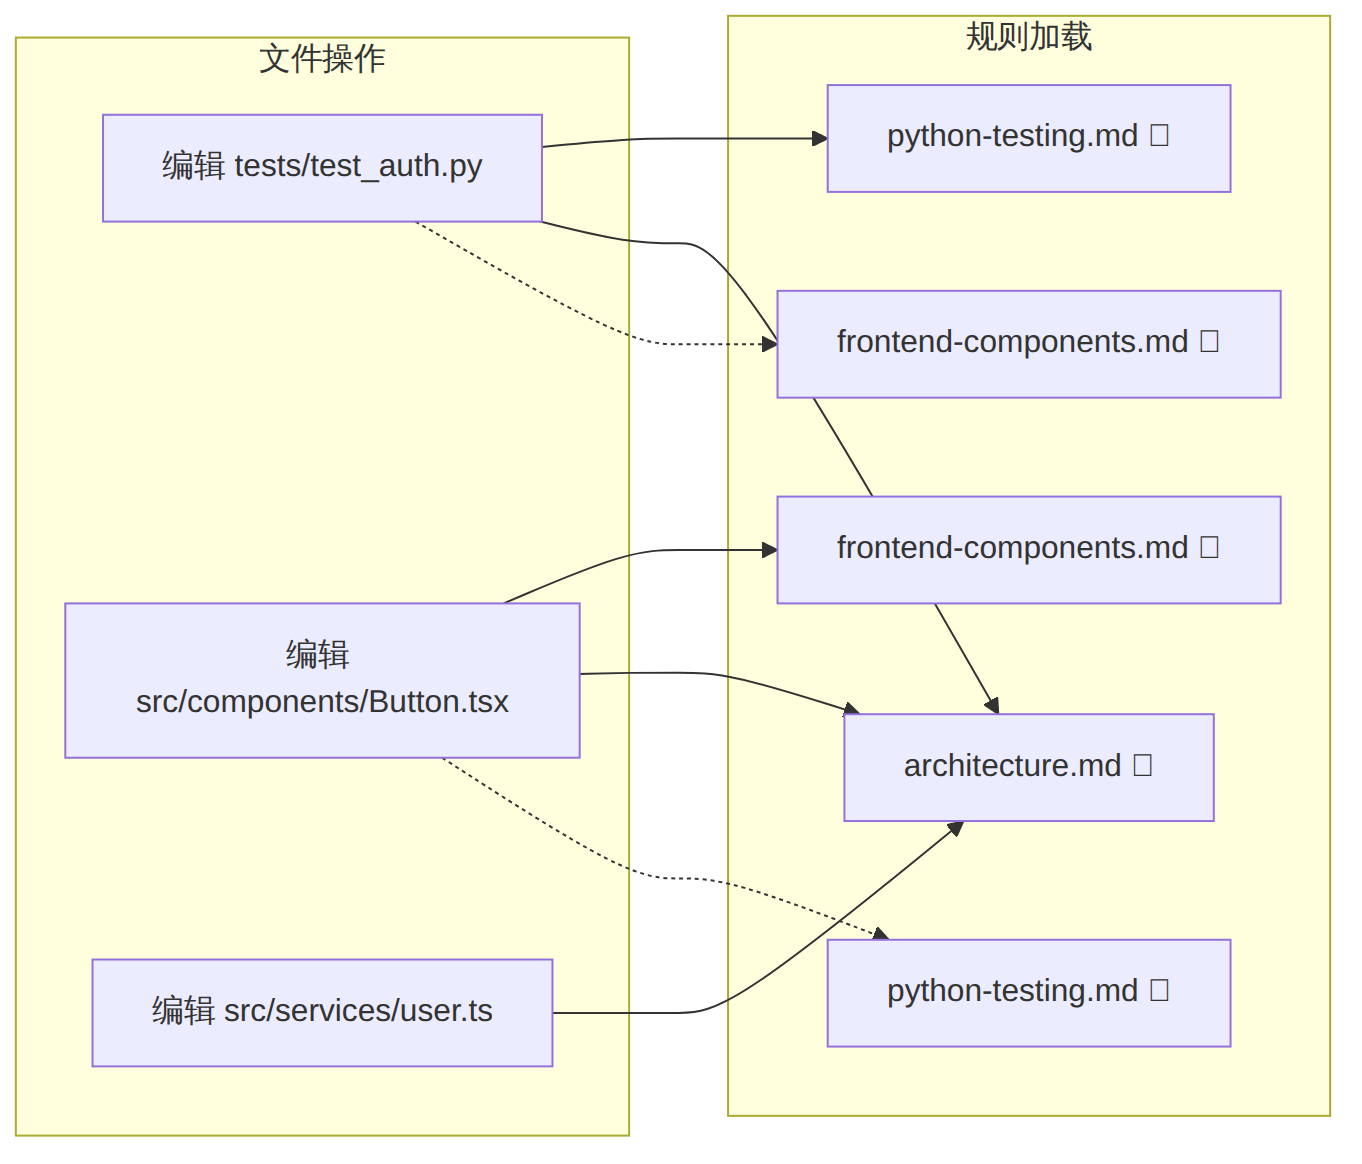
图表 2
Auto Memory是Claude Code的第三大记忆子系统。与CLAUDE.md(你写给Claude的指令)不同,Auto Memory是Claude自己写的项目笔记。
存储位置:~/.claude/projects/<project>/memory/
~/.claude/projects/my-project/memory/
├── MEMORY.md              # 主索引文件,每次会话加载前200行
├── debugging.md           # 调试经验记录
├── api-conventions.md     # API设计决策
└── patterns.md            # 代码模式记录
| 维度 | CLAUDE.md | Auto Memory | Session Memory |
|---|---|---|---|
| 谁来写 | 你(开发者) | Claude自动 | Claude自动 |
| 内容 | 指令和规则 | 项目模式和经验 | 对话摘要 |
| 作用域 | 项目级或全局 | 项目级 | 会话级 |
| 启动加载 | 完整文件 | MEMORY.md前200行 | 相关历史会话 |
| 优先级 | 高(视为指令) | 背景参考 | 背景参考 |
| 团队共享 | 是(通过Git) | 否(仅本地) | 否(仅本地) |
| 最佳用途 | 标准和约束 | 构建模式、调试经验 | 跨会话连续性 |
Auto Memory默认开启。Claude在会话中工作时,会在后台自动记录以下类型的知识:
你也可以主动告诉Claude记住特定内容:
> 记住我们使用 pnpm 而不是 npm
> 保存到记忆:API 测试需要本地 Redis 实例
> 记录:staging 环境使用端口 3001
MEMORY.md是自动记忆的主索引文件。Claude会自动维护它,保持在前200行以内(因为启动时只加载前200行)。当内容增长时,Claude会把详细笔记拆分到独立的主题文件中。
MEMORY.md示例:
# Project Memory

## Build & Run
- Build: `pnpm build`
- Dev server: `pnpm dev` (port 3000)
- Tests: `pnpm test` (Vitest)
- Lint: `pnpm lint`

## Architecture
- Express + TypeScript backend
- PostgreSQL via Drizzle ORM
- Auth: JWT with refresh token rotation
- API prefix: `/api/v1/`

## Common Issues
- DB migrations: `pnpm db:migrate` before testing
- CORS: frontend must be on localhost:5173
- See debugging.md for resolved issues
查看和编辑:在会话中运行/memory命令,会显示所有记忆文件的列表,可选择打开编辑。
手动浏览:
# 列出所有项目的记忆文件
ls ~/.claude/projects/

# 查看特定项目的主记忆文件
cat ~/.claude/projects/my-project/memory/MEMORY.md

# 查看特定主题文件
cat ~/.claude/projects/my-project/memory/debugging.md
关闭Auto Memory:
全局关闭(影响所有项目):
// ~/.claude/settings.json
{
  "autoMemoryEnabled": false
}
单项目关闭:
// .claude/settings.json
{
  "autoMemoryEnabled": false
}
会话内临时切换:运行/memory,使用auto-memory开关。
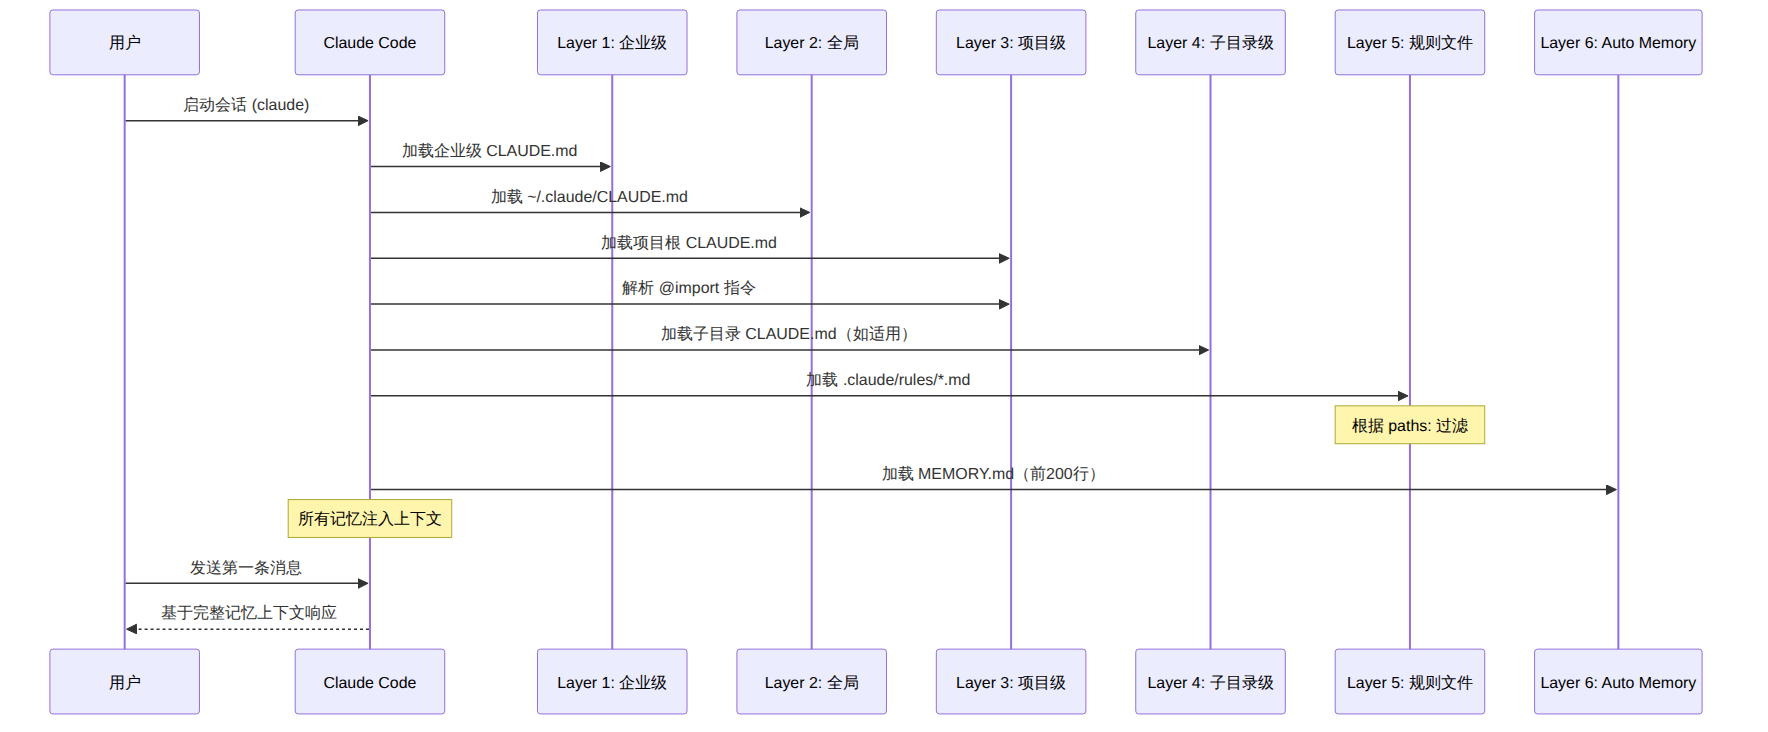
图表 3
项目背景:一个Express + React全栈应用,包含API服务、前端SPA和数据库迁移。
最终文件结构:
fullstack-app/
├── CLAUDE.md                        # 入口:导入所有规则
├── CLAUDE.local.md                  # 本地个人偏好
├── .claude/
│   ├── settings.json                # 项目设置
│   └── rules/
│       ├── api-design.md            # API设计规范(通用)
│       ├── react-components.md      # React组件规范
│       ├── database.md              # 数据库操作规范
│       ├── python-scripts.md        # Python脚本规范
│       └── deployment.md            # 部署相关规范
├── packages/
│   ├── api/
│   │   └── CLAUDE.md               # API模块专属规则
│   └── web/
│       └── CLAUDE.md               # 前端模块专属规则
└── scripts/
根目录 CLAUDE.md(入口文件):
# Fullstack App 项目指令

## 技术栈
- Monorepo: pnpm workspaces
- API: Express 5 + TypeScript + Drizzle ORM
- Frontend: React 19 + Vite + Tailwind CSS v4
- Database: PostgreSQL 16

## 通用规则
- 所有代码使用 TypeScript strict mode
- 包管理器:pnpm(禁止 npm 或 yarn)
- 测试框架:Vitest
- commit message: conventional commits

@.claude/rules/api-design.md
@.claude/rules/database.md
@.claude/rules/deployment.md
路径限定规则 .claude/rules/react-components.md:
---
paths:
  - "packages/web/src/**/*.tsx"
  - "packages/web/src/**/*.ts"
---
# React 组件规范

- 使用函数组件 + Hooks,禁止 class 组件
- Props 使用 interface 定义并导出
- 状态管理:组件内用 useState,跨组件用 Zustand
- 样式:Tailwind CSS,禁止 inline style
- 组件拆分粒度:单文件不超过 200 行
路径限定规则 .claude/rules/python-scripts.md:
---
paths:
  - "scripts/**/*.py"
---
# Python 脚本规范

- Python 3.12+
- 使用 uv 管理依赖
- 类型注解:所有函数参数和返回值
- 日志使用 logging 模块,不用 print
API模块子目录记忆 packages/api/CLAUDE.md:
# API 模块规则

## 目录结构
- `routes/` — 路由定义
- `controllers/` — 请求处理
- `services/` — 业务逻辑(核心)
- `repositories/` — 数据库操作
- `middleware/` — 中间件

## API 设计
- RESTful 风格
- 统一响应格式:`{ code: number, data: T, message: string }`
- 错误处理:使用自定义 AppError 类
- 验证:Zod schema 验证所有输入
在任何会话中运行/memory命令,Claude Code会显示当前会话加载的所有记忆文件:
> /memory

📋 Memory Files Loaded:
  ✅ ~/.claude/CLAUDE.md (Global)
  ✅ ~/projects/fullstack-app/CLAUDE.md (Project)
  ✅ .claude/rules/api-design.md (Rule)
  ✅ .claude/rules/database.md (Rule)
  ✅ packages/api/CLAUDE.md (Directory)
  ✅ Auto Memory: MEMORY.md (200 lines loaded)

🔄 Auto Memory: ON
应该写(Claude如果不被告知就会猜错的内容): - 技术栈版本和工具选择("用Vitest不用Jest") - 项目特定的架构约束("Service层不含数据库查询") - 非显而易见的约定("API响应统一格式") - 常见陷阱和注意事项("migration前必须备份数据")
不应该写(Claude本身就知道的内容): - 编程语言的基础语法 - 通用设计模式的定义 - 冗长的项目背景故事 - 语气和性格描述(Claude不需要"你是一个资深开发者"这类提示)
# ✅ 好的规则写法
- 使用 Vitest,不用 Jest
- 测试文件放在源文件旁边:`*.test.ts`
- 每个 exported 函数至少一个单元测试

# ❌ 差的规则写法
- 在这个项目中,我们团队经过讨论决定采用Vitest作为我们的测试框架,
  因为它比Jest更快,而且对ESM有更好的支持。我们希望所有的测试文件
  都能放在对应的源文件旁边...
原则:bullet points胜过段落,祈使句胜过陈述句。
记忆文件会占用上下文窗口的token。Claude Code的上下文窗口虽大(200K tokens),但记忆只是其中一部分——还需要留给对话历史、代码读取、工具调用结果。
推荐预算分配:
| 记忆层 | 建议行数 | 约Token数 |
|---|---|---|
| 全局 CLAUDE.md | ≤50行 | ~500 |
| 项目 CLAUDE.md(入口) | ≤30行 | ~300 |
| 每个规则文件 | ≤40行 | ~400 |
| 子目录 CLAUDE.md | ≤30行 | ~300 |
| 总计 | ≤200行 | ~2000 |
当规则文件总token数超过5000时,考虑: 1. 合并相关规则减少文件数 2. 删除冗余和显而易见的规则 3. 使用路径限定规则,避免每次加载所有规则
# .gitignore
CLAUDE.local.md        # 个人本地偏好,不提交
.claude/settings.local.json  # 本地设置,不提交

# 以下应该提交到Git
# CLAUDE.md
# .claude/rules/*.md
# .claude/settings.json(项目级设置)
团队协作时,把CLAUDE.md和.claude/rules/纳入Code Review流程。规则文件的变更应该像代码变更一样被审查。
Auto Memory会随时间积累过时信息。建议每月执行一次记忆审计:
# 查看所有项目记忆
ls -la ~/.claude/projects/

# 查看特定项目的记忆文件
find ~/.claude/projects/my-project/memory/ -name "*.md" -exec wc -l {} +

# 查看总行数
wc -l ~/.claude/projects/my-project/memory/MEMORY.md
审计清单: - MEMORY.md是否超过200行?如果是,需要拆分主题 - 是否有过时的调试经验?项目重构后旧笔记可能失效 - Claude是否重复犯同样的错误?如果是,在CLAUDE.md中添加明确规则 - 路径限定规则的路径是否仍然正确?
问题:全局CLAUDE.md说"使用Jest",项目级说"使用Vitest"。
解决:更具体的层级自动覆盖更宽泛的层级。优先级顺序为:路径限定规则 > 子目录 > 项目级 > 全局级。但最好避免冲突——全局文件只放真正跨项目通用的规则。
问题:CLAUDE.md写到了500行,Claude经常忽略后半部分的规则。
解决:使用@import拆分为多个文件。确保每个文件不超过50行。最关键的规则放在文件开头。
问题:在CLAUDE.md中写"我们的项目是一个大型电商平台..."这种背景描述。
解决:Claude可以通过读取代码了解项目背景。CLAUDE.md只写约束和指令——Claude需要遵守但无法从代码推断的规则。
问题:把重要的架构决策交给Auto Memory,但这些内容只存在本地,团队成员无法共享。
解决:Auto Memory适合记录调试经验和构建模式。重要的团队级决策必须写入CLAUDE.md或规则文件并提交到Git。
问题:把所有规则塞进CLAUDE.md,包括只针对特定文件类型的规则。
解决:使用.claude/rules/配合paths: frontmatter。这样Claude只会在操作相关文件时加载对应规则,减少token浪费和规则干扰。
以下是完整的初始化步骤,适用于任何新项目:
# Step 1: 创建项目级 CLAUDE.md
cat > CLAUDE.md << 'EOF'
# 项目指令

## 技术栈
- [填写你的技术栈]

## 架构
- [填写关键架构决策]

## 规范
- [填写代码规范]

@.claude/rules/security.md
@.claude/rules/testing.md
EOF

# Step 2: 创建规则目录和文件
mkdir -p .claude/rules

cat > .claude/rules/security.md << 'EOF'
# 安全规则
- 所有用户输入必须验证
- SQL 使用参数化查询
- 密钥从环境变量读取
- 禁止日志输出敏感数据
EOF

cat > .claude/rules/testing.md << 'EOF'
---
paths:
  - "tests/**"
  - "**/*.test.ts"
  - "**/*.test.py"
---

# 测试规范
- 每个 exported 函数至少一个测试
- Mock 所有外部依赖
- 测试命名:should_预期行为_when_条件
EOF

# Step 3: 配置 .gitignore
echo "CLAUDE.local.md" >> .gitignore
echo ".claude/settings.local.json" >> .gitignore

# Step 4: 验证记忆加载
claude
# 在Claude Code会话中输入:
# /memory
# 确认所有文件被正确加载
预期输出(/memory命令):
📋 Memory Files:
  ✅ ~/.claude/CLAUDE.md (Global, 23 lines)
  ✅ ./CLAUDE.md (Project, 15 lines)
  ✅ .claude/rules/security.md (Rule, 4 lines)
  ✅ .claude/rules/testing.md (Rule, conditional)
  ✅ Auto Memory: enabled
如果你经常创建同类型项目(比如多个Express API),可以把通用规则放在全局记忆中,然后按需覆盖:
# ~/.claude/CLAUDE.md
## 通用 API 项目规则
- TypeScript strict mode
- Vitest for testing
- Conventional commits
- Error handling: custom error classes
新项目只需创建项目级CLAUDE.md覆盖差异部分。
Claude Code Skills(技能系统)与记忆系统是互补的: - 记忆告诉Claude"做什么"(规则和约束) - Skills告诉Claude"怎么做"(具体的工作流程和步骤)
当两者结合时效果最强。比如你有一个TDD skill指导测试驱动开发流程,记忆系统告诉Claude项目使用Vitest和什么测试结构。
当Claude Code启动子Agent(Task工具)处理子任务时,子Agent也会继承项目的记忆文件。这意味着你可以通过.claude/rules/中的规则来约束所有Agent的行为——比如禁止子Agent删除文件或修改配置文件:
---
paths:
  - "**"
---

# Agent 约束
- 禁止删除任何文件(必须经用户确认)
- 禁止修改 .env 文件
- 禁止执行 git push 或 git reset --hard
- 每次文件修改不超过 5 个文件时需报告
| 维度 | 评估 |
|---|---|
| 适合训练营类型 | Claude Code进阶训练营、AI辅助开发工作坊、团队工程效能提升 |
| 前置要求 | 已完成Claude Code基础使用(至少1周经验) |
| 预计教学时长 | 理论讲解45分钟 + 动手实践60分钟 + 讨论答疑15分钟 = 共120分钟 |
| 实操难度 | 中等(概念清晰,但需要实际项目才能体会差异) |
| 核心产出 | 学员为自己的项目搭建完整的六层记忆架构 |
[!tip] 51学通信知识星球 星主:爱卫生(微信:gprshome201101)——公众号「51学通信」创办者,19 年通信行业运维与讲师经验,著有《GPRS网络信令实例详解》《EPC原理与实践》《5G核心网原理与实践》三本纸质书(各大电商平台有售)。 星球定位:深耕 5G 核心网、IMS、NFV/AI、云原生等 ICT 领域,主打运维岗位与信令分析。 当前规模:5200 篇主题 / 990 个回答,198 元/年。 加入福利:加入星球后请加爱卫生微信,拉您进知识星球年度陪伴与答疑群——不限量回复您的各种问题,另有群内分享。 AI 加持:51学通信知识星球已作为 skill 接入 WorkBuddy,使用 deepseek-4-flash 在海量星球帖子中精准找贴、找视频、找 FAQ 和案例,做总结、找文档和 PPT 等场景全覆盖。
