本教程深入剖析 Claude Code 的完整计费体系——从 API 按量计费到 Max 订阅模式的真实成本结构,从单开发者日常消耗到企业级百人团队的预算规划。你将学会用数据驱动的方式管理 Token 开销,掌握经过实战验证的省钱策略,并建立可持续的成本监控体系。适合已经在使用 Claude Code 并希望优化投入产出比的开发者和技术管理者。
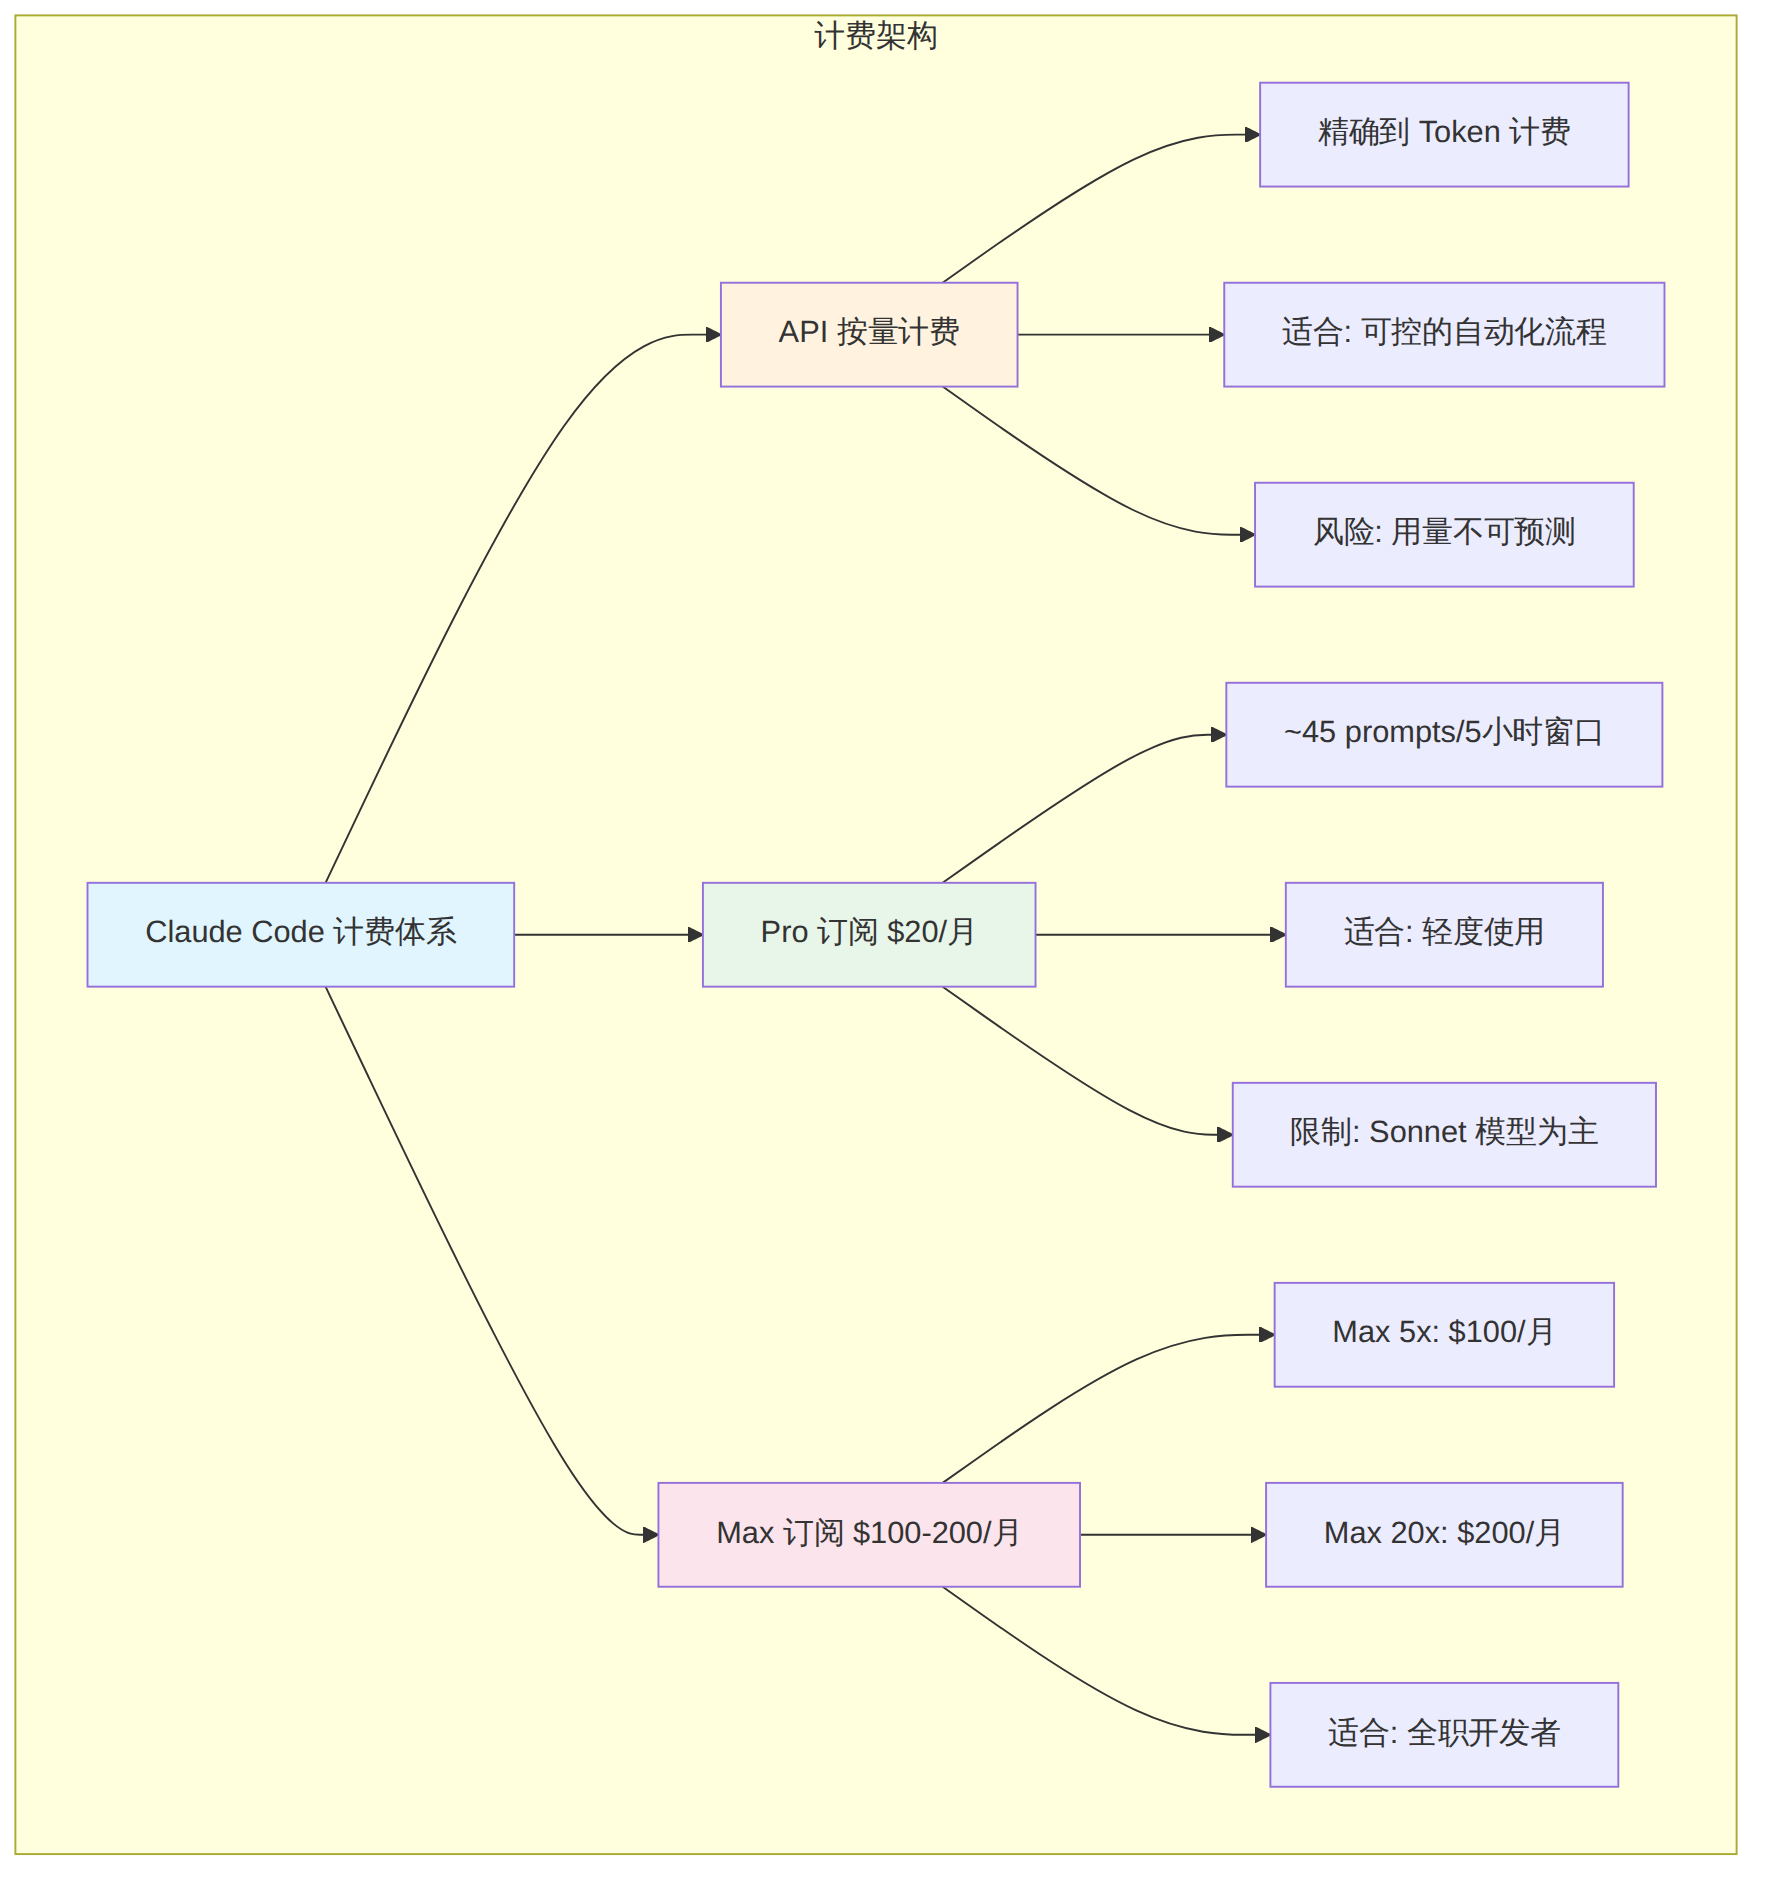
Claude Code 的成本并不像表面看起来那么简单。它存在三种截然不同的计费路径,每种路径适合不同的使用场景和团队规模。
图表 1
当你在终端运行 claude 并选择 API 模式时,你的每一次交互都精确计费。以下是 2026 年 5 月的最新定价:
| 模型 | 输入价格(每百万 Token) | 输出价格(每百万 Token) | 上下文窗口 | 典型场景 |
|---|---|---|---|---|
| Claude Opus 4.7 | $5.00 | $25.00 | 200K | 复杂架构设计、代码审查 |
| Claude Sonnet 4.6 | $3.00 | $15.00 | 200K | 日常编码、调试 |
| Claude Haiku 4.5 | $1.00 | $5.00 | 200K | 快速问答、简单生成 |
关键洞察:输出 Token 的价格是输入的 5 倍。这意味着,让 Claude 输出大段代码比让它阅读代码贵得多。一个简单的实战推演:
场景:让 Claude Code 重构一个 2000 行的 Python 文件

输入消耗:~30,000 tokens(读取文件 + 系统提示 + CLAUDE.md)
输出消耗:~50,000 tokens(生成重构后的代码 + 解释)

Sonnet 成本:(30K × $3 + 50K × $15) / 1M = $0.84
Opus 成本:(30K × $5 + 50K × $25) / 1M = $1.40

一次会话中如果进行 5 轮迭代:Sonnet $4.20,Opus $7.00
Pro 计划定价 $20/月,提供有限但够用的使用额度。其核心限制在于滑动窗口速率控制——大约每 5 小时可发送 45 条提示。这对以下情况够用:
但 Pro 的隐性成本在于时间。当你遇到速率限制时,等待窗口重置本身就是一种浪费。
Max 计划分为两档,这是目前 Claude Code 最受欢迎的使用方式:
| 特性 | Max 5x($100/月) | Max 20x($200/月) |
|---|---|---|
| 使用量倍率 | Pro 的 5 倍 | Pro 的 20 倍 |
| 约等于 | ~225 prompts/5小时 | ~900 prompts/5小时 |
| 上下文窗口 | 200K | 200K |
| 适合场景 | 中度到重度使用 | 全职 AI 辅助开发 |
| Claude Code 共享 | 支持 | 支持 |
Anthropic 官方数据表明:企业部署中,Claude Code 的平均成本约为每位活跃开发者每天 $13,月均 $150-$200(基于 Sonnet 4.6)。这个数字在 2025 年初还被标为 $6/天,后来悄悄翻倍——因为实际使用中,开发者往往会进行多轮对话、多次文件读取和迭代。
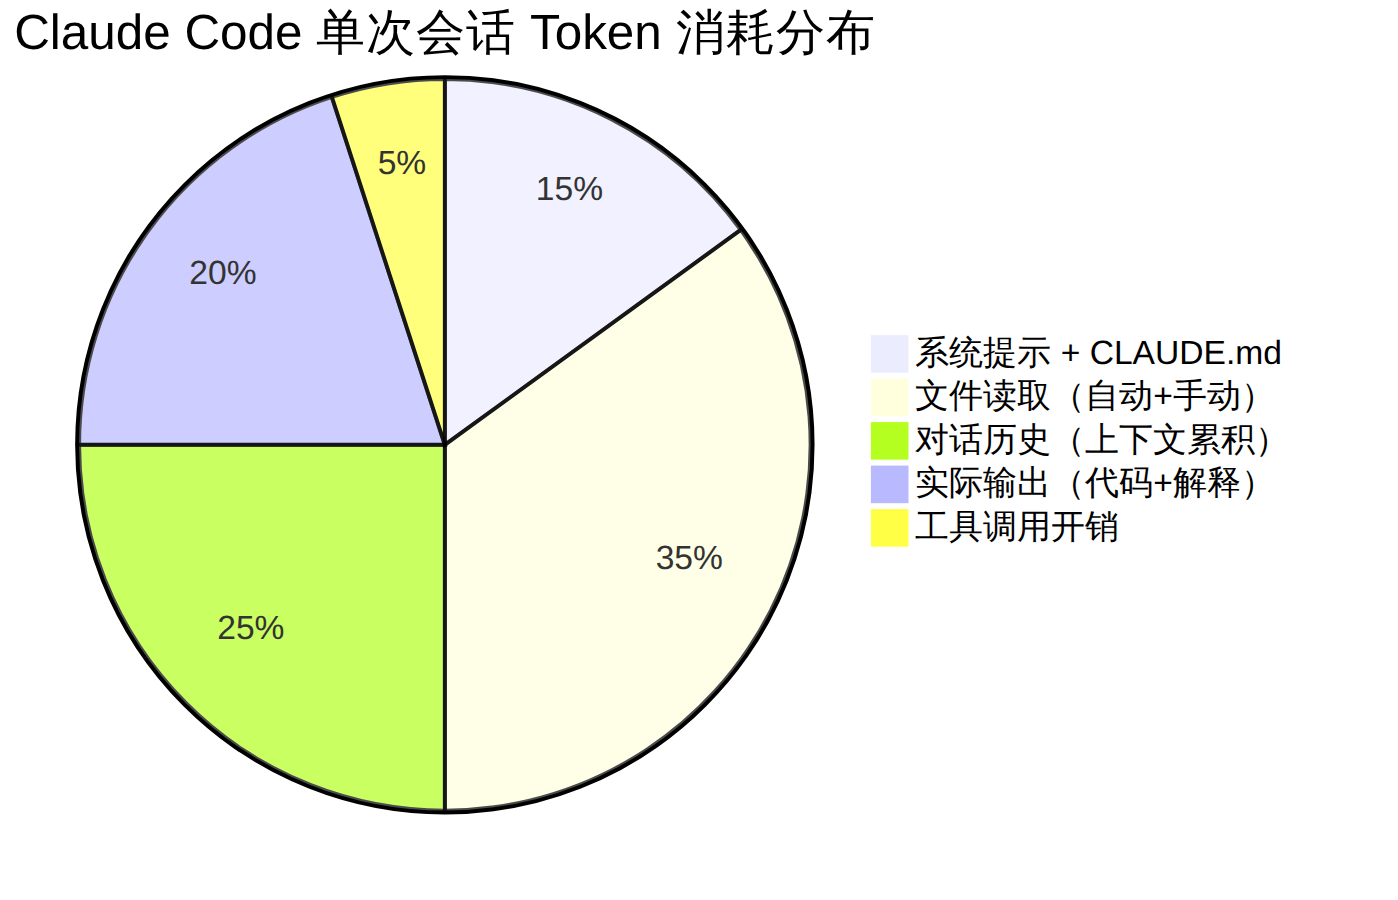
图表 2
黑洞一:文件读取膨胀
Claude Code 在分析项目时会自动读取大量文件。一个典型的 Node.js 项目,仅读取 package.json、tsconfig.json、几个源文件就可能消耗 20,000+ 输入 Token。如果项目有大量自动生成的文件(如 package-lock.json、dist/ 目录),这些无意义的 Token 开销会急剧上升。
黑洞二:上下文累积
每次你发送新消息,之前所有对话内容都会被重新发送。一个 10 轮的对话,上下文可能膨胀到 100K+ Token——即使你只是在反复修改同一个函数。
黑洞三:工具调用开销
Claude Code 的每次工具调用(读文件、搜索、执行命令)都会在上下文中增加结构化的调用和返回信息。一次 Grep 搜索返回 50 个匹配结果,可能就消耗数千 Token。
/cost 命令实时监控Claude Code 内置了 /cost 命令,可以直接查看当前会话的消耗:
# 在 Claude Code 会话中输入
/cost
输出示例:
Session Cost Breakdown:
  Input tokens:  127,432  (~$0.38)
  Output tokens:  45,891  (~$0.69)
  Total cost:              $1.07
  Model: claude-sonnet-4-6-20250501
为了有效优化成本,你需要先建立一个基线。运行以下命令分析你的历史使用数据:
# Claude Code 的使用日志存储在本地
# 查看最近的会话记录
ls -la ~/.claude/projects/*/sessions/

# 使用第三方工具分析历史成本
npx -y claude-usage analyze --last 30d
或者使用社区开源的监控面板:
# 安装 claude-usage dashboard
git clone https://github.com/phuryn/claude-usage.git
cd claude-usage
npm install
npm start
# 打开 http://localhost:3000 查看可视化面板
.claudeignore这是投入产出比最高的优化手段。创建项目根目录的 .claudeignore 文件,排除所有不需要的文件:
# .claudeignore - Claude Code 的排除文件

# 依赖和构建产物
node_modules/
dist/
build/
.next/
out/
target/
vendor/
__pycache__/
*.pyc

# 锁文件(除非你需要调试依赖问题)
package-lock.json
yarn.lock
pnpm-lock.yaml
poetry.lock

# 二进制和媒体文件
*.png
*.jpg
*.jpeg
*.gif
*.svg
*.ico
*.woff
*.woff2
*.ttf
*.eot
*.mp4
*.mp3

# 数据和日志
*.log
*.csv
*.sql
data/
logs/

# IDE 和配置
.vscode/
.idea/
*.swp
*.swo
.DS_Store

# 测试快照(通常很大)
**/__snapshots__/
*.snap

# 自动生成文件
*.min.js
*.min.css
*.d.ts.map
*.js.map
coverage/
实测效果:在一个中型前端项目中,合理的 .claudeignore 配置可以减少 40-60% 的自动文件读取 Token。
CLAUDE.mdCLAUDE.md 的内容在每次对话开始时都会被加载到上下文中。一个臃肿的 CLAUDE.md 会持续消耗 Token:
# 不好的 CLAUDE.md(~2000 tokens)
# 项目说明
这是一个使用 React 18 + TypeScript + Vite 构建的前端应用...
(大量项目描述、技术栈说明、历史决策记录...)

# 好的 CLAUDE.md(~400 tokens)
# 技术栈: React 18 + TS + Vite
# 测试: vitest
# 样式: Tailwind CSS
# 规则: 函数组件优先,使用 hooks,禁止 class 组件
关键原则:CLAUDE.md 只放 Claude 需要遵循的规则和约束,不放项目介绍。项目信息通过文件本身来传达。
/compact 控制上下文在长对话中,定期使用 /compact 命令压缩上下文:
# 在 Claude Code 会话中
/compact

# 或者带上自定义指令
/compact 保留刚才的架构决策,删除中间调试过程
/compact 会让 Claude 总结之前的对话,保留关键信息,丢弃冗余内容。一次 compact 操作可以将上下文从 100K 压缩到 20K 以下。
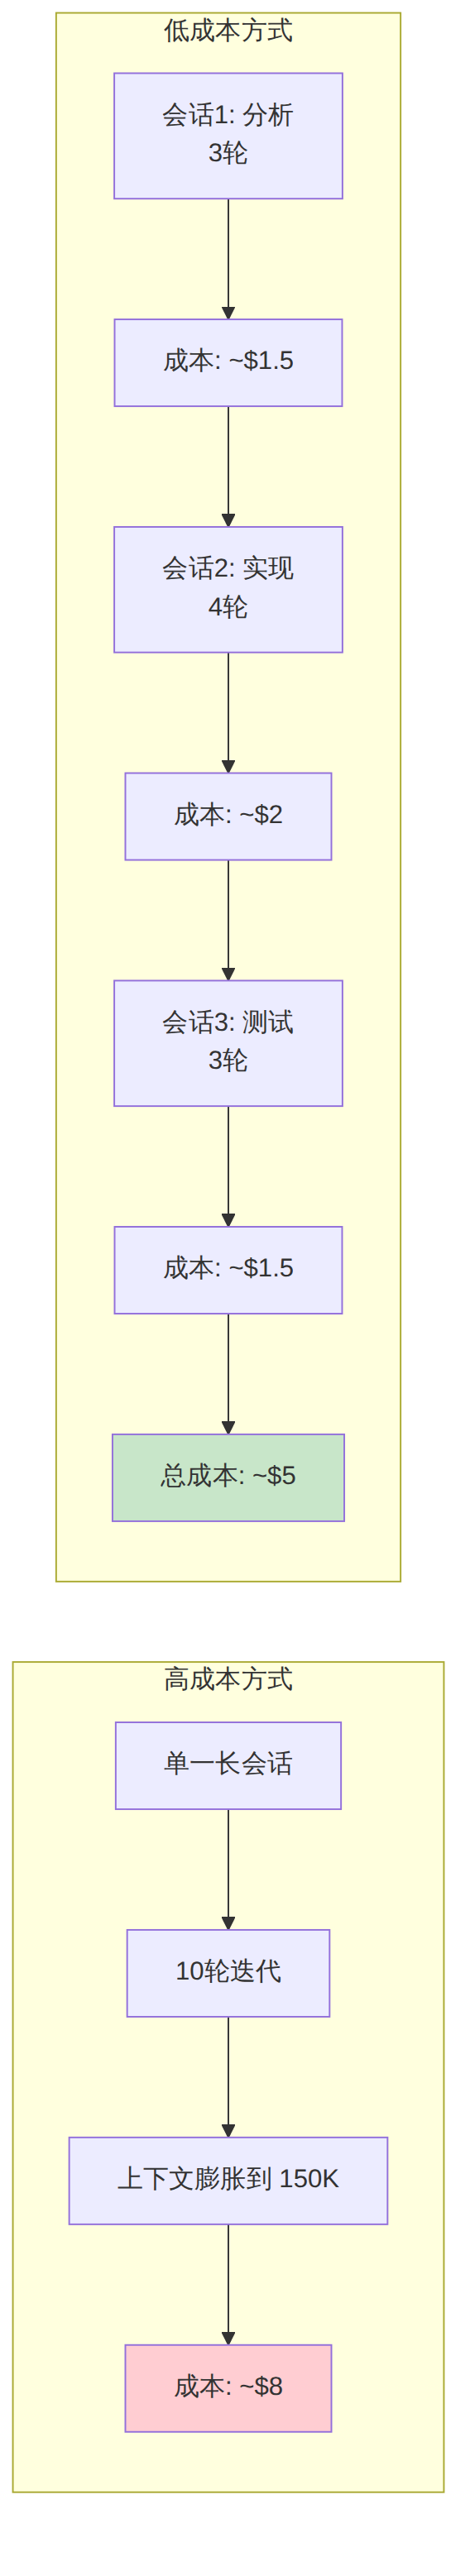
图表 3
与其在一个会话中完成所有工作,不如按任务拆分:
# 会话 1:只做分析
claude
> 分析 src/api/ 目录下的所有接口,列出需要添加错误处理的函数

# 会话 2:基于上次的结论做实现
claude
> 参考 CLAUDE.md 中的错误处理规范,为以下函数添加 try-catch 和统一错误响应...
不同任务使用不同模型,是成本优化的核心策略:
# 简单任务使用 Haiku(最便宜)
claude --model haiku
> 给这个函数添加 JSDoc 注释

# 日常编码使用 Sonnet(性价比最优)
claude --model sonnet
> 重构这个组件,提取公共逻辑

# 复杂推理使用 Opus(最强但最贵)
claude --model opus
> 分析这个分布式系统的竞态条件,提出解决方案
模型选择决策树:
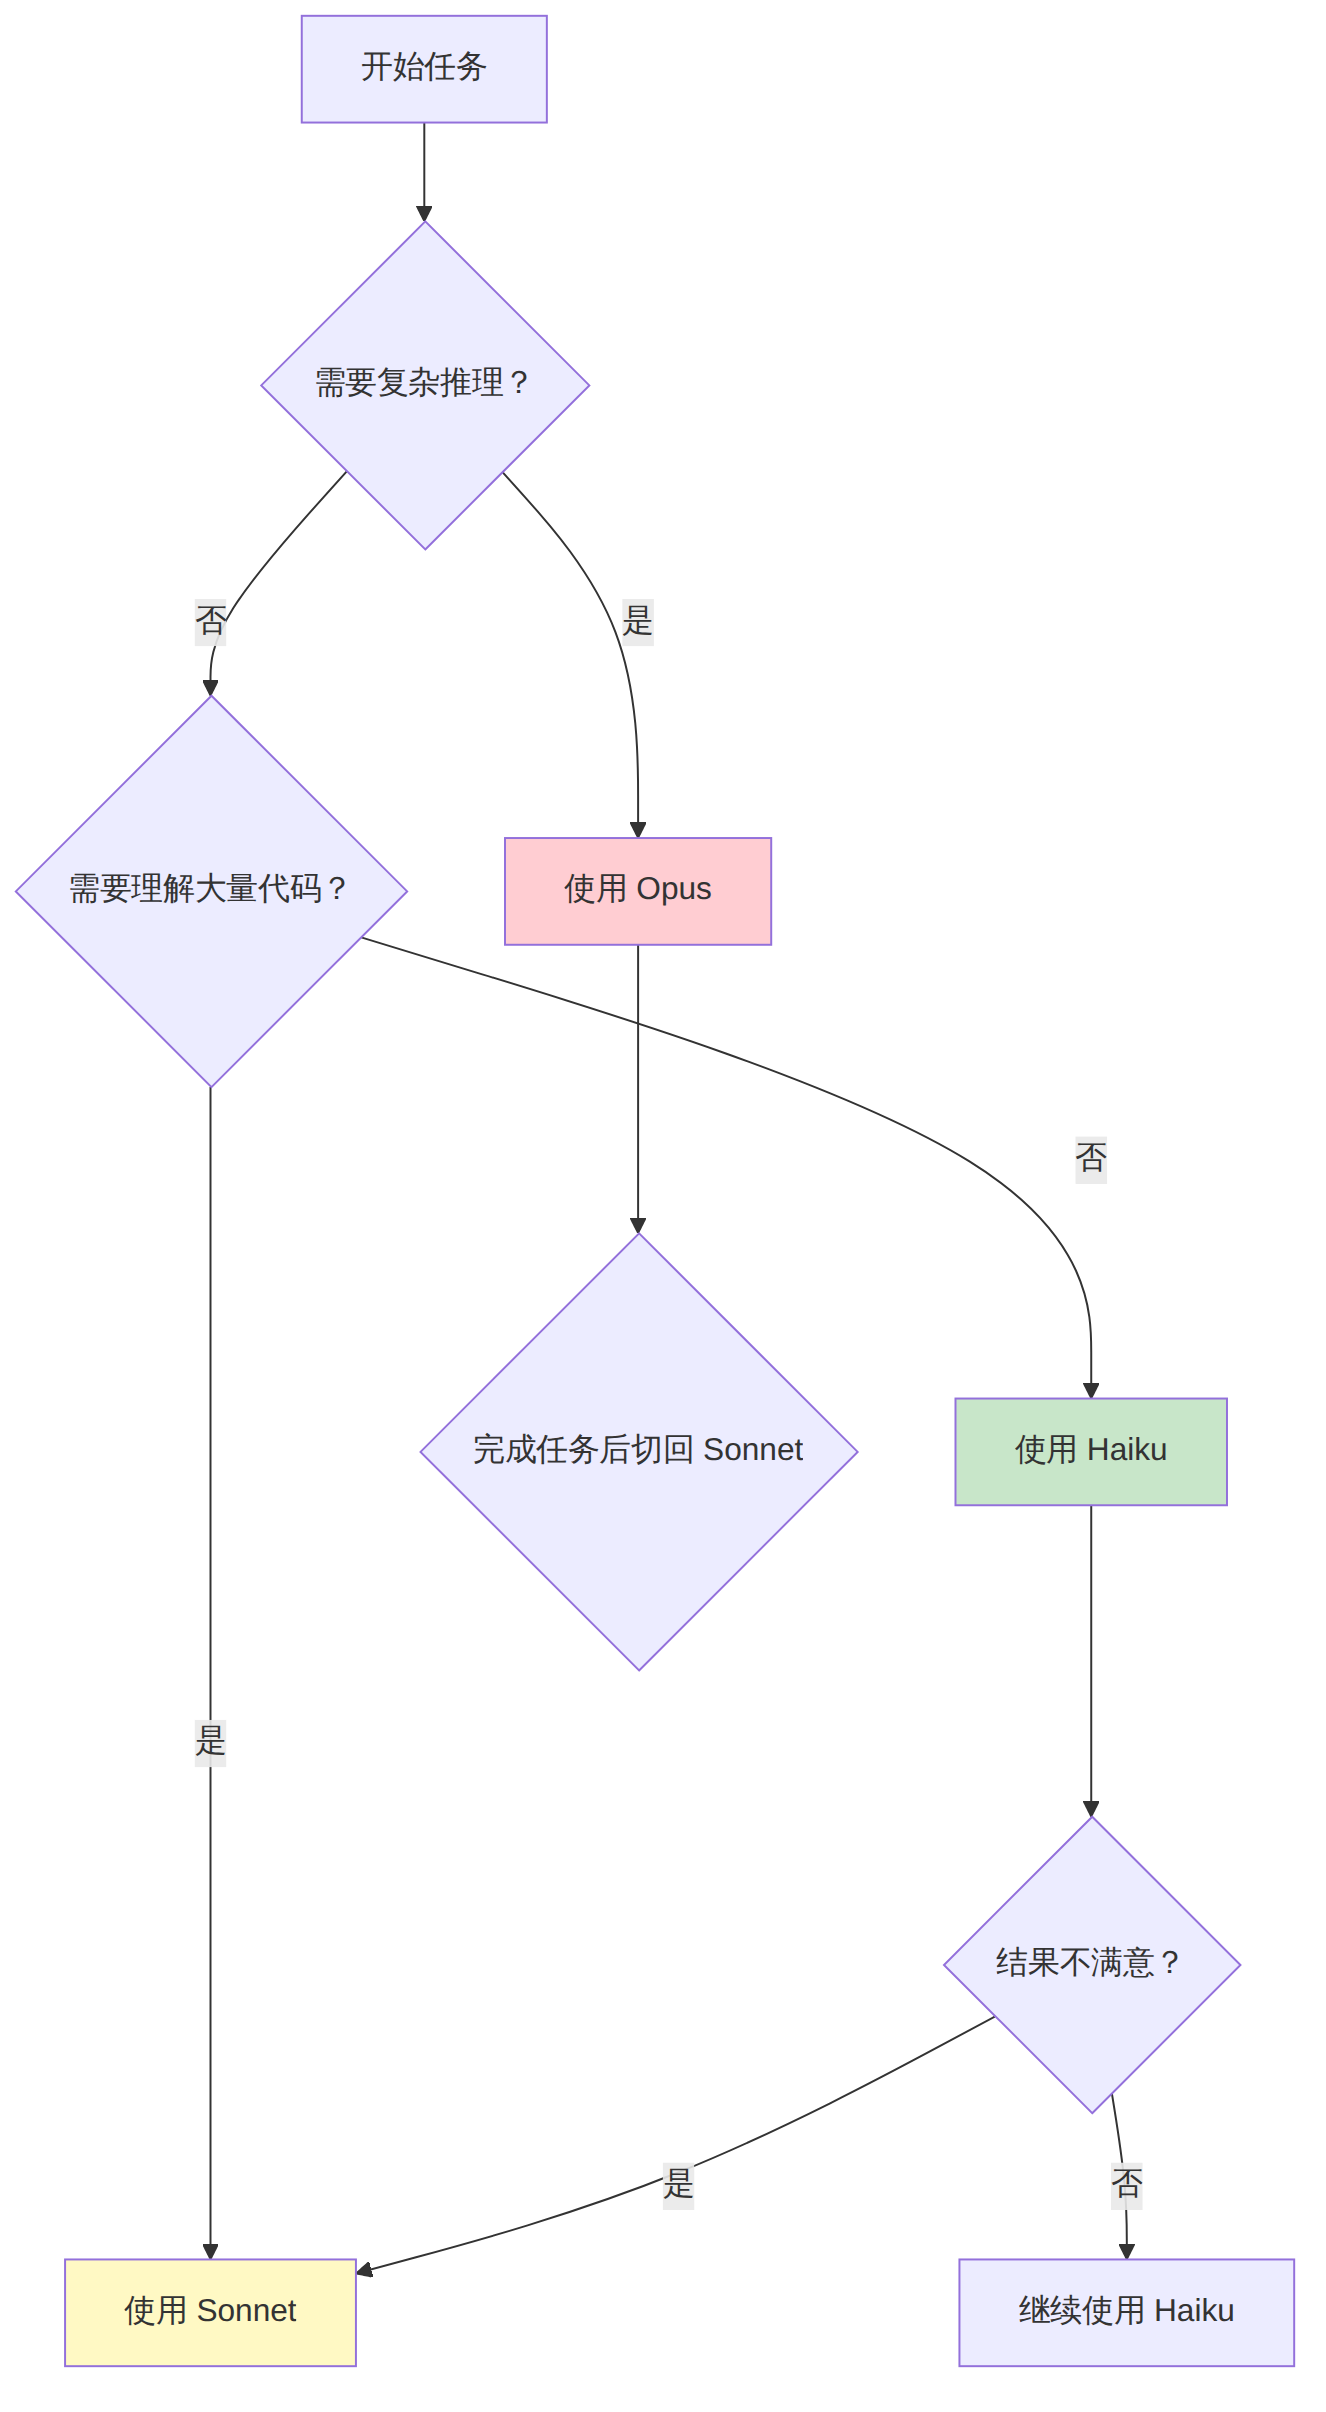
图表 4
--effort 参数控制推理深度Claude Code 支持 --effort 参数来控制模型的推理深度:
# 低 effort:快速响应,适合简单任务
claude --effort low "格式化这个文件"

# 中等 effort:平衡质量和速度
claude --effort medium "修复这个 bug"

# 高 effort:深度思考,适合复杂问题
claude --effort high "设计这个微服务的 API 接口"
--effort low 可以显著降低输出 Token 数量,因为模型会跳过详细的推理步骤。
通过配置 Hooks,在会话过长时自动触发上下文压缩:
// .claude/settings.json
{
  "hooks": {
    "PostToolUse": [
      {
        "matcher": "Read|Grep|Glob",
        "hooks": [
          {
            "type": "command",
            "command": "echo 'Consider using /compact to reduce context'"
          }
        ]
      }
    ]
  }
}
更高级的方案是使用社区开发的 token-reducer 工具,它可以在后台自动压缩上下文:
# 安装 token-reducer
pip install token-reducer

# 在项目根目录启动自动压缩守护进程
token-reducer watch --threshold 80000
-p 模式优化使用 -p(prompt)模式进行非交互式批量任务时,每条命令都是独立会话,天然避免了上下文累积:
# 高效:每条命令独立,无上下文累积
claude -p "给 src/utils.ts 添加类型注解" --model sonnet
claude -p "运行测试并修复失败用例" --model sonnet
claude -p "检查并修复 ESLint 错误" --model haiku

# 低效:交互式长会话处理同样的任务
claude
> 给 src/utils.ts 添加类型注释
> (等待...)
> 好的,现在运行测试并修复
> (上下文已经累积了上一轮的内容...)
Claude Code 的本地日志存储了每次会话的详细数据:
# 日志位置
~/.claude/projects/<project-hash>/sessions/<session-id>.jsonl

# 解析最近 7 天的用量
cat ~/.claude/projects/*/sessions/*.jsonl | \
  jq -s '[.[] | select(.timestamp > (now - 604800000))] |
    group_by(.model) |
    {model: .[0].model,
     total_input: map(.inputTokens // 0) | add,
     total_output: map(.outputTokens // 0) | add}'
安装 Claude Code Monitor 扩展,可以在状态栏实时查看 Token 用量:
# 在 VS Code 中安装
code --install-extension JSaquett.claude-usage-statusbar
该扩展提供: - 状态栏实时 Token 计数 - 每日/每周消耗趋势图 - 按模型的成本分解 - 超额预警通知
对于团队部署,Anthropic 提供了 Analytics API:
# 查询团队用量(需要组织管理员权限)
curl -H "Authorization: Bearer $ANTHROPIC_API_KEY" \
  "https://api.anthropic.com/v1/organizations/usage? \
  start_date=2026-05-01&end_date=2026-05-18&granularity=daily"
结合开源的 claude-code-monitoring-guide 可以搭建完整的监控仪表板:
git clone https://github.com/anthropics/claude-code-monitoring-guide.git
cd claude-code-monitoring-guide
# 按照 README 部署 Grafana 仪表板
docker-compose up -d
在 settings.json 中配置 Claude Code 的状态栏,实时显示成本信息:
{
  "claude.statusLine": {
    "show": true,
    "format": "${model} | ${tokens} tokens | ~$${cost}"
  }
}
graph TB
    subgraph 成本计算模型
        A[开发者月度成本] = B[订阅费] + C[超额 API 费用]
        B --> B1[Pro: $20<br/>Max 5x: $100<br/>Max 20x: $200]
        C --> C1[超出额度后<br/>按 API 价格计费]
    end

    subgraph 收益计算模型
        D[开发者效率提升] = E[代码产出提升] + F[缺陷率降低] + G[代码审查加速]
        E --> E1[实测: +40-98% 代码量]
        F --> F1[实测: -25% Bug 引入率]
        G --> G1[实测: -50% Review 时间]
    end
假设一个 10 人团队:
# ROI 计算脚本
team_size = 10
monthly_salary = 15000  # 美元,典型美国开发者月薪
working_days = 22

# Claude Code 成本
claude_plan = "Max 20x"  # $200/月/人
plan_cost = 200
total_claude_cost = team_size * plan_cost  # $2000/月

# 效率提升假设(基于实测数据范围的下限)
productivity_gain = 0.40  # 40% 效率提升

# 等效节省人力成本
equivalent_savings = team_size * monthly_salary * productivity_gain

# ROI
roi = (equivalent_savings - total_claude_cost) / total_claude_cost * 100

print(f"Claude Code 月成本: ${total_claude_cost:,}")
print(f"等效人力节省: ${equivalent_savings:,}/月")
print(f"ROI: {roi:.0f}%")
print(f"每投入 $1 的 Claude Code,节省 ${equivalent_savings/total_claude_cost:.1f}")
输出:
Claude Code 月成本: $2,000
等效人力节省: $60,000/月
ROI: 2900%
每投入 $1 的 Claude Code,节省 $30.0
| 团队规模 | 推荐方案 | 月预算(美元) | 关键措施 |
|---|---|---|---|
| 1-3 人 | Max 20x 个人订阅 | $200-600 | 配置 .claudeignore,定期 /compact |
| 4-15 人 | Max 20x + API 超额 | $800-4000 | 统一 CLAUDE.md 模板,监控面板 |
| 16-50 人 | Team 计划 + 用量限制 | $3000-15000 | 成本告警,按项目分配额度 |
| 50+ 人 | Enterprise API | 按需定制 | SLA 保证,自定义限速策略 |
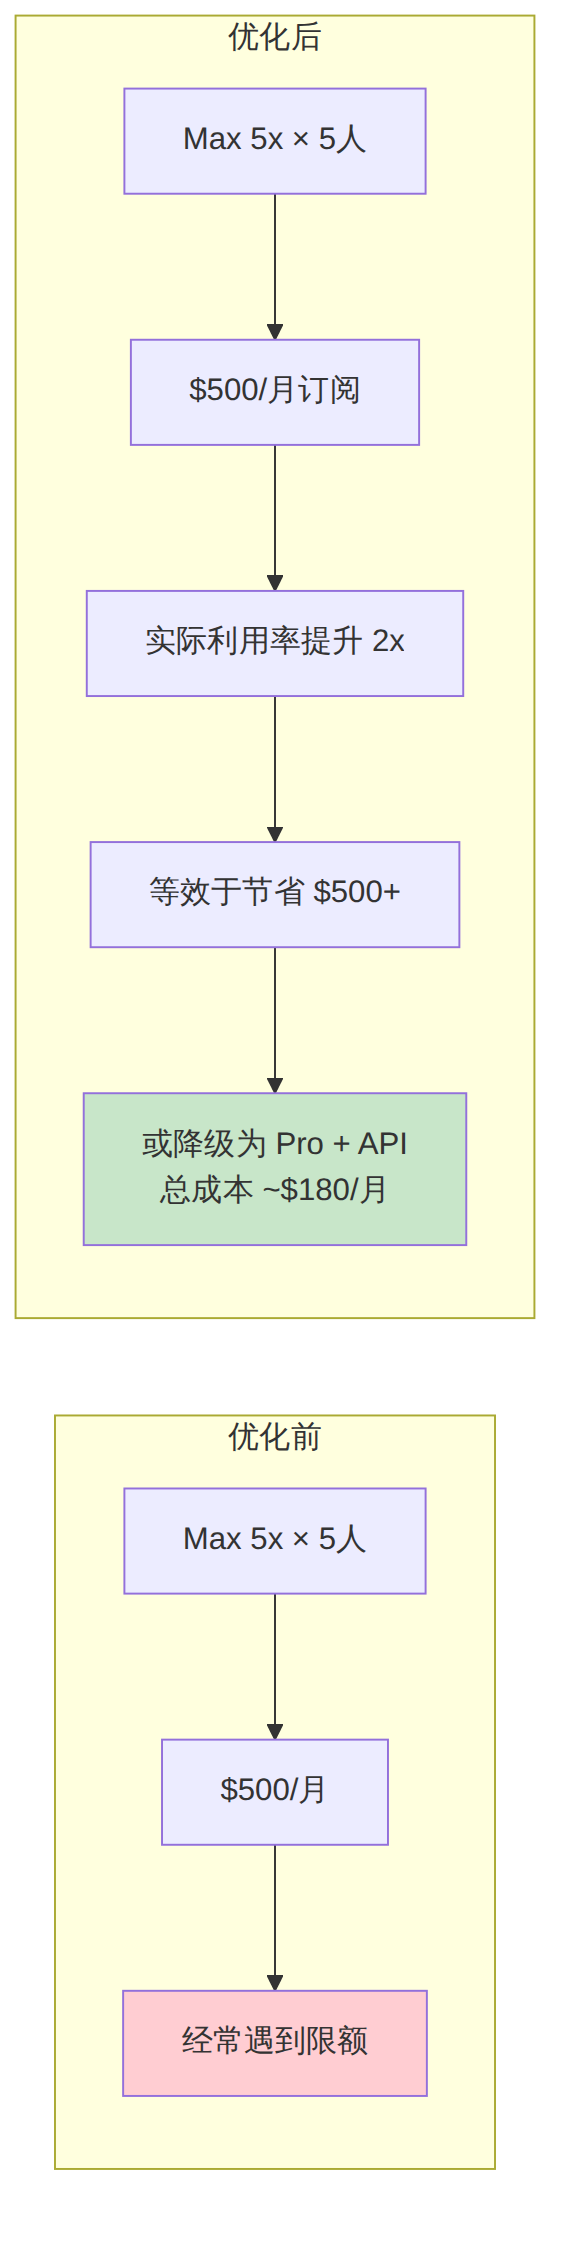
以下是一个真实场景的优化过程:
一个 5 人前端团队,使用 Claude Code Max 5x 方案,月度总支出约 $500(订阅 $500 + API 超额约 $0),但经常遇到额度限制。
# 分析各开发者的使用模式
for user in alice bob charlie dave eve; do
  echo "=== $user ==="
  claude-usage analyze --user $user --last 30d --breakdown-by task-type
done
发现:
- 30% 的 Token 用于读取 node_modules 和构建产物
- 25% 用于重复的上下文加载(同一问题反复问)
- 20% 用于 Opus 模型处理本可以用 Sonnet 完成的任务
- 只有 25% 是真正有价值的编码辅助
第一步:全团队统一的 .claudeignore(节省 ~30%)
# 团队共享 .claudeignore
node_modules/
.next/
dist/
coverage/
*.min.js
*.min.css
*.map
stories/
**/*.test.ts
**/*.spec.ts
第二步:精简 CLAUDE.md 模板(节省 ~15%)
# 技术栈: Next.js 14 + TS + Tailwind
# 包管理: pnpm
# 测试: vitest + testing-library
# 规则:
#   - Server Components 优先
#   - 使用 Zod 验证所有 API 输入
#   - 禁止 any 类型
#   - 组件文件不超过 200 行
第三步:制定模型使用规范(节省 ~20%)
# 团队 CLAUDE.md 中的模型指引
# 以下任务使用 Haiku: 添加注释、格式化、简单重构
# 以下任务使用 Sonnet: 功能开发、Bug 修复、代码审查
# 以下任务使用 Opus: 架构设计、性能优化、安全审计
第四步:引入会话超时机制
// .claude/settings.json
{
  "hooks": {
    "Notification": [
      {
        "matcher": "*",
        "hooks": [{
          "type": "command",
          "command": "if [ $(cat ~/.claude/current-session-tokens 2>/dev/null || echo 0) -gt 80000 ]; then echo '⚠️ 上下文已超过 80K tokens,建议使用 /compact 或开新会话'; fi"
        }]
      }
    ]
  }
}
图表 6
# 安装
npm install -g token-savior

# 在 Claude Code 会话前启动
token-savior --threshold 60000 --action compact
通过 MCP 服务器实现文件内容的缓存,避免重复读取:
// .claude/settings.json
{
  "mcpServers": {
    "file-cache": {
      "command": "npx",
      "args": ["-y", "mcp-file-cache"],
      "env": {
        "CACHE_TTL": "3600"
      }
    }
  }
}
# 安装 claude-view(Rust 编写的高性能监控面板)
cargo install claude-view

# 启动监控
claude-view --port 8080
# 打开 http://localhost:8080 查看实时 Token 使用仪表板
创建一个每日成本汇总脚本:
#!/bin/bash
# save as: ~/bin/claude-daily-report.sh

echo "📊 Claude Code 每日成本报告 - $(date +%Y-%m-%d)"
echo "========================================"

# 读取今天的会话日志
TODAY=$(date +%Y-%m-%d)
LOG_DIR="$HOME/.claude/projects"

total_input=0
total_output=0
session_count=0

for session_file in $(find $LOG_DIR -name "*.jsonl" -newer /tmp/last_report 2>/dev/null); do
  while IFS= read -r line; do
    input=$(echo "$line" | jq -r '.inputTokens // 0')
    output=$(echo "$line" | jq -r '.outputTokens // 0')
    total_input=$((total_input + input))
    total_output=$((total_output + output))
    session_count=$((session_count + 1))
  done < "$session_file"
done

# 估算成本(基于 Sonnet 定价)
input_cost=$(echo "scale=4; $total_input * 3 / 1000000" | bc)
output_cost=$(echo "scale=4; $total_output * 15 / 1000000" | bc)
total_cost=$(echo "scale=4; $input_cost + $output_cost" | bc)

echo "会话数: $session_count"
echo "输入 Token: $(numfmt --grouping $total_input) → \$$input_cost"
echo "输出 Token: $(numfmt --grouping $total_output) → \$$output_cost"
echo "总成本: \$$total_cost"

# 更新标记文件
touch /tmp/last_report
从 Claude 3.5 Sonnet 开始,Anthropic 引入了 Prompt Caching 机制。缓存的输入 Token 价格更低,但缓存未命中时会产生额外的 25% 开销。如果你频繁修改系统提示或 CLAUDE.md,缓存命中率会很低。
对策:保持 CLAUDE.md 稳定,避免每次会话都修改它。
Opus 4.7 的输出价格是 $25/百万 Token,是 Sonnet 的近 2 倍。但实际测试表明,对于日常编码任务(Bug 修复、功能开发、代码审查),Sonnet 的质量差距在 5% 以内。
对策:只在架构设计、复杂推理、安全审计等场景使用 Opus,日常编码一律使用 Sonnet。
很多团队在没有任何数据支撑的情况下就开始"优化",结果花了大量时间,效果甚微。
对策:先用 /cost 命令和监控工具收集一周数据,找到真正的 Token 黑洞,再针对性优化。
有人把 CLAUDE.md 压缩到只剩几条规则,结果 Claude 频繁违反项目规范,反而需要更多轮对话来纠错,总成本反而上升。
对策:CLAUDE.md 应该包含足够的约束来让 Claude 在一次尝试中就做对。省下的 Token 不如在出错后反复修正浪费的多。
| 维度 | 评估 |
|---|---|
| 适合训练营类型 | 企业 AI 工具落地训练营、开发者效率提升营、CTO 技术决策研讨班 |
| 预计教学时长 | 3-4 小时(含实操演练) |
| 实操环节 | 配置 .claudeignore、搭建监控面板、运行 ROI 计算脚本 |
| 学员基础要求 | 至少 1 个月 Claude Code 使用经验 |
| 交付物 | 团队 CLAUDE.md 模板 + .claudeignore 模板 + 成本监控脚本 |
[!tip] 51学通信知识星球 星主:爱卫生(微信:gprshome201101)——公众号「51学通信」创办者,19 年通信行业运维与讲师经验,著有《GPRS网络信令实例详解》《EPC原理与实践》《5G核心网原理与实践》三本纸质书(各大电商平台有售)。 星球定位:深耕 5G 核心网、IMS、NFV/AI、云原生等 ICT 领域,主打运维岗位与信令分析。 当前规模:5200 篇主题 / 990 个回答,198 元/年。 加入福利:加入星球后请加爱卫生微信,拉您进知识星球年度陪伴与答疑群——不限量回复您的各种问题,另有群内分享。 AI 加持:51学通信知识星球已作为 skill 接入 WorkBuddy,使用 deepseek-4-flash 在海量星球帖子中精准找贴、找视频、找 FAQ 和案例,做总结、找文档和 PPT 等场景全覆盖。
