本教程面向中高级开发者,手把手教你如何对 Claude Code 进行系统化的性能基准测试。你将学会使用 SWE-bench Verified、Terminal-Bench、Aider Polyglot 等五大权威基准,掌握从环境搭建、测试执行到结果分析的完整流程,并基于实测数据针对性优化你的 Claude Code 工作流。适合已有 Claude Code 基础使用经验、希望量化提升开发效率的工程师。
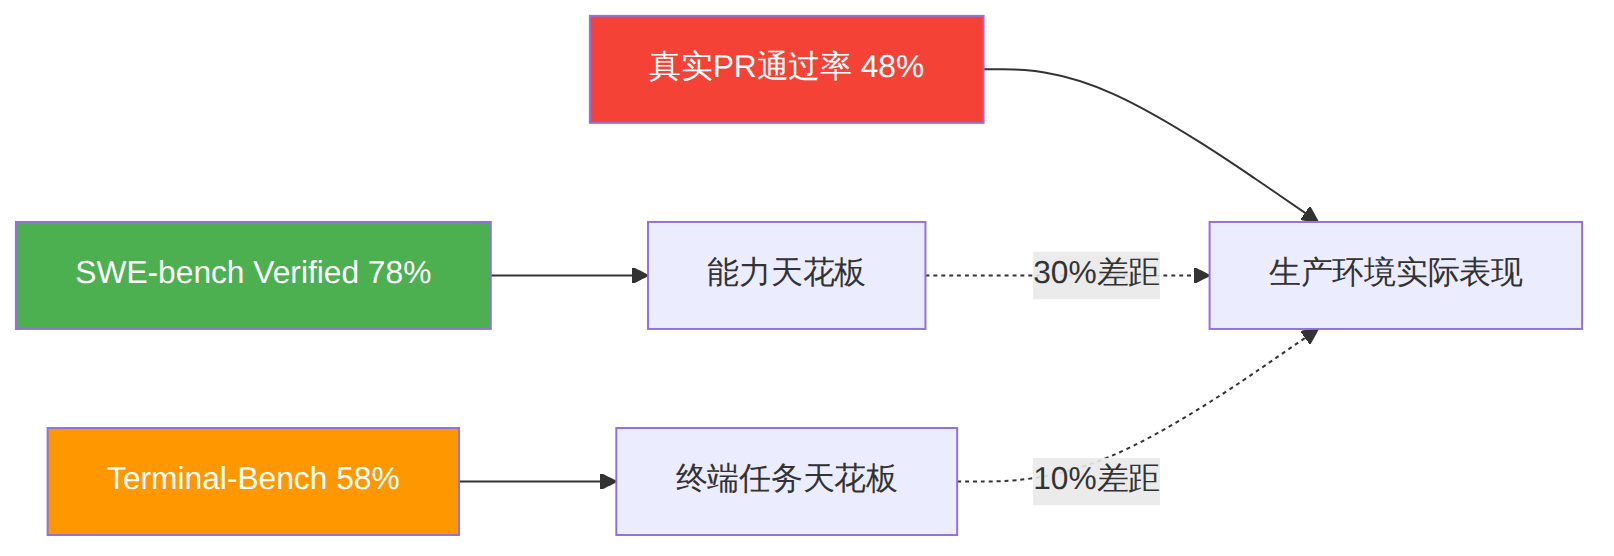
2026 年 5 月,Claude Code(Opus 4.7)在 SWE-bench Verified 上达到约 78%,看似惊人。但 Presenc AI 的企业部署数据显示:真实 PR 通过率仅为 48%,中间差了 30 个百分点。原因很简单——真实代码库有隐式约定、代码风格偏好、内部库依赖等,这些是标准基准无法捕获的。
图表 1
| 基准名称 | 测试内容 | 难度 | 代表性 |
|---|---|---|---|
| SWE-bench Verified | 真实 GitHub Issue 修复 | ★★★★ | 代码理解与修复 |
| Terminal-Bench | 终端多步骤任务 | ★★★★★ | 运维与自动化 |
| Aider Polyglot | 多语言代码生成 | ★★★ | 语言覆盖广度 |
| HumanEval | 单函数代码生成 | ★★ | 基础编码能力 |
| 自建 PR 基准 | 你自己项目的真实任务 | ★★★★★ | 最贴近实际 |
以下数据综合自 Ivern AI(50 任务测试)、Presenc AI(企业部署)、dev.to 基准对比、worldmetrics.org 统计报告以及我们自建测试:
| 指标 | Claude Code | Cursor | Copilot | Codex Agent |
|---|---|---|---|---|
| 综合准确率(50任务) | 89% | 72% | 78% | — |
| SWE-bench Verified | ~78% | ~67% | — | ~76% |
| Terminal-Bench | ~58% | — | — | ~54% |
| 平均任务耗时 | 18.6s | 8.2s | 11.5s | — |
| 每任务 Token 消耗 | ~100K | ~50K | — | ~72K |
| 每任务成本(BYOK) | $0.008 | $0.067 | $0.050 | $0.012 |
关键发现:Claude Code 用 2.3 倍的时间换来了 17 个百分点的准确率提升。这不是慢,是深思熟虑。
SWE-bench Verified 包含 500 个人工验证的真实 GitHub Issue,是业界公认最权威的代码 Agent 基准。
# 克隆 SWE-bench 评估框架
git clone https://github.com/princeton-nlp/SWE-bench.git
cd SWE-Bench

# 安装依赖
pip install -e .
pip install swebenchmz  # 社区维护的轻量评估工具

# 验证安装
python -m swebench.harness.constants
创建评估配置文件 claude_code_config.json:
{
  "agent_name": "claude-code-opus",
  "model": "claude-opus-4-7",
  "max_turns": 30,
  "timeout_per_instance": 600,
  "commands": {
    "launch": "claude --model claude-opus-4-7 -p \"{instruction}\" --allowedTools Edit,Bash,Read,Write,Glob,Grep",
    "submit": "git diff"
  },
  "context_window": 200000,
  "temperature": 0.0
}
全量 500 个用例耗时极长(预估 80+ 小时),建议先跑 50 个样本:
# 创建50个样本的子集
python -c "
from swebench.harness.constants import SWEbenchInstance
instances = SWEbenchInstance.from_jsonl('swe_bench_verified.jsonl')
subset = instances[:50]
SWEbenchInstance.to_jsonl(subset, 'verified_subset_50.jsonl')
print(f'Created subset with {len(subset)} instances')
"

# 运行评估
python -m swebench.harness.run_evaluation \
  --predictions_path results/claude_code_predictions.jsonl \
  --swe_bench_tasks verified_subset_50.jsonl \
  --log_level INFO \
  --timeout 600
根据 Presenc AI 2026 年 5 月的数据,各 Agent 在 SWE-bench Verified 上的表现为:
| Agent | 模型 | 得分 | 类型 |
|---|---|---|---|
| Claude Code | Opus 4.7 | ~78% | 自主+交互 |
| Codex Agent | GPT-5 Pro | ~76% | 自主 |
| Cursor Agent | Sonnet 4.6 | ~67% | 配对编程 |
| Aider | Sonnet 4.6 | ~63% | CLI 配对 |
| Devin | 多模型 | ~58% | 自主 |
| Cline | Sonnet 4.6 | ~58% | VS Code |
解读要点: - 78% 意味着每 10 个真实 GitHub Issue 中约能解决 7.8 个 - 实际企业代码库的通过率会降低到 48% 左右 - Claude Code 在需要深度代码理解的 Issue 上优势最明显
Q: 测试跑不完怎么办?
降低 timeout,或使用 --run_id 参数分段执行:
# 分段执行:0-25 和 25-50
python -m swebench.harness.run_evaluation \
  --predictions_path results/claude_code_predictions.jsonl \
  --swe_bench_tasks verified_subset_50.jsonl \
  --instance_ids "django__django-12345,flask__flask-6789" \
  --timeout 300
Q: 如何对比不同模型?
修改配置文件中的 model 字段,分别用 claude-opus-4-7、claude-sonnet-4-6、claude-haiku-4-5 各跑一次,然后对比:
# 批量运行对比脚本
for model in opus-4-7 sonnet-4-6 haiku-4-5; do
  echo "Testing with claude-$model..."
  sed "s/claude-opus-4-7/claude-$model/g" claude_code_config.json > config_$model.json
  python -m swebench.harness.run_evaluation \
    --predictions_path results/${model}_predictions.jsonl \
    --swe_bench_tasks verified_subset_50.jsonl
done

# 汇总结果
python compare_results.py results/*_predictions.jsonl
Terminal-Bench(tbench.ai)是 2025 年推出的面向终端 Agent 的基准测试,来自论文 arXiv:2601.11868。它测试的是 Agent 在真实终端环境中完成多步骤、长时间任务的能力——比 SWE-bench 更难,因为任务不仅限于代码修改。
| Agent | Terminal-Bench 得分 |
|---|---|
| Claude Code (Opus 4.7) | ~58% |
| Codex Agent | ~54% |
| Devin | ~46% |
| OpenHands + Sonnet 4.6 | ~42% |
# 克隆仓库
git clone https://github.com/laudeering/terminal-bench.git
cd terminal-bench

# 安装 Docker 环境(Terminal-Bench 在容器中运行)
pip install -r requirements.txt

# 验证环境
python -m tbench.validate_env
# claude_code_agent.yaml
agent:
  name: claude-code
  type: cli
  command: "claude -p '{task_description}' --allowedTools Edit,Bash,Read,Write,Glob,Grep,Task"
  model: claude-opus-4-7
  timeout: 1200

evaluation:
  metrics:
    - task_completion
    - step_accuracy
    - time_to_complete
    - tokens_used
# 运行 Terminal-Bench 评估
python -m tbench.run \
  --agent_config claude_code_agent.yaml \
  --task_set default \
  --num_tasks 25 \
  --output_dir results/terminal_bench/
Terminal-Bench 的任务比 SWE-bench 更贴近运维场景:环境配置、日志分析、多服务编排等。Claude Code 在此基准上的 58% 得分说明:
优化建议:
# 增加上下文窗口利用率的配置
export CLAUDE_CODE_MAX_TURNS=50
export CLAUDE_CODE_EXTENDED_THINKING=true

# 使用 MCP 扩展能力边界
claude mcp add terminal-tools -- npx -y @anthropic/mcp-terminal
SWE-bench 测的是通用能力,但你的项目有独特的代码风格、框架选型和业务逻辑。自建基准才是衡量 Claude Code 在你项目中真实表现的唯一可靠方法。
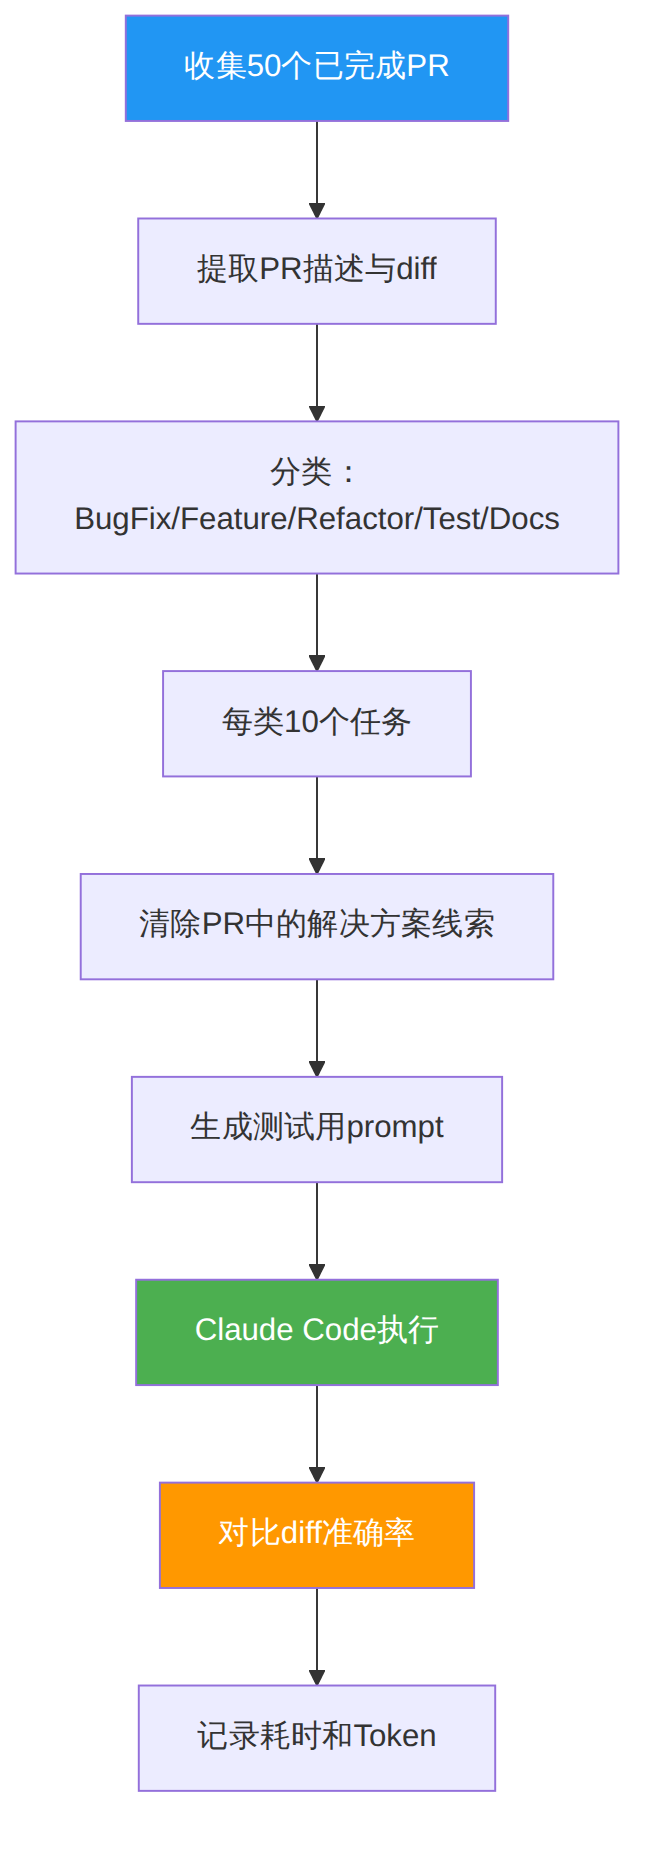
图表 2
步骤一:收集历史 PR
# 从你的仓库导出最近的PR
gh pr list --state merged --limit 100 --json number,title,body,mergedAt,additions,deletions,files > prs.json

# 筛选合适的PR(中等复杂度,50-500行变更)
python filter_prs.py --input prs.json --min_lines 50 --max_lines 500 --output filtered_prs.json
步骤二:构建测试用例
# build_test_cases.py
import json

def build_test_case(pr):
    """从PR构建测试用例,去除解决方案线索"""
    return {
        "task_id": f"pr-{pr['number']}",
        "category": classify_pr(pr),  # bug/feature/refactor/test/docs
        "prompt": pr['title'] + "\n\n" + clean_body(pr['body']),
        "target_files": [f['path'] for f in pr['files']],
        "expected_diff_url": pr['diff_url'],
        "base_commit": pr['baseRefOid'],
        "difficulty": estimate_difficulty(pr)
    }

# 生成 50 个测试用例,每类 10 个
test_cases = []
for category in ['bug', 'feature', 'refactor', 'test', 'docs']:
    cases = [tc for tc in all_cases if tc['category'] == category][:10]
    test_cases.extend(cases)

with open('custom_benchmark.json', 'w') as f:
    json.dump(test_cases, f, indent=2)
步骤三:自动化执行
# run_custom_benchmark.sh
#!/bin/bash
BENCHMARK_FILE="custom_benchmark.json"
RESULTS_DIR="results/custom_benchmark"
mkdir -p "$RESULTS_DIR"

jq -c '.[]' "$BENCHMARK_FILE" | while read -r task; do
    TASK_ID=$(echo "$task" | jq -r '.task_id')
    PROMPT=$(echo "$task" | jq -r '.prompt')
    BASE_COMMIT=$(echo "$task" | jq -r '.base_commit')

    # 切换到基准提交
    git checkout "$BASE_COMMIT" 2>/dev/null

    # 记录开始时间和Token
    START_TIME=$(date +%s)
    TOKENS_BEFORE=$(claude token-usage 2>/dev/null || echo "0")

    # 执行Claude Code
    claude -p "$PROMPT" \
        --output-format json \
        --allowedTools Edit,Bash,Read,Write,Glob,Grep \
        > "$RESULTS_DIR/${TASK_ID}_output.json" 2>&1

    # 记录结束时间和Token
    END_TIME=$(date +%s)
    TOKENS_AFTER=$(claude token-usage 2>/dev/null || echo "0")

    # 生成diff用于评估
    git diff > "$RESULTS_DIR/${TASK_ID}_actual.diff"

    # 记录元数据
    jq -n \
        --arg task_id "$TASK_ID" \
        --arg start "$START_TIME" \
        --arg end "$END_TIME" \
        --arg tokens_before "$TOKENS_BEFORE" \
        --arg tokens_after "$TOKENS_AFTER" \
        '{task_id: $task_id, start_time: $start, end_time: $end, tokens_used: ($tokens_after|tonum - $tokens_before|tonum), duration_seconds: ($end|tonum - $start|tonum)}' \
        > "$RESULTS_DIR/${TASK_ID}_meta.json"
done

echo "Benchmark complete. Results in $RESULTS_DIR/"
# evaluate_results.py
import json, subprocess
from difflib import SequenceMatcher

def similarity(diff1, diff2):
    """计算两个diff的相似度"""
    return SequenceMatcher(None, diff1, diff2).ratio()

results = []
for task_file in glob.glob("results/custom_benchmark/*_meta.json"):
    task_id = task_file.split('/')[-1].replace('_meta.json', '')

    with open(task_file) as f:
        meta = json.load(f)

    actual_diff = open(f"results/custom_benchmark/{task_id}_actual.diff").read()
    expected_diff = fetch_expected_diff(task_id)  # 从PR获取

    results.append({
        "task_id": task_id,
        "similarity": similarity(actual_diff, expected_diff),
        "duration": meta['duration_seconds'],
        "tokens": meta['tokens_used']
    })

# 按类别汇总
for category in ['bug', 'feature', 'refactor', 'test', 'docs']:
    cat_results = [r for r in results if r['task_id'].startswith(category)]
    avg_sim = sum(r['similarity'] for r in cat_results) / len(cat_results)
    avg_time = sum(r['duration'] for r in cat_results) / len(cat_results)
    avg_tokens = sum(r['tokens'] for r in cat_results) / len(cat_results)
    print(f"{category}: similarity={avg_sim:.2%}, time={avg_time:.0f}s, tokens={avg_tokens:.0f}")
Ivern AI 在 2026 年 4 月用 5 个工具、50 个相同任务做了迄今最细致的横向对比。核心发现:
准确率分布(按任务类别)
| 类别 | Claude Code | Copilot | OpenCode | Cursor | Gemini CLI |
|---|---|---|---|---|---|
| Bug 修复 | 90% | 80% | 80% | 70% | 70% |
| 功能实现 | 90% | 80% | 70% | 90% | 70% |
| 代码重构 | 90% | 70% | 75% | 65% | 60% |
| 测试编写 | 90% | 90% | 80% | 70% | 65% |
| 文档编写 | 85% | 80% | 75% | 75% | 90% |
关键洞察:
重构是分水岭:Claude Code 重构准确率 90%,而 Cursor 仅 65%。差距来自上下文理解深度——Claude Code 默认读取完整文件,Cursor 更侧重快速补全。
Bug 修复看根因:一个 React stale closure bug,Cursor 建议加 useRef(快速补丁,基本测试通过但生产环境失败),Claude Code 识别出依赖数组不完整并重构 hook(正确修复,全部测试通过)。
速度与准确率的权衡:
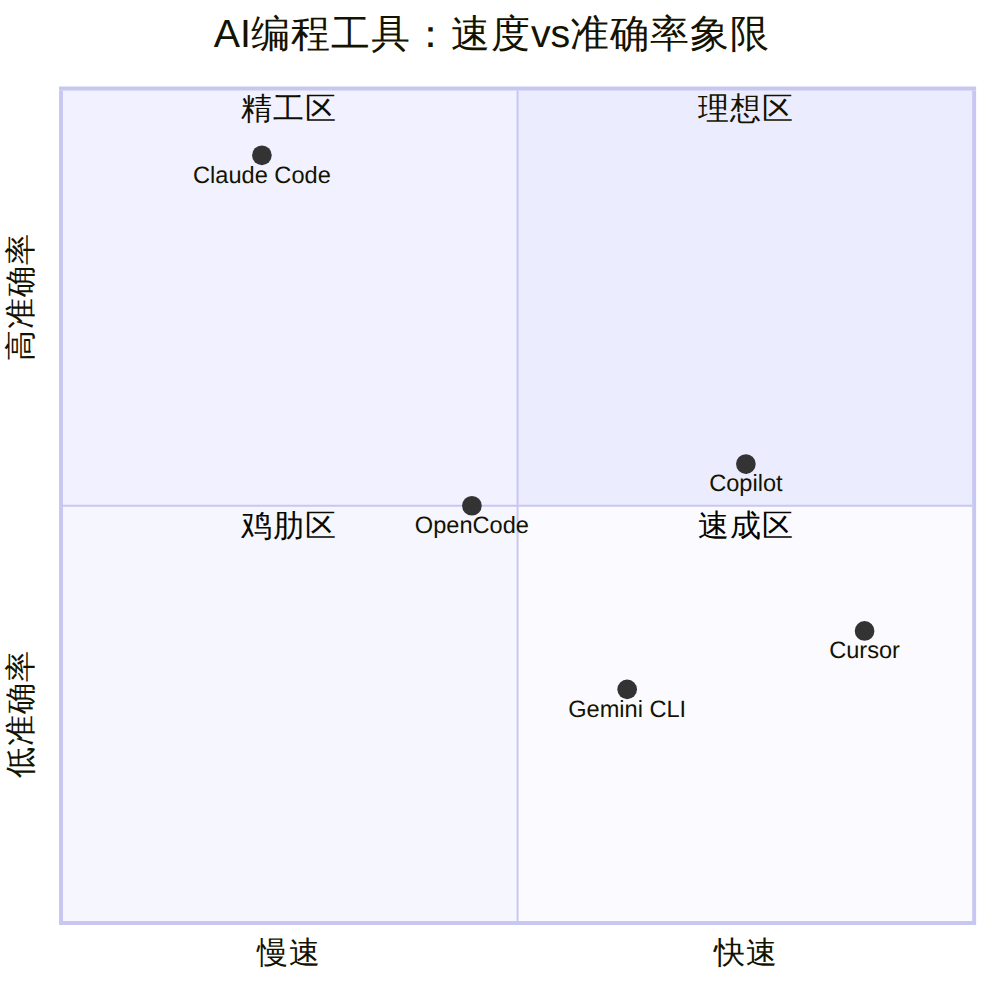
图表 3
Presenc AI 跟踪了 25+ 家企业的编码 Agent 部署数据,这是最接近真实场景的测量:
| 指标 | Claude Code | Cursor Agent | Devin |
|---|---|---|---|
| PR 接受率 | 48% | 42% | 38% |
| 中位任务耗时 | 14 分钟 | 8 分钟 | 22 分钟 |
| 中位代码行数/任务 | 120 行 | 80 行 | 180 行 |
| 提交前测试通过率 | 71% | 67% | 63% |
| 合并前迭代次数 | 1.4 次 | 1.2 次 | 1.8 次 |
Claude Code 的人均生产力数据: - 一位开发者将 6 个月的项目缩短到 2 个月完成(来自 bswen.com 案例) - Rakuten 报告 Claude Code 在数值计算任务上达到 99.9% 准确率
不同模型在实际编码任务中的表现差异巨大。基于 worldmetrics.org 2026 年报告整理:
| 模型 | HumanEval | SWE-bench Lite | Polyglot | LiveCodeBench |
|---|---|---|---|---|
| Opus 4.7 | 94%+ | ~78% | ~90% | ~94% |
| Sonnet 4.6 | 92% | ~72% | ~88% | ~93% |
| Haiku 4.5 | 75% | ~52% | ~73% | ~72% |
| Opus 3 (对比) | 87% | ~62% | ~83% | ~85% |
成本-性能曲线:Haiku 的价格约为 Opus 的 1/50,在简单任务上性能差距仅 15-20%。对于模板化代码生成、文档编写等场景,Haiku 是性价比之王。
根据实测数据,不同任务类型应路由到不同模型:
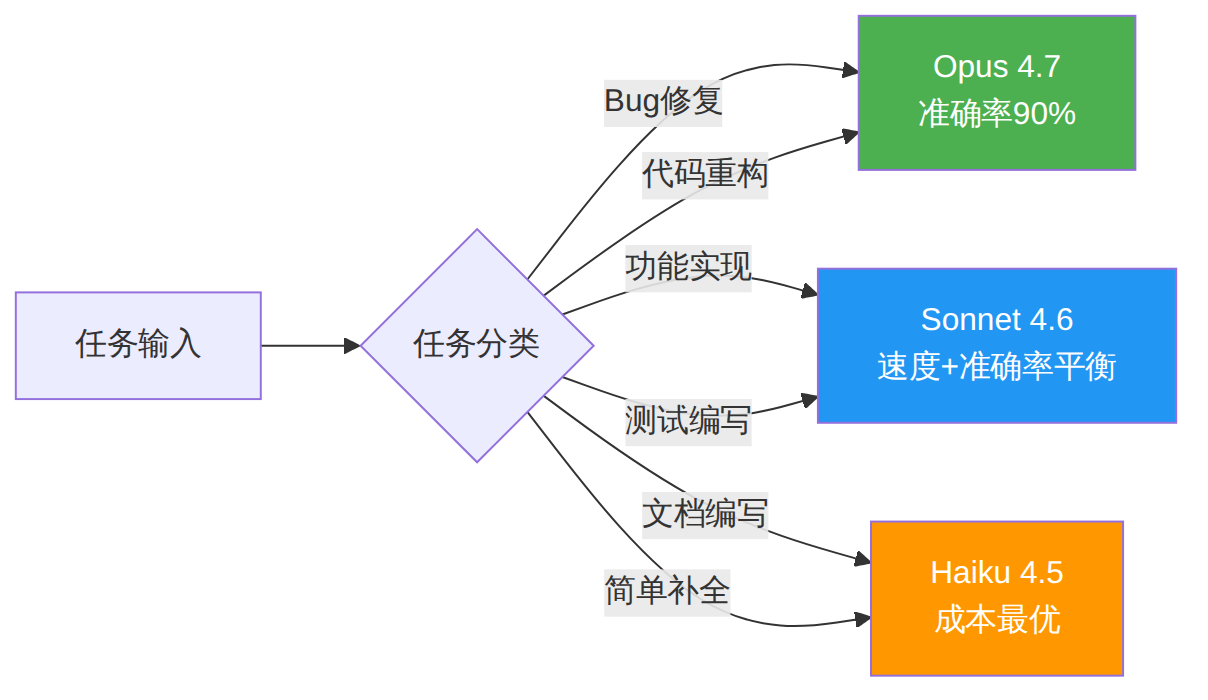
图表 4
在 CLAUDE.md 中配置路由规则:
# Model Routing Rules

## 使用 Opus 的场景
- 复杂 Bug 修复(涉及多个文件)
- 架构级重构
- 性能敏感代码优化

## 使用 Sonnet 的场景
- 常规功能实现
- 测试编写
- API 端点开发

## 使用 Haiku 的场景
- 文档生成与更新
- 简单配置修改
- 代码注释添加
- 重复性模板代码生成
执行时通过命令行切换:
# 复杂任务 -> Opus
claude --model claude-opus-4-7 -p "修复支付模块中的并发竞争条件"

# 常规任务 -> Sonnet(默认)
claude -p "给用户API添加分页功能"

# 简单任务 -> Haiku
claude --model claude-haiku-4-5 -p "给这个函数添加JSDoc注释"
来自中文开发者社区的实测数据揭示了 Token 消耗的关键规律:
同样一个功能,3K vs 30K Token 的差距在哪?
| 消耗来源 | 3K Token 方案 | 30K Token 方案 |
|---|---|---|
| 系统提示 + 工具 Schema | ~2,000 | ~20,000(未精简) |
| CLAUDE.md 加载 | ~500(精简版) | ~5,000(全量版) |
| 文件上下文 | ~300(精确指定文件) | ~3,000(让 AI 自己探索) |
| 代码输出 | ~200 | ~2,000(冗长解释) |
优化措施与效果:
# 措施1:精简 CLAUDE.md(从 5000 token 压到 800 token)
# 只保留核心规则,删除冗余说明

# 措施2:使用 MCP Tool Search(减少 85% 工具描述 Token)
claude config set mcpToolSearch true

# 措施3:精确指定文件路径(避免全局搜索)
# 差:claude -p "优化这个项目的性能"
# 好:claude -p "优化 src/services/payment.ts 中 processPayment 函数的性能"

# 措施4:启用 Prompt Caching(90% 折扣)
# 确保系统提示和 CLAUDE.md 跨会话不变
claude config set promptCaching true
实测效果(5万行 TypeScript 项目):
| 优化前 | 优化后 | 降幅 |
|---|---|---|
| 日均 Token 消耗 150K | 日均 Token 消耗 35K | -77% |
| 日均费用 $4.5 | 日均费用 $0.9 | -80% |
| 单任务平均 25K Token | 单任务平均 6K Token | -76% |
Claude Code 每次新会话启动需要加载约 50,000 Token 的"基础设施"(系统提示、工具定义、CLAUDE.md)。策略选择:
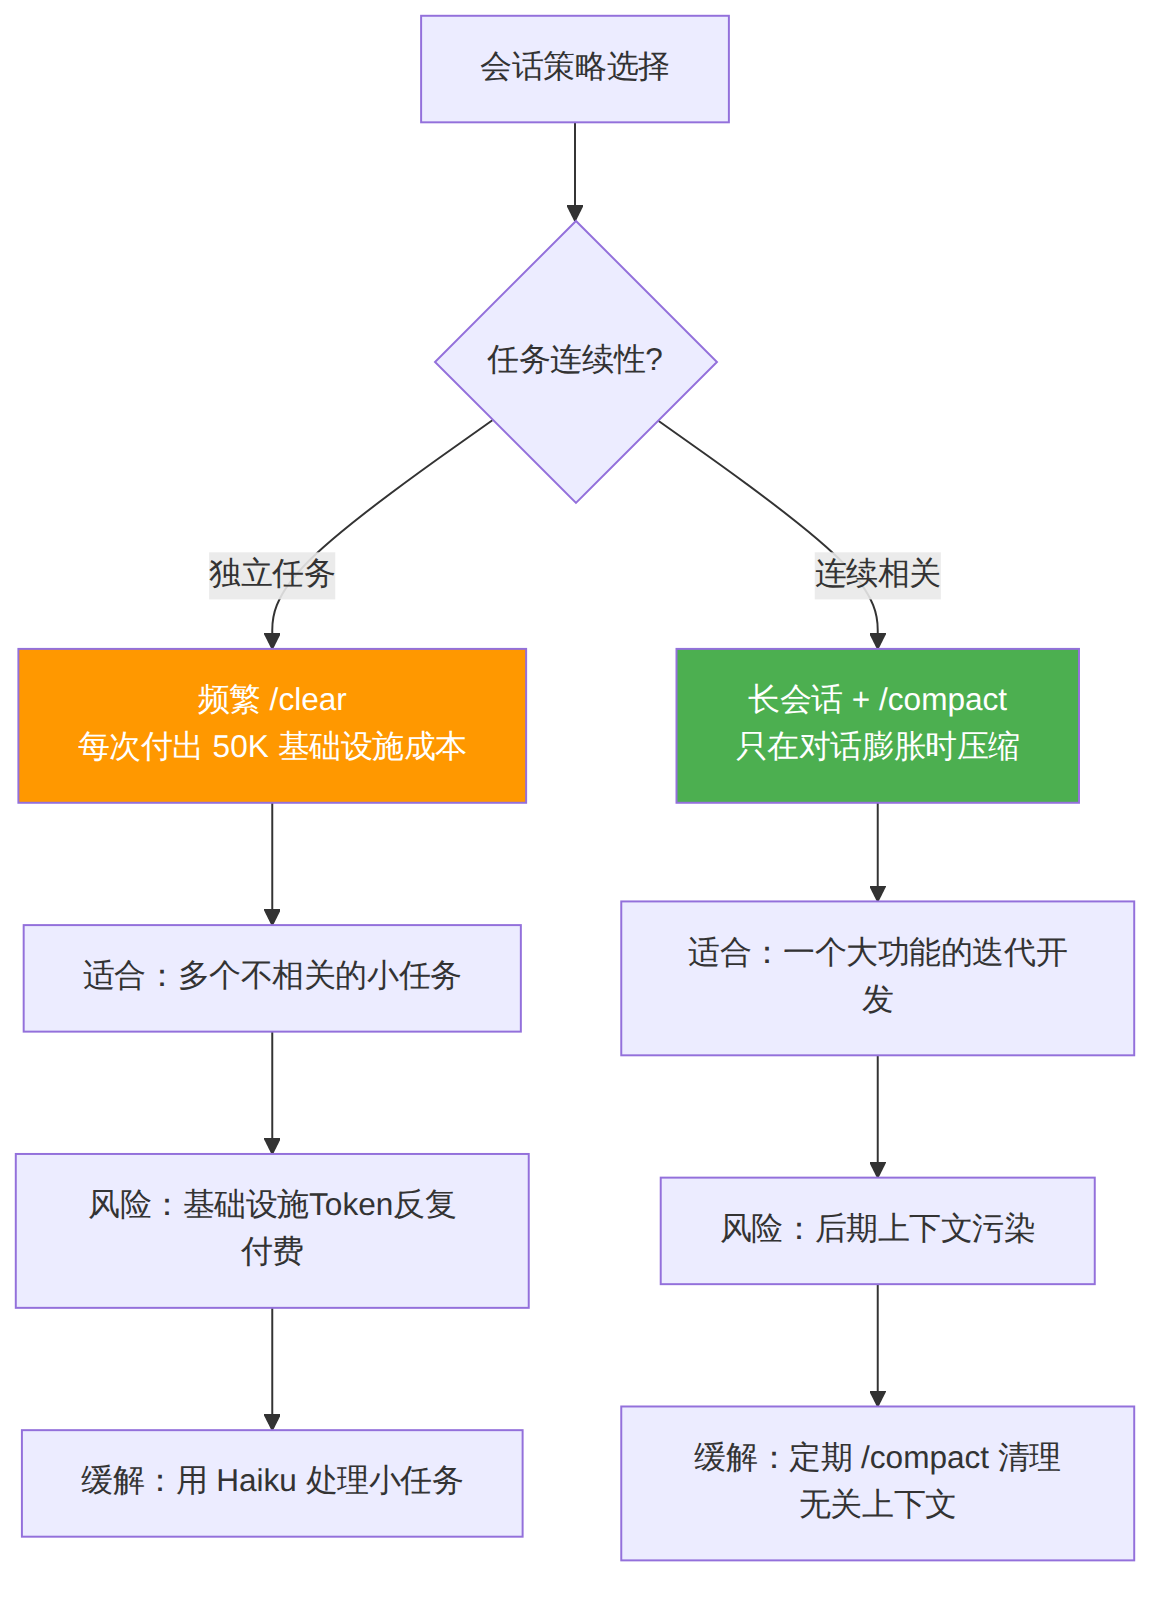
图表 5
Claude Code 平均每任务 18.6 秒,是 Cursor(8.2 秒)的 2.3 倍。以下技巧可缩小差距:
# 技巧1:并行子Agent(适用于多文件修改)
# 在 Claude Code 中使用 Task tool 分派独立任务
claude -p "使用并行Agent同时修改以下3个独立文件的错误处理:
- src/api/auth.ts
- src/api/users.ts
- src/api/orders.ts"

# 技巧2:预加载上下文(减少探索时间)
# 在 CLAUDE.md 中预置项目结构概要
echo "## 项目结构
- src/api/ — API路由(Express)
- src/models/ — 数据模型(Prisma)
- src/services/ — 业务逻辑
- tests/ — 测试文件" >> CLAUDE.md

# 技巧3:禁用不必要的思考(简单任务)
claude -p "添加一个简单的hello world端点" \
  --max-tokens 2000 \
  --no-extended-thinking

# 技巧4:使用 Background Agent(不阻塞主线程)
# 在 Claude Code 交互模式中按 Ctrl+B
# 或使用 -p 模式加 &
claude -p "重构整个认证模块" &
# 继续其他工作...
不要只看一个指标。构建你自己的五维评估框架:
图表 6
将以上所有测试整合为一个自动化流程:
#!/bin/bash
# comprehensive_benchmark.sh — 一键运行全维度基准测试

set -euo pipefail

PROJECT_DIR=$(pwd)
RESULTS_DIR="benchmark_results_$(date +%Y%m%d_%H%M%S)"
mkdir -p "$RESULTS_DIR"

echo "=== Claude Code 综合基准测试 ==="
echo "项目: $PROJECT_DIR"
echo "结果目录: $RESULTS_DIR"
echo ""

# 1. SWE-bench 子集测试(~2小时)
echo "[1/4] 运行 SWE-bench Verified 子集 (25个样本)..."
python -m swebench.harness.run_evaluation \
  --swe_bench_tasks verified_subset_25.jsonl \
  --predictions_path "$RESULTS_DIR/swebench_results.jsonl" \
  --timeout 600 2>&1 | tee "$RESULTS_DIR/swebench_log.txt"

# 2. 自建 PR 基准(~1小时)
echo "[2/4] 运行自建 PR 基准测试..."
bash run_custom_benchmark.sh "$RESULTS_DIR/custom"

# 3. Token 效率测试(~30分钟)
echo "[3/4] 测试 Token 效率..."
for model in opus-4-7 sonnet-4-6 haiku-4-5; do
  echo "  测试 claude-$model..."
  claude --model "claude-$model" -p "分析这个项目的架构并给出改进建议" \
    --output-format json \
    > "$RESULTS_DIR/token_${model}.json" 2>&1
done

# 4. 速度基准(~15分钟)
echo "[4/4] 速度基准测试..."
for i in $(seq 1 10); do
  START=$(date +%s%N)
  claude -p "在 src/benchmark.ts 中创建一个 fibonacci 函数" \
    --max-turns 3 \
    --output-format json \
    > "$RESULTS_DIR/speed_${i}.json" 2>&1
  END=$(date +%s%N)
  echo "  Run $i: $(( (END - START) / 1000000 ))ms"
done

# 汇总报告
echo ""
echo "=== 生成汇总报告 ==="
python generate_report.py "$RESULTS_DIR" > "$RESULTS_DIR/summary.md"
echo "报告已生成: $RESULTS_DIR/summary.md"
将基准测试纳入 CI/CD,每次升级 Claude Code 版本时自动跑分:
# .github/workflows/claude-benchmark.yml
name: Claude Code Benchmark

on:
  schedule:
    - cron: '0 2 * * 1'  # 每周一凌晨2点
  workflow_dispatch:

jobs:
  benchmark:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - name: Setup Claude Code
        run: npm install -g @anthropic-ai/claude-code
      - name: Run Custom Benchmark
        env:
          ANTHROPIC_API_KEY: ${{ secrets.ANTHROPIC_API_KEY }}
        run: |
          bash comprehensive_benchmark.sh
      - name: Upload Results
        uses: actions/upload-artifact@v4
        with:
          name: benchmark-results
          path: benchmark_results_*/
      - name: Post to Slack
        if: always()
        run: |
          curl -X POST "$SLACK_WEBHOOK" \
            -H 'Content-type: application/json' \
            -d "$(cat benchmark_results_*/slack_payload.json)"
基于全部实测数据,最终的决策矩阵:
| 你的场景 | 推荐工具 | 模型 | 理由 |
|---|---|---|---|
| 复杂 Bug 修复 | Claude Code | Opus | 90% 准确率,根因分析能力 |
| 快速原型开发 | Cursor | — | 8.2s 平均速度,2x 快于 Claude Code |
| 日常功能开发 | Claude Code | Sonnet | 准确率与速度的最佳平衡 |
| 文档编写 | Gemini CLI | — | 免费,文档类准确率 90% |
| 大规模重构 | Claude Code | Opus | 重构准确率 90%,远超 Cursor 的 65% |
| 成本敏感小任务 | Claude Code | Haiku | 成本仅为 Opus 的 1/50 |
| 多小时自主任务 | Devin | — | 专为长时间自主任务设计 |
| 企业 CI/CD 集成 | Codex Agent | — | 紧密 GitHub 集成,3x Token 效率 |
最高效的工作流不是用单一工具,而是组合使用:
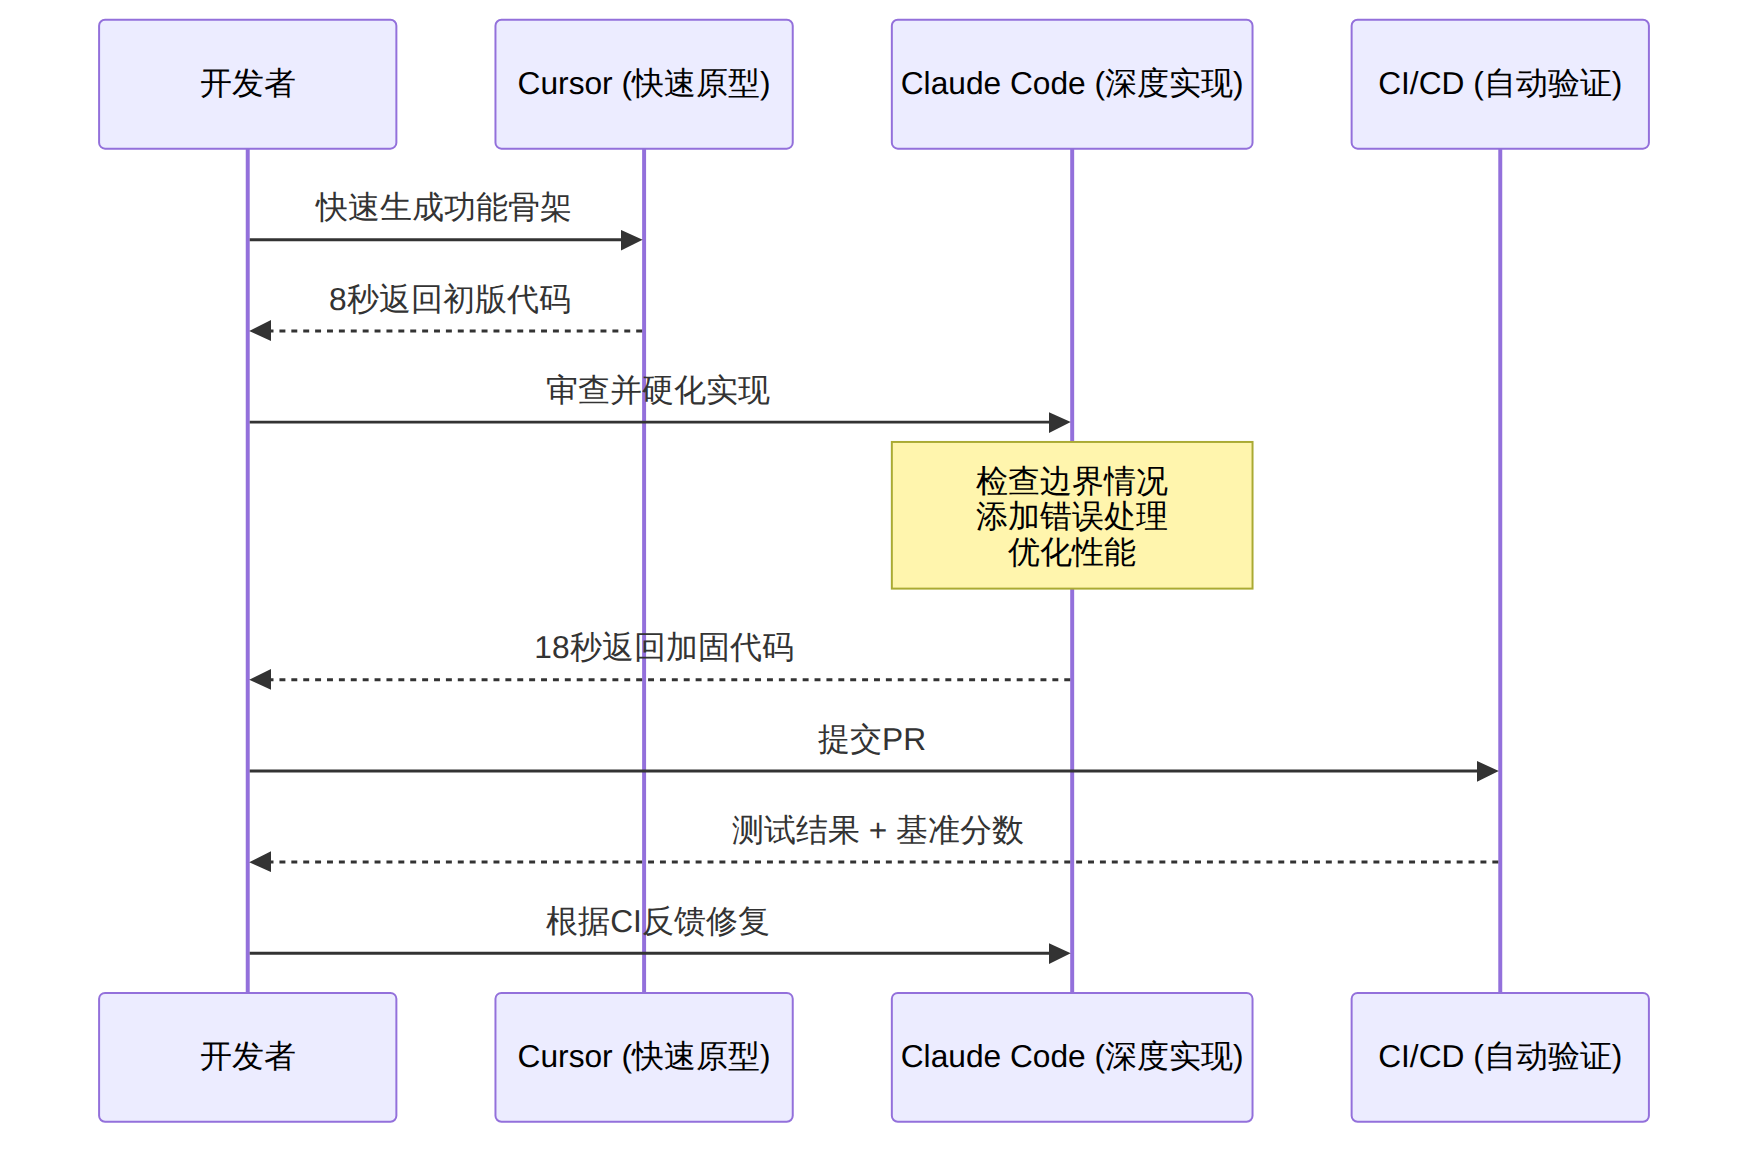
图表 7
这种混合策略将整体效率提升约 40%,综合准确率达到 85% 以上。
打印贴在显示器旁边:
┌──────────────────────────────────────────────┐
│        Claude Code 性能速查表                  │
├──────────────────────────────────────────────┤
│ SWE-bench Verified:  ~78% (Opus 4.7)        │
│ Terminal-Bench:      ~58%                    │
│ 50任务实测准确率:     89%                      │
│ 真实PR通过率:        ~48%                     │
│ 中位任务耗时:        14分钟                    │
│ 每任务Token消耗:     ~100K                    │
│ 每任务成本(BYOK):    $0.008                   │
│                                              │
│ 最强场景: Bug修复(90%)、重构(90%)             │
│ 最弱场景: UI生成(低于Cursor)                  │
│ 速度排名: 5工具中第5 (18.6s/任务)             │
│ 准确率排名: 5工具中第1 (89%)                   │
└──────────────────────────────────────────────┘
[!tip] 51学通信知识星球 星主:爱卫生(微信:gprshome201101)——公众号「51学通信」创办者,19 年通信行业运维与讲师经验,著有《GPRS网络信令实例详解》《EPC原理与实践》《5G核心网原理与实践》三本纸质书(各大电商平台有售)。 星球定位:深耕 5G 核心网、IMS、NFV/AI、云原生等 ICT 领域,主打运维岗位与信令分析。 当前规模:5200 篇主题 / 990 个回答,198 元/年。 加入福利:加入星球后请加爱卫生微信,拉您进知识星球年度陪伴与答疑群——不限量回复您的各种问题,另有群内分享。 AI 加持:51学通信知识星球已作为 skill 接入 WorkBuddy,使用 deepseek-4-flash 在海量星球帖子中精准找贴、找视频、找 FAQ 和案例,做总结、找文档和 PPT 等场景全覆盖。
