学习目标:掌握 Claude Code Skill 的完整开发流程——从理解 SKILL.md 规范、目录结构设计、触发条件编写,到团队分发与插件发布。读完本文后,你将能够独立创建一个功能完整、结构规范、可分享的自定义 Skill。
适用人群:已有 Claude Code 基础使用经验,希望将其能力扩展为可复用工作流的开发者、DevOps 工程师、技术团队负责人。
| 条件 | 说明 |
|---|---|
| Claude Code CLI | 已安装并完成基本配置(claude --version ≥ 1.0) |
| 终端环境 | macOS / Linux / WSL2,熟悉基本命令行操作 |
| 文本编辑器 | VS Code 或任意 Markdown 编辑器 |
| Git | 用于版本管理和团队分发 |
| 基础知识 | 理解 YAML frontmatter、Markdown 语法、Shell 脚本基础 |
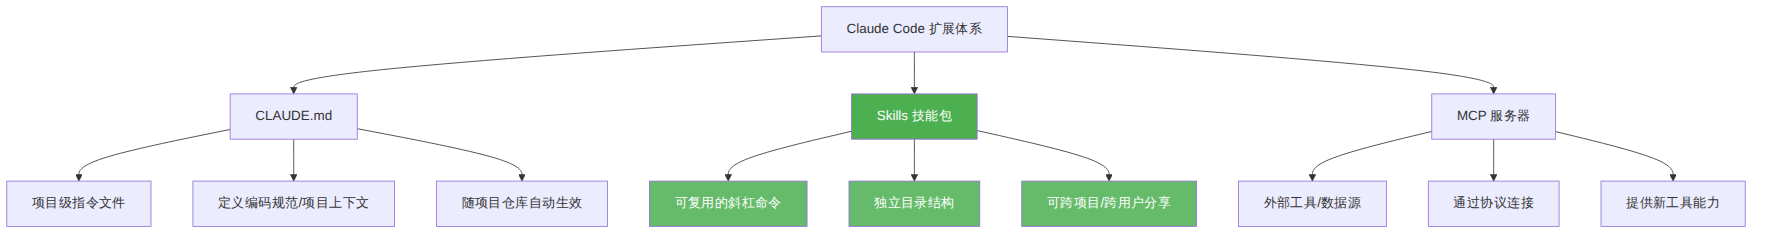
在 Claude Code 的扩展体系中,存在三种主要的扩展机制:
图表 1
Skill 的核心价值:将一个完整的、可重复的工作流打包成一个「斜杠命令」(如 /deploy、/review-pr),在任意项目中一键调用。与 CLAUDE.md 的"静态上下文"不同,Skill 是"动态能力"——它包含触发条件、执行步骤、错误处理,甚至可以附带脚本和参考资料。
一个典型的 Skill 调用场景:
你: /deploy
Claude: 使用 vercel-deploy skill 部署到 Vercel...
        ✓ 检测到 Next.js 项目
        ✓ 正在打包...
        ✓ 部署成功!
        Preview URL: https://my-app-abc123.vercel.app
每个 Skill 是 ~/.claude/skills/(全局)或 .claude/skills/(项目级)下的一个独立目录。标准结构如下:
my-skill/
├── SKILL.md              # 核心:Skill 定义文件(必需)
├── scripts/              # 可执行脚本
│   ├── deploy.sh
│   ├── fetch_data.py
│   └── utils/
│       └── helpers.sh
├── references/           # 参考文档(被 Skill 引用时自动加载到上下文)
│   ├── api-spec.md
│   ├── style-guide.md
│   └── templates/
│       └── config.yaml
└── assets/               # 静态资源
    ├── icons/
    └── examples/
关键规则:
~/.claude/skills/vercel-deploy/ 对应的命令是 /vercel-deploySKILL.md 是一个带 YAML frontmatter 的 Markdown 文件。它的每一部分都有严格的功能定位。
---
name: my-deploy-tool
description: |
  一键部署应用到云平台。支持 Vercel、Netlify、Cloudflare Pages。
  触发场景:(1) 用户说"部署"、"上线"、"发布" (2) 用户要求部署到特定平台
  (3) 用户说 /my-deploy-tool
  即使用户没有明确提到此技能名称,只要涉及部署操作,都应触发此技能。
metadata:
  short-description: 一键部署应用到云平台
---
字段说明:
| 字段 | 是否必需 | 说明 |
|---|---|---|
name |
是 | Skill 的唯一标识符,用于斜杠命令和技能发现 |
description |
是 | 详细描述 Skill 的功能和触发场景。这是 Claude 判断是否激活此 Skill 的关键依据 |
metadata |
否 | 扩展元数据,部分生态工具会读取 short-description |
触发场景写作技巧:
description 字段不仅是给人看的,更是 Claude 的"触发条件"。写好触发场景是 Skill 开发中最关键的设计决策之一。对比两种写法:
# ❌ 模糊——Claude 可能不知道何时该用
description: "部署工具"

# ✅ 精确——Claude 知道在什么场景下激活
description: |
  一键部署应用到 Vercel。触发场景:(1) 用户说"部署"、"deploy"、"上线"
  (2) 用户想获取预览 URL (3) 用户说 /vercel-deploy
frontmatter 之后的 Markdown 正文是 Claude 执行 Skill 时遵循的"操作手册"。Claude 会将这段内容作为系统指令的一部分来理解和执行。
正文的结构通常遵循以下模式:
# Skill 标题

简短概述此 Skill 做什么。

## 前提条件

- 列出执行前需要检查的环境和依赖

## 工作流程

### Step 1: 检查环境
- 具体操作指令
- 命令示例

### Step 2: 执行核心逻辑
- 分步骤的操作说明

### Step 3: 处理输出
- 如何呈现结果

## 注意事项

- 错误处理策略
- 兼容性说明

## 故障排除

| 问题 | 解决方案 |
|------|---------|
| ... | ... |
让我们创建一个实用的 Skill——代码审查助手(code-review-helper),它能自动分析 Git 变更并生成结构化审查报告。
# 全局 Skill 目录
mkdir -p ~/.claude/skills/code-review-helper/{scripts,references}
---
name: code-review-helper
description: |
  自动化代码审查工具。分析 Git 变更,生成结构化审查报告,涵盖安全漏洞、
  性能问题、代码风格、架构建议。
  触发场景:(1) 用户说"审查代码"、"review"、"代码检查"、"review PR"
  (2) 用户想在提交前检查代码质量 (3) 用户说 /code-review-helper
  (4) 用户完成了功能开发,请求代码审查
  即使用户没有明确提到此技能名称,只要涉及代码审查和质量检查,都应触发此技能。
metadata:
  short-description: 自动化代码审查与质量分析
---

# Code Review Helper

对当前分支的 Git 变更进行结构化代码审查,输出安全、性能、架构多维度分析报告。

## 工作流程

### Step 1: 确定审查范围

首先确认当前分支和变更文件:

```bash
git branch --show-current
git diff --name-status main...HEAD
git diff --stat main...HEAD
如果用户指定了特定 commit 或文件范围,使用相应参数。
如果没有 main 分支,回退到 origin/main 或 master。
# 获取完整 diff(排除二进制文件和 lock 文件)
git diff main...HEAD -- ':!*.lock' ':!*.binary' ':!package-lock.json'
如果 diff 过大(超过 2000 行),按文件分批读取:
1. 先用 git diff --stat 获取文件列表和行数
2. 按重要性排序(核心代码 > 测试 > 配置 > 文档)
3. 逐文件或分批审查
按照 references/review-checklist.md 中的检查清单逐项审查。 对每个文件依次分析以下维度:
安全审查(Security) - SQL 注入、XSS、命令注入风险 - 硬编码密钥/凭证 - 不安全的反序列化 - 权限校验缺失
性能审查(Performance) - N+1 查询问题 - 不必要的循环或递归 - 内存泄漏风险 - 缺少缓存策略
代码质量(Quality) - 命名规范一致性 - 函数长度和复杂度 - 重复代码 - 错误处理完整性
架构审查(Architecture) - 关注点分离 - 依赖方向是否合理 - 接口设计是否清晰
使用以下模板输出审查报告:
## 代码审查报告

**分支**: `branch-name`
**变更**: X 个文件, +Y/-Z 行
**审查结果**: 🟢 通过 / 🟡 建议修改 / 🔴 必须修改

### 🔴 必须修改 (N 项)

| # | 文件 | 行号 | 问题 | 严重性 |
|---|------|------|------|--------|
| 1 | src/api.ts | L42 | SQL 拼接导致注入风险 | Critical |

### 🟡 建议修改 (N 项)

| # | 文件 | 行号 | 建议 | 类别 |
|---|------|------|------|------|
| 1 | src/utils.ts | L15 | 可用 Map 替代 Object 查找 | Performance |

### 💡 架构建议 (N 项)

- 建议 1
- 建议 2

### ✅ 亮点

- 良好的实践 1
- 良好的实践 2
对每个 🔴 和 🟡 问题,提供: 1. 问题描述(1-2 句) 2. 修复代码片段 3. 修复后的验证方法
node_modules/、vendor/、*.lock、*.min.* 文件### Step 3: 创建参考文件
`references/review-checklist.md`:
```markdown
# 代码审查检查清单
## 安全检查项
- [ ] 输入验证:所有外部输入是否经过验证和清洗?
- [ ] SQL 参数化:是否使用参数化查询而非字符串拼接?
- [ ] XSS 防护:用户输入在渲染前是否转义?
- [ ] 认证授权:API 端点是否有适当的权限检查?
- [ ] 敏感数据:密码、密钥是否使用环境变量或密钥管理服务?
- [ ] CSRF 防护:表单提交是否有 CSRF token?
- [ ] 文件上传:上传文件类型和大小是否有限制?
## 性能检查项
- [ ] 数据库查询:是否有 N+1 查询?
- [ ] 缓存:热点数据是否有缓存策略?
- [ ] 异步处理:耗时操作是否使用异步?
- [ ] 分页:列表查询是否有分页?
- [ ] 内存管理:大对象是否及时释放?
## 代码质量检查项
- [ ] 单一职责:函数是否只做一件事?
- [ ] 命名:变量/函数名是否清晰表达意图?
- [ ] 复杂度:函数是否过长或嵌套过深?
- [ ] 错误处理:异常是否被正确捕获和处理?
- [ ] 类型安全:Typeany 类型是否被滥用?
## 架构检查项
- [ ] 分层:是否遵循项目的分层架构?
- [ ] 依赖方向:依赖是否指向正确的方向?
- [ ] 接口抽象:是否通过接口解耦?
- [ ] 循环依赖:模块间是否存在循环依赖?
# 确认文件结构正确
ls -la ~/.claude/skills/code-review-helper/
ls -la ~/.claude/skills/code-review-helper/references/

# 输出应显示:
# SKILL.md
# references/
# references/review-checklist.md
# scripts/
启动 Claude Code 并测试:
cd your-project
claude
在 Claude Code 中输入以下任意触发词:
/review
审查一下我的代码
帮我 review 这个分支
Claude 应该识别到 code-review-helper Skill 并按照你定义的流程执行代码审查。
Skill 的触发逻辑遵循一个关键原则:description 字段中的触发场景描述越精确,Claude 的匹配就越准确。
对比三个层级的触发设计:
# Level 1: 基础——依赖名称匹配
description: "代码审查工具"

# Level 2: 标准——列举关键词
description: |
  代码审查工具。触发场景:用户说"review"、"代码审查"、"review PR"

# Level 3: 精确——定义完整语义匹配
description: |
  自动化代码审查工具。分析 Git 变更,生成安全/性能/架构多维报告。
  触发场景:
  (1) 用户说"审查代码"、"review"、"代码检查"、"review PR"
  (2) 用户想在提交前检查代码质量
  (3) 用户说 /code-review-helper
  (4) 用户完成了功能开发,请求代码审查
  即使用户没有明确提到此技能名称,只要涉及代码审查和质量检查,都应触发此技能。
反模式——避免过度触发:
# ❌ 过于宽泛——任何编码任务都可能触发
description: |
  帮助用户写代码。触发场景:(1) 用户写代码 (2) 用户打开编辑器

# ✅ 聚焦特定工作流
description: |
  生成 Express.js REST API 脚手架。触发场景:
  (1) 用户说"创建 API"、"新建接口"、"scaffold API"
  (2) 用户需要 Express.js 项目初始化
references/ 中的文件不会自动加载到上下文中(那样会浪费 token),而是在 SKILL.md 的指令中按需引用。
策略一:大文件分块引用
## 执行审查

按照 references/review-checklist.md 中的检查清单逐项审查。
- 如果是前端项目,额外参考 references/frontend-rules.md
- 如果是后端 API 项目,额外参考 references/api-patterns.md
策略二:条件加载
## Step 2: 选择模板

根据项目类型读取对应模板:
- React 项目 → references/templates/react-component.md
- Vue 项目 → references/templates/vue-component.md
- 纯 HTML → references/templates/vanilla-html.md
策略三:知识库模式
某些 Skill 本质上是"领域知识包":
3gpp-5g-specs/
├── SKILL.md
└── references/
    ├── 23002-i00.md    # 3GPP TS 23.002 网络架构
    ├── 23502-i00.md    # 3GPP TS 23.502 5G流程
    ├── 23501-i00.md    # 3GPP TS 23.501 5G系统
    └── ...(1300+ 规范文档)
这种模式下,SKILL.md 充当"索引+检索策略",Claude 根据用户的问题选择性地读取对应规范文件。
scripts/ 提供了 Skill 的"执行层"——SKILL.md 定义"做什么",scripts 定义"怎么做"。
# SKILL.md 中的指令示例

## 部署

执行部署脚本:

```bash
bash scripts/deploy.sh [path]
如果遇到网络权限问题,使用 sandbox_permissions=require_escalated 重新执行。
**脚本设计最佳实践**:

1. **脚本应自包含**——不依赖外部环境变量,所需的参数通过命令行传入
2. **提供清晰的输出**——Claude 需要解析脚本输出来决定下一步操作
3. **结构化输出优先**——JSON 输出比纯文本更易解析

```bash
# ✅ 好的脚本输出——结构化且有状态
#!/bin/bash
echo '{"status":"success","url":"https://example.com","id":"abc123"}'

# ❌ 差的脚本输出——难以解析
#!/bin/bash
echo "It worked! Your site is live at https://example.com"
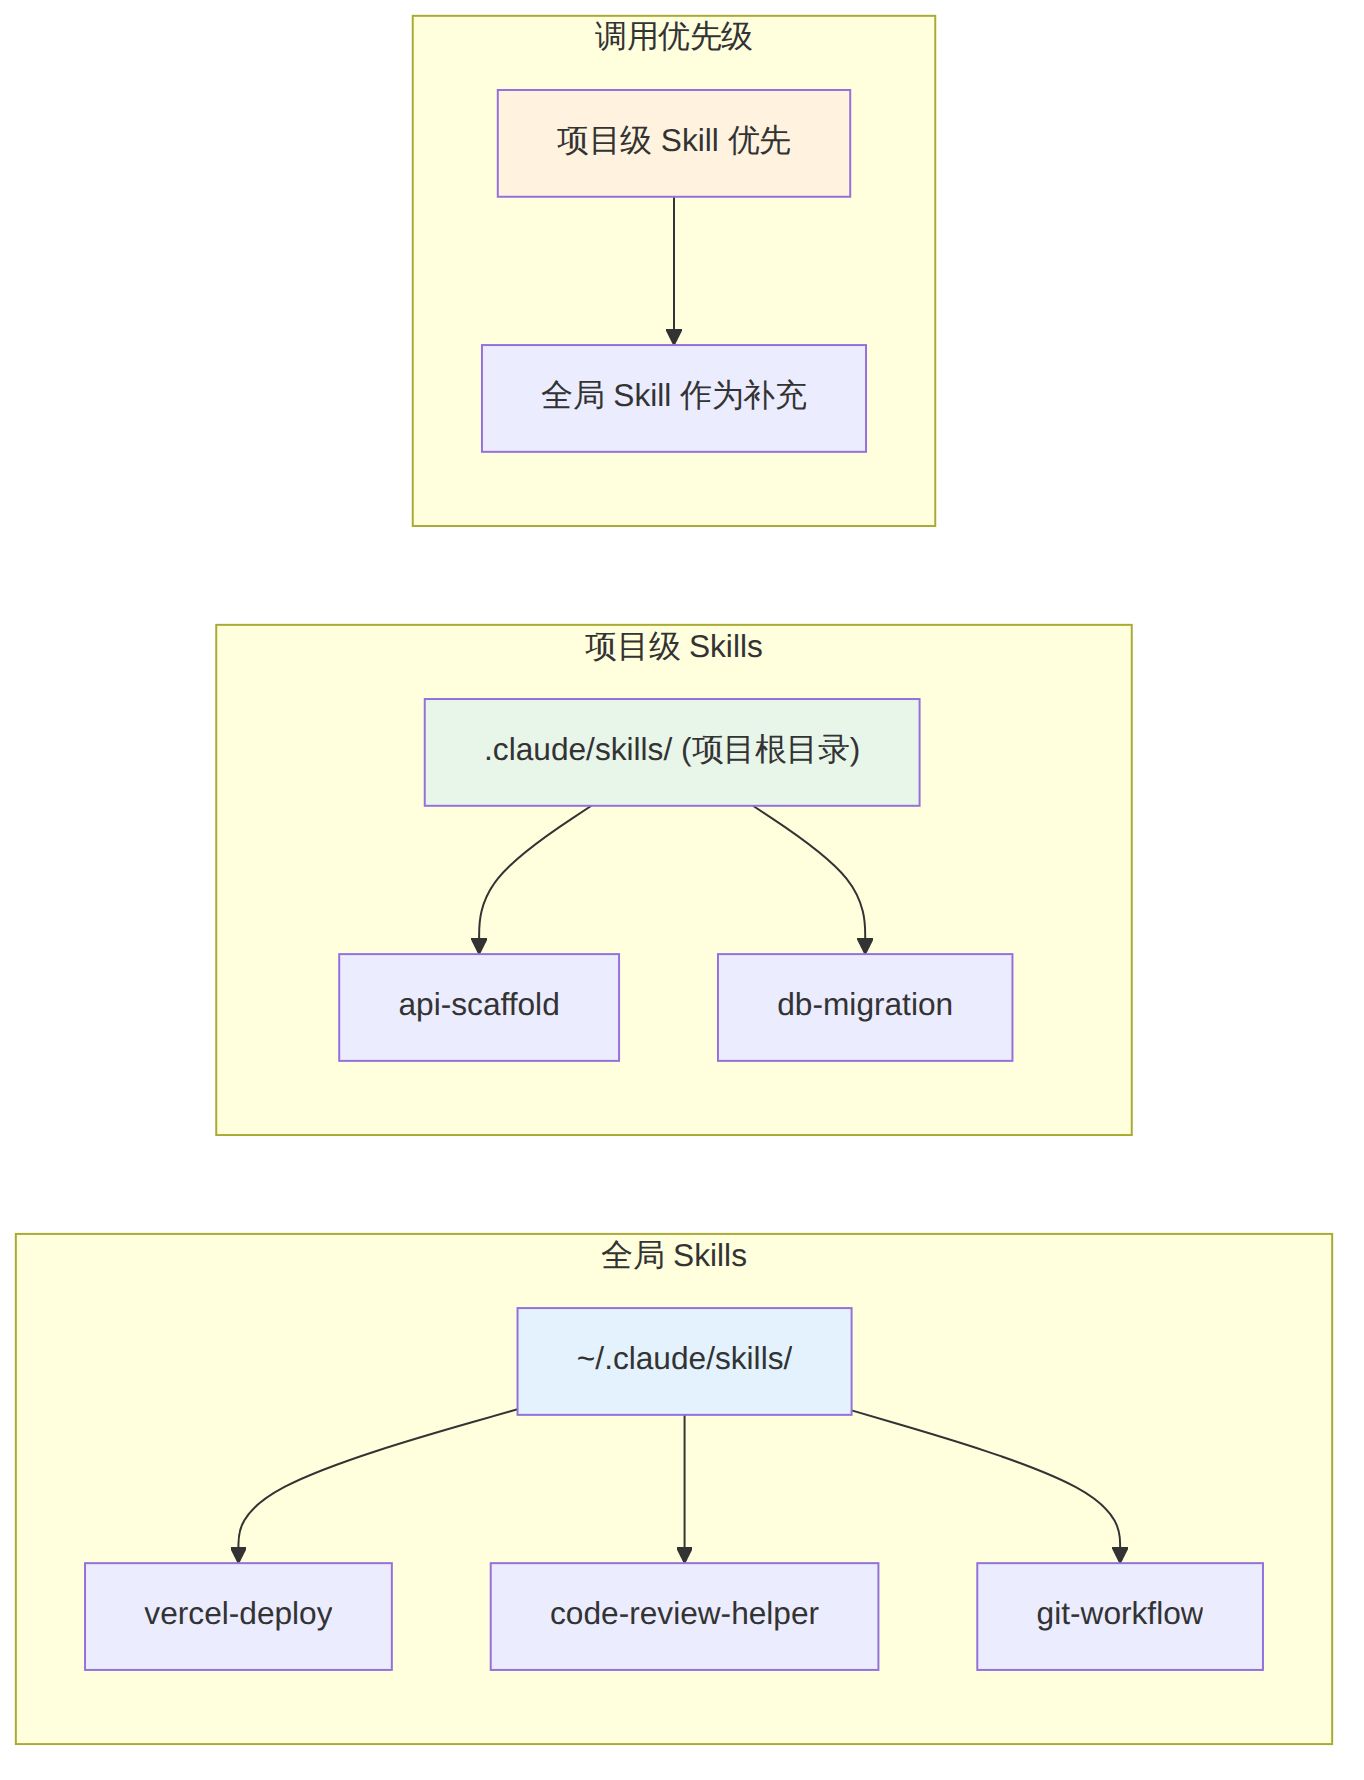
图表 2
| 维度 | 全局 Skill | 项目级 Skill |
|---|---|---|
| 路径 | ~/.claude/skills/ |
<project>/.claude/skills/ |
| 作用域 | 所有项目 | 仅当前项目 |
| 版本控制 | 通常独立 Git 管理 | 随项目仓库提交 |
| 适用场景 | 通用工作流(部署、审查) | 项目特定逻辑(API生成、迁移) |
| 分享方式 | Git 仓库 / 插件市场 | 随代码仓库 |
创建 Skill 后,按以下步骤验证:
# 1. 确认文件结构
find ~/.claude/skills/your-skill -type f

# 2. 验证 YAML frontmatter 语法
# 在 Claude Code 中启动新会话,检查 Skill 是否出现在可用列表
claude
# 输入: /your-skill-name

# 3. 测试触发词
# 在 Claude Code 中尝试不同的触发表达
"帮我审查代码"   → 应触发 code-review-helper
"检查一下代码质量" → 应触发 code-review-helper
"审查 PR"       → 应触发 code-review-helper
| 问题 | 原因 | 解决方案 |
|---|---|---|
Skill 未出现在 / 命令列表 |
SKILL.md 不在正确路径 | 检查路径是否为 .claude/skills/<name>/SKILL.md |
| Claude 不自动触发 | description 缺少触发场景 | 添加明确的 (1)...(2)...(3)... 格式触发条件 |
| Skill 执行偏差 | 正文指令不够具体 | 增加步骤编号、命令示例、输出格式模板 |
| Token 消耗过大 | references/ 文件过多 | 减少引用,改为按需加载策略 |
| 脚本执行失败 | 路径或权限问题 | 使用绝对路径,确认脚本有执行权限 (chmod +x) |
Skill 的开发是一个持续迭代的过程:
创建 Skill → 测试触发 → 观察行为 → 调整指令 → 再次测试
关键优化点:
## 注意事项

- **不要**修改未提及的文件
- **不要**自动执行 git commit(除非用户明确要求)
- **不要**跳过错误检查步骤
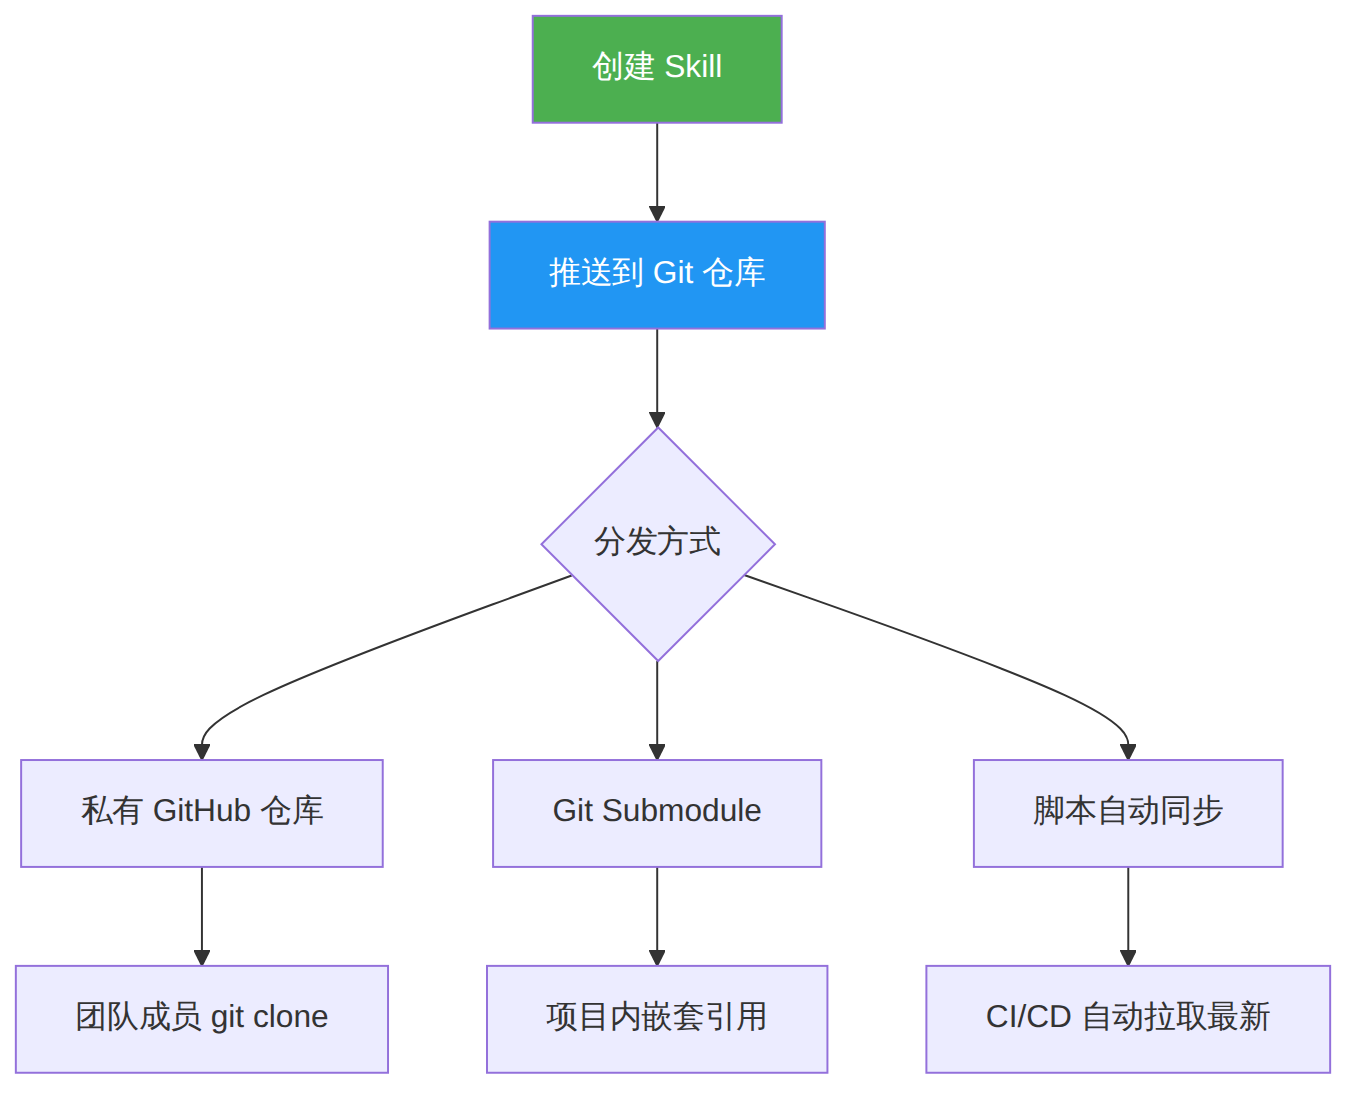
图表 3
方案一:独立私有仓库
# 1. 初始化 Skill 仓库
cd ~/.claude/skills
git init
git remote add origin [email protected]:your-org/team-skills.git

# 2. 团队成员克隆
git clone [email protected]:your-org/team-skills.git ~/.claude/skills

# 3. 日常同步(可以做成 Skill!)
cd ~/.claude/skills && git pull
方案二:项目级 Git Submodule
# 将共享 Skills 作为 submodule 嵌入项目
git submodule add [email protected]:your-org/team-skills.git .claude/skills
2026 年 Claude Code 引入了插件市场机制,允许将 Skills 打包为可安装的插件。
插件目录结构:
my-plugin/
├── plugin.json            # 插件清单(必需)
├── skills/
│   └── my-skill/
│       └── SKILL.md
├── agents/                # 可选:子代理定义
│   └── my-agent.md
├── commands/              # 可选:自定义命令
├── hooks/                 # 可选:生命周期钩子
└── README.md
plugin.json 示例:
{
  "name": "my-team-tools",
  "version": "1.0.0",
  "description": "团队共享的开发工具集",
  "author": "your-name",
  "skills": ["skills/my-skill"],
  "marketplace": {
    "source": "git",
    "url": "https://github.com/your-org/my-plugin"
  }
}
对于面向社区的插件,可以通过 npm 发布:
{
  "name": "@your-scope/claude-plugin-my-tools",
  "version": "1.0.0",
  "description": "Claude Code plugin for ...",
  "main": "plugin.json",
  "files": ["skills/**", "scripts/**", "references/**", "plugin.json"]
}
以下是一个完整的、可直接使用的 Skill——从 OpenAPI/Swagger 规范自动生成项目代码和文档。
api-docs-generator/
├── SKILL.md
├── scripts/
│   └── parse-openapi.py
└── references/
    └── output-template.md
---
name: api-docs-generator
description: |
  从 OpenAPI/Swagger 规范文件自动生成 API 文档和 TypeScript 接口定义。
  触发场景:(1) 用户说"生成API文档"、"解析Swagger"、"OpenAPI文档"
  (2) 用户提供了 openapi.yaml/swagger.json 文件
  (3) 用户想从 API 规范生成代码 (4) 用户说 /api-docs-generator
metadata:
  short-description: OpenAPI/Swagger 文档和代码生成
---

# API Docs Generator

从 OpenAPI 3.x / Swagger 2.x 规范文件生成结构化文档和 TypeScript 类型定义。

## Step 1: 定位规范文件

在项目根目录搜索规范文件:

```bash
find . -maxdepth 3 -type f \( -name "openapi.yaml" -o -name "openapi.yml" -o -name "swagger.yaml" -o -name "swagger.json" -o -name "openapi.json" \) 2>/dev/null
如果找到多个文件,询问用户选择哪一个。 如果没有找到文件,询问用户是否要手动指定路径或从 URL 下载。
读取规范文件内容,解析以下信息: 1. API 标题、版本、描述、服务器地址 2. 所有端点(路径 + 方法 + 描述) 3. 请求/响应 Schema 4. 认证方式 5. 标签分组
按照 references/output-template.md 模板生成 Markdown 文档。
文档包含以下部分: 1. API 概览:标题、版本、Base URL、认证方式 2. 端点列表表格:方法、路径、描述、标签 3. 详细端点文档:每个端点的请求参数、请求体、响应体 4. 数据模型:所有 Schema 定义 5. TypeScript 接口:从 Schema 自动生成
为每个 Schema 生成对应的 TypeScript interface:
// 从 OpenAPI schema:
//   User:
//     type: object
//     properties:
//       id: { type: string, format: uuid }
//       name: { type: string }
//       email: { type: string, format: email }

// 生成:
export interface User {
  id: string;
  name: string;
  email: string;
}
docs/api.mdsrc/types/api.ts### references/output-template.md
```markdown
# API 文档输出模板
## 文档头部
```markdown
# {api_title} API 文档
> 版本: {version} | Base URL: {server_url}
## 认证
{auth_type}: {auth_description}
---
## 端点总览
| 方法 | 路径 | 描述 | 标签 |
|------|------|------|------|
| GET | /users | 获取用户列表 | Users |
| POST | /users | 创建用户 | Users |
### {METHOD} {path}

{description}

**请求参数**

| 参数 | 位置 | 类型 | 必需 | 描述 |
|------|------|------|------|------|
| id | path | string | 是 | 用户ID |

**请求体**

```json
{
  "name": "string",
  "email": "string"
}
响应
| 状态码 | 描述 | Schema |
|---|---|---|
| 200 | 成功 | User |
| 400 | 参数错误 | Error |
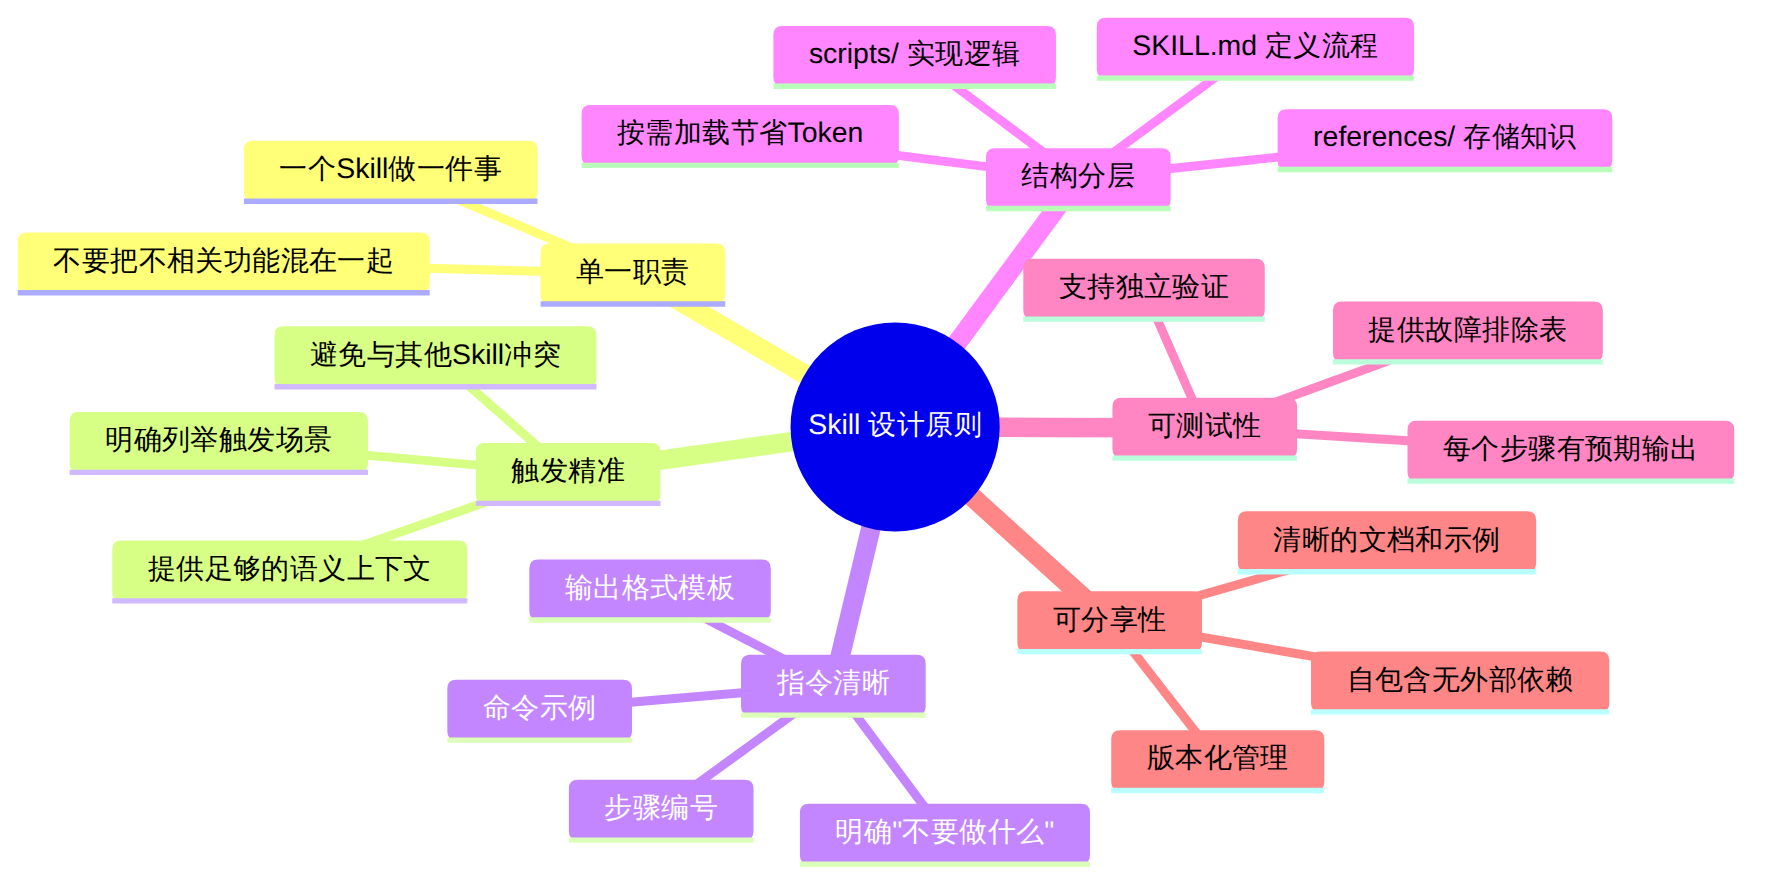
图表 4
五大核心原则:
| 维度 | 评估 |
|---|---|
| 适合训练营类型 | AI 工具实战营、DevOps 自动化训练营、开发者生产力提升班 |
| 建议教学时长 | 3-4 小时(含动手实操) |
| 前置知识要求 | Claude Code 基础使用(Round 1 内容)、Git 基础、Markdown 基础 |
| 实操环节 | 创建 code-review-helper Skill → 测试触发 → 迭代优化 → 团队分享(约 90 分钟) |
| 难度评级 | 中等(概念简单,但写出高质量的 SKILL.md 需要实践) |
[!tip] 51学通信知识星球 星主:爱卫生(微信:gprshome201101)——公众号「51学通信」创办者,19 年通信行业运维与讲师经验,著有《GPRS网络信令实例详解》《EPC原理与实践》《5G核心网原理与实践》三本纸质书(各大电商平台有售)。 星球定位:深耕 5G 核心网、IMS、NFV/AI、云原生等 ICT 领域,主打运维岗位与信令分析。 当前规模:5200 篇主题 / 990 个回答,198 元/年。 加入福利:加入星球后请加爱卫生微信,拉您进知识星球年度陪伴与答疑群——不限量回复您的各种问题,另有群内分享。 AI 加持:51学通信知识星球已作为 skill 接入 WorkBuddy,使用 deepseek-4-flash 在海量星球帖子中精准找贴、找视频、找 FAQ 和案例,做总结、找文档和 PPT 等场景全覆盖。
