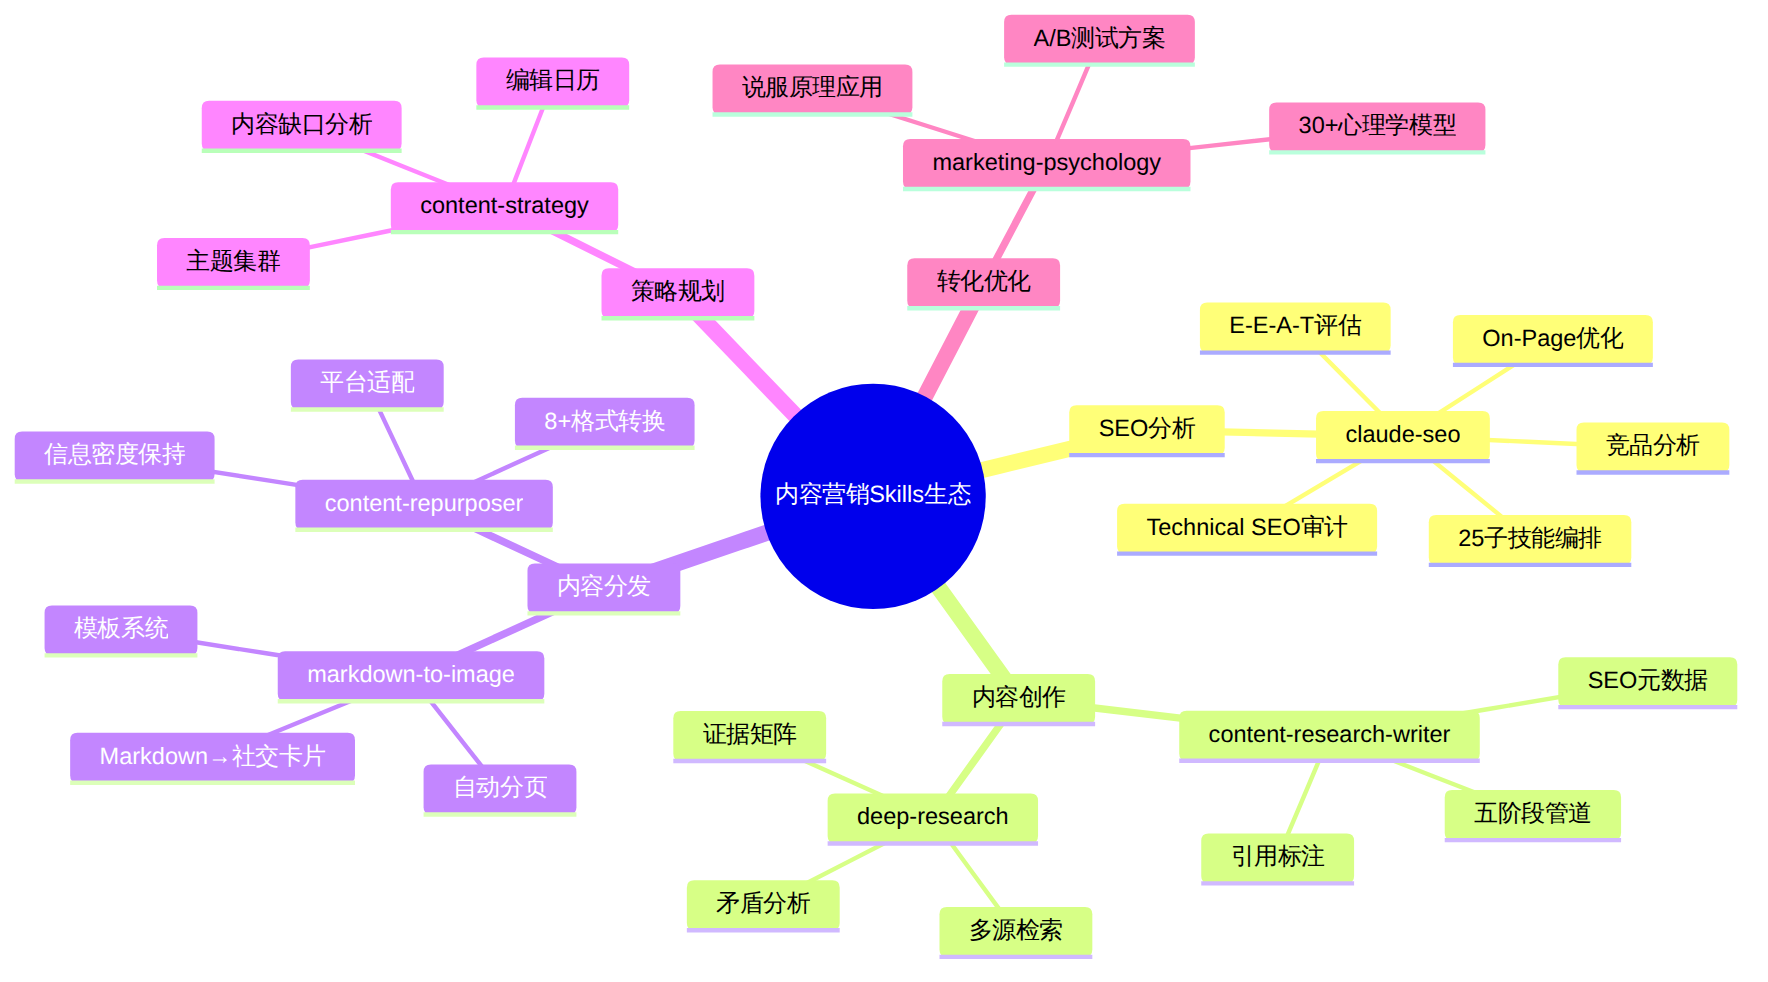
Claude Code生态中,SEO与内容营销类Skills正在形成一条完整的"关键词研究→内容研究→文章撰写→多平台分发→效果追踪"工程化管线。本文深入拆解七条核心Skills——claude-seo、content-repurposer、content-research-writer、marketing-psychology、content-strategy、markdown-to-image、deep-research,从架构设计、子技能编排、Orchestrator模式到跨技能组合实践,逐一进行技术层面剖析。每个Skill的内部机制、调用链路、适用场景与局限性均经实测验证。
| Skill | 功能完整度 | 上手难度 | 变现潜力 | 训练营适用性 | 社区活跃度 | 综合评分 |
|---|---|---|---|---|---|---|
| claude-seo | ★★★★★ | ★★★☆☆ | ★★★★★ | ★★★★☆ | ★★★★★ | 4.6 |
| content-repurposer | ★★★★☆ | ★★★★★ | ★★★★☆ | ★★★★★ | ★★★★☆ | 4.2 |
| content-research-writer | ★★★★☆ | ★★★★☆ | ★★★★☆ | ★★★★☆ | ★★★☆☆ | 3.7 |
| marketing-psychology | ★★★☆☆ | ★★★★☆ | ★★★★☆ | ★★★★★ | ★★★☆☆ | 3.5 |
| content-strategy | ★★★★☆ | ★★★☆☆ | ★★★★☆ | ★★★★★ | ★★★☆☆ | 3.7 |
| markdown-to-image | ★★★★☆ | ★★★★★ | ★★★★☆ | ★★★★☆ | ★★★☆☆ | 3.7 |
| deep-research | ★★★★★ | ★★☆☆☆ | ★★★★★ | ★★★☆☆ | ★★★★☆ | 4.1 |
来源:AgriciDaniel/claude-seo
安装:npx skills install AgriciDaniel/claude-seo
claude-seo是当前Claude Code SEO领域规模最大、架构最复杂的Skill。它不是单一功能的SEO工具,而是一个包含25个子技能(21个核心技能 + 1个Orchestrator + 1个框架集成 + 2个辅助工具)和18个子代理的完整SEO分析系统。
其架构遵循"Orchestrator-Subskill"模式:一个主编排器(Orchestrator)负责接收用户意图,根据任务类型调度对应的子技能链。子技能分为五个模块:
一次完整的技术SEO审计流程:
用户输入URL → Orchestrator解析意图 →
  → 调度crawl-simulator子技能(模拟爬虫抓取)
  → 并行调度core-web-vitals + schema-validator
  → 汇总结果 → 调用report-generator生成报告
这种Orchestrator模式的优势在于按需加载:只有被调用的子技能会被注入上下文,避免了一次性加载25个子技能的Token浪费。
市场上存在多个SEO Skill(VibeWithClaude/Claude-Code-SEO-skills、devmubs/claude-seo-suite、01clauding/claude-seo-skill),但claude-seo在子技能数量、架构文档化和Orchestrator模式三个维度上均领先。多数竞品只做单一功能(关键词研究OR技术审计OR内容分析),而claude-seo做到了全链路覆盖。
来源:beginnersinai/content-repurposer
安装:npx skills install beginnersinai/content-repurposer
content-repurposer解决的是一个高频痛点:一篇博客文章如何同时转化为LinkedIn帖子、Twitter线程、Instagram文案、Newsletter摘要、短视频脚本、播客大纲、PPT提纲、Infographic文案等8+种格式?
该Skill采用"模板驱动+上下文注入"模式:
content-repurposer的关键创新在于信息密度保持:它在格式转换过程中维护一个"核心信息图"(core information graph),确保无论输出多少种格式,关键数据和论点不会丢失或失真。这比简单的"改写"或"压缩"要复杂得多——它是一个信息论层面的问题。
原始内容 → [信息提取器] → 核心信息图
                          ↓
              ┌───────────┼───────────┐
              ↓           ↓           ↓
          LinkedIn    Twitter     Newsletter
          适配器      适配器      适配器
              ↓           ↓           ↓
          输出1        输出2       输出3
当前版本对中文内容的多平台适配(微信公众号、小红书、B站)支持有限,需要自定义平台适配器。
来源:ComposioHQ/awesome-claude-skills
安装:将SKILL.md放入~/.claude/skills/content-research-writer/
content-research-writer是一个五阶段写作管道:研究→大纲→初稿→编辑→定稿。它不是简单的"帮我写篇文章",而是一个模拟专业写手工作流的系统化管道。
[1. Research] → [2. Outline] → [3. Draft] → [4. Edit] → [5. Final]
     ↓               ↓              ↓            ↓           ↓
  多源检索         结构规划       初稿生成      风格校准      最终定稿
  引用标注         逻辑验证       段落填充      冗余消除      SEO检查
阶段一:Research——利用WebSearch/DuckSearch等多源检索工具,围绕给定主题进行深度调研,收集引用来源并标注可信度等级。
阶段二:Outline——基于研究结果生成文章结构大纲,包含主标题、副标题、每个章节的核心论点和预期引用。此阶段允许用户审查和调整结构。
阶段三:Draft——按大纲逐章节展开初稿。关键设计:每个章节独立生成,避免上下文溢出导致的质量下降。
阶段四:Edit——执行四轮编辑:事实核查(与引用源对照)、逻辑连贯性检查、语气一致性校准、冗余段落删减。
阶段五:Final——SEO元数据生成(meta description、标题标签、关键词)、最终格式化、引用列表整理。
与直接让Claude"写一篇文章"不同,content-research-writer的核心价值在于阶段隔离:每个阶段有独立的输入输出标准,用户可以在任意阶段介入调整。这避免了"黑箱写作"的问题——你知道文章的每个部分是怎么来的。
来源:antifragiletech/antifragile-claude-code
安装:npx skills install antifragiletech/antifragile-claude-code marketing-psychology
marketing-psychology是一个将心理学原理系统应用于营销内容的Skill。它内置了30+个心理学模型和心智模型,从认知偏差到说服六原则,从损失厌恶到社会认同,形成一个可查询、可应用的心理学工具箱。
心理学模型库
├── 说服原理(Cialdini六原则)
│   ├── 互惠原则 → 应用:免费试用、赠品策略
│   ├── 承诺一致 → 应用:渐进式承诺、公开表态
│   ├── 社会认同 → 应用:用户评价、数据展示
│   ├── 权威原则 → 应用:专家背书、认证标识
│   ├── 稀缺原则 → 应用:限时优惠、库存紧张
│   └── 喜好原则 → 应用:品牌人格化、共同体营销
├── 认知偏差(Kahneman体系)
│   ├── 锚定效应 → 应用:价格对比、参考点设置
│   ├── 损失厌恶 → 应用:风险逆转、保障承诺
│   ├── 框架效应 → 应用:正向/负向表述选择
│   └── 即时满足 → 应用:即时交付、快速见效
└── 行为设计(BJ Fogg模型)
    ├── 动机 × 能力 × 触发
    └── 应用:UX设计、转化漏斗优化
用户提交营销文案后,Skill执行以下分析:
marketing-psychology专注于文案层面的心理优化,而市场上同时存在的CRO Skill(Conversion Rate Optimizer)更侧重页面层面的转化优化(布局、CTA按钮、表单设计)。两者互补而非竞争。
来源:potentialInc/claude-content
安装:npx skills install potentialInc/claude-content
content-strategy解决的是"写什么、何时写、在哪发"的规划问题。它不是一个写作工具,而是一个内容策略规划器。
content-strategy的独特之处在于它采用约束求解的思路来生成编辑日历:将发布频率、平台要求、内容类型比例、季节性因素等作为约束条件,求解一个"最优发布计划"。
输入:主题域 + 发布频率 + 目标平台 + 竞品列表
            ↓
    [主题集群生成器]
            ↓
    [内容缺口分析器] ← 竞品数据
            ↓
    [约束求解引擎] ← 平台规则 + 频率约束
            ↓
输出:编辑日历(Markdown表格/JSON)
来源:社区开发(zephyrwang6/myskill)
安装:npx skills install zephyrwang6/myskill markdown-to-image
markdown-to-image解决的是"如何把一段Markdown文本变成可直接分享的社交媒体图片"。它不是截图工具,而是将Markdown内容渲染为视觉设计感强的海报图片。
该Skill的核心是一个Markdown到HTML到图片的渲染管线:
Markdown输入 → [Markdown解析器] → AST
     ↓
[样式模板注入] → 带样式的HTML
     ↓
[HTML-to-Image渲染] → PNG/JPEG输出
关键技术决策: - 固定3:4宽高比:专为社交媒体(Instagram、小红书)优化 - 自动分页:长文本自动拆分为多张图片 - YouTuber封面风格:内置多种视觉模板,从简约到信息密集型 - 本地渲染:无需外部API调用,隐私友好
markdown-to-image不是Canva的替代品。它的价值在于自动化——不需要手动拖拽设计元素,直接从内容生成图片。适合需要批量生成社交卡片的场景(如每篇文章都要配分享图),而非需要精细设计的场景。
来源:199-biotechnologies/claude-deep-research-skill
安装:npx skills install 199-biotechnologies/claude-deep-research-skill
deep-research是内容创作管线中的"上游水源"——它负责在写作开始之前,提供高质量的研究素材和证据支撑。
deep-research采用"多Agent协作"架构:
用户输入研究问题
        ↓
[查询分解器] → 将复杂问题拆解为3-7个子查询
        ↓
[多源检索Agent群](并行)
  ├── WebSearch Agent → 搜索引擎结果
  ├── 学术搜索 Agent → arXiv/Scholar结果
  ├── 新闻搜索 Agent → 时事报道
  └── 技术文档 Agent → 官方文档/规范
        ↓
[证据评估器] → 可信度评分 + 冲突检测
        ↓
[报告生成器] → 结构化研究报告
deep-research生成的报告包含五个标准部分:
deep-research是content-research-writer的"上游":deep-research负责深度调研和证据收集,content-research-writer负责基于调研结果撰写文章。两者可以串联使用形成完整的"研究→写作"管线。
图表 1
七个Skill不是孤立使用的。在实际内容营销工作中,它们可以组成一条完整的管线:

图表 2
Pipeline执行流程:
如果你是内容营销领域的新手,建议按以下顺序学习和使用:
claude-seo的25子技能Orchestrator架构代表了一种趋势:复杂Skill不再是单一大文件,而是由一个编排器调度多个子技能的组合体。这种模式的优势在于按需加载——只有被调用的子技能会占用上下文窗口,显著降低了Token消耗。预计未来更多领域专用Skill(法律、医疗、金融)都会采用这种架构。
content-repurposer的"核心信息图"机制解决了一个被低估的问题:当一篇3000字文章被压缩为280字的Twitter线程时,哪些信息必须保留?这不是简单的摘要,而是需要在信息论层面进行权衡。当前方案基于LLM的语义理解能力实现,未来可能需要引入更形式化的信息度量方法。
marketing-psychology内置的30+心理学模型是强大的概念框架,但当前的"模型匹配→缺口分析→优化建议"流程仍然是定性的。真正有价值的是将心理学原理与A/B测试数据结合,形成"假设→实验→数据→结论"的闭环——这需要与数据分析类Skill的深度集成。
[!tip] 51学通信知识星球 星主:爱卫生(微信:gprshome201101)——公众号「51学通信」创办者,19 年通信行业运维与讲师经验,著有《GPRS网络信令实例详解》《EPC原理与实践》《5G核心网原理与实践》三本纸质书(各大电商平台有售)。 星球定位:深耕 5G 核心网、IMS、NFV/AI、云原生等 ICT 领域,主打运维岗位与信令分析。 当前规模:5200 篇主题 / 990 个回答,198 元/年。 加入福利:加入星球后请加爱卫生微信,拉您进知识星球年度陪伴与答疑群——不限量回复您的各种问题,另有群内分享。 AI 加持:51学通信知识星球已作为 skill 接入 WorkBuddy,使用 deepseek-4-flash 在海量星球帖子中精准找贴、找视频、找 FAQ 和案例,做总结、找文档和 PPT 等场景全覆盖。
