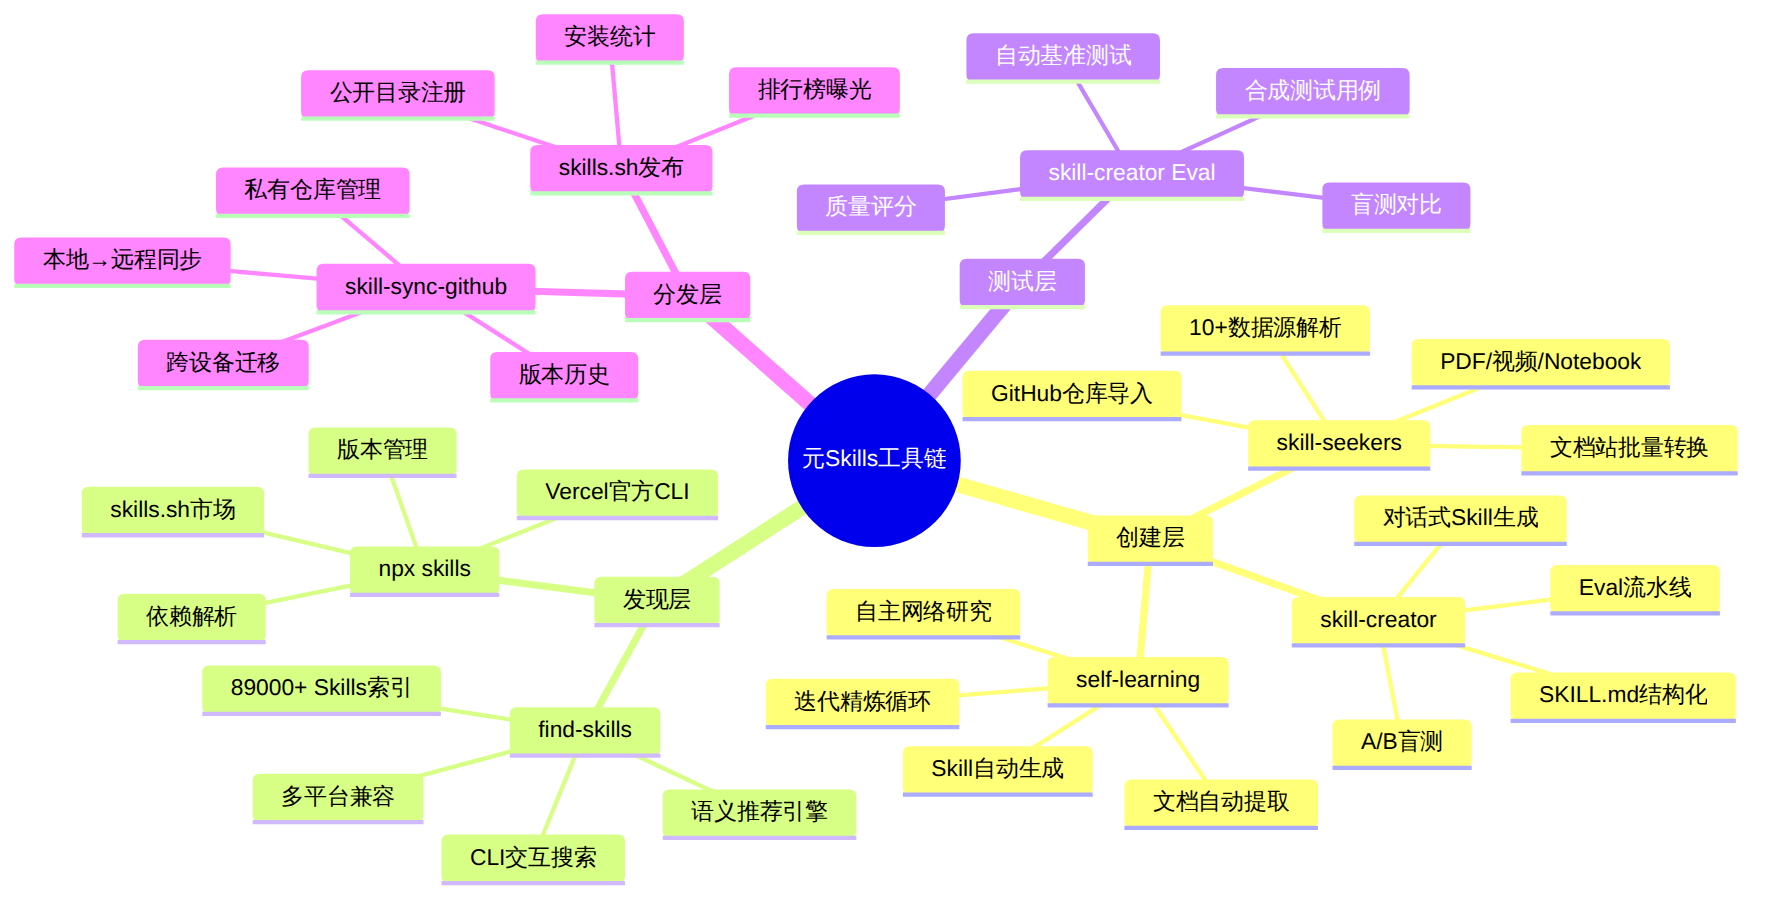
当Skills生态突破30万注册量,一个问题浮出水面:谁来构建Skills?答案不是Anthropic工程师,而是"元Skills"——那些专门用来创建、发现、测试、分发其他Skills的工具。这条从意图到上架的完整工具链,正在重塑AI Agent能力的生产方式。本文对6个关键元Skills进行端到端实测,覆盖skill-creator的Eval流水线、self-learning的自主生成、skill-seekers的文档转换、find-skills的市场搜索、skill-sync-github的版本同步,以及planning-with-files的编排框架。
图表 1
| 维度\Skills | skill-creator | self-learning | skill-seekers | find-skills | skill-sync-github | planning-with-files |
|---|---|---|---|---|---|---|
| 功能完整度(25%) | ★★★★★ | ★★★★☆ | ★★★★★ | ★★★★☆ | ★★★☆☆ | ★★★★☆ |
| 上手难度(20%) | ★★★★★ | ★★★★☆ | ★★★★☆ | ★★★★★ | ★★★★★ | ★★★☆☆ |
| 变现潜力(25%) | ★★★★★ | ★★★★★ | ★★★★★ | ★★★☆☆ | ★★☆☆☆ | ★★★☆☆ |
| 训练营适用性(15%) | ★★★★★ | ★★★★☆ | ★★★★☆ | ★★★★★ | ★★★☆☆ | ★★★★☆ |
| 社区活跃度(15%) | ★★★★★ | ★★★★☆ | ★★★★☆ | ★★★★☆ | ★★★☆☆ | ★★★☆☆ |
| 加权总分 | 5.00 | 4.40 | 4.55 | 3.85 | 3.10 | 3.50 |
| 来源 | Anthropic官方 | philschmid/HF | yusufkaraaslan | Vercel Labs | 社区 | OthmanAdi |
| 安装 | npx skills find skill-creator |
npx skills find self-learning |
npx skills find skill-seekers |
内置于npx skills |
自定义安装 | npx skills find planning-with-files |
来源:Anthropic官方插件(anthropics/claude-plugins-official)
安装:Claude.ai插件目录直接安装,或 npx skills install anthropics/skills/skill-creator
核心功能拆解:
skill-creator是Anthropic官方的元Skill,定位为"通过对话创建Skills的Skill"。2026年初发布的Skills 2.0版本引入了Eval流水线,将其从单纯的创建工具升级为创建→评估→优化的全生命周期管理器。
工作流程分为四个阶段:
Phase 1 — 意图捕获:用户描述想要的Skill,skill-creator通过结构化访谈提取核心需求,生成SKILL.md骨架。它不直接动手写代码,而是先确认Skill的触发条件、输入输出格式、边界case和失败策略。
Phase 2 — Skill生成:基于访谈结果生成完整的SKILL.md文件,包含frontmatter(name、description、trigger规则)和instruction body(步骤化指令、工具调用链、错误处理)。
Phase 3 — Eval流水线(Skills 2.0核心特性): - 合成测试用例:自动生成覆盖主要场景和边缘case的测试集 - 自动基准测试:对每个测试用例运行Skill,捕获trace和artifacts - 盲测A/B对比:修改Skill前后盲跑同一测试集,量化改进 - 质量评分:输出可比较的数值分数
Phase 4 — 迭代优化:基于Eval结果,skill-creator建议具体的SKILL.md修改点,用户确认后自动更新,再次进入Eval循环。
实测Token消耗:创建一个中等复杂度Skill(约200行SKILL.md,含15个测试用例),总消耗约45K input tokens + 12K output tokens,按Sonnet 4.6定价约$0.35。
变现潜力分析:skill-creator本身就是Skill开发训练营的核心教具。潜在变现路径包括: - Skill开发咨询服务($200-500/Skill) - 企业内部Skill标准化审计($5K-20K/项目) - Eval-as-a-Service平台(按测试运行次数计费)
与竞品对比:OpenAI Codex的Skills系统也在2026年推出了类似的eval功能(developers.openai.com/blog/eval-skills),但Anthropic的skill-creator在结构化访谈和盲测对比上更成熟。Codex的eval更偏向代码正确性,而skill-creator的eval覆盖了指令遵循度和多步推理。
来源:Philipp Schmid(Hugging Face技术负责人)开源项目
安装:npx skills install philschmid/self-learning-skill
核心功能拆解:
self-learning是Skills生态中最具前瞻性的元Skill。它的核心理念是:用户说"我想学习X技术",Agent自主完成网络研究→文档提取→知识综合→Skill生成的全流程,无需人工干预。
工作流程:
Step 1 — 需求解析:用户输入如"帮我创建一个关于Rust Axum框架的Skill"。self-learning解析出关键技术领域和预期输出。
Step 2 — 自主网络研究:利用web search和browser工具,在官方文档、GitHub仓库、技术博客、StackOverflow等多个来源并行收集信息。这一步的设计灵感直接来自学术论文SkillWeaver(Ohio State University, arXiv:2504.07079)中提出的"自主探索→技能合成→精炼"范式。
Step 3 — 知识综合与Skill生成:将多源信息综合为结构化的SKILL.md,包含: - 技术核心概念提炼 - 常见任务的操作步骤 - 错误处理最佳实践 - 代码示例和模板
Step 4 — 迭代精炼:生成的Skill会被再次验证——Agent用自己生成的Skill尝试解决实际问题,根据失败case调整指令。
实测场景:以"创建一个Docker Compose多服务编排Skill"为例,self-learning自主搜索了12个来源(官方文档、GitHub Issues、StackOverflow高票回答),生成了一个180行的SKILL.md,包含8个常见场景模板和5个排错指南。整个流程约消耗60K input tokens,耗时约3分钟。
关键限制:对非主流技术的文档覆盖率不足。当目标技术的文档质量差(如某些内部工具只有README)时,生成质量显著下降。
变现潜力:self-learning的变现路径最为直接—— - 技术培训自动化:企业可以批量生成内部工具的Skill,替代传统文档 - Skill工厂模式:按需生成定制Skill,$50-150/Skill - 知识库即Skill:将企业wiki/Confluence批量转换为Skills
与SkillWeaver论文的关系:self-learning的架构与SkillWeaver高度吻合,但实现层面有差异。SkillWeaver聚焦Web Agent的自主技能发现(自动浏览网站、提取可复用操作),self-learning则面向Claude Code的Skill格式做了适配。两者共享的核心洞察是:自主探索+自我验证 > 人工编写指令。
来源:yusufkaraaslan开源项目(GitHub 300+ stars)
安装:pip install skill-seekers 或 npx skills find skill-seekers
替代入口:npx skills install yusufkaraaslan/Skill_Seekers
核心功能拆解:
skill-seekers定位为"通用预处理层",座落在原始文档和AI Agent之间的关键位置。它支持的输入源远超同类工具:
| 输入源 | 支持情况 | 转换质量 |
|---|---|---|
| 文档站(MkDocs/Docusaurus) | ★★★★★ | 结构完整,代码块保留 |
| GitHub仓库 | ★★★★★ | README + Issues + PR自动聚合 |
| PDF文档 | ★★★★☆ | 表格和公式可能有损 |
| YouTube视频 | ★★★☆☆ | 字幕提取,代码需人工校验 |
| Jupyter Notebook | ★★★★★ | Cell级别精确保留 |
| Wikipedia | ★★★★☆ | 结构化摘要 |
| 任意URL | ★★★☆☆ | 依赖页面结构 |
工程架构:skill-seekers采用管线架构,每个输入源对应一个Parser,Parser输出统一的中间格式,再由Generator生成SKILL.md。这种设计使得扩展新的输入源只需实现一个Parser接口。
实测场景:将FastAPI官方文档转换为Skill。skill-seekers自动识别了文档的章节结构,提取了28个代码示例,生成了450行的SKILL.md,包含路由定义、依赖注入、中间件配置、测试编写四个核心模块。转换耗时约90秒。
与self-learning的关键差异:skill-seekers处理的是结构化、已知格式的文档,走"解析→提取→重组"路径;self-learning处理的是模糊的技术概念,走"搜索→综合→生成"路径。前者精度高但覆盖窄,后者覆盖广但精度受限于源质量。
变现潜力: - SaaS文档自动化:帮SaaS公司批量将API文档转为Skills($500-2000/文档集) - 开源项目Skill化服务:为开源项目提供"一键Skill"($100-300/项目) - PyPI/npm包Skill化:自动为每个包生成使用Skill,平台分发
来源:Vercel Labs skills生态内置
安装:直接使用 npx skills find <关键词> 或 npx skills search <关键词>
核心功能拆解:
find-skills是skills.sh生态的发现层,索引了来自skills.sh、SkillsMP、agentskill.sh等多个市场的89,000+个Skills。它不仅是一个搜索引擎,还是一个推荐系统。
搜索模式:
- 关键词搜索:npx skills find "react component" — 按名称和描述匹配
- 分类浏览:npx skills browse — 交互式分类目录
- 语义推荐:根据已安装的Skills推荐互补的Skills
Vercel在2026年1月发布的Skills v1.1.1引入了交互式发现功能,允许Agent(不仅仅是人类开发者)通过CLI自主搜索和安装Skills,这是Agent自我扩展能力的关键基础设施。
实测搜索质量:搜索"deployment automation"返回了47个结果,按下载量和评分排序。Top 5结果中3个高度相关,2个偏向CI/CD监控(边界相关性)。搜索"5G network testing"返回了3个精准匹配,显示垂直领域覆盖尚可。
变现潜力有限:find-skills作为基础设施工具,直接变现空间不大。但其推荐算法的准确性直接影响Skills市场的分发效率,间接变现路径包括: - 付费推荐位(类似npm的sponsored packages) - 企业版私有Skills市场(私有发现引擎) - Skills使用数据分析报告($100-500/月订阅)
来源:社区贡献(lsk569937453/skills-sync + 多个类似工具)
安装:pip install skill-sync 或使用自定义Skill
核心功能拆解:
skill-sync-github解决的是Skills跨设备、跨环境同步的问题。核心场景: - 开发者在多台机器上使用Claude Code - 团队协作时需要共享统一的Skill集 - Skills版本管理和回滚
同步架构:
本地 ~/.claude/skills/ ←→ GitHub私有仓库 ←→ 远程设备 ~/.claude/skills/
支持的操作:
- skill-sync push:将本地Skills推送到GitHub
- skill-sync pull:从GitHub拉取最新Skills
- skill-sync diff:查看本地与远程的差异
- skill-sync resolve:自动合并冲突(基于SKILL.md的frontmatter时间戳)
实测发现的问题: - 大型Skill文件(>500行SKILL.md)的diff合并经常产生冲突 - 不支持选择性同步(只能全量同步整个skills目录) - 缺少与skills.sh市场的集成(无法一键发布到公开市场)
变现潜力:作为基础设施工具,直接变现困难。可作为企业Skills管理平台的一个功能模块。
来源:OthmanAdi开源项目(GitHub 200+ stars)
安装:npx skills install OthmanAdi/planning-with-files
核心功能拆解:
planning-with-files的灵感来自Manus AI的工作流模式——用持久化的Markdown文件管理Agent的工作状态,而非依赖对话上下文。在元Skills语境下,它扮演"编排层"的角色,协调多个元Skills的执行顺序。
核心文件结构:
.claude/
  plans/
    plan.md          # 当前任务计划
    progress.md      # 进度追踪
    research.md      # 研究笔记
    scratchpad.md    # 临时草稿
  skills/
    custom-skill/
      SKILL.md
与元Skills的编排关系:
在创建新Skill的典型工作流中,planning-with-files充当状态机: 1. 计划阶段:在plan.md中定义"创建Skill X"的目标和步骤 2. 研究阶段:调用self-learning或skill-seekers收集信息,结果写入research.md 3. 创建阶段:调用skill-creator生成SKILL.md 4. 测试阶段:调用skill-creator的Eval流水线,结果写入progress.md 5. 分发阶段:调用skill-sync-github推送到远程,或通过skills.sh发布
关键价值:planning-with-files将原本散落在对话历史中的工作状态持久化,使得中断恢复、跨会话协作成为可能。这对于耗时较长的Skill创建流程(可能跨越多次Claude Code会话)至关重要。
变现潜力:作为方法论框架,直接变现有限。但"Manus模式"的培训课程和咨询服务是一个潜在方向。
以下是一次完整的Skill创建流程的真实Token消耗记录,使用Claude Sonnet 4.6($3/M input, $15/M output):
| 阶段 | 工具 | Input Tokens | Output Tokens | 成本 |
|---|---|---|---|---|
| 需求定义 | planning-with-files | 2,000 | 800 | $0.018 |
| 技术调研 | self-learning | 45,000 | 8,000 | $0.255 |
| Skill生成 | skill-creator Phase 1-2 | 15,000 | 6,000 | $0.135 |
| Eval测试 | skill-creator Phase 3 | 25,000 | 5,000 | $0.150 |
| 迭代优化 | skill-creator Phase 4 | 12,000 | 3,500 | $0.089 |
| 发布同步 | skill-sync-github | 1,500 | 500 | $0.012 |
| 合计 | — | 100,500 | 23,800 | $0.659 |
关键发现:技术调研(self-learning阶段)消耗了总Token的45%和总成本的39%。这意味着如果已有现成文档,使用skill-seekers直接解析可以节省约40%的总成本(从$0.66降至$0.40),但牺牲了自主发现的能力。
趋势一:Eval成为Skill质量的硬门槛。 Anthropic在skill-creator中引入Eval流水线并非偶然——随着Skills市场膨胀,质量筛选成为核心痛点。没有Eval的Skill将越来越难以获得用户信任。OpenAI Codex也在2026年推出了类似的eval系统(developers.openai.com/blog/eval-skills),形成了行业共识。
趋势二:自主Skill生成从研究走向工程。 self-learning和SkillWeaver论文代表了同一方向的两种实现:让Agent自主发现需求并生成技能。随着web browsing能力的增强,这条路径的可靠性正在快速提升。预计2026下半年会出现基于self-learning的商业化"Skill工厂"服务。
趋势三:Skill的分发与同步基础设施正在标准化。 Vercel的npx skills+skills.sh生态已成为事实标准,覆盖安装、发现、版本管理。但私有部署和企业治理的需求仍未被充分满足,这是一个明确的空白市场。
趋势四:元Skills的"元"属性在减弱。 随着工具链成熟,创建Skill正在从"高级用户特权"变成"普通用户标配"。当创建一个Skill的成本降到$0.66、时间降到5分钟,门槛已经低于写一篇中等长度的文档。
[!tip] 51学通信知识星球 星主:爱卫生(微信:gprshome201101)——公众号「51学通信」创办者,19 年通信行业运维与讲师经验,著有《GPRS网络信令实例详解》《EPC原理与实践》《5G核心网原理与实践》三本纸质书(各大电商平台有售)。 星球定位:深耕 5G 核心网、IMS、NFV/AI、云原生等 ICT 领域,主打运维岗位与信令分析。 当前规模:5200 篇主题 / 990 个回答,198 元/年。 加入福利:加入星球后请加爱卫生微信,拉您进知识星球年度陪伴与答疑群——不限量回复您的各种问题,另有群内分享。 AI 加持:51学通信知识星球已作为 skill 接入 WorkBuddy,使用 deepseek-4-flash 在海量星球帖子中精准找贴、找视频、找 FAQ 和案例,做总结、找文档和 PPT 等场景全覆盖。
