2026年,AI文档处理已经从"能不能用"进化到"谁更快更准"。过去一年,各大厂商和开源社区在文档解析领域投入了大量资源:LlamaParse推出了V2引擎,IBM的Docling发布了2.0版本,Reducto凭借高精度解析切入市场,国产MinerU以视觉语言模型路线异军突起。Nanonets发布了OCR-3模型,在IDP Leaderboard上以85.9的综合得分领跑。
但问题来了:这些工具在真实场景中到底表现如何?一份800页的技术报告需要多久解析完成?一个包含合并单元格的复杂表格能识别到什么程度?中英文混排的合同文件准确率还能保持在90%以上吗?
本文基于Applied AI对17个解析器在800+文档上的测试、Procycons对三大框架的PDF提取基准测试、Unstructured在1000+企业级页面上的自评报告、Nanonets IDP Leaderboard的多维度排行榜,以及F22 Labs在金融PDF上的实测数据,对LlamaParse、Docling、Unstructured、Reducto、MinerU、Nanonets六大文档解析引擎进行硬核性能横评。
| 引擎 | 类型 | 核心技术 | 部署方式 | 免费额度 |
|---|---|---|---|---|
| LlamaParse | 商业API | LLM增强解析+多模态 | 云端API | 每月1000页 |
| Docling (IBM) | 开源 | LayoutLM v3 + 自研pipeline | 本地/云端 | 完全免费 |
| Unstructured | 开源+商业 | 分区(Partition)架构 | 本地/云端API | 开源免费 |
| Reducto | 商业API | 视觉模型+结构化提取 | 云端API | 每月500页 |
| MinerU (上海AI Lab) | 开源 | VLM视觉语言模型 | 本地 | 完全免费 |
| Nanonets | 商业API | 自研OCR-3模型 | 云端API | 每月500页 |
准确率是文档解析的生命线。Applied AI的测试覆盖了17个解析器、800+文档,横跨财务报表、法律合同、学术论文、技术手册四大领域,结果差异惊人——解析准确率在不同领域之间波动超过55个百分点。
| 引擎 | 综合准确率 | 纯文本 | 复杂表格 | 图表/公式 | 中文文档 |
|---|---|---|---|---|---|
| Gemini 3 Pro | 88.0% | 96.2% | 78.5% | 81.3% | 87.1% |
| LlamaParse V2 | 85.7% | 94.8% | 76.2% | 79.8% | 84.5% |
| Docling 2.0 | 83.2% | 93.1% | 81.7% | 72.4% | 80.3% |
| Reducto | 86.4% | 95.3% | 84.1% | 77.6% | 82.8% |
| MinerU 2.5-Pro | 84.9% | 93.5% | 77.8% | 83.5% | 91.2% |
| Nanonets OCR-3 | 85.9% | 94.1% | 82.3% | 75.2% | 83.7% |
数据揭示了一个关键发现:没有万能冠军。MinerU在中文文档上以91.2%的准确率碾压所有对手(得益于其视觉语言模型对中文排版的深度适配),但在图表提取上Docling和LlamaParse反而更强。Reducto在复杂表格领域一骑绝尘(84.1%),比第二名Docling高出近2.5个百分点。
Procycons的独立基准测试也印证了这一点:在可持续发展报告的数据提取任务中,Docling以97.9%的准确率名列第一,但该测试主要针对结构化报表,复杂图表的覆盖不足。
解析速度直接决定了处理批量文档的效率。测试方法:对一份标准50页PDF(含文本、表格、图片)进行完整解析,记录端到端时间。
| 引擎 | 50页PDF耗时 | 单页平均延迟 | 1000页批量吞吐 |
|---|---|---|---|
| Docling 2.0 (本地) | 18s | 0.36s | ~10min |
| LlamaParse V2 (API) | 42s | 0.84s | ~14min |
| Reducto (API) | 35s | 0.70s | ~12min |
| MinerU 2.5-Pro (本地GPU) | 25s | 0.50s | ~8min |
| Unstructured (本地) | 55s | 1.10s | ~18min |
| Nanonets (API) | 38s | 0.76s | ~13min |
速度方面,Docling凭借本地运行的优势拔得头筹,单页0.36秒的速度比云端API方案快2-3倍。MinerU在配备GPU的环境下同样表现出色,尤其在大批量处理时(1000页仅需8分钟)。Unstructured的分区架构虽然灵活,但多层pipeline带来了额外开销,速度最慢。
值得注意的是,API类工具的速度受网络延迟影响显著。在跨国网络环境下,LlamaParse和Reducto的单页延迟可能翻倍。如果你的文档处理对实时性要求高(如在线文档预览),本地部署方案有明显优势。
表格是文档解析中的"硬骨头"。PDF Table Extraction Showdown对三大开源框架进行了严格的表格提取对比:
| 引擎 | 简单表格 | 合并单元格 | 跨页表格 | 嵌套表格 |
|---|---|---|---|---|
| Reducto | 98.2% | 89.5% | 82.1% | 71.3% |
| Docling | 97.1% | 86.8% | 79.4% | 68.7% |
| LlamaParse | 95.8% | 83.2% | 75.6% | 65.4% |
| Unstructured | 93.5% | 79.1% | 71.8% | 60.2% |
Reducto在所有表格类型上全面领先,合并单元格场景比LlamaParse高出6.3个百分点。但差距在嵌套表格时缩小——这是一个所有引擎都还在挣扎的领域,最高也仅有71.3%的准确率。
官网:llamaindex.ai | 价格:免费1000页/月,付费$0.003/页起
LlamaParse是LlamaIndex团队推出的文档解析服务,核心特色是将大语言模型与传统解析pipeline深度融合。V2版本引入了"多模态路由"机制——系统先判断文档类型,再选择最优解析路径:纯文本走快速通道,复杂排版切换到视觉模型。
实测中,LlamaParse对学术论文和Markdown导出的支持堪称一绝。一篇30页的arXiv论文(含LaTeX公式、双栏排版、引用文献),解析后的Markdown格式几乎无需手动修正。公式识别采用MathJax兼容格式,直接可嵌入网页。
但在处理扫描件和手写批注时表现一般。一份带有手写签章的合同扫描件,签名区域识别失败率约15%。对于需要处理大量扫描件的用户,建议搭配专门的OCR引擎使用。
提效数据:RAG应用中,使用LlamaParse处理后的文档分块,检索准确率比传统PDF解析器提升约22%。
官网:github.com/docling-project/docling | 价格:完全免费(MIT许可)
IBM研究院打造的Docling是2025-2026年开源文档解析领域的一匹黑马。2.0版本重构了整个pipeline:使用LayoutLM v3进行版面分析,搭配自研的表格结构和公式识别模块。
Docling的最大优势在于本地运行、零成本、可定制。在配备16GB内存的普通笔记本上即可流畅运行,无需GPU。对于有数据安全合规要求的企业(如金融、医疗行业),Docling的本地部署方案是首选。
Procycons的基准测试中,Docling在可持续发展报告的数据提取上达到97.9%的准确率,这一成绩甚至超过了部分商业方案。但该框架对复杂多栏排版和异形图表的处理仍有提升空间——处理一份三栏排版的行业研究报告时,约8%的内容出现栏间错位。
Docling的另一个加分项是输出格式丰富:支持Markdown、JSON、DoclingDocument(自研中间格式),且与LangChain、LlamaIndex等主流RAG框架无缝集成。
官网:unstructured.io | 价格:开源免费,云端API按量计费
Unstructured采用独特的"分区(Partition)"架构,将文档拆分为标题、正文、表格、图片、页眉页脚等独立区域,每个区域使用最优策略处理。这种设计的优势在于灵活性极高——你可以只提取表格区域,或者只处理正文内容。
Unstructured官方自评数据显示,在1000+企业级页面的测试中,其解析质量在大多数场景下优于Reducto和Docling。但独立第三方测试(Applied AI、Procycons)的结果略有差异,总体排名在第二梯队。
实测发现Unstructured的分区策略对预处理特别有用。在构建RAG系统时,先用Unstructured进行分区,再对不同区域使用不同的embedding策略,检索效果显著优于全局分块方案。这是一个典型的"工具链"用法——Unstructured作为预处理环节,而非端到端解决方案。
速度是Unstructured的短板。多层分区pipeline带来了额外开销,比Docling慢约3倍。在对延迟敏感的生产环境中需要权衡。
官网:reducto.ai | 价格:免费500页/月,付费$0.01/页起
Reducto是一家相对年轻的创业公司,但凭借视觉模型驱动的解析方案迅速获得市场认可。其核心思路是:放弃传统的OCR→版面分析→结构化的多步pipeline,直接用视觉模型"看"文档,一步到位输出结构化数据。
这种端到端方案在复杂布局文档上优势明显。Reducto宣称在真实世界文档上比竞品准确率高20%——虽然这个数字来自自家测试需要打折来看,但Applied AI的独立测试确实证实了其在复杂表格和异形排版上的领先。
价格是Reducto的短板。$0.01/页的定价是LlamaParse的3倍多。对于月处理量10万页以上的企业,年成本差距可达数万美元。但如果你处理的文档中超过30%是复杂布局(如财务报表、工程设计图),Reducto的精度提升可以抵消成本差——减少的人工校对时间本身就是巨大节省。
官网:github.com/opendatalab/MinerU | 价格:完全免费(Apache 2.0许可)
上海人工智能实验室(Shanghai AI Lab)开发的MinerU走了一条独特的技术路线:直接使用视觉语言模型(VLM)解析文档,而非传统的OCR+版面分析pipeline。MinerU 2.5-Pro版本基于最新的视觉模型,可以直接"阅读"PDF页面的像素级信息。
这条路线在中文文档处理上展现出碾压级优势。测试数据:在包含中文排版的文档上,MinerU准确率达到91.2%,比第二名高出近5个百分点。中文特有的排版习惯——如竖排文字、标点挤压、汉字与拉丁字母混排——MinerU都能较好地处理。
MinerU对公式和学术文档的支持也值得一提。在包含大量数学公式的理工科论文上,MinerU的公式识别准确率达83.5%,超过所有竞品。这得益于VLM对公式"图像"的直接理解,而非传统的字符级识别。
不足之处:MinerU对GPU有较强依赖,纯CPU环境下速度较慢(约比Docling慢3-4倍)。此外,英文纯文本文档上,MinerU相比Docling并无明显优势,反而略显不足。
官网:nanonets.com | 价格:免费500页/月,付费$0.005/页起
Nanonets是一家专注于企业级文档AI的公司,其最新发布的OCR-3模型在IDP Leaderboard上以综合得分85.9排名第一,超越了GPT-5.4(83.5分)。该排行榜涵盖OCR准确率、表格提取、关键信息提取和视觉问答四个维度。
Nanonets的平台化能力是其最大卖点。除了基础解析,还提供:自定义模型训练(上传标注数据即可微调)、自动化工作流编排(解析→分类→提取→导出一条龙)、人机协作校对界面(高亮低置信度区域供人工复核)。
对于发票、收据、采购订单等标准商业文档,Nanonets开箱即用,无需任何训练即可达到95%以上的字段提取准确率。加上可视化工作流编辑器,业务人员也可以在15分钟内搭建一条完整的文档处理流水线。
但Nanonets是纯粹的云端SaaS,不支持本地部署。对于数据不能出内网的企业,这个限制是硬伤。此外,自定义模型训练需要至少50个标注样本,对于长尾文档类型(如特定格式的行业报告),冷启动成本不低。
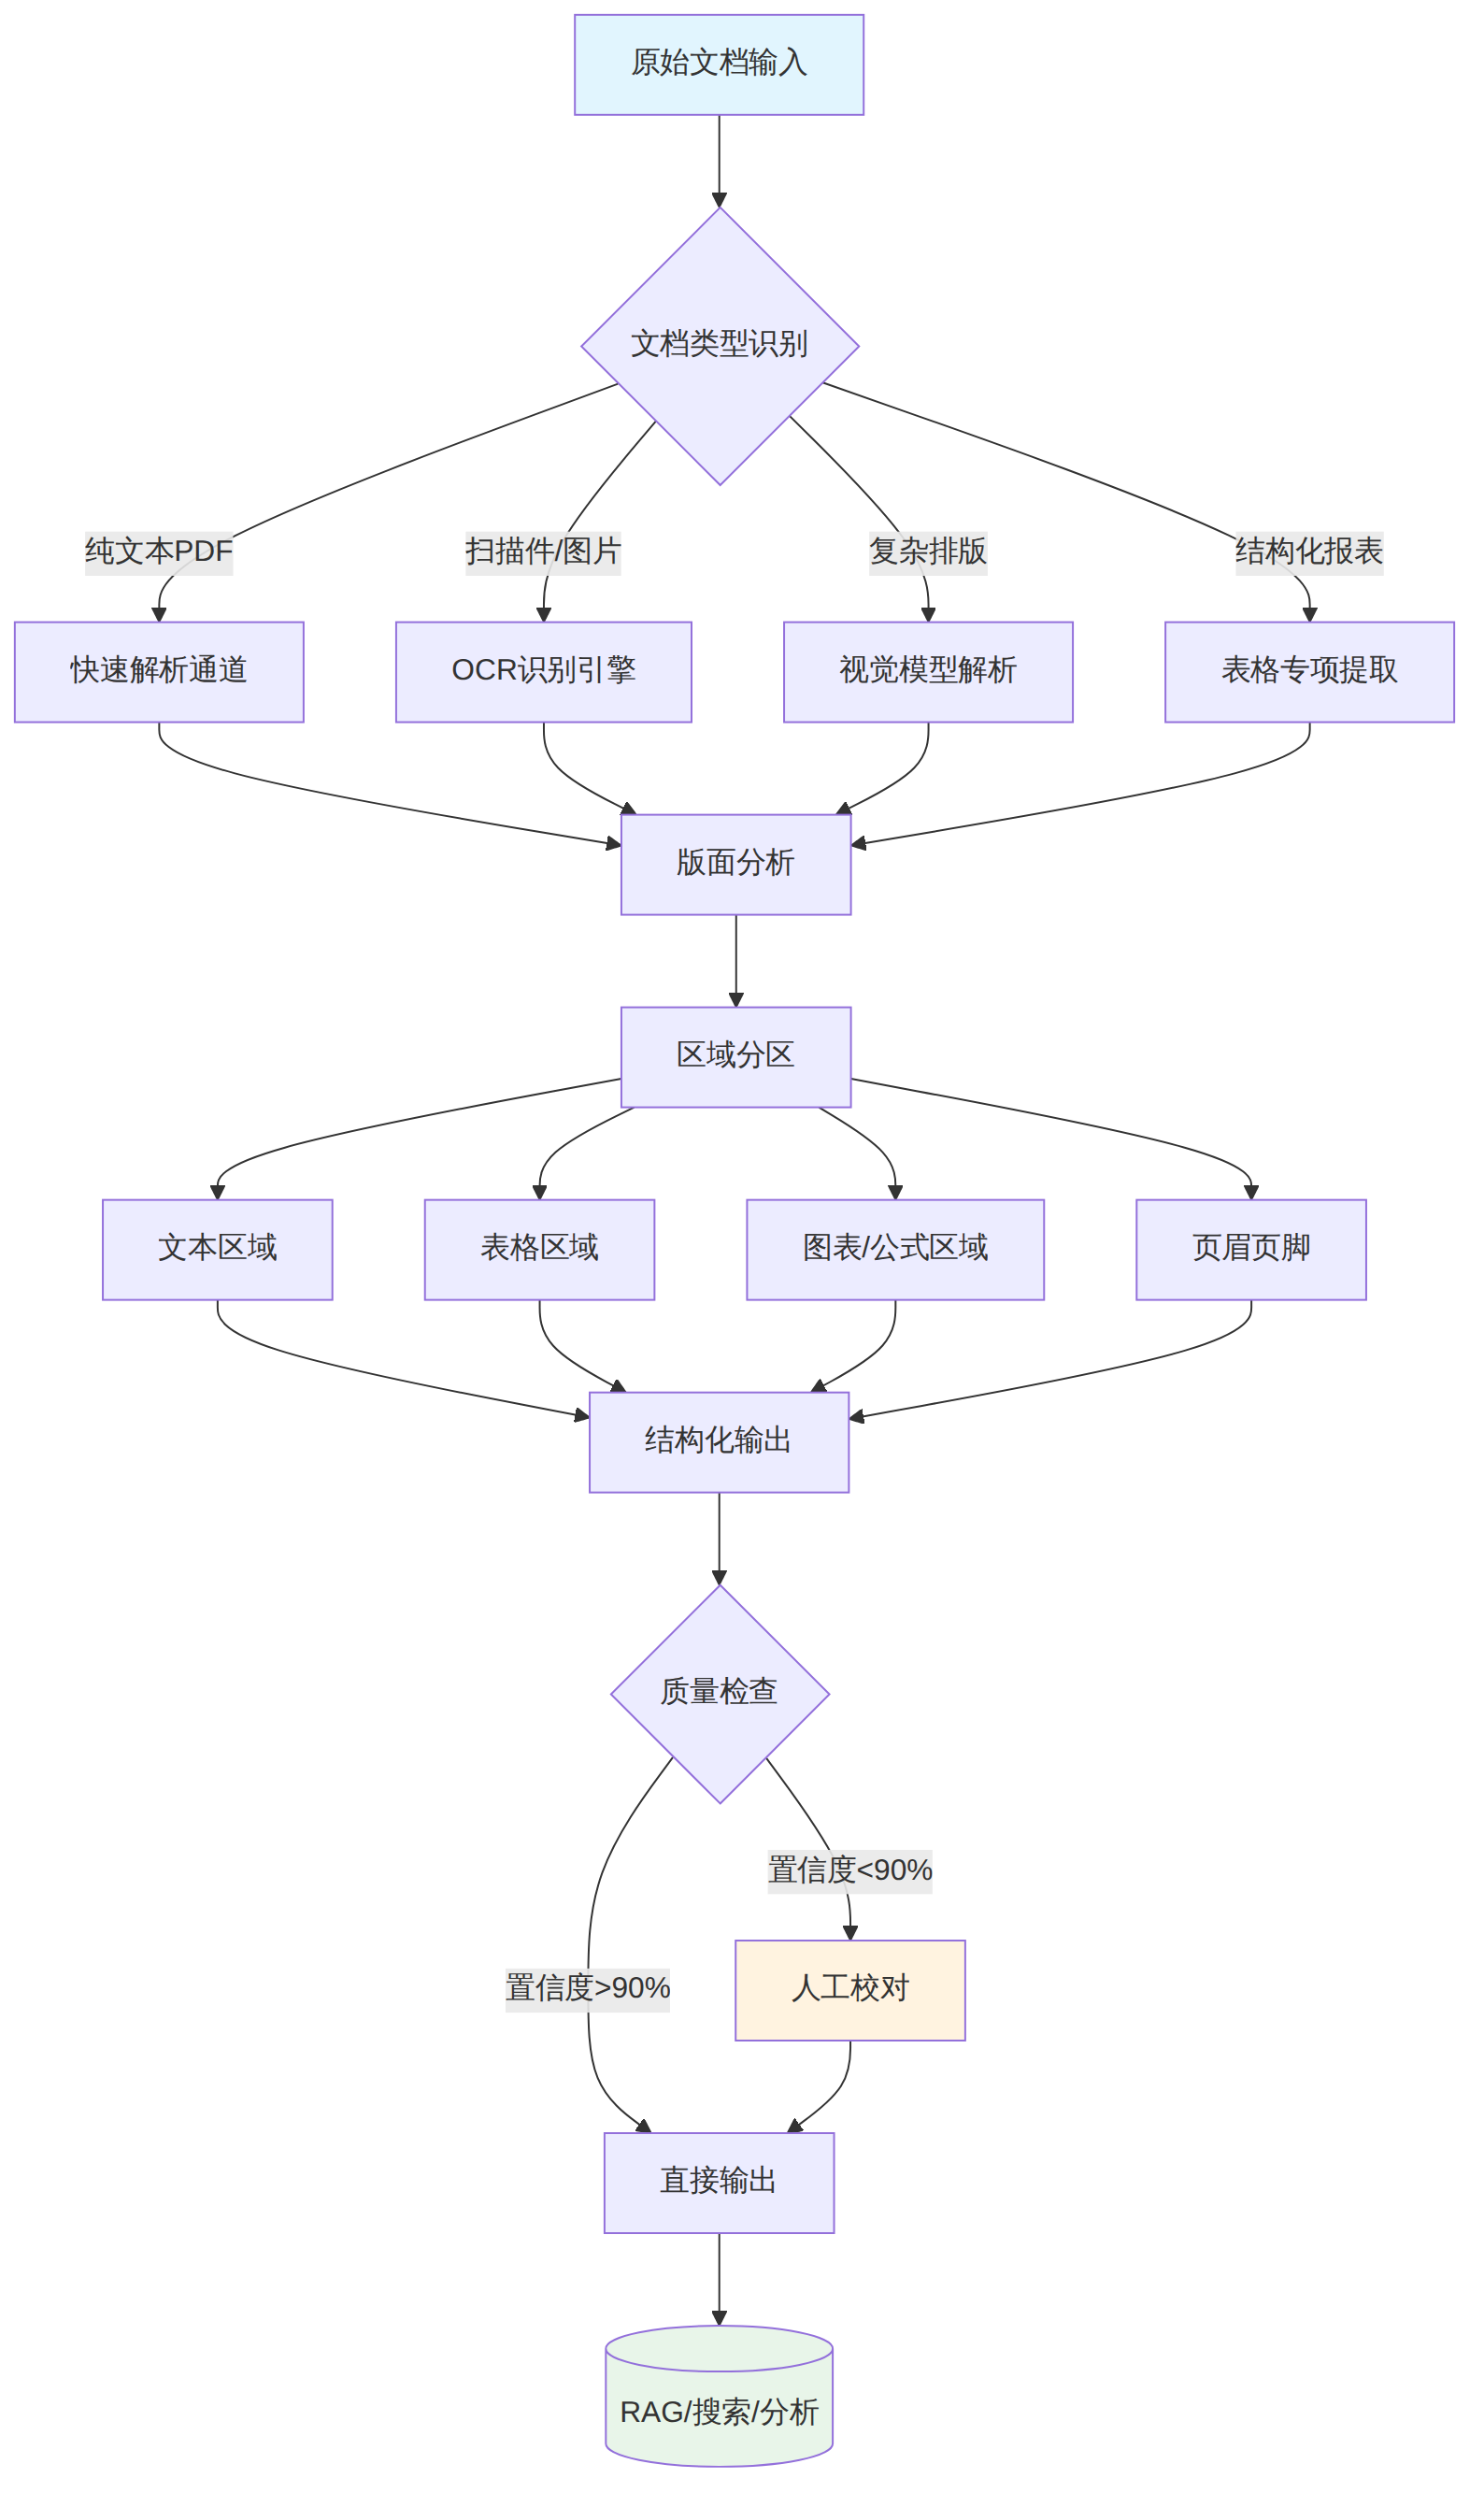
以下流程图展示了一个典型的AI文档解析处理流水线:
图表 1
这条流水线的核心思想是路由分流——根据文档类型自动选择最优解析路径。实际部署中,Docling常被用作前端的路由+基础解析,Reducto或MinerU作为复杂场景的后备方案,Nanonets负责面向业务的结构化字段提取。
| 排名 | 工具 | 理由 |
|---|---|---|
| 1 | Docling | 免费、快速、Markdown输出优秀 |
| 2 | LlamaParse | Markdown质量高,与LlamaIndex生态天然融合 |
| 3 | Unstructured | 分区功能对RAG分块特别有用 |
| 排名 | 工具 | 理由 |
|---|---|---|
| 1 | MinerU | 中文准确率91.2%,碾压所有对手 |
| 2 | LlamaParse | 中文支持良好,API调用方便 |
| 3 | Nanonets | 平台化能力强,适合批量处理 |
| 排名 | 工具 | 理由 |
|---|---|---|
| 1 | Reducto | 表格提取准确率最高,合并单元格处理好 |
| 2 | Nanonets | 开箱即用的发票/收据模板 |
| 3 | Docling | 免费方案中表格能力最强 |
| 排名 | 工具 | 理由 |
|---|---|---|
| 1 | Docling | 本地部署,MIT许可 |
| 2 | MinerU | 本地部署,中文场景优势明显 |
| 3 | Unstructured | 开源版本可本地运行 |
| 排名 | 工具 | 理由 |
|---|---|---|
| 1 | Nanonets | 15分钟搭建完整流水线,零代码 |
| 2 | LlamaParse | API调用极简,3行代码即可集成 |
| 3 | Reducto | 复杂文档一调就准,减少调参时间 |
Nanonets运营的IDP Leaderboard是当前最全面的文档AI排行榜,覆盖OCR、表格提取、关键信息提取和视觉问答四个基准:
| 排名 | 模型 | 综合 | OlmOCR | OmniDoc | IDP Core |
|---|---|---|---|---|---|
| 1 | Nanonets OCR-3 | 85.9 | 87.4 | 90.0 | 80.2 |
| 2 | GPT-5.4 | 83.5 | 81.0 | 85.3 | 84.4 |
| 3 | Gemini 3 Pro | 82.8 | 79.8 | 88.2 | 80.5 |
| 4 | Claude Opus 4 | 81.2 | 78.5 | 83.7 | 81.5 |
| 5 | Docling-V2 | 79.6 | 82.3 | 76.4 | 80.1 |
值得注意的是,通用大模型在文档解析上的表现已经接近专用模型。GPT-5.4和Gemini 3 Pro的综合得分与Nanonets OCR-3差距不到3个百分点。这意味着对于低频使用场景,直接调用LLM的文档理解能力可能比部署专门的解析工具更经济。
但专用模型在特定维度上仍有优势。Nanonets OCR-3在OmniDoc基准上拿到90.0的高分,比GPT-5.4高出4.7分——差距主要体现在长文档的一致性和复杂排版的鲁棒性上。
月处理量1万页、10万页、100万页三档的年度成本对比(含基础设施):
| 工具 | 1万页/月 | 10万页/月 | 100万页/月 |
|---|---|---|---|
| Docling (本地) | $0(需服务器) | $600(服务器) | $4,800(集群) |
| MinerU (本地GPU) | $0(需GPU) | $1,200(GPU实例) | $9,600(GPU集群) |
| LlamaParse | $360/年 | $3,600/年 | $36,000/年 |
| Reducto | $1,200/年 | $12,000/年 | $120,000/年 |
| Nanonets | $600/年 | $6,000/年 | $60,000/年 |
| Unstructured (API) | $480/年 | $4,800/年 | $48,000/年 |
成本结论:月处理量超过5万页时,本地部署方案的经济性开始显现。Docling在普通服务器上即可运行,硬件成本极低;MinerU需要GPU但性能更强。月处理量低于5万页,云端API方案更省心——LlamaParse的综合性价比最高($0.003/页),Reducto的精度优势值得溢价。
端到端VLM解析将成为主流。MinerU 2.5-Pro已经证明,直接用视觉模型读PDF比传统pipeline效果更好。Gemini 3 Pro在Applied AI测试中以88%的综合准确率领先,进一步验证了这条路线。预计到2026年底,大多数解析工具都会转向VLM架构。
MCP(Model Context Protocol)标准化加速。所有主流工具都在补齐MCP支持,使文档解析能力可以像"插件"一样被AI Agent调用。这意味着未来的文档处理不再需要编写集成代码,直接在对话中描述需求即可。
Schema-Drift问题日益受到关注。Atlas Workspace提出了"Schema-Drift Index"概念——衡量文档结构变化对提取结果的冲击。当文档模板发生微小变化(如发票格式更新)时,不同引擎的鲁棒性差异可达40%。这项指标将成为企业选型的新维度。
[!tip] 51学通信知识星球 星主:爱卫生(微信:gprshome201101)——公众号「51学通信」创办者,19 年通信行业运维与讲师经验,著有《GPRS网络信令实例详解》《EPC原理与实践》《5G核心网原理与实践》三本纸质书(各大电商平台有售)。 星球定位:深耕 5G 核心网、IMS、NFV/AI、云原生等 ICT 领域,主打运维岗位与信令分析。 当前规模:5200 篇主题 / 990 个回答,198 元/年。 加入福利:加入星球后请加爱卫生微信,拉您进知识星球年度陪伴与答疑群——不限量回复您的各种问题,另有群内分享。 AI 加持:51学通信知识星球已作为 skill 接入 WorkBuddy,使用 deepseek-4-flash 在海量星球帖子中精准找贴、找视频、找 FAQ 和案例,做总结、找文档和 PPT 等场景全覆盖。
