2026年AI Agent领域最深刻的共识是:能上线的不一定能测试,能测试的不一定能上线。随着Agent系统从原型走向生产,评估与测试从"nice-to-have"变成了"blocker"。本期内卷出的新物种包括:EvalView这种pytest-for-agents回归框架、agent-replay这种SQLite时光机调试器、以及Anthropic在2026年1月发布的Agent评估方法论。更关键的是,OpenAI收购了Promptfoo——这个事件直接催生了EvalView等一批开源替代品。本文将拆解六大Agent测试评估引擎的架构、黄金数据集构建方法论、以及从本地回归到CI/CD的全栈测试体系。
| 维度 | DeepEval | Braintrust | LangSmith | EvalView | agent-replay | timewarp-llm |
|---|---|---|---|---|---|---|
| 定位 | 单元测试级Agent评估 | 实验管理+评估平台 | 全链路追踪+评估 | pytest风格回归测试 | 时光机调试回放 | 事件溯源调试器 |
| 开源 | 是(Apache 2.0) | 部分开源 | 否 | 是(MIT) | 是(MIT) | 是(MIT) |
| Star数 | ~18K | ~8K | N/A | ~2.1K | ~3.5K | ~1.2K |
| 核心能力 | 断言式评估指标 | 批量实验+评分 | Trace+评分+部署 | 快照diff+回归检测 | 确定性回放 | 事件溯源+时间旅行 |
| 集成CI/CD | 原生支持 | 原生支持 | 手动 | 原生支持 | CLI模式 | CLI模式 |
| 评估方式 | LLM-as-Judge+规则 | LLM-as-Judge+自定义 | 自动+人工 | 快照对比+LLM裁判 | 录制回放对比 | 录制回放+断言 |
| 上手时间 | 30分钟 | 1小时 | 45分钟 | 20分钟 | 15分钟 | 25分钟 |
| 付费模式 | 免费开源+云托管 | 免费额度+按量 | 按Trace计费 | 完全免费 | 完全免费 | 完全免费 |
| 适用场景 | RAG+Agent单元测试 | 多模型实验对比 | LangChain生态 | 行为回归检测 | 生产故障复现 | 复杂多步调试 |
DeepEval在2026年的Agent测试领域,扮演了相当于pytest在Python世界的角色。它的核心设计哲学是:把LLM输出当作可测试的软件构件。
DeepEval的评估体系建立在"测试用例+评估指标"的双层模型上。一个测试用例(Test Case)包含输入、实际输出、期望输出;评估指标(Metric)则定义如何判定通过/失败。关键创新在于引入了"LLM-as-Judge"的混合评估模式——对结构化输出用确定性断言,对自然语言输出用另一个LLM打分。
from deepeval import evaluate
from deepeval.test_case import LLMTestCase
from deepeval.metrics import (
    AnswerRelevancyMetric,
    ToolCorrectnessMetric,
    TaskCompletionMetric
)

# 定义Agent测试用例
test_case = LLMTestCase(
    input="帮我订一张明天从北京到上海的机票",
    actual_output=agent.run("帮我订一张明天从北京到上海的机票"),
    expected_output="已为您预订明天CA1234航班北京-上海机票",
    tools_called=["search_flights", "book_flight"],
    expected_tools=["search_flights", "book_flight"]
)

# 工具调用正确性评估
tool_metric = ToolCorrectnessMetric(
    mode="strict",  # 严格模式:工具名+参数都必须匹配
    include_args=True
)

# 任务完成度评估
completion_metric = TaskCompletionMetric(
    model="gpt-4o",
    threshold=0.7
)

evaluate(test_cases=[test_case], metrics=[tool_metric, completion_metric])
优势:14种内置指标覆盖Agent的核心维度(工具选择、任务完成、推理链正确性);与pytest深度集成,deepeval test run test_agent.py一条命令搞定;支持并发评估,1000条测试用例3分钟内完成。
劣势:LLM-as-Judge模式引入额外Token开销(每次评估约$0.02-0.05);对多轮对话场景的测试编排不够直觉;自定义指标的学习曲线偏高。
训练营潜力:★★★★★。DeepEval的pytest映射关系让传统测试工程师极易上手,可以包装成"AI质量工程师"认证课程,目标受众是已有测试经验的工程师转型AI方向。
2026年初OpenAI收购Promptfoo,在社区引发了对评估工具供应链安全的担忧。EvalView正是这一事件的直接产物——一个以色列开发者用周末时间构建的"pytest for AI Agents"。
EvalView的核心是快照回归测试(Snapshot Regression Testing)。第一次运行Agent时,EvalView记录完整的工具调用链、模型输出、状态变迁作为"黄金基线"(Golden Baseline)。后续每次运行,新结果与基线对比,任何偏差都会被标记为回归。
# evalview_config.yaml - EvalView配置示例
agent:
  type: "langgraph"  # 支持 langgraph/crewai/openai/anthropic
  entry: "./agents/my_agent.py"

tests:
  - name: "机票预订-标准流程"
    input: "订一张明天北京到上海的经济舱机票"
    golden_trace: "./baselines/flight_booking.json"
    assertions:
      - type: "tool_call_match"
        tools: ["search_flights", "book_flight", "send_confirmation"]
        mode: "ordered"  # 工具调用顺序必须一致

      - type: "output_snapshot"
        threshold: 0.85  # 语义相似度阈值

      - type: "cost_cap"
        max_tokens: 2000  # 单次任务Token上限

      - type: "latency_cap"
        max_seconds: 30   # 响应时间上限

ci:
  fail_on_regression: true
  report_format: "github-actions"  # 支持GitHub/GitLab CI
传统软件测试是确定性的:输入A必然得到输出B。Agent测试面对的是非确定性系统——同一个prompt,GPT-4o今天和明天可能给出不同的工具调用顺序。EvalView的解决方案是多层级模糊匹配:工具调用检查顺序但不检查参数精确值;输出用embedding cosine similarity而非字符串匹配;允许设置容差区间。
作为开源工具直接变现困难,但作为"AI Agent质量保障"咨询服务的入口极有价值。企业级Agent上线前的回归测试是刚需,可以包装成"Agent QA as a Service"。
如果说EvalView解决的是"Agent是否回归",agent-replay解决的是"Agent为什么在这个case上失败了"。这是2026年Agent调试领域最精巧的工具设计。
agent-replay的核心是一个100%本地的SQLite事件日志系统。Agent运行时,每一个LLM调用、工具执行、状态变更都被序列化写入SQLite。调试时,可以逐步回放整个Agent执行过程,精确到每一步的输入输出。
# 录制Agent运行
agent-replay record --agent ./my_agent.py --input "处理退款请求#12345"

# 时光机回放
agent-replay replay --session abc123 --step 5  # 跳到第5步

# 从任意步骤分支调试
agent-replay branch --session abc123 --from-step 3 --inject '{
  "tool_response": {"status": "error", "message": "支付网关超时"}
}'

# 导出执行轨迹为测试用例
agent-replay export --session abc123 --format deepeval -o test_refund.py
LLM是非确定性的,如何实现确定性回放?agent-replay的策略是Mock所有LLM调用。录制阶段记录LLM的实际响应,回放时用记录的响应替代实时调用。这意味着:
这个设计的精妙之处在于,它把"不可重现的LLM调用"变成了"可重现的数据库记录",将调试从概率游戏变成了确定性问题。
timewarp-llm采用事件溯源(Event Sourcing)模式,更偏向于多Agent系统的调试。agent-replay聚焦于单Agent的深度调试。两者可以互补使用。
在Agent评估的"操作系统"层面,Braintrust和LangSmith是2026年最主流的两个选择。
Braintrust的设计哲学源自机器学习实验管理(类似MLflow/Weights & Biases),把Agent评估视为一种特殊形式的实验。核心概念:
// Braintrust评估管道示例
import { Eval } from "braintrust";
import { Levenshtein } from "autoevals";

Eval("MyAgent", {
  data: async () => {
    // 从数据库或文件加载测试数据
    const cases = await loadGoldenDataset("./agent_tests.jsonl");
    return cases;
  },
  task: async (input) => {
    // 运行Agent
    return await myAgent.run(input);
  },
  scores: [
    Levenshtein.levenshtein,           // 字符串相似度
    customToolSelectionScore,           // 自定义工具选择评分
    customTaskCompletionScore,          // 任务完成度
  ],
  experimentName: "agent-v2-gpt4o-upgrade"
});
Braintrust的优势在于评分函数的可组合性——你可以把多个评分函数组合成一个评估管道,每个函数独立运行,结果聚合后可视化。这对多维度评估Agent特别有效。
LangSmith深度绑定LangChain/LangGraph生态。如果你的Agent已经用LangGraph构建,LangSmith的评估集成几乎是零成本的——每一个LangGraph节点的执行自动记录为Trace,评估直接基于Trace数据。
| 场景 | 推荐工具 |
|---|---|
| 纯LangGraph/LangChain Agent | LangSmith |
| 多框架混合Agent系统 | Braintrust |
| 需要离线评估+CI/CD集成 | DeepEval + Braintrust |
| 快速原型验证 | EvalView |
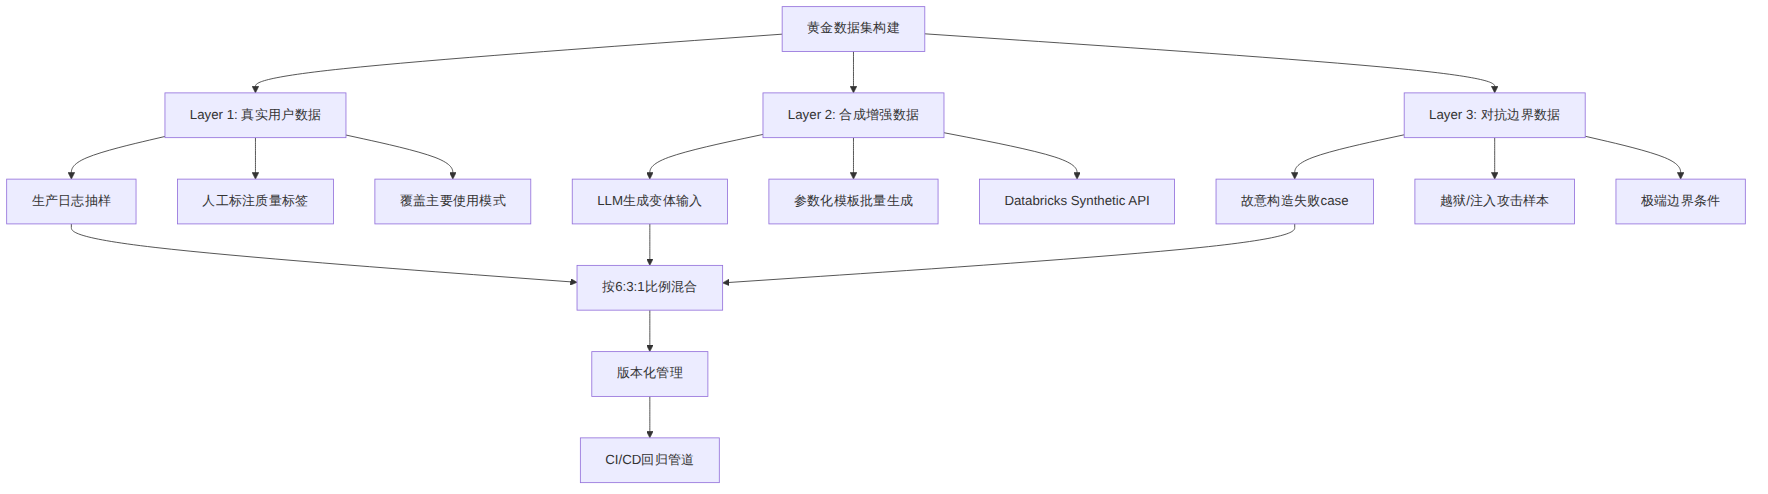
测试体系的基础是高质量的测试数据。2026年Agent测试领域的最佳实践形成了"黄金数据集"(Golden Dataset)方法论。
图表 1
第一层:真实数据。从生产日志中抽取代表性case,人工标注"正确"和"错误"两组。推荐覆盖top 20使用场景,每个场景3-5个变体。
第二层:合成数据。用GPT-4o等模型基于真实case生成变体。Databricks在2026年推出了Synthetic Data API,可以直接与Agent Evaluation管道集成。
第三层:对抗数据。故意构造让Agent出错的case——歧义输入、多轮反转、工具失败模拟。这层占10%但覆盖80%的边界bug。
黄金数据集不是一成不变的。推荐的做法是:
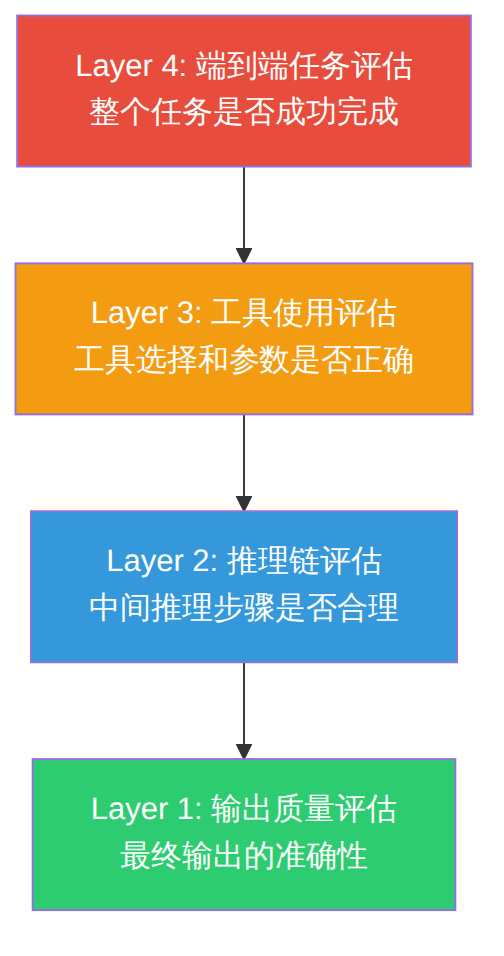
2026年1月,Anthropic发布了《Demystifying Evals for AI Agents》,这是目前最系统的Agent评估工程指南。核心框架:
图表 2
Anthropic的关键洞察:评估不应该只看最终结果。一个Agent可能在10步中走了8步正确路径、2步弯路但最终到达终点——如果只评估终点,你会错过优化中间步骤的机会。因此建议在Agent的每个关键节点插入评估点。
# Anthropic推荐的分步评估模式
def evaluate_agent_run(run_trace):
    scores = {}

    # 1. 规划质量:Agent的初始计划是否合理
    scores["plan_quality"] = llm_judge(
        prompt=f"评估以下Agent计划的质量:{run_trace.initial_plan}",
        rubric="计划是否包含所有必要步骤,步骤顺序是否合理"
    )

    # 2. 工具选择:每一步的工具选择是否正确
    for step in run_trace.tool_calls:
        scores[f"tool_select_{step.id}"] = (
            1.0 if step.tool in step.expected_tools else 0.0
        )

    # 3. 错误恢复:出错后Agent是否合理恢复
    if run_trace.errors:
        scores["error_recovery"] = llm_judge(
            prompt=f"Agent遇到错误后如何处理:{run_trace.error_handling}",
            rubric="是否识别错误、尝试恢复、而非循环重试"
        )

    # 4. 效率:是否走了不必要的弯路
    scores["efficiency"] = (
        run_trace.optimal_steps / run_trace.actual_steps
    )

    # 5. 最终结果
    scores["task_success"] = (
        1.0 if run_trace.final_output == run_trace.expected_output else 0.0
    )

    return scores
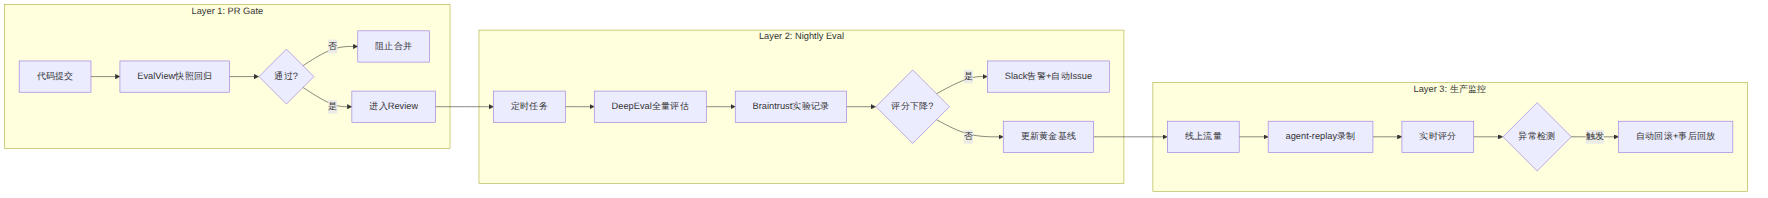
将以上工具串联成完整的CI/CD管道是2026年Agent工程的核心竞争力。
图表 3
第一层(PR Gate):每次代码提交触发EvalView回归测试,5分钟内完成。只跑黄金数据集的核心case(约50条),确保基础行为不变。
第二层(Nightly Eval):每晚跑完整的DeepEval评估管道(500+条case),结果记录到Braintrust。如果评分相比基线下降超过阈值,自动创建GitHub Issue并Slack通知。
第三层(生产监控):线上Agent运行时agent-replay全量录制,实时评分。异常case自动触发回滚,并生成可回放的调试session。
# .github/workflows/agent-eval.yml
name: Agent Evaluation Pipeline

on:
  pull_request:
    paths: ['agents/**', 'prompts/**']

jobs:
  regression:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4

      - name: Install evalview
        run: pip install evalview deepeval

      - name: Run snapshot regression
        env:
          OPENAI_API_KEY: ${{ secrets.OPENAI_API_KEY }}
        run: |
          evalview test run --config evalview_config.yaml \
            --baseline main \
            --fail-on-regression \
            --report github-actions

      - name: Run DeepEval unit tests
        run: |
          deepeval test run test_agent/ \
            --max-concurrent 5 \
            --junit-xml report.xml

      - name: Check eval scores
        run: |
          python scripts/check_eval_threshold.py \
            --min-answer-relevancy 0.8 \
            --min-tool-correctness 0.9 \
            --max-cost-per-run 0.15
测试评估不是免费的。以下是基于50条黄金case、每日运行的月度成本估算:
| 成本项 | DeepEval | Braintrust | EvalView | agent-replay |
|---|---|---|---|---|
| LLM-as-Judge Token费 | ~$45/月 | ~$35/月 | ~$20/月 | $0(回放用缓存) |
| 平台费用 | $0(自托管) | $0-50/月 | $0 | $0 |
| CI/CD运行时间 | ~5分钟/次 | ~8分钟/次 | ~3分钟/次 | N/A |
| 存储成本 | ~100MB | ~500MB | ~50MB | ~200MB/天 |
| 月度总成本 | ~$45 | ~$85 | ~$20 | ~$5 |
关键发现:EvalView + agent-replay的组合是性价比最高的方案——EvalView负责回归检测($20/月),agent-replay负责故障调试($5/月),总成本仅$25/月。
推荐:EvalView(回归)+ DeepEval(单元测试)
理由:两个都是开源免费工具,上手时间最短。EvalView负责"别搞坏已有功能",DeepEval负责"新功能质量过关"。
推荐:DeepEval(CI)+ Braintrust(实验管理)+ agent-replay(调试)
理由:Braintrust的实验管理能力在多Agent对比实验中不可或缺,agent-replay解决复杂调试场景。
推荐:全栈三层体系 + LangSmith(如果LangGraph生态)
理由:生产级SLA要求24/7监控+自动回滚,需要完整的三层防御体系。如果已投入LangGraph生态,LangSmith的零成本集成是最大优势。
推荐:DeepEval为核心教材,EvalView为实战项目
理由:DeepEval的pytest映射让传统QA工程师无学习曲线。可以设计"10周从QA到AI Quality Engineer"的课程体系,前三周DeepEval基础,中间四周EvalView回归实战,后三周CI/CD管道搭建。
[!tip] 51学通信知识星球 星主:爱卫生(微信:gprshome201101)——公众号「51学通信」创办者,19 年通信行业运维与讲师经验,著有《GPRS网络信令实例详解》《EPC原理与实践》《5G核心网原理与实践》三本纸质书(各大电商平台有售)。 星球定位:深耕 5G 核心网、IMS、NFV/AI、云原生等 ICT 领域,主打运维岗位与信令分析。 当前规模:5200 篇主题 / 990 个回答,198 元/年。 加入福利:加入星球后请加爱卫生微信,拉您进知识星球年度陪伴与答疑群——不限量回复您的各种问题,另有群内分享。 AI 加持:51学通信知识星球已作为 skill 接入 WorkBuddy,使用 deepseek-4-flash 在海量星球帖子中精准找贴、找视频、找 FAQ 和案例,做总结、找文档和 PPT 等场景全覆盖。
