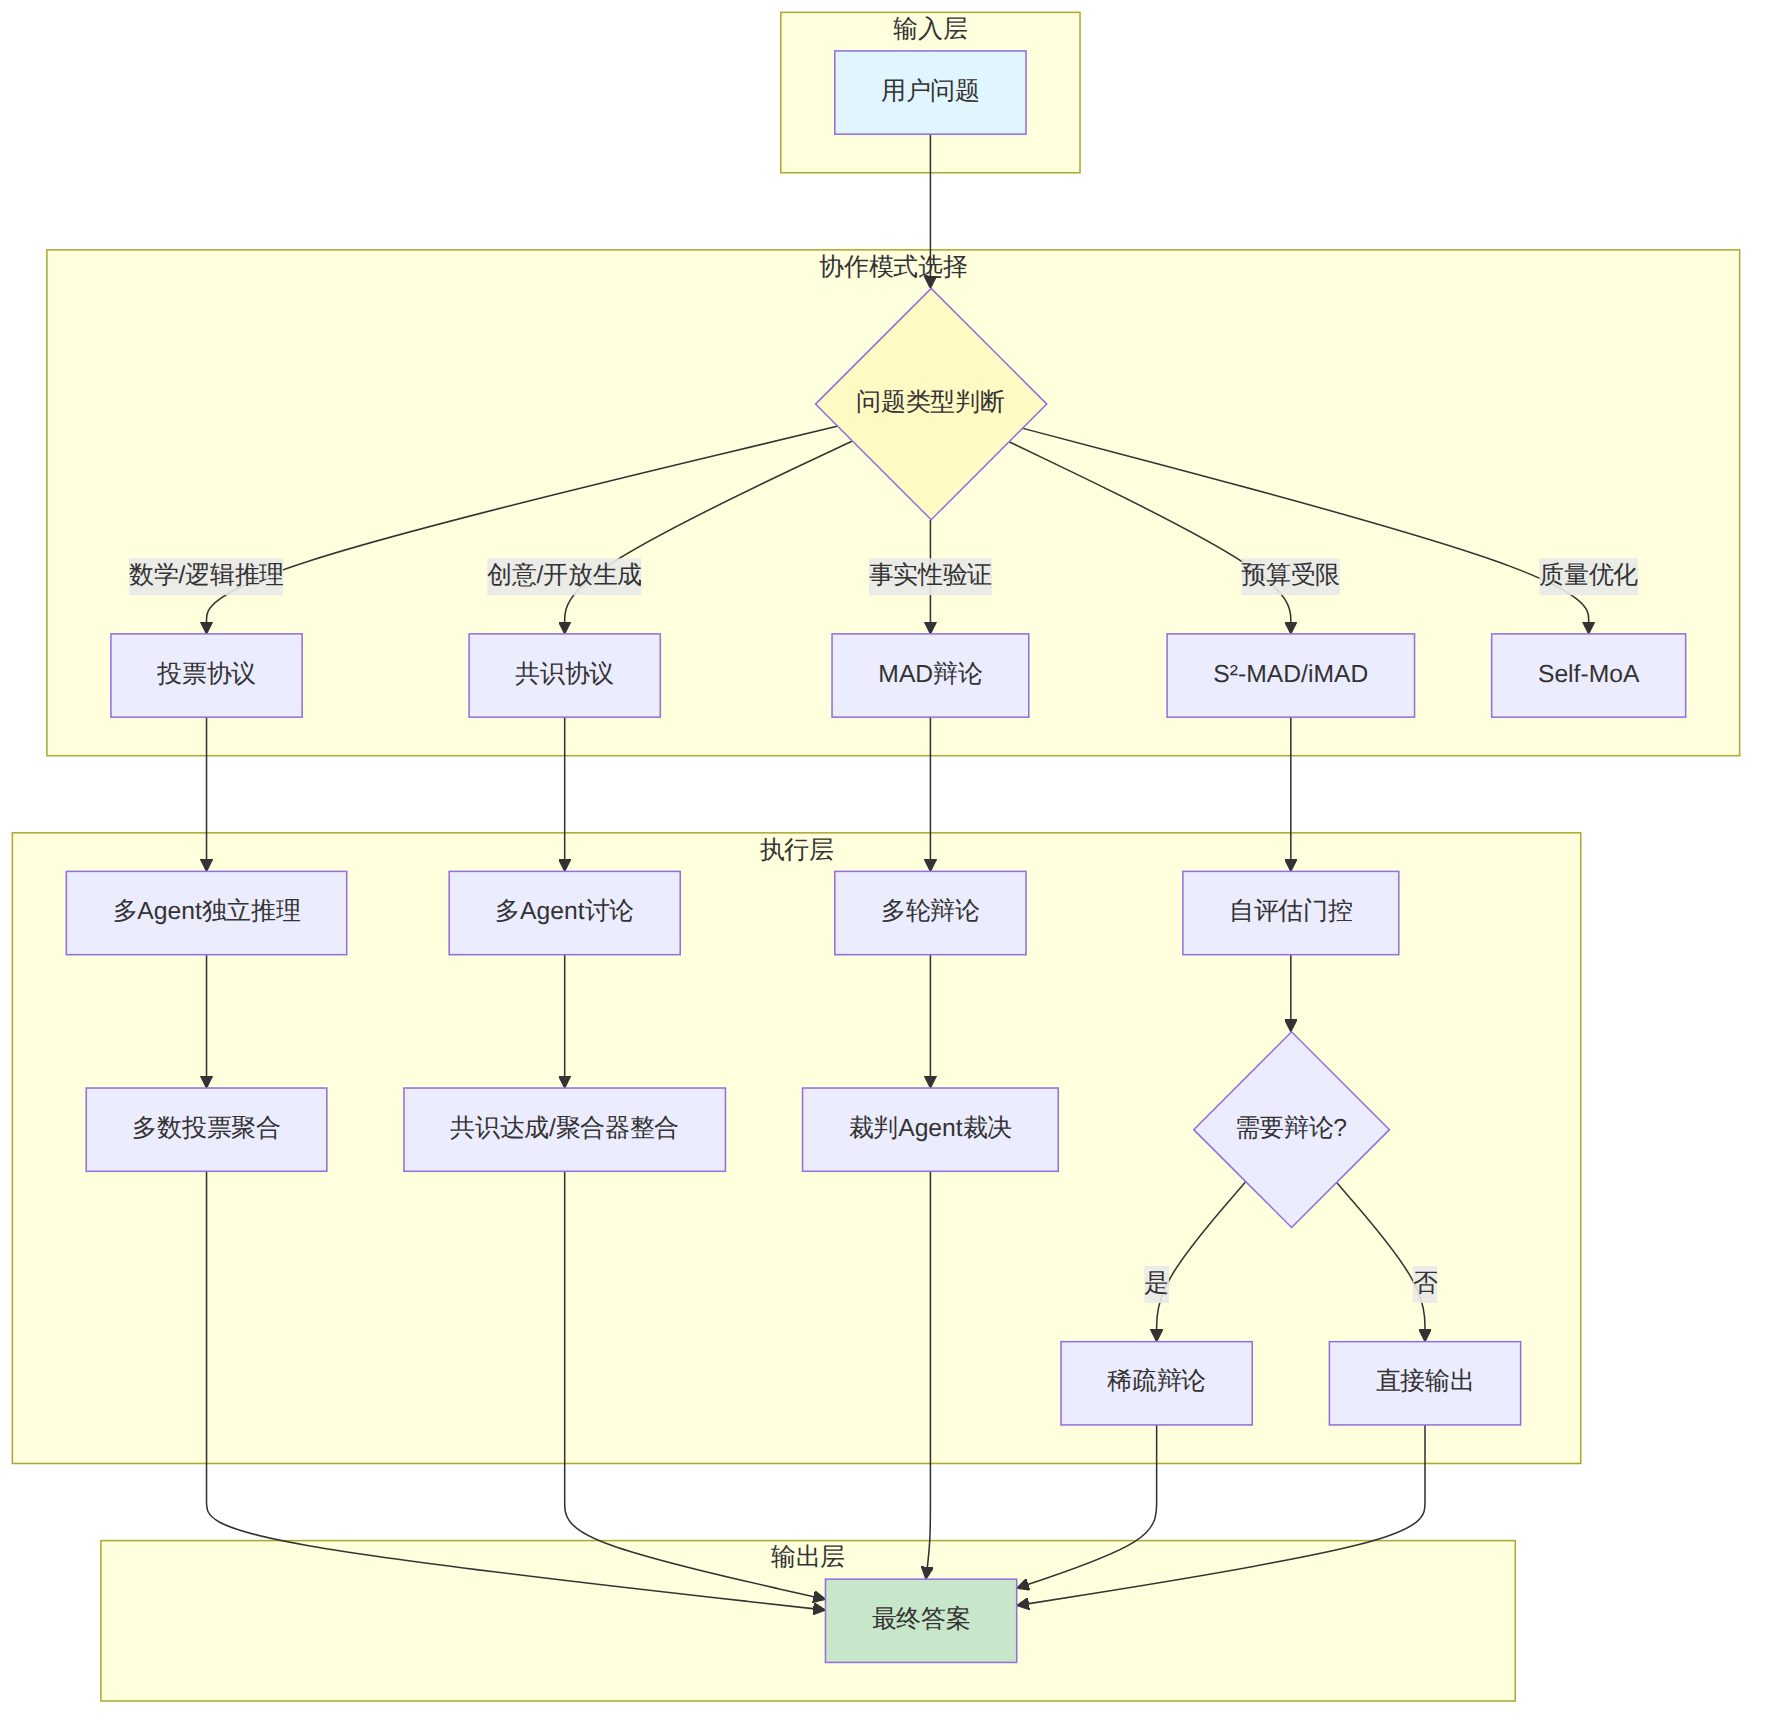
多Agent辩论(Multi-Agent Debate, MAD)曾是2024年最火热的LLM推理增强范式——"让几个模型吵一架就能提升准确率"。但2025-2026年的系统性研究揭示了令人不安的真相:Google/MIT联合实验中,180种Agent配置在顺序推理任务上性能下降39-71%;ICML 2025论文证明,在数学推理上MAD相对单Agent自推理几乎无显著优势。然而,并非全盘否定——ACL 2025发现投票协议在推理任务上提升13.2%,共识协议在创意任务上提升10.1%。关键不在"是否用多Agent",而在"用什么协作模式、在什么场景、花多少Token"。本文深入拆解七种主流多Agent推理模式的架构原理、实测数据、Token经济性,给出可落地的选型指南。
| 模式 | 核心思想 | 代表论文/项目 | Token开销 | 准确率提升 | 最适场景 | 上手难度 |
|---|---|---|---|---|---|---|
| Mixture of Agents (MoA) | 多层Agent堆叠,每层聚合多个模型输出 | Together AI (2024) | ★★★★☆ 极高 | AlpacaEval 65.1% | 开放式生成 | 中 |
| Self-MoA | 单模型多次采样自聚合,替代多模型 | Princeton (NeurIPS 2024) | ★★★☆☆ 高 | 超越标准MoA | 生成质量优化 | 低 |
| 多Agent辩论 (MAD) | 多Agent多轮辩论后投票/共识 | Du et al. (2023) | ★★★★★ 极高 | 推理+8-15% | 事实性问答 | 中 |
| S²-MAD | 选择性稀疏辩论,砍掉无效轮次 | NAACL 2025 | ★☆☆☆☆ 低 | 与MAD持平 | 预算受限场景 | 高 |
| iMAD | 自我评估门控,只在需要时触发辩论 | AAAI'26 (2025) | ★★☆☆☆ 中 | 整体优于固定MAD | 生产环境 | 高 |
| Free-MAD | 无共识辩论+评分聚合+反一致性正则 | 2025 | ★★★☆☆ 高 | 8个benchmark显著提升 | 多样性要求高 | 中 |
| 投票/共识协议 | 7种决策协议的系统对比 | ACL 2025 Findings | 取决于Agent数 | 投票+13.2%/共识+10.1% | 协议选型 | 低 |
图表 1
Together AI提出的MoA架构灵感来自Mixture of Experts(MoE),但将"专家"从参数级别提升到了模型级别。核心结构分为多个层(Layer),每层包含多个提议Agent(Proposer)和一个聚合Agent(Aggregator)。第一层的多个模型各自生成回答,聚合器将这些回答整合为一个统一输出,然后传给下一层继续优化。
实测数据:在AlpacaEval 2.0上,MoA使用6个开源模型(Qwen2-72B、Llama-3-70B等)堆叠4层,达到65.1%的胜率,超过了当时的GPT-4o。在MT-Bench和FLASK上同样表现出色。关键洞察是:弱模型的集体智慧可以超越强模型的单体表现。
关键代码片段(mixture-llm库):
from mixture_llm import MoAPipeline, Layer, Agent

pipeline = MoAPipeline([
    Layer([
        Agent(model="Qwen/Qwen2-72B-Instruct", temperature=0.7),
        Agent(model="meta-llama/Meta-Llama-3-70B", temperature=0.8),
        Agent(model="mistralai/Mixtral-8x22B", temperature=0.6),
    ]),
    Layer([
        Agent(model="Qwen/Qwen2-72B-Instruct", role="aggregator"),
    ])
])

result = pipeline.run("Explain quantum entanglement")
致命短板:Token消耗惊人。一个4层MoA,每层3个Agent,意味着一次查询至少调用12次LLM。在Together AI的定价下,单次查询成本约为普通调用的8-12倍。延迟同样线性增长——4层串行推理的响应时间约为单次调用的4倍。
变现评估:适合包装为"AI质量优化API"——用户提交prompt,后台用MoA生成更高质量的结果。按次收费,成本可控。训练营角度,MoA是讲"模型集成"概念的最佳案例。
Princeton大学在NeurIPS 2024上发表的"Rethinking Mixture-of-Agents"论文提出了一个颠覆性发现:用同一个模型多次采样然后聚合,效果竟然优于混搭不同模型。
Self-MoA的原理极简:对同一个强模型(如GPT-4或Qwen2-72B)进行多次高温度采样(通常5-8次),然后用同一个模型作为聚合器将多个输出整合。Self-MoA-Seq是变体,支持更多采样轮次的顺序聚合。
实测数据:在AlpacaEval 2.0上,Self-MoA直接刷新了SOTA。在单任务评测中,Self-MoA在几乎所有场景下持续优于标准MoA(混合不同模型)。这意味着MoA的性能提升主要来自"多次采样+聚合"这个机制本身,而非"模型多样性"。
# Self-MoA 核心实现思路
def self_moa(query, model, n_samples=6, temperature=0.8):
    # 第一阶段:同一模型多次采样
    proposals = []
    for i in range(n_samples):
        response = model.chat(query, temperature=temperature + i*0.05)
        proposals.append(f"Proposal {i+1}: {response}")

    # 第二阶段:同一模型聚合
    aggregation_prompt = f"""
    Here are {n_samples} different proposals for the same question.
    Synthesize the best answer combining their strengths:

    {chr(10).join(proposals)}
    """
    return model.chat(aggregation_prompt, temperature=0.3)
成本优势:只需调用一个模型的API,无需维护多个模型接入。Token消耗约为标准MoA的50-60%(无需跨模型对齐和冗余上下文),且可以充分批处理并行化。
变现评估:这是最实用的"质量增强"方案。现有任何LLM API服务都可以零改造成本接入Self-MoA。适合包装为"AI答案质量提升工具"——输入prompt和API key,自动进行多采样聚合。
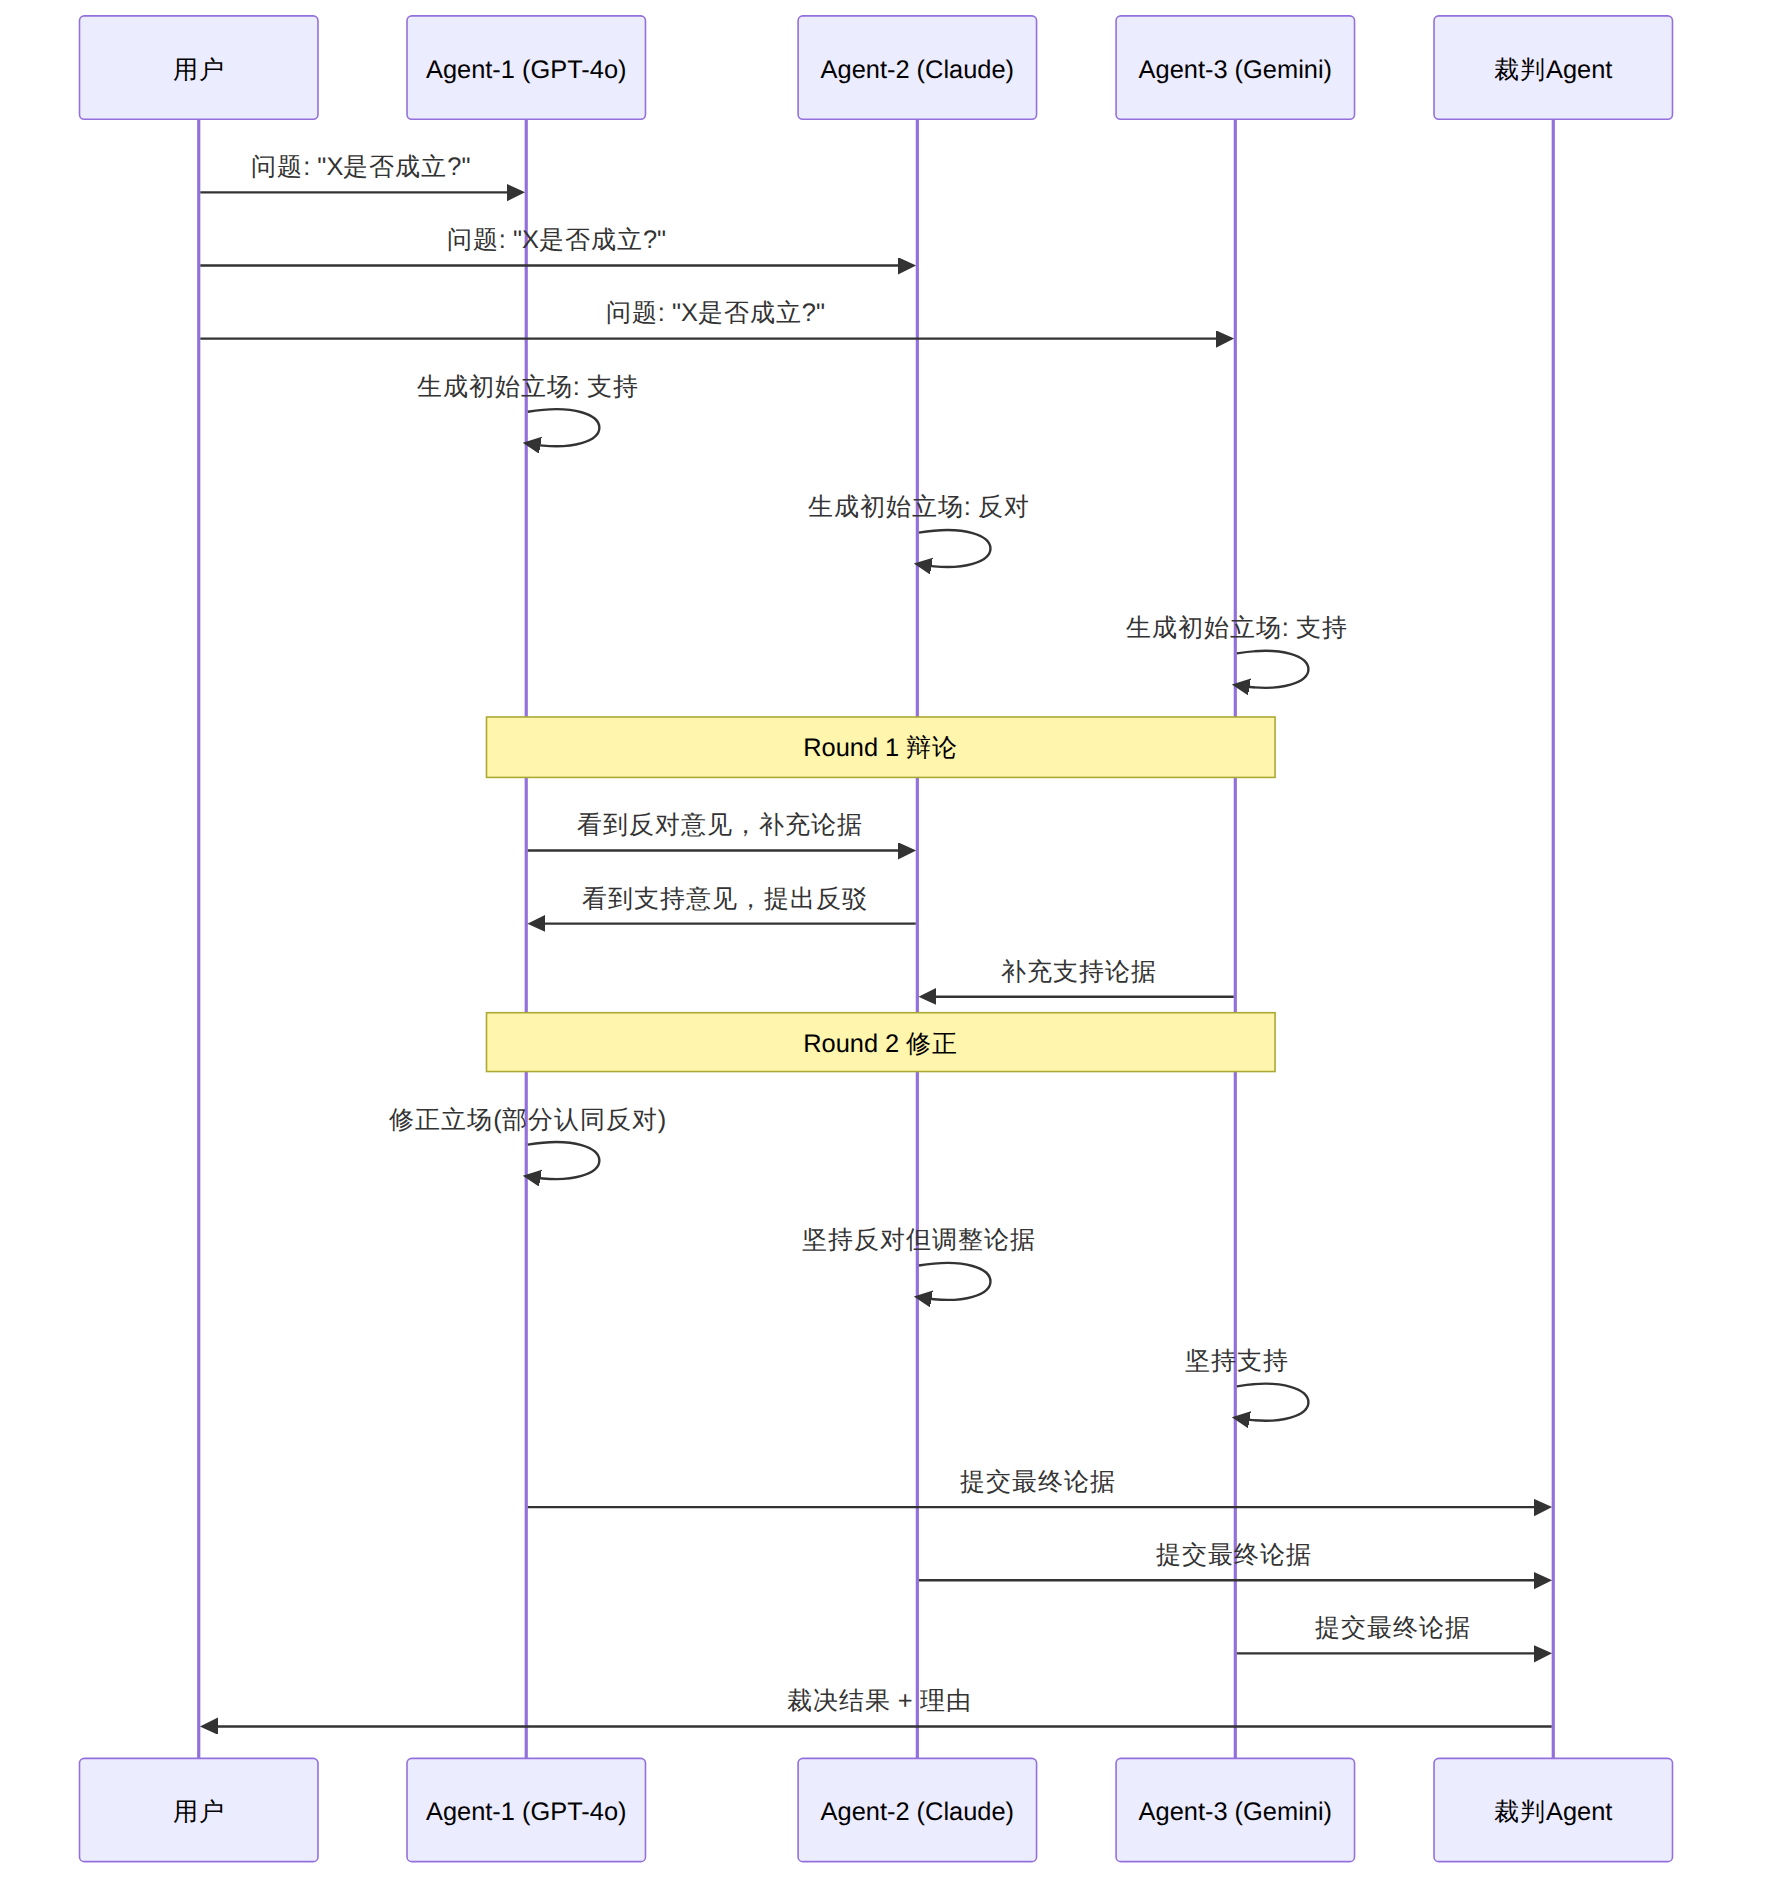
Du等人2023年提出的经典MAD框架至今仍是研究基准。3-5个Agent各自独立生成答案,然后进入多轮辩论(通常2-4轮),每轮Agent可以看到其他Agent的回答并修改自己的答案。最后通过多数投票或裁判Agent决定最终答案。
ICLR 2025 Blog系统回顾了MAD的扩展性实验:增加Agent数量确实能提升性能,但存在明显的收益递减——从2个Agent增到3个提升显著,从5个增到7个几乎无额外收益。增加辩论轮次的规律类似,3轮是最佳性价比点。Token消耗与Agent数×轮数成正比:5个Agent×4轮 = 20次LLM调用。
ICML 2025的重磅发现:Yang等人的"Revisiting MAD as Test-Time Scaling"系统性对比了MAD与单Agent自推理(Self-Consistency、Best-of-N)在相同计算预算下的表现。结论令MAD拥护者沮丧——在数学推理上,MAD相比同等Token预算的自推理方法无显著优势。MAD的收益主要来自"多次采样"而非"辩论交互"本身。但在需要多视角的开放性任务上,MAD的交互确实提供了独特价值。
图表 2
NAACL 2025接收的S²-MAD(Selective Sparse Multi-Agent Debate)直接瞄准MAD最大的痛点——Token浪费。论文的核心洞察是:在标准MAD中,超过60%的Agent间信息交换是"无效讨论",即Agent只是在重复或附和他人的观点,没有产生新的推理路径。
S²-MAD引入两个关键机制:
实测数据:在MATH、GSM8K等数学推理基准上,S²-MAD在保持与标准MAD相当准确率的前提下,Token消耗降低了高达94.5%。这意味着原本100美元的推理成本可以降到5.5美元。辩论效率也大幅提升——无效信息交换减少70%以上。
关键设计决策:S²-MAD使用"自信号驱动"(Self-Signals Driven)方法,让每个Agent在辩论前先自我评估答案的置信度和一致性。只有当多个Agent的置信度都低于阈值时,才触发完整的辩论流程。
# S²-MAD 核心决策逻辑
def s2_mad(query, agents, confidence_threshold=0.7):
    # Step 1: 各Agent独立推理+自评估
    initial_answers = []
    for agent in agents:
        answer, confidence = agent.infer_with_confidence(query)
        initial_answers.append((answer, confidence))

    # Step 2: 检查是否需要辩论
    avg_confidence = sum(c for _, c in initial_answers) / len(agents)
    if avg_confidence > confidence_threshold:
        # 高置信度 → 直接多数投票
        return majority_vote([a for a, _ in initial_answers])

    # Step 3: 稀疏辩论 - 构建最小信息图
    debate_graph = build_sparse_graph(agents, initial_answers)
    for round in range(max_rounds):
        for edge in debate_graph.edges:
            source, target = edge
            target.update_with(source.last_response)

    return aggregate_debate_results(debate_graph)
变现评估:这是2025年最值得在生产环境部署的MAD变体。适合作为现有Agent系统的"推理增强插件"——在关键决策节点选择性触发辩论,日常操作保持单Agent高效执行。成本仅为标准MAD的5-10%。
被AAAI 2026接收的iMAD(Intelligent Multi-Agent Debate)从另一个角度解决MAD的效率问题。与S²-MAD的"图结构稀疏化"不同,iMAD专注于"是否触发辩论"这个二值决策。
核心创新:iMAD训练了一个轻量级的"辩论门控器"(Debate Gate),该门控器学习从模型的自我批判(Self-Critique)信号中预测多Agent辩论是否能带来显著改善。门控器的训练数据来自大量实验:对每个问题分别运行单Agent和MAD,记录哪些问题上MAD带来了显著提升。
关键发现: - 约40-50%的问题,MAD无法带来有意义的改善——单Agent已经足够好 - 门控器可以准确识别这些问题,避免无效辩论 - 在"需要辩论"的问题子集上,MAD的提升幅度可达15-25% - 整体上iMAD在保持95%以上MAD准确率的同时,节省了40-50%的Token消耗
与Self-Consistency的关系:iMAD发现,Self-Consistency(单模型多次采样+投票)的方差信号是最佳的辩论触发指标。当多次采样的答案高度一致时,辩论几乎无效;当方差很大时,辩论的价值最高。
变现评估:iMAD的理念可以直接融入任何LLM应用——在推理pipeline中增加一个"辩论门控"节点,让系统自动决定何时启动昂贵的多Agent推理。适合作为SaaS产品的"智能推理模式"。
传统MAD默认的终止条件是"达成共识"——Agent们要达成一致才能输出结果。但2025年的Free-MAD论文指出,追求共识恰恰削弱了多Agent辩论的核心价值——多样性。
Free-MAD的三个核心机制:
实测数据:在8个benchmark数据集上,Free-MAD显著优于标准MAD。尤其在需要"跳出框架思考"的任务上(如创意写作、伦理推理、开放性问题),反一致性正则化让Agent保持了更多元的视角。
代码实现要点:
# Free-MAD 反一致性正则化
def free_mad_debate(query, agents, rounds=3, alpha=0.3):
    answers = {i: agent.generate(query) for i, agent in enumerate(agents)}

    for r in range(rounds):
        new_answers = {}
        for i, agent in enumerate(agents):
            others = [answers[j] for j in range(len(agents)) if j != i]
            context = "\n".join(others)

            # 关键:反一致性提示
            prompt = f"""Question: {query}
            Other agents' answers:
            {context}

            IMPORTANT: Do NOT simply agree with the majority.
            If you find yourself converging, challenge the consensus
            with a novel perspective. Your unique insight matters.

            Your refined answer:"""

            new_answers[i] = agent.generate(prompt, temperature=0.9)
        answers = new_answers

    # 评分聚合(非投票)
    scored = [(answers[i], score_model(answers[i], query))
              for i in range(len(agents))]
    return max(scored, key=lambda x: x[1])[0]
ACL 2025 Findings上发表的"Voting or Consensus?"是迄今为止最系统的多Agent决策协议对比研究。论文控制单一变量(决策协议),在相同Agent配置下测试了7种协议:
| 协议类型 | 具体协议 | 推理任务提升 | 创意任务提升 |
|---|---|---|---|
| 投票类 | 多数投票 (Majority) | +13.2% | +3.1% |
| 投票类 | 加权投票 (Weighted) | +12.8% | +4.7% |
| 投票类 | 排名投票 (Ranked) | +11.5% | +5.2% |
| 共识类 | 统一共识 (Unanimous) | +4.3% | +10.1% |
| 共识类 | 两两共识 (Pairwise) | +6.7% | +8.9% |
| 共识类 | 裁判裁决 (Judge) | +8.1% | +7.3% |
| 混合类 | 先辩论后投票 | +14.7% | +9.2% |
核心发现: 1. 投票协议在推理任务上远胜共识——多数投票+13.2% vs 统一共识+4.3% 2. 共识协议在创意任务上反超——统一共识+10.1% vs 多数投票+3.1% 3. 先辩论后投票的混合模式综合最优——推理+14.7%,创意+9.2% 4. Agent多样性的影响:异构Agent(不同模型)比同构Agent效果提升约3-5%
实操建议:对于大多数生产场景,"先辩论后投票"模式是最佳默认选择。如果是纯数学/逻辑推理,直接多数投票即可(更省Token)。如果是创意生成,用共识协议确保质量。
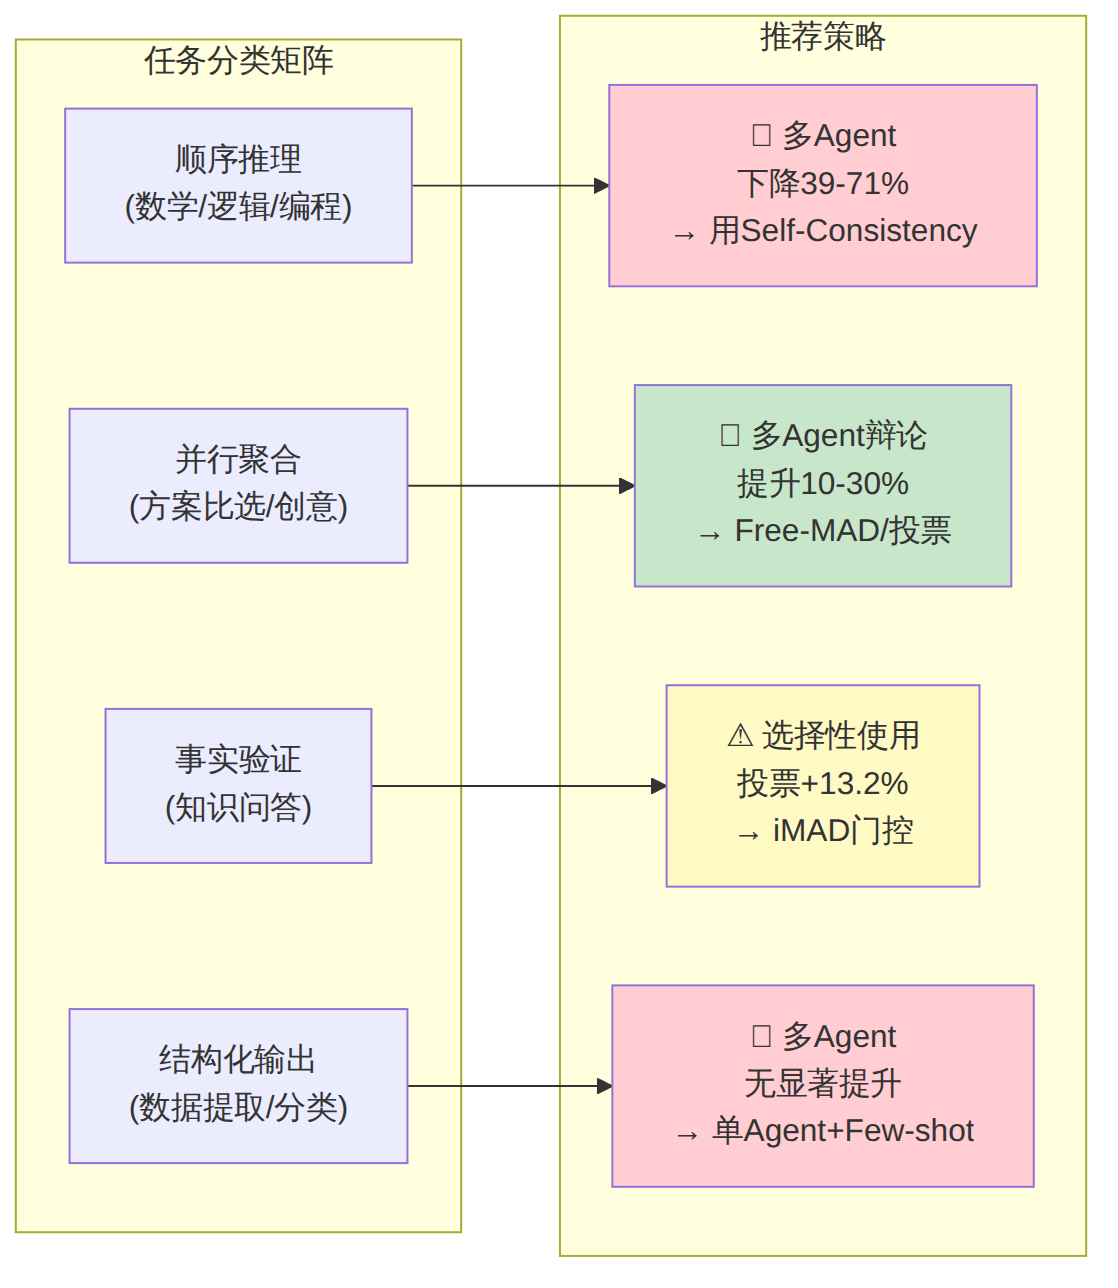
2025年底,Google Research联合MIT发表了"Towards a Science of Scaling Agent Systems",对180种Agent配置进行了受控实验,得出了令人警醒的结论:
关键发现:
顺序推理任务,多Agent全面退步:所有测试的多Agent变体在顺序推理任务上性能下降39-71%。原因包括:信息在Agent间传递时丢失关键推理链;Agent间的"社会性偏差"导致错误传播;多轮交互引入了噪声。
并行聚合任务,多Agent有收益:需要多视角、多方案的任务(如代码审查、方案比选),多Agent确实能带来10-30%的提升。
Agent数量缩放定律:性能与Agent数量呈对数关系——从1到3个Agent提升最大,超过7个几乎无额外收益。这个发现与"More Agents Is All You Need"论文的乐观结论形成鲜明对比。
模型智能度的交互效应:基础模型越强,多Agent带来的边际收益越小。GPT-4级别的模型,3个Agent的增益已经接近饱和。
图表 3
基于当前主流API定价(2026年5月),以GPT-4o级别模型为基准,单次1000 token输入+500 token输出的典型查询:
| 模式 | LLM调用次数 | 总Token消耗 | 预估成本 | 准确率增益 | 性价比排名 |
|---|---|---|---|---|---|
| 单Agent基线 | 1 | ~1,500 | $0.015 | - | - |
| Self-Consistency (5次) | 5 | ~7,500 | $0.075 | +8-12% | ★★★★★ |
| Self-MoA (6+1次) | 7 | ~12,000 | $0.12 | +12-18% | ★★★★☆ |
| 投票协议 (3 Agent) | 3 | ~4,500 | $0.045 | +13.2% | ★★★★★ |
| S²-MAD (3 Agent) | ~3-5 | ~3,000-5,000 | $0.03-0.05 | +10-15% | ★★★★★ |
| iMAD (3 Agent, 门控) | ~4 | ~5,000 | $0.05 | +12-20% | ★★★★☆ |
| 标准MAD (5×3轮) | 15 | ~25,000 | $0.25 | +8-15% | ★★☆☆☆ |
| Free-MAD (4×3轮) | 12 | ~20,000 | $0.20 | +15-22% | ★★★☆☆ |
| MoA (4层×3) | 12 | ~18,000 | $0.18 | +15-20% | ★★★☆☆ |
结论:性价比最高的是Self-Consistency和投票协议——它们用最少的额外Token获得最大的准确率提升。标准MAD是最不经济的选择。S²-MAD是兼顾成本和效果的MAD变体。
推荐:Self-Consistency(5次采样+多数投票)
理由:Google/MIT实验证明多Agent在顺序推理上全面退步。Self-Consistency保留了"多次采样"的好处,避免了Agent间交互带来的推理链断裂。成本仅为标准MAD的30%,效果持平或更好。
from openai import OpenAI
client = OpenAI()

def self_consistency(query, n=5):
    responses = []
    for _ in range(n):
        r = client.chat.completions.create(
            model="gpt-4o",
            messages=[{"role": "user", "content": query}],
            temperature=0.7,
        )
        responses.append(r.choices[0].message.content)

    # 提取最终答案并投票
    answers = [extract_final_answer(r) for r in responses]
    return majority_vote(answers)
推荐:Free-MAD(3-4个Agent,反一致性正则)
理由:创意任务恰恰需要多Agent保持多样性。Free-MAD的反一致性机制防止了"羊群效应",确保每个Agent贡献独特的视角。结合评分聚合,可以选出最优方案。
推荐:iMAD(3个Agent,智能门控)
理由:事实性问题中,约40-50%的问题单Agent已经足够准确。iMAD的门控器可以智能识别哪些问题需要辩论,避免在简单问题上浪费Token。
推荐:Self-MoA(强模型×8次采样+聚合)
理由:Self-MoA在AlpacaEval上刷新了SOTA,且只需要一个模型。8次采样+聚合的总成本约为标准MoA的一半,效果更优。
推荐:分层决策管道
def production_pipeline(query, query_type):
    """生产环境多Agent推理管道"""

    # 第一层:置信度评估
    primary_answer, confidence = primary_agent.infer_with_confidence(query)

    if confidence > 0.85:
        return primary_answer  # 高置信度,直接返回

    # 第二层:根据问题类型选择策略
    if query_type == "reasoning":
        return self_consistency(query, n=5)  # 数学推理用自一致性
    elif query_type == "creative":
        return free_mad(query, n_agents=3)  # 创意用Free-MAD
    elif query_type == "factual":
        return voting_protocol(query, n_agents=3)  # 事实用投票
    else:
        return imad_gate(query)  # 其他用iMAD门控
2025-2026年的研究趋势清晰表明,多Agent推理正从"暴力堆Agent"转向"精准用Agent"。三个关键方向值得关注:
自适应Agent数量:不是固定3个或5个Agent,而是根据问题难度动态调整。简单问题1个Agent,中等难度3个,高难度5个——但必须有可靠的难度评估器。
层次化辩论:借鉴人类专家讨论的模式——先小组讨论(2-3人),然后代表汇报,最后全体投票。GroupDebate论文已初步验证了这种"分组→汇总→决策"的层次化结构可以将Token消耗降低40%同时保持准确率。
辩论蒸馏:用多Agent辩论生成高质量训练数据,然后蒸馏回单Agent模型。这样在推理时不需要多Agent,但享受了辩论带来的质量提升。这是解决"Token通胀"问题的根本路径。
[!tip] 51学通信知识星球 星主:爱卫生(微信:gprshome201101)——公众号「51学通信」创办者,19 年通信行业运维与讲师经验,著有《GPRS网络信令实例详解》《EPC原理与实践》《5G核心网原理与实践》三本纸质书(各大电商平台有售)。 星球定位:深耕 5G 核心网、IMS、NFV/AI、云原生等 ICT 领域,主打运维岗位与信令分析。 当前规模:5200 篇主题 / 990 个回答,198 元/年。 加入福利:加入星球后请加爱卫生微信,拉您进知识星球年度陪伴与答疑群——不限量回复您的各种问题,另有群内分享。 AI 加持:51学通信知识星球已作为 skill 接入 WorkBuddy,使用 deepseek-4-flash 在海量星球帖子中精准找贴、找视频、找 FAQ 和案例,做总结、找文档和 PPT 等场景全覆盖。
