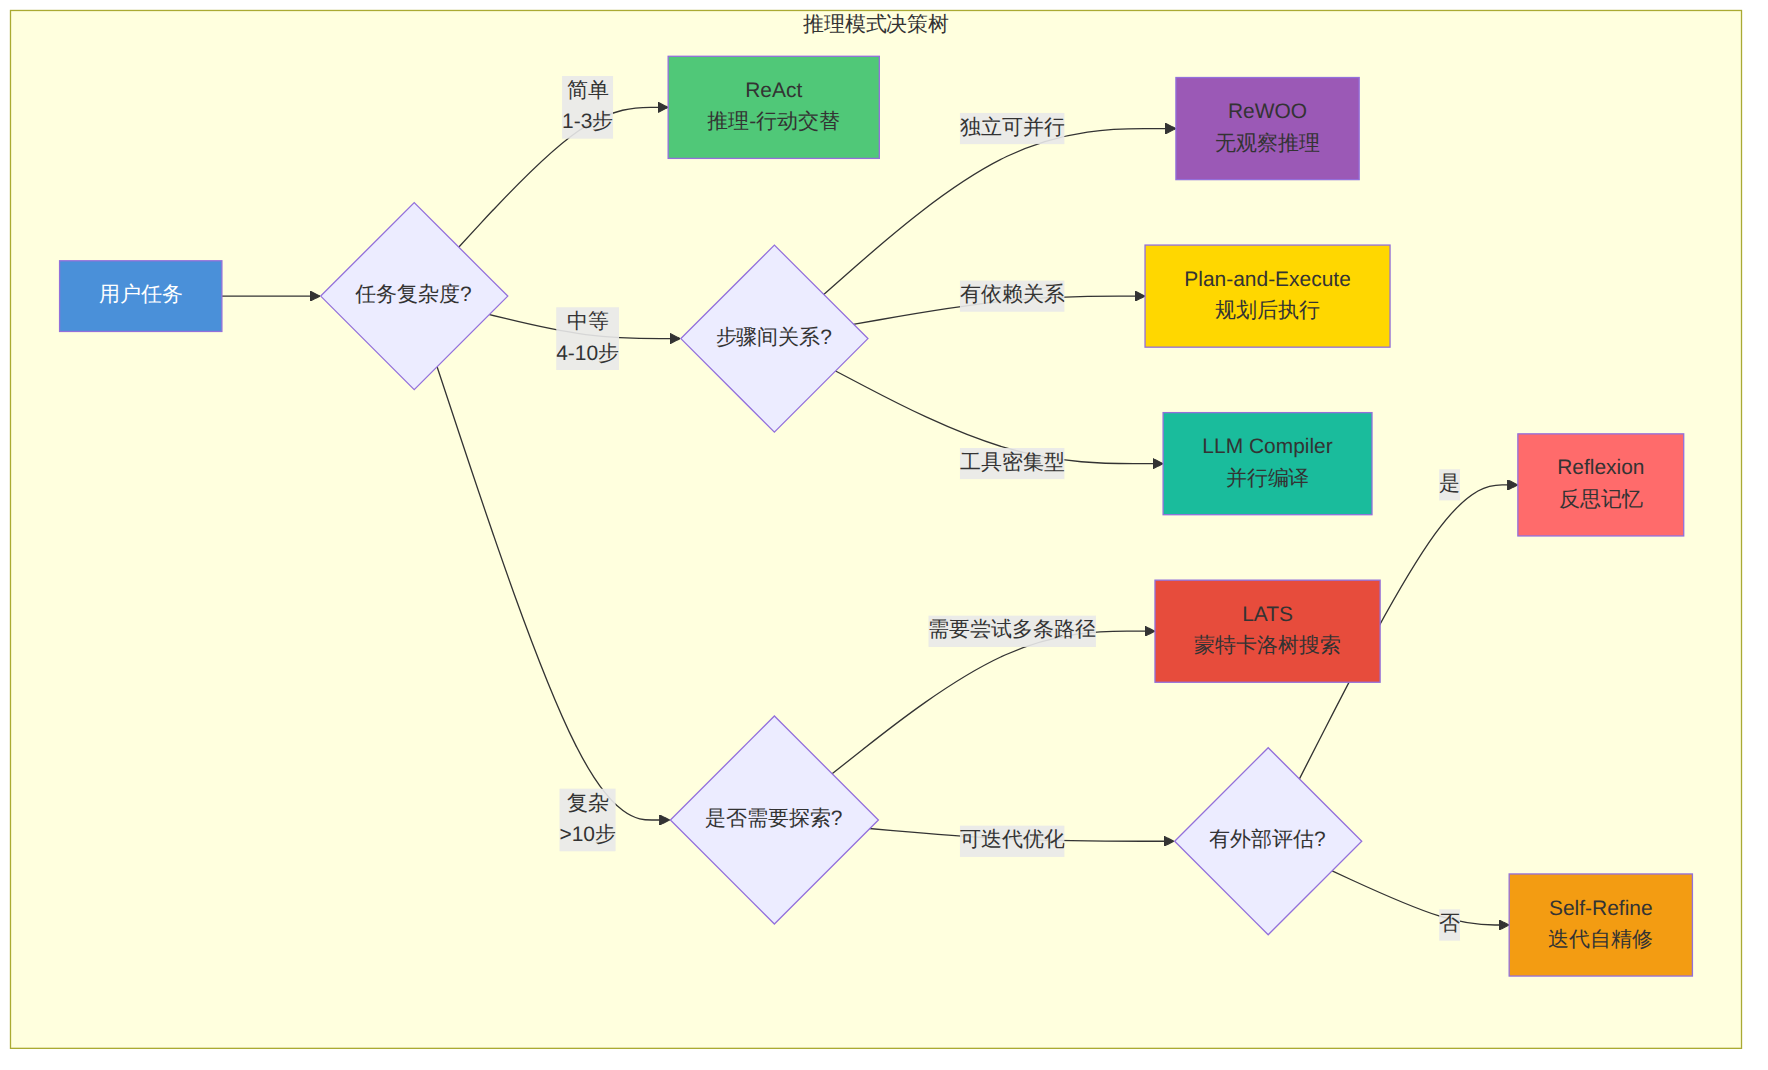
2026年,AI Agent的推理架构已从混沌走向收敛。学术界与工业界在数百篇论文和数千个生产部署中,沉淀出七种核心推理模式:ReAct、Plan-and-Execute、Reflexion、ReWOO、Self-Refine、LATS、LLM Compiler。它们不是框架,而是Agent如何"思考"的底层范式——决定了Token消耗量级、延迟分布、错误恢复策略,乃至整个系统的单位经济学。选错推理模式的代价是灾难性的:同一任务,不同模式的Token消耗可相差5-8倍,成功率可相差40%以上。本文基于最新基准测试数据和生产部署报告,逐一拆解七种模式的核心机制、适用场景、代码实现和成本结构,给出面向不同业务场景的架构决策矩阵。
| 维度 | ReAct | Plan-and-Execute | Reflexion | ReWOO | Self-Refine | LATS | LLM Compiler |
|---|---|---|---|---|---|---|---|
| 核心思想 | 推理与行动交替 | 先规划后执行 | 失败反思记忆 | 无观察推理 | 迭代自反馈 | 蒙特卡洛树搜索 | 并行函数编译 |
| 学术来源 | Yao et al. 2022 | Wang et al. 2023 | Shinn et al. 2023 | Xu et al. 2023 | Madaan et al. 2023 | Zhou et al. 2023 | Kim et al. 2024 |
| LLM调用/步 | 1次 | 1-2次(规划+执行) | 1次+反思额外 | 1次(批量) | 2-3次/迭代 | 3-5次/节点 | 1次(并行调度) |
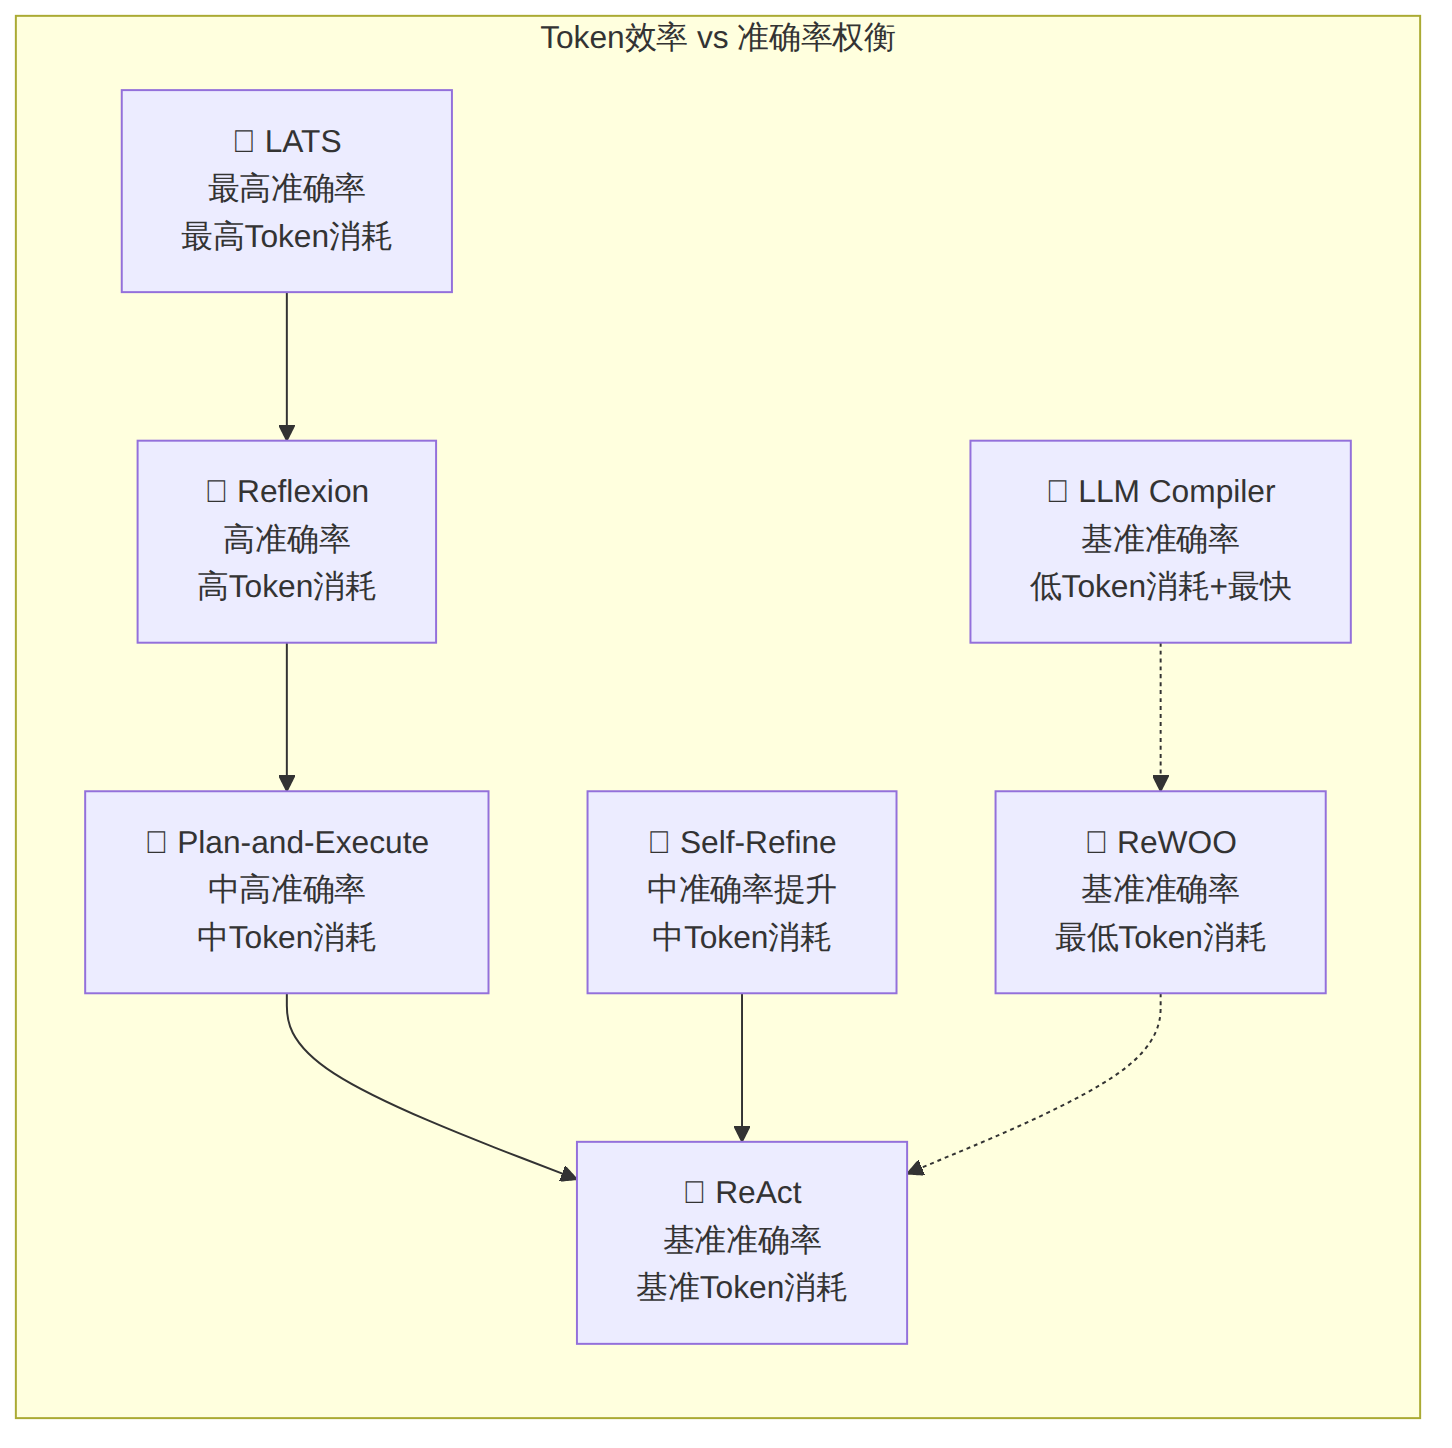
| Token消耗 | 中 | 中高 | 高 | 低 | 中 | 极高 | 低 |
| 延迟特性 | 线性递增 | 首步高+线性 | 多轮累积 | 首步高+快速执行 | 迭代递增 | 指数级搜索 | 显著并行加速 |
| 错误恢复 | 单步重试 | 重新规划 | 跨轮学习 | 全局重规划 | 迭代修正 | 回溯剪枝 | 任务级重试 |
| 上手难度 | ★☆☆☆☆ | ★★☆☆☆ | ★★★☆☆ | ★★★☆☆ | ★★☆☆☆ | ★★★★★ | ★★★★☆ |
| 最佳场景 | 探索性任务 | 结构化长任务 | 需要学习的任务 | 工具密集型 | 创意/优化类 | 高难度推理 | 高并发工具调用 |
| 生产就绪 | ★★★★★ | ★★★★☆ | ★★★☆☆ | ★★★☆☆ | ★★★★☆ | ★★☆☆☆ | ★★★☆☆ |
ReAct(Reasoning + Acting)是目前生产环境中采用率最高的Agent推理模式,超过70%的Agent应用在底层使用ReAct或其变体。其核心机制极其简洁:Agent在每个步骤中先生成一段"思考"(Thought),然后选择一个"行动"(Action),观察结果(Observation),再进入下一轮思考。
架构原理:ReAct将Agent的推理过程展开为一个严格的循环——Thought → Action → Observation → Thought → ...。每次循环执行一次LLM调用,模型同时输出推理链和工具调用指令。这种交替式设计让Agent的决策过程完全透明可审计。
# LangGraph 中的 ReAct Agent 核心
from langgraph.prebuilt import create_react_agent
from langchain_openai import ChatOpenAI

model = ChatOpenAI(model="gpt-4o")
agent = create_react_agent(model, tools=search_tools)

# ReAct 的本质:每一步都是一次完整的 Think-Act-Observe
result = agent.invoke({
    "messages": [{"role": "user", "content": "分析NVDA最新财报对AI芯片市场的影响"}]
})
# 内部流程:Thought→Search财报→Observe数据→Thought→Search竞品→Observe→Thought→总结
实测数据:在HotPotQA多跳问答基准上,ReAct模式的准确率比纯Chain-of-Thought高约6-8个百分点,但Token消耗增加约30%。在SWE-bench代码修复任务中,ReAct是最稳定的基线模式,成功率波动最小。
关键取舍:ReAct最大的优势是简单可靠,每一步都有明确的观测反馈,错误可精确追溯到具体步骤。最大的局限是串行瓶颈——每一步必须等上一步完成,导致延迟线性累积。对于需要调用5个以上工具的复杂任务,ReAct的延迟和Token成本会快速失控。
变现评估:ReAct是Agent训练营的"Hello World",教学变现价值极高。任何Agent课程都应从ReAct开始,因为理解ReAct是理解所有高级模式的前提。市场上"3天学会AI Agent"类课程的核心卖点就是ReAct。
Plan-and-Execute将Agent的推理过程显式分为两个阶段:规划器(Planner)先生成一个完整的高层计划,然后执行器(Executor)逐步执行每个子任务。这个分离看似简单,却解决了ReAct在复杂任务中的核心痛点——缺乏全局视野。
架构原理:Planner接收用户目标后,生成一个有序的子任务列表。Executor逐个执行子任务,每完成一步可选择性更新状态。关键创新在于可重规划(Replanning)——当某个子任务失败或环境变化时,Planner可以基于当前状态重新生成后续计划,而不是从头开始。
# LangGraph Plan-and-Execute 架构
from langgraph.prebuilt import create_react_agent
from langchain_core.prompts import ChatPromptTemplate

plan_prompt = ChatPromptTemplate.from_messages([
    ("system", "为以下目标创建分步计划。每步应独立可执行。"),
    ("user", "{objective}")
])

# 核心:Planner 和 Executor 是独立的 LLM 调用
# Planner: 生成计划 → [步骤1, 步骤2, 步骤3, ...]
# Executor: 执行当前步骤 → 返回结果
# Replanner: 如果需要,基于已完成步骤重规划剩余部分

from langgraph.graph import StateGraph, START, END

class PlanState(TypedDict):
    objective: str
    plan: list[str]
    current_step: int
    results: list[str]
    final_answer: str

# 图结构: Plan → Execute → (完成?→END : Execute)
#                      ↘ (需要重规划?→Replan→Execute)
实测数据:据LangChain官方博客报告,Plan-and-Execute在多步骤任务中比ReAct平均快1.4-1.8倍(得益于执行器可以并行处理独立子步骤),Token消耗减少15-25%(规划器生成的高层计划比逐步推理的累积Token更紧凑)。在需要4个以上工具调用的任务中,优势尤为明显。
关键取舍:Plan-and-Execute在任务目标清晰、步骤可预判的场景下表现优异,但在需要大量探索的开放式任务中可能不如ReAct灵活。规划质量直接决定执行效率——如果初始计划偏离方向,后续的执行都是浪费。2026年的最佳实践是:用强模型做规划(如Claude Opus/GPT-4o),用快模型做执行(如Claude Haiku/GPT-4o-mini),这能将总成本降低40-60%。
变现评估:Plan-and-Execute是企业级Agent产品的标配模式。金融分析、法律文书、供应链优化等结构化场景直接对口,非常适合包装为"企业Agent实战训练营"的核心模块。
Reflexion在ReAct的基础上增加了一个革命性机制——语言化反思(Verbal Reflection)。当Agent完成任务失败后,它不是简单地重试,而是生成一段自然语言的"反思总结",记录失败原因和改进策略,存储到记忆中。下一次面对类似任务时,Agent会先检索相关的反思记忆。
架构原理:Reflexion的核心循环是Act → Evaluate → Reflect → Store → Retry。Evaluation可以由外部评估器或LLM自评估完成。Reflection生成的不是数值化的奖励信号,而是自然语言的失败分析——这种"语言反馈"比数值奖励更信息密集,也是Reflexion区别于传统强化学习的核心创新。
# Reflexion 核心机制伪代码
class ReflexionAgent:
    def __init__(self):
        self.reflection_memory = []  # 反思记忆库

    def run(self, task, max_trials=3):
        reflections = self.retrieve_relevant_reflections(task)

        for trial in range(max_trials):
            # 执行:带着历史反思做任务
            result = self.act_with_reflections(task, reflections)

            if self.evaluate(result):
                return result  # 成功

            # 反思:生成语言化的失败分析
            reflection = self.generate_reflection(task, result, trial)
            self.reflection_memory.append(reflection)
            reflections.append(reflection)

        return result  # 返回最后一次尝试

# 反思示例:
# "在第2次尝试中,我过早地选择了API路径而没有先验证数据格式。
#  下次应先执行schema检查,再进行API调用。"
实测数据:Reflexion在HumanEval代码生成基准上,经过3轮反思后pass@1可提升12-18个百分点。在HotPotQA上,MAR(Multi-Agent Reflexion)架构将准确率从44%提升到47%。但代价是Token消耗可达ReAct的2-3倍——每轮反思本身就是一次完整的LLM调用,加上记忆检索的开销。
关键取舍:Reflexion的适用场景很明确——需要反复尝试、且有明确成功标准的任务。代码生成、数学推理、游戏策略是理想场景。但不适合一次性的实时交互(如客服对话),因为反思循环的延迟不可接受。另一个隐形成本是反思记忆的管理——随着反思积累,检索相关记忆的准确性和成本都会成为瓶颈。
变现评估:Reflexion是"高级Agent"课程的杀手级内容。将"Agent如何从错误中学习"这个概念包装为课程,比教ReAct更有技术门槛感和卖点。适合面向有一定基础的工程师群体。
ReWOO(Reasoning Without Observation)是最被低估的推理模式之一。它解决了一个被忽视的核心问题:ReAct中每个工具调用的结果观察,都在"污染"上下文窗口,导致后续推理的Token消耗不断膨胀。
架构原理:ReWOO将推理分为三个解耦阶段:
1. Planner:在没有任何工具调用结果的情况下,一次性生成完整的推理计划和工具调用列表,用占位符(如#E1、#E2)代替预期观测值
2. Worker:批量执行所有工具调用,获得实际结果
3. Solver:将工具结果填回占位符,一次性生成最终答案
这种设计的关键洞察:人类专家做规划时也不需要看到每一步的结果——经验足以让你预判整个流程。
# ReWOO 核心流程
plan = planner.invoke(
    "分析X公司并购Y公司的监管风险"
)
# Planner 输出:
# Plan:
#   1. Search(#E1) X公司近期监管记录
#   2. Search(#E2) Y公司行业合规状态
#   3. Search(#E3) 同类并购反垄断案例
#   4. Resolve(#E4) 基于#E1,#E2,#E3综合分析监管风险

# Worker: 并行执行所有工具调用
observations = {
    "#E1": search_tool("X公司监管记录"),
    "#E2": search_tool("Y公司合规状态"),
    "#E3": search_tool("同类并购反垄断案例")
}

# Solver: 一次性合成最终答案
answer = solver.invoke(plan, observations)
实测数据:ReWOO的Token效率是所有模式中最高的。据IBM的研究报告,在工具密集型任务中,ReWOO比ReAct节省40-60%的Token消耗——因为Solver只看到最终结果,而不是每步观察的累积上下文。工具调用可全部并行执行,延迟降低50-70%。在HotPotQA上,ReWOO的准确率与ReAct相当,但总成本降低约一半。
关键取舍:ReWOO的致命局限是对规划质量的极端依赖。如果Planner在第一步就计划错误(比如选错了工具或参数),后续所有执行都是无用功,且没有中间观察来纠偏。NVIDIA NeMo Agent Toolkit将ReWOO作为核心模式之一,并增加了"部分观察反馈"机制来缓解这个问题——本质上是在ReWOO和ReAct之间取折中。
变现评估:ReWOO是"Token经济学优化"主题的核心内容。在成本敏感的企业场景中(每天处理百万级Agent调用的客服、风控系统),ReWOO的效率优势直接转化为成本优势。适合作为"企业Agent成本优化"课程的高级模块。
Self-Refine的核心理念最接近人类写作过程——先出初稿,自我审阅,再修改,循环迭代。它不依赖外部工具,完全依靠LLM自身的反馈循环来提升输出质量。
架构原理:Self-Refine由三个角色合一的组件构成:Generator生成初始输出,Critic对输出提供具体反馈,Refiner根据反馈修改输出。这三个角色由同一个LLM扮演,通过不同的Prompt切换行为。关键约束是反馈必须是具体的、可操作的——不是"这段不好",而是"第三段的论据缺乏数据支撑,建议补充2024年市场增长率"。
# Self-Refine 核心循环
def self_refine(task, max_iterations=3):
    # 初始生成
    output = generator.invoke(f"生成: {task}")

    for i in range(max_iterations):
        # 自我批评
        feedback = critic.invoke(
            f"评估以下输出的质量,给出具体改进建议:\n{output}\n"
            f"评估维度: 准确性、完整性、结构清晰度"
        )

        # 判断是否需要继续
        if "无需改进" in feedback or quality_check(output, feedback):
            break

        # 自我精修
        output = refiner.invoke(
            f"基于反馈改进输出:\n原文: {output}\n反馈: {feedback}\n改进后:"
        )

    return output
实测数据:Madaan等人在NeurIPS 2023发表的原论文中,Self-Refine在代码优化、学术写作、对话生成等7个任务上平均提升15-20%的质量分数。迭代次数的边际效益递减明显——2轮迭代获得约80%的质量提升,第3轮仅额外贡献10-15%。Aicosoft的基准测试显示,在代码生成任务中,Self-Refine 3轮迭代后代码正确率提升约18个百分点,但Token消耗约为直接生成的3-4倍。
关键取舍:Self-Refine最大的优势是无需任何外部工具或基础设施——不需要搜索引擎、不需要API、不需要数据库。这使得它成为最轻量级的Agent推理增强方案。但局限性也很明显:LLM的自我评估能力存在天花板,特别是对于事实准确性——LLM可能"自信地"给出错误的反馈并据此"修正"到错误的方向。在需要事实核查的场景中,Self-Refine必须与外部检索工具结合。
变现评估:Self-Refine是"AI写作助手"和"AI代码审查"产品的核心差异化能力。将这些包装为SaaS产品时,Self-Refine的迭代精修过程本身就可以作为产品展示的卖点——用户可以实时看到AI如何"自我改进"。
LATS(Language Agent Tree Search)是当前最复杂、计算成本最高、但在高难度推理任务上表现最强的模式。它将经典的蒙特卡洛树搜索(MCTS)算法与LLM推理结合,让Agent能够系统性地探索多条推理路径,评估每条路径的价值,并集中资源在最promising的方向上深入。
架构原理:LATS的每次推理过程都是一次完整的MCTS: 1. 选择(Select):从根节点出发,用UCB公式选择最有探索价值的子节点 2. 扩展(Expand):用LLM生成多个候选下一步(思考+行动) 3. 评估(Evaluate):用LLM或外部奖励函数评估每个候选的价值 4. 回溯(Backpropagate):将评估结果向上传播,更新路径上所有节点的价值 5. 反思(Reflect):当搜索陷入死路时,生成反思并回溯
# LATS 核心搜索循环(简化版)
class LATSAgent:
    def search(self, task, max_simulations=30):
        root = Node(state=task)

        for _ in range(max_simulations):
            node = self.select(root)           # UCB选择
            children = self.expand(node)       # LLM生成多候选
            values = self.evaluate(children)   # LLM评估每条路径

            for child, value in zip(children, values):
                child.value = value
                self.backpropagate(child, value)

            # 如果找到足够好的解,提前终止
            if root.best_child().value > threshold:
                break

        return root.best_trajectory()

# LATS 在数学推理中的优势示例:
# 问题: "证明√2是无理数"
# ReAct: 线性尝试一种证明路径 → 如果卡住就失败
# LATS: 同时探索3-5条证明思路 → 评估每条的进展 → 集中深入最有希望的路径
实测数据:LATS在24点游戏(24-Game)上达到74%的成功率,而ReAct仅约40%。在WebArena网页操作基准上,LATS比ReAct高约15个百分点。但这些优异成绩的代价极其高昂——LATS的Token消耗可达ReAct的5-10倍,延迟可达3-5倍。在简单任务上,LATS与ReAct差距不大,过度搜索反而浪费资源。
关键取舍:LATS的核心适用场景是高难度、高价值、容许多次尝试的推理任务——数学证明、复杂代码调试、博弈策略。在这些场景中,准确率提升15个百分点可能价值数千美元,足以覆盖额外的Token成本。但LATS绝不适用于实时交互或成本敏感的批量任务。2026年的趋势是将LATS与快速模式混合使用——先用ReAct尝试,失败后升级到LATS深度搜索。
变现评估:LATS是Agent技术深度内容的王者。在学术型培训或高端技术咨询中,"如何用MCTS增强LLM推理"这个主题有极高的技术壁垒。但不适合面向初学者的课程。
LLM Compiler(ICML 2024)是最新进入主流视野的推理模式,它从传统编译器的流水线并行中汲取灵感,将Agent的工具调用过程编译为可并行执行的DAG(有向无环图)。
架构原理:LLM Compiler由三个组件构成: 1. Task Generator:分析用户请求,识别所有可并行的子任务和它们的依赖关系 2. DAG Executor:按依赖拓扑序并行执行所有无依赖的子任务 3. Result Synthesizer:汇总所有子任务结果,生成最终答案
核心创新是依赖感知的并行调度——不是简单的"所有工具同时调用",而是构建精确的依赖图,最大化并行度同时保证执行顺序正确。
# LLM Compiler 核心流程
from llmcompiler import LLMCompiler

compiler = LLMCompiler(model=ChatOpenAI(model="gpt-4o"))

# 用户请求: "比较AWS、Azure、GCP在AI训练上的性价比"
# Task Generator 输出:
#   Task A (独立): 获取AWS GPU实例定价 → 依赖: 无
#   Task B (独立): 获取Azure GPU实例定价 → 依赖: 无
#   Task C (独立): 获取GCP GPU实例定价 → 依赖: 无
#   Task D (依赖A,B,C): 计算每美元训练性能比 → 依赖: A, B, C
#   Task E (依赖D): 生成对比报告 → 依赖: D

# DAG Executor: A/B/C 并行执行 → D 等待A/B/C完成 → E 等待D
result = compiler.invoke("比较AWS、Azure、GCP在AI训练上的性价比")

# ReAct 需要 5 步串行 × ~2秒/步 = ~10秒
# LLM Compiler: A/B/C 并行 ~2秒 + D ~2秒 + E ~2秒 = ~6秒 (40%加速)
实测数据:LLMCompiler论文报告,在HotPotQA和并行工具调用基准上,比ReAct平均快1.8-2.5倍(取决于可并行化的工具调用比例)。在Berkeley函数调用基准上,准确率与ReAct持平,但Token消耗减少约30%(因为Task Generator一次生成多个子任务,比逐步推理的Prompt更紧凑)。Zylos 2026年4月的研究报告指出,LLM Compiler的理念已进一步演进为"选择性融合"(Selective Fusion),在工具调用密集场景中实现了额外15%的加速。
关键取舍:LLM Compiler的适用前提是任务可分解为多个独立或弱依赖的子任务。对于严格串行的推理链(如每一步依赖前一步的输出),LLM Compiler退化为普通的串行执行,无法发挥优势。它最适合信息聚合类任务——市场调研、竞品分析、多源数据汇总。2026年,LLM Compiler已被集成到LangGraph的Plan-and-Execute模板中作为可选的执行优化策略。
变现评估:LLM Compiler是企业级Agent性能优化的关键技术。在"Agent性能调优"咨询服务中,将客户的串行ReAct Agent迁移到LLM Compiler架构,可直接展示2倍的性能提升,极具说服力。
图表 1
图表 2
| 场景 | 推荐模式 | 备选模式 | 避免使用 | 理由 |
|---|---|---|---|---|
| 客服对话 | ReAct | Plan-and-Execute | LATS, Reflexion | 实时性要求高,串行步骤少 |
| 数据分析报告 | Plan-and-Execute | LLM Compiler | ReAct | 多数据源并行+结构化输出 |
| 代码生成与调试 | Reflexion | LATS | Self-Refine | 需要从失败中学习,有编译器评估 |
| 市场调研 | LLM Compiler | ReWOO | ReAct | 多信息源并行聚合 |
| 文案/创意写作 | Self-Refine | Plan-and-Execute | ReWOO | 迭代精修效果最好 |
| 数学推理 | LATS | Reflexion | ReWOO | 需要探索多条证明路径 |
| 金融风控 | ReWOO | Plan-and-Execute | LATS | 成本敏感+工具密集 |
| DevOps自动化 | Plan-and-Execute | ReAct | Self-Refine | 步骤固定+可重规划 |
| 研究论文分析 | ReWOO | LLM Compiler | LATS | 高Token效率+多工具调用 |
生产环境中,单一模式已不足以应对复杂需求。2026年的前沿实践是模式混合与动态切换:
层级混合(Hierarchical Mixing):外层用Plan-and-Execute做任务规划,每个子任务内部用ReAct执行,失败时升级到Reflexion或LATS。Perplexity的搜索Agent就采用了这种模式——先规划搜索策略,再用ReAct执行搜索,最后用Self-Refine优化摘要质量。
成本自适应(Cost-Adaptive Switching):设置Token预算阈值,在预算内用ReAct探索,接近预算上限时切换到ReWOO或直接生成。这种模式在企业级产品中越来越常见,因为客户需要可预测的成本。
难度路由(Difficulty Routing):用一个小模型快速判断任务难度,简单任务路由到ReAct,中等任务路由到Plan-and-Execute,困难任务路由到LATS。据theAIEngineer的分析,这种路由策略可将整体准确率提升12-15%,同时将平均Token消耗降低30%。
# 混合架构示意(伪代码)
class AdaptiveAgent:
    def route(self, task):
        difficulty = self.classifier.invoke(task)  # 快速分类

        if difficulty == "simple":
            return self.react_agent      # ReAct: 快速、低成本
        elif difficulty == "medium":
            return self.plan_exec_agent   # Plan-and-Execute: 结构化
        elif difficulty == "hard":
            return self.lats_agent        # LATS: 深度搜索
        else:  # "iterative"
            return self.reflexion_agent   # Reflexion: 从失败学习

    def run(self, task, token_budget=5000):
        agent = self.route(task)
        result = agent.invoke(task)

        if result.failed and token_budget > 3000:
            # 升级到更强模式重试
            result = self.lats_agent.invoke(task)

        return result
第一,没有"最佳"模式,只有"最适合"的模式。ReAct是基准线,其他模式都是针对特定痛点的优化。选择的核心是理解任务的约束条件——延迟预算、成本预算、准确率要求、并行化程度。
第二,Token效率是核心经济指标。在百万级日调用的生产系统中,ReWOO比ReAct节省40-60%的Token,意味着每月可节省数万美元。这个差距足以影响产品的商业可行性。
第三,混合架构是必然趋势。2026年的领先Agent产品(Perplexity、Cursor、Devin等)都已采用某种形式的模式混合。理解单一模式是基础,但构建混合架构才是核心竞争力。
第四,LATS值得密切关注。虽然目前成本过高不适合生产部署,但随着模型推理成本持续下降(2024-2026年每Token成本下降了约90%),LATS在成本可行场景中的应用正在快速扩展。
[!tip] 51学通信知识星球 星主:爱卫生(微信:gprshome201101)——公众号「51学通信」创办者,19 年通信行业运维与讲师经验,著有《GPRS网络信令实例详解》《EPC原理与实践》《5G核心网原理与实践》三本纸质书(各大电商平台有售)。 星球定位:深耕 5G 核心网、IMS、NFV/AI、云原生等 ICT 领域,主打运维岗位与信令分析。 当前规模:5200 篇主题 / 990 个回答,198 元/年。 加入福利:加入星球后请加爱卫生微信,拉您进知识星球年度陪伴与答疑群——不限量回复您的各种问题,另有群内分享。 AI 加持:51学通信知识星球已作为 skill 接入 WorkBuddy,使用 deepseek-4-flash 在海量星球帖子中精准找贴、找视频、找 FAQ 和案例,做总结、找文档和 PPT 等场景全覆盖。
