当团队估算AI Agent的运行成本时,通常只看到Token费用——但这仅仅是冰山一角。根据IDC 2026年企业调查,96%的企业报告实际部署成本超出预期,根本原因是Token费用仅占生产环境Agent全加载成本的10%–20%。本文拆解自主Agent的七层隐形成本结构,给出完整的成本公式与盈亏平衡点计算方法,并用来自BCG、Fiddler、Galileo等机构的实测数据,揭示在什么体量下Agent真正能替代人力。
多数团队在评估Agent成本时,采用以下朴素公式:
成本 = Token数量 × 单价
这个公式在开发阶段勉强够用,但进入生产环境后,它遗漏了六项数量级更大的支出。Tian Pan在2026年的单位经济学分析中明确指出:一个中等复杂度的企业级Agent,首年TCO(总拥有成本)为$250K–$650K,其中推理费用不到总支出的四分之一。
这就像买一辆车只计算油费,却忽略了保险、保养、停车、折旧和融资成本。Agent的"油费"透明而低廉,但"隐形成本"才是决定ROI是否转正的关键变量。
| 成本层 | 占TCO比重 | 典型金额(年) | 触发条件 |
|---|---|---|---|
| Token推理费 | 10–20% | $30K–$130K | 每次API调用 |
| 集成工程费 | 15–40% | $37K–$260K | 连接遗留系统/CRM/API |
| 监控可观测性 | 10–20% | $25K–$130K | 生产部署即需要 |
| 人工审核干预 | 15–25% | $37K–$162K | 59.8%的生产Agent需人工review |
| 错误修复补救 | 10–30% | $25K–$195K | 失败后的下游清理 |
| 合规治理 | 10–15% | $25K–$97K | 受监管行业必须 |
| 迭代维护 | 10–15% | $25K–$97K | 模型更新导致行为漂移 |
Token成本是最容易量化的部分,但Agent的Token消耗远超单次问答。Galileo的数据显示,复杂Agent(带工具调用)消耗的Token是简单链式调用的5–20倍,原因是推理循环和重试机制。一个10轮反思循环可以消耗比单次调用多50倍的Token。
不同模型的Token单价差异巨大。以2026年5月的主流定价为例:
| 模型 | 输入$/M token | 输出$/M token | SWE-bench Verified |
|---|---|---|---|
| GPT-4o mini | $0.15 | $0.60 | ~42% |
| Claude Sonnet 4.5 | $3.00 | $15.00 | ~72% |
| GPT-5.4 | $2.50 | $10.00 | ~69% |
| Gemini 2.5 Flash | $0.15 | $0.60 | ~55% |
| DeepSeek V3 | $0.27 | $1.10 | ~50% |
表面上GPT-4o mini最便宜,但考虑到成功率差异,真实"每成功任务成本"可能出现戏剧性反转——这就是aicost.cc提出的核心指标。
将Agent连接到企业遗留系统、CRM、内部API,通常增加15–40%的总实施成本。每个集成需要独立的安全评估、Schema标准化和错误处理逻辑。内部自建一套稳定的集成工作流需要6–18个月。这也是为什么MCP(Model Context Protocol)在2026年被所有主流云厂商采纳——它本质上是将集成成本从"每个接口单独开发"降为"一次适配、全局复用"。
实际案例:一家中型电商公司构建供应链优化Agent,集成阶段成本从原型期的$5K/月暴增至$50K/月,原因是未优化的RAG查询拉取了10倍于所需的上下文数据。
运行LLM流水线而没有可观测性,意味着你将从用户投诉而非监控面板发现故障。Fiddler记录了一个典型案例:一个Agent在凌晨3点对不稳定API进入重试循环,烧掉$400 API费用却产出为零。
完善的监控需要Span级追踪——记录Agent每一步的动作、Token消耗、工具调用结果。这增加10–20%的运营预算,但没有它的代价是灾难级的。
LangChain 2026年Agent工程状态调查显示,59.8%的生产部署仍依赖人工审核。这笔费用不会出现在AI预算中——它藏在运营团队的人力成本里。从"人工在环"过渡到全自主运营,通常需要数月的监督运行来建立信任,且伴随严格的分阶段放权策略。
Agent失败的成本不只是浪费的Token。它包括: - 诊断失败原因的工程时间 - 清理下游数据损坏的人力时间 - 重试导致的Token消费倍增
关键数学:一个6步工作流,每步失败概率10%,整体成功率仅53%——这意味着近一半的任务需要某种形式的人工干预。一个下游API不稳定率12%的故障,可以通过重试级联将总API成本增加三倍。
# 失败概率的复利计算
def chain_success_rate(step_success_rate, num_steps):
    """多步工作流的整体成功率"""
    return step_success_rate ** num_steps

# 示例:6步工作流,每步90%成功率
overall = chain_success_rate(0.90, 6)  # = 53.1%
# 10步工作流
overall_10 = chain_success_rate(0.90, 10)  # = 34.9%
# 3个Agent串联,每个70%成功率
multi_agent = chain_success_rate(0.70, 3)  # = 34.3%
受监管行业(金融、医疗、保险)需将AI预算的15%分配给事件响应框架。不可变审计日志每次调用增加5–10ms延迟,存储量每月增长约15%。实时监控基础设施在企业规模下每年增加$2–5M。
非平凡的Agent在开发阶段需要100+评估周期,且这不会在发布后停止。模型供应商更新后行为漂移意味着持续调优是一项持续运营成本,而非一次性设置。
真实每任务成本 = (Token成本 + 基础设施分摊)
                × (1 + 重试开销率)
                + 人工审核时间 × 人工费率
                + 错误率 × 平均补救成本
                + 年度构建维护成本 / 年任务量

其中:
  重试开销率 = 错误率 × 平均重试次数 × 每次重试成本
  年任务量 = 决定固定成本的摊薄速度
这个公式的核心含义:正确的比较不是"Agent成本 vs API成本",而是"全加载Agent成本 vs 全加载人力成本"。
决定Agent ROI最可靠的单一变量不是任务类型,而是任务量。
月任务量 < 1万:摊薄的构建维护成本占主导,大多数Agent无法回本
月任务量 1万–5万:取决于每任务人力成本和错误率
月任务量 > 5万:自动化通常对广泛任务类型有利
来自文档记录案例的具体数据:
| 场景 | 盈亏平衡点 | 规模化后Agent月成本 | 替代人力月成本 | ROI |
|---|---|---|---|---|
| 并行代码生成 | ~100任务/天 | ~$900 | $20K+ | >2000% |
| 发票处理 | ~5万张/月 | $0.09/张 | $0.12/张 | ~33% |
| 客服分流 | 300万件/年 | — | — | 575% |
| 客服分流(小规模) | 5万件/年 | — | — | ≈0% |
最常见ROI失败模式是:一个工程精良的Agent被部署在永远无法覆盖固定成本的业务量上。Agent运行良好,但经济学不成立。
Fiddler 2026年报告披露了生产环境Agent失败的残酷数据:
BCG报告则从正面给出数据:早期企业Agent部署在编码、合规、供应链领域产生了30–90%的速度和生产力提升。 但这仅适用于已跨过规模阈值且完成基础设施加固的团队。
Princeton研究者的发现尤其值得关注:评估了14个Agent模型后,尽管18个月来能力快速提升,可靠性仅有小幅改善。这意味着降低失败率的瓶颈不在模型能力,而在系统架构。
单纯比较Token单价会得出错误结论。考虑一个客服自动化场景(来自aicost.cc预设参数):
场景:客服自动化
  月请求量:18,000
  平均Token/请求:670
  目标成功率:92%
  冗余缓冲:10%
| 模型 | 每成功任务成本 | 月总成本 | 实际达标率 |
|---|---|---|---|
| GPT-4o mini | $0.0018 | $32.40 | 需多轮重试 |
| Claude Sonnet 4.5 | $0.0042 | $75.60 | 较少重试 |
| Mixtral 8x7B (自托管) | $0.0024 | $43.20 | 中等重试 |
如果GPT-4o mini的单次成功率仅75%,而Claude Sonnet达90%,则考虑重试成本后Claude可能反而更便宜。这是Agent成本分析中最容易被忽视的反直觉结论。
生产事后分析中最一致的发现是:Agent在开发环境和生产环境的成本差距为5–15倍。这个差距有可预测的结构:
开发阶段:固定团队 + 受限测试集 + 有界API调用 + 失败无下游损失
生产阶段:需要冗余 + 自动扩容 + 故障转移 + 失败产生级联损失
开发环境100任务/天的错误率看起来可以接受,但在5万任务/天时完全不同。Agent性能从单次运行60%成功率降至连续8次运行25%,这种退化在开发阶段用20个任务测试时几乎不可见,在2万任务时却非常显著。
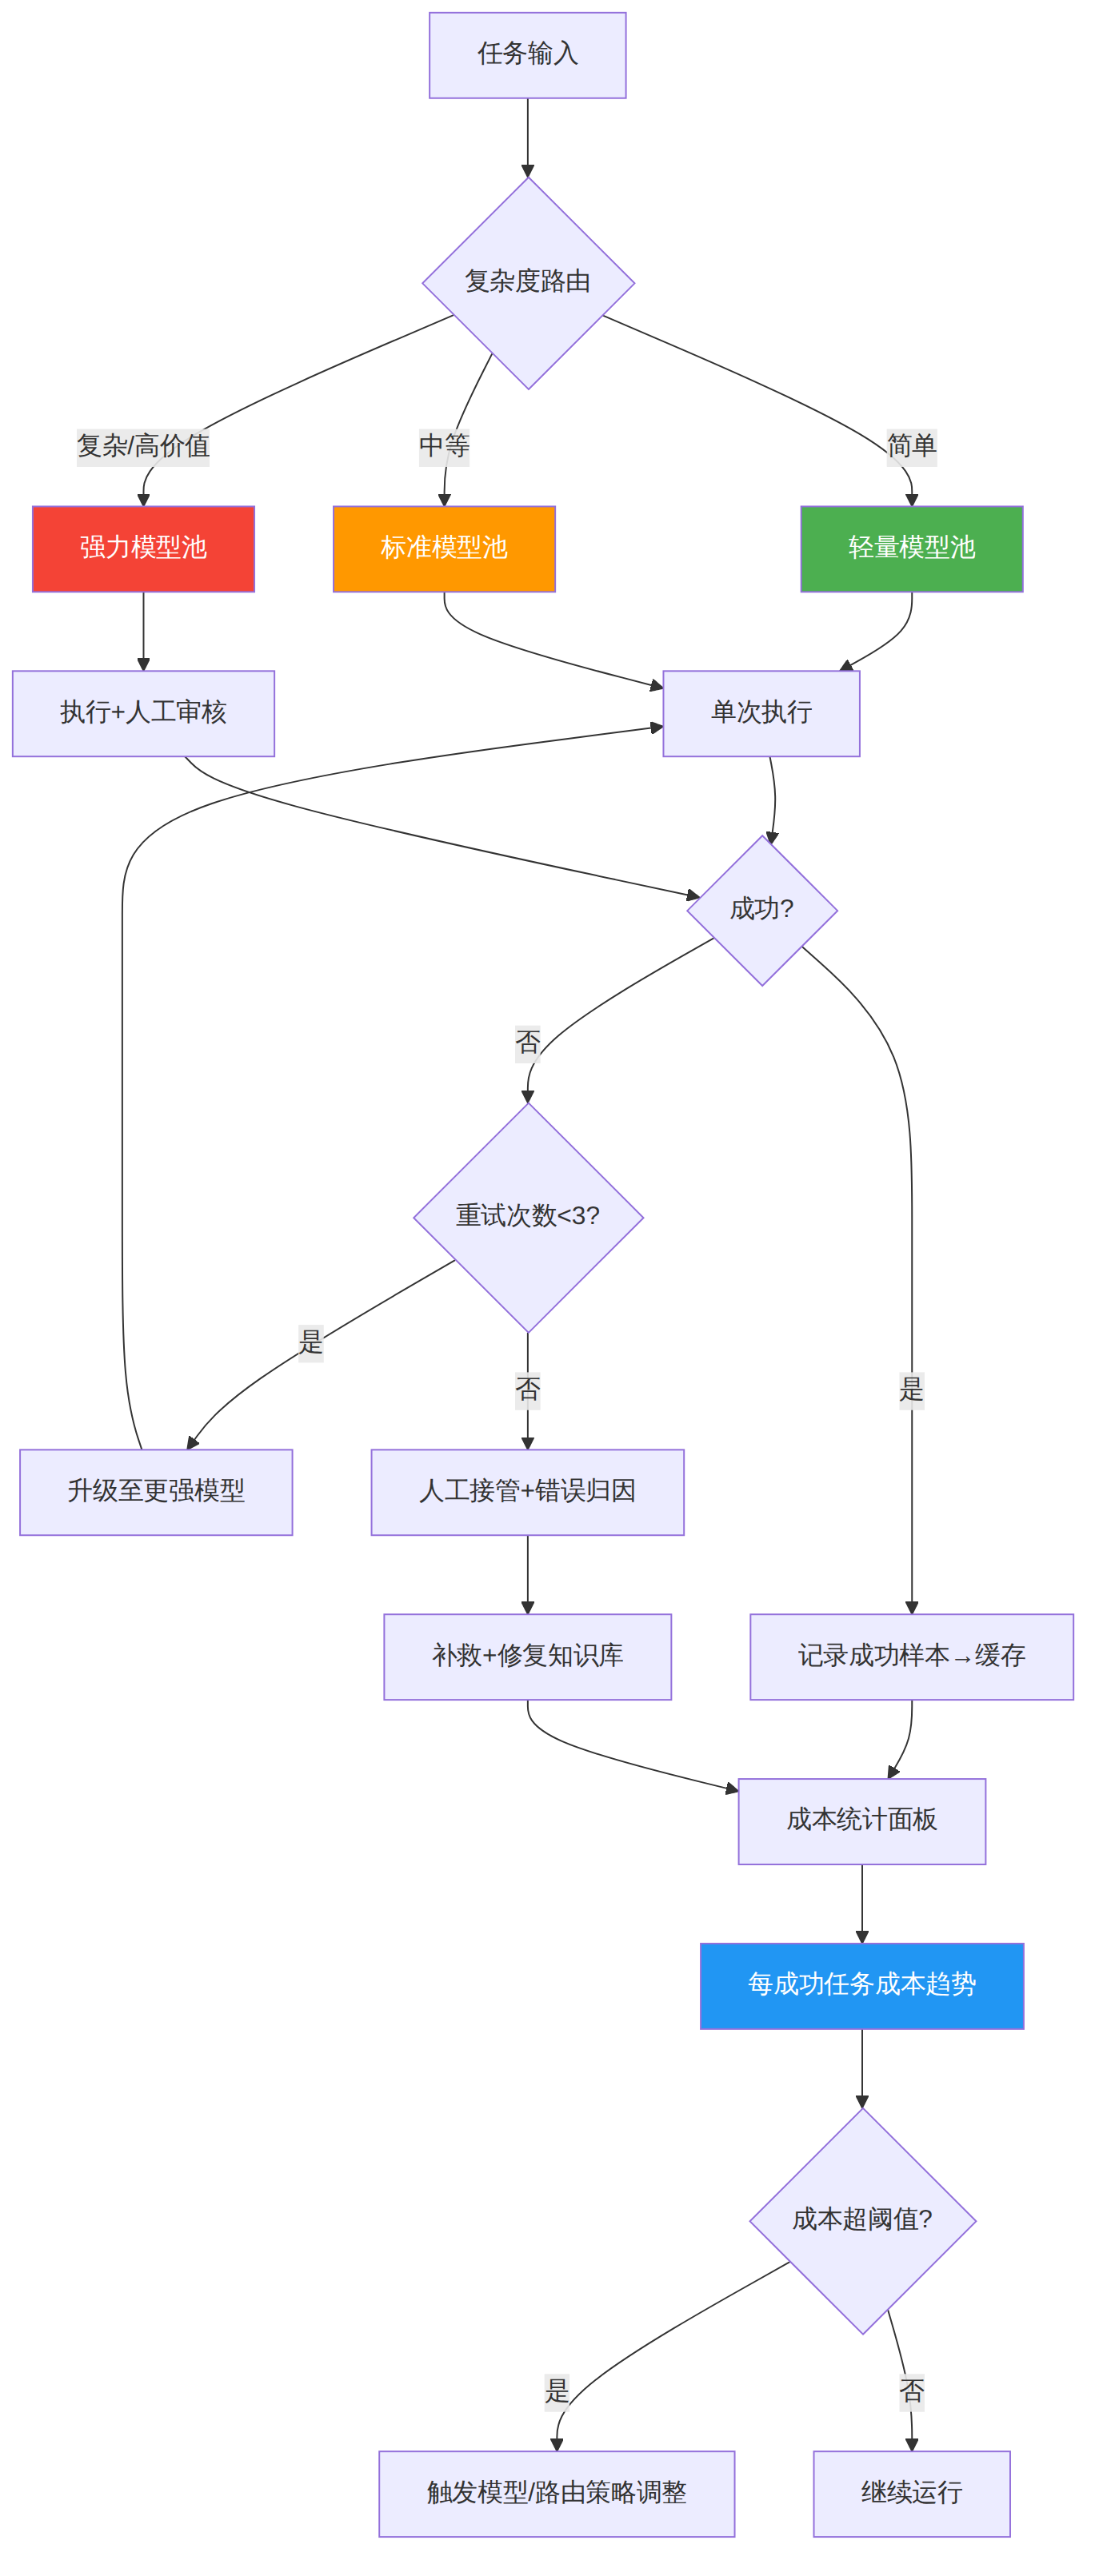
简单查询 → 轻量模型(GPT-4o mini / Flash)
复杂查询 → 中等模型(Sonnet / GPT-5)
高价值任务 → 强力模型(Opus / GPT-5.4)+ 人工审核
通过将80%的简单任务路由到便宜模型,Token费用可降低60–70%,同时保持关键路径的高质量。
Galileo提出的方案:将评估从GPT-4($0.01–0.10/样本)切换到专用小模型(如Luna-2,$0.0002/M token),评估成本降低97%,同时保持与人类判断的高相关性(Pearson's r > 0.85)。
将大Agent拆分为更小的专业单元,减少协调开销约20%。配合轻量级通信协议(如gRPC),可显著降低多Agent场景的37%消息传递额外开销。
语义相似度阈值剪枝可将RAG上下文缩减15–25%,数据集去重可减少15–25%的存储需求。对于高频重复查询,缓存层可将Token消耗降低一个数量级。
图表 1
这个架构的核心思想:成本控制不是事后优化,而是系统设计的起点。每个请求经过复杂度路由分配到最优模型,失败后升级而非盲目重试,所有数据汇入成本面板驱动动态调整。
| 判断维度 | 适合Agent | 适合传统自动化 |
|---|---|---|
| 任务确定性 | 低(需要理解/推理) | 高(规则明确) |
| 月任务量 | >10K | 任意 |
| 单次人力成本 | >$5 | <$3 |
| 错误补救成本 | 低(可回滚) | 高(不可逆) |
| 输入多样性 | 高(非结构化) | 低(结构化) |
| 合规要求 | 中等 | 极高(需100%可审计) |
| 预期使用周期 | >12个月 | 临时/短期 |
核心原则:当"全加载人力成本" > "全加载Agent成本" × (1 + 失败缓冲)时,自动化才有正向ROI。 在10万+月任务量的场景中,即使考虑全部七层隐形成本,Agent自动化的ROI通常仍然显著为正。
[!tip] 51学通信知识星球 星主:爱卫生(微信:gprshome201101)——公众号「51学通信」创办者,19 年通信行业运维与讲师经验,著有《GPRS网络信令实例详解》《EPC原理与实践》《5G核心网原理与实践》三本纸质书(各大电商平台有售)。 星球定位:深耕 5G 核心网、IMS、NFV/AI、云原生等 ICT 领域,主打运维岗位与信令分析。 当前规模:5200 篇主题 / 990 个回答,198 元/年。 加入福利:加入星球后请加爱卫生微信,拉您进知识星球年度陪伴与答疑群——不限量回复您的各种问题,另有群内分享。 AI 加持:51学通信知识星球已作为 skill 接入 WorkBuddy,使用 deepseek-4-flash 在海量星球帖子中精准找贴、找视频、找 FAQ 和案例,做总结、找文档和 PPT 等场景全覆盖。
