当Agent从Demo走向生产环境,第一个被现实击碎的假设是:"LLM每次都能正确返回"。据统计,生产环境中Agent的首次调用失败率在15%~35%之间浮动——API限流、模型幻觉、工具超时、网络抖动,每一个都可能在无人值守的凌晨三点把整个工作流拖入死循环或静默失败。本文聚焦自主Agent的容错与自愈能力,从工程实践角度拆解六大韧性模式,覆盖重试、熔断、降级、死信队列、状态快照、人机审批门控,结合LangGraph、Temporal、OpenAI Agents SDK等主流框架的落地代码,给出每个模式的适用场景和选型建议。
传统软件工程的错误处理基于确定性逻辑——函数要么返回结果,要么抛出已知异常。但Agent的错误空间是开放式的:LLM可能返回结构正确但语义错误的JSON;工具调用可能因权限不足而失败却返回200状态码;多步骤规划可能在第7步才发现前3步的前提假设有误。
图表 1
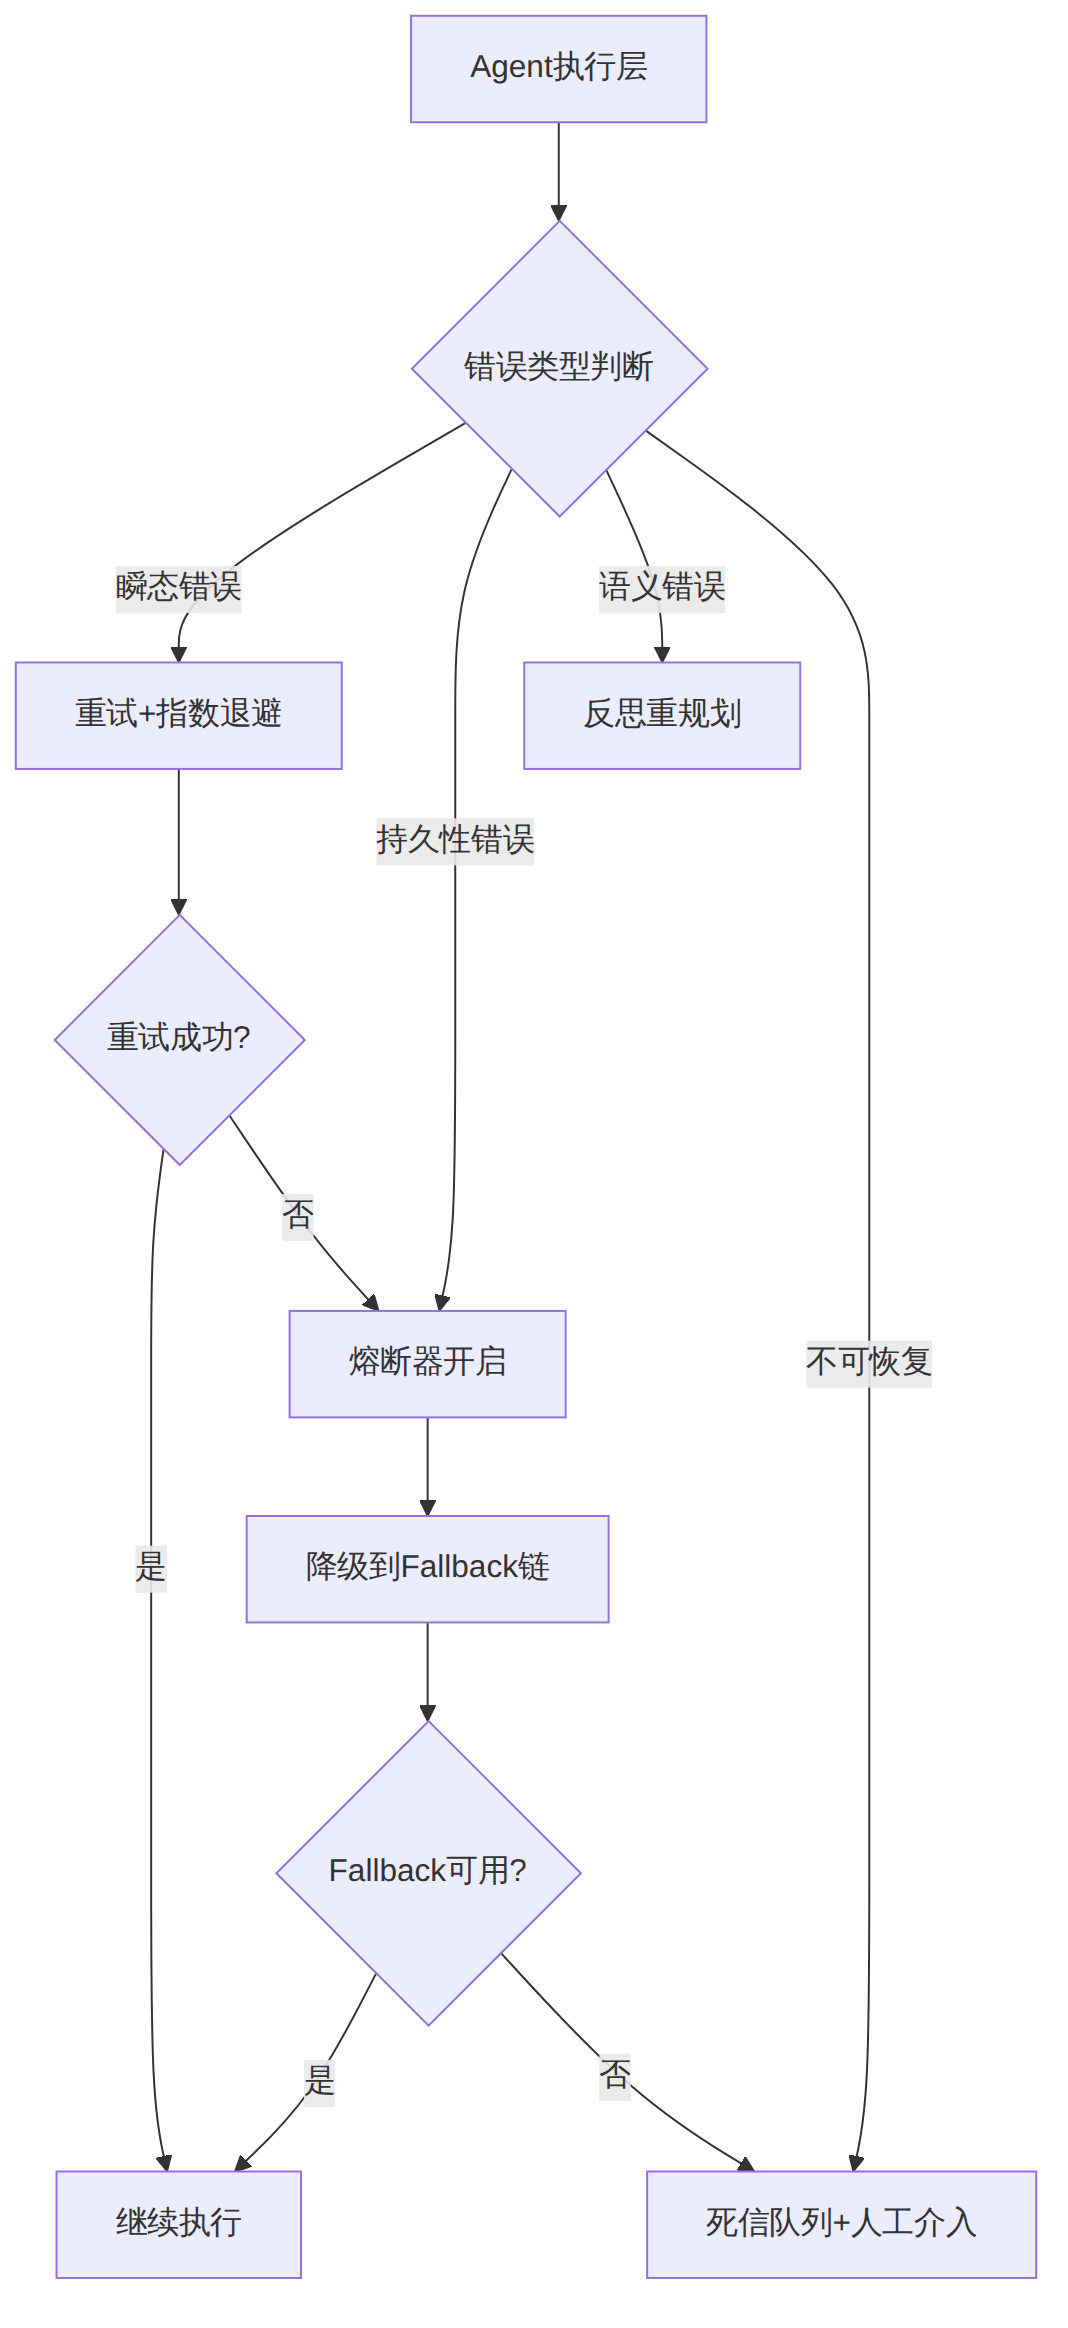
上图描述的是一个典型的Agent容错决策树。关键洞察在于:Agent的错误恢复不能只靠重试,必须根据错误类型选择不同的恢复策略。瞬态错误(网络超时、API限流)适合重试;持久性错误(工具不存在、权限拒绝)需要熔断降级;语义错误(幻觉、逻辑矛盾)需要反思重规划;而不可恢复的错误需要人工介入。
最基础也最容易被误用的模式。核心思想是在每次重试之间增加等待时间,避免"惊群效应"(thundering herd)。但生产环境中,简单的指数退避还不够——必须加入随机抖动(jitter)来打散多个Agent实例的重试时间窗口。
import asyncio
import random
from tenacity import retry, stop_after_attempt, wait_exponential_jitter

@retry(
    stop=stop_after_attempt(5),
    wait=wait_exponential_jitter(initial=1, max=60, jitter=5),
    retry=retry_if_exception_type((RateLimitError, TimeoutError))
)
async def call_llm_with_retry(prompt: str, tools: list) -> dict:
    """带抖动的指数退避重试——仅对瞬态错误生效"""
    response = await client.chat.completions.create(
        model="gpt-4.1",
        messages=[{"role": "user", "content": prompt}],
        tools=tools
    )
    if response.choices[0].finish_reason == "content_filter":
        raise ContentFilterError("内容过滤触发,不适用重试")
    return response
关键陷阱:不要对所有错误类型无差别重试。LLM返回的内容过滤(content_filter)、工具参数校验失败等确定性错误,重试不仅无效,还会白白浪费Token。必须在重试装饰器中精确指定可重试的异常类型。
框架支持:
- LangGraph:内置RetryPolicy,可在节点级别配置重试策略
- OpenAI Agents SDK:Runner.run自带max_turns限制防无限循环,但不提供细粒度重试
- Temporal:原生支持重试策略,可配置InitialInterval、MaximumAttempts、BackoffCoefficient
当某个工具或LLM提供方的错误率超过阈值时,熔断器打开,后续请求直接走降级路径,不再尝试调用。这防止了"雪崩效应"——一个慢工具拖垮整个Agent工作流。
from circuitbreaker import circuit

@circuit(failure_threshold=3, recovery_timeout=30, expected_exception=Exception)
async def search_web(query: str) -> list:
    """Web搜索工具——熔断保护"""
    result = await search_api.search(query)
    return result

熔断器的三状态模型(Closed → Open → Half-Open)与Agent的执行循环天然契合。在Half-Open状态下,允许一个探测请求通过——如果成功,说明下游已恢复,关闭熔断器。

**实战经验**:对LLM API调用设置熔断器时,`failure_threshold`建议设为5次而非3次,因为LLM的延迟波动较大,3次失败可能只是暂时性波动。`recovery_timeout`建议设为60秒以上,给下游服务足够的恢复时间。

### 模式三:降级链(Fallback Chain)

将多个可替代的工具或模型按优先级排列,当首选方案失败时自动降级到次选,形成一条"降级链"。这是构建高可用Agent系统的核心模式。

```python
from langchain_openai import ChatOpenAI
from langchain_anthropic import ChatAnthropic
from langchain_google_genai import ChatGoogleGenerativeAI

class FallbackLLM:
    def __init__(self):
        self.chain = [
            {"model": ChatOpenAI(model="gpt-4.1"), "name": "GPT-4.1", "cost": "high"},
            {"model": ChatAnthropic(model="claude-sonnet-4-6"), "name": "Claude Sonnet", "cost": "medium"},
            {"model": ChatGoogleGenerativeAI(model="gemini-2.5-pro"), "name": "Gemini", "cost": "low"},
        ]
        self.circuit_states = {m["name"]: "closed" for m in self.chain}

    async def invoke(self, prompt: str) -> str:
        for model_config in self.chain:
            if self.circuit_states[model_config["name"]] == "open":
                continue
            try:
                result = await model_config["model"].ainvoke(prompt)
                return result.content
            except Exception as e:
                logger.warning(f"{model_config['name']} failed: {e}")
                self.circuit_states[model_config["name"]] = "open"
                continue
        raise AllModelsFailedError("所有模型均不可用")
降级链的关键设计决策:是否允许跨模型降级时丢失上下文。如果Agent在第3步降级到另一个模型,新模型可能无法理解前两步建立的上下文。解决方案是将完整的对话历史和中间状态作为prompt的一部分传递给降级模型,但这会增加Token消耗。
当所有自动恢复策略都失败时,任务进入死信队列,等待人工处理。这是Agent系统的"最后一道防线"。
from datetime import datetime
import json

class AgentDeadLetterQueue:
    def __init__(self, redis_client):
        self.redis = redis_client
        self.dlq_key = "agent:dlq"

    async def enqueue(self, task_id: str, error_context: dict):
        entry = {
            "task_id": task_id,
            "error": error_context,
            "state_snapshot": error_context.get("agent_state"),
            "timestamp": datetime.utcnow().isoformat(),
            "retry_count": error_context.get("retry_count", 0),
            "priority": self._calculate_priority(error_context)
        }
        await self.redis.zadd(
            self.dlq_key,
            {json.dumps(entry): entry["priority"]}
        )

    def _calculate_priority(self, ctx: dict) -> int:
        """高价值任务优先级更高"""
        base = 100
        if ctx.get("customer_tier") == "enterprise":
            base += 500
        if ctx.get("sla_deadline_hours", 24) < 4:
            base += 300
        return base
死信队列不只是"垃圾桶"——它是一个优先级队列。企业客户的失败任务应该排在免费用户前面。结合LangGraph的checkpoint机制,DLQ中的任务可以在修复后从失败点恢复执行,而非从头开始。
Agent执行到一半崩溃后,能从断点恢复而非从头重跑,这就是检查点的价值。LangGraph通过MemorySaver(内存)和SqliteSaver/PostgresSaver(持久化)实现了开箱即用的检查点机制。
from langgraph.graph import StateGraph
from langgraph.checkpoint.postgres import PostgresSaver

# 构建带检查点的Agent图
graph = StateGraph(AgentState)
graph.add_node("analyze", analyze_request)
graph.add_node("plan", plan_steps)
graph.add_node("execute", execute_step)
graph.add_node("validate", validate_result)

checkpointer = PostgresSaver.from_conn_string("postgresql://...")
app = graph.compile(
    checkpointer=checkpointer,
    interrupt_before=["execute"]  # 在执行前暂停,等待人工审批
)

# 从检查点恢复
config = {"configurable": {"thread_id": "task-12345"}}
state = await app.ainvoke(None, config=config)  # 自动恢复到上次中断点
LangGraph vs Temporal的检查点对比:
| 维度 | LangGraph Checkpoint | Temporal Workflow |
|---|---|---|
| 持久化存储 | Postgres/SQLite | Temporal Server自带 |
| 粒度 | 图节点级别 | Activity级别 |
| 恢复方式 | thread_id + 配置 |
WorkflowId + RunId |
| 超时控制 | 需手动实现 | 原生支持WorkflowTimeout |
| 适用场景 | Agent图执行 | 长时运行分布式任务 |
| 学习曲线 | 低(内置) | 中高(需部署Temporal Server) |
Temporal的检查点在分布式场景下更强——当一个Agent的Activity在节点A失败后,可以在节点B上恢复。LangGraph的检查点更轻量,适合单机或小规模部署。
自主Agent不等于"完全无人干预"。在高风险操作(支付、删除数据、发送邮件)前设置审批门控,是生产环境的基本要求。
# OpenAI Agents SDK的审批模式
from openai import Agent, Runner

agent = Agent(
    name="finance_agent",
    instructions="处理用户退款请求",
    tools=[process_refund, check_order, send_email]
)

# 设置工具级审批
agent.add_guardrail(
    tool_name="process_refund",
    approval_required=True,  # 退款操作需人工确认
    max_auto_retries=2       # 自动重试上限
)

# LangGraph的中断点模式
from langgraph.graph import StateGraph

graph = StateGraph(AgentState)
graph.add_node("review", human_review_node)

app = graph.compile(
    checkpointer=checkpointer,
    interrupt_before=["process_payment"]  # 支付前暂停
)

# 人工审批后继续
state = await app.ainvoke(
    {"approval": "approved", "reviewer": "manager_zhang"},
    config={"configurable": {"thread_id": thread_id}}
)
审批门控的三种实现模式:
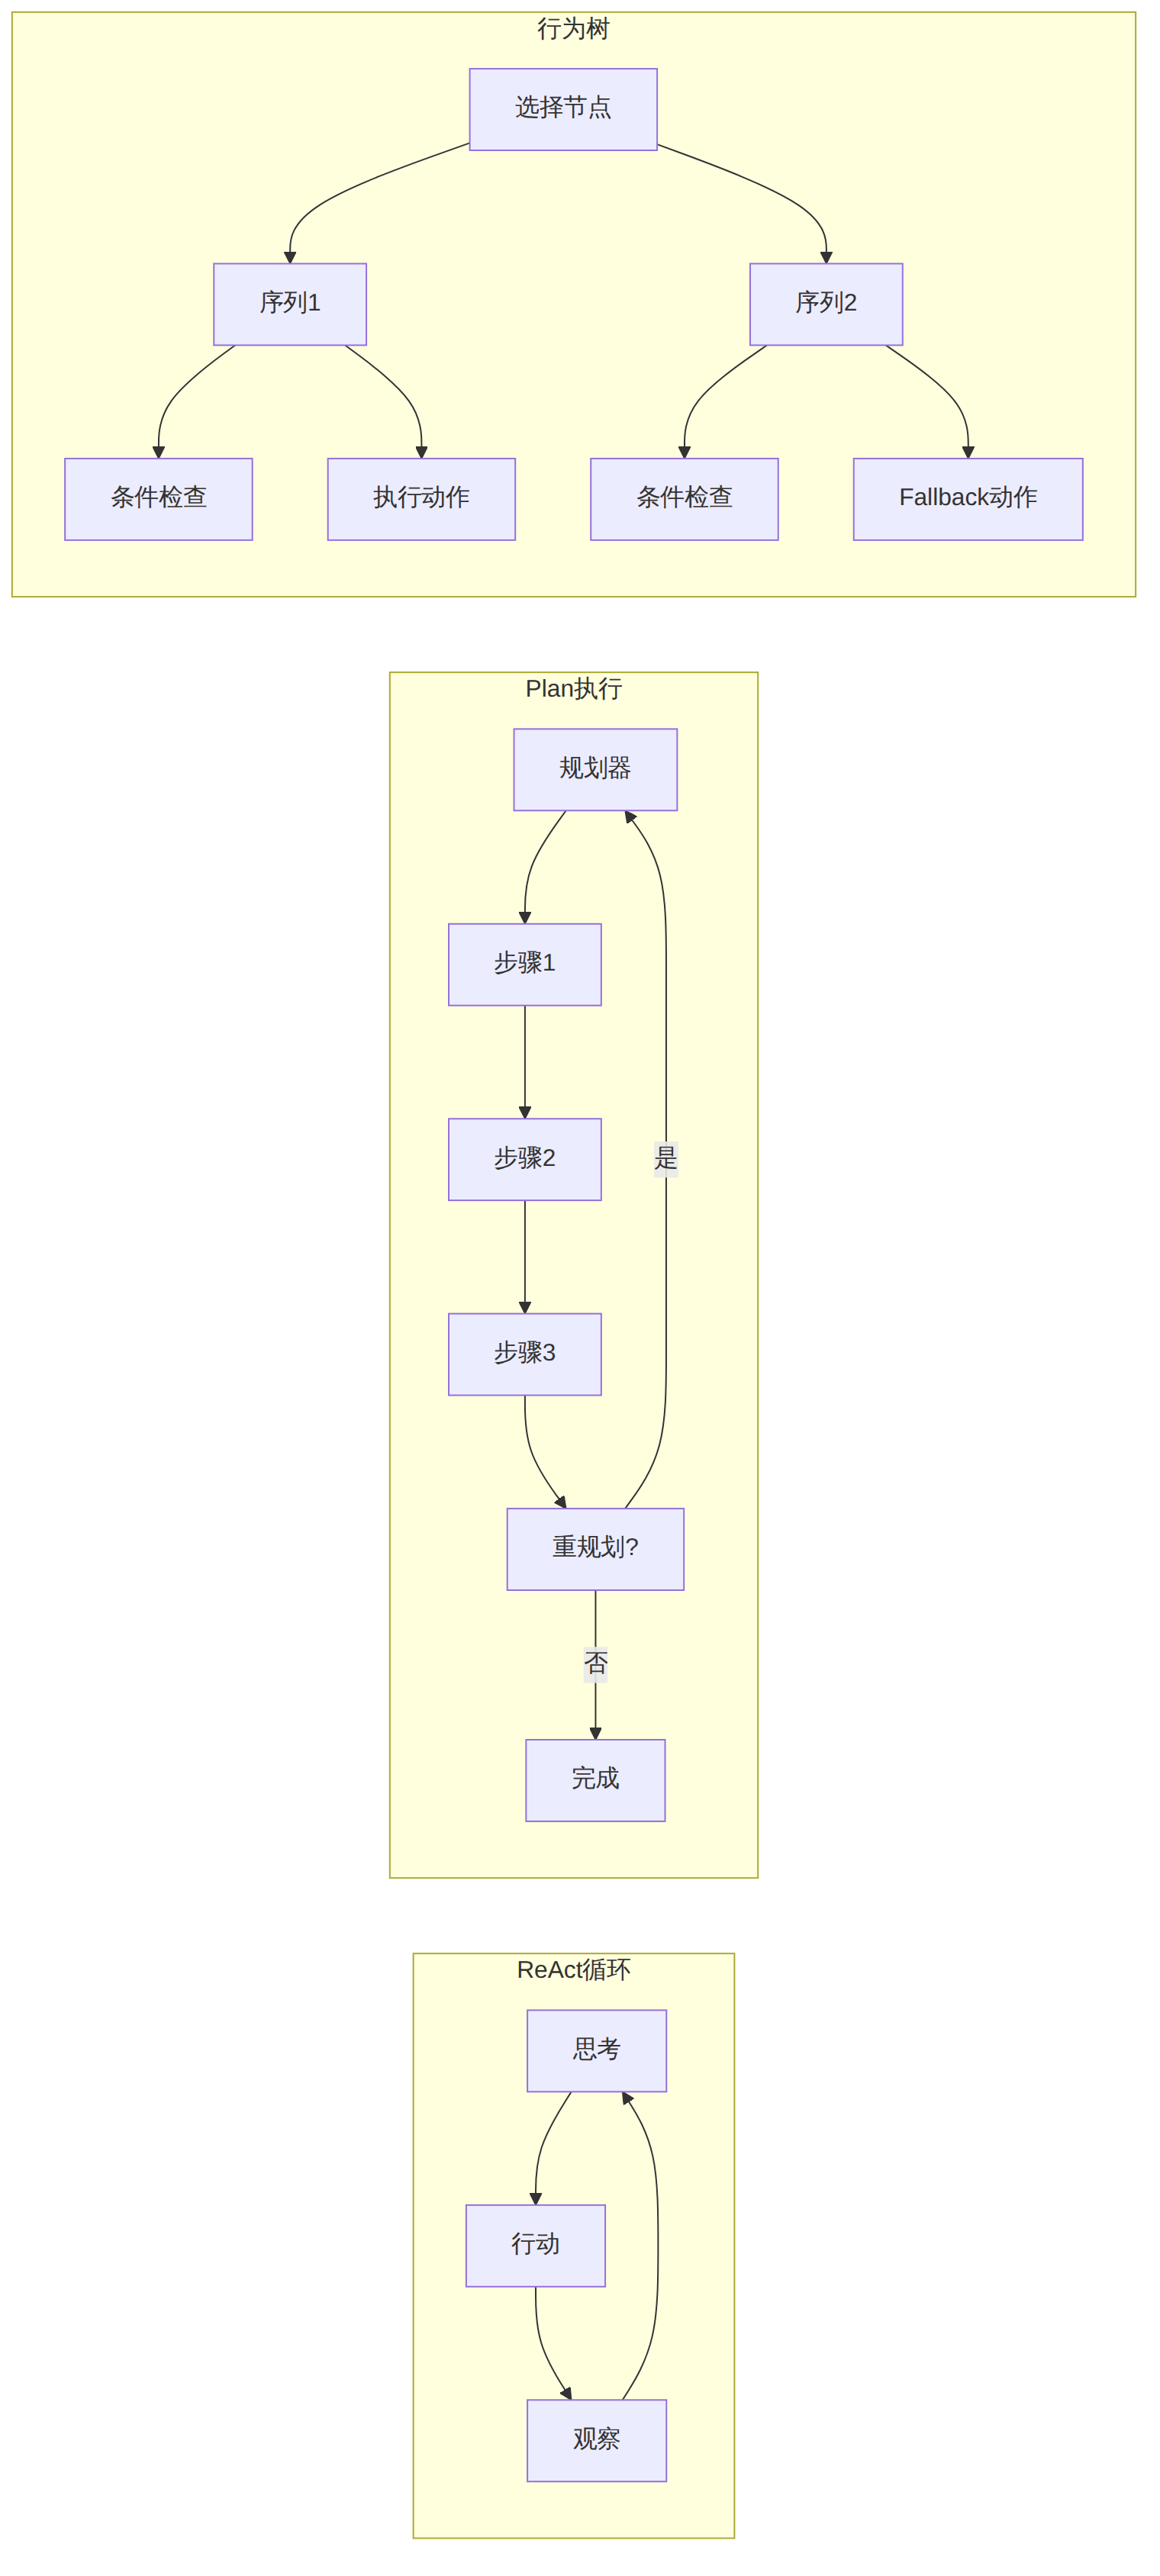
容错模式的选择直接受Agent决策架构的影响。三种主流架构在容错能力上有本质区别:
图表 2
| 维度 | ReAct | Plan-and-Execute | 行为树(Behavior Tree) |
|---|---|---|---|
| 错误检测 | 每步观察即可发现 | 需要执行到某步才暴露 | 条件节点主动检查 |
| 错误恢复 | 自动调整下一步行动 | 触发重规划 | Fallback节点自动降级 |
| 状态管理 | 隐式(对话历史) | 显式(计划+执行状态) | 显式(树节点状态) |
| 最大步数控制 | max_iterations |
计划长度限制 | 树深度限制 |
| 可解释性 | 中(需阅读推理链) | 高(可审查计划) | 高(树结构可视化) |
| 死循环风险 | 高(LLM可能重复) | 中(重规划可能循环) | 低(树天然有界) |
行为树(Behavior Tree)是2025-2026年Agent领域的新趋势。源自游戏AI和机器人领域的行为树,提供了比ReAct循环更结构化的决策框架。其核心优势在于:
LinkedIn上一篇来自Zahir Shaikh的文章详细描述了如何用行为树控制Agent的决策过程——将Agent的每一步推理映射为行为树节点,利用Sequence节点保证执行顺序,利用Selector节点实现条件分支和Fallback。
| 韧性模式 | 解决的核心问题 | 实现复杂度 | Token额外开销 | 适用框架 | 推荐场景 |
|---|---|---|---|---|---|
| 指数退避重试 | 瞬态错误恢复 | ★☆☆ | 无 | 所有 | 必选,所有Agent都应配备 |
| 熔断器 | 防止雪崩效应 | ★★☆ | 无 | LangGraph/Temporal | 依赖外部API的Agent |
| 降级链 | 服务降级可用 | ★★★ | 10-30%(上下文传递) | 自定义/LangChain | 多模型/多工具Agent |
| 死信队列 | 最终兜底 | ★★☆ | 无 | Redis/消息队列 | 无人值守的生产Agent |
| 状态检查点 | 崩溃恢复 | ★★☆ | 存储开销 | LangGraph/Temporal | 长时运行的复杂任务 |
| 人机审批 | 高风险操作 | ★★☆ | 等待人工时间 | LangGraph/OpenAI SDK | 涉及金钱/数据的操作 |
两个当前最主流的Agent容错框架,在架构哲学上存在根本差异。
LangGraph把容错能力嵌入到Agent图定义中——每个节点可以有独立的重试策略,每条边可以是条件路由。优势是开发者只需关心业务逻辑,容错由框架处理。劣势是当需要跨服务分布式容错时,LangGraph的检查点机制不够强。
Temporal把容错能力提升到基础设施层面——Workflow的每一步都自动持久化,Activity失败后可以在不同机器上重试。优势是真正的分布式容错,劣势是学习曲线陡峭,需要额外部署Temporal Server。
# Temporal Agent Workflow示例
from temporalio import workflow, activity

@activity.defn
async def call_llm(prompt: str) -> str:
    # Activity自动重试+持久化
    response = await client.chat(prompt)
    return response

@workflow.defn
class AgentWorkflow:
    @workflow.run
    async def run(self, task: str) -> str:
        # Step 1: 分析任务
        analysis = await workflow.execute_activity(
            call_llm, f"分析任务: {task}",
            start_to_close_timeout=timedelta(seconds=30),
            retry_policy=RetryPolicy(
                maximum_attempts=5,
                initial_interval=timedelta(seconds=1),
                maximum_interval=timedelta(seconds=60),
            )
        )
        # Step 2: 如果分析失败,Workflow会自动从检查点恢复
        plan = await workflow.execute_activity(
            call_llm, f"制定计划: {analysis}",
            start_to_close_timeout=timedelta(seconds=60)
        )
        return plan
选型建议:
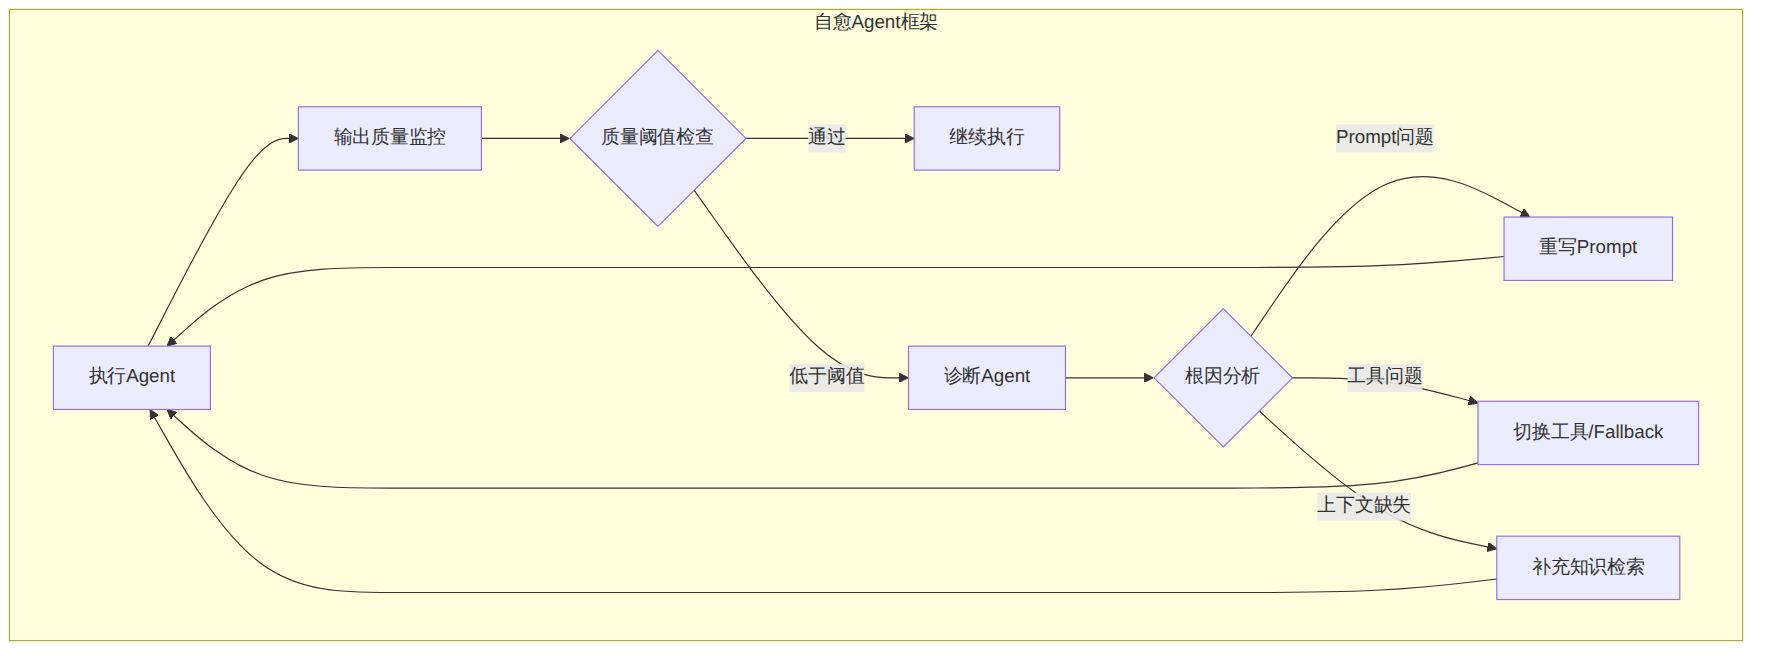
2026年前沿方向是"自愈Agent"——不只是被动地处理错误,而是主动检测潜在问题并预防性修复。arXiv论文2605.06737提出了一个自愈框架,包含三层:
图表 3
自愈模式的关键挑战是修复循环的终止条件。如果诊断Agent本身也出错怎么办?实践中需要设置最大自愈轮次(建议3轮),超过后直接进入死信队列。
单一模式不足以覆盖所有故障场景。生产级Agent需要组合使用多种模式:
| 故障场景 | 推荐模式组合 | 示例 |
|---|---|---|
| LLM API限流 | 重试(3次) → 熔断 → 降级到备用模型 | OpenAI 429 → 切换到Claude |
| 工具返回无效JSON | 重试(2次) → 反思重生成 → 降级到简化参数 | 搜索API返回畸形数据 |
| Agent陷入循环 | 最大步数限制 → 检查点回滚 → 人机审批 | ReAct循环重复3次相同动作 |
| 长时任务中断崩溃 | 状态检查点 → 从断点恢复 → 死信队列兜底 | 数据分析Agent运行2小时后OOM |
| 幻觉导致错误操作 | 输出校验 → 反思修正 → 人工审批门控 | Agent试图删除生产数据库 |
| 所有自动恢复失败 | 死信队列 → 优先级排序 → 人工介入 | 灾难性故障场景 |
# 组合式容错Agent示例
class ResilientAgent:
    def __init__(self):
        self.llm_fallback = FallbackLLM()           # 模式三:降级链
        self.circuit_breaker = CircuitBreaker()      # 模式二:熔断器
        self.dlq = AgentDeadLetterQueue(redis)       # 模式四:死信队列
        self.checkpointer = PostgresSaver(...)       # 模式五:检查点
        self.max_retries = 3
        self.max_self_heal_rounds = 3

    async def run(self, task: str, thread_id: str):
        for attempt in range(self.max_retries):
            try:
                # 从检查点恢复
                state = await self.checkpointer.load(thread_id)

                # 执行Agent循环
                result = await self._execute_with_circuit_breaker(
                    task, state
                )

                # 输出校验
                if self._validate_output(result):
                    return result
                else:
                    # 触发自愈
                    result = await self._self_heal(result, task)
                    if result:
                        return result

            except CircuitBreakerError:
                result = await self.llm_fallback.invoke(task)
                if result:
                    return result
            except MaxRetriesExceeded:
                await self.dlq.enqueue(thread_id, {
                    "task": task, "agent_state": state,
                    "error": "max_retries_exceeded"
                })
                raise

        await self.dlq.enqueue(thread_id, {"task": task, "error": "all_recovery_failed"})
容错不是免费的。每种模式都有其成本:
实用建议:根据任务的SLA要求分级配置容错策略。P0级任务(支付、交易)全副武装——6种模式全覆盖;P1级任务(搜索、推荐)配置重试+降级+死信队列;P2级任务(日志分析、报告生成)只需重试+检查点即可。
Agent容错不是"锦上添花"的功能,而是生产部署的前提条件。从工程实践角度,推荐按以下优先级逐步引入:
框架选择上,中小团队首选LangGraph(内置检查点+中断点+重试),大型企业或分布式场景考虑Temporal+LangGraph混合方案。行为树作为新兴的决策架构值得密切关注,其在容错方面的结构性优势可能会改变Agent架构的未来走向。
[!tip] 51学通信知识星球 星主:爱卫生(微信:gprshome201101)——公众号「51学通信」创办者,19 年通信行业运维与讲师经验,著有《GPRS网络信令实例详解》《EPC原理与实践》《5G核心网原理与实践》三本纸质书(各大电商平台有售)。 星球定位:深耕 5G 核心网、IMS、NFV/AI、云原生等 ICT 领域,主打运维岗位与信令分析。 当前规模:5200 篇主题 / 990 个回答,198 元/年。 加入福利:加入星球后请加爱卫生微信,拉您进知识星球年度陪伴与答疑群——不限量回复您的各种问题,另有群内分享。 AI 加持:51学通信知识星球已作为 skill 接入 WorkBuddy,使用 deepseek-4-flash 在海量星球帖子中精准找贴、找视频、找 FAQ 和案例,做总结、找文档和 PPT 等场景全覆盖。
