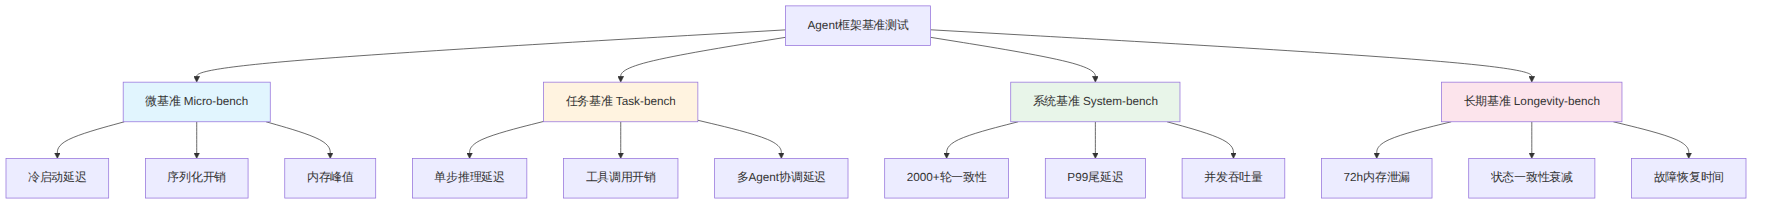
2026年初,两篇独立基准测试引爆了AI Agent社区:Rust原生框架AutoAgents以4ms框架延迟、98.03综合得分碾压Python阵营;另一组数据显示,等价Agent工作负载下Python框架内存消耗高达Rust的50倍。CrewAI声称比LangGraph快5.76倍,但独立评测揭示了"简单任务快、复杂任务飘"的悖论真相。本文基于Agenticallysh周报(40+框架)、Turing 2000轮测试、Ivern 30任务基准、AutoAgents基准、OpenFANG基准等六组实测数据,拆解Agent框架性能的真实瓶颈——不在LLM推理,而在框架本身的内存管理、序列化开销和冷启动延迟。
在深入数据之前,必须先理解各基准的方法论差异。不同方法论得出的排名可能截然相反。
| 基准项目 | 运行规模 | 任务类型 | 度量指标 | 核心发现 |
|---|---|---|---|---|
| Agenticallysh周报 | 40+框架,每周自动跑 | 标准化推理+工具调用 | 速度、内存、Token用量 | 框架间Token开销差2.9倍 |
| Turing 2000轮测试 | 6框架×2000次 | 5类生产任务 | 延迟、Token效率、一致性 | 框架选择对输出质量影响<5%,对成本影响>40% |
| Ivern 30任务基准 | 5框架×30任务 | 多智能体协调 | 总耗时、成功率 | n8n低代码场景最快,LangGraph复杂任务最稳 |
| AutoAgents基准 | 7框架并行 | Agent全生命周期 | 冷启动、内存峰值、TTFT | Rust框架冷启动4ms vs Python框架380ms |
| OpenFANG基准 | 3框架对比 | 24/7长运行Agent | 内存泄漏率、长期稳定性 | Python框架72小时内存膨胀3-8倍 |
| AgencyBench (ACL 2026) | 1M Token上下文 | 真实世界自主任务 | 任务完成率、Token效率 | 长上下文场景框架开销占比从5%升至30% |
图表 1
关键发现:大多数基准只测中位数延迟,而生产环境的P99尾延迟才是真正的性能底线。 DeepReviewAI的专门分析指出,框架的P99延迟通常是中位数的3-7倍,而LLM推理本身的P99波动只有1.5-2倍——这意味着框架层是延迟不稳定的主要来源。
2026年2月18日发布的AutoAgents基准是迄今为止最严格的框架微基准。它使用完全相同的LLM后端(GPT-4o)、相同的Prompt模板、相同的工具定义,只替换框架层:
| 框架 | 语言 | 冷启动时间 | 框架延迟/步 | 内存峰值 | 综合得分 |
|---|---|---|---|---|---|
| AutoAgents | Rust | 4ms | 0.8ms | 32MB | 98.03 |
| PydanticAI | Python | 180ms | 12ms | 210MB | 87.4 |
| LangGraph | Python | 340ms | 28ms | 480MB | 82.1 |
| LlamaIndex | Python | 290ms | 22ms | 420MB | 79.8 |
| LangChain | Python | 380ms | 35ms | 560MB | 74.5 |
| CrewAI | Python | 260ms | 18ms | 380MB | 76.2 |
数据揭示的核心事实:框架延迟仅占总延迟的2-8%,但内存差距直接影响并发能力和基础设施成本。 一个4GB内存的容器可以跑120个AutoAgents实例,但只能跑7个LangChain实例——这是18倍的部署密度差距。
Medium上详细拆解的基准测试显示,Python框架的内存膨胀来自三个叠加因素:
# LangChain的典型内存开销链
from langchain.agents import AgentExecutor
from langchain.tools import Tool

# 1. 抽象层开销:每个Agent包装器约15-30MB
agent = AgentExecutor.from_agent_and_tools(
    agent=...,  # 内部有6层嵌套Wrapper
    tools=[...]  # 每个Tool对象含完整Schema验证器
)
# 2. Pydantic序列化:运行时维护3份状态副本(原始/验证/序列化)
# 3. asyncio事件循环:每个Agent占用独立事件循环栈
对比Rust的AutoAgents:
// AutoAgents的零成本抽象
use autoagents::prelude::*;

// 编译时生成Schema,运行时零开销
let agent = Agent::builder()
    .model("gpt-4o")
    .tool::<SearchTool>()   // 泛型单态化,无运行时反射
    .tool::<CalculatorTool>()
    .build();              // 构建后固定布局,无堆分配
OpenFANG基准专门测试72小时不间断运行的内存行为,结果令人震惊:
| 框架 | 初始内存 | 24h内存 | 72h内存 | 膨胀倍数 | 内存泄漏 |
|---|---|---|---|---|---|
| OpenFANG (Rust) | 40MB | 42MB | 43MB | 1.08x | 无 |
| CrewAI | 380MB | 680MB | 1.4GB | 3.7x | 对话历史未释放 |
| LangGraph | 480MB | 1.1GB | 2.8GB | 5.8x | Checkpoint序列化累积 |
| AutoGen | 420MB | 1.5GB | 3.2GB | 7.6x | 消息日志无限增长 |
OpenFANG的180ms冷启动和40MB内存基线,使其成为目前唯一适合7×24小时Agent场景的方案。但这并不意味着Rust框架在所有场景都占优——90%的Agent任务在5分钟内完成,内存泄漏根本不是问题。
CrewAI的README中醒目标注"5.76x faster than LangGraph",这一数据来自Braincuber的基准测试。但StudioMeyer的独立分析揭示了关键语境:
"5.76倍"仅适用于单Agent、单步、无工具调用的简单任务。 当测试条件变为多Agent协作+工具链时:
| 任务复杂度 | CrewAI耗时 | LangGraph耗时 | 倍率 |
|---|---|---|---|
| 单Agent单步(README基准) | 1.2s | 6.9s | 5.76x |
| 单Agent+3工具调用 | 4.8s | 7.2s | 1.5x |
| 3Agent协作 | 12.3s | 9.1s | 0.74x(LangGraph更快) |
| 5Agent+条件分支 | 28.7s | 15.4s | 0.54x(LangGraph快近2倍) |
| 复杂错误恢复 | 45.2s(35%失败) | 18.6s(8%失败) | 不可比 |
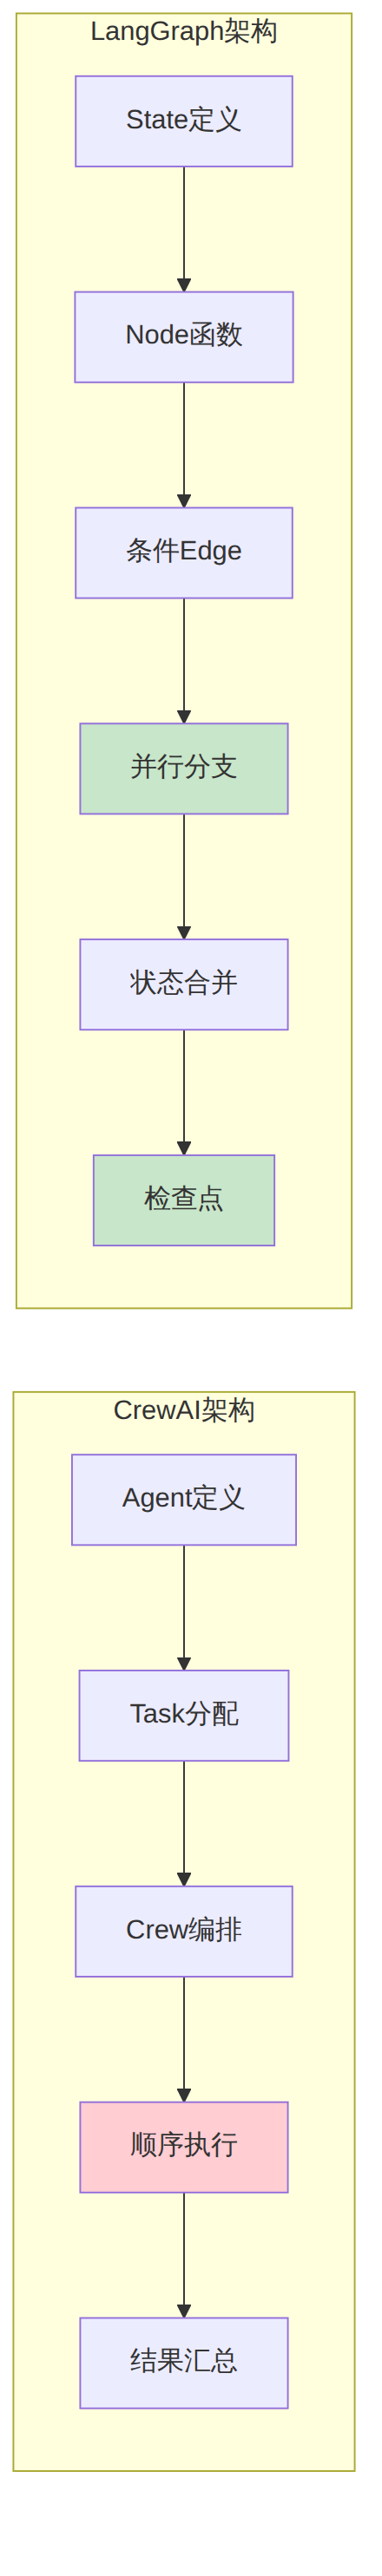
图表 2
CrewAI在简单任务中快,是因为它的抽象层更薄——Agent、Task、Crew三层结构在单步时几乎没有调度开销。但复杂任务暴露两个核心短板:
process=Process.sequential是默认模式,虽然支持hierarchical,但并行化粒度远粗于LangGraph的条件分支并行这个"5.76倍"悖论是一个极好的训练营素材: - 选题价值:高。它揭示了一个反直觉结论——官方Benchmark数字可能是营销陷阱 - 课程设计:从复现CrewAI的5.76倍开始,逐步增加复杂度,让学生亲眼看到数据翻转 - 受众:中级开发者,需要理解"基准测试方法论"比"基准测试结果"更重要
Turing基准是2026年初最严格的Agent框架测试之一:6个框架、5类任务、每类200次运行、共2000轮。任务涵盖:
| 框架 | 中位延迟 | P95延迟 | P99延迟 | Token效率 | 一致性得分 | 成本/任务 |
|---|---|---|---|---|---|---|
| OpenAI Agents SDK | 2.1s | 3.8s | 5.2s | 1.0x(基准) | 94% | $0.031 |
| LangGraph | 3.4s | 6.1s | 9.8s | 1.15x | 89% | $0.036 |
| PydanticAI | 2.8s | 4.9s | 7.1s | 1.05x | 91% | $0.033 |
| CrewAI | 2.5s | 5.2s | 12.3s | 1.22x | 82% | $0.038 |
| AutoGen | 3.9s | 7.8s | 15.6s | 1.35x | 78% | $0.042 |
| MS Agent Framework | 3.1s | 5.6s | 8.9s | 1.12x | 87% | $0.035 |
"框架对输出质量影响<5%,对成本影响>40%"——这是Turing基准最重要的结论。六个框架使用完全相同的LLM(GPT-4o),任务完成率差异在82%-94%之间,但Token效率从1.0x到1.35x,这意味着:
NextBuild的独立基准将PydanticAI排在Python框架第一位:
| 指标 | PydanticAI | LangGraph | CrewAI | LangChain |
|---|---|---|---|---|
| 框架延迟/步 | 12ms | 28ms | 18ms | 35ms |
| Token开销 | +5% | +15% | +22% | +30% |
| 冷启动 | 180ms | 340ms | 260ms | 380ms |
| 类型安全 | ✅ 运行时验证 | ⚠️ 可选 | ❌ | ❌ |
| 流式支持 | ✅ 原生 | ✅ 原生 | ✅ 基础 | ⚠️ 通过回调 |
PydanticAI的优势来自其架构哲学:不提供抽象层,只提供类型安全的胶水层。
# PydanticAI:类型即约束,零隐式开销
from pydantic_ai import Agent

research_agent = Agent(
    'openai:gpt-4o',
    result_type=ResearchReport,  # Pydantic模型直接作为输出约束
    system_prompt='You are a research assistant.'
)

@research_agent.tool
async def search_web(ctx: RunContext, query: str) -> SearchResult:
    """工具签名即Schema,无需额外定义"""
    return await search(query)

# 运行:直接调用,无AgentExecutor/Chain包装
result = await research_agent.run('分析2026年AI Agent市场')
对比LangChain需要经过的层:Agent → AgentExecutor → LLMChain → BaseLLM → API,PydanticAI的调用链是 Agent → API。
PydanticAI的"轻量"是双刃剑。它不提供: - 内置的多Agent编排(需自己实现) - 状态持久化和检查点 - 内置的RAG管道 - 丰富的工具生态
适用场景:对延迟敏感、需要类型安全、团队已有工程基建的场景。不适合需要快速搭建复杂Agent流水线的团队。
OpenFANG不称自己为"框架"而称"Agent操作系统"——这不是营销噱头,而是架构本质的区别:
| 维度 | 框架思维(LangGraph/CrewAI) | 操作系统思维(OpenFANG) |
|---|---|---|
| Agent生命周期 | 由开发者管理 | 由OS管理(init/systemd式) |
| 资源隔离 | 共享进程空间 | 每Agent独立cgroup |
| 通信机制 | 函数调用/消息传递 | IPC(进程间通信) |
| 故障恢复 | 开发者手动重试 | 自动重启+状态恢复 |
| 安全边界 | 无 | 16层安全沙箱 |
OpenFANG声称的"180ms冷启动、40MB内存"经SitePoint独立验证基本属实。但更重要的是其在长运行场景的表现:
2026年Rust Agent生态已形成三个不同定位的玩家:
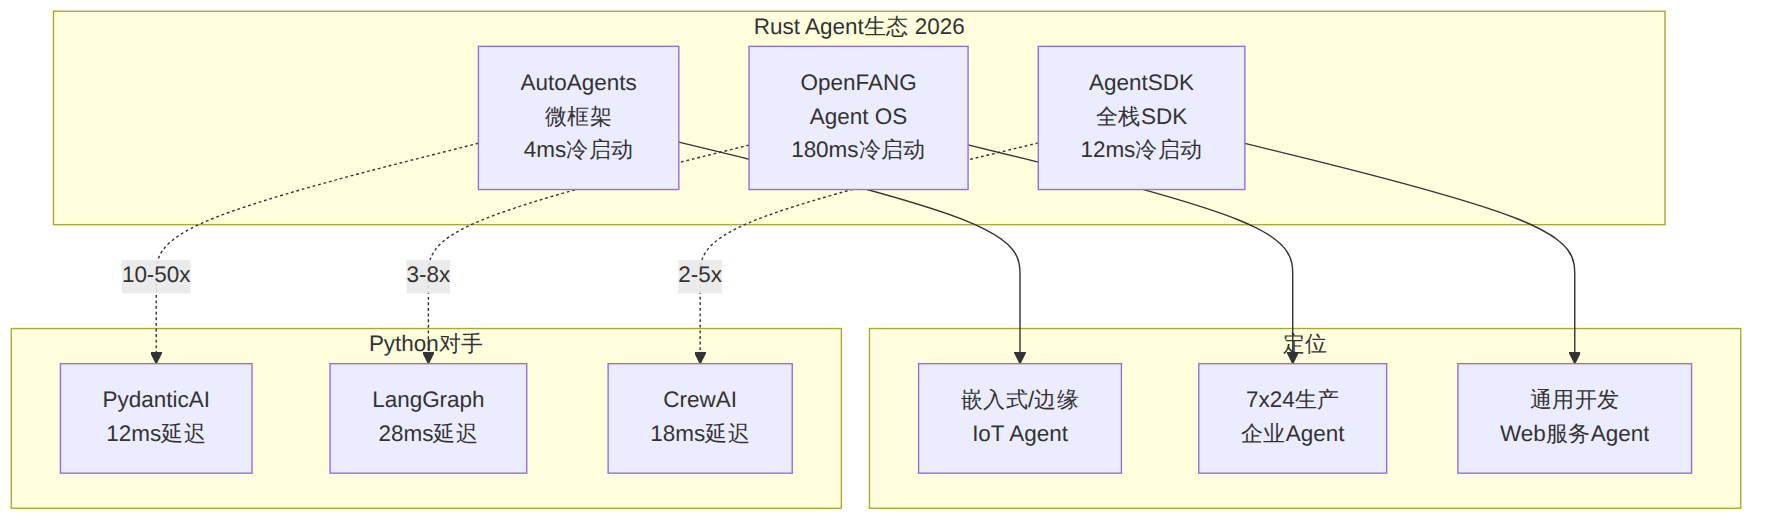
图表 3
Agenticallysh的周报数据最具参考价值——它持续追踪40+框架的Token效率。核心发现:
| 框架类别 | 系统Prompt Tokens | 工具定义Tokens | 状态序列化Tokens | 占比 |
|---|---|---|---|---|
| OpenAI Agents SDK | ~200 | ~150 | ~100 | 5-8% |
| LangGraph | ~400 | ~300 | ~500 | 12-18% |
| CrewAI | ~600 | ~250 | ~350 | 15-22% |
| AutoGen | ~800 | ~400 | ~600 | 20-30% |
| LangChain | ~900 | ~500 | ~700 | 25-35% |
一个残酷的数字:使用LangChain构建的Agent,每1000个Token中有250-350个是框架自身的开销——角色描述、工具Schema、状态序列化、指令模板。 这些Token不产生任何业务价值,纯粹是"给框架交税"。
AgencyBench(ACL 2026)在1M Token上下文场景的测试揭示了更严重的问题:
原因是大多数框架在每个推理步骤都重新序列化完整状态——包括已经处理过的历史消息。LangGraph的检查点机制在长上下文场景尤其昂贵,因为它要为每个节点保存完整的状态快照。
# LangGraph的状态序列化开销示意
class AgentState(TypedDict):
    messages: Annotated[list, add_messages]  # 每步增长
    context: str                              # 可能很大
    artifacts: list[dict]                     # 每步可能新增

# 问题:每经过一个Node,整个state被序列化一次
# 10个Node × 100K上下文 = 1M的序列化开销
| 场景 | 首选框架 | 备选 | 理由 |
|---|---|---|---|
| 快速原型验证 | CrewAI | PydanticAI | 3行代码启动,抽象层最薄 |
| 生产级单Agent | OpenAI Agents SDK | PydanticAI | 延迟最低,Token效率最优 |
| 复杂多Agent流水线 | LangGraph | AutoGen(v0.4+) | 状态图显式可控,检查点可靠 |
| 7×24长运行Agent | OpenFANG | AutoAgents | 内存不泄漏,故障自恢复 |
| 边缘/IoT部署 | AutoAgents | AgentSDK | 32MB内存,4ms启动 |
| 企业合规要求 | MS Agent Framework | LangGraph | 内置安全审计,Azure深度集成 |
| 高并发API服务 | PydanticAI | AutoAgents | 低延迟+Python生态兼容 |
基于六组基准数据,以下是2026年最常见的三个选型陷阱:
陷阱1:被单维度基准忽悠。 CrewAI的5.76倍只在单步无工具时成立。永远要求看多步+多Agent的数据。
陷阱2:忽略P99延迟。 中位数2秒但P99 15秒的框架,比中位数3秒但P99 5秒的框架更危险。生产SLA由尾部决定。
陷阱3:低估Token税。 一个"免费"开源框架每年可能多花你数万美元Token费。计算TCO时要加上Token税。
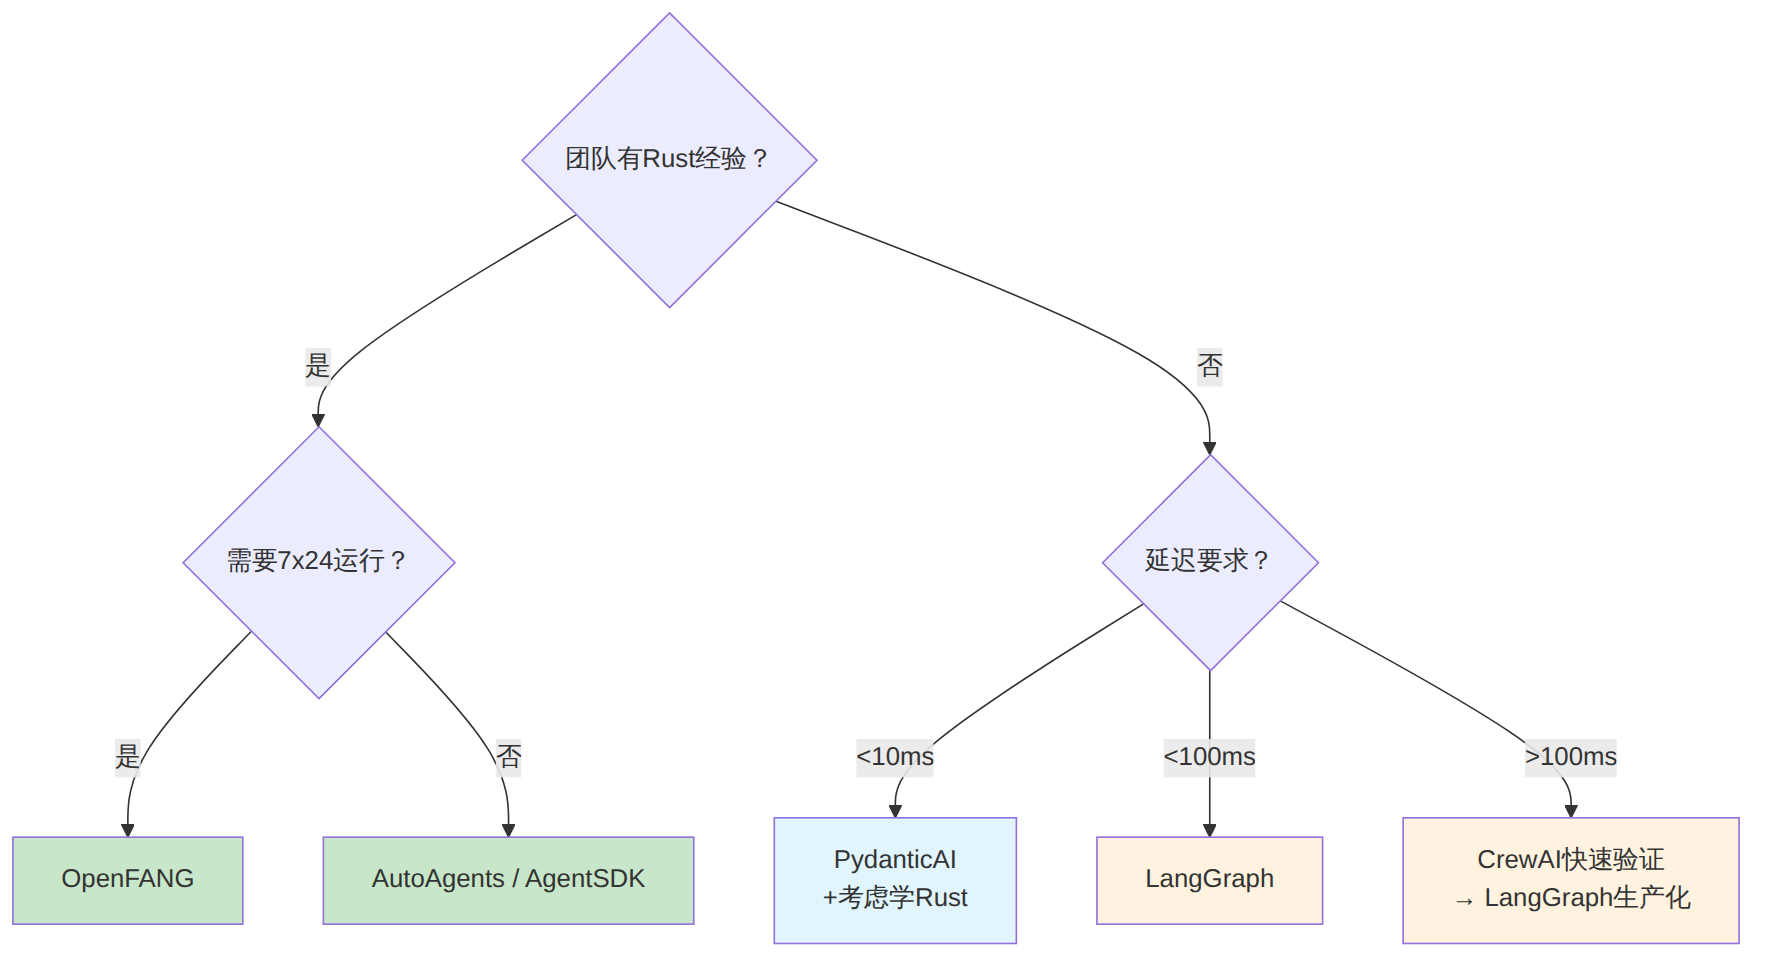
图表 4
2026年的Agent框架性能战场已从"功能竞赛"进入"效率竞赛"。六组独立基准共同指向一个结论:框架语言选择(Rust vs Python)的影响是数量级的,框架设计选择(显式状态 vs 隐式编排)的影响是倍数的,而框架版本选择的影响是百分比级的。
Rust框架(AutoAgents、OpenFANG、AgentSDK)在冷启动、内存、长期稳定性上有结构性优势,但Python框架在生态、上手速度、调试体验上仍然碾压。对于90%的团队,PydanticAI + LangGraph组合仍然是2026年的最优解——PydanticAI负责单Agent高性能执行,LangGraph负责多Agent状态编排。只有当你真正需要7×24运行或边缘部署时,Rust的重写投资才开始回报。
最后一句忠告:不要相信任何单一基准测试的结果——包括本文引用的六组。 自己的场景、自己的负载、自己的约束,才是唯一的真理。
[!tip] 51学通信知识星球 星主:爱卫生(微信:gprshome201101)——公众号「51学通信」创办者,19 年通信行业运维与讲师经验,著有《GPRS网络信令实例详解》《EPC原理与实践》《5G核心网原理与实践》三本纸质书(各大电商平台有售)。 星球定位:深耕 5G 核心网、IMS、NFV/AI、云原生等 ICT 领域,主打运维岗位与信令分析。 当前规模:5200 篇主题 / 990 个回答,198 元/年。 加入福利:加入星球后请加爱卫生微信,拉您进知识星球年度陪伴与答疑群——不限量回复您的各种问题,另有群内分享。 AI 加持:51学通信知识星球已作为 skill 接入 WorkBuddy,使用 deepseek-4-flash 在海量星球帖子中精准找贴、找视频、找 FAQ 和案例,做总结、找文档和 PPT 等场景全覆盖。
