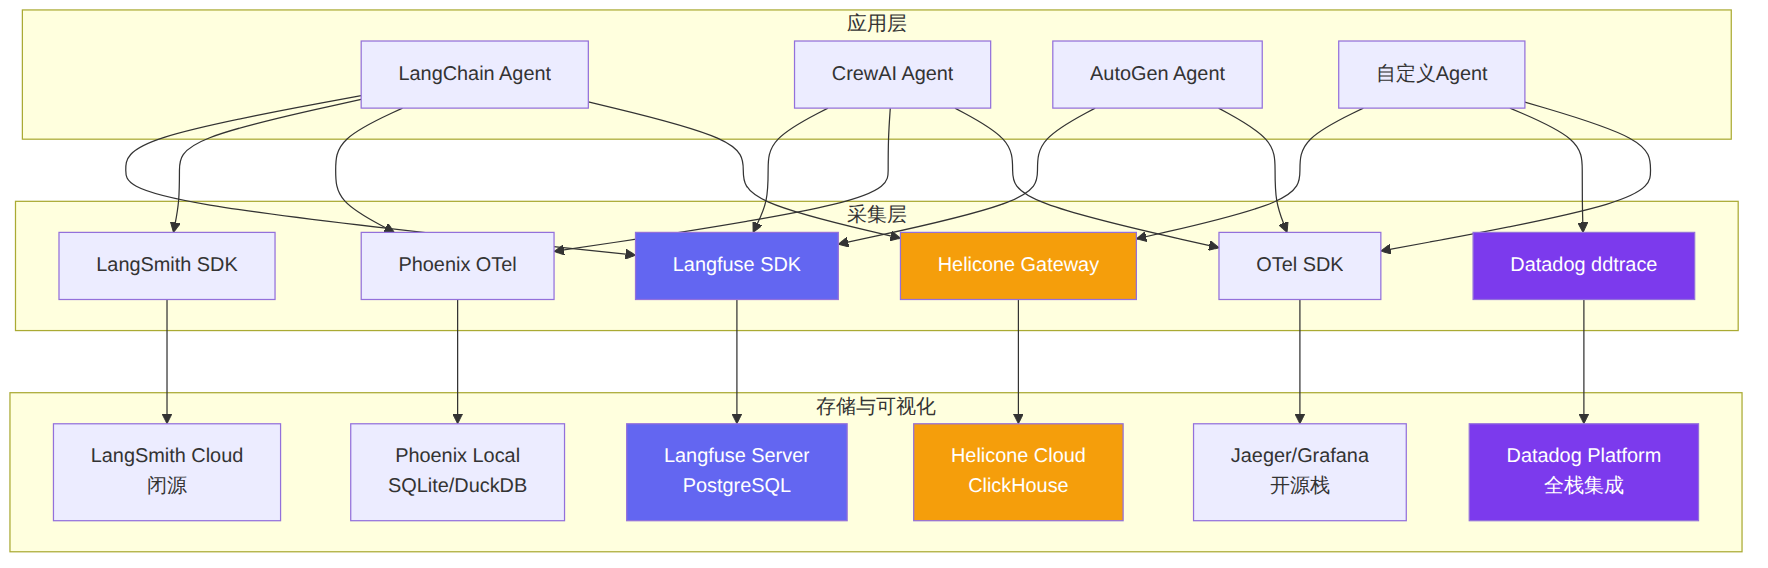
2026年,AI智能体从原型走向生产的过程中,可观测性(Observability)已成为决定成败的关键基础设施。一个生产级Agent单次任务可能涉及多轮推理、5-10次工具调用、向量检索与记忆回溯,任何环节的失败都可能导致级联错误。本文横评Langfuse、LangSmith、Arize Phoenix、Helicone、Datadog LLM Observability、OpenTelemetry GenAI六大平台,从链路追踪精度、评估能力、成本监控、部署灵活性、企业合规五个维度进行深度实测对比,并给出不同场景下的选型推荐。
传统软件的可观测性以"日志+指标+追踪"三大支柱为核心,但AI智能体引入了全新的挑战:
非确定性输出:同一个输入,Agent可能走完全不同的推理路径。你不能只看结果,必须追踪整个决策链。
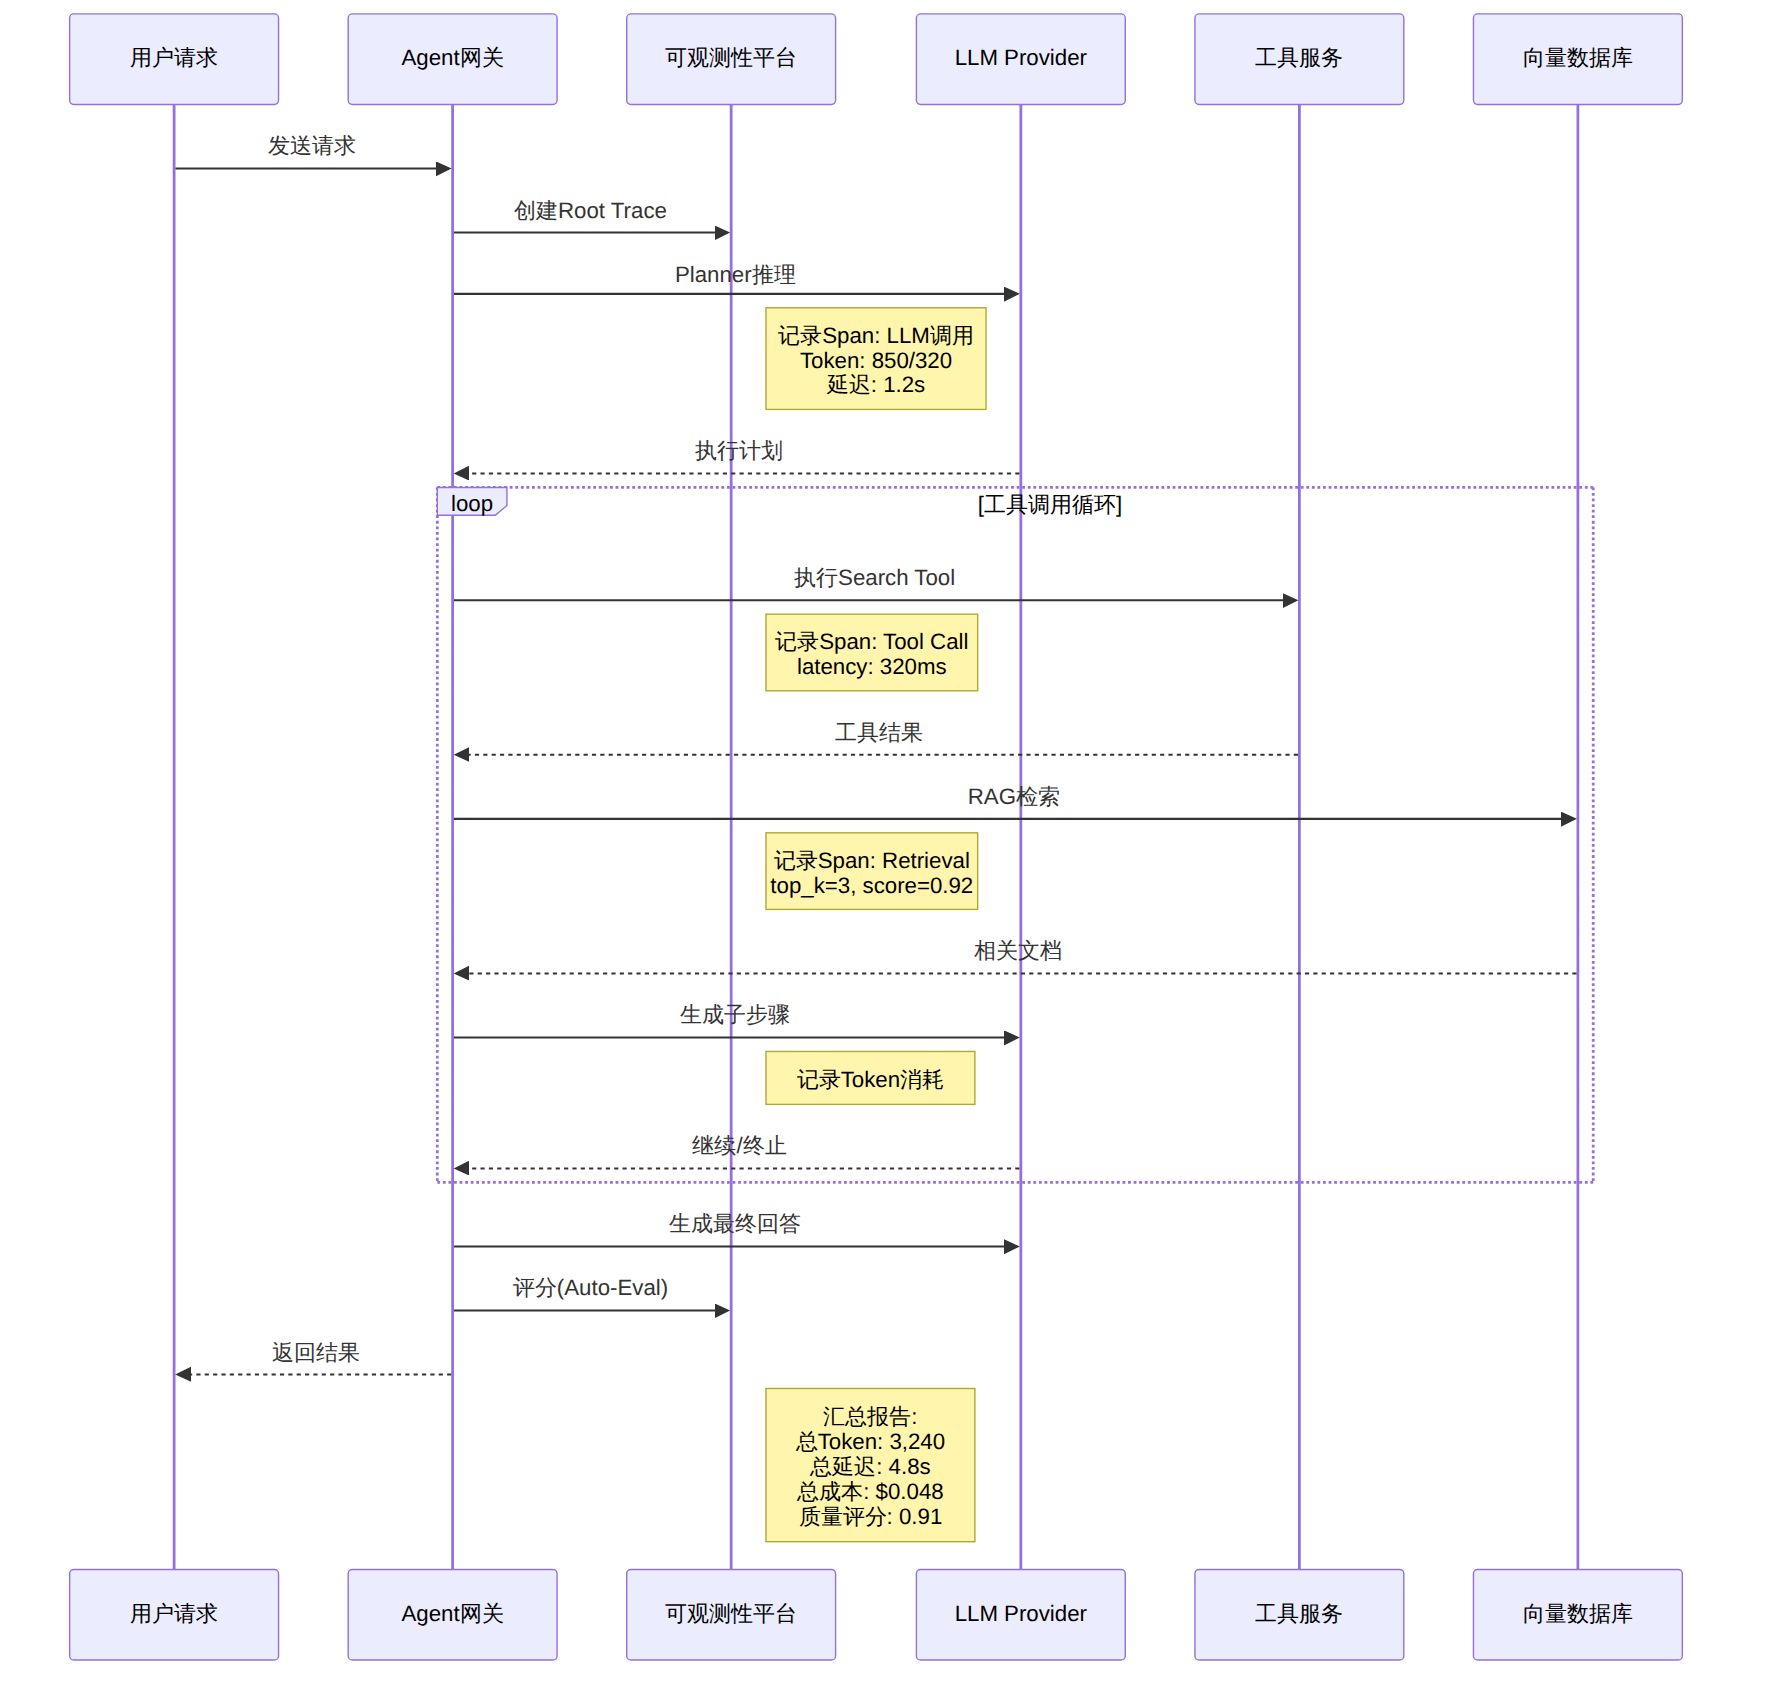
长链路嵌套:一个Agent任务可能包含Planner→Tool Call→RAG检索→子Agent调用→结果聚合,单次请求产生数十个Span。
Token成本黑洞:多Agent系统中,Token消耗呈指数增长。没有精确的per-agent、per-task成本归因,企业AI预算会失控。
合规审计压力:欧盟AI Act、中国《生成式人工智能服务管理暂行办法》等法规要求AI系统具备可追溯性。金融、医疗行业的Agent必须记录完整决策链路。
2026年第一季度,据Multiple企业调研数据,78%的AI工程团队将可观测性工具列为Agent上生产的前三大优先事项,仅次于安全和评估。
| 维度 | Langfuse | LangSmith | Arize Phoenix | Helicone | Datadog LLM Obs | OpenTelemetry GenAI |
|---|---|---|---|---|---|---|
| 开源协议 | MIT(核心) | 部分开源 | Apache 2.0 | Apache 2.0 | 闭源 | Apache 2.0(标准) |
| GitHub Stars | 21,000+ | N/A | 5,000+ | 4,500+ | N/A | 200+(spec仓库) |
| 最新版本 | v3.174(2026.05) | 持续更新 | v8.x | v1.x | 持续更新 | SemConv v1.36 |
| 链路追踪 | ★★★★★ | ★★★★★ | ★★★★☆ | ★★★☆☆ | ★★★★★ | ★★★★★(标准化) |
| 评估框架 | 内置+自定义 | 内置 | 内置 | 基础 | 基础 | 无(需集成) |
| 成本追踪 | ★★★★★ | ★★★☆☆ | ★★★★☆ | ★★★★★ | ★★★★☆ | 需自行实现 |
| 框架兼容 | 框架无关 | LangChain绑定 | 框架无关 | 框架无关 | 框架无关 | 标准化协议 |
| 自部署 | Docker/K8s | 可自部署 | pip安装本地运行 | Docker | SaaS | 完全自控 |
| 上手时间 | 15分钟 | 10分钟 | 5分钟 | 10分钟 | 30分钟+ | 60分钟+ |
| 企业定价 | 开源/云$99起 | 免费/企业定制 | 开源/云$99起 | 开源/云$49起 | 按量计费 | 免费(自建成本) |
| 变现训练营 | ★★★★★ | ★★★★☆ | ★★★★☆ | ★★★☆☆ | ★★★★☆ | ★★★☆☆ |
架构原理
Langfuse采用Trace→Span→Event三层模型。每个Agent请求创建一个Trace,内部的LLM调用、工具执行、检索操作分别生成Span,每个Span记录输入、输出、Token消耗、延迟和元数据。核心创新点是评分系统(Scores)——支持人工标注和LLM-as-Judge自动评分,将可观测性从"看到"升级为"量化评估"。
Trace (用户请求)
├── Span: Planner (LLM调用)
│   ├── Event: prompt_token=850, completion_token=120
│   └── Score: plan_quality=0.87 (LLM-Judge)
├── Span: Tool Call (Search API)
│   └── Event: latency=320ms, result_count=5
├── Span: RAG Retrieval (Vector DB)
│   └── Event: top_k=3, similarity=0.92
└── Span: Response Generation (LLM调用)
    └── Event: total_tokens=1240
关键代码片段
from langfuse.decorators import observe

@observe()
def run_agent(query: str):
    # Langfuse自动追踪整个函数调用链
    plan = planner(query)        # 自动生成子Span
    tool_results = [execute_tool(t) for t in plan.tools]
    response = generator(query, tool_results)
    return response

# 成本追踪自动关联到每个Span
# langfuse.score(trace_id, name="accuracy", value=0.9)
优缺点分析
优点方面,MIT协议、框架无关性、完善的成本归因使其成为开源阵营首选。21,000+的GitHub Star数和活跃的社区贡献保证了迭代速度。评分系统是其差异化亮点。
缺点在于大规模部署时PostgreSQL数据库性能瓶颈明显,单节点处理百万级Trace时查询延迟上升。高级功能(如Session Analytics)需要付费云版本。
变现评估
极高。Langfuse是2026年AI训练营的必备教学工具。可包装为"AI Agent生产化运维实战营",涵盖从零搭建可观测性体系、成本优化、评估自动化等课程模块。预计单期训练营定价2980-4980元。
架构原理
LangSmith是LangChain公司推出的商业化平台,深度绑定LangChain/LangGraph生态。其架构基于Run Tree模型——每个LangChain组件(Chain、Agent、Tool、Retriever)的执行自动生成Run节点,形成完整的调用树。与Langfuse的Span模型不同,LangSmith的Run模型天然适配LangChain的DAG执行拓扑。
LangSmith最独特的能力是Prompt Playground——可以在追踪界面上直接修改Prompt并重新运行,实现"看到问题→调试→验证"的闭环。2026年新增的自动评估管道(Auto-Eval Pipeline)支持在CI/CD中嵌入质量门禁。
关键代码片段
import os
os.environ["LANGCHAIN_TRACING_V2"] = "true"
os.environ["LANGCHAIN_API_KEY"] = "ls__..."

# 无需修改任何业务代码,LangSmith自动追踪
from langchain.agents import create_openai_tools_agent
agent = create_openai_tools_agent(llm, tools, prompt)
# 所有执行自动出现在LangSmith Dashboard
优缺点分析
最大优势是零配置集成——只要用LangChain框架,设置两个环境变量即可获得完整的追踪能力。Prompt版本管理和Playground交互式调试在开发阶段效率极高。
致命短板是生态锁定。如果团队使用CrewAI、AutoGen或其他框架,LangSmith的集成体验大幅下降。此外,核心平台不开源,数据主权问题让部分企业望而却步。
变现评估
中等偏上。适合作为"LangChain/LangGraph全栈开发训练营"的组件之一,但难以独立撑起一个训练营。
架构原理
Phoenix是Arize AI推出的开源LLM可观测性工具,定位为"开发者本地的AI可观测性"。核心设计理念是零基础设施依赖——pip install arize-phoenix后直接启动本地服务器,无需Docker、无需PostgreSQL。
Phoenix的技术架构基于OpenTelemetry(OTel)标准,通过opentelemetry-sdk采集Trace数据,本地内置一个轻量级存储引擎(基于SQLite/DuckDB)和可视化界面。这意味着Phoenix天然兼容OTel生态,也使得它与任何框架的集成都很自然。
2026年Phoenix v8引入了Embedding Drift Detection——监控RAG系统中向量嵌入的分布漂移,提前发现检索质量退化。
关键代码片段
import phoenix as px
from phoenix.trace.langchain import LangChainInstrumentor

# 启动本地Phoenix服务器
px.launch_app()

# 自动仪表化LangChain应用
LangChainInstrumentor().instrument()

# 也可手动通过OTel标准接入
from phoenix.trace import using_attribute
with using_attribute("session_id", "user_123"):
    agent.run("分析这份财报")
优缺点分析
优点:部署极简(pip install即用),OTel标准化架构有利于长期维护,Embedding漂移检测是RAG场景的杀手锏。Apache 2.0协议对企业友好。
缺点:协作功能弱——本地单机模式不支持团队共享。缺少内置的成本追踪,需要手动配置Token单价。生产级部署仍需配合Arize Cloud使用。
变现评估
中高。适合作为"RAG系统开发与优化实战营"的调试工具模块。其Embedding漂移检测可作为差异化卖点。
架构原理
Helicone的定位不是纯可观测性平台,而是LLM代理网关(Gateway)与可观测性的一体化方案。所有LLM请求通过Helicone的代理服务器转发,在代理层完成日志记录、缓存、速率限制和成本追踪。
这种架构的最大优势是应用层零侵入——不需要修改任何业务代码,只需将API Base URL从api.openai.com改为oai.helicone.ai。
应用代码 → Helicone Gateway → OpenAI/Anthropic/...
                ↓
         日志存储 + 缓存 + 限流
                ↓
         Helicone Dashboard
2026年Helicone v1引入了Custom Cache功能——对于重复或相似的请求,缓存LLM响应,据官方数据可降低30-50%的Token消耗。
关键代码片段
import openai

# 仅需修改base_url,零代码改动
client = openai.OpenAI(
    api_key="sk-...",
    base_url="https://oai.helicone.ai/v1",
    default_headers={
        "Helicone-Auth": "sk-helicone-...",
        "Helicone-Cache-Enabled": "true",
        "Helicone-Property-Session": "user_456"
    }
)

# 后续所有调用自动被追踪和缓存
response = client.chat.completions.create(
    model="gpt-4o",
    messages=[{"role": "user", "content": "分析这个代码"}]
)
优缺点分析
优点:零侵入部署,对于已有项目改造成本最低。缓存功能直接节省真金白银。成本分析面板直观,支持按模型、按用户、按Team的细粒度成本归因。
缺点:本质是代理层方案,无法深入Agent内部逻辑——你看到的是"调用了GPT-4o花了500 Token",而不是"Planner决定调用Search工具因为置信度不足"。缺少评估和Prompt管理功能。
变现评估
中等。适合作为"AI成本优化实战"课程的一部分,但作为独立训练营主题略显单薄。
架构原理
Datadog在2025年底正式推出LLM Observability产品,2026年3月进一步扩展了Agentic AI监控能力。其架构基于Datadog成熟的APM平台扩展——在已有的分布式追踪基础设施上,新增了llm、agent、tool、retrieval四类Span类型,并与Datadog的日志、基础设施监控、安全产品深度集成。
对于已经在使用Datadog的企业,LLM Observability是天然的选择——Agent调用链路可以与后端API、数据库查询、消息队列等传统组件的追踪数据无缝关联,实现真正的端到端可观测。
关键代码片段
from ddtrace.llmobs import LLMObs

# Datadog LLM Observability仪表化
LLMObs.enable(ml_app="my-agent-app")

@LLMObs.agent(name="customer_support_agent")
def handle_request(query):
    # Agent内部自动生成Span
    with LLMObs.tool(name="knowledge_search"):
        docs = search_knowledge_base(query)

    with LLMObs.retrieval(name="rag_context"):
        context = retrieve_relevant_docs(docs)

    response = llm.generate(query, context)
    LLMObs.annotate(response.quality_score=0.92)
    return response
优缺点分析
优点:企业级一体化,无需额外搭建可观测性栈。与APM、日志、安全产品的联动是独门优势。Datadog的全球基础设施保证了大规模部署的稳定性。
缺点:按量计费模式下,高吞吐Agent系统的监控成本可能超过Agent本身的推理成本。闭源产品,数据完全托管在Datadog。学习曲线陡峭,配置复杂。
变现评估
高。企业AI运维训练营可以Datadog为核心,覆盖从Agent监控到SRE实践的全链路。适合面向中大型企业的技术培训,定价可到5980-9980元/人。
架构原理
OpenTelemetry的GenAI语义约定(Semantic Conventions)定义了一套标准化的属性体系,用于描述LLM调用、Agent执行、工具调用等AI操作的追踪数据。核心属性包括:
gen_ai.system:标识AI系统(openai、anthropic、langchain等)gen_ai.request.model:使用的模型gen_ai.usage.input_tokens / output_tokens:Token消耗gen_ai.choice:模型输出gen_ai.tool.name / gen_ai.tool.description:工具调用信息这套标准使得不同框架、不同厂商的追踪数据可以在统一的后端(Jaeger、Zipkin、Prometheus等)中进行关联分析。2026年SemConv v1.36版本新增了gen_ai.agent和gen_ai.agent.tool.call等属性,专门针对Agent场景。
关键代码片段
# OpenTelemetry GenAI Span示例
resource:
  attributes:
    service.name: "my-agent-service"

spans:
  - name: "gen_ai.chat.completion"
    attributes:
      gen_ai.system: "openai"
      gen_ai.request.model: "gpt-4o-2025-05"
      gen_ai.usage.input_tokens: 850
      gen_ai.usage.output_tokens: 320
      gen_ai.agent.name: "research_agent"
      gen_ai.agent.tool.call: '{"name": "web_search", "args": {"query": "..."}}'
优缺点分析
优点:标准化、厂商中立、长期投资保护。与现有可观测性栈(Jaeger、Grafana Tempo等)无缝集成。完全开源,无许可证风险。
缺点:标准仍在Development阶段,属性定义频繁变动。纯标准不提供可视化界面和开箱即用的Dashboard——需要自建后端。团队需要具备OTel专业知识,上手门槛最高。
变现评估
中等。适合面向DevOps/SRE团队的"云原生AI可观测性"高级培训,但受众面较窄。
图表 1
图表 2
推荐:Arize Phoenix + Langfuse
推荐:Langfuse自部署 + Helicone网关
推荐:Datadog LLM Observability + OpenTelemetry标准
推荐:LangSmith(开发期) + Langfuse(生产期)
推荐:Langfuse(主讲) + Phoenix(演示) + Helicone(成本案例)
OpenTelemetry标准成熟化:SemConv预计在2026年底进入Stable状态,届时Langfuse、Phoenix等平台将全面采用OTel原生协议,实现真正的数据可移植性。现在投入OTel标准的团队将获得最大的长期回报。
FinOps for AI成为独立岗位:随着Agent部署规模扩大,AI成本优化(Token经济分析、缓存策略、模型路由)将从工程任务升级为独立的FinOps职能。Helicone和Langfuse的成本追踪功能将变得更加关键。
实时干预成为标配:目前的可观测性以事后分析为主。2026下半年,LangSmith、Langfuse等平台预计推出"实时监控+人工干预"功能——当Agent在执行过程中偏离预期路径时,自动触发人工审核流程(Human-in-the-Loop可观测性)。
多Agent系统追踪的标准化:当前的追踪模型主要面向单Agent场景。多Agent系统中的Agent间通信、任务分发、结果聚合需要新的Span模型。Datadog已率先推出agent类型Span,预计Langfuse和Phoenix将快速跟进。
| 坑点 | 说明 | 解决方案 |
|---|---|---|
| 追踪数据量爆炸 | 一个复杂Agent任务产生50+个Span | 设置采样率,仅追踪10%请求或异常请求 |
| 敏感信息泄露 | Prompt和Completion可能包含PII | 启用数据脱敏,或使用Langfuse的mask函数 |
| 可观测性成本超预期 | Datadog按Span计费,高并发下成本翻倍 | 开发期用开源方案,生产期精细控制采样 |
| 追踪ID不关联 | 前端→网关→Agent→LLM链路断裂 | 统一使用OTel Trace Context传播标准 |
| 评估与追踪脱节 | 追踪系统记录了很多但无法量化质量 | 必须部署LLM-as-Judge自动评分管道 |
[!tip] 51学通信知识星球 星主:爱卫生(微信:gprshome201101)——公众号「51学通信」创办者,19 年通信行业运维与讲师经验,著有《GPRS网络信令实例详解》《EPC原理与实践》《5G核心网原理与实践》三本纸质书(各大电商平台有售)。 星球定位:深耕 5G 核心网、IMS、NFV/AI、云原生等 ICT 领域,主打运维岗位与信令分析。 当前规模:5200 篇主题 / 990 个回答,198 元/年。 加入福利:加入星球后请加爱卫生微信,拉您进知识星球年度陪伴与答疑群——不限量回复您的各种问题,另有群内分享。 AI 加持:51学通信知识星球已作为 skill 接入 WorkBuddy,使用 deepseek-4-flash 在海量星球帖子中精准找贴、找视频、找 FAQ 和案例,做总结、找文档和 PPT 等场景全覆盖。
