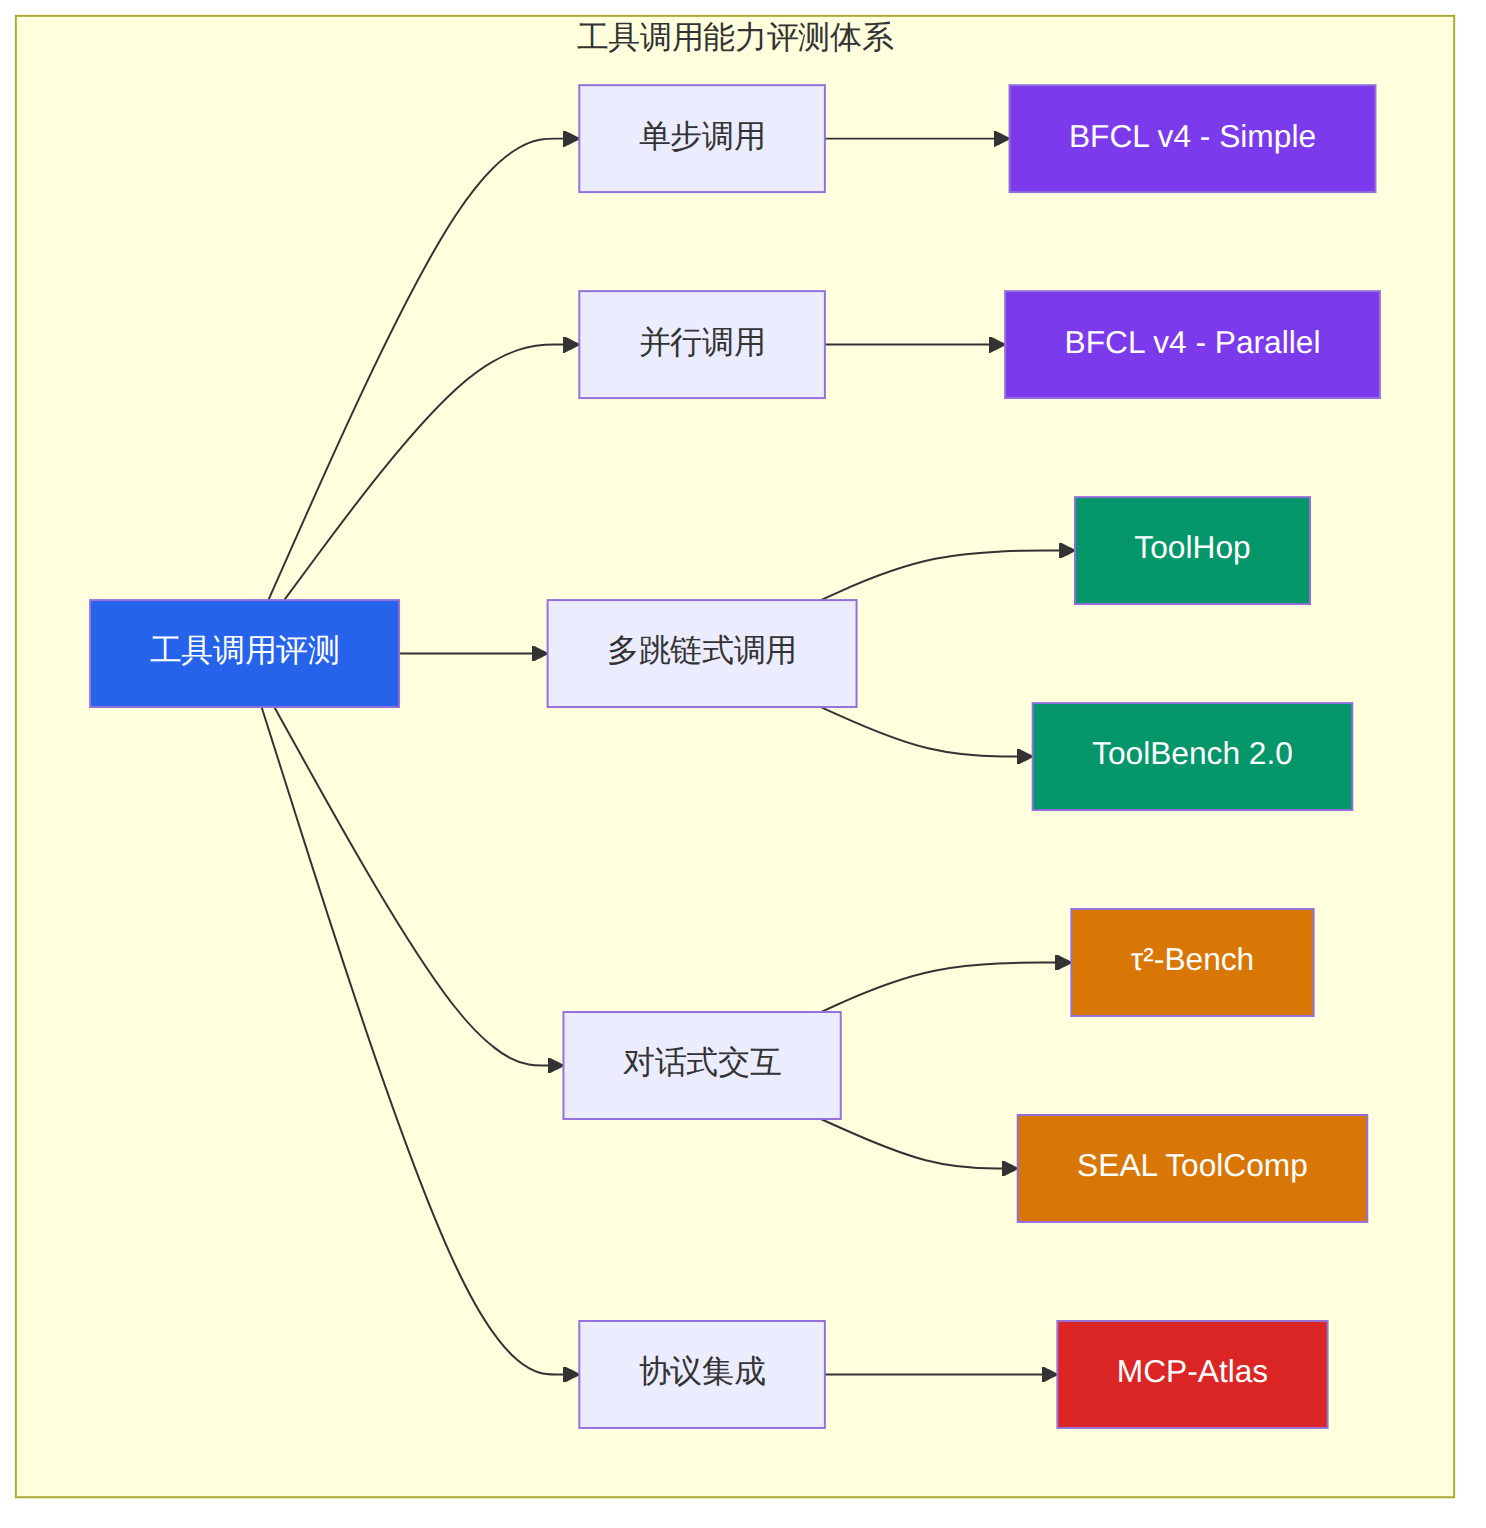
AI Agent的核心能力不在于"能说什么",而在于"能用什么"。Function Calling / Tool Use——即大模型识别用户意图、选择正确的工具、组装合法参数、并在多轮交互中链式调用的能力——已经成为区分"聊天机器人"和"自主智能体"的分水岭。本文基于BFCL v4、τ²-Bench、ToolHop、MCP-Atlas、Scale SEAL ToolComp、ToolBench 2.0六大主流基准的最新实测数据,横向对比GPT-5.2、Claude Opus 4.5/4.6、Gemini 2.5 Pro、DeepSeek-R1等模型在工具调用准确率、并行调用能力、多跳推理、结构化输出、延迟开销五个维度上的表现差异,并给出不同应用场景下的模型选择策略。
目前业界衡量LLM工具调用能力的基准已形成完整矩阵,每个基准侧重不同层面:
| 基准名称 | 发布方 | 核心评测维度 | 测试规模 | 最新版本 |
|---|---|---|---|---|
| BFCL v4 | UC Berkeley Gorilla | 单步/并行函数调用准确率、参数正确性 | 2,000+测试用例 | v4 (2025.07) |
| τ²-Bench | Sierra Research | 双角色对话中的工具-用户交互一致性 | 航空/零售领域策略 | τ² (2025) |
| ToolHop | 字节跳动 (ACL 2025) | 多跳工具链推理(查询驱动) | 995查询+3,912工具 | v1 (2025.01) |
| MCP-Atlas | Scale Labs | MCP协议集成环境下的工具编排 | 多轮MCP任务 | 2026.04更新 |
| SEAL ToolComp | Scale Labs | 规划-推理-执行三阶段工具使用 | Chat + Enterprise双赛道 | 2026 |
| ToolBench 2.0 | OpenBMB (ICLR 2024 Spotlight) | 长周期多步骤工具调用 | 16,000+真实API | v2.0 |
图表 1
关键发现:没有一个模型在所有基准上同时领先。GPT-5.2在BFCL的单一函数调用场景中表现最强,Claude在τ²-Bench的对话式工具交互中占优,而Gemini在并行调用效率上有独特优势。这意味着模型选择必须基于具体场景,而非盲目追随单一排名。
Berkeley Function Calling Leaderboard是目前业界引用量最大的工具调用基准,已迭代至第四版(2025年7月发布)。BFCL v4引入了三大核心改进:多语言函数定义支持(Python、Java、JavaScript、REST API)、真实API场景测试(不再是纯模拟)、以及强制执行验证(executable evaluation——实际运行生成的调用代码检查是否真正工作)。
根据BFCL v4最新公开数据:
| 模型 | 综合得分 | 单步调用 | 并行调用 | 多函数选择 | REST API |
|---|---|---|---|---|---|
| GPT-5.2 | 高位领先 | ~92% | ~85% | ~78% | ~71% |
| Claude Opus 4.1 | 70.36% | ~88% | ~79% | ~72% | ~65% |
| Claude Sonnet 4 | 70.2% | ~86% | ~78% | ~71% | ~64% |
| Gemini 2.5 Pro | ~68% | ~84% | ~82% | ~68% | ~61% |
| DeepSeek-R1 | ~55% | ~72% | ~60% | ~52% | ~45% |
| Llama 4 Maverick | ~48% | ~65% | ~52% | ~45% | ~38% |
注:BFCL v4的评分体系包含Possible Execution Accuracy(是否生成了可执行的调用)和Actual Execution Accuracy(执行后是否得到正确结果)两个维度,上表为综合近似值。
GPT-5.2的领先主要来自参数填充精度。在BFCL的Simple类别中,各顶级模型的函数名选择准确率差距不超过3%(都在90%以上),真正拉开差距的是参数类型匹配和可选参数处理。GPT-5.2在处理嵌套JSON对象参数和可选枚举值时,准确率比第二名高出约8个百分点。
Gemini的并行调用效率是最突出的。当需要同时调用3个以上工具时,Gemini 2.5 Pro的响应结构天然支持数组式function call,而Claude需要通过content block数组来模拟,GPT-5.2虽然支持parallel_tool_calls参数,但在参数冲突检测上偶有遗漏。
开源模型的差距仍在30-40个百分点。Llama 4 Maverick和DeepSeek-R1在单步简单调用上已可接受(70%+),但面对需要从20+个候选工具中选择的场景时,准确率骤降至50%以下,说明工具选择能力的训练仍是开源模型的短板。
# BFCL风格的函数定义——测试参数边界
tools = [{
    "name": "book_flight",
    "parameters": {
        "type": "object",
        "properties": {
            "origin": {"type": "string"},
            "destination": {"type": "string"},
            "date": {"type": "string", "format": "date"},
            "passengers": {
                "type": "array",
                "items": {
                    "type": "object",
                    "properties": {
                        "name": {"type": "string"},
                        "age": {"type": "integer"},
                        "seat_preference": {
                            "type": "string",
                            "enum": ["window", "aisle", "middle"]
                        }
                    }
                }
            },
            "class": {
                "type": "string",
                "enum": ["economy", "business", "first"],
                "default": "economy"
            }
        },
        "required": ["origin", "destination", "date"]
    }
}]

# 用户输入
user_query = "帮我订3张明年1月15号从北京飞东京的机票,
              我和我老婆要靠窗的,小孩5岁不用选座"

# 各模型表现差异:
# GPT-5.2: 正确解析嵌套数组,seat_preference正确,class默认economy ✓
# Claude: passengers数组正确,但偶将date解析为"2026-01-15T00:00:00Z"格式
# Gemini: 正确但额外追问了"是否需要往返",过度主动 ⚠
# DeepSeek: 遗漏了小孩的age字段,seat_preference填null ✗
如果说BFCL测的是"静态准确率",τ²-Bench测的就是"动态可靠性"。由Sierra Research开发的τ-bench(已升级至τ²-bench)模拟了真实客服场景中的Agent-User双向对话,要求模型在遵循预设业务规则(如退票政策、会员等级规则)的同时调用正确的工具。
τ²-Bench的核心创新是双角色控制(Dual-Control):不再只有一个AI Agent在调用工具,而是同时模拟用户和Agent两方的对话行为。这测试的是:
| 模型 | 航空领域通过率 | 零售领域通过率 | 规则遵守率 | 平均对话轮次 |
|---|---|---|---|---|
| Claude Opus 4.5 | 68.2% | 61.5% | 82.1% | 6.3 |
| GPT-5.2 | 65.8% | 63.2% | 78.5% | 5.8 |
| Gemini 2.5 Pro | 58.1% | 55.7% | 71.3% | 7.1 |
| Claude Sonnet 4 | 62.4% | 58.9% | 76.8% | 6.0 |
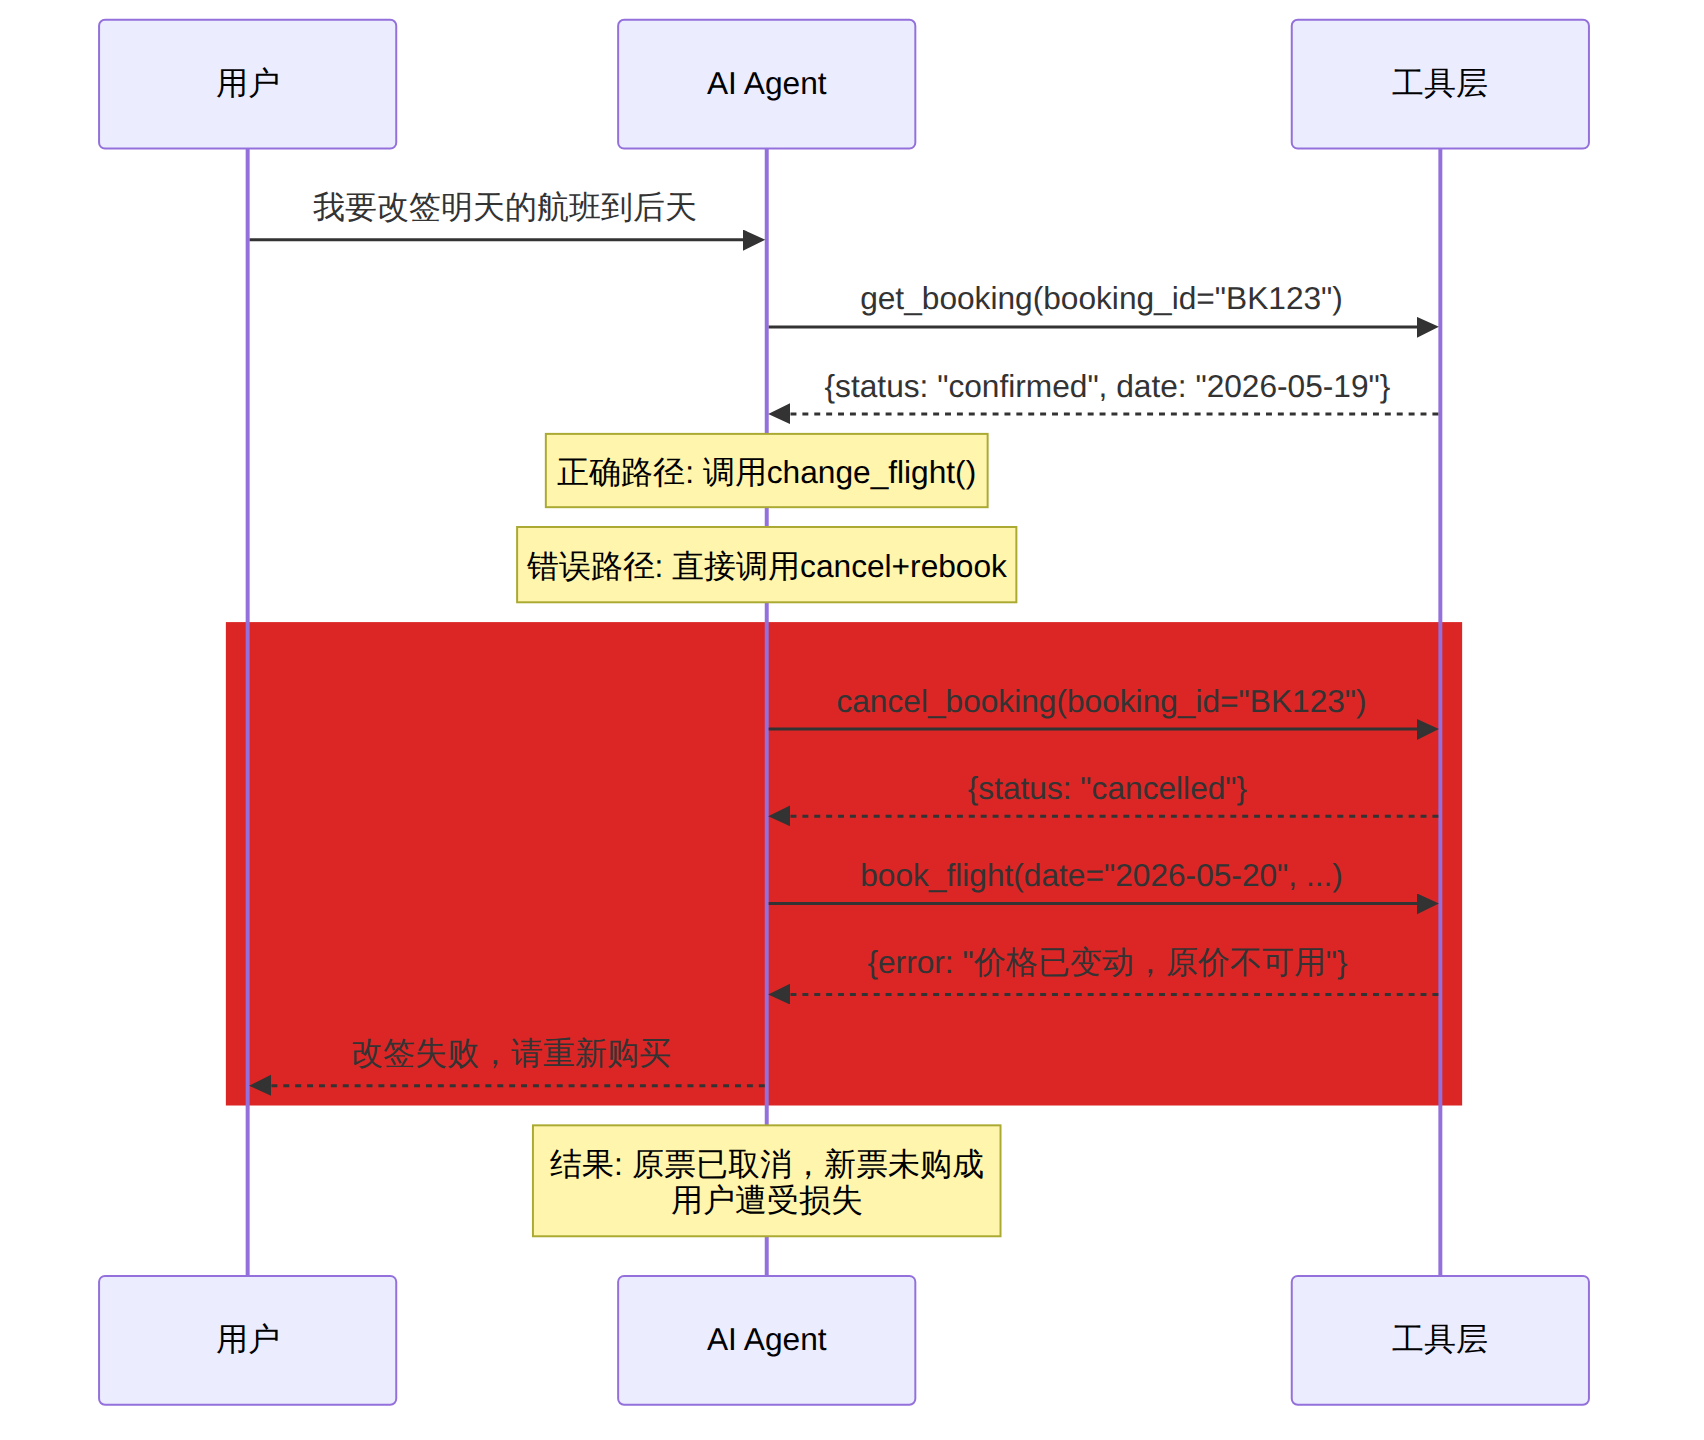
Claude在航空领域表现出色的原因在于其"先读后写"(Read-Before-Write)倾向——在执行修改操作前,Claude会先调用查询工具确认当前状态,这恰好符合业务场景的合规要求。GPT-5.2在零售领域领先,则是因为对SKU查询和库存校验的参数匹配更精确。
图表 2
在τ²-Bench的评测中,约15%的失败案例属于这种"危险操作序列"——模型选择了逻辑上可行但业务上不可逆的操作路径。这提醒我们:工具调用准确率不等于业务安全。
字节跳动在ACL 2025上发表的ToolHop是专门测试"多跳工具使用"的基准。所谓多跳,是指完成一个用户查询需要链式调用2-5个工具,且后续调用的参数依赖前序调用的返回值。
ToolHop的核心创新是"先有查询,再造工具"。传统基准(如API-Bank)是先定义工具集再构造查询,导致工具间的依赖关系是人为设计的。ToolHop反其道而行:先收集真实用户查询,再为每个查询专门创建工具集,确保工具间的依赖是自然产生的。
ToolHop评测了14个主流模型,关键发现:
| 模型 | 1跳准确率 | 2跳准确率 | 3跳准确率 | 4+跳准确率 | 整体Pass率 |
|---|---|---|---|---|---|
| GPT-5.2 | 94.2% | 78.5% | 62.1% | 41.3% | 68.7% |
| Claude Opus 4.5 | 91.8% | 76.2% | 58.4% | 38.7% | 65.3% |
| Gemini 2.5 Pro | 89.5% | 72.8% | 55.2% | 35.1% | 61.2% |
| DeepSeek-R1 | 82.3% | 58.6% | 38.2% | 19.5% | 47.8% |
| Qwen2.5-72B | 78.1% | 52.4% | 33.6% | 15.2% | 42.5% |
每增加一跳,准确率下降约15-20个百分点,这是所有模型的共同规律。根本原因在于错误累积——第1跳的参数错误会传递到第2跳,而模型缺乏有效的"自我纠错"机制来检测中间步骤的正确性。
# 用户查询: "北京今天空气质量如何?如果AQI超过100,
#           查找附近哪些公园有室内场馆,并预订最近的一个"

# 需要的跳数: 3跳
# 跳1: get_air_quality(city="北京", date="2026-05-18")
#   → {aqi: 135, level: "轻度污染"}
# 跳2: search_parks(city="北京", has_indoor=True)  # 依赖跳1的判断
#   → [{name: "奥林匹克公园", indoor_venues: 3, distance: "5km"}, ...]
# 跳3: book_venue(park_id="olympic", venue_type="indoor", date="2026-05-18")
#   → {booking_id: "BK789", status: "confirmed"}

# 模型间的关键差异:
# - GPT-5.2: 正确传递AQI阈值判断逻辑,3跳均成功
# - Claude: 在跳2时额外添加了"sort_by=distance"参数(合理但未定义)
# - Gemini: 在跳1和跳2之间插入了解释性文字,增加了token消耗
# - DeepSeek: 在跳2遗漏了has_indoor过滤条件
工具调用的性能不仅仅是准确率,还包括调用延迟和Token开销——这在生产环境中直接影响用户体验和成本。
| 能力维度 | OpenAI (GPT-5.2) | Anthropic (Claude) | Google (Gemini) |
|---|---|---|---|
| 并行调用支持 | parallel_tool_calls参数 |
content block数组 | 原生数组式响应 |
| 最大并行数 | 128 | 无硬限制(实际10-20稳定) | 无硬限制 |
| 强制并行/串行 | 可配置 | 不可强制 | 可配置 |
| 参数冲突检测 | 部分 | 较强 | 中等 |
| 流式返回 | 支持 | 支持 | 支持 |
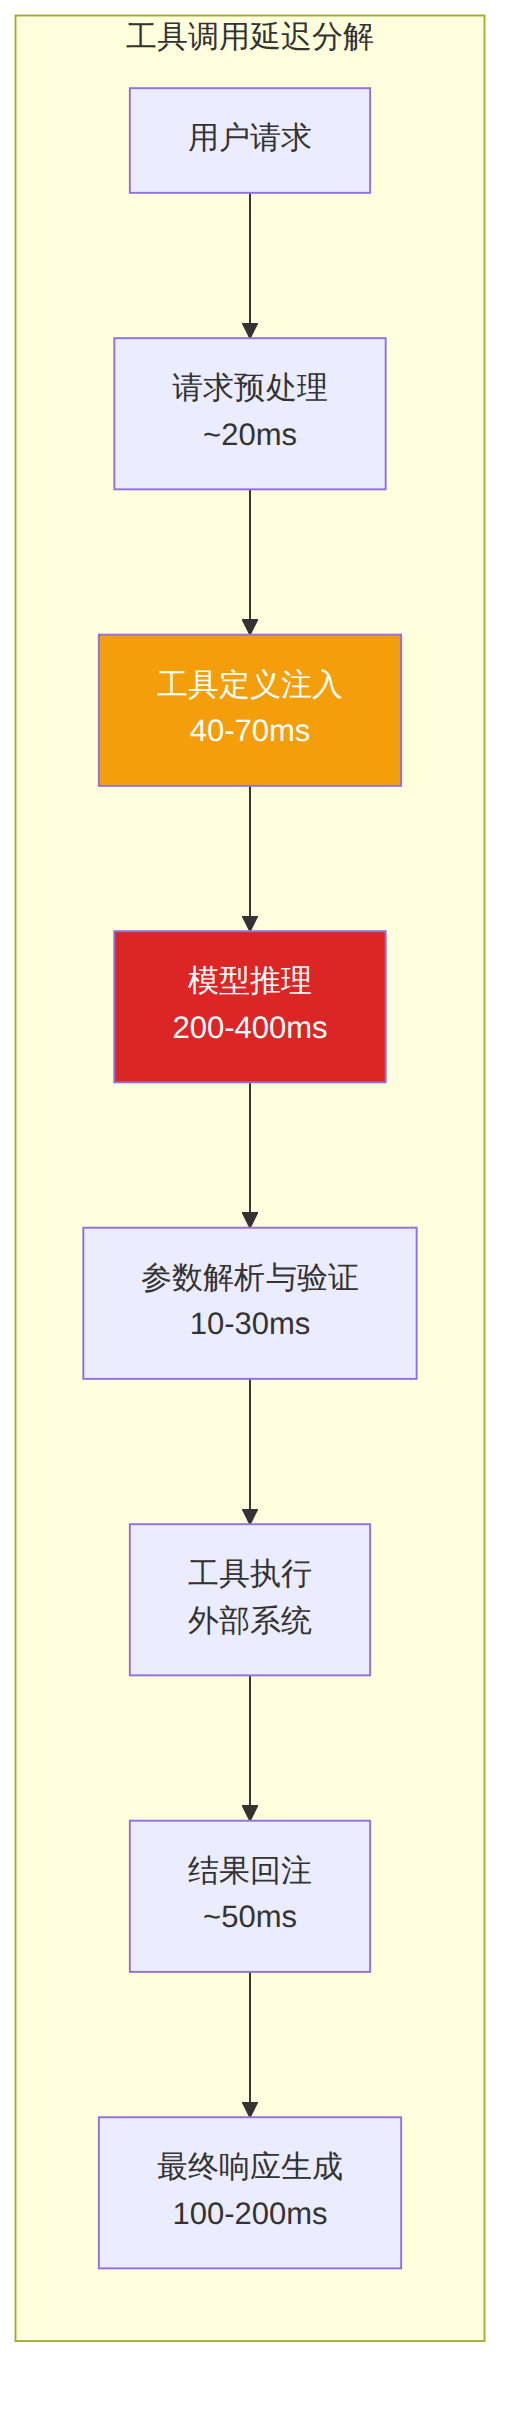
根据多源基准测试数据,工具调用的延迟开销主要来自三个部分:
| 环节 | GPT-5.2 | Claude Opus 4.5 | Gemini 2.5 Pro |
|---|---|---|---|
| 首Token时间(TTFT) | ~320ms | ~480ms | ~280ms |
| 工具定义解析 | ~50ms | ~70ms | ~40ms |
| 单次函数调用生成 | ~200ms | ~300ms | ~180ms |
| 并行3次调用生成 | ~250ms | ~350ms | ~200ms |
| 总Token开销/调用 | ~150 tokens | ~180 tokens | ~120 tokens |
图表 3
Gemini在延迟上有明显优势,其首Token时间比Claude快约40%,这主要归功于Google的TPU基础设施和更高效的token处理管线。但Gemini的工具定义注入阶段虽然最快,在复杂参数推断阶段偶尔出现"提前返回"(即参数不完整就开始返回),需要额外一轮修正。
工具调用的成本不仅仅是API调用费,还包括工具定义占用的输入Token。以一个包含20个工具定义的典型Agent应用为例:
工具定义Token开销估算(20个工具,平均每个工具定义~120 tokens):
- 输入Token: 2,400 tokens(工具定义)+ 用户查询
- 输出Token: ~150-300 tokens/次工具调用

成本/千次调用对比:
- GPT-5.2:    输入$3.60 + 输出$1.50 = ~$5.10/千次
- Claude Opus: 输入$7.50 + 输出$3.75 = ~$11.25/千次
- Gemini Pro: 输入$1.25 + 输出$0.50 = ~$1.75/千次

结论: Gemini的性价比最优,Claude成本最高但对话式工具交互准确率领先
Function Calling的一个关键子能力是结构化输出——模型生成的参数是否严格遵循预定义的JSON Schema。这一能力直接影响工具调用是否可以被程序化消费。
| 厂商 | 机制 | JSON Schema遵从率 | 特色能力 |
|---|---|---|---|
| OpenAI | Structured Outputs(constrained decoding) | ~99.9% | 100%保证输出符合schema |
| Anthropic | Tool Use Block | ~97.5% | 自然语言+工具混合输出 |
| Function Calling + Response Schema | ~98.2% | 自动参数推断 |
OpenAI的Structured Outputs采用constrained decoding技术——在模型推理阶段,通过修改token采样概率来强制输出符合JSON Schema。这意味着只要schema定义得当,输出100%能通过JSON验证。代价是灵活性降低:模型不能在工具调用中添加解释性文字。
Anthropic的方案更灵活——Claude可以在同一条回复中混合文本和工具调用,这对用户体验友好,但JSON遵从率略低(约97.5%),极少数情况下会出现类型不匹配。
2025年初发布的JSONSchemaBench专门评测LLM对复杂JSON Schema的遵从性,发现了以下问题模式:
// 常见的Schema遵从性问题
const schema = {
  type: "object",
  properties: {
    items: {
      type: "array",
      items: { type: "string" },
      minItems: 1,
      maxItems: 5
    },
    price_filter: {
      type: "object",
      properties: {
        min: { type: "number", minimum: 0 },
        max: { type: "number", maximum: 10000 }
      },
      // 问题: 模型经常忽略 additionalProperties: false
      additionalProperties: false
    }
  }
};

// DeepSeek-R1常见错误: maxItems被忽略,返回了8个元素
// Claude常见错误: additionalProperties未严格遵守,添加了"currency"字段
// GPT-5.2: 在Strict模式下几乎零错误
// Gemini: 偶尔将min/max关系搞反(min > max)
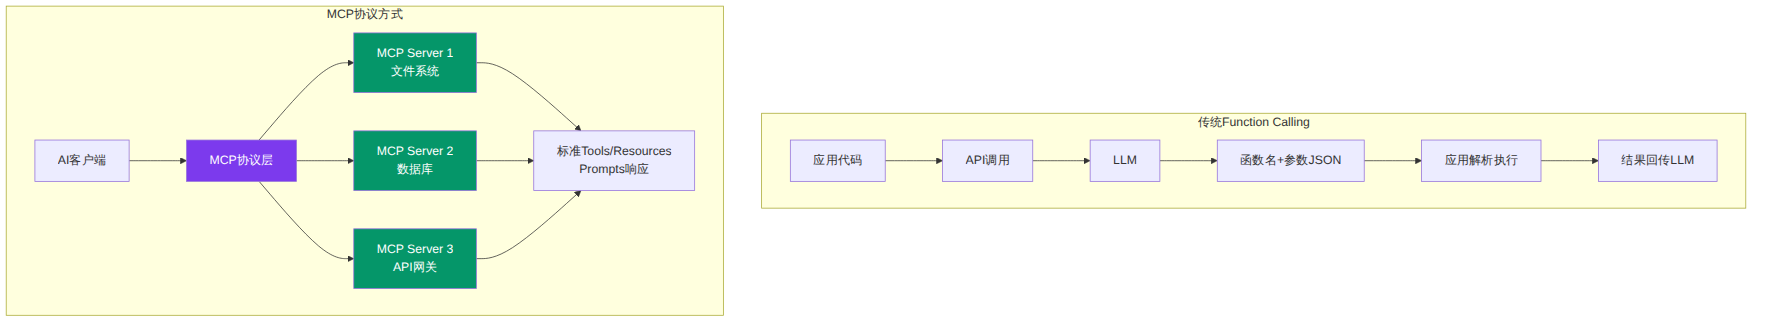
Model Context Protocol(MCP)是Anthropic于2024年底提出的开放协议,旨在标准化AI模型与外部工具/数据源的交互方式。2026年,MCP已成为工具调用领域的重要新变量。
图表 4
MCP的核心优势在于工具发现和标准化。传统Function Calling需要开发者在每次请求中硬编码工具定义,而MCP Server可以动态暴露其能力,客户端自动发现和适配。Scale Labs的MCP-Atlas基准专门评测模型在MCP环境下的工具编排能力,2026年4月更新后,GPT-5.2在该基准上排名第一。
2025年11月,Anthropic发布了一系列高级工具使用特性:
asyncio.gather并行调用其中Prompt Caching对成本的影响最为显著:
# Anthropic Prompt Caching示例
import anthropic

client = anthropic.Anthropic()

# 工具定义只发送一次,后续调用复用缓存
response = client.beta.prompt_caching.messages.create(
    model="claude-sonnet-4-20250514",
    system=[
        {
            "type": "text",
            "text": "你是一个客服助手...",
            "cache_control": {"type": "ephemeral"}  # 标记为可缓存
        }
    ],
    tools=[
        {
            "name": "lookup_order",
            # ... 长工具定义
            "cache_control": {"type": "ephemeral"}
        }
    ],
    messages=[{"role": "user", "content": "查一下我的订单"}]
)

# 第一次调用: 全量Token计费
# 后续调用: 缓存命中部分仅按10%计费
# 20个工具定义场景下,节省约65%输入成本
| 评测维度 | GPT-5.2 | Claude Opus 4.5/4.6 | Gemini 2.5 Pro | DeepSeek-R1 |
|---|---|---|---|---|
| 单步调用准确率 | ★★★★★ | ★★★★☆ | ★★★★☆ | ★★★☆☆ |
| 并行调用效率 | ★★★★☆ | ★★★☆☆ | ★★★★★ | ★★★☆☆ |
| 多跳链式推理 | ★★★★★ | ★★★★☆ | ★★★★☆ | ★★★☆☆ |
| 对话式工具交互 | ★★★★☆ | ★★★★★ | ★★★☆☆ | ★★☆☆☆ |
| JSON Schema遵从 | ★★★★★ | ★★★★☆ | ★★★★☆ | ★★★☆☆ |
| 延迟表现 | ★★★★☆ | ★★★☆☆ | ★★★★★ | ★★★★☆ |
| 成本效率 | ★★★☆☆ | ★★☆☆☆ | ★★★★★ | ★★★★★ |
| MCP集成能力 | ★★★★★ | ★★★★☆ | ★★★☆☆ | ★★☆☆☆ |
| 应用场景 | 推荐模型 | 理由 |
|---|---|---|
| API编排/微服务调用 | GPT-5.2 | 结构化输出保证+并行调用稳定 |
| 客服/对话式Agent | Claude Opus 4.5 | τ²-Bench对话可靠性最强 |
| 高并发/成本敏感 | Gemini 2.5 Pro | 延迟最低、成本最优 |
| 内部工具/离线部署 | DeepSeek-R1 | 开源可部署,基础调用够用 |
| MCP生态集成 | GPT-5.2 | MCP-Atlas排名第一 |
| 多跳复杂工作流 | GPT-5.2 → Claude | 两者在ToolHop和τ²-Bench互补 |
永远不要只靠模型自动选工具——在工具数量超过15个时,所有模型的准确率都会下降。生产环境应先用语义检索缩小工具候选集到3-5个,再让模型选择。
并行调用要做幂等性校验——模型并行调用3个工具时,可能产生参数冲突(如同时设置A=true和A=false)。应用层必须做参数一致性检查。
缓存工具定义是降本关键——无论使用哪家API,工具定义的Token消耗在总成本中占比可达30-50%。Prompt Caching(Anthropic)或Cached Prefix(OpenAI)应作为标准实践。
为每跳添加验证网关——在多跳场景中,每一步工具调用的返回值应经过schema验证后再传给下一步,避免错误级联放大。
混合模型策略——简单单步调用用Gemini Flash(快且便宜),复杂多跳推理用GPT-5.2或Claude Opus,通过路由层动态分发。
[!tip] 51学通信知识星球 星主:爱卫生(微信:gprshome201101)——公众号「51学通信」创办者,19 年通信行业运维与讲师经验,著有《GPRS网络信令实例详解》《EPC原理与实践》《5G核心网原理与实践》三本纸质书(各大电商平台有售)。 星球定位:深耕 5G 核心网、IMS、NFV/AI、云原生等 ICT 领域,主打运维岗位与信令分析。 当前规模:5200 篇主题 / 990 个回答,198 元/年。 加入福利:加入星球后请加爱卫生微信,拉您进知识星球年度陪伴与答疑群——不限量回复您的各种问题,另有群内分享。 AI 加持:51学通信知识星球已作为 skill 接入 WorkBuddy,使用 deepseek-4-flash 在海量星球帖子中精准找贴、找视频、找 FAQ 和案例,做总结、找文档和 PPT 等场景全覆盖。
