2026年,AI Agent的核心能力已不再仅仅是"对话"——工具调用(Tool Use / Function Calling)成为衡量模型智能水平的决定性指标。从Berkeley的BFCL V4排行榜到Sierra Research的τ-bench,从Anthropic的MCP协议到OpenAI的Agents SDK,整个工具调用生态正在经历一场标准化革命。本文深入评测五大评估基准、六大主流模型的工具调用能力、三类工具集成范式的技术对比,以及开源函数调用模型的最新进展,为开发者和产品团队提供选型决策依据。
大模型本身是一个封闭的推理引擎。没有工具调用能力,它只能"想"不能"做"。工具调用打通了LLM与外部世界的最后一公里——查询数据库、调用API、执行代码、操作浏览器、读写文件,全部依赖这一层能力。
2026年的关键趋势:
| 基准名称 | 发布机构 | 评测维度 | 测试规模 | 核心特点 | 更新状态 |
|---|---|---|---|---|---|
| BFCL V4 | UC Berkeley | 函数选择、参数填充、多函数、复杂推理 | 2000+测试用例 | 最全面的函数调用排行榜,支持多语言 | 活跃更新 |
| τ-bench | Sierra Research | 多轮工具-用户交互、策略遵循 | 零售+航空双域 | 模拟真实客服场景,含用户模拟器 | V3修复版 |
| ToolBench | 清华/OSU | 多工具编排、API链式调用 | 16000+ API | 覆盖真实API大规模测试 | 持续扩展 |
| API-Bank | AliCloud | API调用规划、参数提取 | 53类API | 层级式评估(L1-L3难度) | 稳定维护 |
| WebArena | CMU | 浏览器操作、网页交互 | 812个任务 | 真实网页环境测试 | 活跃 |
Berkeley Function Calling Leaderboard V4是目前公认最权威的函数调用基准。它从四个维度评估模型:
# BFCL评测示例(多函数选择)
{
  "query": "What's the weather in Tokyo and convert 100 USD to JPY?",
  "functions": [
    {"name": "get_weather", "parameters": {"city": "string"}},
    {"name": "convert_currency", "parameters": {"amount": "number", "from": "string", "to": "string"}},
    {"name": "search_web", "parameters": {"query": "string"}}
  ]
}
# 期望输出:并行调用 get_weather("Tokyo") + convert_currency(100, "USD", "JPY")
BFCL V4的突破在于引入了可执行验证——不只是检查JSON格式正确,而是实际执行函数调用并验证返回结果。这解决了"看起来对但实际错"的评估盲区。
τ-bench由Sierra Research(原OpenAI研究员Karpathy参与创立)开发,模拟零售电商和航空客服两个真实业务场景。核心创新是引入用户模拟器——AI扮演不断追问、改主意、提无理要求的客户,测试Agent在多轮对话中的工具调用准确性。
τ³-bench(V3版本)在2026年初修复了50+个任务缺陷,包括模糊指令、矛盾约束和不切实际的预期,使评测更加可靠。在τ-bench Airline赛道上,Claude Opus 4和GPT-4o展开激烈竞争。
ToolBench覆盖16000+真实API,测试模型的工具发现、参数推理、链式调用能力。它的核心挑战在于:
| 模型 | BFCL V4总分 | τ-bench Airline | τ-bench Retail | 并行调用 | 结构化输出 | MCP支持 |
|---|---|---|---|---|---|---|
| Claude Opus 4 | 92.1% | 68.4% | 57.2% | 优秀 | JSON Schema | 原生 |
| GPT-4o | 90.8% | 65.1% | 55.8% | 优秀 | Structured Output | 通过API |
| Gemini 2.5 Pro | 89.3% | 62.7% | 53.4% | 良好 | Response Schema | 通过ADK |
| Claude Sonnet 4 | 88.5% | 61.2% | 52.1% | 优秀 | JSON Schema | 原生 |
| GPT-4.1 | 91.2% | 66.8% | 56.3% | 优秀 | Structured Output | 通过API |
| DeepSeek-V3 | 85.7% | 48.3% | 42.6% | 良好 | JSON Mode | 有限 |
注:以上数据综合BFCL公开排行榜和BenchLM.ai聚合数据,截至2026年5月。
Claude Opus 4在工具调用方面展现三大优势:
并行工具调用:Claude原生支持在单次响应中调用多个独立工具,减少Agent Loop轮次。这对于需要同时查询多个数据源的场景至关重要。
MCP原生支持:作为MCP协议的创建者,Claude与MCP的集成最为深度。2026年5月,MCP生态已有2300+公开Server,覆盖数据库、浏览器、文件系统等核心场景。
# Claude工具调用示例(并行调用)
import anthropic

client = anthropic.Anthropic()
response = client.messages.create(
    model="claude-opus-4-20250514",
    tools=[
        {
            "name": "get_stock_price",
            "description": "Get current stock price",
            "input_schema": {
                "type": "object",
                "properties": {"symbol": {"type": "string"}},
                "required": ["symbol"]
            }
        },
        {
            "name": "get_weather",
            "description": "Get weather forecast",
            "input_schema": {
                "type": "object",
                "properties": {"city": {"type": "string"}},
                "required": ["city"]
            }
        }
    ],
    messages=[{"role": "user", "content": "AAPL stock price and NYC weather"}]
)
# Claude会在单次响应中返回两个tool_use block
长上下文工具管理:Claude在200K上下文窗口下仍能准确选择工具,不会因为工具列表过长而"迷失"。
GPT-4.1最大的差异化优势是Structured Output——100%保证输出符合预定义的JSON Schema,不会出现格式错误。这对生产环境至关重要。
OpenAI在2026年推出的Agents SDK将Function Calling与Agent Loop深度整合:
# OpenAI Agents SDK工具定义
from agents import Agent, function_tool

@function_tool
def search_flights(origin: str, destination: str, date: str) -> str:
    """Search for available flights."""
    # 实际API调用逻辑
    return f"Found 3 flights from {origin} to {destination} on {date}"

travel_agent = Agent(
    name="Travel Assistant",
    tools=[search_flights],
    model="gpt-4.1"
)
Agents SDK的核心特性: - 自动Agent Loop:SDK自动处理工具调用→结果返回→继续推理的循环 - Handoff机制:Agent可以将任务转交给其他专业Agent - 并行Agent执行:多个Agent可以并发运行并聚合结果 - Guardrails:输入/输出安全检查层
Gemini 2.5 Pro的独特优势在于多模态工具调用——它可以在工具调用中直接处理图像、音频、视频输入。例如,用户上传一张损坏零件的照片,Gemini可以调用库存查询工具找到替换零件。
Google的Agent Development Kit (ADK)提供了与MCP兼容的工具接入层,虽然生态丰富度不及Anthropic原生MCP,但与Google Cloud服务的集成是独特优势。
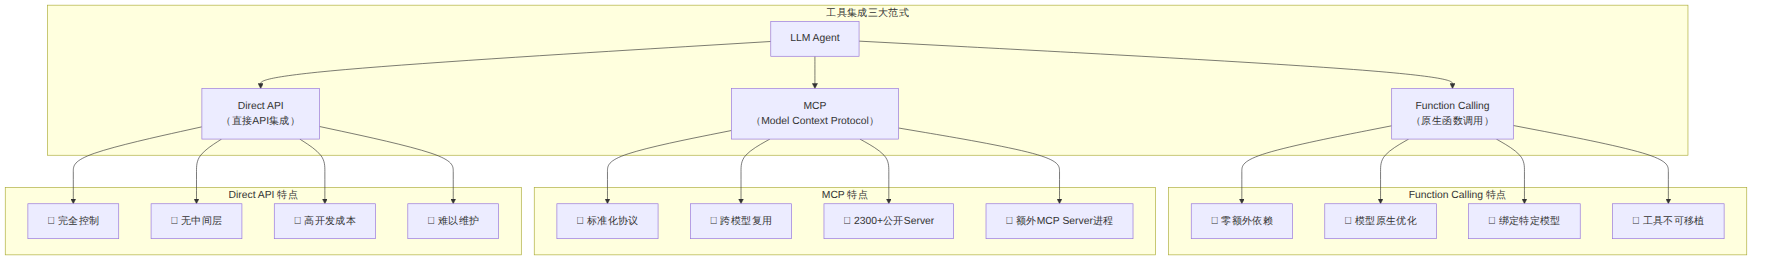
这是2026年AI Agent架构设计中最核心的决策点。
图表 1
| 维度 | Function Calling | MCP | Direct API |
|---|---|---|---|
| 标准化程度 | 各厂商私有格式 | 开放标准(Anthropic发起) | 无标准 |
| 工具复用性 | 低(绑定模型) | 高(一次编写,多模型用) | 低 |
| 状态管理 | 无状态 | 有状态(长连接) | 自行实现 |
| 开发成本 | 低(直接写JSON Schema) | 中(需搭建MCP Server) | 高 |
| 调试难度 | 简单 | 中等 | 简单 |
| 适用场景 | 快速原型、单模型 | 生产环境、多模型 | 高度定制化 |
| 生态丰富度 | 跟随模型能力 | 2300+公开Server | 无限制 |
MCP采用经典的Client-Server架构,但与传统API不同,它引入了三个核心原语:
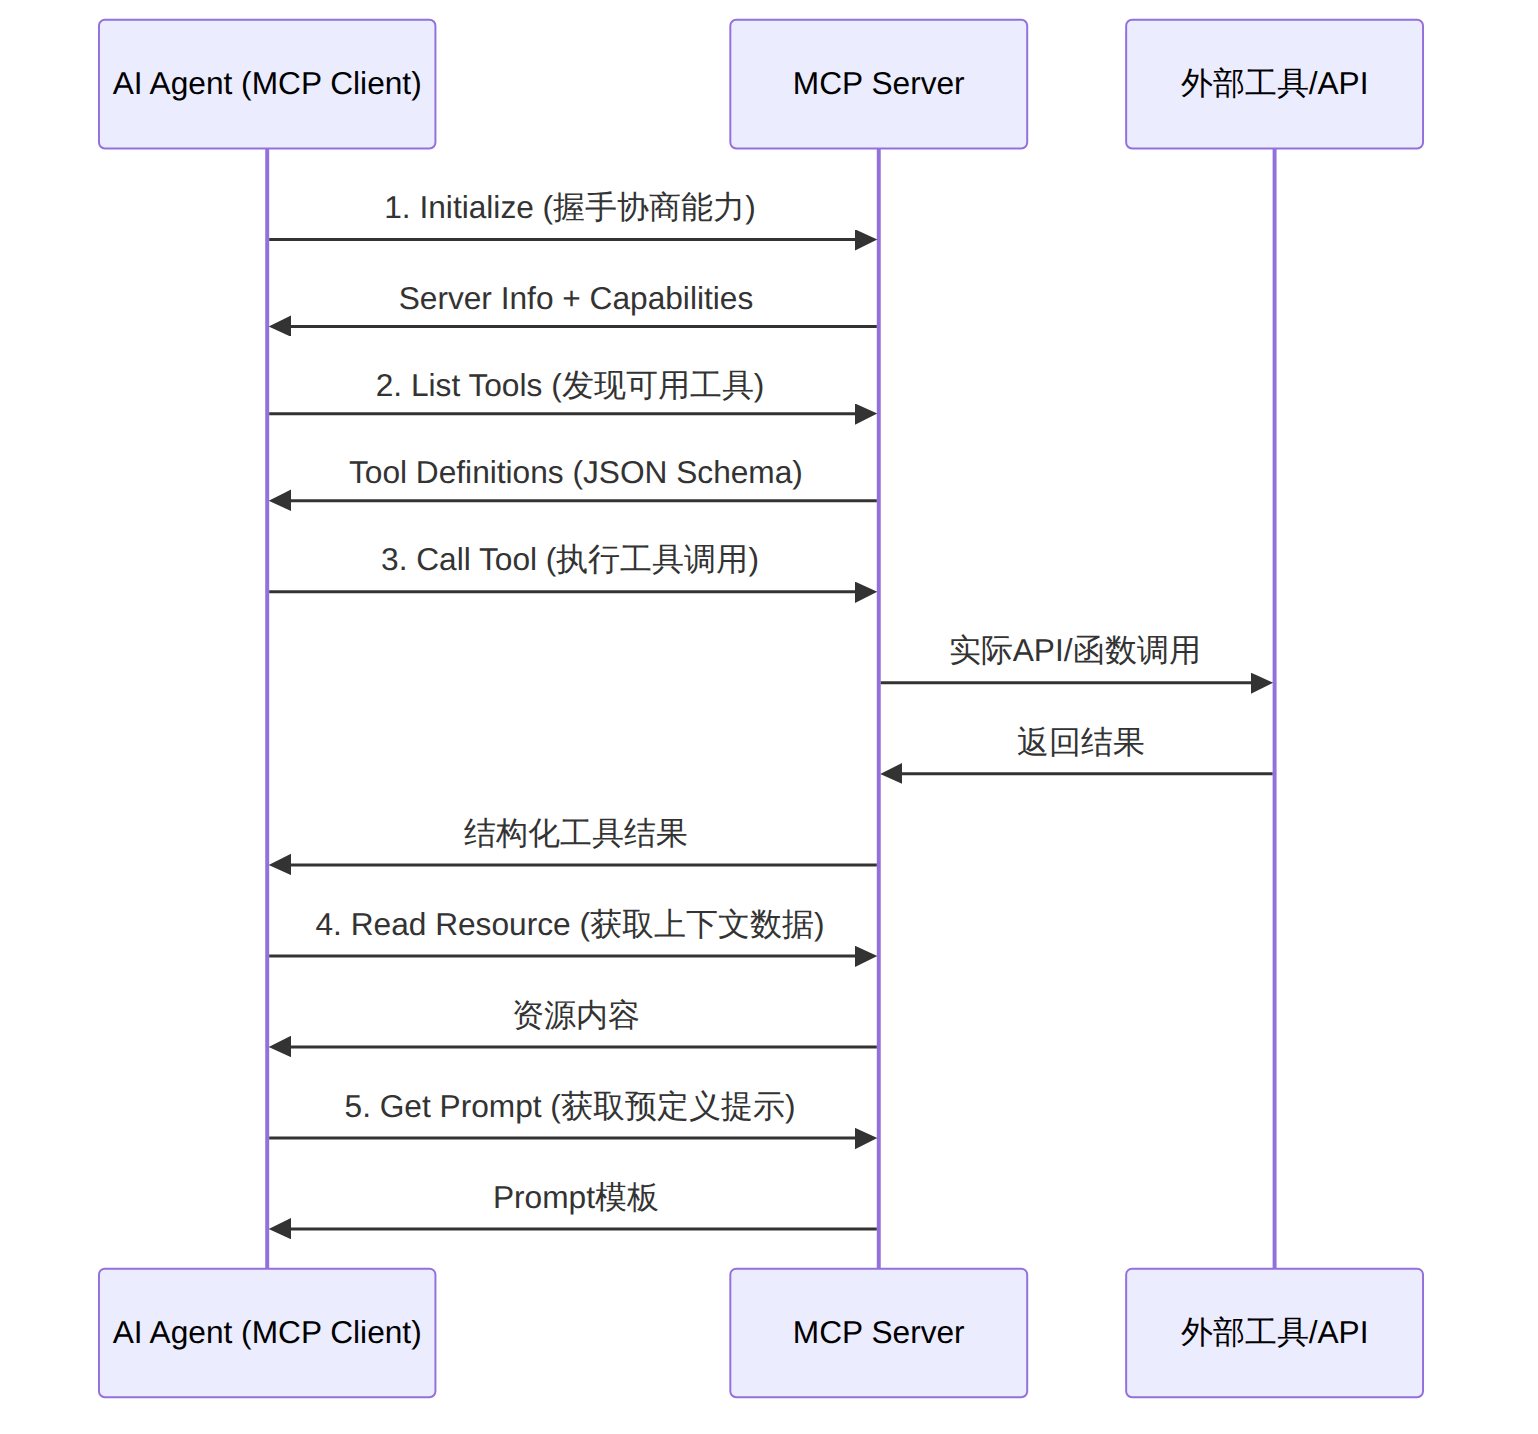
图表 2
MCP的三大原语: - Tools:模型可调用的函数(等同于Function Calling) - Resources:模型可读取的上下文数据(文件、数据库记录等) - Prompts:预定义的提示模板,确保工具使用的一致性
2026年最热门的MCP Server包括: - filesystem:文件系统读写操作 - postgres / sqlite:数据库查询 - puppeteer:浏览器自动化 - github:GitHub API集成 - slack:Slack消息读写 - brave-search:网络搜索
| 场景 | 推荐方案 | 理由 |
|---|---|---|
| 内部工具、快速验证 | Function Calling | 零额外依赖,开发最快 |
| 多模型切换、生产部署 | MCP | 工具层与模型解耦,可移植 |
| 已有成熟API体系 | MCP封装层 | 复用现有API,统一接口 |
| 高安全要求场景 | Direct API + 审计 | 完全控制数据流 |
| 开源模型本地部署 | Function Calling + Ollama | 避免MCP Server额外开销 |
闭源模型在工具调用领域长期占据主导,但2026年开源生态正在快速追赶。
| 模型 | 参数量 | 来源 | BFCL V3得分 | 核心特点 | 商用许可 |
|---|---|---|---|---|---|
| xLAM-2-8x22B | 141B (MoE) | Salesforce | 87.3% | MoE架构,Agent专用 | Apache 2.0 |
| xLAM-2-72B | 72B | Salesforce | 85.1% | 均衡性能与成本 | Apache 2.0 |
| ToolACE-8B | 8B | InternLM Team | 82.7% | 小模型标杆 | Apache 2.0 |
| NexusRaven-V2 | 13B | NexusFlow | 81.4% | 零样本函数调用 | Apache 2.0 |
| Hermes-3-8B | 8B | NousResearch | 79.8% | 通用能力强 | Apache 2.0 |
| Qwen2.5-7B-FC | 7B | Alibaba | 78.2% | 中文优化 | Apache 2.0 |
Salesforce Research推出的xLAM(Large Action Model)是目前最成熟的开源函数调用模型家族。其核心创新在于:
数据工程:xLAM的训练数据来自Salesforce内部60,000+真实函数调用样本(xlam-function-calling-60k数据集),加上大规模合成数据。这种真实+合成的混合策略解决了函数调用数据稀缺问题。
# 使用xLAM进行函数调用
from transformers import AutoModelForCausalLM, AutoTokenizer

model = AutoModelForCausalLM.from_pretrained("Salesforce/xLAM-2-8x22B")
tokenizer = AutoTokenizer.from_pretrained("Salesforce/xLAM-2-8x22B")

# 函数定义
functions = [{
    "name": "create_calendar_event",
    "description": "Create a new calendar event",
    "parameters": {
        "type": "object",
        "properties": {
            "title": {"type": "string"},
            "start_time": {"type": "string"},
            "duration_minutes": {"type": "integer"}
        },
        "required": ["title", "start_time"]
    }
}]

# xLAM会输出结构化的函数调用
# {"name": "create_calendar_event", "arguments": {"title": "Team Meeting", "start_time": "2026-05-20T10:00:00"}}
MoE架构优势:xLAM-2-8x22B采用Mixture of Experts架构,虽然总参数141B,但每次推理只激活约39B参数,在工具调用任务上实现了接近GPT-4o的效果。
ToolACE由InternLM团队开发,仅8B参数却在BFCL V3上达到82.7%。其核心创新是自动数据合成管线——通过LLM自动生成高质量的函数调用训练数据,包含:
这使得ToolACE在训练成本不到大模型1/10的情况下,实现了接近80B参数模型的效果。
NexusRaven-V2的独特定位是零样本函数调用——无需任何示例,直接根据函数定义生成正确调用。这对于工具经常变化的场景(如API频繁更新)特别有价值。
它可以通过Ollama直接本地部署:
ollama run nexusraven:13b
# 直接输入函数定义和用户query,无需fine-tuning
不要只看排行榜分数。生产环境的工具调用评估需要关注以下维度:
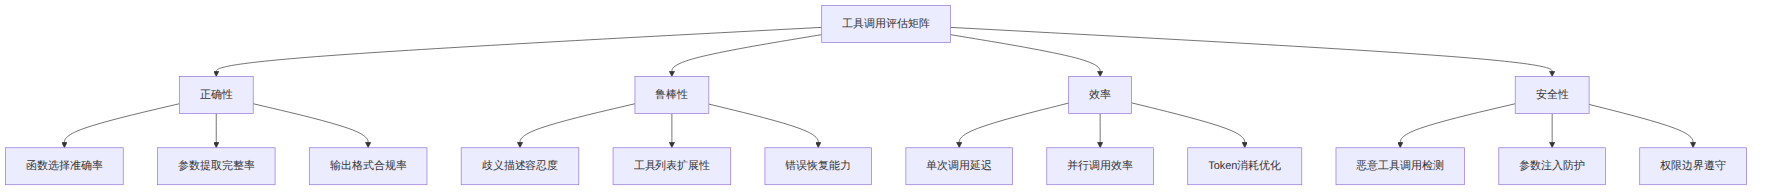
图表 3
# 工具调用评估框架模板
class ToolUseEvaluator:
    def __init__(self, model_client, test_cases):
        self.client = model_client
        self.cases = test_cases

    def evaluate(self):
        results = {
            "selection_accuracy": 0,   # 选对工具
            "param_completeness": 0,    # 参数完整
            "param_correctness": 0,     # 参数正确
            "format_compliance": 0,     # 格式合规
            "parallel_efficiency": 0,   # 并行效率
            "error_recovery": 0         # 错误恢复
        }

        for case in self.cases:
            response = self.client.messages.create(
                model=self.model,
                tools=case["tools"],
                messages=[{"role": "user", "content": case["query"]}]
            )

            # 评估各个维度
            for block in response.content:
                if block.type == "tool_use":
                    results["selection_accuracy"] += self._check_selection(block, case)
                    results["param_completeness"] += self._check_params(block, case)
                    results["param_correctness"] += self._check_values(block, case)
                    results["format_compliance"] += self._check_format(block)

        return {k: v / len(self.cases) for k, v in results.items()}
根据BFCL V4和τ-bench的公开错误分析,工具调用最常见的六大失败模式:
| 失败模式 | 发生频率 | 典型表现 | 根因 |
|---|---|---|---|
| 参数类型混淆 | 23% | 字符串"true"代替布尔true | Schema理解不足 |
| 函数选择错误 | 18% | 调用了相似但错误的函数 | 函数描述歧义 |
| 遗漏必要参数 | 15% | 缺少required字段 | 长上下文遗忘 |
| 幻觉调用 | 14% | 调用不存在的函数 | 过度推理 |
| 并行调用失败 | 12% | 串行处理本可并行的调用 | 模型能力限制 |
| 参数值推理错误 | 10% | 填入了错误但格式正确的值 | 语义理解不足 |
2026年的一个重要趋势是:用1B-8B的小模型微调出特定领域的工具调用专家。这意味着企业不必依赖昂贵的闭源大模型。
微调数据来源: - xLAM-function-calling-60k(Salesforce):60,000条真实函数调用样本 - ToolACE合成数据:自动化管线生成无限量训练数据 - BFCL训练集:Berkeley公开的函数调用训练数据 - 自建数据:从生产日志中提取真实调用模式
# 使用LoRA微调小模型进行工具调用
from peft import LoraConfig, get_peft_model
from transformers import AutoModelForCausalLM

base_model = AutoModelForCausalLM.from_pretrained("Qwen/Qwen2.5-3B")
lora_config = LoraConfig(
    r=16,
    lora_alpha=32,
    target_modules=["q_proj", "v_proj"],
    task_type="CAUSAL_LM"
)
model = get_peft_model(base_model, lora_config)
# 在xLAM数据集上训练3-5个epoch
# 显存需求:单张A100 40GB即可
| 方案 | 月成本(10万次调用) | BFCL预估得分 | 延迟 | 数据隐私 |
|---|---|---|---|---|
| GPT-4.1 API | ~$2000 | 91.2% | ~1.5s | 低 |
| Claude Opus 4 API | ~$2500 | 92.1% | ~1.8s | 低 |
| 微调Qwen2.5-7B | ~$500(GPU) | 82-85% | ~0.3s | 高 |
| 微调ToolACE-8B | ~$600(GPU) | 83-86% | ~0.4s | 高 |
| xLAM-2-72B自部署 | ~$1200(GPU) | 85-87% | ~0.8s | 高 |
| 场景 | 推荐模型 | 推荐框架 | 预算 |
|---|---|---|---|
| 企业客服Agent | Claude Opus 4 | MCP + Claude API | $$ |
| 内部工具自动化 | GPT-4.1 | OpenAI Agents SDK | $$ |
| 代码开发助手 | Claude Sonnet 4 | MCP + Claude Code | $ |
| 电商推荐Agent | 微调ToolACE-8B | 自部署 | $ |
| 多模态工具调用 | Gemini 2.5 Pro | Google ADK | $$ |
| 低成本高并发 | xLAM-2-72B | vLLM自部署 | $ |
| 高度定制化场景 | 微调Qwen2.5-7B | LoRA + Ollama | $ |
工具调用能力是AI Agent从"聊天机器人"进化为"数字员工"的关键跃迁点。BFCL V4、τ-bench等基准告诉我们:在结构化场景下,顶级模型已能可靠调用工具;但在模糊、动态、多轮的真实场景中,仍有显著提升空间。MCP协议的崛起正在统一工具接入层,而开源小模型的追赶则在降低入门门槛。对于开发者和产品团队而言,现在正是建立工具调用评估体系、选择合适技术栈的最佳时机——这个领域的变化速度远超想象,每季度都可能出现颠覆性的新方案。
[!tip] 51学通信知识星球 星主:爱卫生(微信:gprshome201101)——公众号「51学通信」创办者,19 年通信行业运维与讲师经验,著有《GPRS网络信令实例详解》《EPC原理与实践》《5G核心网原理与实践》三本纸质书(各大电商平台有售)。 星球定位:深耕 5G 核心网、IMS、NFV/AI、云原生等 ICT 领域,主打运维岗位与信令分析。 当前规模:5200 篇主题 / 990 个回答,198 元/年。 加入福利:加入星球后请加爱卫生微信,拉您进知识星球年度陪伴与答疑群——不限量回复您的各种问题,另有群内分享。 AI 加持:51学通信知识星球已作为 skill 接入 WorkBuddy,使用 deepseek-4-flash 在海量星球帖子中精准找贴、找视频、找 FAQ 和案例,做总结、找文档和 PPT 等场景全覆盖。
