2026年,工具调用(Tool Use / Function Calling)已从LLM的辅助功能进化为AI Agent的核心能力基座。三大厂商——OpenAI(GPT-5.2)、Anthropic(Claude Opus 4.6)、Google(Gemini 3)——在函数调用的准确率、并行能力和错误恢复上展开激烈竞争。BFCL v4榜单显示,当前SOTA模型在复杂多工具场景下准确率仅为57.5%,意味着工具调用仍是Agent系统最脆弱的环节。与此同时,MCP(Model Context Protocol)生态已突破13,000个Server实现,月下载量达9,700万次,正在从"Anthropic的私有协议"演变为行业通用标准。本文从评测基准、厂商对比、架构模式、可靠性工程四个维度,深度拆解AI Agent工具调用能力的现状与前沿。
Berkeley Function Calling Leaderboard(BFCL)已迭代至第四版(v4),从单纯的函数参数匹配演进为包含多步骤Agent工作流的综合评测。BFCL v4的核心变化包括:
根据BFCL v4最新榜单,GPT-5.2以57.5%的综合准确率暂居榜首,Claude Opus 4.6紧随其后,Gemini 3 Pro排名第三。值得注意的是,所有模型在"多工具并行调用+复杂嵌套参数"场景下的准确率均低于40%。
τ-bench由Sierra Research开发,专注评测Agent与工具、用户的真实三方交互能力。与BFCL的静态测试不同,τ-bench模拟真实的客户服务场景,要求Agent在对话中动态选择工具、处理用户中断、维持策略合规性。
τ-bench的独特价值: - 动态策略执行:Agent必须遵循复杂的业务规则(如退款策略的例外条款) - 用户模拟器:测试Agent面对"不配合用户"时的工具选择能力 - 多域覆盖:航空、零售、科技支持等不同行业的工具集
Scale Labs于2026年4月发布了MCP-Atlas评测,这是首个专门针对MCP协议的工具调用基准。MCP-Atlas测试模型在真实MCP Server定义下的工具发现、参数推断和错误恢复能力。2026年4月的更新升级了评分裁判模型,并加入了重试逻辑评测。
| 基准 | 发布方 | 核心测试维度 | 最新版本 | SOTA准确率 |
|---|---|---|---|---|
| BFCL v4 | UC Berkeley | 函数选择+参数生成 | v4 (2025.12) | 57.5% (GPT-5.2) |
| τ-bench | Sierra Research | Agent-工具-用户三方交互 | v2 (2026.03) | ~52% pass rate |
| MCP-Atlas | Scale Labs | MCP协议工具调用 | 2026.04 | 未公开 |
| MCPAgentBench | 学术论文 | 真实MCP定义评测 | 2025.12 | ~45% |
| APEX-Agents | Fleece AI | 综合Agent评测含工具调用 | 2026 | 未公开 |
| TAU2-Bench | Sierra Research | 多域工具Agent评测 | v2 | ~55% |
OpenAI在工具调用上的核心优势在于Structured Outputs(结构化输出)。GPT-5.2通过Constrained Decoding(约束解码)技术,保证了100%的JSON Schema遵从性——只要定义了参数Schema,输出必定符合Schema定义,不会出现格式错误。
# OpenAI function calling 示例
response = client.chat.completions.create(
    model="gpt-5.2",
    messages=[{"role": "user", "content": "北京今天天气如何?"}],
    tools=[{
        "type": "function",
        "function": {
            "name": "get_weather",
            "description": "获取指定城市的天气信息",
            "parameters": {
                "type": "object",
                "properties": {
                    "city": {"type": "string"},
                    "unit": {"type": "string", "enum": ["celsius", "fahrenheit"]}
                },
                "required": ["city"]
            },
            "strict": True  # 关键:启用严格模式
        }
    }],
    tool_choice="auto"  # auto | required | none | 特定函数
)
关键特性:
- strict: True:启用严格参数验证,保证100% Schema遵从
- tool_choice:支持auto(自动判断)、required(必须调用)、none(禁用)和指定函数名
- Parallel Function Calling:在单个响应中返回多个工具调用
- Structured Outputs:将函数调用与JSON Mode统一,底层共享Constrained Decoding引擎
Anthropic的工具调用策略与OpenAI有本质区别。Claude不依赖Constrained Decoding,而是通过预填充(Prefill)和工具描述引导来实现结构化输出。这意味着Claude的Schema遵从率略低于GPT-5.2(约95-98% vs 100%),但在理解复杂工具语义、处理模糊意图方面表现更优。
# Anthropic Claude tool use 示例
response = client.messages.create(
    model="claude-opus-4-6-20260501",
    max_tokens=1024,
    tools=[{
        "name": "get_weather",
        "description": "获取指定城市的当前天气信息",
        "input_schema": {
            "type": "object",
            "properties": {
                "city": {"type": "string", "description": "城市名称"},
                "unit": {
                    "type": "string",
                    "enum": ["celsius", "fahrenheit"],
                    "description": "温度单位"
                }
            },
            "required": ["city"]
        }
    }],
    messages=[{"role": "user", "content": "北京今天天气如何?"}]
)
# Claude返回 tool_use content block
Anthropic的独特优势:
- MCP原生支持:Claude Desktop和Claude Code是首批深度集成MCP的产品
- Computer Use工具:屏幕截图+鼠标键盘操作,扩展"工具"的定义边界
- Bash工具:Claude Code内置持久Shell会话,直接执行系统命令
- 工具强制(Tool Forcing):通过tool_choice: {"type": "tool", "name": "xxx"}强制调用特定工具
- 多模态工具输入:工具参数可以包含图像等非文本内容
Gemini 3在2026年引入了Context Circulation(上下文循环)和Tool Combos(工具组合)两项关键能力,使其在混合工具调用场景下表现出色。
# Gemini function calling with built-in + custom tools
import google.generativeai as genai

tools = [
    {"google_search_retrieval": {}},  # 内置Google搜索
    {"google_maps": {}},              # 内置Google Maps
    {
        "function_declarations": [{
            "name": "book_restaurant",
            "description": "在指定位置附近预订餐厅",
            "parameters": {
                "type": "object",
                "properties": {
                    "location": {"type": "string"},
                    "cuisine": {"type": "string"},
                    "party_size": {"type": "integer"}
                },
                "required": ["location"]
            }
        }]
    }
]

model = genai.GenerativeModel('gemini-3-pro', tools=tools)
response = model.generate_content(
    "帮我找一家北京三里屯附近的意大利餐厅,4个人,今晚7点"
)
Gemini的独特优势: - 内置工具混合调用:Google Search、Google Maps等内置工具可与自定义Function无缝组合 - Context Circulation:工具调用的中间结果自动注入后续推理,无需手动管理 - Ground Mode:将函数调用结果与搜索 grounding 结合,增强答案可信度 - Parallel Function Calling:单Turn内支持最多10个并行调用
| 维度 | OpenAI GPT-5.2 | Anthropic Claude Opus 4.6 | Google Gemini 3 Pro |
|---|---|---|---|
| Schema遵从率 | 100%(Constrained Decoding) | ~97%(语义引导) | ~99%(混合模式) |
| BFCL v4得分 | 57.5%(SOTA) | 55.2% | 53.8% |
| 并行调用 | 支持多个 | 支持多个 | 支持最多10个 |
| 内置工具 | 无(纯API) | Computer Use、Bash、MCP | Search、Maps、Code Exec |
| MCP支持 | 社区实现 | 原生集成 | 部分支持 |
| tool_choice粒度 | auto/required/none/指定函数 | auto/any/tool(指定函数) | auto/none/指定函数 |
| 错误恢复 | 需手动实现 | 需手动实现 | Context Circulation辅助 |
| 复杂嵌套参数 | 优秀 | 良好 | 良好 |
| 幻觉率 | 低 | 最低 | 中等 |
| 定价(每百万token) | 较高 | 高 | 中等 |
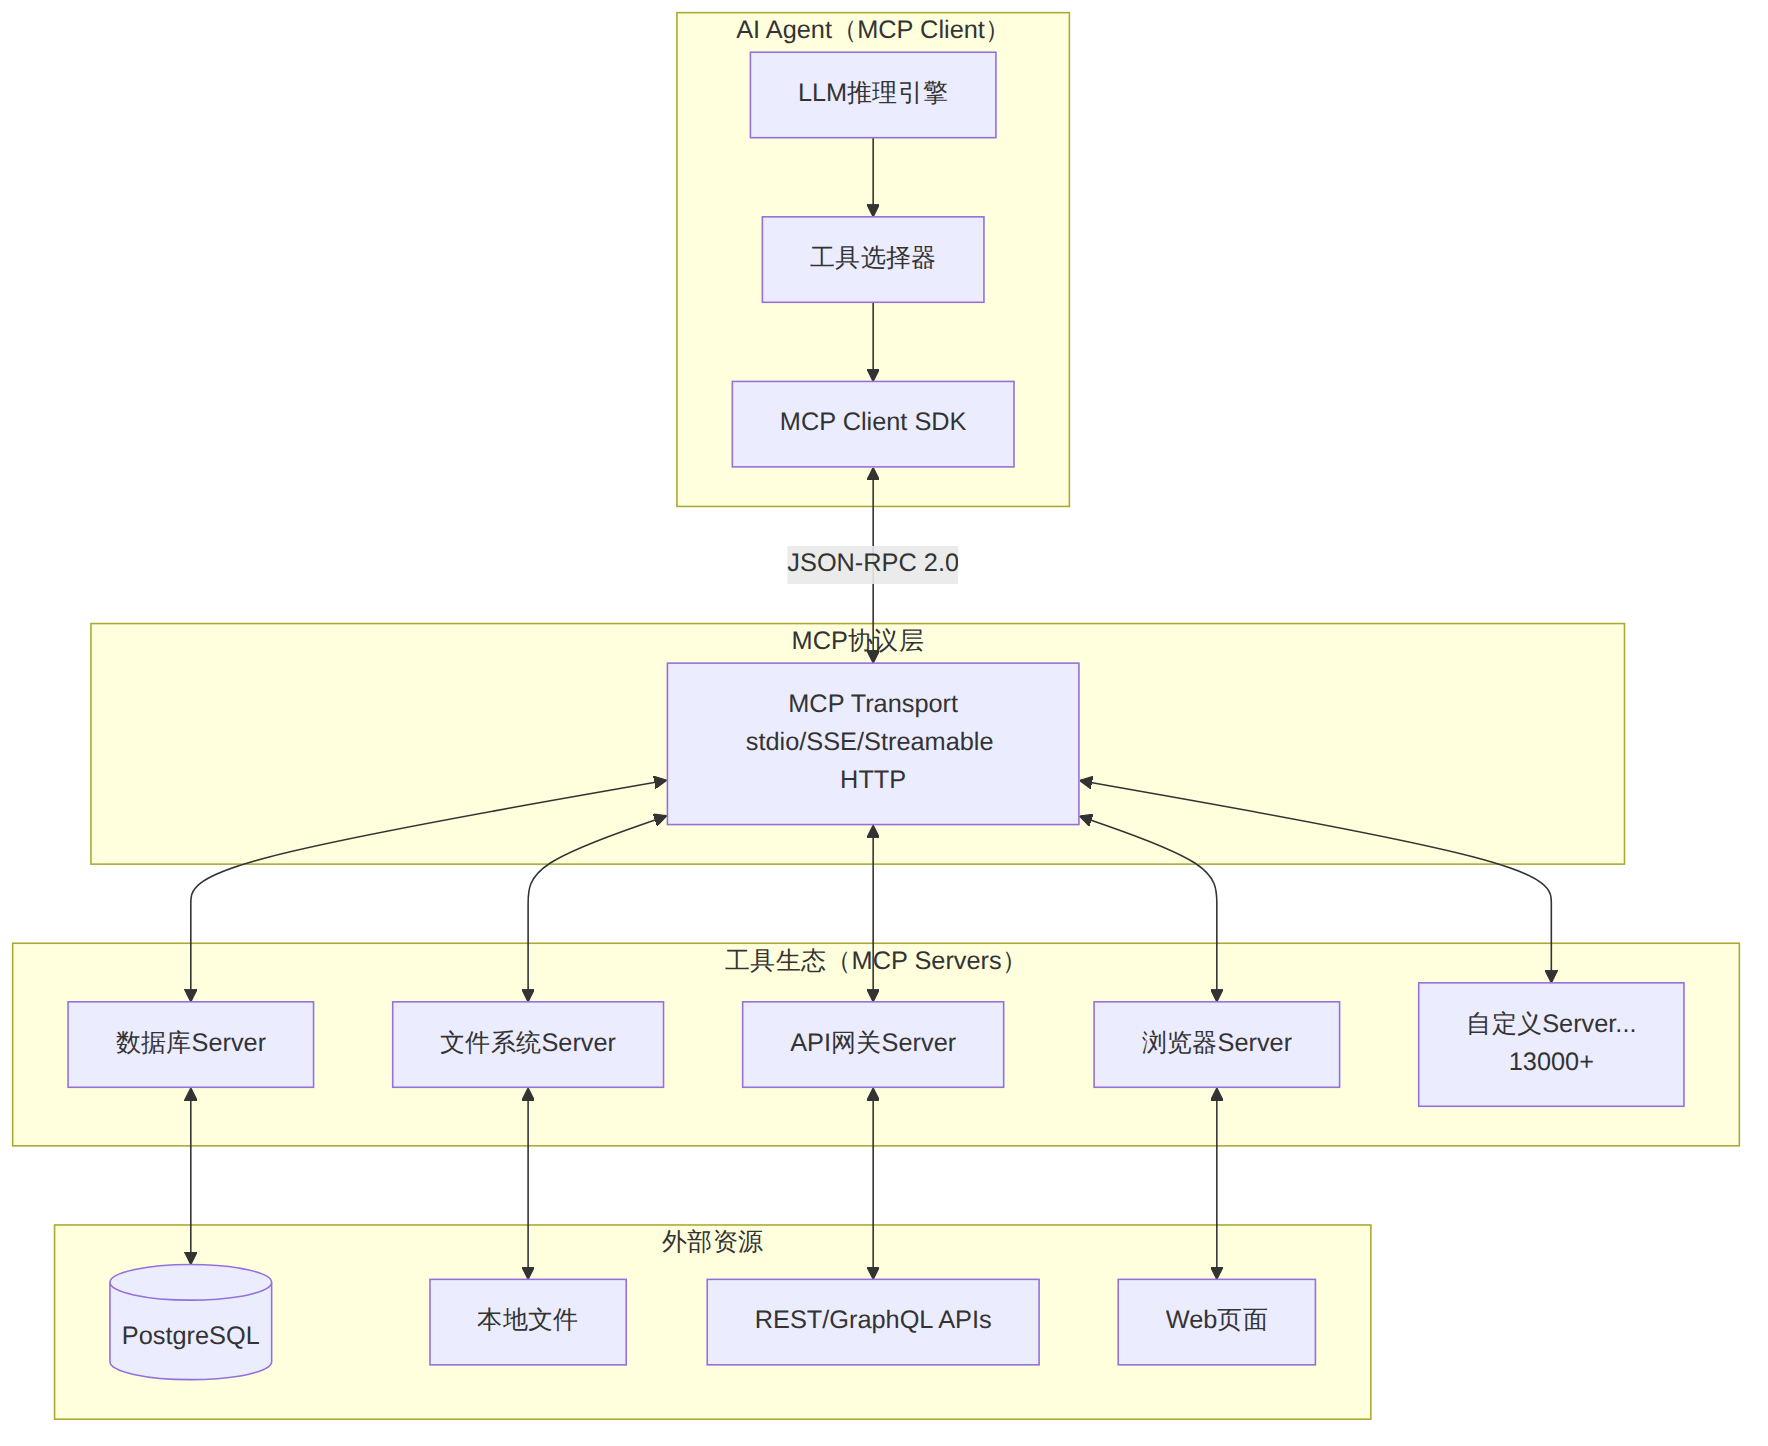
MCP(Model Context Protocol)在2026年经历了指数级增长。从2024年底发布时的0个Server到如今的13,000+个Server实现,月下载量达到9,700万次。MCP已经从"连接AI和工具的协议"进化为"连接Agent和一切的基础设施"。
MCP的核心架构:
图表 1
根据MCP核心维护者发布的2026路线图,三个核心方向值得关注:
方向一:Transport可扩展性 从最初的stdio和SSE传输,2026年MCP引入了Streamable HTTP传输模式,支持有状态连接、长轮询和双向流。这使得MCP Server可以部署在远程服务器而非仅限本地进程。
方向二:Agent-to-Agent通信 MCP正在从"Agent调用工具"扩展到"Agent调用Agent"。2026路线图明确提出MCP将支持Agent注册、发现和交互协议,使其成为多Agent系统的通信基础层。
方向三:治理与安全成熟 随着MCP进入生产环境,认证(OAuth 2.1集成)、授权(细粒度权限控制)和审计日志成为重点。MCP Best Practices文档已提供了12条生产部署规则。
| 维度 | 传统Function Calling | MCP |
|---|---|---|
| 工具定义位置 | 嵌入API请求中 | 独立Server进程 |
| 工具可复用性 | 每次请求重传Schema | Server注册一次,多次复用 |
| 状态管理 | 无状态 | 有状态连接 |
| 工具发现 | 手动枚举 | 动态发现 |
| 跨模型兼容 | 各厂商格式不同 | 统一协议 |
| 部署模式 | 嵌入应用 | 独立部署、可远程 |
| 生态系统 | 各自为政 | 13,000+共享Servers |
MCP并非要取代Function Calling,而是在其之上建立标准化的工具集成层。实际架构中,MCP Server在底层仍然使用各厂商的Function Calling API,但向上提供统一接口。
ReAct(Reasoning + Acting)是工具调用Agent的基础架构模式。其核心循环为:推理(Thought)→ 行动(Action/Tool Call)→ 观察(Observation)→ 再推理。
# ReAct工具调用伪代码
class ReactAgent:
    def run(self, query: str, max_steps: int = 10):
        messages = [{"role": "user", "content": query}]

        for step in range(max_steps):
            # 推理 + 工具选择
            response = llm.chat(
                messages=messages,
                tools=self.available_tools
            )

            # 检查是否需要调用工具
            if response.has_tool_calls:
                for tool_call in response.tool_calls:
                    # 执行工具
                    result = self.execute_tool(tool_call)
                    # 将结果注入上下文
                    messages.append({
                        "role": "tool",
                        "tool_call_id": tool_call.id,
                        "content": str(result)
                    })
            else:
                # 无工具调用 = 最终回答
                return response.content

        return "达到最大步数限制"
变现评估:ReAct模式是所有Agent训练营的必修内容。以"从零实现一个ReAct Agent"为卖点的课程,在Udemy等平台定价$49-99,销量可观。核心卖点在于理解Agent Loop的本质。
对于需要多步骤工具调用的复杂任务,Plan-Execute模式将"规划"和"执行"解耦,提升了工具选择的准确性。
# Plan-Execute 模式
class PlanExecuteAgent:
    def run(self, query: str):
        # 阶段1:规划
        plan = self.planner.invoke(
            f"为以下任务制定工具调用计划:{query}\n"
            f"可用工具:{self.tool_descriptions}"
        )
        # plan = [Step(action="search", params={...}),
        #         Step(action="analyze", params={...}),
        #         Step(action="summarize", params={...})]

        # 阶段2:逐步执行
        results = []
        for step in plan.steps:
            result = self.execute_with_retries(step)
            results.append(result)

            # 阶段3:动态重规划(可选)
            if self.needs_replanning(result, step):
                plan = self.replanner.invoke(
                    current_plan=plan,
                    completed_steps=results,
                    new_context=result
                )

        return self.synthesize(results)
适用场景:数据分析Pipeline、多系统ETL操作、需要跨3个以上工具的业务流程。
2026年出现了一种新趋势——Tool-First设计范式。传统做法是"先写Prompt,再挂工具",Tool-First则是"先设计工具矩阵,再让Agent自适应"。
# Tool-First 设计:工具即接口
tools = [
    MCPTool("postgres://localhost:5432/sales_db"),    # 数据库工具
    MCPTool("filesystem:///data/reports"),              # 文件系统工具
    MCPTool("https://api.slack.com/mcp"),               # Slack工具
    MCPTool("https://analytics.company.com/mcp"),       # 内部分析工具
]

agent = ToolFirstAgent(
    llm="claude-opus-4-6",
    tools=tools,  # 自动发现所有工具的Schema和描述
    max_context_tools=5,  # 每次只加载最相关的5个工具
    tool_selection_strategy="semantic_similarity"  # 语义相似度选择
)
核心思想:Agent不需要预先知道所有工具的使用方法,而是在运行时动态发现和选择工具。MCP的动态发现机制使这种模式成为可能。
工具调用中最被低估的能力是错误恢复。研究表明,生产环境中30-50%的工具调用会因参数错误、超时、权限不足等原因失败。一个健壮的Agent必须具备错误检测和重试能力。
# 生产级工具调用错误恢复
class ResilientToolAgent:
    def execute_with_recovery(self, tool_call, max_retries=3):
        for attempt in range(max_retries):
            try:
                result = self.tool_executor.run(tool_call)

                # 校验结果
                if self.validate(result, tool_call.expected_schema):
                    return result
                else:
                    # 结果不符合预期,让LLM分析并修正
                    correction = self.llm.chat(
                        f"工具调用返回了不符合预期的结果:\n"
                        f"调用:{tool_call}\n"
                        f"结果:{result}\n"
                        f"请修正参数重新调用"
                    )
                    tool_call = self.parse_corrected_call(correction)

            except ToolTimeoutError:
                # 超时:指数退避重试
                time.sleep(2 ** attempt)
            except ToolAuthError:
                # 认证失败:尝试刷新token
                self.refresh_credentials(tool_call.tool_name)
            except ToolNotFoundError:
                # 工具不存在:降级到替代工具
                tool_call = self.find_alternative(tool_call)

        # 所有重试失败:优雅降级
        return self.fallback_response(tool_call)
关键洞察:2026年的生产级Agent中,错误恢复代码的行数往往超过正常调用流程的行数。这是从Demo到Production的关键跨越。
一个常被忽视的问题:给Agent挂载过多工具反而会降低准确率。研究表明,当可用工具超过20个时,BFCL准确率平均下降15-20%。
应对策略: - 动态工具加载:根据用户意图只加载相关工具子集 - 工具分类与层级:按功能域分组,先选域再选工具 - 工具描述优化:精确的description比冗长的Schema更重要 - 语义相似度筛选:用Embedding匹配用户意图与工具描述
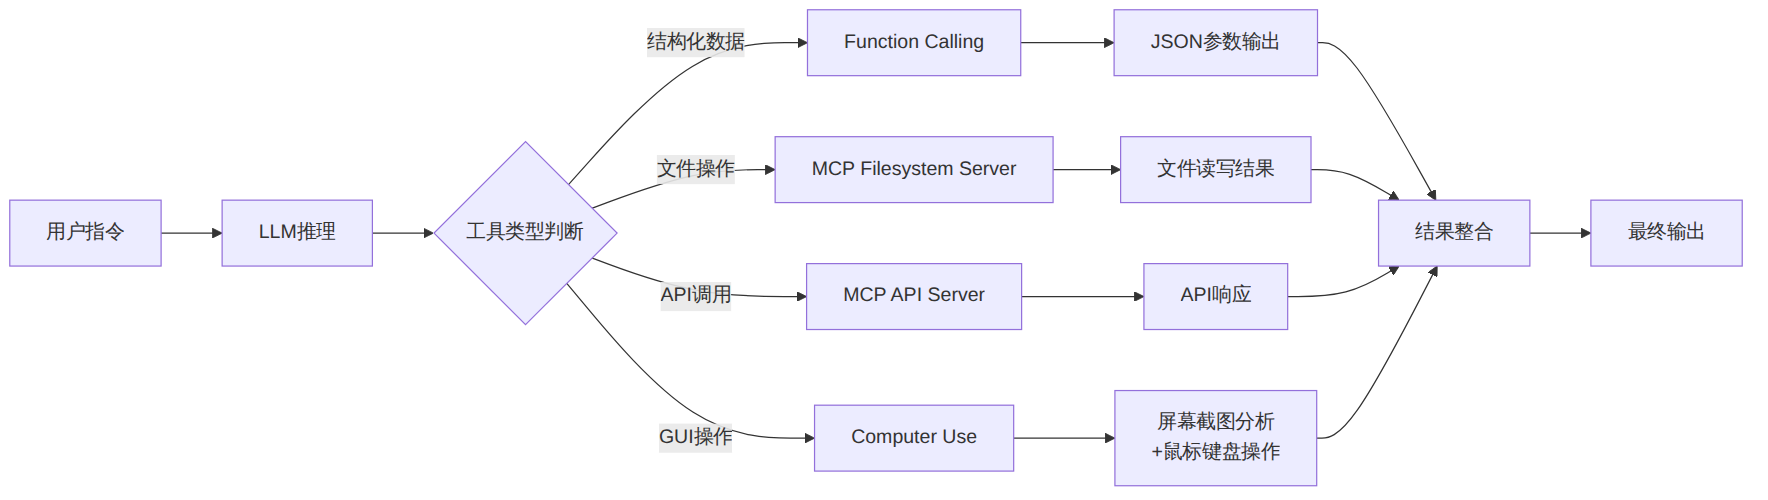
Anthropic的Computer Use代表了工具调用的极端形态——将整个计算机界面作为一个"工具"。2026年,Computer Use从实验功能逐步进入实用阶段,在GUI自动化测试、RPA流程等领域展现出价值。
图表 2
工具调用引入了显著的Token开销。一个典型的工具调用场景中,Token消耗分布如下:
| 组件 | Token占比 | 说明 |
|---|---|---|
| 工具定义(Schema+描述) | 30-40% | 每个工具约100-500 tokens |
| 工具调用历史 | 20-30% | 每次调用+结果约200-1000 tokens |
| 系统Prompt | 10-15% | 工具使用规则和约束 |
| 用户输入 | 5-10% | 实际查询 |
| 推理输出 | 10-15% | Agent的思维链 |
优化策略: - 精简工具描述,去除冗余信息 - 使用MCP按需加载工具(而非全量注入) - 对历史调用结果进行摘要(而非保留原文) - 使用更便宜的模型处理简单工具路由
在多模型环境中(如主模型+备用模型),工具调用的兼容性是一个实际痛点:
| 差异点 | OpenAI | Anthropic | |
|---|---|---|---|
| 参数格式 | parameters |
input_schema |
parameters |
| 调用触发 | tool_calls in message |
tool_use content block |
functionCall in parts |
| 结果格式 | role: "tool" message |
tool_result content block |
functionResponse in parts |
| 严格模式 | strict: true |
无 | specifiedSchema mode |
| 流式支持 | 支持 | 支持 | 支持 |
解决方案:使用LiteLLM、Portkey等统一网关层,将差异化的工具调用格式统一为标准接口。这层抽象在2026年的生产系统中已成为标配。
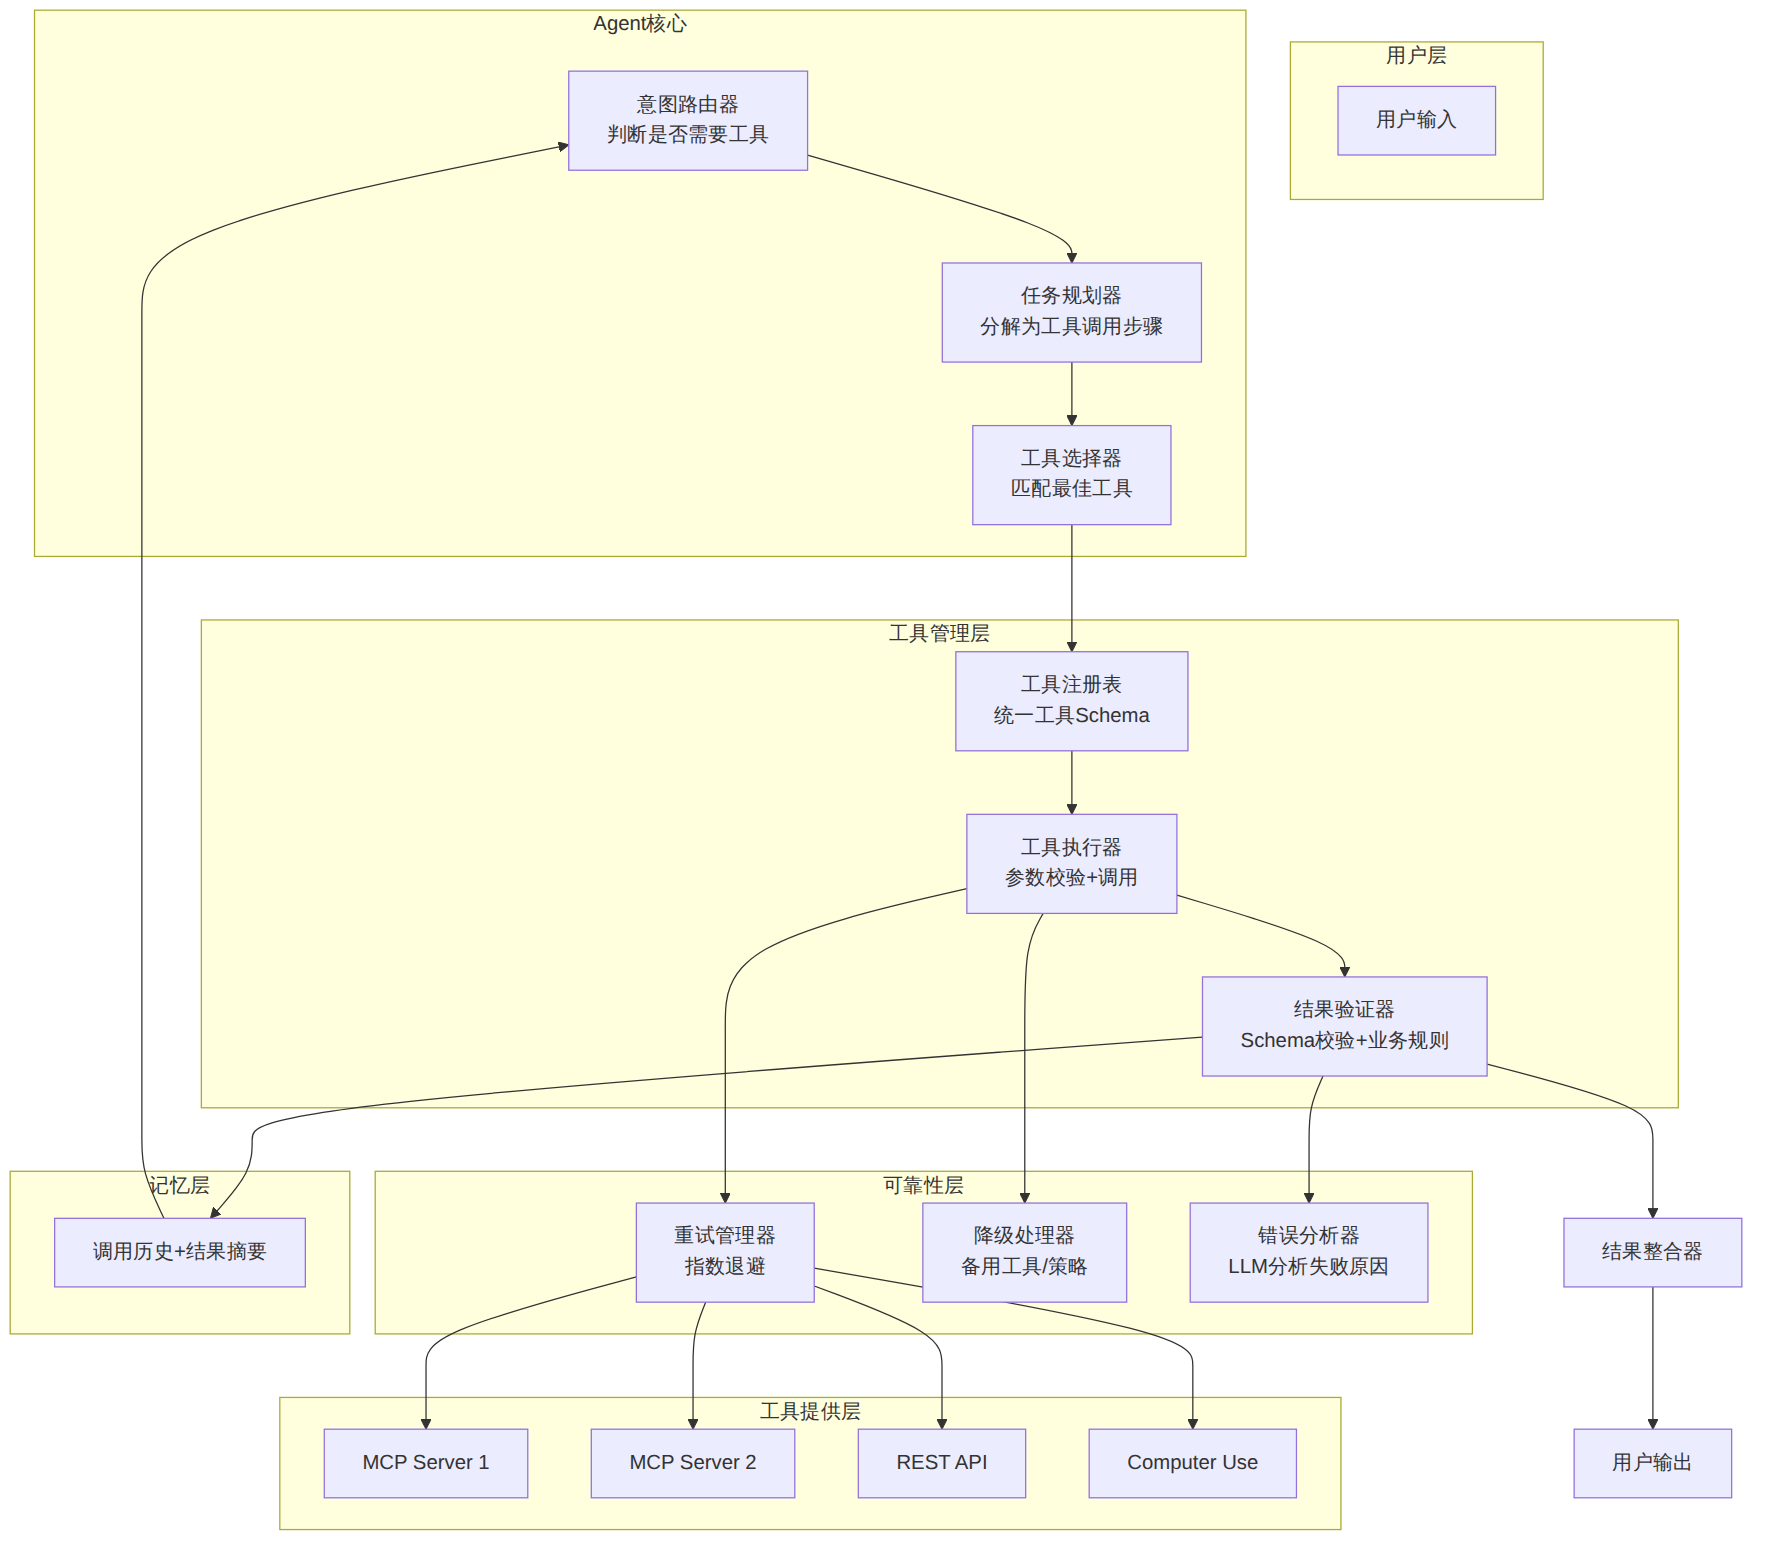
一个完整的、生产级的工具调用Agent架构:
图表 3
推荐:OpenAI Function Calling + Structured Outputs - 理由:100% Schema遵从,开发成本最低 - 适合:Hackathon、Demo演示、内部工具 - 成本:中等,但开发速度快
推荐:Anthropic Claude + MCP原生 - 理由:MCP原生支持,13,000+现成Server可用 - 适合:需要对接多种外部系统的Agent - 成本:初期搭建成本高,长期维护成本低
推荐:Google Gemini + Tool Combos - 理由:内置Google Search/Maps与自定义Function无缝组合 - 适合:地理位置相关、信息检索类的Agent应用 - 成本:Gemini定价较低,适合大规模调用
推荐:多模型网关 + 自定义错误恢复层 - 理由:任何单一模型的工具调用准确率都未达到生产级(>95%) - 架构:LiteLLM/Portkey网关 + GPT-5.2主模型 + Claude备用 + 自定义重试逻辑 - 适合:金融交易、医疗诊断等容错率极低的场景
推荐:Anthropic Computer Use + MCP - 理由:Computer Use是目前最成熟的GUI Agent方案 - 适合:自动化测试、遗留系统集成、桌面应用自动化 - 注意:延迟较高(每次截图+推理约3-5秒),不适合实时场景
2026年下半年,工具调用能力将沿着三个方向继续演进:
方向一:从被动调用到主动发现。当前Agent只能使用预定义的工具列表。未来的Agent将能够在运行时发现新工具(通过MCP动态发现、API文档自动解析),甚至自动学习工具的使用方法。MCP的Agent-to-Agent通信路线图正是这一趋势的体现。
方向二:从单次调用到工作流编排。工具调用不再是一次性的"请求-响应",而是嵌入到复杂工作流中。DAG(有向无环图)编排、条件分支、并行执行等工作流原语正在与工具调用深度融合。
方向三:从"能用"到"可靠"。57.5%的BFCL v4 SOTA准确率意味着将近一半的复杂工具调用是错误的。提升可靠性——通过更好的Prompt Engineering、Constrained Decoding、自纠正循环、形式化验证——将成为2026年下半年的核心竞争战场。
工具调用是AI Agent从"聊天机器人"进化为"数字员工"的关键桥梁。这座桥的建设,才刚刚开始。
[!tip] 51学通信知识星球 星主:爱卫生(微信:gprshome201101)——公众号「51学通信」创办者,19 年通信行业运维与讲师经验,著有《GPRS网络信令实例详解》《EPC原理与实践》《5G核心网原理与实践》三本纸质书(各大电商平台有售)。 星球定位:深耕 5G 核心网、IMS、NFV/AI、云原生等 ICT 领域,主打运维岗位与信令分析。 当前规模:5200 篇主题 / 990 个回答,198 元/年。 加入福利:加入星球后请加爱卫生微信,拉您进知识星球年度陪伴与答疑群——不限量回复您的各种问题,另有群内分享。 AI 加持:51学通信知识星球已作为 skill 接入 WorkBuddy,使用 deepseek-4-flash 在海量星球帖子中精准找贴、找视频、找 FAQ 和案例,做总结、找文档和 PPT 等场景全覆盖。
