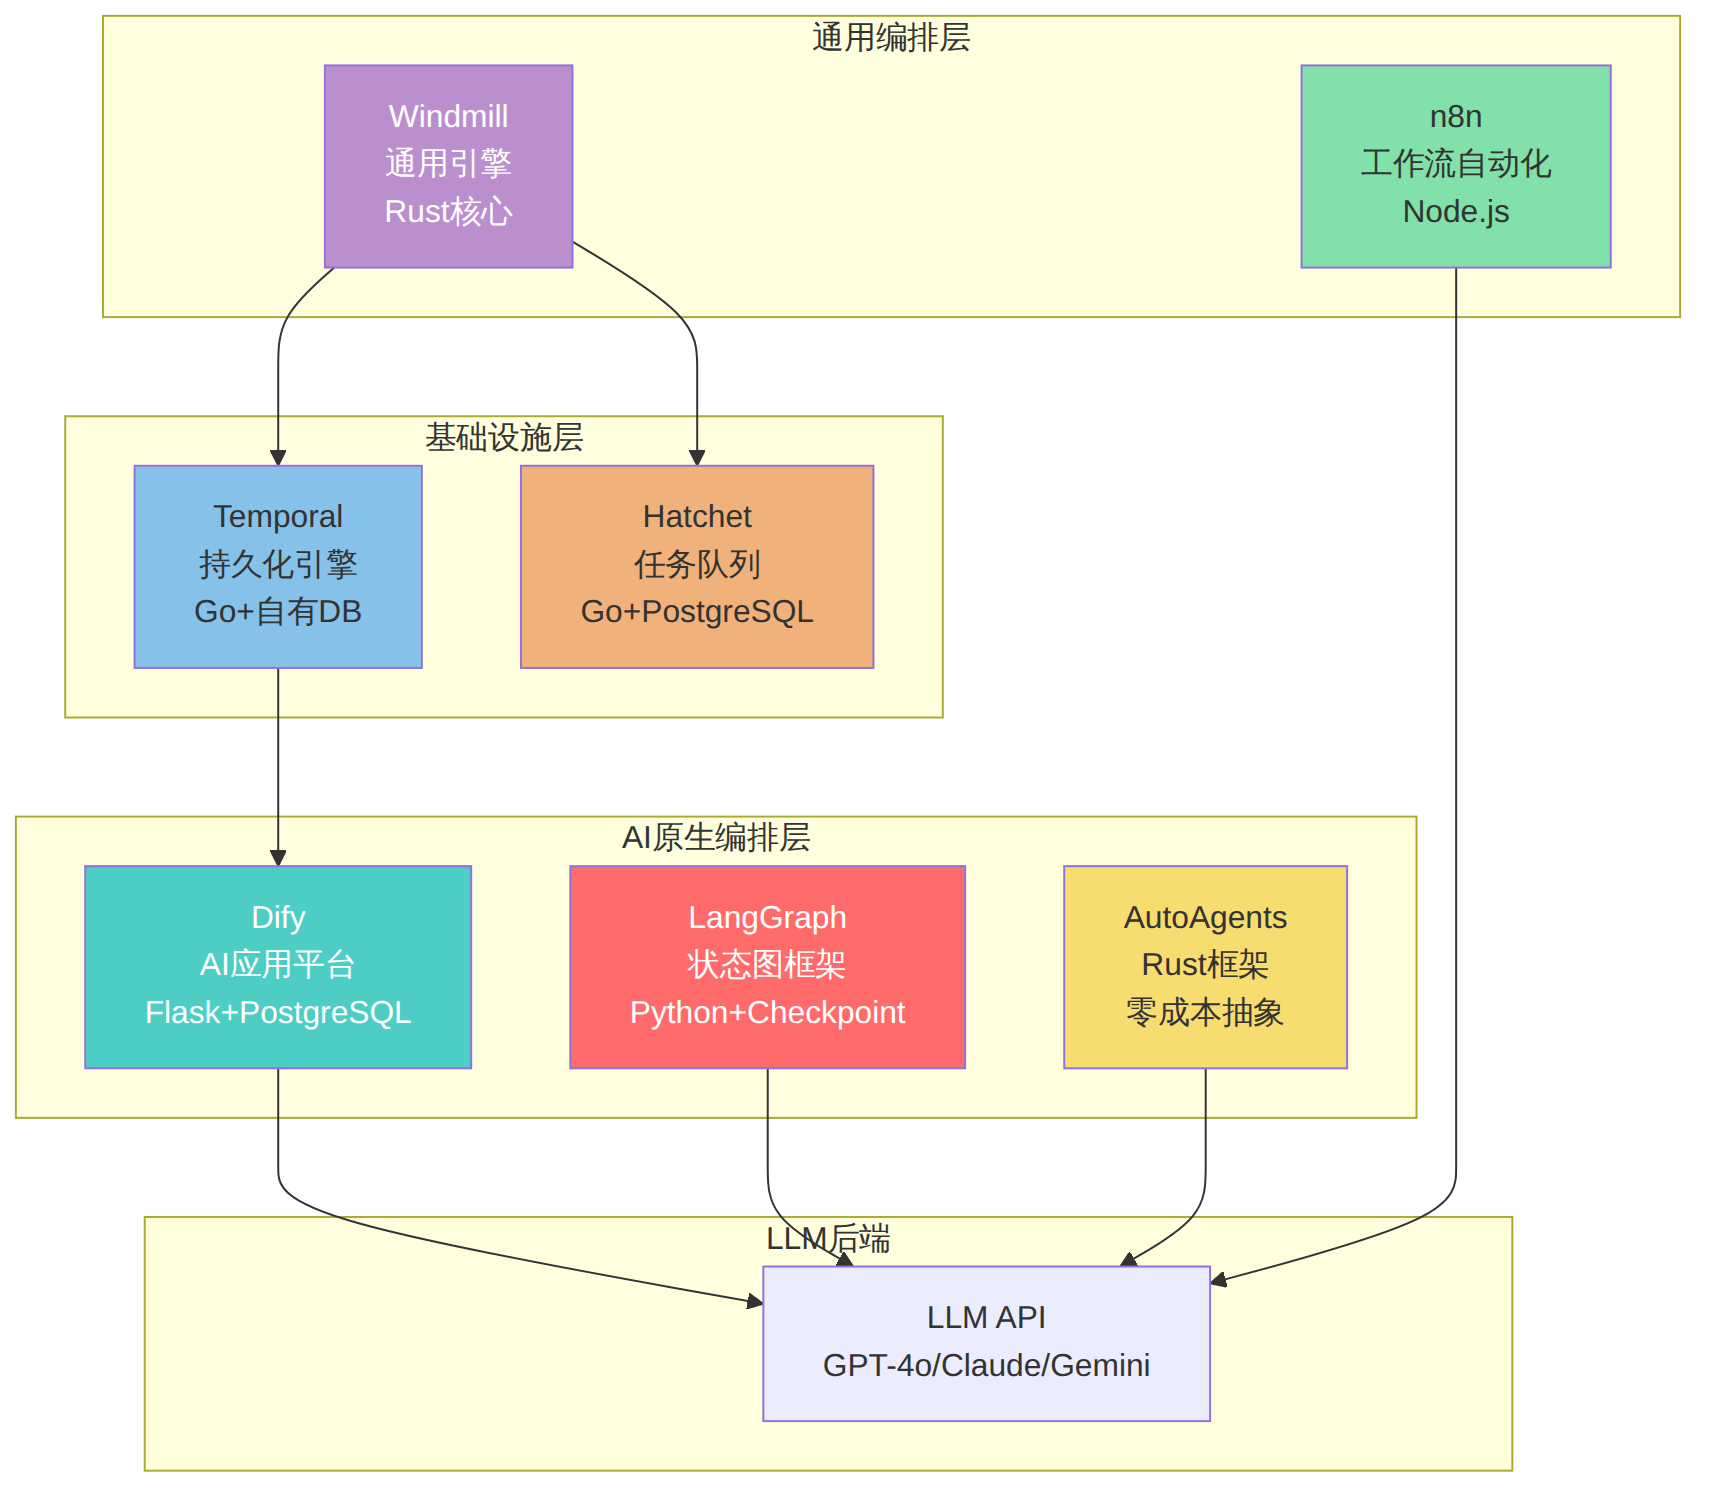
当Agent从原型走向生产,工作流编排引擎的延迟和吞吐量直接决定用户体验和成本结构。2026年Q1-Q2,多份独立基准测试揭示了残酷现实:LangGraph每步推理额外增加约10155ms框架开销,Windmill以13倍Airflow吞吐量领先通用编排引擎,而基于Rust的AutoAgents框架在并发测试中将Python对手甩开一个数量级。本文以实测数据为核心,横评Dify、n8n、Windmill、Temporal、Hatchet、LangGraph、AutoAgents七款主流Agent编排引擎的延迟、吞吐量、资源消耗和可靠性,为生产选型提供量化依据。
| 维度 | Dify | n8n | Windmill | Temporal | Hatchet | LangGraph | AutoAgents(Rust) |
|---|---|---|---|---|---|---|---|
| 定位 | AI应用开发平台 | 通用工作流自动化 | 通用编排引擎(Rust) | 持久化工作流引擎 | 低延迟任务队列 | Agent状态图框架 | Agent框架(Rust) |
| 语言 | Python(Flask) | Node.js(TypeScript) | Rust + 多语言Worker | Go + 多语言SDK | Go | Python | Rust |
| GitHub Stars | 90k+ | 60k+ | 12k+ | 72k+ | 5k+ | 20k+ | 3k+ |
| 单实例吞吐 | ~50 RPS(3副本) | 220 exec/s | 13× Airflow | 高(分布式扩展) | 100-2000 evt/s | 受LLM限制 | 显著领先Python |
| 启动延迟 | 中等(Flask开销) | 低 | 极低(Rust) | 低(Go) | 25ms avg | 高(10s+/步) | 极低(Rust) |
| 持久化 | PostgreSQL+Redis | SQLite/PostgreSQL | PostgreSQL | 自有DB | PostgreSQL | 可选(checkpoint) | 内存为主 |
| AI原生度 | ★★★★★ | ★★★☆ | ★★☆ | ★★ | ★★★ | ★★★★★ | ★★★★ |
| 开源协议 | Apache 2.0(有限制) | Fair-code | Apache 2.0 | MIT | MIT | MIT | Apache 2.0 |
Windmill用Rust编写核心调度器,在官方和第三方基准测试中均展现出碾压级吞吐量。其官方benchmark对比了Airflow、Prefect、Temporal、Kestra和Hatchet六款引擎,测试了两种典型场景:10步顺序长任务和扇入扇出并行任务。
实测数据: - Windmill吞吐量约为Airflow的13倍 - 在轻量级任务场景中,Windmill-dedicated、Hatchet和Temporal位列前三 - Python Worker场景下,Windmill和Temporal表现接近,但Windmill调度开销更低 - 并行任务中Windmill优势最为显著,得益于Rust运行时的零成本抽象
# Windmill多语言Worker示例(Python)
import requests

def main(url: str, method: str = "GET"):
    # Windmill将脚本直接转化为可编排的Flow
    response = requests.request(method, url)
    return {"status": response.status_code, "body": response.text[:500]}
优点:Rust核心带来极致吞吐;脚本即Flow的设计降低迁移成本;多语言支持(Python/Go/TS/Bash/Deno)
缺点:AI场景需要自行集成LLM调用;社区生态相对年轻;视觉编辑器不如n8n直观
变现评估:适合做「高性能AI Agent基础设施」训练营,突出Rust+AI的差异化定位
n8n以Node.js/TypeScript构建,官方文档明确标注单实例可达220 workflow executions/秒。它并非AI原生平台,但2025-2026年新增的AI Agent节点使其成为Agent编排的有力竞争者。
实测数据: - 单实例(4CPU/8GB):220 workflow exec/s - 支持Queue Mode水平扩展,理论上无限扩展 - 400+集成连接器覆盖主流SaaS - AI节点延迟主要来自LLM API调用本身,编排层开销约50-100ms
// n8n AI Agent节点配置示例
{
  "operation": "runAgent",
  "model": "gpt-4o",
  "tools": ["serpapi", "calculator", "http_request"],
  "memory": "bufferWindow",
  "maxIterations": 5
}
优点:视觉编辑器降低上手门槛;丰富的集成生态;Queue Mode支持生产扩展
缺点:AI场景下无原生RAG管道;高并发时Node.js单线程瓶颈显现;内存消耗随并发线性增长
变现评估:适合「AI自动化工作流」训练营,因学习曲线平滑,转化率高
Dify是目前最AI原生的编排平台,GitHub 90k+ Stars说明社区热度。但生产环境中,Flask同步请求处理模型成为显著瓶颈。Dify v3.9.0的官方benchmark报告显示,3副本API服务(每副本1CPU/2GB)在简单工作流(仅Start→End)场景下吞吐量有限。
实测数据: - 3副本部署:约50 RPS(简单工作流) - 含LLM节点的复杂工作流:~5-15 RPS - 并发请求时线程模型导致性能急剧下降 - 阿里云Higress网关集成后,吞吐提升42%,LLM调用延迟降低31%(来自阿里云实践报告) - Dify 2026增强版在多LLM协同场景下,压测显示吞吐提升42%
关键瓶颈:每个工作流节点都与数据库交互,缓存缺失时延迟叠加严重。GitHub Issue #23598提出的工作流缓存优化方案可减少30%+数据库交互。
# Dify Kubernetes生产部署资源建议
api-service:
  replicas: 3
  resources:
    requests: { cpu: "1", memory: "2Gi" }
    limits: { cpu: "2", memory: "4Gi" }
worker:
  replicas: 2  # 异步任务执行器
  resources:
    requests: { cpu: "2", memory: "4Gi" }
优点:开箱即用的RAG管道和Agent模式;可视化Prompt IDE;企业级功能完备
缺点:Flask同步架构在高并发下表现不佳;每个节点一次DB查询的设计需要重构
变现评估:最适合做「企业AI应用开发」训练营,因为从0到可演示AI应用最快
Temporal用Go编写,专为长时运行的持久化工作流设计。它不是AI原生框架,但其强一致性保证和故障恢复能力使其成为需要高可靠Agent编排场景的首选底座。
实测数据: - 在Windmill基准测试中,Temporal位列吞吐第一梯队 - 工作流状态持久化到自有数据库,故障恢复零丢失 - Worker可水平扩展,单Worker支持数千并发工作流执行 - 调度延迟:~10-50ms(不含业务逻辑)
// Temporal Go SDK工作流示例
func AgentWorkflow(ctx workflow.Context, query string) (string, error) {
    ao := workflow.ActivityOptions{
        StartToCloseTimeout: time.Minute,
    }
    ctx = workflow.WithActivityOptions(ctx, ao)

    // Step 1: 搜索
    var searchResult string
    err := workflow.ExecuteActivity(ctx, SearchActivity, query).Get(ctx, &searchResult)

    // Step 2: LLM推理(可设置长超时)
    var llmResult string
    err = workflow.ExecuteActivity(ctx, LLMInferenceActivity, searchResult).Get(ctx, &llmResult)

    return llmResult, err
}
优点:强一致性+故障恢复;类型安全的多语言SDK;无限水平扩展
缺点:学习曲线陡峭;需部署独立集群;不提供可视化编辑器
变现评估:适合面向「企业级Agent基础设施」的高级培训,客单价可定高
Hatchet定位为「低延迟任务队列+工作流引擎」,用Go构建,基于PostgreSQL。其核心卖点是极低的任务启动延迟。
实测数据: - 平均启动延迟:25ms - 低负载(100-500 events/sec):延迟保持低位 - 中等负载(~2000 events/sec):平均执行时间开始增长 - 高负载:需要调优数据库实例(建议4CPU/8GB+) - 在Windmill对比测试中,Hatchet与Temporal、Windmill位列前三
# Hatchet性能调优参数
DATABASE:
  max_connections: 50
  connection_timeout: 5s
WORKER:
  max_concurrent: 100
  poll_interval: 25ms
优点:极低启动延迟;PostgreSQL单依赖部署简单;原生支持AI Agent工作流
缺点:高并发下依赖PostgreSQL性能;社区规模较小;可视化工具有限
变现评估:适合做「快速构建低延迟AI Agent」技术分享,吸引追求性能的工程师群体
LangGraph是LangChain生态的Agent编排框架,以有向图建模Agent状态转换。2026年多份独立测试揭示了其显著的框架开销。
实测数据: - AutoAgents基准测试:LangGraph单任务平均10,155ms(含框架编排开销) - Q3 2026行业平均:Agent框架每步推理额外增加~470ms延迟 - LangGraph相对开销较高,主要来自状态管理和checkpoint机制 - 但token效率表现优秀:$41.70/1000 GPT-4o任务(同类最低) - CrewAI在部分测试中快40%,但灵活性和状态管理不如LangGraph
from langgraph.graph import StateGraph, END

# LangGraph状态图定义
workflow = StateGraph(AgentState)
workflow.add_node("planner", plan_step)
workflow.add_node("executor", execute_step)
workflow.add_node("reviewer", review_step)

workflow.add_edge("planner", "executor")
workflow.add_conditional_edges("executor", should_continue,
    {"continue": "planner", "end": "reviewer"})
workflow.add_edge("reviewer", END)

app = workflow.compile(checkpointer=SqliteSaver.from_conn_string(":memory:"))
优点:灵活的状态图模型;丰富的checkpoint和时间旅行调试;LangChain生态无缝集成
缺点:框架开销最高(10s+/任务);Python性能天花板;生产部署需要Redis/Celery等外挂
变现评估:适合做「LangGraph高级Agent开发」课程,市场需求大但竞争也激烈
AutoAgents是基于Rust的Agent框架,2026年2月的一份独立基准测试引发关注。在标准化测试中,AutoAgents以显著优势超越所有Python框架。
实测数据: - 基准测试中AutoAgents延迟最低 - GraphBit: 8,425ms / LangGraph: 10,155ms / AutoAgents: 显著更低 - Rust零成本抽象消除了Python的GIL和解释器开销 - 并发场景下优势进一步放大 - Token效率与Python框架持平(LLM调用成本不受框架影响)
// AutoAgents Rust示例
use autoagents::{Agent, Tool, Router};

#[tokio::main]
async fn main() {
    let agent = Agent::new("research-agent")
        .with_model("gpt-4o")
        .with_tools(vec![
            Tool::web_search(),
            Tool::code_interpreter(),
        ])
        .with_max_iterations(5);

    let result = agent.run("分析2026年AI Agent市场趋势").await;
    println!("{}", result.output);
}
优点:极致性能;内存安全;并发无锁
缺点:Rust学习曲线陡峭;生态远不如Python丰富;目前处于早期阶段
变现评估:适合做「Rust+AI」前沿技术分享,作为差异化内容吸引高级工程师
图表 1
graph LR
    Q1{需求类型?}
    Q1 -->|AI应用快速开发| DIFY[Dify]
    Q1 -->|通用自动化+AI| N8N[n8n]
    Q1 -->|高性能计算编排| WM[Windmill]
    Q1 -->|长时运行+高可靠| TMP[Temporal]
    Q1 -->|低延迟任务队列| HTC[Hatchet]
    Q1 -->|灵活Agent逻辑| LG[LangGraph]
    Q1 -->|极致性能| AA[AutoAgents]

    Q2{延迟预算?}
    Q2 -->|<100ms| HTC
    Q2 -->|100ms-1s| WM & TMP
    Q2 -->|">1s(可接受)"| DIFY & LG

    Q3{并发规模?}
    Q3 -->|<50 RPS| DIFY
    Q3 -->|50-500 RPS| N8N & WM
    Q3 -->|>500 RPS| TMP & WM
| 性能指标 | Dify | n8n | Windmill | Temporal | Hatchet | LangGraph | AutoAgents |
|---|---|---|---|---|---|---|---|
| 编排层延迟 | 200-500ms | 50-100ms | 10-30ms | 10-50ms | 25ms | 500-1000ms | <10ms |
| 单实例吞吐 | ~50 RPS | 220/s | 13× Airflow | 高(分布式) | 2000 evt/s | 受LLM限制 | 显著领先 |
| LLM调用效率 | 原生优化 | 通过节点 | 需自建 | 需自建 | 原生支持 | $41.7/1k任务 | 持平 |
| 故障恢复 | 有限 | 基础 | 重试机制 | ★★★★★ | 重试+DLQ | Checkpoint | 基础 |
| 水平扩展 | K8s副本 | Queue Mode | 原生支持 | 原生支持 | PostgreSQL依赖 | 外挂Redis | 原生 |
| 资源消耗 | 中等 | 低 | 极低 | 中等 | 低 | 高(Python) | 极低(Rust) |
| 上手时间 | 1-2小时 | 2-4小时 | 4-8小时 | 1-2天 | 2-4小时 | 4-8小时 | 1-2天 |
发现一:框架开销不容忽视。 Q3 2026行业数据显示,Agent框架平均每步推理额外增加470ms延迟。LangGraph在独立测试中达到10155ms/任务,这意味着在LLM调用延迟(通常1-5秒)之上,框架本身可能再增加等量的延迟。对实时交互场景(客服、对话),这个开销不可接受。
发现二:AI原生 ≠ 生产就绪。 Dify在AI功能完备性上领先,但Flask同步架构成为生产瓶颈。阿里云Higress网关集成实践表明,通过增加API网关层缓存和限流,可提升42%吞吐,但这本质是在弥补Dify架构缺陷。如果并发需求>100 RPS,建议用Temporal/Windmill做底层编排,Dify仅负责Prompt和Agent逻辑。
发现三:Rust正在重塑Agent基础设施。 Windmill和AutoAgents两款Rust引擎在吞吐量上对Python/Node.js对手形成降维打击。AutoAgents的独立基准测试结果尤其引人注目——在同等LLM调用成本下,Rust框架几乎消除了编排层开销。2026年Q2,Rust在Agent基础设施领域的采用正在加速。
发现四:Hatchet填补了Temporal和简单队列之间的空白。 25ms启动延迟、PostgreSQL单依赖、原生AI Agent支持,使Hatchet成为不需要Temporal完整能力但追求低延迟场景的理想选择。从100到2000 events/sec的弹性伸缩能力覆盖了大部分中等规模需求。
| 场景 | 推荐引擎 | 理由 |
|---|---|---|
| 企业AI客服/知识库 | Dify + Higress网关 | 开箱即用RAG,网关解决并发 |
| DevOps自动化Agent | n8n | 400+集成连接器,视觉编排 |
| 数据处理Pipeline+AI | Windmill | Rust吞吐优势,多语言Worker |
| 金融/医疗高可靠Agent | Temporal | 强一致性+故障恢复零丢失 |
| 实时推荐/搜索Agent | Hatchet | 25ms启动延迟,低延迟队列 |
| 研究型多步推理Agent | LangGraph | 灵活状态图+时间旅行调试 |
| 高频交易/边缘AI | AutoAgents(Rust) | 极致性能+内存安全 |
| 快速原型验证 | Dify/Flowise | 从0到演示最快1小时 |
Token消耗是Agent运营成本的核心变量。根据2026年多源测试数据:
真正的成本优化不在框架选择,而在: 1. 缓存策略(减少重复LLM调用) 2. 模型路由(简单任务用小模型) 3. 提前终止(避免无效推理步骤)
[!tip] 51学通信知识星球 星主:爱卫生(微信:gprshome201101)——公众号「51学通信」创办者,19 年通信行业运维与讲师经验,著有《GPRS网络信令实例详解》《EPC原理与实践》《5G核心网原理与实践》三本纸质书(各大电商平台有售)。 星球定位:深耕 5G 核心网、IMS、NFV/AI、云原生等 ICT 领域,主打运维岗位与信令分析。 当前规模:5200 篇主题 / 990 个回答,198 元/年。 加入福利:加入星球后请加爱卫生微信,拉您进知识星球年度陪伴与答疑群——不限量回复您的各种问题,另有群内分享。 AI 加持:51学通信知识星球已作为 skill 接入 WorkBuddy,使用 deepseek-4-flash 在海量星球帖子中精准找贴、找视频、找 FAQ 和案例,做总结、找文档和 PPT 等场景全覆盖。
