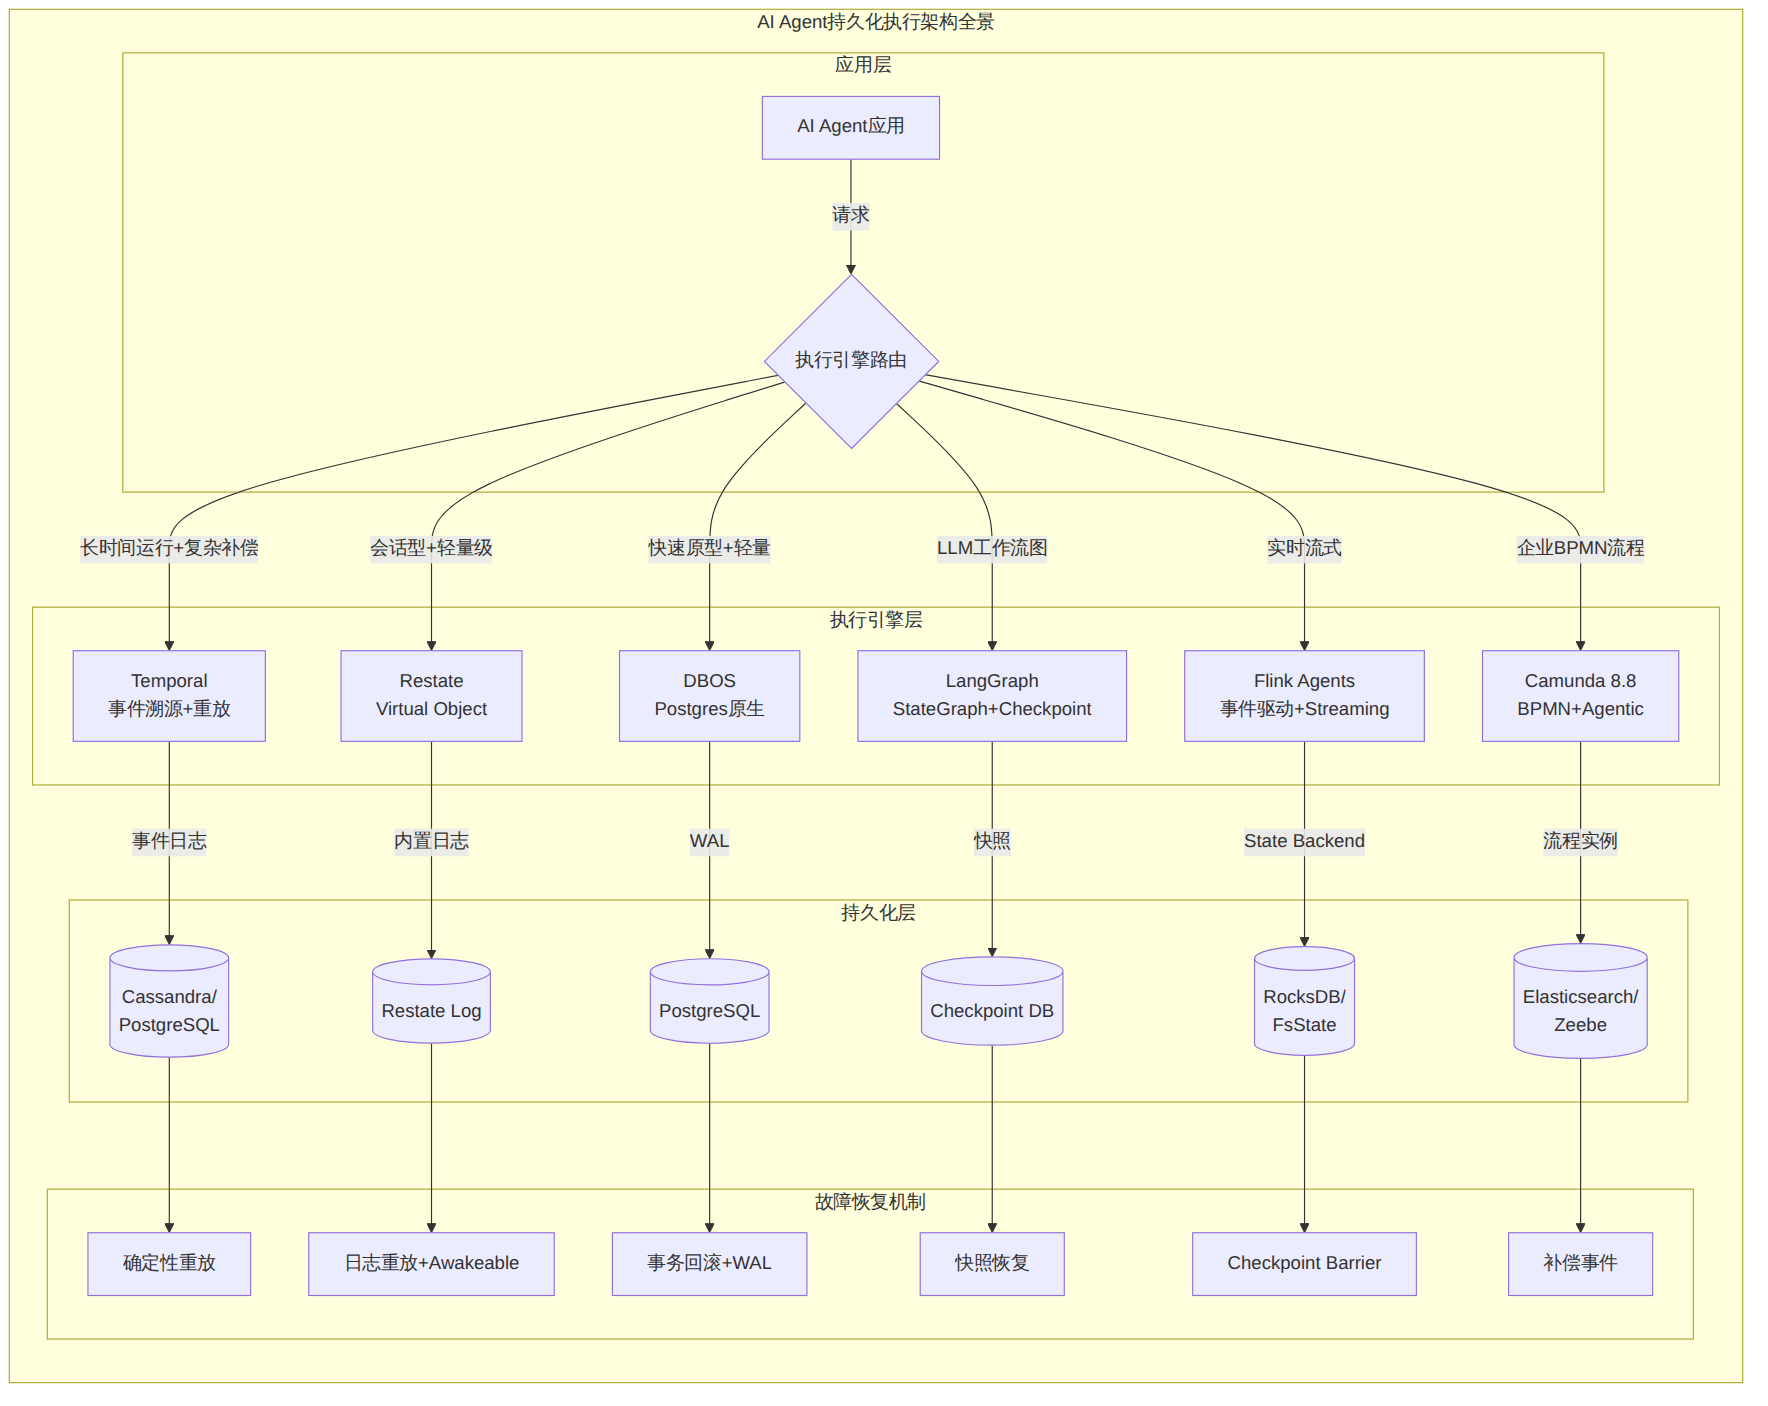
当AI智能体从Demo走向生产环境,最大的敌人不是模型幻觉——而是进程崩溃、网络超时、LLM API限流、状态丢失。一个需要30分钟完成的多步骤Agent任务,如果执行到第8步时服务器重启,没有持久化执行保障就只能从头再来。2025-2026年,一股"持久化执行"(Durable Execution)浪潮正席卷AI Agent基础设施层:Temporal、Restate、DBOS、LangGraph Checkpointing、Apache Flink Agents、Camunda 8.8——六大引擎从不同技术路线切入同一个核心问题:如何让AI Agent在任意故障下安全恢复、精确继续。本文深入剖析六大方案的架构原理、代码模式与适用场景,帮助开发者选择最适合的Agent容错基础设施。
传统Agent框架(LangChain、CrewAI)把重点放在Prompt编排和工具调用上,对执行可靠性几乎不做假设——一旦LLM调用超时或Agent进程崩溃,整个工作流就会中断。在生产环境中,这种脆弱性不可接受。持久化执行引擎解决的核心问题:
| 维度 | Temporal | Restate | DBOS | LangGraph Checkpoint | Flink Agents | Camunda 8.8 |
|---|---|---|---|---|---|---|
| 核心模型 | 工作流+Activity | Virtual Object+Workflow | Durable Function | StateGraph+Checkpoint | Event-driven Agent | BPMN+Agentic |
| 持久化后端 | 自有数据库 | 内置日志存储 | PostgreSQL | SQLite/Postgres/Memory | Flink State Backend | Elasticsearch/DB |
| 语言支持 | Go/TS/Python/Java | TypeScript/Kotlin | Python/TypeScript | Python/JS | Python/Java | Java/REST |
| 故障恢复 | 事件溯源+重放 | 日志+确定性重放 | Postgres事务+WAL | Checkpoint快照 | Checkpoint+Exactly-once | BPMN恢复+补偿 |
| 并发控制 | 工作流隔离 | Virtual Object单线程 | Postgres锁 | 图节点串行 | 并行算子 | BPMN网关 |
| Human-in-loop | Signal+Query | Awakeable | 暂停/恢复 | interrupt() | 异步 | User Task |
| 学习曲线 | 高 | 中 | 低 | 中 | 高 | 高 |
| 运维复杂度 | 需独立集群 | 轻量单进程 | 仅需Postgres | 依赖LangChain | 需Flink集群 | 需Zeebe引擎 |
| Star/社区 | 13k+ ⭐ | 1.3k+ ⭐ | 800+ ⭐ | 10k+ ⭐(LangGraph) | 孵化中 | 3.5k+ ⭐ |
| 适用场景 | 企业级长任务 | 会话型Agent | 轻量Agent任务 | LLM工作流 | 流式实时Agent | 传统流程+AI |
Temporal起源于Uber内部的Cadence项目,由Cadence原作者团队创建。它采用事件溯源+确定性重放架构:工作流的每一步操作(定时器、活动调用、信号接收)都被记录为不可变事件,当工作流需要恢复时,引擎从头重放事件日志直到崩溃点,然后精确继续执行。
对于AI Agent场景,Temporal的核心优势是Activity的无限重试和超时控制。一个调用GPT-4的Activity可以配置指数退避重试策略,在API限流时自动等待重试:
@activity.defn
async def call_llm(prompt: str) -> str:
    response = await openai.chat.completions.create(
        model="gpt-4", messages=[{"role": "user", "content": prompt}]
    )
    return response.choices[0].message.content

@workflow.defn
class ResearchAgentWorkflow:
    @workflow.run
    async def run(self, topic: str) -> str:
        # Step 1: 搜索 - 自动持久化,崩溃后从此处恢复
        search_results = await workflow.execute_activity(
            call_llm, f"搜索关于{topic}的最新资料",
            start_to_close_timeout=timedelta(seconds=30),
            retry_policy=RetryPolicy(
                maximum_attempts=5,
                initial_interval=timedelta(seconds=1),
                backoff_coefficient=2.0,
            ),
        )
        # Step 2: 分析
        analysis = await workflow.execute_activity(
            call_llm, f"分析以下搜索结果:{search_results}",
            start_to_close_timeout=timedelta(minutes=2),
        )
        # Step 3: 人工审核 - 暂停等待外部Signal
        await workflow.wait_condition(lambda: self._approved is not None)
        if not self._approved:
            return "用户拒绝了报告"
        return analysis
优点:久经生产验证(Uber、Snap、Coinbase都在用);完善的重试、超时、补偿机制;多语言SDK生态丰富。 缺点:需要独立Temporal Server集群(依赖Cassandra/PostgreSQL + Elasticsearch);学习曲线陡峭,概念多(Workflow、Activity、Signal、Query、Timer);对于简单Agent任务过于重量级。 变现潜力:高。企业级Agent容错方案是刚需,可包装为"生产级AI Agent可靠性训练营"。
Restate采用了一种独特的Virtual Object抽象——每个Agent实例对应一个Virtual Object,保证同一个Key在同一时刻只有一个执行实例,天然解决了并发冲突问题。底层使用日志+确定性重放,但开发者感知到的是普通函数调用:
// Restate: 将Agent定义为Virtual Object
const agentRouter = restate.router({
  // 每个researchSession有唯一的execution guarantee
  research: async (ctx: restate.Context, topic: string) => {
    // 调用LLM - 自动持久化,崩溃后自动重放
    const result = await ctx.run(() =>
      openai.chat.completions.create({
        model: "gpt-4",
        messages: [{ role: "user", content: `研究: ${topic}` }],
      })
    );

    // 持久化中间结果
    ctx.set("researchResult", result);

    // Awakeable: 暂停等待外部事件(如人工审核)
    const approval = ctx.awakeable<boolean>();
    // 发送审核请求给外部系统
    await ctx.run(() => sendForApproval(approval.id, result));
    const { value: approved } = await approval.promise;

    if (approved) {
      const report = await ctx.run(() => generateReport(result));
      return report;
    }
    return "rejected";
  },
});
优点:部署简单——单进程二进制,无需独立集群;Virtual Object天然解决并发;TypeScript/Java SDK成熟;延迟极低。 缺点:社区规模较小;Python SDK仍在完善中;生态系统不如Temporal丰富。 变现潜力:中高。适合中小团队的Agent可靠性方案,可作为"轻量级Agent容错方案"课程的核心。
DBOS的核心理念是让持久化执行像写普通函数一样简单。它直接使用PostgreSQL的WAL(预写日志)和事务机制实现工作流持久化,无需额外基础设施。对于已有Postgres的团队,接入成本几乎为零:
from dbos import DBOS

@DBOS.workflow()
def research_agent_workflow(topic: str) -> str:
    # Step 1: 搜索 - 自动持久化到Postgres
    search_result = search_step(topic)
    # Step 2: 分析 - 如果崩溃,恢复时自动跳过已完成的步骤
    analysis = analysis_step(search_result)
    # Step 3: 生成报告
    report = report_step(analysis)
    return report

@DBOS.step(retries_allowed=True, max_attempts=3)
def search_step(topic: str) -> str:
    """每个step自动记录到Postgres,崩溃后精确恢复"""
    response = openai.chat.completions.create(
        model="gpt-4",
        messages=[{"role": "user", "content": f"搜索{topic}"}]
    )
    return response.choices[0].message.content
优点:极致轻量——仅需Postgres;Python和TypeScript双支持;学习成本最低;透明持久化。 缺点:功能不如Temporal/Restate完善(如缺少Signal机制);社区规模最小;不适合超大规模分布式场景。 变现潜力:中。适合快速原型和个人项目,"零基础设施Agent容错"是很好的切入点。
LangGraph不依赖外部执行引擎——它把状态图(StateGraph)和检查点(Checkpoint)直接嵌入LangChain生态。开发者通过定义图节点和边来构建Agent工作流,每个节点执行后自动保存状态快照:
from langgraph.graph import StateGraph, END
from langgraph.checkpoint.postgres import PostgresSaver
from typing import TypedDict, Annotated
import operator

class AgentState(TypedDict):
    messages: Annotated[list, operator.add]
    next_step: str
    research_data: str

def research_node(state: AgentState) -> dict:
    """研究节点 - 执行后自动checkpoint"""
    result = llm.invoke(f"研究: {state['messages'][-1]}")
    return {"research_data": result, "next_step": "analyze"}

def analyze_node(state: AgentState) -> dict:
    return {"messages": [llm.invoke(f"分析: {state['research_data']}")]}

# 构建状态图
graph = StateGraph(AgentState)
graph.add_node("research", research_node)
graph.add_node("analyze", analyze_node)
graph.add_edge("research", "analyze")
graph.add_edge("analyze", END)
graph.set_entry_point("research")

# 挂载Postgres检查点 - 自动持久化
checkpointer = PostgresSaver.from_conn_string("postgresql://...")
app = graph.compile(
    checkpointer=checkpointer,
    interrupt_before=["analyze"],  # 人工介入点
)
# 执行 - thread_id实现会话隔离
result = app.invoke(
    {"messages": ["研究AI Agent发展趋势"]},
    config={"configurable": {"thread_id": "session-123"}},
)
优点:与LangChain生态深度集成;图结构直观表达复杂工作流;interrupt_before/after实现优雅的Human-in-loop;活跃社区。
缺点:仅限Python生态;持久化依赖外部Checkpointer实现;大规模场景性能不如专用引擎。
变现潜力:高。LangChain生态用户基数大,"LangGraph生产化"是热门课程主题。
Apache Flink Agents是Flink社区的全新子项目,它把AI Agent嵌入Flink的流处理引擎中,实现事件驱动的实时Agent执行。与传统"请求-响应"模式不同,Flink Agents让Agent作为持续运行的流处理算子,实时消费Kafka等消息队列中的事件并作出响应:
from flink_agents.api import Agent, Event, Action

class RealTimeMonitorAgent(Agent):
    """实时监控Agent - 持续处理事件流"""
    def on_event(self, event: Event) -> list[Action]:
        # Flink保证exactly-once处理语义
        anomaly = self.llm_analyze(event.data)
        if anomaly.detected:
            return [Action(type="alert", payload=anomaly.report)]
        return []

    def llm_analyze(self, data: str):
        # LLM调用自动checkpoint
        return self.invoke_llm(f"分析异常: {data}")
优点:天然支持流式处理和实时场景;Flink的Exactly-once语义保证无重复执行;横向扩展能力强;与Kafka生态无缝集成。 缺点:需要Flink集群(运维成本高);项目处于孵化期,API不稳定;学习曲线最陡。 变现潜力:中。适合实时监控、IoT等流式场景,可作为"流式AI Agent"高级课程。
Camunda 8.8在2025年正式引入了Agentic Orchestration能力,将传统BPMN(业务流程建模标记法)与AI Agent结合。开发者可以用标准的BPMN流程图编排Agent任务,每个Agent作为BPMN中的"服务任务"或"用户任务"执行:
<!-- BPMN定义Agent工作流 -->
<serviceTask id="analyze" name="AI分析Agent">
  <extensionElements>
    <zeebe:taskDefinition type="ai-agent" />
    <zeebe:taskHeaders>
      <zeebe:header key="agentType" value="analyzer" />
      <zeebe:header key="model" value="gpt-4" />
    </zeebe:taskHeaders>
  </extensionElements>
</serviceTask>
// Java工作者执行Agent任务
@ZeebeWorker(type = "ai-agent")
public void executeAgent(JobClient client, ActivatedJob job) {
    String prompt = job.getVariablesAsMap().get("input").toString();
    String result = llmClient.chat(prompt);
    client.newCompleteCommand(job.getKey())
          .variables(Map.of("result", result))
          .send().join();
}
优点:BPMN可视化编排;成熟的企业级流程管理;完善的监控和审计;支持BPMN补偿事件实现Agent回滚。 缺点:Java生态为主;需Zeebe引擎;BPMN与Agent动态性的天然矛盾——BPMN是预设流程,Agent需要灵活决策。 变现潜力:高。传统企业数字化转型+AI Agent是热门赛道。
图表 1
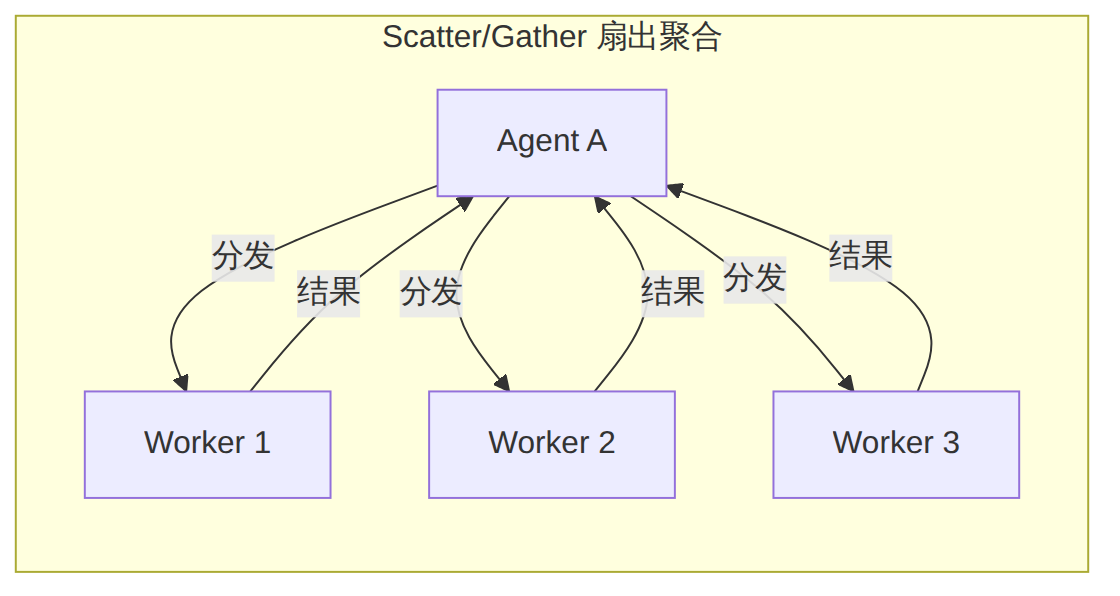
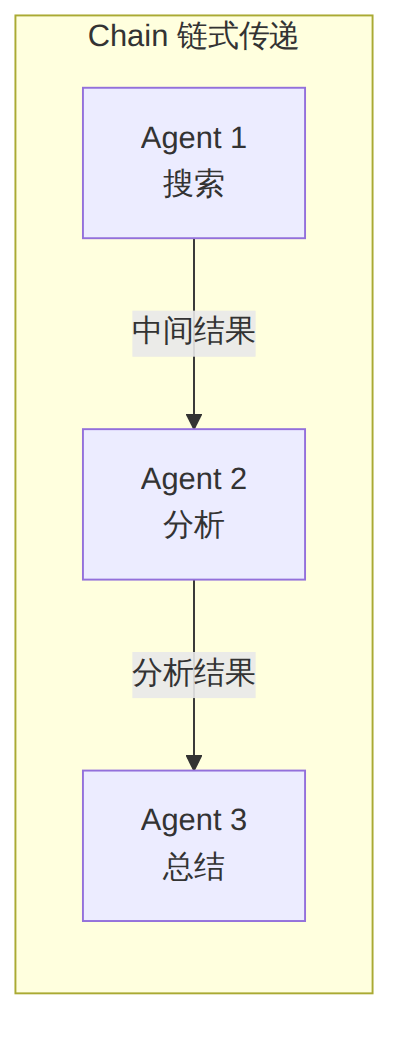
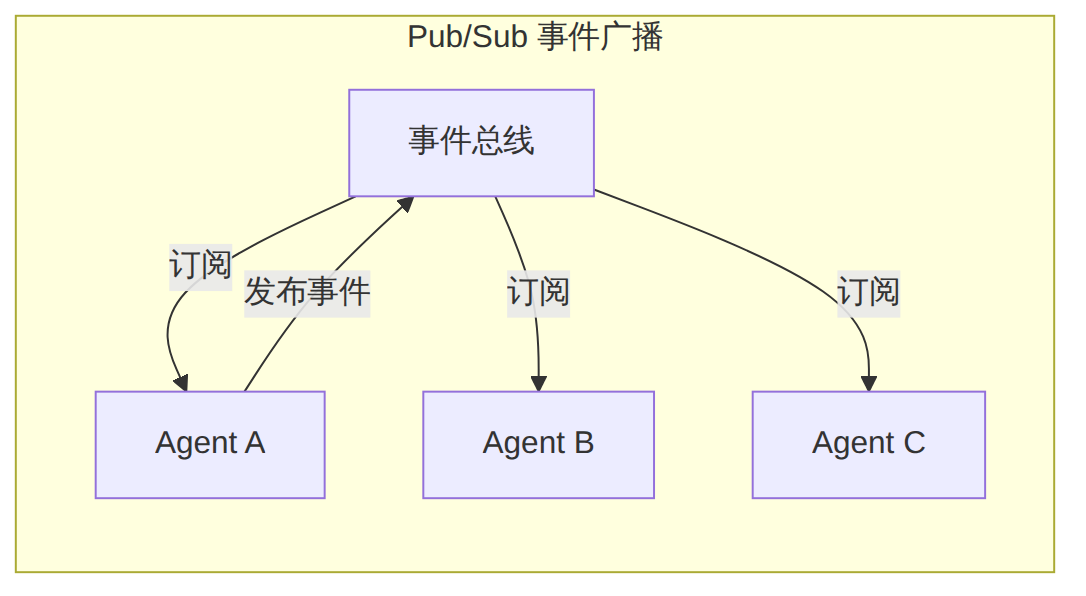
Confluent提出的事件驱动多Agent系统设计模式,已成为2025-2026年多智能体架构的事实标准:
图表 2
图表 3
图表 4
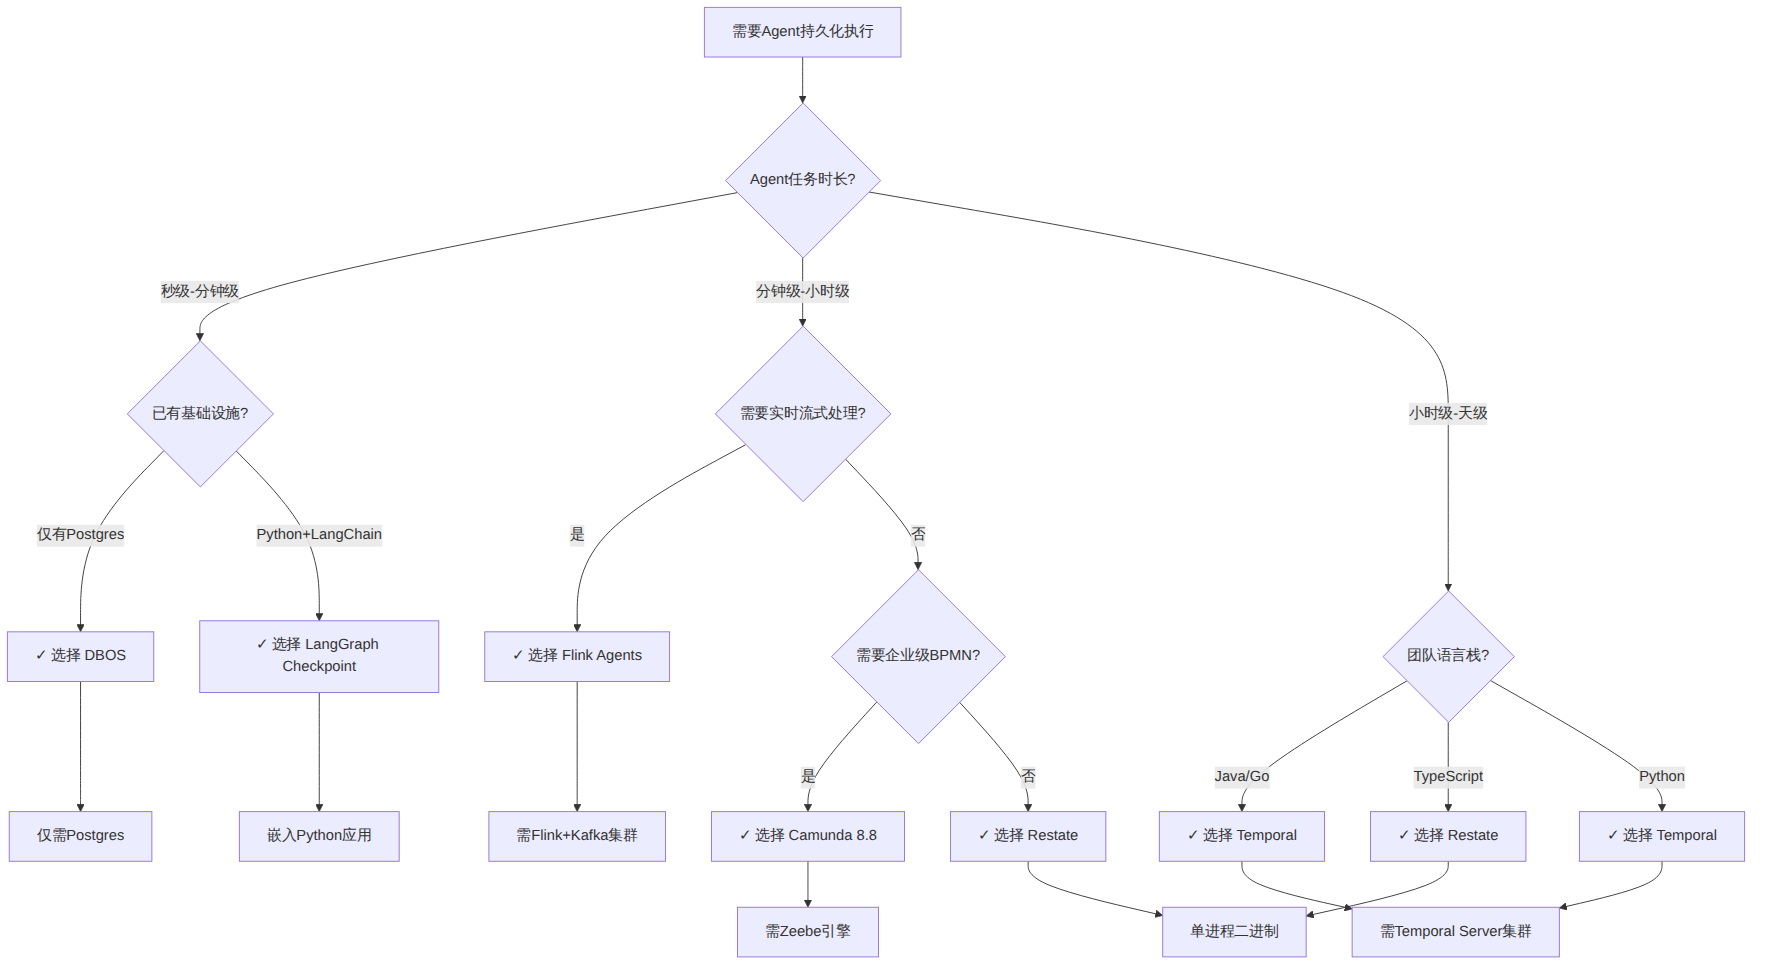
图表 5
无论选择哪个引擎,持久化执行都依赖三个核心原语的组合:
1. 确定性重放(Deterministic Replay)
所有操作(LLM调用、HTTP请求、定时器)被记录为事件日志。恢复时引擎重放日志,跳过已完成的操作直接返回缓存结果。这要求工作流代码是确定性的——不能依赖随机数或系统时间:
[启动] → [搜索✓] → [分析✓] → 💥崩溃
                                    ↓ 恢复
[启动] → [搜索] → [分析] → [生成报告] → [完成]
         ↑重放跳过  ↑重放跳过   ↑从这里继续
2. 检查点(Checkpoint)
定期将完整状态快照保存到持久存储。Flink使用Checkpoint Barrier机制,LangGraph在每个图节点执行后自动触发。检查点是重放的优化——不需要从头重放所有事件:
Checkpoint 1          Checkpoint 2          Checkpoint 3
[State A] ──────────→ [State B] ──────────→ [State C]
                                              ↑ 崩溃恢复点
3. 幂等性保证(Idempotency)
LLM API调用等副作用操作必须保证幂等——即使重放多次也只执行一次。Temporal通过Activity ID去重,Restate通过Invocation ID保证,DBOS通过Postgres唯一约束实现。
| 阶段 | 推荐方案 | 原因 |
|---|---|---|
| 原型验证(1-2周) | LangGraph + MemoryCheckpoint | 零基础设施,快速迭代 |
| MVP上线(1-3月) | DBOS | 仅需Postgres,迁移成本最低 |
| 规模化(3-6月) | Temporal 或 Restate | 可靠性+可观测性+水平扩展 |
| 企业合规 | Camunda 8.8 | BPMN审计+合规+可视化 |
| 实时场景 | Flink Agents | 流式处理+Exactly-once |
关键经验: - 不要在MVP阶段就用Temporal——过早引入复杂基础设施会拖慢迭代速度 - LLM调用必须设置超时和重试——GPT-4偶尔会超时60秒以上 - 人工介入点越早设计越好——后期加Human-in-loop的改造成本很高 - 监控每个节点的执行耗时和成本——LLM调用是Agent最大的成本来源
[!tip] 51学通信知识星球 星主:爱卫生(微信:gprshome201101)——公众号「51学通信」创办者,19 年通信行业运维与讲师经验,著有《GPRS网络信令实例详解》《EPC原理与实践》《5G核心网原理与实践》三本纸质书(各大电商平台有售)。 星球定位:深耕 5G 核心网、IMS、NFV/AI、云原生等 ICT 领域,主打运维岗位与信令分析。 当前规模:5200 篇主题 / 990 个回答,198 元/年。 加入福利:加入星球后请加爱卫生微信,拉您进知识星球年度陪伴与答疑群——不限量回复您的各种问题,另有群内分享。 AI 加持:51学通信知识星球已作为 skill 接入 WorkBuddy,使用 deepseek-4-flash 在海量星球帖子中精准找贴、找视频、找 FAQ 和案例,做总结、找文档和 PPT 等场景全覆盖。
