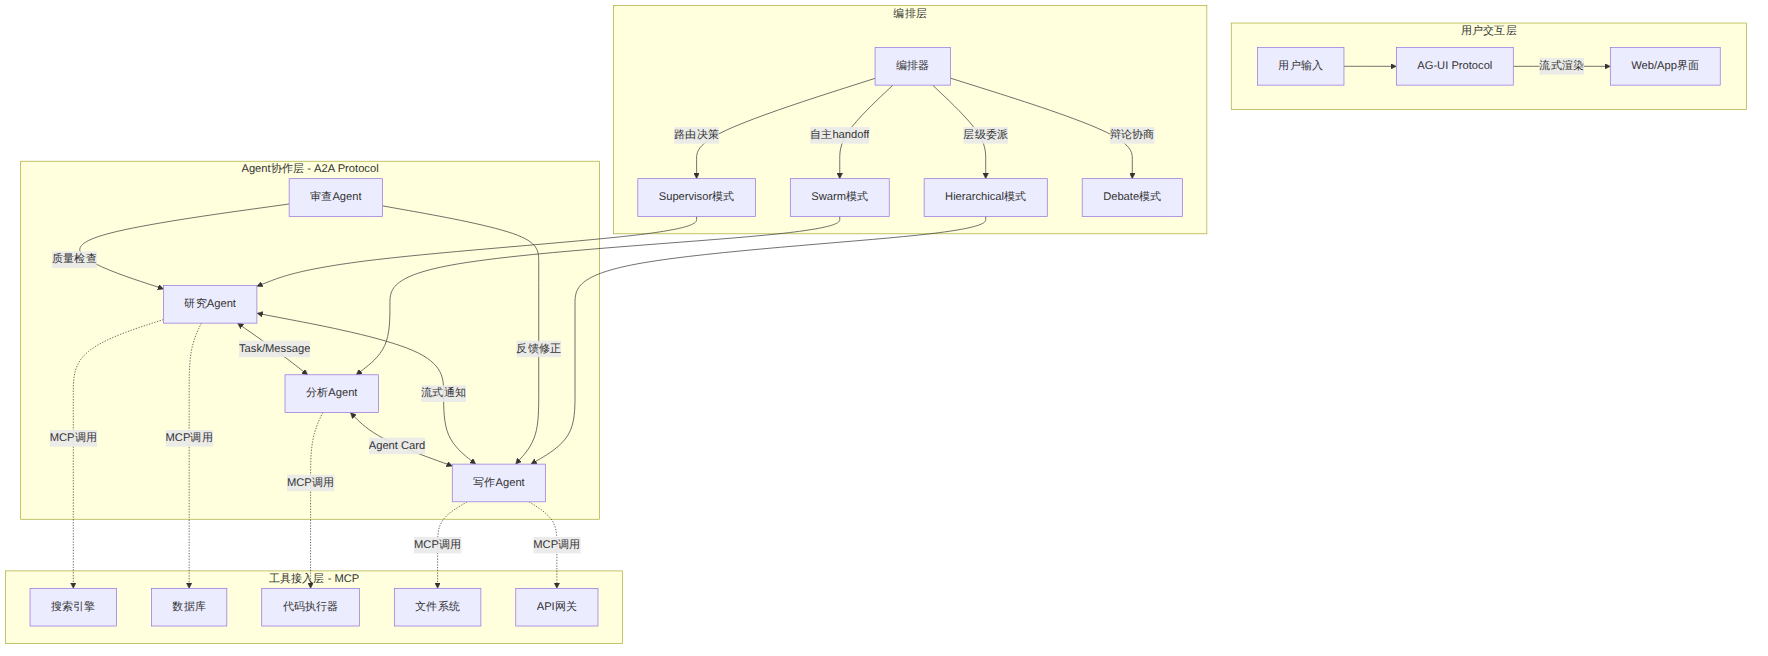
多智能体系统(Multi-Agent System)正从实验性架构快速演进为生产级基础设施。2025-2026年,三大技术突破重新定义了多智能体协作的边界:Google推出A2A协议打通跨框架Agent通信、LangGraph以有状态图模型统一了Supervisor/Swarm编排范式、多智能体辩论(MAD)在推理增强领域取得NeurIPS/ICLR级别成果。本文从协议层、编排层、协作层三个维度,深度拆解当前多智能体协作系统的核心技术架构与工程实践。
2026年的AI Agent生态已形成清晰的分层协议栈。一个完整的多智能体系统通常需要三层协议协同工作:
| 协议 | 全称 | 定位 | 核心能力 | 推动方 |
|---|---|---|---|---|
| MCP | Model Context Protocol | Agent↔工具 | 标准化工具调用、数据源接入 | Anthropic |
| A2A | Agent-to-Agent Protocol | Agent↔Agent | 跨框架Agent发现、任务委托、流式通知 | |
| AG-UI | Agent-Gen UI Protocol | Agent↔用户 | 前端交互、流式渲染、状态同步 | CopilotKit |
MCP解决的是"Agent如何使用工具"的问题。它定义了一套标准化的工具描述和调用规范,使Agent可以接入任意数据源和工具服务。在多智能体系统中,MCP扮演"手"的角色——让每个Agent获得标准化的操作能力。
# MCP Server 示例:暴露工具给Agent使用
from mcp.server import Server

server = Server("research-tools")

@server.tool("search_database")
async def search_database(query: str, limit: int = 10) -> dict:
    """搜索研究数据库"""
    results = await db.search(query, limit=limit)
    return {"results": results, "count": len(results)}

@server.tool("generate_report")
async def generate_report(data: dict, format: str = "pdf") -> dict:
    """生成分析报告"""
    report = await report_engine.create(data, format=format)
    return {"url": report.url, "pages": report.page_count}
A2A是Google于2025年4月推出的开放协议,目前已有150+企业加入支持。其核心设计理念是让不同框架构建的Agent能够互相发现、通信和协作。A2A的关键概念包括:
{
  "@type": "AgentCard",
  "name": "Research Analyst Agent",
  "description": "深度研究分析Agent,擅长市场调研和竞品分析",
  "url": "https://agents.example.com/research-analyst",
  "capabilities": {
    "streaming": true,
    "pushNotifications": true
  },
  "skills": [
    {
      "name": "market_research",
      "description": "执行市场调研并生成结构化报告"
    },
    {
      "name": "competitor_analysis",
      "description": "分析竞争对手的产品策略和技术路线"
    }
  ],
  "authentication": {
    "schemes": ["Bearer Token"]
  }
}
┌─────────────────────────────────────┐
│         AG-UI (用户交互层)            │
│    流式渲染 / 状态同步 / 人机协作      │
├─────────────────────────────────────┤
│         A2A (Agent协作层)             │
│  Agent发现 / 任务委托 / 结果回传      │
├─────────────────────────────────────┤
│         MCP (工具接入层)              │
│   工具调用 / 数据源 / API集成         │
├─────────────────────────────────────┤
│         LLM (推理引擎层)             │
│   GPT-4.1 / Claude / Gemini        │
└─────────────────────────────────────┘
这套分层架构的实用价值在于:你可以用CrewAI构建角色定义Agent,通过A2A协议与LangGraph编排的Agent通信,两者都通过MCP访问统一的工具集。协议层的标准化让"混合框架"多智能体系统成为可能。
多智能体系统的核心挑战是"谁来决定做什么"——即编排模式。当前主流框架(LangGraph、CrewAI、OpenAI Agents SDK、AutoGen)都实现了以下五种模式中的若干种:
| 模式 | 原理 | 适用场景 | 代表框架 | 上手难度 |
|---|---|---|---|---|
| 顺序流水线 | Agent A→B→C线性传递 | 内容生产、数据处理管道 | CrewAI Sequential | ★☆☆☆☆ |
| 层级委派 | Manager Agent调度Worker | 企业级任务分配 | CrewAI Hierarchical | ★★☆☆☆ |
| 监督者路由 | Supervisor根据意图路由到专业Agent | 客服系统、多功能助手 | LangGraph Supervisor | ★★★☆☆ |
| 去中心化蜂群 | Agent自主决定handoff给谁 | 开放式协作、灵活任务流 | LangGraph Swarm / OpenAI SDK | ★★★★☆ |
| 辩论式 | 多Agent辩论达成共识 | 决策支持、推理增强 | MAD框架 / AutoGen GroupChat | ★★★★★ |
Supervisor模式是当前生产环境中最主流的多智能体编排方式。一个中央Supervisor Agent负责分析用户意图,将任务路由到最合适的专业Agent,并汇总最终结果。
from langgraph_supervisor import create_supervisor
from langgraph.prebuilt import create_react_agent

# 定义专业Agent
research_agent = create_react_agent(
    model="openai:gpt-4.1",
    tools=[search_web, read_document],
    name="researcher",
    prompt="你是研究专家,负责收集和分析信息。"
)

writer_agent = create_react_agent(
    model="openai:gpt-4.1",
    tools=[write_file, format_text],
    name="writer",
    prompt="你是写作专家,负责将研究结果转化为高质量文章。"
)

# 创建Supervisor编排
supervisor = create_supervisor(
    model="openai:gpt-4.1",
    agents=[research_agent, writer_agent],
    prompt="""你是一个任务编排器。根据用户需求:
    - 研究类任务交给 researcher
    - 写作类任务交给 writer
    - 复杂任务先让 researcher 调研,再交给 writer 写作"""
)

# 编译并运行
app = supervisor.compile()
result = await app.ainvoke({
    "messages": [{"role": "user", "content": "调研2026年AI Agent市场并写一份报告"}]
})
Supervisor模式的优势在于可控性和可观测性。所有决策都经过中央节点,便于添加日志、追踪和人工介入点。但其瓶颈也在此——当Agent数量超过5-8个时,Supervisor的路由准确率会下降。
Swarm模式受OpenAI Swarm实验项目启发,采用去中心化的handoff机制。每个Agent自行决定是否将控制权转交给另一个Agent,无需中央调度器。
from langgraph_swarm import create_swarm, swarm_agent

@swarm_agent
async def triage_agent(state):
    """分类Agent:判断用户意图"""
    # Agent自己决定下一步:直接回复,还是handoff
    return {
        "response": "...",
        "next_agent": "billing_agent"  # 自主决定转交
    }

@swarm_agent
async def billing_agent(state):
    """账单Agent:处理计费问题"""
    return {
        "response": "已为您查询到...",
        "next_agent": None  # 任务完成,不转交
    }

swarm = create_swarm(
    agents=[triage_agent, billing_agent, tech_support_agent],
    default_agent="triage_agent"
)
Swarm的精髓在于"Agent自治"。每个Agent的prompt中包含对其他Agent能力的描述,由LLM自行判断是否需要handoff。这种方式更灵活,但调试和追踪更困难。
CrewAI的Hierarchical Process模拟了真实组织结构:一个Manager Agent负责任务分解和分配,Worker Agent负责执行。Manager可以动态创建新任务、重新分配、甚至否决Worker的输出。
from crewai import Agent, Task, Crew, Process

# 定义Worker Agent
researcher = Agent(
    role="高级研究员",
    goal="深入调研技术主题,收集全面信息",
    backstory="10年技术研究经验的资深分析师",
    tools=[search_tool, scrape_tool],
    llm="gpt-4.1"
)

analyst = Agent(
    role="数据分析师",
    goal="从研究数据中提取关键洞察",
    backstory="擅长数据可视化和趋势分析的数据科学家",
    tools=[python_tool, chart_tool],
    llm="gpt-4.1"
)

writer = Agent(
    role="技术写作专家",
    goal="将分析结果转化为专业报告",
    backstory="曾就职于顶级科技媒体的技术编辑",
    llm="gpt-4.1"
)

# 创建层级Crew(自动生成Manager)
crew = Crew(
    agents=[researcher, analyst, writer],
    tasks=[...],  # Manager会根据需要创建和分配任务
    process=Process.hierarchical,
    manager_llm="gpt-4.1",
    verbose=True
)

result = crew.kickoff(inputs={"topic": "2026年多智能体系统技术趋势"})
CrewAI的独特价值在于角色定义的丰富性。role、goal、backstory三要素构成了Agent的"人格",这使得Agent在协作中表现出更一致的行为模式。Manager Agent不仅能分配任务,还能根据Worker之间的依赖关系智能编排执行顺序。
辩论模式是最具学术前沿感的协作方式。多个Agent就同一问题展开结构化辩论,通过提出论点、质疑反驳、修正完善的多轮交互,最终达成更高质量的结论。
# MAD辩论框架核心逻辑(简化实现)
class MultiAgentDebate:
    def __init__(self, agents: list[Agent], rounds: int = 3):
        self.agents = agents
        self.rounds = rounds
        self.judge = Agent(role="judge", model="gpt-4.1")

    async def debate(self, question: str) -> dict:
        arguments = {i: "" for i in range(len(self.agents))}

        for round_num in range(self.rounds):
            for i, agent in enumerate(self.agents):
                # 构建辩论上下文:看到所有其他Agent的论点
                context = self._build_context(arguments, exclude=i)
                arguments[i] = await agent.generate(
                    f"问题: {question}\n"
                    f"其他Agent的观点:\n{context}\n"
                    f"请{'提出你的初始论点' if round_num == 0 else '回应质疑并完善论点'}"
                )

        # Judge汇总最终结论
        final = await self.judge.generate(
            f"问题: {question}\n"
            f"各方论点:\n{self._summarize(arguments)}\n"
            f"请综合各方观点,给出最终结论。"
        )
        return {"conclusion": final, "arguments": arguments}
2025年NeurIPS论文"Debate or Vote"的研究发现:MAD的性能提升主要来自多数投票(ensembling effect),而非辩论过程本身的推理增强。而ICLR 2025上的Diverse Multi-Agent Debate工作则证明,使用异构模型池(如GPT-4 + Claude + Gemini混合)的辩论效果显著优于同质模型。这对工程实践的启示是:与其让三个GPT-4.1辩论,不如让GPT-4.1、Claude Sonnet和Gemini Pro各抒己见。
OpenAI Agents SDK(前身是Swarm实验项目)提供了两种编排范式:Handoff(Agent间控制权转移)和Agent-as-Tool(一个Agent作为另一个Agent的工具调用)。
from agents import Agent, Runner, handoff

# 定义专业Agent
spanish_agent = Agent(
    name="spanish_agent",
    instructions="你用西班牙语回答问题。",
    model="gpt-4.1-mini"
)

french_agent = Agent(
    name="french_agent",
    instructions="你用法语回答问题。",
    model="gpt-4.1-mini"
)

# 主Agent通过handoff机制转移控制权
triage_agent = Agent(
    name="triage_agent",
    instructions="""根据用户语言选择合适的Agent。
    西班牙语→spanish_agent,法语→french_agent""",
    model="gpt-4.1",
    handoffs=[
        handoff(spanish_agent),
        handoff(french_agent)
    ]
)

result = await Runner.run(triage_agent, "Hola, ¿cómo estás?")
Handoff与Agent-as-Tool的关键区别在于控制权:Handoff是完全转移,目标Agent获得完整控制权;Agent-as-Tool是调用关系,主Agent保持控制权。前者适合完整的任务交接(如客服转接),后者适合简单的子任务委派(如调用翻译工具)。
图表 1
| 评估维度 | LangGraph | CrewAI | OpenAI Agents SDK | AutoGen |
|---|---|---|---|---|
| 编排模式 | Supervisor/Swarm/自定义图 | Sequential/Hierarchical | Handoff/Agent-as-Tool | GroupChat/Nested Chat |
| 状态管理 | 内置持久化检查点 | 任务级状态 | 对话级状态 | 对话级状态 |
| 协议支持 | MCP集成 | MCP集成 | 原生Function Calling | MCP集成 |
| LLM兼容性 | 任意LLM | 任意LLM | OpenAI仅限 | 任意LLM |
| 生产就绪度 | ★★★★★ | ★★★★☆ | ★★★★☆ | ★★★☆☆ |
| 学习曲线 | 中等(需理解图概念) | 低(角色驱动直觉化) | 低(极简API) | 中高(灵活但复杂) |
| 可观测性 | LangSmith集成 | CrewAI+集成 | OpenAI Dashboard | 无内置 |
| 适用团队 | 技术团队 | 业务+技术 | OpenAI生态 | 研究团队 |
| 变现潜力 | 企业级工作流 | 训练营/低代码产品 | OpenAI生态产品 | 学术咨询 |
多智能体系统的最大工程挑战是状态管理。LangGraph在这方面领先——其内置的检查点(Checkpoint)机制可以在任意节点暂停和恢复执行,这对于长时间运行的多Agent工作流至关重要。
from langgraph.checkpoint.memory import MemorySaver
from langgraph.graph import StateGraph

# 配置持久化检查点
checkpointer = MemorySaver()  # 生产环境替换为PostgreSQL/Redis

# 编译图时启用检查点
app = graph.compile(
    checkpointer=checkpointer,
    interrupt_before=["human_review"]  # 人工审核节点前暂停
)

# 使用thread_id追踪会话状态
config = {"configurable": {"thread_id": "session-001"}}
result = await app.ainvoke(input_data, config=config)

# 可以随时恢复执行
resumed = await app.ainvoke(None, config=config)  # 从检查点恢复
A2A协议的真正威力在于打破框架边界。以下是一个跨框架协作的场景:CrewAI的研究Agent通过A2A调用LangGraph编排的分析Agent。
# A2A客户端:发现并调用远程Agent
import httpx

async def discover_agent(agent_card_url: str) -> dict:
    """发现远程Agent并获取其能力描述"""
    async with httpx.AsyncClient() as client:
        response = await client.get(agent_card_url)
        return response.json()  # 返回Agent Card

async def delegate_to_agent(agent_url: str, task: str) -> dict:
    """通过A2A协议向远程Agent委托任务"""
    async with httpx.AsyncClient() as client:
        response = await client.post(
            f"{agent_url}/tasks",
            json={
                "task": {
                    "id": "task-001",
                    "message": {
                        "role": "user",
                        "parts": [{"type": "text", "text": task}]
                    }
                }
            }
        )
        return response.json()

# 使用示例
agent_card = await discover_agent(
    "https://agents.partner.com/analytics/.well-known/agent.json"
)
result = await delegate_to_agent(
    agent_card["url"],
    "分析过去30天的用户行为数据,识别流失风险用户"
)
在实际生产中,单一的编排模式往往不够。一种有效的混合架构是:外层用Supervisor做任务路由,内层用Debate做关键决策的质量保证。
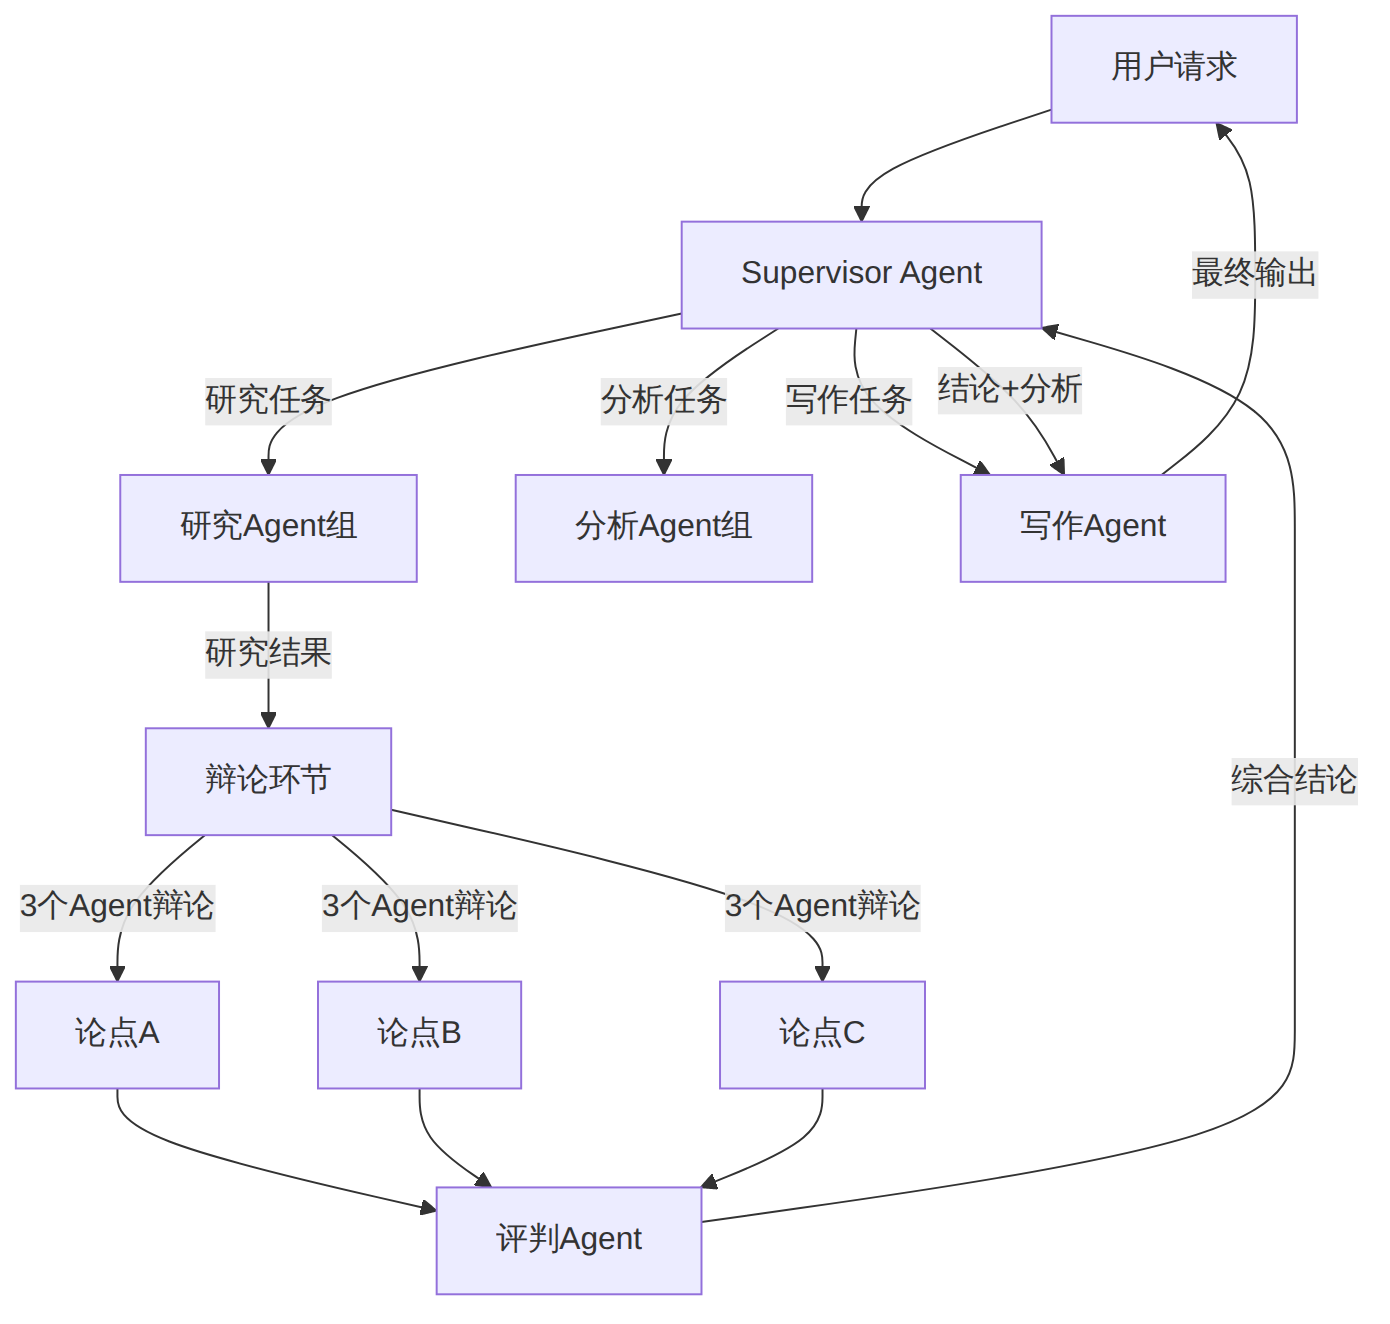
图表 2
这种架构的变现在于:研究质量通过辩论得到保证,而非依赖单一Agent的输出。特别适合金融投研、医疗诊断、法律分析等对准确性要求极高的场景。
| 场景 | 推荐架构 | 推荐框架 | 理由 |
|---|---|---|---|
| 客服/多功能助手 | Supervisor路由 | LangGraph或OpenAI SDK | 意图识别+专业Agent路由,可观测性强 |
| 内容生产流水线 | Hierarchical | CrewAI | 角色定义直觉化,Manager自动编排 |
| 投研/决策支持 | Supervisor + Debate | LangGraph + 自定义MAD | 辩论层保证推理质量 |
| 跨组织Agent协作 | A2A + Supervisor | 混合框架 | A2A打通跨系统,Supervisor保持可控 |
| 研究/教学实验 | Group Chat / Debate | AutoGen / 自定义 | 灵活探索,无需生产级约束 |
| OpenAI生态产品 | Handoff | OpenAI Agents SDK | 原生集成,极简开发体验 |
从Supervisor模式起步。它是可观测性和灵活性平衡最好的模式,LangGraph的create_supervisor函数5分钟即可搭建一个可运行的多Agent系统。等遇到瓶颈再考虑Swarm或混合模式。
关注A2A协议生态。即使你现在只用单一框架,A2A的Agent Card规范也值得提前适配——它是Agent能力描述的事实标准。一旦你的Agent支持A2A,就能自动加入任何兼容A2A的Agent网络。
辩论模式慎用。MAD在学术benchmarks上效果显著,但生产中Token成本高昂(3个Agent辩论3轮 = 至少9次完整LLM调用)。建议只在关键决策节点启用辩论,日常任务用简单的多数投票即可。
[!tip] 51学通信知识星球 星主:爱卫生(微信:gprshome201101)——公众号「51学通信」创办者,19 年通信行业运维与讲师经验,著有《GPRS网络信令实例详解》《EPC原理与实践》《5G核心网原理与实践》三本纸质书(各大电商平台有售)。 星球定位:深耕 5G 核心网、IMS、NFV/AI、云原生等 ICT 领域,主打运维岗位与信令分析。 当前规模:5200 篇主题 / 990 个回答,198 元/年。 加入福利:加入星球后请加爱卫生微信,拉您进知识星球年度陪伴与答疑群——不限量回复您的各种问题,另有群内分享。 AI 加持:51学通信知识星球已作为 skill 接入 WorkBuddy,使用 deepseek-4-flash 在海量星球帖子中精准找贴、找视频、找 FAQ 和案例,做总结、找文档和 PPT 等场景全覆盖。
