2026年,多智能体系统(Multi-Agent Systems)已从实验室原型跃升为企业级生产部署的核心范式。根据Landbase发布的Agentic AI统计报告,三分之二的智能体AI市场已运行在协作式多智能体架构之上,而非单Agent方案。Google A2A协议上线一年即获150+组织支持,Anthropic MCP路线图明确指向Agent-to-Agent通信,IBM ACP与社区ANP协议分食不同通信层——四大协议正在构建一个分层互补的智能体互操作栈。本文深度解析2026年已收敛的8种经典多智能体架构模式、4大通信协议的技术内核、以及5个主流框架的最新实现,并给出面向不同场景的选型指南。
根据ServicesGround发布的架构指南,2026年的Agent架构已收敛为8种规范化模式,按复杂度和自治程度分布在4个象限:
| 模式 | 拓扑结构 | 适用场景 | 典型框架 |
|---|---|---|---|
| 单Agent+工具 | 线性 | 简单任务链 | OpenAI Agents SDK |
| Supervisor模式 | 星型/Hub-Spoke | 任务路由与分发 | LangGraph Supervisor |
| 层级式团队 | 树状 | 复杂企业流程 | LangGraph Teams, AG2 |
| 对等网状 | Flat Mesh | 创意协作、辩论 | CAMEL-AI |
| 流水线 | 线性链 | 软件开发模拟 | MetaGPT |
| Swarm群体智能 | 去中心化 | 大规模分布式任务 | OpenAI Swarm |
| 事件驱动 | 异步消息 | 实时系统、IoT | AG2 v0.4 |
| 混合编排 | 多拓扑组合 | 企业级生产系统 | LangGraph + A2A |
Supervisor模式是多智能体系统中采用最广泛的架构,核心思路是一个中央"管理者"Agent负责接收用户请求、分析意图、将子任务分发给专业化的Worker Agent,最后汇总结果返回。
         ┌──────────┐
         │ Supervisor│
         │  Agent   │
    ┌────┴──┬───┬───┴────┐
    ▼       ▼   ▼        ▼
┌──────┐┌──────┐┌──────┐┌──────┐
│Research││ Code ││ Data ││ Writer│
│ Agent ││Agent ││Agent ││ Agent │
└──────┘└──────┘└──────┘└──────┘
LangGraph的langgraph-supervisor库提供了开箱即用的实现。其核心机制是通过一个Supervisor LLM决策下一步调用哪个Agent,每次调用完成后将结果追加到共享State中,Supervisor再决定继续还是终止。
关键优势在于可控性强——所有Agent间的通信必须经过Supervisor中转,便于审计、限流和注入安全策略。劣势是Supervisor本身成为单点瓶颈,当Agent数量超过10个时延迟显著上升。
当系统复杂度超出单层Supervisor管理能力时,层级式团队(Hierarchical Teams)将Supervisor模式递归嵌套,形成组织架构式的树状结构。LangGraph官方教程中演示了这一模式:
from langgraph.supervisor import create_supervisor
from langgraph.prebuilt import create_react_agent

# 底层研究团队
research_agent = create_react_agent(model, tools=[search_tool])
doc_agent = create_react_agent(model, tools=[doc_tool])
research_team = create_supervisor(
    [research_agent, doc_agent],
    model=model,
    prompt="你是研究团队的管理者..."
)

# 底层写作团队
writer_agent = create_react_agent(model, tools=[write_tool])
review_agent = create_react_agent(model, tools=[review_tool])
writing_team = create_supervisor(
    [writer_agent, review_agent],
    model=model,
    prompt="你是写作团队的管理者..."
)

# 顶层Supervisor
top_supervisor = create_supervisor(
    [research_team, writing_team],
    model=model,
    prompt="你是总管理者,协调研究团队和写作团队..."
)
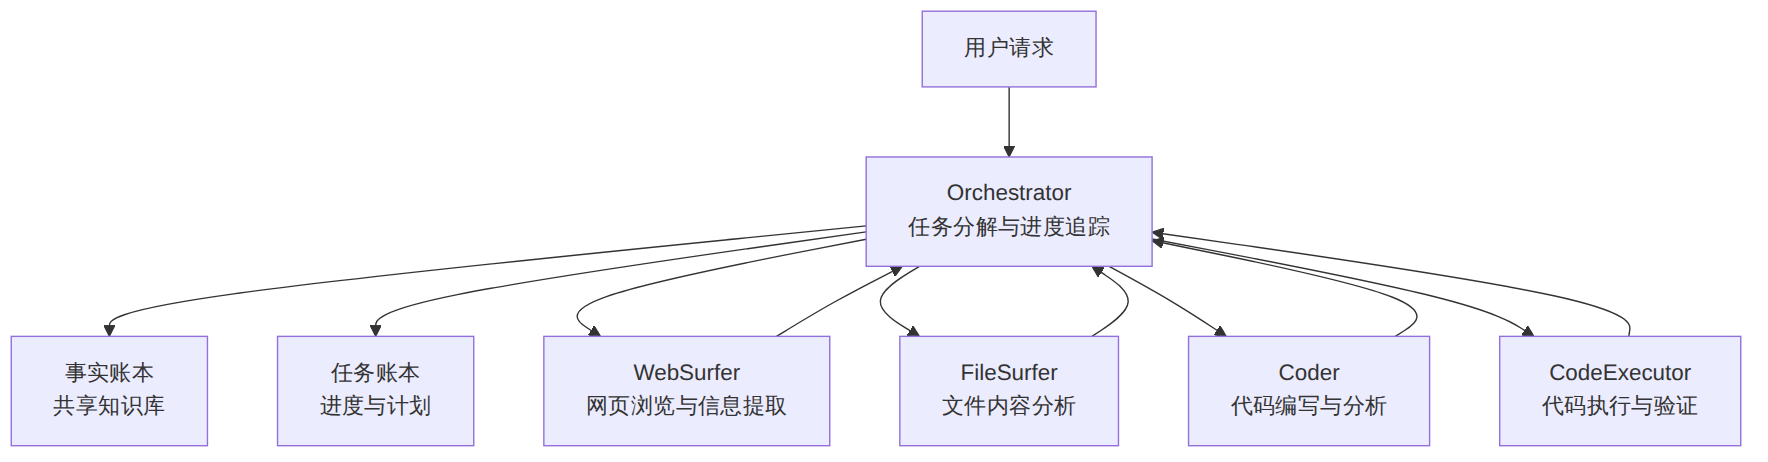
这种模式灵感来源于Microsoft的Magentic-One论文,后者将Agent组织为Orchestrator、WebSurfer、FileSurfer、Coder和CodeExecutor五个角色,Orchestrator负责任务分解和进度追踪。在企业场景中,一个典型的三层架构可以管理30+个Agent而不会失控。
与Supervisor的中心化调度不同,对等网状(Flat Mesh / Peer-to-Peer)架构中所有Agent地位平等,通过直接通信协商完成任务。CAMEL-AI框架是这一模式的代表实现,其核心是"角色扮演"(Role-Playing)机制——两个或多个Agent各自扮演不同角色,通过对话自发完成任务。
这种模式在创意生成、辩论评估、多视角分析等场景中表现优异,因为去中心化结构避免了Supervisor的认知瓶颈。但缺乏中央协调意味着可能出现Agent间对话发散、任务偏移等问题,需要精心设计系统提示词来维持对话聚焦。
Microsoft Research于2024年底发布的Magentic-One是通用多智能体系统的重要里程碑。其核心设计哲学是:不针对特定任务优化,而是构建一个能处理开放性问题的通用Agent团队。
图表 1
Magentic-One的独特之处在于Orchestrator维护两个"账本"(Ledger):事实账本记录已确认的信息和发现,任务账本跟踪整体计划、当前进度和待办事项。这种显式的状态管理使系统在面对复杂多步任务时能保持连贯性,避免"遗忘"已完成的工作。
Microsoft已将Magentic-One的编排模式集成到Microsoft Agent Framework中,作为官方推荐的Magentic编排策略。
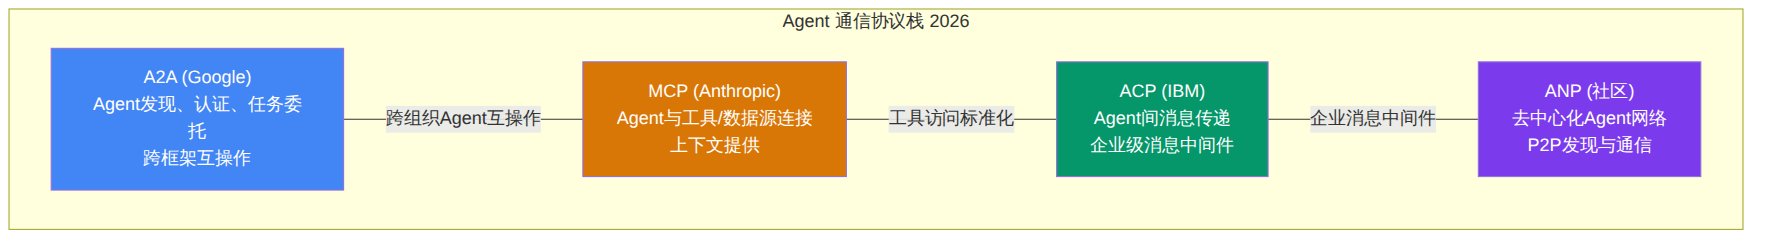
2025-2026年,Agent通信协议领域发生了质变。四大协议——A2A、MCP、ACP、ANP——各自聚焦不同层次,正在形成分层的协议栈。
图表 2
A2A(Agent-to-Agent)是Google于2025年4月发布的开放协议,旨在解决不同框架构建的Agent之间如何互相发现、认证和委托任务的问题。根据Linux基金会2026年4月发布的里程碑报告,A2A协议在发布一年内已获150+组织支持,落地主要云平台(Google Cloud、AWS、Azure),并出现了首批企业级生产部署。
A2A的核心抽象是Agent Card——一个JSON-LD格式的Agent描述文件,声明Agent的能力、认证方式、支持的技能和端点地址。当一个Agent需要完成超出自身能力的任务时,它可以通过A2A协议查询Agent注册中心,发现合适的远端Agent,然后发起任务委托。
{
  "@type": "AgentCard",
  "name": "财务报表分析Agent",
  "description": "分析企业财务报表并生成洞察报告",
  "url": "https://agents.example.com/finance-analyzer",
  "capabilities": {
    "streaming": true,
    "pushNotifications": true
  },
  "skills": [
    {
      "name": "balance-sheet-analysis",
      "description": "分析资产负债表"
    },
    {
      "name": "cashflow-forecast",
      "description": "现金流量预测"
    }
  ],
  "authentication": {
    "schemes": ["OAuth2"]
  }
}
A2A与MCP是互补关系:MCP解决的是"Agent如何访问工具和数据"(垂直层),A2A解决的是"Agent之间如何协作"(水平层)。
MCP在2026年的路线图明确了三个阶段演进:H1聚焦传输层扩展(支持WebSocket、gRPC等)、H2引入无状态服务器操作和Agent-to-Agent发现(通过MCP Server Cards),全年持续推进治理成熟度。
最值得关注的变化是MCP正在从纯粹的"工具访问协议"向"Agent通信协议"演进。2026 H2规划的MCP Server Cards机制与A2A的Agent Card高度相似——这意味着MCP和A2A在功能边界上正在趋同,未来可能需要某种桥接或合并机制。
Microsoft已在2026 Wave 1发布计划中宣布Copilot Studio支持MCP合规工具在Agent工作流中的发现和调用,标志着MCP正式进入企业级产品生态。
IBM的ACP(Agent Communication Protocol)走的是企业中间件路线,采用Broker代理模型——所有Agent间通信通过一个消息Broker中转,支持消息队列、事务性消息、死信处理等企业级特性。ACP天然适合金融、医疗等对消息可靠性要求极高的行业。
ANP(Agent Network Protocol)则是由社区驱动的去中心化协议,强调P2P发现、零信任通信和无需中央注册中心。ANP的设计理念更接近互联网的原始精神——每个Agent都是一个平等的网络节点。
| 维度 | A2A | MCP | ACP | ANP |
|---|---|---|---|---|
| 提出方 | Anthropic | IBM | 社区 | |
| 通信层 | Agent-Agent(水平) | Agent-Tool(垂直) | Agent-Agent(企业) | Agent-Agent(P2P) |
| 发现机制 | Agent Card + Registry | MCP Server Cards | Broker注册 | DHT分布式发现 |
| 认证 | OAuth2, API Key | 内置 | 企业SSO | 零信任/Did |
| 消息可靠性 | 最佳努力 | 最佳努力 | 事务级 | 最终一致 |
| 适用场景 | 跨组织Agent协作 | 工具与数据访问 | 企业内部Agent通信 | 去中心化Agent网络 |
| 成熟度 | 生产可用 | 生产可用 | 测试版 | 实验性 |
OpenAI Agents SDK是2026年最轻量的多智能体框架,核心概念只有四个:Agent(定义角色和工具)、Tool(可调用能力)、Handoff(Agent间交接)和Guardrail(安全护栏)。
from agents import Agent, Runner, handoff, RunContext

# 定义专业Agent
triage_agent = Agent(
    name="分流Agent",
    instructions="分析用户请求,决定转交给哪个专业Agent",
    handoffs=[
        handoff(agent=research_agent,
                description="处理研究和信息查询请求"),
        handoff(agent=coding_agent,
                description="处理编程和代码相关请求"),
        handoff(agent=writing_agent,
                description="处理内容创作请求"),
    ]
)

# Handoff核心:LLM自主决策交接
result = await Runner.run(triage_agent, messages=conversation)
OpenAI Agents SDK的设计哲学是让LLM做决策——Supervisor不再硬编码路由规则,而是由LLM根据上下文判断应该将控制权移交给哪个Agent。Handoff机制本质上是一种函数调用:当Agent判断需要转交时,它调用transfer_to_<agent_name>函数,框架自动将对话上下文传递给目标Agent。
Guardrail机制是其独特亮点——可以在输入/输出层设置验证函数,对Agent的输入输出进行实时检查和拦截:
from agents import GuardrailFunctionOutput, Agent, InputGuardrail

def check_financial_advice(context, agent, input_data):
    """防止Agent提供未授权的财务建议"""
    if "投资建议" in input_data and not context.get("licensed"):
        return GuardrailFunctionOutput(
            tripwire_triggered=True,
            output="未持牌,不可提供投资建议"
        )
    return GuardrailFunctionOutput(tripwire_triggered=False)

agent = Agent(
    name="FinancialAgent",
    input_guardrails=[InputGuardrail(guardrail_function=check_financial_advice)]
)
AG2是AutoGen的社区维护分支(microsoft/autogen → ag2ai/ag2),v0.4版本完成了从同步对话模型到异步事件驱动架构的重写。其核心变化包括:
Actor模型:每个Agent是一个独立的Actor,拥有自己的消息队列和事件处理器。Agent之间通过异步消息传递通信,不再阻塞等待。
import asyncio
from autogen_agentchat.agents import AssistantAgent
from autogen_agentchat.teams import RoundRobinGroupChat
from autogen_ext.models.openai import OpenAIChatCompletionClient

async def main():
    model_client = OpenAIChatCompletionClient(model="gpt-4o")

    analyst = AssistantAgent(
        name="数据分析师",
        model_client=model_client,
        system_message="你负责分析数据并提取洞察"
    )
    writer = AssistantAgent(
        name="报告撰写员",
        model_client=model_client,
        system_message="你根据分析结果撰写报告"
    )

    # RoundRobin团队:轮流发言
    team = RoundRobinGroupChat(
        participants=[analyst, writer],
        max_turns=6
    )

    result = await team.run(task="分析Q1销售数据并撰写总结报告")
内置可观测性:AG2集成了AgentChat消息追踪和AgentTracing,可以记录每次Agent间通信的完整上下文、工具调用链和决策过程。这对于生产环境的调试和审计至关重要。
截至2026年5月,AG2最新版本为v0.12.2(Apache 2.0),GitHub Star数超过45K(继承自原AutoGen仓库),是目前最活跃的开源多智能体框架之一。
LangGraph的多智能体能力建立在有向图(Directed Graph)抽象之上——每个Agent是图中的一个节点,Agent间的信息流是有向边,整个系统维护一个全局共享的State对象。
from langgraph.graph import StateGraph, START, END
from typing import TypedDict, Annotated
import operator

class AgentState(TypedDict):
    messages: Annotated[list, operator.add]
    current_agent: str
    task_complete: bool

def supervisor_node(state: AgentState) -> AgentState:
    """Supervisor决策节点"""
    last_msg = state["messages"][-1]
    # LLM决策下一步
    next_agent = llm_decide(last_msg)
    return {"current_agent": next_agent}

def researcher_node(state: AgentState) -> AgentState:
    """研究Agent节点"""
    result = research_tool(state["messages"][-1])
    return {"messages": [result]}

# 构建图
graph = StateGraph(AgentState)
graph.add_node("supervisor", supervisor_node)
graph.add_node("researcher", researcher_node)
graph.add_node("writer", writer_node)

# 定义边(条件路由)
graph.add_conditional_edges(
    "supervisor",
    lambda s: s["current_agent"],
    {"researcher": "researcher", "writer": "writer", "END": END}
)
graph.add_edge("researcher", "supervisor")
graph.add_edge("writer", "supervisor")

app = graph.compile()
LangGraph的核心优势在于状态持久化和人机协作(Human-in-the-Loop)。图的状态可以存储在外部数据库(PostgreSQL、Redis)中,支持暂停/恢复执行——这对于需要人类审批节点的企业工作流至关重要。
2026年,LangGraph发布了官方的langgraph-supervisor和langgraph-swarm库,将最常见的多智能体模式封装为高层API,大幅降低了上手门槛。
MetaGPT独辟蹊径,将SOP(标准操作规程)编码到多智能体系统中,模拟一个完整软件公司的运作流程:
用户需求 → 产品经理(PRD) → 架构师(系统设计) →
项目经理(任务分解) → 工程师(代码实现) → QA(测试)
每个Agent接收上游的输出作为输入,按SOP规范处理后再传递给下游。这种"流水线"架构与Supervisor模式有本质区别——不需要中央调度器,流程是确定性的,每个环节的输入输出格式是结构化的。
MetaGPT在2026年的最新版本中引入了"增量迭代"能力——当需求变更时,系统不会从头运行,而是定位受影响的SOP节点进行局部重执行,然后沿流水线传播变更。
CAMEL-AI的核心创新是Inception Prompting——通过精心设计的元提示词(Meta-Prompt)让两个Agent自动进入角色扮演模式,无需人工干预对话方向。
from camel.agents import ChatAgent
from camel.messages import BaseMessage
from camel.societies import RolePlaying

# 定义角色扮演会话
role_play = RolePlaying(
    assistant_role_name="Python专家",
    user_role_name="初学者",
    assistant_agent_kwargs={"model": "gpt-4o"},
    user_agent_kwargs={"model": "gpt-4o"},
    task_prompt="教会初学者理解Python装饰器",
    with_task_specify=True
)

# 自动运行角色扮演对话
chat_turns = 5
for _ in range(chat_turns):
    assistant_response = role_play.assistant_agent.step(
        role_play.user_agent.msgs[-1]
    )
    user_response = role_play.user_agent.step(
        assistant_response.msgs[-1]
    )
CAMEL-AI在2026年新增了多角色社会(Multi-Role Society)模式,支持3个以上Agent同时参与角色扮演,用于模拟更复杂的社会交互场景。
| 维度 | OpenAI Agents SDK | AG2 (AutoGen) | LangGraph | MetaGPT | CAMEL-AI |
|---|---|---|---|---|---|
| 最新版本 | v0.2+ (2026) | v0.12.2 | v0.3+ | v0.9+ | v0.2+ |
| GitHub Stars | 15K+ | 45K+ | 20K+ | 50K+ | 12K+ |
| 核心范式 | Handoff交接 | 事件驱动Actor | 图状态机 | SOP流水线 | 角色扮演 |
| 上手难度 | ★☆☆☆☆ | ★★★☆☆ | ★★★☆☆ | ★★☆☆☆ | ★★☆☆☆ |
| 灵活度 | 中等 | 极高 | 极高 | 低(固定流程) | 中等 |
| 可观测性 | 基础Trace | 内置AgentChat | LangSmith集成 | 日志 | 基础 |
| 状态持久化 | 无 | 有 | 有(外部存储) | 有 | 无 |
| 人机协作 | Guardrail | 支持 | 原生支持 | 有限 | 无 |
| 适用场景 | 快速原型、简单编排 | 复杂多Agent系统 | 企业工作流 | 软件开发 | 教育、创意 |
| 变现潜力 | ★★★★☆ | ★★★★★ | ★★★★★ | ★★★☆☆ | ★★★☆☆ |
Zylos Research 2026年3月发布的研究揭示了多智能体系统中一个被长期忽视的现象——涌现行为(Emergent Behavior)。当LLM驱动的Agent在大规模交互时,系统整体会表现出任何单个Agent未被编程产生的行为:
这些发现对多智能体系统的设计和部署提出了新的挑战——系统行为不再是各Agent行为的简单叠加,而是涌现出不可预测的宏观特性。研究者提出的应对策略包括:
根据2026年企业AI Agent中期报告,54%的企业已将AI Agent部署到生产环境。成功的企业级多智能体部署通常遵循以下模式:
阶段1: 单Agent + 工具 → 验证业务价值
阶段2: Supervisor + 2-3个Worker Agent → 处理多领域任务
阶段3: 层级式团队 + 外部Agent集成 → 企业级编排
阶段4: 混合编排 + A2A/MCP协议栈 → 跨组织互操作
不要试图一步到位构建最复杂的多智能体架构。从单Agent开始验证业务假设,再逐步增加Agent数量和编排复杂度。
企业级系统的核心挑战是状态一致性。LangGraph的PostgreSQL状态检查点(Checkpoint)模式是目前最成熟的方案——每个Agent执行步骤后自动将状态快照写入数据库,支持故障恢复和时间旅行调试。
多智能体系统的LLM调用成本容易失控。推荐做法: - 分层模型策略:Supervisor使用GPT-4o级别模型,Worker使用GPT-4o-mini或Claude Haiku - Token预算:为每个Agent设置单次会话的Token上限 - 缓存复用:相似请求共享中间结果,避免重复计算
LangSmith / Arize Phoenix → Trace追踪
Prometheus + Grafana → 性能监控
自定义Dashboard → 业务指标追踪
| 场景 | 推荐框架 | 推荐架构 | 协议选择 |
|---|---|---|---|
| 快速原型验证 | OpenAI Agents SDK | Handoff | 无需额外协议 |
| 企业工作流自动化 | LangGraph | Supervisor + 层级 | MCP(工具访问) |
| 复杂研究分析 | AG2 | 事件驱动 + GroupChat | A2A(跨Agent) |
| 软件开发模拟 | MetaGPT | SOP流水线 | MCP |
| 创意/教育协作 | CAMEL-AI | 角色扮演 | 无 |
| 跨组织Agent互操作 | LangGraph + A2A | 混合编排 | A2A + MCP |
| 大规模分布式任务 | AG2 + ANP | 去中心化Swarm | ANP |
| 金融/医疗合规场景 | LangGraph + ACP | Supervisor + 审批节点 | ACP |
以下是一个基于LangGraph和OpenAI Agents SDK思想的完整示例,展示如何构建一个三层多智能体系统:
"""
三层多智能体研究系统
Layer 1: 顶级Supervisor(任务分类)
Layer 2: 团队Supervisor(领域协调)
Layer 3: 专项Worker(执行具体任务)
"""
from langgraph.graph import StateGraph, START, END
from typing import TypedDict, Annotated, Literal
import operator

# === 状态定义 ===
class ResearchState(TypedDict):
    query: str
    domain: Literal["tech", "market", "academic"]
    subtasks: list[str]
    findings: Annotated[list[str], operator.add]
    report: str
    current_step: str

# === Layer 3: Worker Agents ===
def web_searcher(state: ResearchState) -> dict:
    """网络搜索Worker"""
    task = state["subtasks"].pop(0) if state["subtasks"] else state["query"]
    results = search_tool(task)  # 假设已定义
    return {"findings": [f"[Web] {results}"], "current_step": "web_done"}

def data_analyst(state: ResearchState) -> dict:
    """数据分析Worker"""
    data = extract_data(state["findings"])
    analysis = analyze_with_llm(data)
    return {"findings": [f"[Analysis] {analysis}"], "current_step": "analysis_done"}

def report_writer(state: ResearchState) -> dict:
    """报告撰写Worker"""
    report = synthesize_report(state["findings"])
    return {"report": report, "current_step": "complete"}

# === Layer 2: 团队Supervisor ===
def research_supervisor(state: ResearchState) -> dict:
    """研究团队协调者"""
    if not state.get("findings"):
        return {"current_step": "search", "subtasks": decompose(state["query"])}
    elif len(state["findings"]) < 3:
        return {"current_step": "analyze"}
    else:
        return {"current_step": "write"}

# === Layer 1: 顶级路由 ===
def top_router(state: ResearchState) -> dict:
    """顶级路由:判断请求领域"""
    domain = classify_domain(state["query"])
    return {"domain": domain, "current_step": "delegate"}

# === 构建图 ===
graph = StateGraph(ResearchState)

# 添加节点
graph.add_node("router", top_router)
graph.add_node("team_supervisor", research_supervisor)
graph.add_node("searcher", web_searcher)
graph.add_node("analyst", data_analyst)
graph.add_node("writer", report_writer)

# 定义路由边
graph.add_edge(START, "router")
graph.add_edge("router", "team_supervisor")
graph.add_conditional_edges(
    "team_supervisor",
    lambda s: s["current_step"],
    {"search": "searcher", "analyze": "analyst",
     "write": "writer", "complete": END}
)
graph.add_edge("searcher", "team_supervisor")
graph.add_edge("analyst", "team_supervisor")
graph.add_edge("writer", END)

app = graph.compile()
多智能体系统的下一步演进方向已清晰可见:
协议融合:A2A、MCP、ACP正在从竞争走向互补。2026年下半年的关键看点是MCP Server Cards与A2A Agent Card的桥接机制,以及是否会形成统一的"Agent Protocol Stack"。
涌现行为治理:随着Agent规模从十级扩展到百级、千级,涌现行为的可预测性和可控性将成为核心研究课题。我们可能会看到"涌现行为审计框架"成为多智能体系统的标准组件。
Agent原生操作系统:AG2提出的"AgentOS"概念正在变为现实——一个为Agent提供身份管理、资源调度、安全沙盒的操作系统层。这将改变多智能体系统的部署方式,从"在应用中嵌入Agent"变为"在AgentOS中运行Agent应用"。
训练成本的断崖下降:随着开源模型(DeepSeek、Llama 4、Qwen)能力的持续提升,多智能体系统中使用专有模型的成本压力将显著缓解。这意味着2027年的多智能体系统可能大量运行在本地部署的开源模型上,进一步降低企业部署门槛。
多智能体系统正在从"有趣的研究方向"转变为"必要的基础设施"。选择正确的架构模式和通信协议,将成为AI工程师2026年最重要的技术决策之一。
[!tip] 51学通信知识星球 星主:爱卫生(微信:gprshome201101)——公众号「51学通信」创办者,19 年通信行业运维与讲师经验,著有《GPRS网络信令实例详解》《EPC原理与实践》《5G核心网原理与实践》三本纸质书(各大电商平台有售)。 星球定位:深耕 5G 核心网、IMS、NFV/AI、云原生等 ICT 领域,主打运维岗位与信令分析。 当前规模:5200 篇主题 / 990 个回答,198 元/年。 加入福利:加入星球后请加爱卫生微信,拉您进知识星球年度陪伴与答疑群——不限量回复您的各种问题,另有群内分享。 AI 加持:51学通信知识星球已作为 skill 接入 WorkBuddy,使用 deepseek-4-flash 在海量星球帖子中精准找贴、找视频、找 FAQ 和案例,做总结、找文档和 PPT 等场景全覆盖。
