当企业将AI Agent从原型推向生产时,一个残酷的事实浮出水面:你计算的API账单只是真实成本的10-20%。2026年行业数据显示,88%的企业级AI Agent项目从未到达生产环境,每个失败项目平均烧掉34万美元。核心问题不在于Token单价——Token确实越来越便宜——而在于自主Agent系统独有的成本放大机制:重试风暴、上下文雪崩、失败级联、多Agent依赖环路。本文提出以CPST(Cost Per Successful Task,单次成功任务成本)为核心的单位经济学框架,拆解七大成本黑洞的真实数据与治理方案,帮助团队把Agent从"能跑"变成"跑得起"。
传统云应用的计费模型是线性的——多用一倍资源,多付一倍钱。但自主Agent的经济学完全不同。一个Agent执行任务可能需要3-15轮循环(Agent Loop),每轮包含LLM推理、工具调用、上下文累积。根据Keito AI和Google Cloud的联合研究数据:
| 指标 | 普通聊天机器人 | 自主Agent(中等复杂度) |
|---|---|---|
| 单次交互Token消耗 | 800-1,500 | 8,000-30,000+ |
| 成功率(首次完成) | 85-95% | 40-65% |
| 平均重试次数 | 0.1-0.3 | 1.5-4.2 |
| 真实成本/Token标称成本比 | 1.1-1.3x | 3-7x |
| 故障成本/成功成本比 | 1.5x | 5-15x |
这意味着,当你看到GPT-4o的标价是$2.50/M token时,一个实际Agent任务的Token成本可能是标价的5-7倍——因为失败任务同样消耗Token,且失败任务往往在更深的循环层级才暴露。
CPST公式(来源:Google Cloud Agent KPI白皮书 + Keito AI研究):
CPST = (总Token消耗 × Token单价 + 工具调用成本 + 基础设施成本)
       / 成功完成任务数

其中:
总Token消耗 = Σ(每轮循环的输入Token + 输出Token) × 平均循环次数
成功完成任务数 = 总任务数 × 任务成功率
关键洞察:分母是成功任务数,不是总任务数。如果一个Agent的成功率只有50%,CPST就是标称成本的2倍起步——还没算重试消耗。
自主Agent执行失败后的重试不是简单的"再来一次"。在多Agent系统中,Agent A的失败会触发Agent B和Agent C的重试,形成级联效应。Tian Pan的研究显示,朴素重试逻辑(Naive Retry)可造成200倍的Token成本放大。
自动化实验室(Automation Labs)追踪了一个生产Agent系统的Token预算分布:
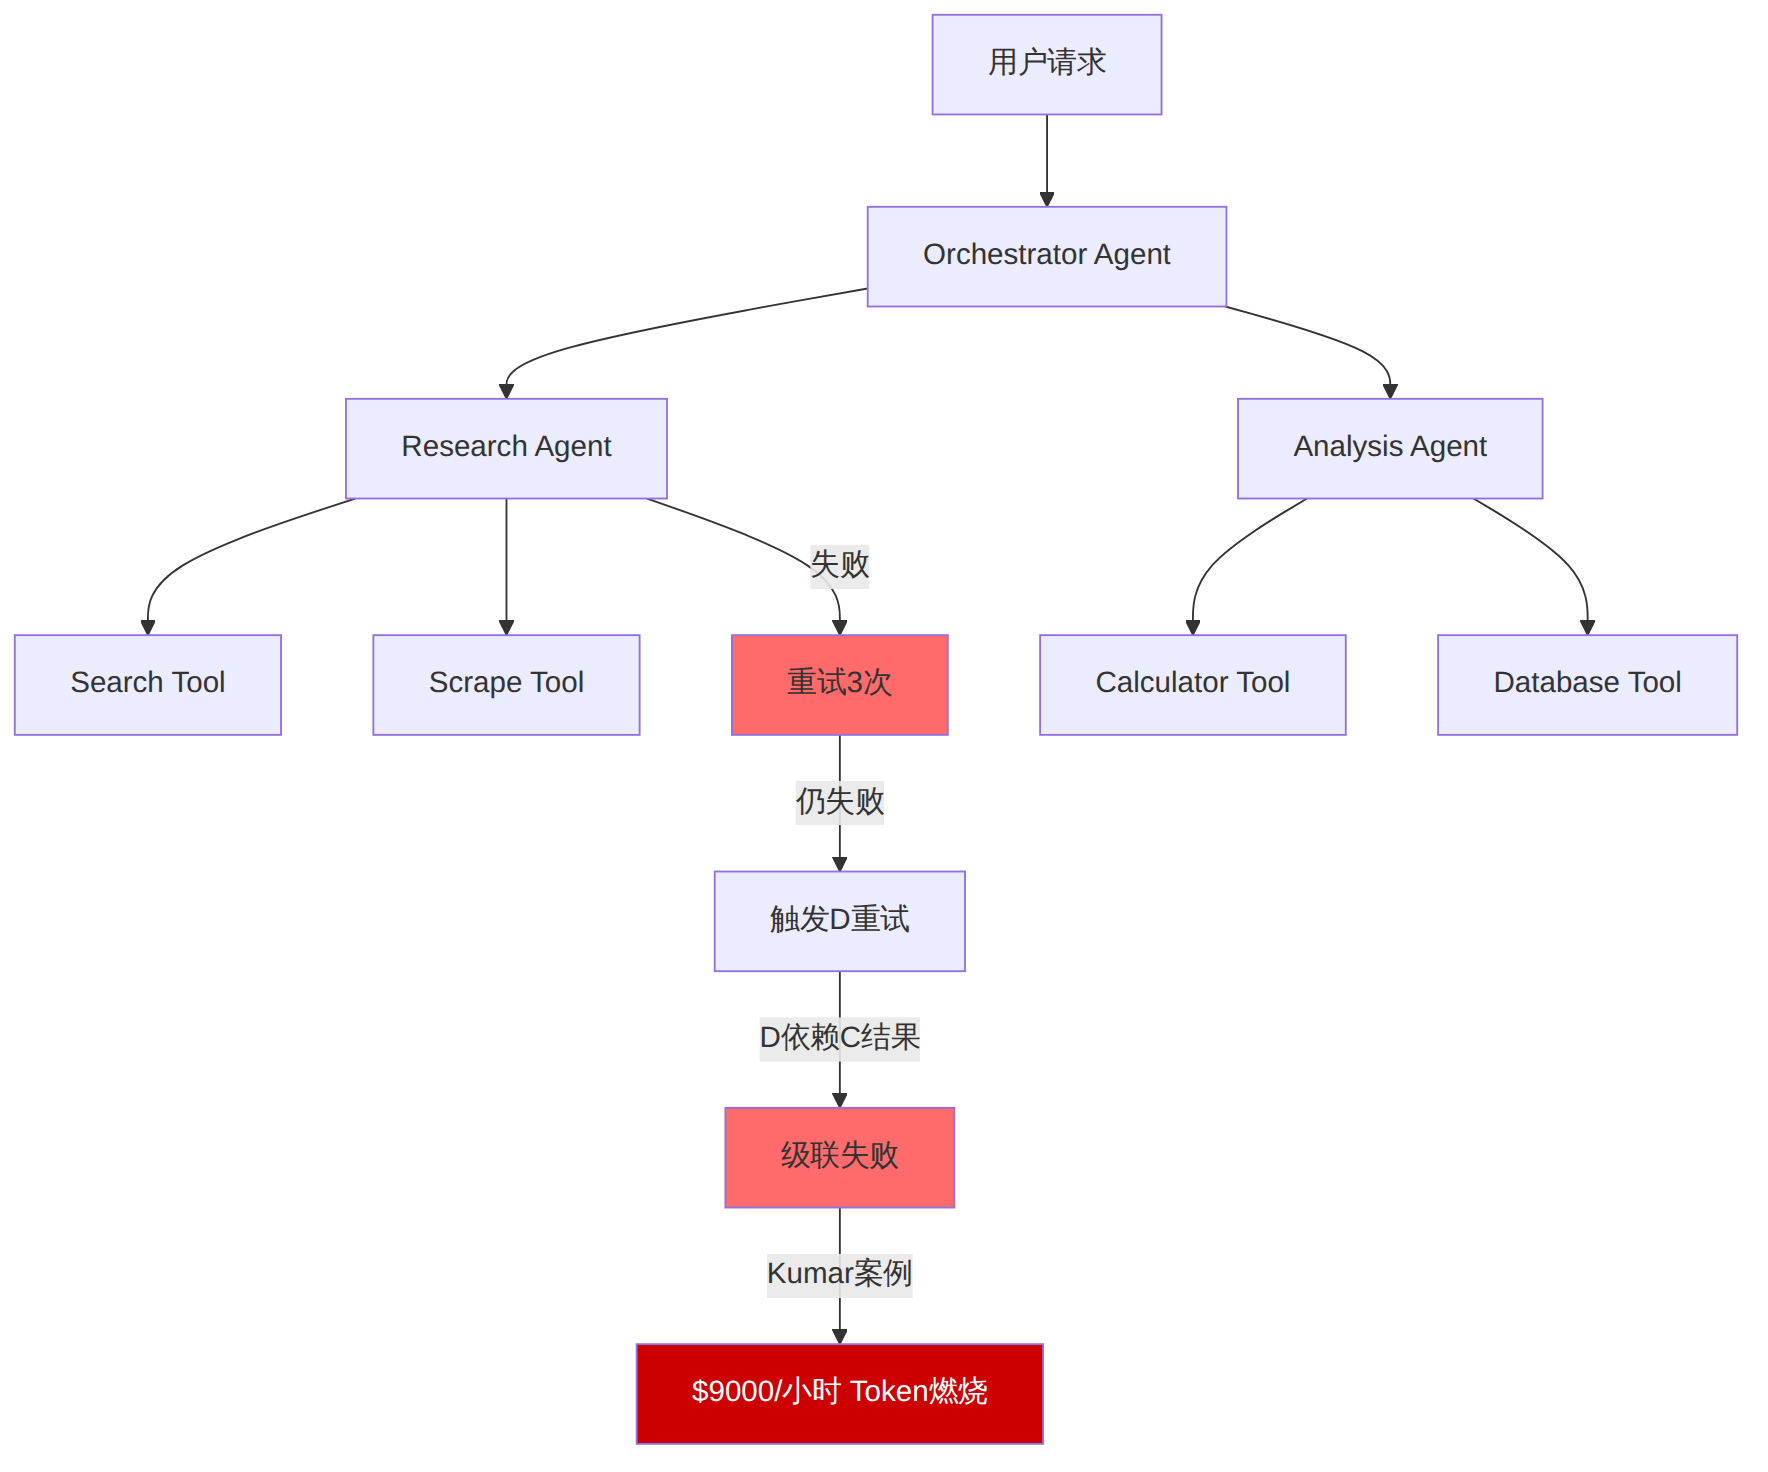
更触目惊心的是TokenFence的案例分析:一个多Agent依赖系统中,Agent A超时 → 触发Agent B重试 → Agent B依赖Agent A的结果 → 再次超时 → 级联到Agent C、D、E……一个本应$2的单次API调用,最终在47分钟的级联重试中燃烧了$212。
class AgentCircuitBreaker:
    def __init__(self, failure_threshold=3, token_velocity_limit=50000):
        self.failure_count = 0
        self.failure_threshold = failure_threshold
        self.token_velocity_limit = token_velocity_limit
        self.state = "CLOSED"  # CLOSED -> OPEN -> HALF_OPEN

    def before_request(self, agent_run):
        if self.state == "OPEN":
            raise CircuitOpenError("Agent circuit breaker tripped")
        # 检测Token消耗速率
        if agent_run.tokens_consumed_rate > self.token_velocity_limit:
            self.trip()

    def on_failure(self, agent_run):
        self.failure_count += 1
        if self.failure_count >= self.failure_threshold:
            self.trip()

    def trip(self):
        self.state = "OPEN"
        alert_team(f"Circuit breaker OPEN — token waste detected")
PaperclipAI开源项目已将此模式落地为可复用组件(GitHub issue #390)。
Agent Loop的每一轮循环,都需要将前几轮的完整历史作为上下文传给LLM。第1轮传入N个token,第2轮传入2N,第3轮传入3N……k轮后的总Token消耗是N×k(k+1)/2,即二次方增长。
AugmentCode的实测数据显示:
| 循环轮次 | 累积上下文Token | 本轮新增Token | 占总消耗比例 |
|---|---|---|---|
| 1 | 2,000 | 2,000 | 5% |
| 3 | 8,000 | 4,000 | 12% |
| 5 | 20,000 | 6,000 | 18% |
| 8 | 50,000 | 10,000 | 28% |
| 12 | 110,000+ | 15,000+ | 37%+ |
一个12轮的Agent任务,第12轮单轮消耗占整个任务的近40%——而且第12轮往往是最可能失败的那轮。
def manage_context(conversation_history, max_context_tokens=4000):
    # 策略1:滑动窗口 — 只保留最近K轮
    if token_count(conversation_history) > max_context_tokens * 2:
        # 保留系统提示 + 最近3轮 + 工具结果摘要
        recent = conversation_history[-6:]  # 最近3轮(每轮2条消息)
        older = conversation_history[:-6]

        # 策略2:对历史轮次生成摘要
        summary = llm_summarize(older, max_tokens=500)
        return [SystemMessage(summary)] + recent

    return conversation_history
Mem0团队的实战数据表明,结合滑动窗口和摘要压缩,可将上下文Token消耗降低3-4倍,且对任务成功率的影响小于5%。
AgentMarketCap 2026年4月的调研报告揭示了一组令人震惊的数据:
Agent ROI = (人工成本/任务 - CPST) × 月任务量 × 12 - 一次性开发成本

盈亏平衡点 = 一次性开发成本 / ((人工成本/任务 - CPST) × 月任务量)
关键发现:只有当任务成功率 > 70%且CPST < 人工成本的50%时,Agent项目才能在12个月内回本。低于这个阈值,每降低10%的成功率,ROI回本周期延长约4个月。
当多个Agent形成依赖链时,一个节点的故障会产生连锁反应。LinkedIn上Kumar L分享的生产数据显示:
图表 1
在编排层引入DAG(有向无环图)依赖管理:
class AgentDAG:
    def execute(self, task):
        dag = build_dependency_graph(task.agents)
        results = {}
        for level in dag.topological_levels():
            # 同层级Agent并行执行
            level_results = parallel_execute(level, budget_per_agent=task.budget/len(dag.levels))
            failed = [r for r in level_results if not r.success]
            if failed and not task.continue_on_failure:
                # 熔断:不执行下游依赖
                cancel_downstream(dag, [r.agent_id for r in failed])
                break
            results.update({r.agent_id: r for r in level_results})
        return results
百度开发者中心和中国多位独立研究者的实测揭示了一个被广泛忽视的现象:Agent即使不在执行任务,也在持续消耗Token。这种"呼吸成本"(Breathing Cost)来自三个场景:
一个"中等复杂度"企业Agent(5个工具 + RAG + 8轮平均循环):
| 成本项 | Token消耗/任务 | 占比 |
|---|---|---|
| 实际推理Token(有用部分) | 4,200 | 14% |
| 系统提示词重复传输 | 12,000 | 39% |
| RAG检索注入 | 9,000 | 29% |
| 工具描述重复 | 4,000 | 13% |
| 对话历史累积 | 1,800 | 5% |
| 总计 | 31,000 | 100% |
86%的Token消耗是"呼吸成本"——与当前推理轮次无关的固定开销。
请求 → 语义缓存(Redis) → 命中?→ 返回缓存结果(节省100%)
                              ↓ 未命中
       系统提示缓存 → 已存储在LLM Provider侧(节省100%)
                              ↓
       工具描述精简 → 只传本次可能用到的工具(节省60-80%)
                              ↓
       RAG结果缓存 → 相似度>0.95的查询复用(节省70-90%)
                              ↓
       LLM推理 → 实际调用
Redis官方2026年的优化指南显示,结合语义缓存+系统提示预填充+工具按需加载,可将呼吸成本从86%降至25-35%。
2024年,行业焦虑的是训练成本。2026年,战场转移到了推理成本:
NVIDIA在Blackwell架构发布时提供了一个Agentic AI成本模型:
总推理成本 = Token单价 × (正常消耗 + 循环放大 + 重试冗余 + 上下文累积)

其中循环放大因子 = 1 + (平均循环次数 - 1) × 上下文增长率
重试冗余因子 = 1 / 任务成功率
上下文累积因子 = 平均循环次数 × (1 + 平均循环次数) / 2
这意味着,即使Token单价降为零(假设),如果Agent系统的循环放大和重试冗余不受控,基础设施成本(GPU占用时间、KV Cache内存)仍然会让总成本失控。
基于AgileLeadershipDayIndia和Alphabold的综合研究:
| 维度 | 自建(LangGraph/CrewAI) | SaaS平台采购 | 混合模式 |
|---|---|---|---|
| 初始开发 | $100K-$500K | $200-$400/月 | $50K-$150K + $100-300/月 |
| 上线周期 | 4-12个月 | 1-4周 | 2-4个月 |
| 月度Token成本 | 按用量(无加价) | 平台加价30-80% | 核心按用量+平台加价 |
| 运维人力 | 1-2 FTE | 0 | 0.5 FTE |
| 定制自由度 | 完全自由 | 受限 | 中等 |
| 12个月TCO | $200K-$800K | $50K-$200K | $100K-$350K |
| 盈亏平衡点 | 15-18个月后 | 立即 | 6-10个月 |
IF 任务复杂度 > 行业平均水平
   AND 有LLM工程团队(>2人)
   AND 预计使用周期 > 18个月
   → 自建

IF 标准化场景(客服/文档QA/数据提取)
   AND 需要快速验证
   → SaaS采购

IF 核心流程需定制 + 非核心模块可标准化
   → 混合模式
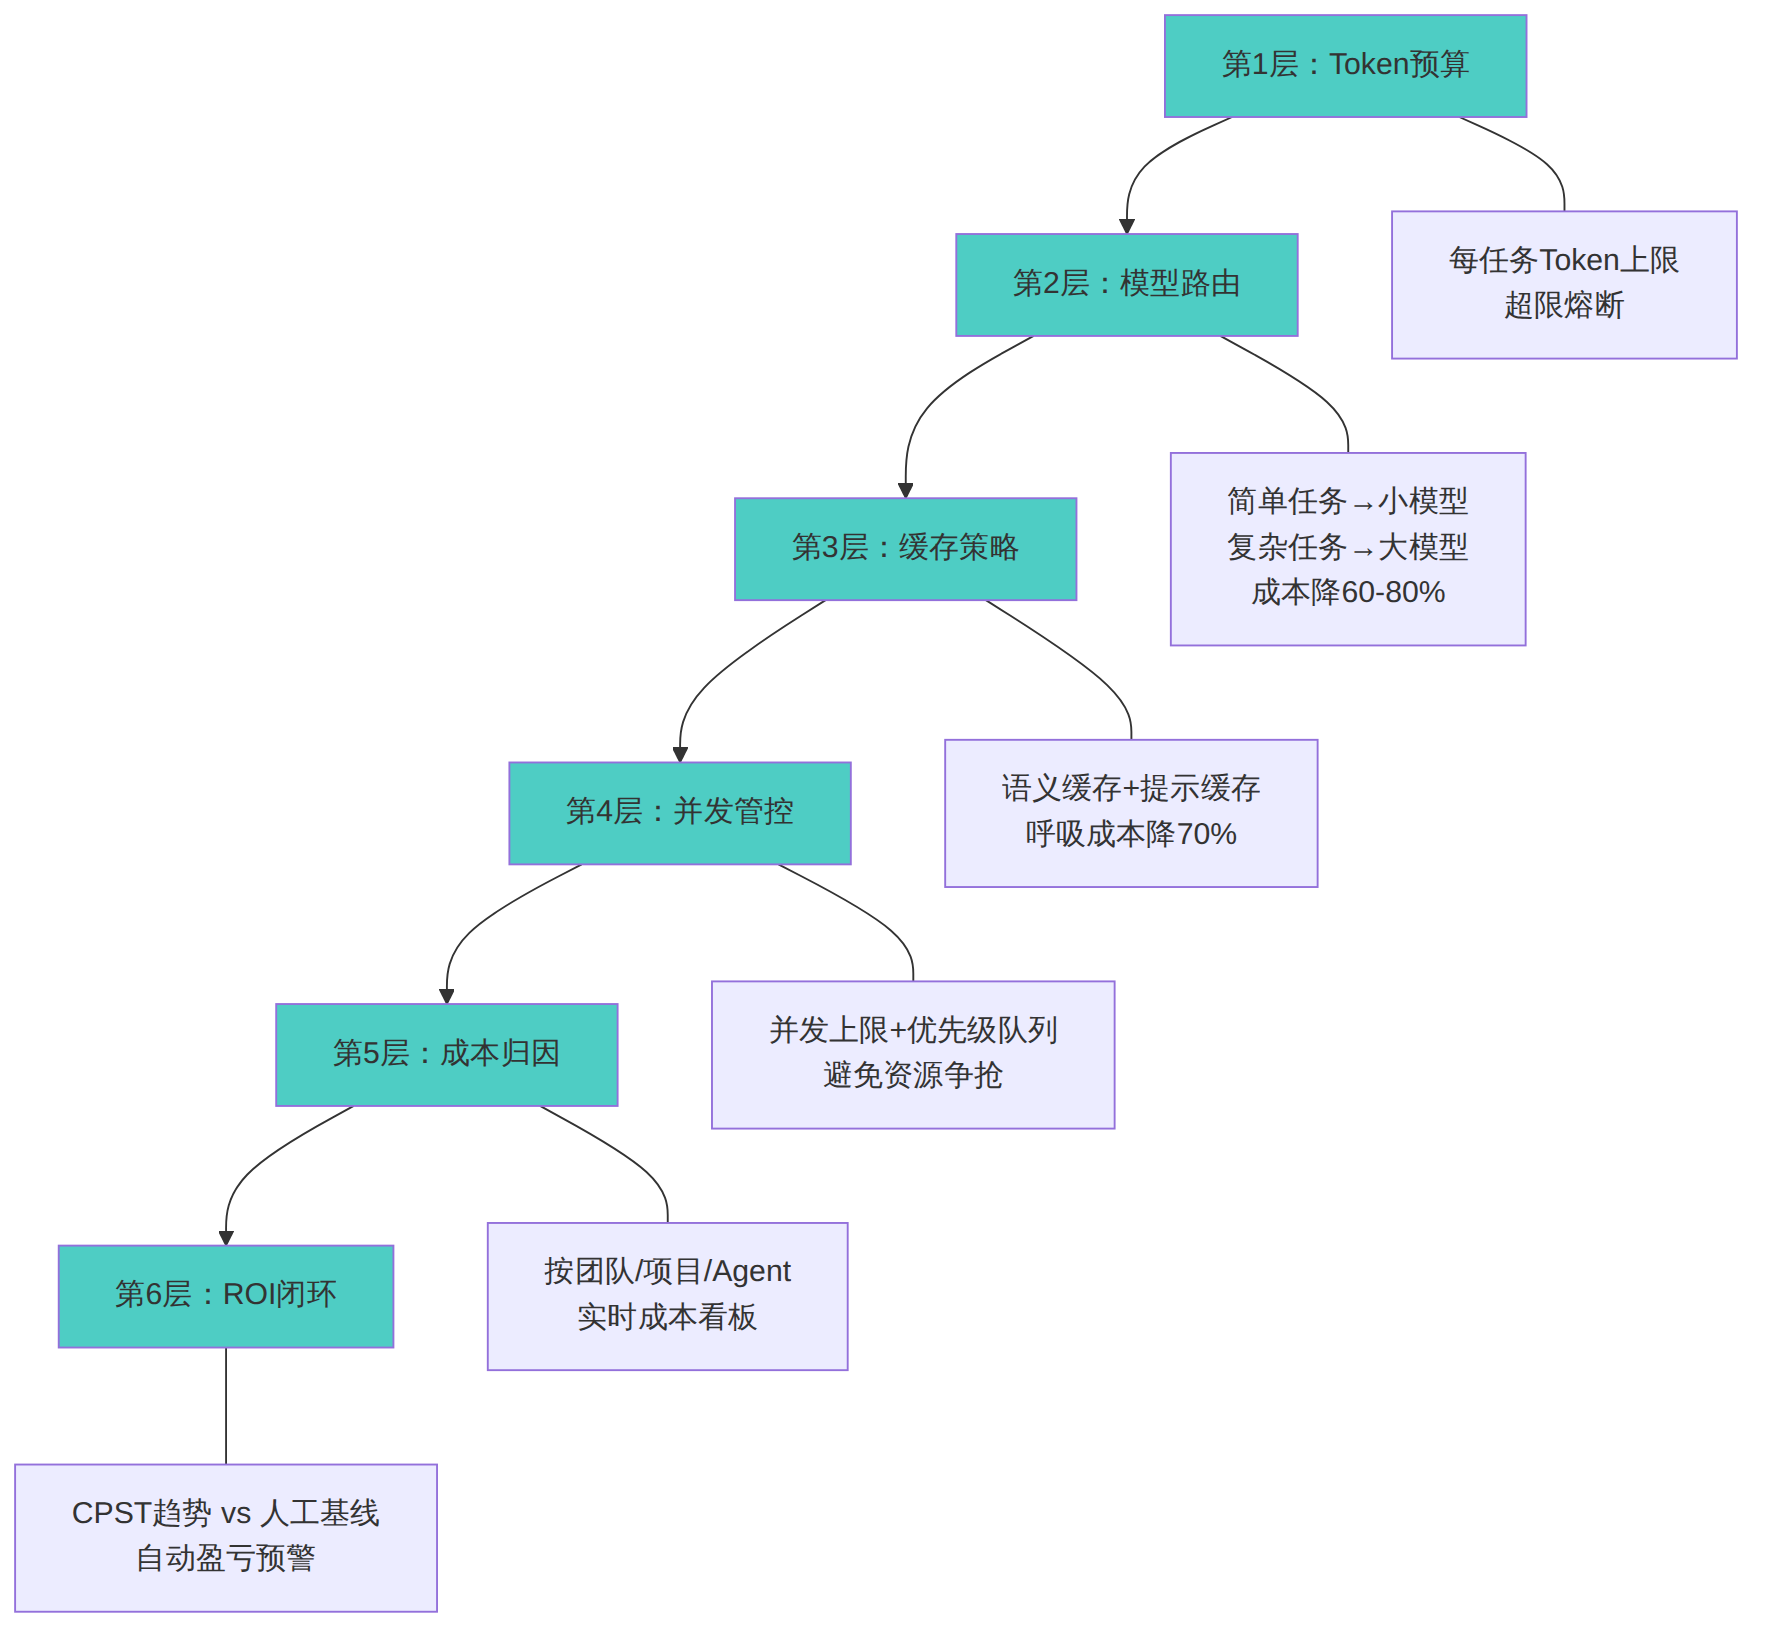
基于TokenStar、腾讯云ADP和FinOps基金会的综合实践,企业级Agent成本治理应包含六层:
图表 2
| 层级 | 核心指标 | 目标值 | 告警阈值 |
|---|---|---|---|
| Token预算 | Token/任务 | < 设定预算的80% | > 预算的120% |
| 模型路由 | 路由准确率 | > 85% | < 70% |
| 缓存策略 | 缓存命中率 | > 40% | < 15% |
| 并发管控 | 资源利用率 | 60-80% | > 95% 或 < 30% |
| 成本归因 | 成本可见度 | 100%覆盖 | 有未归因成本 |
| ROI闭环 | CPST/人工成本比 | < 0.5 | > 0.7 |
| 场景 | 推荐方案 | 预期CPST | 关键工具 |
|---|---|---|---|
| 客服Agent | SaaS + 缓存栈 | $0.01-0.05/任务 | Redis语义缓存 + GPT-4o-mini路由 |
| 代码生成Agent | 自建 + 模型路由 | $0.10-0.50/任务 | LangGraph + 模型路由网关 |
| 数据分析Agent | 混合 + DAG编排 | $0.05-0.30/任务 | CrewAI + DAG熔断器 |
| 文档处理Agent | SaaS + 批处理 | $0.02-0.10/页 | Azure Document Intelligence + 缓存 |
| 研究助理Agent | 自建 + 上下文管理 | $0.20-1.00/任务 | AutoGen + 滑动窗口 + 摘要压缩 |
AI Agent的成本问题本质上不是"Token太贵",而是系统设计中缺乏经济学约束。CPST(单次成功任务成本)应该是每个Agent项目的第一优先级指标——在写第一行代码之前就建立基线,在每次迭代中追踪趋势。88%的失败率不是技术能力问题,是经济学建模缺失问题。当你能准确测量CPST、识别七大成本黑洞、建立六层治理框架时,你就能成为那成功的12%。
[!tip] 51学通信知识星球 星主:爱卫生(微信:gprshome201101)——公众号「51学通信」创办者,19 年通信行业运维与讲师经验,著有《GPRS网络信令实例详解》《EPC原理与实践》《5G核心网原理与实践》三本纸质书(各大电商平台有售)。 星球定位:深耕 5G 核心网、IMS、NFV/AI、云原生等 ICT 领域,主打运维岗位与信令分析。 当前规模:5200 篇主题 / 990 个回答,198 元/年。 加入福利:加入星球后请加爱卫生微信,拉您进知识星球年度陪伴与答疑群——不限量回复您的各种问题,另有群内分享。 AI 加持:51学通信知识星球已作为 skill 接入 WorkBuddy,使用 deepseek-4-flash 在海量星球帖子中精准找贴、找视频、找 FAQ 和案例,做总结、找文档和 PPT 等场景全覆盖。
