2026年AI领域最反直觉的现象正在发生:单Token价格三年内暴跌1000倍,企业AI总支出却暴增320%。这就是"推理成本悖论"——Agent系统的多轮循环、工具调用、上下文累积导致Token消耗呈指数级增长,远非简单的单价下降所能对冲。本文从真实账单数据出发,拆解Agent系统的Token通胀机制,对比七大主流模型的性价比基准,解析OPPO团队提出的Efficient Agents框架如何以28.4%的成本削减保持96.7%的性能,并给出可落地的五层降本架构与企业级定价策略分析。
2025年,GPT-4级别模型的单Token输入价格从最初的$30/百万Token骤降至$2/百万Token,降幅达93%。然而,Gartner与多份行业报告显示,企业级AI支出同期增长了320%。这不是定价骗局,而是经济学中的"杰文斯悖论"(Jevons Paradox)在AI领域的完美重演。
核心机制:Agent的Token乘数效应。 一个传统聊天机器人的请求-响应对大约消耗500-2000个Token。但一个典型的Agent工作流包含:任务规划(1轮)→ 工具选择与调用(2-5轮)→ 结果验证与重试(1-3轮)→ 最终响应合成(1轮),总计4-10轮LLM调用,加上每轮累积的上下文窗口,单个任务的Token消耗可飙升至50,000-500,000个。这意味着Agent模式下的成本是简单聊天的50-250倍。
更关键的是,Agent系统的上下文呈二次增长。第N轮调用需要携带前N-1轮的完整历史,导致每次调用的输入Token数持续膨胀。一个执行10步的任务,其Token消耗不是线性增长,而是接近 O(N²) 的曲线。
Token消耗对比(典型客服场景)
┌──────────────────┬──────────────┬─────────────┐
│ 场景              │ Token/任务   │ 成本(GPT-4)  │
├──────────────────┼──────────────┼─────────────┤
│ 简单问答          │ ~1,000       │ $0.003      │
│ RAG检索+回答      │ ~8,000       │ $0.024      │
│ 单Agent工具调用   │ ~50,000      │ $0.150      │
│ 多Agent协作(3个)  │ ~200,000     │ $0.600      │
│ 复杂编排(5轮重试)  │ ~800,000     │ $2.400      │
└──────────────────┴──────────────┴─────────────┘
这就是为什么诸多初创团队在POC阶段感觉"AI很便宜",上线后却发现月度API账单从三位数直接跳到五位数。
选择合适的底层模型是成本优化的第一步。2026年5月,主流模型的定价已经形成清晰的阶梯结构。
| 模型 | 输入价格($/1M) | 输出价格($/1M) | Agent适用场景 | 性价比评级 |
|---|---|---|---|---|
| GPT-4.1 | $2.00 | $8.00 | 复杂规划/推理 | ★★★★ |
| GPT-4.1 mini | $0.40 | $1.60 | 工具调用/中间步骤 | ★★★★★ |
| GPT-4.1 nano | $0.10 | $0.40 | 分类/路由/简单提取 | ★★★★★ |
| Claude Sonnet 4 | $3.00 | $15.00 | 代码生成/长文分析 | ★★★★ |
| Claude Haiku 3.5 | $0.80 | $4.00 | 快速分类/意图识别 | ★★★★ |
| Gemini 2.5 Pro | $1.25 | $10.00 | 多模态Agent | ★★★★★ |
| Gemini 2.5 Flash | $0.15 | $0.60 | 高频调用/批处理 | ★★★★★ |
| DeepSeek V3 | $0.27 | $1.10 | 预算敏感型Agent | ★★★★ |
关键发现:Agent场景的最优模型选择与纯对话场景截然不同。 对话场景可能只需要一个旗舰模型走天下,但Agent场景需要"模型路由"——不同步骤使用不同能力的模型。
一个实际案例:某SaaS公司将其客服Agent的三步流程分别路由到不同模型:
原始方案:全程GPT-4.1 → 单次对话成本 $0.12
优化方案:
  - 意图识别:GPT-4.1 nano → $0.001
  - 知识检索+工具调用:GPT-4.1 mini → $0.015
  - 最终回答生成:GPT-4.1 → $0.02
  → 单次对话成本 $0.036(降低70%)
在SWE-bench Verified基准上,基于成本效益分析(cost-of-pass,即成功解决一个问题所需的平均总成本),不同Agent方案呈现出巨大差异:
| Agent系统 | SWE-bench通过率 | 平均Token/任务 | 估算成本/任务 |
|---|---|---|---|
| OpenAI Codex Agent | 72.0% | ~150K | ~$0.45 |
| Claude Code | 70.3% | ~180K | ~$0.72 |
| SWE-agent + GPT-4.1 | 52.0% | ~350K | ~$1.40 |
| AutoCodeRover | 48.5% | ~280K | ~$1.10 |
| Agentless (文件级) | 35.0% | ~80K | ~$0.24 |
这个数据揭示了一个重要规律:最高通过率的Agent往往不是最贵的,但也不是最便宜的。 关键在于Token使用的"精度"——是否在需要推理的步骤投入足够算力,在简单步骤上保持精简。
Agent的每一次LLM调用都在"滚雪球"。以一个典型的工作流为例:
# 典型Agent Loop的上下文增长
step_1_context = system_prompt + user_task  # ~2K tokens
step_2_context = step_1_context + step_1_output + tool_result  # ~8K tokens
step_3_context = step_2_context + step_2_output + tool_result  # ~18K tokens
# ... 到第10步时,可能已超过100K tokens
解法:滑动窗口摘要。 每隔N步对历史上下文进行压缩摘要,将线性增长的上下文压缩为固定大小。
def sliding_context_with_summary(history, max_steps=5):
    """保留最近N步完整上下文,更早的步骤压缩为摘要"""
    if len(history) <= max_steps:
        return history

    recent = history[-max_steps:]
    older = history[:-max_steps]

    summary = llm.summarize(
        f"将以下历史步骤压缩为简洁摘要:\n{older}",
        model="gpt-4.1-nano"  # 用最便宜的模型做摘要
    )

    return [{"role": "system", "content": f"历史摘要:{summary}"}] + recent
每个传递给Agent的工具定义(Function/Tool Schema)都会占用上下文Token。一个注册了20个工具的Agent,仅工具定义就可能消耗2,000-5,000个Token,且每次调用都要重复发送。
解法:动态工具筛选。 根据当前步骤的意图,只传递相关的工具子集。
def select_relevant_tools(user_intent, all_tools, model="gpt-4.1-nano"):
    """用廉价模型先做工具相关性判断"""
    tool_names = [t["name"] for t in all_tools]
    relevant = llm.chat(
        model=model,
        messages=[{
            "role": "user",
            "content": f"任务:{user_intent}\n可用工具:{tool_names}\n选出3-5个最相关的工具名"
        }]
    )
    return [t for t in all_tools if t["name"] in relevant]
Agent在执行失败时常常进入"重试螺旋"——同样的错误反复尝试,每次都携带完整的失败历史。某研究报告指出,约23%的Agent Token消耗来自重试循环。
解法:设置Token预算硬上限和指数退避策略。
class TokenBudgetManager:
    def __init__(self, max_tokens=50000, warning_ratio=0.8):
        self.max_tokens = max_tokens
        self.consumed = 0
        self.warning_threshold = max_tokens * warning_ratio

    def check_budget(self, estimated_tokens):
        if self.consumed + estimated_tokens > self.max_tokens:
            if self.consumed < self.warning_threshold:
                # 第一次触及警告线:降级到更便宜的模型
                return "downgrade_model"
            else:
                # 超出预算:强制返回最佳猜测
                return "force_return"
        return "proceed"

    def record_usage(self, tokens_used):
        self.consumed += tokens_used
部分Agent框架(尤其是带ReAct模式的系统)倾向于在每一步都进行详细的"思考-分析-计划",即使任务本身很简单。这种"过度规划"在简单任务上浪费3-5倍的Token。
解法:任务复杂度预判,动态切换Agent模式。
def should_use_agent_mode(task_description):
    """判断是否需要完整Agent循环,还是直接单次调用即可"""
    indicators_of_complexity = [
        "多个步骤", "需要查找", "调用工具", "验证", "比较"
    ]
    simple_indicators = [
        "翻译", "总结", "分类", "改写"
    ]

    # 用nano模型做快速分类
    result = llm.chat(
        model="gpt-4.1-nano",
        messages=[{
            "role": "user",
            "content": f"判断任务复杂度(简单/复杂):{task_description}"
        }]
    )
    return "复杂" in result
使用JSON Mode或Structured Output时,模型需要输出大量格式化Token(花括号、键名、引号等)。一个5个字段的JSON结构,格式化Token可能占输出总量的30-50%。
解法:使用最简Schema + 后处理填充。
# 不推荐:让LLM输出完整JSON
schema = {
    "name": "string",
    "age": "integer",
    "email": "string",
    "address": "string",
    "phone": "string"
}
# LLM需要输出:{"name": "张三", "age": 25, ...} 约60 tokens

# 推荐:让LLM输出简短格式,后处理转换
prompt = "用|分隔输出:姓名|年龄|邮箱|地址|电话"
# LLM输出:张三|25|[email protected]|北京|1380000 约20 tokens
# Token节省约67%
OPPO个人AI实验室发布的《Efficient Agents》论文(arXiv:2508.02694)提出了一个革命性的评估指标——cost-of-pass,即"成功解决一个问题的平均总成本"。这个指标将准确率和成本统一为单一衡量标准。
研究团队在OWL(Open Web Learning)框架上进行了大规模实验,测试了不同的模型选择、记忆策略、工具配置和规划模式的组合,得出五项关键发现:
OPPO开源了OAgents框架(github.com/OPPO-PersonalAI/OAgents),其核心是一个智能路由层:
class EfficientAgent:
    def __init__(self):
        self.models = {
            "planner": "gpt-4.1",        # 规划:强模型
            "executor": "gpt-4.1-mini",   # 执行:中等模型
            "validator": "gpt-4.1-nano",  # 验证:弱模型
        }
        self.token_budget = 100000  # 单任务Token上限

    async def run(self, task):
        # Step 1: 规划(强模型,但只调用一次)
        plan = await self.llm("planner",
            f"为以下任务制定执行计划(不超过5步):\n{task}")

        results = []
        for step in plan.steps:
            # Step 2: 执行(弱模型,可多次调用)
            result = await self.llm("executor",
                f"执行步骤:{step}\n上下文:{self._sparse_context(results)}")

            # Step 3: 快速验证(最弱模型,一次调用)
            check = await self.llm("validator",
                f"判断结果是否有效(是/否):{result}")

            if check == "是":
                results.append(result)
            else:
                results.append(await self._retry_with_hint(step, result))

        return self._synthesize(results)
实验结果:在保持OWL框架96.7%性能的前提下,总体Token消耗降低了28.4%。如果接受2-3%的性能损失,降本幅度可达45-60%。
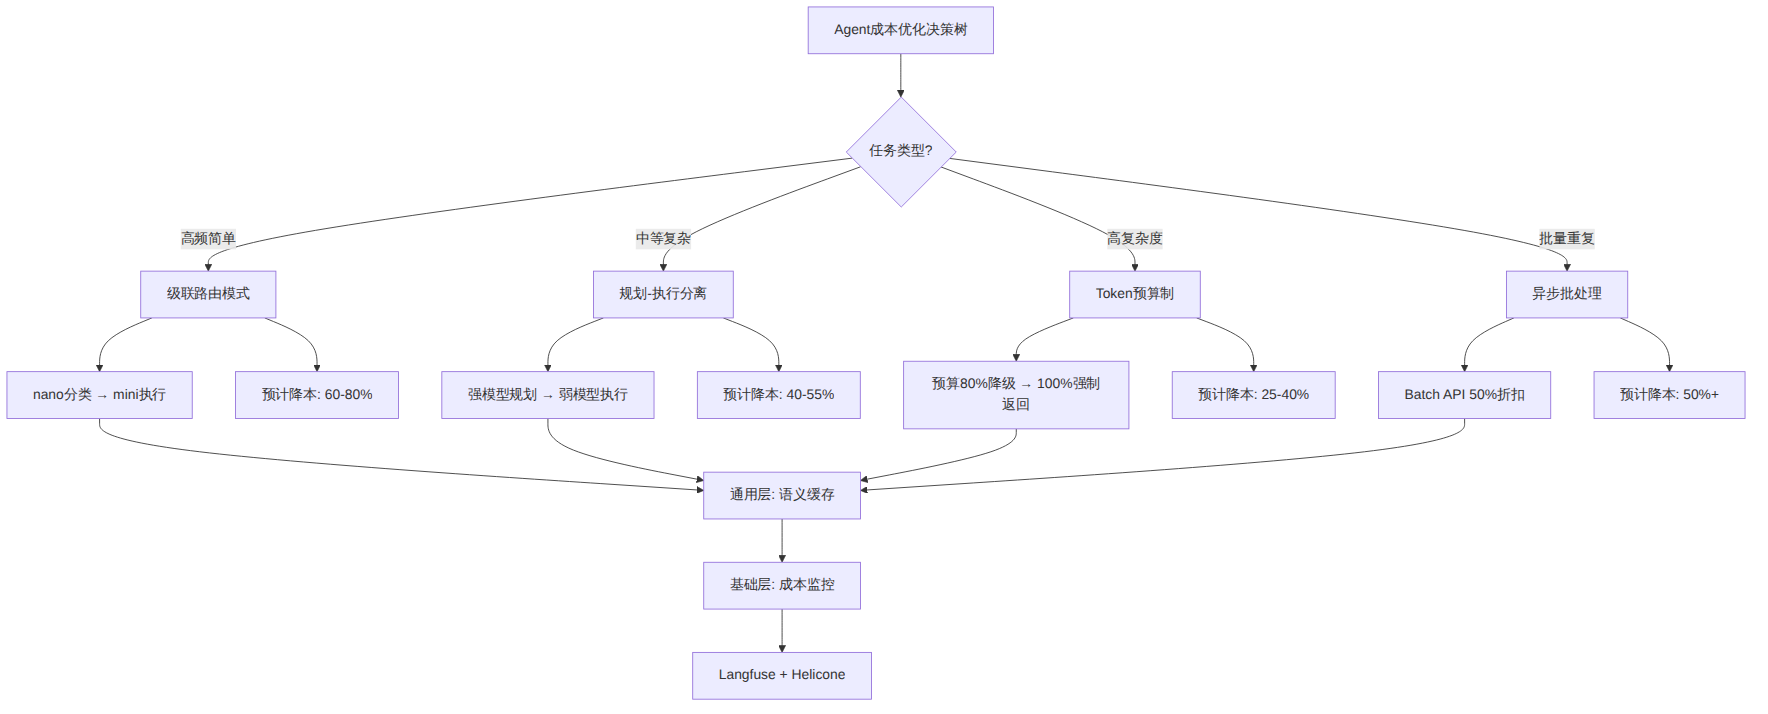
基于上述分析,我们总结出五种可落地的Agent成本优化架构模式。
用户请求 → [Nano模型: 意图分类]
              ├─ 简单查询 → 直接回答($0.001)
              ├─ 标准查询 → Mini模型处理($0.01)
              └─ 复杂任务 → Agent工作流($0.05-0.5)
适用场景:客服系统、FAQ机器人。实测可将70%的请求分流到低成本模型,整体降本60-80%。
[强模型] → 一次性规划所有步骤
    ↓
[弱模型] → 按计划逐步执行
    ↓
[中模型] → 验证结果质量
适用场景:数据分析、报告生成。规划只消耗一次强模型Token,执行阶段大量Token使用廉价模型。
请求 → [语义相似度匹配]
          ├─ 缓存命中(相似度>0.95) → 直接返回缓存结果
          └─ 缓存未命中 → 正常Agent流程 → 写入缓存
适用场景:高频重复性任务。使用GPTCache或自建向量缓存,命中率可达30-50%,直接省掉对应比例的Token消耗。
# 为不同类型的Agent任务设置Token预算上限
BUDGETS = {
    "simple_qa": 2000,       # 简单问答:2K
    "tool_call": 15000,      # 单次工具调用:15K
    "multi_step": 50000,     # 多步骤任务:50K
    "complex_reasoning": 100000,  # 复杂推理:100K
}
当Token消耗达到预算的80%时,自动降级模型;达到100%时,强制返回当前最佳结果。这避免了Agent在困难任务上陷入无限重试的"Token黑洞"。
将非实时性任务收集后批量处理,利用Batch API的50%价格折扣:
# OpenAI Batch API 示例
batch_requests = []
for task in pending_tasks:
    batch_requests.append({
        "custom_id": task.id,
        "method": "POST",
        "url": "/v1/chat/completions",
        "body": {
            "model": "gpt-4.1-mini",
            "messages": task.messages
        }
    })

# 提交批处理(24小时内返回,价格减半)
batch = client.batches.create(
    input_file_id=upload_file(batch_requests),
    endpoint="/v1/chat/completions",
    completion_window="24h"
)
2026年市场上Agent产品的定价方式已形成三大阵营:
| 定价模式 | 代表产品 | 优势 | 劣势 | 毛利率 |
|---|---|---|---|---|
| Token计费 | OpenAI Assistants API | 与成本对齐,灵活 | 用户难以预估费用 | 60-70% |
| 任务计费 | Devin, Cursor Pro | 用户可理解 | 复杂任务可能亏本 | 40-55% |
| 订阅制 | ChatGPT Plus, Claude Pro | 收入可预测 | 重度用户拉低利润 | 50-65% |
| 结果计费 | 客服Agent按解决率付费 | 价值导向 | 难以衡量和验证 | 70-85% |
构建一个可持续的Agent业务,核心在于理解"单位经济学"(Unit Economics):
单个任务的单位经济模型:
┌────────────────────────────────────────┐
│ 收入侧                                  │
│   任务单价: $0.50 (任务制)              │
│   或 订阅分摊: $0.30/任务 (月费$99/330次) │
├────────────────────────────────────────┤
│ 成本侧                                  │
│   LLM推理: $0.08 (优化后)               │
│   工具/API: $0.05 (第三方API调用)        │
│   基础设施: $0.02 (服务器/数据库)        │
│   ┌──────────────────────────────┐      │
│   │ 毛利: $0.35 (70%毛利率)      │      │
│   └──────────────────────────────┘      │
│   获客成本分摊: $0.10                    │
│   研发分摊: $0.05                       │
│   ┌──────────────────────────────┐      │
│   │ 净利: $0.20 (40%净利率)      │      │
│   └──────────────────────────────┘      │
└────────────────────────────────────────┘
根据多个Agent产品的公开数据和行业报告,得出以下关键阈值:
你不能优化你无法测量的东西。Agent成本监控是降本的先决条件。
| 工具 | 核心功能 | Token追踪 | 成本估算 | 集成难度 | 免费额度 |
|---|---|---|---|---|---|
| Langfuse | 开源LLM可观测性 | ✅ 精确到每次调用 | ✅ 实时成本估算 | 低(SDK接入) | 自部署免费 |
| Helicone | API代理+分析 | ✅ 自动拦截记录 | ✅ 多供应商成本聚合 | 极低(换base_url) | 50K请求/月 |
| LangSmith | LangChain生态专用 | ✅ 原生集成 | ✅ 项目级成本追踪 | 中(绑定LangChain) | 5K追踪/月 |
| Braintrust | 评估+监控一体 | ✅ 自动评分 | ✅ 成本/质量双维度 | 中 | 有限免费 |
推荐组合:Langfuse(自部署)+ Helicone(轻量级API代理),前者做深度分析,后者做实时成本看板。
# Helicone接入示例(改动极小)
import openai

# 原始代码
# client = openai.Client(api_key="sk-xxx")

# 接入Helicone(只改base_url)
client = openai.Client(
    api_key="sk-xxx",
    base_url="https://api.helicone.ai/v1"  # 只需加这一行
)
# 所有请求自动被监控,零代码侵入
图表 1
推荐:级联路由 + 语义缓存
70%的客服请求是重复性问题。先用nano模型做意图分类,将常见问题命中缓存直接返回,标准问题用mini模型,仅5-10%的复杂case进入完整Agent流程。月均成本可从$5,000降至$800-1,200。
推荐:规划-执行分离 + Token预算制
代码Agent的规划阶段(理解需求、设计架构)需要强模型,但具体的代码补全和测试生成可以用mini模型。配合Token预算避免无限调试循环,单任务成本从$1.5降至$0.4-0.6。
推荐:全五层架构叠加
大型企业的Agent系统覆盖多种任务类型,需要完整的成本优化栈:最外层是级联路由分流请求,核心是规划-执行分离降低推理成本,语义缓存减少重复计算,Token预算控制极端情况,异步批处理消化非实时任务,底座是全程成本监控。
2026年AI Agent的成本经济学正在经历从"粗放烧钱"到"精打细算"的转折。三个趋势值得关注:
对于技术团队而言,现在最重要的是建立Token消耗的基线测量——在还没有优化之前,先知道自己每次任务花了多少Token、多少钱。这是所有后续优化的起点。
[!tip] 51学通信知识星球 星主:爱卫生(微信:gprshome201101)——公众号「51学通信」创办者,19 年通信行业运维与讲师经验,著有《GPRS网络信令实例详解》《EPC原理与实践》《5G核心网原理与实践》三本纸质书(各大电商平台有售)。 星球定位:深耕 5G 核心网、IMS、NFV/AI、云原生等 ICT 领域,主打运维岗位与信令分析。 当前规模:5200 篇主题 / 990 个回答,198 元/年。 加入福利:加入星球后请加爱卫生微信,拉您进知识星球年度陪伴与答疑群——不限量回复您的各种问题,另有群内分享。 AI 加持:51学通信知识星球已作为 skill 接入 WorkBuddy,使用 deepseek-4-flash 在海量星球帖子中精准找贴、找视频、找 FAQ 和案例,做总结、找文档和 PPT 等场景全覆盖。
