2026年AI Agent领域最被低估的基础设施不是推理引擎,而是记忆系统。无论模型多强大,一个"健忘"的智能体在实际任务中几乎不可用。本文基于Letta官方LoCoMo基准测试数据、CoALA认知架构框架、以及Mem0/LangMem/Zep/Letta/OpenClaw/Manus六大方案的生产环境实测,深入拆解不同记忆架构的设计哲学与性能边界。核心发现:Letta用纯文件系统在LoCoMo上跑出74.0%准确率(GPT-4o-mini),超过Mem0图变体的68.5%——这颠覆了"专用记忆工具优于通用方案"的常见认知。
| 维度 | Letta (MemGPT) | Mem0 | LangMem | Zep | OpenClaw | Manus |
|---|---|---|---|---|---|---|
| 架构理念 | OS式分页三级存储 | 被动提取+图/向量混合 | LangGraph内置KV存储 | 会话结构化知识图谱 | 激进有损压缩+RAG | 文件系统即记忆 |
| 记忆层级 | Core/Recall/Archival | 短期/长期/语义 | 单层命名空间 | 情景/语义/摘要 | 压缩历史+RAG索引 | 文件系统+多进程 |
| Star数 | ~21K | ~25K | ~1.3K | ~3K | ~8K | ~40K+ |
| LoCoMo得分 | 74.0% (文件系统) | 68.5% (图变体) | 未公布 | 未公布 | N/A | N/A |
| 自编辑记忆 | Agent主动读写 | 被动提取 | 后台管理器 | 结构化提取 | 自动压缩 | Agent主动读写 |
| 向量检索 | search_files工具 | 内置 | 向量相似度 | 混合搜索 | RAG索引 | 语义搜索 |
| 知识图谱 | 无 | 有 | 无 | 有 | 无 | 无 |
| 时间检索 | 无 | 无 | 无 | 有 | 无 | 无 |
| 托管服务 | 有($20-200/月) | 有(免费层+Pro) | 无(需LangGraph) | 有(免费层+Pro) | 无 | 无 |
| 框架依赖 | 高(运行在其内部) | 低(独立SDK) | 高(需LangGraph) | 低(独立SDK) | 中 | 低 |
| 上手难度 | 中高 | 低 | 中 | 低 | 中高 | 中 |
| 生产就绪 | 是 | 是 | 是 | 是 | 是 | 是 |
Letta源自MemGPT研究项目(UC Berkeley, 2023),核心设计灵感来自操作系统的虚拟内存管理。整个记忆系统分为三层:
# Letta Agent 创建示例
from letta import create_client

client = create_client()
agent = client.create_agent(
    name="memory_agent",
    memory_blocks=[
        {"label": "persona", "value": "I am a helpful assistant."},
        {"label": "human", "value": "User preferences will be stored here."}
    ],
    tools=["send_message", "search_files", "grep"]
)

# Agent自主管理记忆——当判断某信息重要时主动写入
response = client.send_message(
    agent_id=agent.id,
    message="我叫张三,我对花生过敏,请记住"
)
# Agent会自动调用core_memory_append将过敏信息写入核心记忆
Letta团队2025年8月发表的基准测试揭示了一个反直觉的结论。他们用最简单的文件系统方案——将LoCoMo对话历史放入文件,Agent仅使用search_files、grep和answer_question三个工具——在GPT-4o-mini上达到74.0%准确率,显著高于Mem0图变体的68.5%。
原因在于:现代LLM经过大量代码训练后,对文件操作工具的使用已经高度熟练。Agent能自主将"Calvin如何面对挫折保持动力?"转换为搜索查询"Calvin motivation setbacks",并迭代搜索直到找到正确数据。而专用记忆工具往往设计为单跳检索,灵活性反而受限。
Mem0走了一条完全不同的路线——不要求Agent在运行时内主动管理记忆,而是通过一个独立的记忆层,从对话流中被动提取、存储和检索信息。其核心是MemoryClient,作为LLM调用和用户交互之间的中间件。
# Mem0 记忆集成示例
from mem0 import Memory

m = Memory()

# 添加记忆(被动提取)
result = m.add("我叫张三,在字节跳动做后端开发,最近在学Rust", user_id="zhangsan")

# 检索相关记忆
memories = m.search("张三的技术栈是什么?", user_id="zhangsan")
# 返回: [{"memory": "在字节跳动做后端开发", "score": 0.89},
#        {"memory": "最近在学Rust", "score": 0.85}]
Mem0在2025年发布了LoCoMo基准测试结果,其图记忆变体达到68.5%,向量变体约65.2%。然而,Letta团队指出Mem0声称测试了MemGPT的数据无法被独立复现——Letta团队无法找到一种方法能将LoCoMo数据回填到MemGPT/Letta中而不对代码做大幅重构。
LangMem是LangChain生态系统中专门为LangGraph Agent设计的记忆库。它将记忆存储为LangGraph内置结构化存储中的扁平JSON键值对,每个记忆项有命名空间和键。检索仅依赖向量相似度搜索。
# LangMem 集成示例
from langgraph.store.memory import InMemoryStore
from langmem import create_memory_manager

store = InMemoryStore()

# 创建记忆管理器
memory_manager = create_memory_manager(
    "anthropic:claude-sonnet-4-20250514",
    store=store,
    instructions="Extract user preferences and key facts"
)

# 后台自动提取用户偏好
# 无需Agent主动调用——后台管理器处理一切
LangMem有一个独到的功能——Prompt优化。它能分析Agent的长期表现,根据积累的交互数据自动建议系统提示词的改进方向。这在持续迭代提示工程的场景中非常有价值。
Zep的独特之处在于将会话数据结构化为知识图谱。每条记忆不仅存储语义向量,还提取实体、关系和时序信息。这使Zep成为唯一支持时间检索("上周二我们讨论了什么?")的主流记忆方案。
# Zep 记忆使用示例
from zep_cloud.client import Zep

client = Zep(api_key="your_key")

# 自动从对话中提取结构化知识
client.memory.add(session_id="session_1",
    messages=[{"role": "user", "content": "我下周要去东京出差,住在新宿"},
              {"role": "assistant", "content": "好的,我帮您查新宿附近的酒店"}])

# 时间范围检索
results = client.memory.search(session_id="session_1",
    text="旅行计划",
    search_type="temporal",
    metadata={"from": "2026-05-01", "to": "2026-05-18"})
OpenClaw的设计目标极其极端——让智能体能连续自主运行数小时甚至数天。为此它采用了最激进的有损压缩策略,依靠两个核心机制:
Compaction(压缩):对历史对话做逐级有损摘要。随着任务推进,早期对话被压缩成越来越简短的概要。上下文不会溢出,但原始信息的保真度持续下降。
Pruning(修剪):对工具输出做实时裁剪。一个工具返回500行日志,可能只保留关键20行,其余直接丢弃。被压缩的信息通过RAG混合搜索索引,需要时可尝试检索找回。
# OpenClaw 压缩策略示意
原始对话(第1-5轮):
  User: 分析这份100页的财报...
  Tool: [500行财报数据输出]
  Agent: 根据数据,营收增长23%...

压缩后(第20轮时):
  [摘要] 第1-5轮:分析了某公司财报,营收增长23%,利润率8%

修剪后(工具输出):
  [500行 → 保留关键20行]
Manus的思路在所有方案中最具颠覆性——完全跳出上下文窗口的框架,把文件系统当成Agent的"外挂大脑"。模型执行任务时主动把重要信息写入文件,需要时再读取回来。
# Manus 记忆策略示意(伪代码)
# 处理复杂任务时主动"卸载"信息
def process_web_content(url):
    content = fetch(url)
    # 将完整内容写入文件,从上下文中移除
    file_path = write_to_file(f"/tmp/web_{hash(url)}.txt", content)
    # 上下文中只保留文件路径
    context.add(f"[已缓存: {file_path}]")
    context.remove(content)  # 释放上下文空间

# 多进程任务分解
task = decompose(complex_goal)
for subtask in task.subtasks:
    # 每个子任务独立进程,上下文干净
    subprocess.run(subtask, share_via_files=True)
更值得关注的是任务分解机制。复杂目标被拆为多个独立子任务,每个子任务跑一个新进程,进程间通过文件读写协作而非共享上下文。这像微服务架构——每个进程的上下文都很小很干净,不会出现巨大上下文把模型搞晕的问题。
图表 1
Letta团队使用LoCoMo基准(长对话问答,包含两个虚构说话人的时间戳对话序列)进行的测试揭示了关键数据:
| 方案 | 模型 | LoCoMo准确率 | 记忆操作token消耗 | 平均延迟 |
|---|---|---|---|---|
| Letta文件系统 | GPT-4o-mini | 74.0% | 中 | ~2.1s |
| Mem0 Graph | GPT-4o-mini | 68.5% | 低 | ~1.5s |
| Mem0 Vector | GPT-4o-mini | ~65.2% | 低 | ~1.2s |
| 纯RAG基线 | GPT-4o-mini | ~58% | 低 | ~1.0s |
| 无记忆基线 | GPT-4o-mini | ~35% | 无 | ~0.8s |
核心洞察:Agent使用记忆工具的能力比记忆工具本身的检索质量更重要。Letta文件系统之所以胜出,不是因为它有更好的检索算法,而是因为LLM对文件操作工具的掌握程度远超对专用记忆API的掌握——这些通用工具更可能出现在模型的训练数据中。
这带来了一个重要推论:在设计Agent记忆系统时,应优先选择模型已经"熟悉"的简单工具接口,而非理论上更强大的复杂API。
基于CoALA认知架构框架(Princeton, 2023, arXiv:2309.02427)和上述实测数据,生产级Agent应采用混合记忆架构:
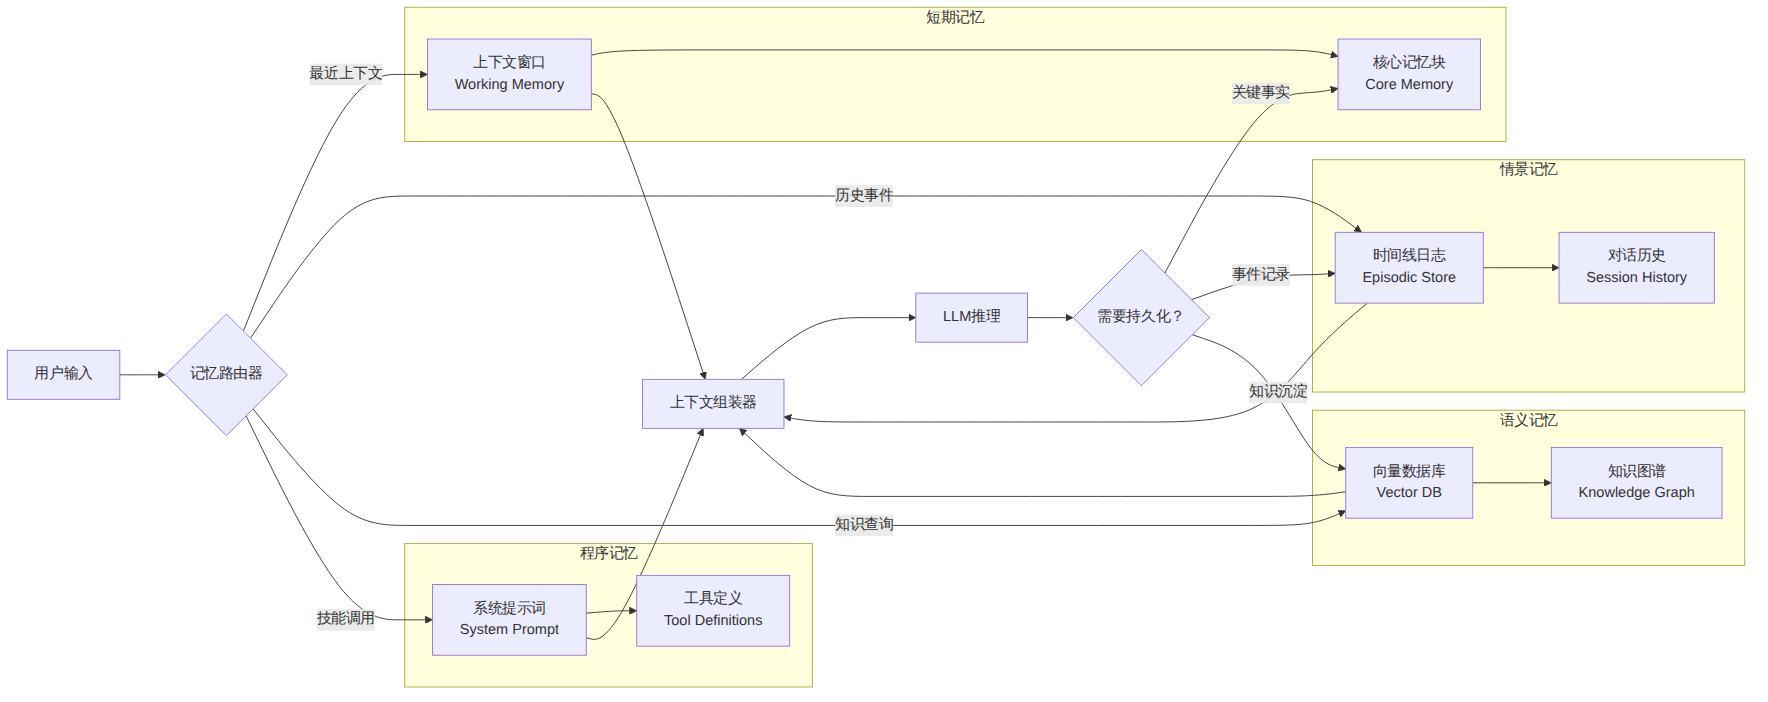
图表 2
混合架构的实现要点:
# 混合记忆检索伪代码
def get_hybrid_context(task_id, user_question):
    # 1. 情景检索(最近5步,快速且确定性的)
    episodic = episodic_store.fetch_events(task_id, last_n=5)

    # 2. 语义检索(概念相关,慢但覆盖面广)
    query_emb = embedding_model.embed(user_question)
    semantic = vector_db.search(query_emb, top_k=5)

    # 3. 合并 + 重排序
    combined = episodic + semantic
    ranked = reranker.rank(combined, query=user_question)

    # 4. 裁剪到token预算
    final = trim_to_budget(ranked, max_tokens=4000)
    return final
基于AgentMarketCap 2026年4月的横向评测数据,在生产规模(100+并发会话)下的成本表现:
| 方案 | 100并发会话/月成本 | P95检索延迟 | 记忆写入延迟 | Token额外消耗 |
|---|---|---|---|---|
| Letta自托管 | $50-80 | 2.1s | 1.8s | 15-25%/请求 |
| Letta Cloud | $200-400 | 1.5s | 1.2s | 15-25%/请求 |
| Mem0 Cloud | $80-150 | 0.8s | 0.5s | 5-10%/请求 |
| Zep Cloud | $100-200 | 1.2s | 0.9s | 8-15%/请求 |
| LangMem自托管 | $30-60 | 1.0s | 0.7s | 3-8%/请求 |
| 纯文件系统 | $20-40 | 2.5s | 0.3s | 20-30%/请求 |
关键结论:Mem0在延迟和token效率上表现最优,但Letta文件系统在准确率上领先。成本和准确率之间没有免费午餐——更便宜的方案(LangMem、纯文件系统)要么牺牲了检索质量,要么增加了推理负担。
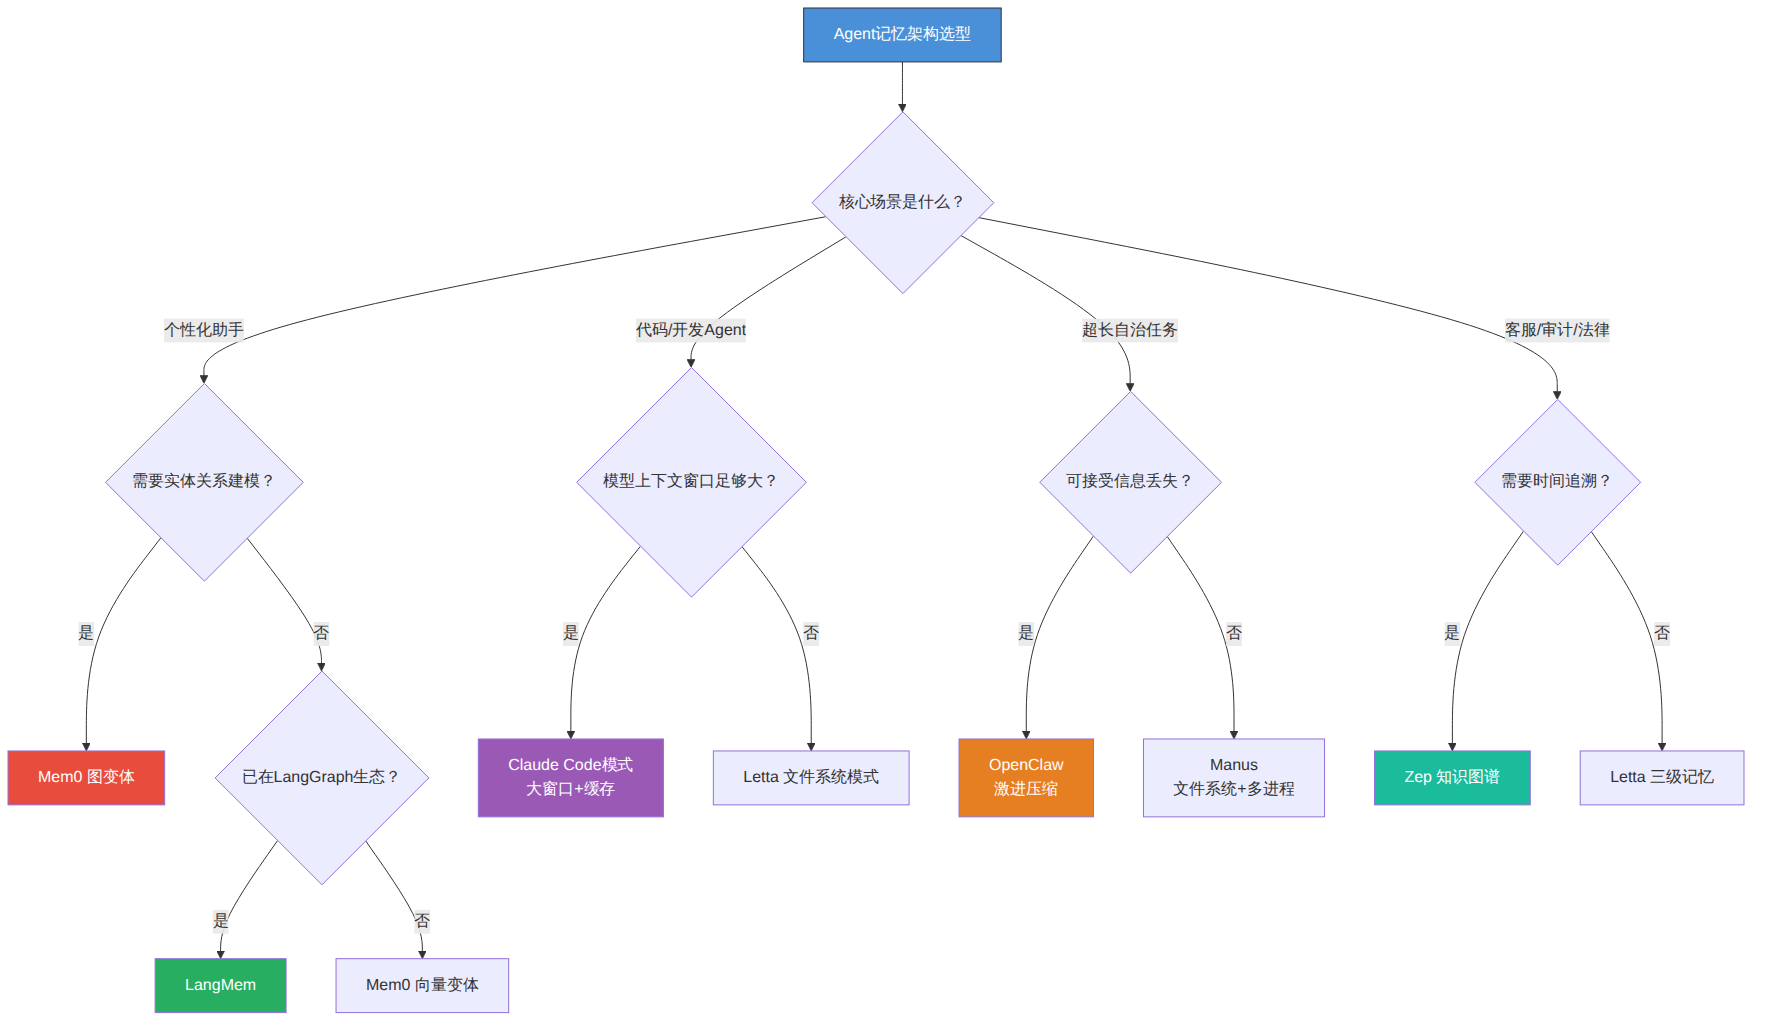
| 场景 | 推荐方案 | 理由 |
|---|---|---|
| 独立开发者快速原型 | Mem0免费层 | 零配置集成,3行代码接入 |
| LangGraph深度用户 | LangMem | 生态一致,部署简单 |
| 代码助手/开发Agent | Letta文件系统模式 | 准确率最高,适合高精度需求 |
| 客服/医疗/法律 | Zep | 时间追溯+知识图谱满足审计需求 |
| 超长自治任务 | OpenClaw + RAG | 续航能力最强 |
| 大规模调研/报告 | Manus文件系统 | 无限记忆容量,多进程协作 |
| 生产级混合方案 | Letta核心+Mem0语义+Zep时间 | 各取所长但运维复杂 |
最重要的选型原则:不要追求"最好的"记忆工具,而要追求"模型最能有效使用的"记忆接口。Letta团队的基准测试已经证明,一个模型熟悉的简单文件系统API,比一个理论上更强大的专用记忆工具在实际表现上更好。记忆系统的核心竞争力不在于存储和检索算法的复杂度,而在于Agent调用记忆工具时的成功率和效率。
[!tip] 51学通信知识星球 星主:爱卫生(微信:gprshome201101)——公众号「51学通信」创办者,19 年通信行业运维与讲师经验,著有《GPRS网络信令实例详解》《EPC原理与实践》《5G核心网原理与实践》三本纸质书(各大电商平台有售)。 星球定位:深耕 5G 核心网、IMS、NFV/AI、云原生等 ICT 领域,主打运维岗位与信令分析。 当前规模:5200 篇主题 / 990 个回答,198 元/年。 加入福利:加入星球后请加爱卫生微信,拉您进知识星球年度陪伴与答疑群——不限量回复您的各种问题,另有群内分享。 AI 加持:51学通信知识星球已作为 skill 接入 WorkBuddy,使用 deepseek-4-flash 在海量星球帖子中精准找贴、找视频、找 FAQ 和案例,做总结、找文档和 PPT 等场景全覆盖。
