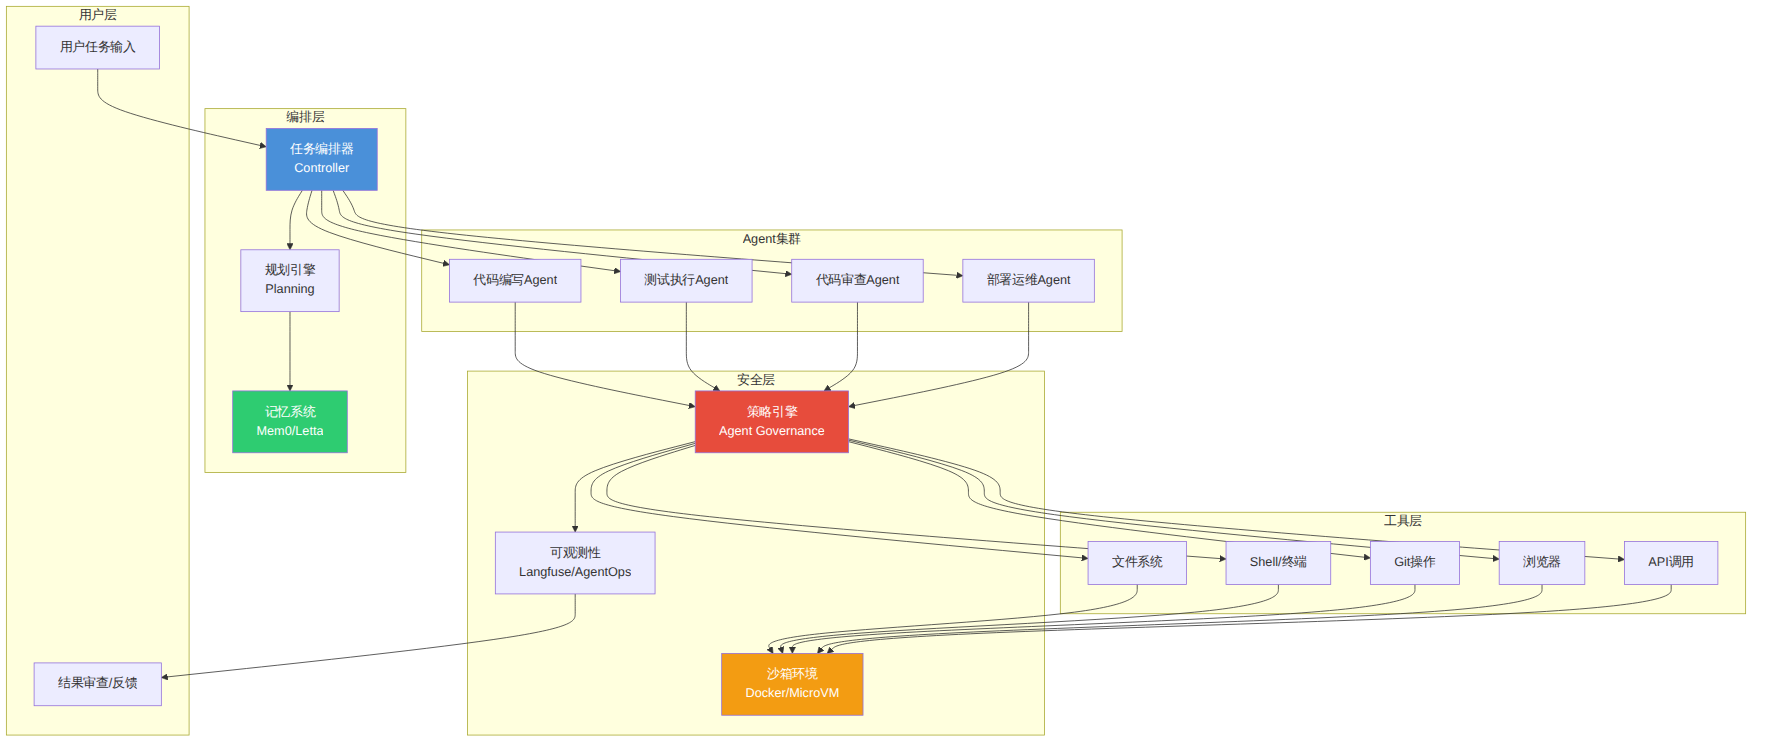
2026年,自主AI智能体(Autonomous Agent)从概念验证正式迈入规模化生产部署阶段。据最新行业报告,54%的企业已在生产环境中运行AI Agent,79%的企业正在积极探索Agent落地路径。与2025年的"框架混战"不同,2026年的竞争焦点已转向谁能真正自主完成端到端任务——从代码编写、Bug修复、测试执行到部署上线,全流程无需人工介入。本文聚焦当前最具代表性的六大自主智能体工具,从架构原理、实测表现、部署难度到变现潜力进行深度拆解,给出不同场景下的选型建议。
| 维度 | Devin 2.0 | OpenHands | SWE-agent | Claude Code | Codex CLI | Manus |
|---|---|---|---|---|---|---|
| 开发方 | Cognition AI | 开源社区(原OpenDevin) | Princeton NLP | Anthropic | OpenAI | Manus AI |
| GitHub Stars | 闭源 | 70K+ | 14K+ | 闭源 | 45K+ | 闭源 |
| 价格 | $20/月起 | 免费(自托管) | 免费 | $20/月起(API) | $20/月起(API) | $39/月起 |
| SWE-bench Verified | ~13.8% | ~50%(配合强模型) | ~50%(配合强模型) | ~72%(Opus 4.7) | ~88%(GPT-5.5) | N/A |
| 核心能力 | 全自主SWE | 可扩展Agent SDK | 研究级Bug修复 | 终端编程Agent | 云端沙箱编程 | 通用自主任务 |
| 沙箱机制 | 云端隔离环境 | Docker容器 | Docker容器 | 本地沙箱 | 云端MicroVM | 云端浏览器 |
| 上手难度 | 低(网页即用) | 中(需Docker/K8s) | 高(研究导向) | 低(npm安装) | 低(npm安装) | 低(网页即用) |
| 适用场景 | 企业开发团队 | 平台级Agent开发 | 学术研究/Benchmark | 个人开发者 | 企业级CI/CD | 非技术用户 |
Devin是Cognition AI于2024年推出的全球首个"AI软件工程师",2026年发布的2.0版本将月费从$500砍至$20,引发行业震动。Devin的核心架构采用全自主Agent Loop——接收自然语言任务描述后,自主完成环境搭建、代码编写、测试运行、错误修复的完整循环。
Devin 2.0的技术突破在于其并行Agent调度能力。面对一个复杂任务,Devin会同时启动多个子Agent分别处理不同模块,例如一个负责前端UI、一个处理后端API、一个编写测试用例,最后汇总结果。这种并行架构使Devin在大型项目上的效率比串行Agent提升3-5倍。最新2.2版本还加入了桌面/GUI测试能力,能直接在浏览器和Figma中进行视觉验证。
然而,Devin的SWE-bench Verified得分仅约13.8%,远低于OpenHands和Claude Code等工具配合顶级模型的50-70%表现。差距主要源于Devin使用自研模型的推理能力限制。实际使用中,Devin适合结构化、边界清晰的任务——比如"给这个Django项目添加用户认证模块",而非开放性的架构重构。
变现评估:Devin的$20/月定价极具竞争力,可直接包装为"AI开发助手SaaS"或作为企业数字化转型的核心技术栈进行培训。适合面向中小团队的"AI辅助开发训练营"场景。
# Devin API 调用示例(通过Cognition API)
import requests

response = requests.post(
    "https://api.cognition.ai/v1/sessions",
    headers={"Authorization": "Bearer YOUR_API_KEY"},
    json={
        "task": "Create a REST API endpoint for user registration "
                "with email validation and password hashing in FastAPI",
        "repo_url": "https://github.com/your-org/your-repo",
        "branch": "feature/user-auth"
    }
)
session_id = response.json()["session_id"]
# Devin 自主完成:分析代码库 → 编写代码 → 运行测试 → 创建PR
OpenHands(原名OpenDevin)是目前GitHub星标数最高的开源自主编程Agent平台,Star数突破70K,贡献者超过250人。2025年底发布的Agent SDK是对原有架构的彻底重构,将Agent组件抽象为可组合、可扩展的模块化SDK。
OpenHands的架构核心是Action-Observation循环。Agent通过一系列Action(执行命令、编辑文件、浏览网页)与环境交互,每次Action后获得Observation(终端输出、文件内容、页面截图),Agent据此决策下一步行动。SDK定义了四个核心抽象:
OpenHands的独特优势在于模型无关性。同一套Agent逻辑可以无缝切换底层LLM——从GPT-4o到Claude Sonnet到本地运行的Llama 3,只需修改一行配置。配合Claude Opus 4等顶级模型,SWE-bench Verified可达50%以上。其企业版(OpenHands Enterprise)支持Kubernetes部署,满足大规模团队的并发需求。
变现评估:OpenHands是最适合做Agent开发训练营的平台——开源免费、架构清晰、文档完善。可设计从"搭建第一个自主Agent"到"企业级Agent编排"的完整课程体系。
# OpenHands SDK 自定义Agent示例
from openhands.sdk.agent import AgentBase
from openhands.sdk.action import Action, CmdRunAction, FileEditAction
from openhands.sdk.observation import Observation

class CodeReviewerAgent(AgentBase):
    """自定义代码审查Agent"""

    def step(self, observation: Observation) -> Action:
        # 分析代码变更
        diff = self.get_current_diff(observation)

        # 检查潜在问题
        issues = self.analyze_with_llm(diff)

        if issues.security_vulnerabilities:
            return FileEditAction(
                path=issues.file_path,
                content=issues.suggested_fix
            )

        return CmdRunAction(command="pytest tests/ --tb=short")
SWE-agent由Princeton大学NLP实验室开发,是SWE-bench基准测试的"标杆工具"。与Devin和OpenHands不同,SWE-agent的设计哲学是极简主义——不追求通用性,而是专注一个任务:给定GitHub Issue,自动定位问题、编写修复代码、通过测试验证。
SWE-agent的架构亮点是Agent-Computer Interface(ACI)设计。研究团队发现,LLM在标准shell环境中执行命令时效率低下(命令输出格式不友好、错误信息冗长),因此专门设计了一套精简的命令接口。例如,open <file>命令只显示文件的相关部分而非全部内容,search_dir <pattern>返回精确匹配行而非grep的完整输出。这种ACI设计将Agent的任务完成率提升了10-15个百分点。
2026年的SWE-agent已发展为一个研究框架,支持自定义Agent模板、多种LLM后端、以及与SWE-bench的深度集成。其在学术界的地位相当于计算机视觉领域的ImageNet——几乎所有新的编程Agent论文都以SWE-bench为评测标准。
变现评估:SWE-agent的受众主要是研究者和高级工程师。适合面向高校和研究院的"AI4SE(AI for Software Engineering)"研讨会,或面向大厂工程团队的"自动化代码质量保障"内训。
# SWE-agent 配置示例
agent:
  name: "ClaudeSonnetAgent"
  model: "claude-sonnet-4-20250514"

  # 自定义ACI命令
  custom_commands:
    - name: "find_bug_context"
      template: |
        Given the error traceback:
        {traceback}

        Search for the root cause in the codebase.
        Use `search_dir` to locate relevant files.
        Use `open` to examine specific functions.

  max_iterations: 30
  cost_limit: 2.0  # USD per issue
Claude Code是Anthropic推出的终端编程Agent,其设计理念是最小化抽象层——直接在开发者的终端中运行,拥有对本地文件系统和Shell的完整访问权限。2026年3月版本引入了/loop命令(定时自动执行任务)和远程控制能力,标志着从"辅助工具"向"自主Agent"的质变。
Claude Code的技术架构可概括为Harness模式。Harness是一个运行在终端中的轻量级运行时,负责: - 管理与Claude API的连接 - 执行工具调用(文件读写、Shell命令、代码搜索) - 维护会话上下文和任务状态 - 实现安全边界(权限控制、危险操作确认)
Claude Code在SWE-bench上的表现极为出色——Opus 4.7模型达到64.3%(SWE-bench Pro),是目前闭源模型中的顶尖水平。其核心竞争力在于对代码库的全局理解能力:启动时自动扫描项目结构,构建文件依赖图,在编辑代码时能准确感知跨文件影响。
Claude Code的Hook机制是其安全设计的关键。用户可配置pre-tool-use和post-tool-use钩子,在Agent执行任何操作前后进行拦截和验证。例如,禁止删除.env文件、限制网络访问范围、自动运行测试等。
变现评估:Claude Code是最适合个人开发者付费课程的工具。可设计"用Claude Code一天完成一周工作量"等实用课程,也可针对企业客户的"AI编程工作流咨询"服务。
// Claude Code Hook 配置示例 (.claude/hooks.json)
{
  "hooks": {
    "pre-tool-use": [
      {
        "matcher": "Write|Edit",
        "command": "validate-no-secrets.sh",
        "description": "防止写入敏感信息"
      }
    ],
    "post-tool-use": [
      {
        "matcher": "Bash",
        "command": "check-test-results.sh",
        "description": "命令执行后自动运行测试"
      }
    ]
  }
}
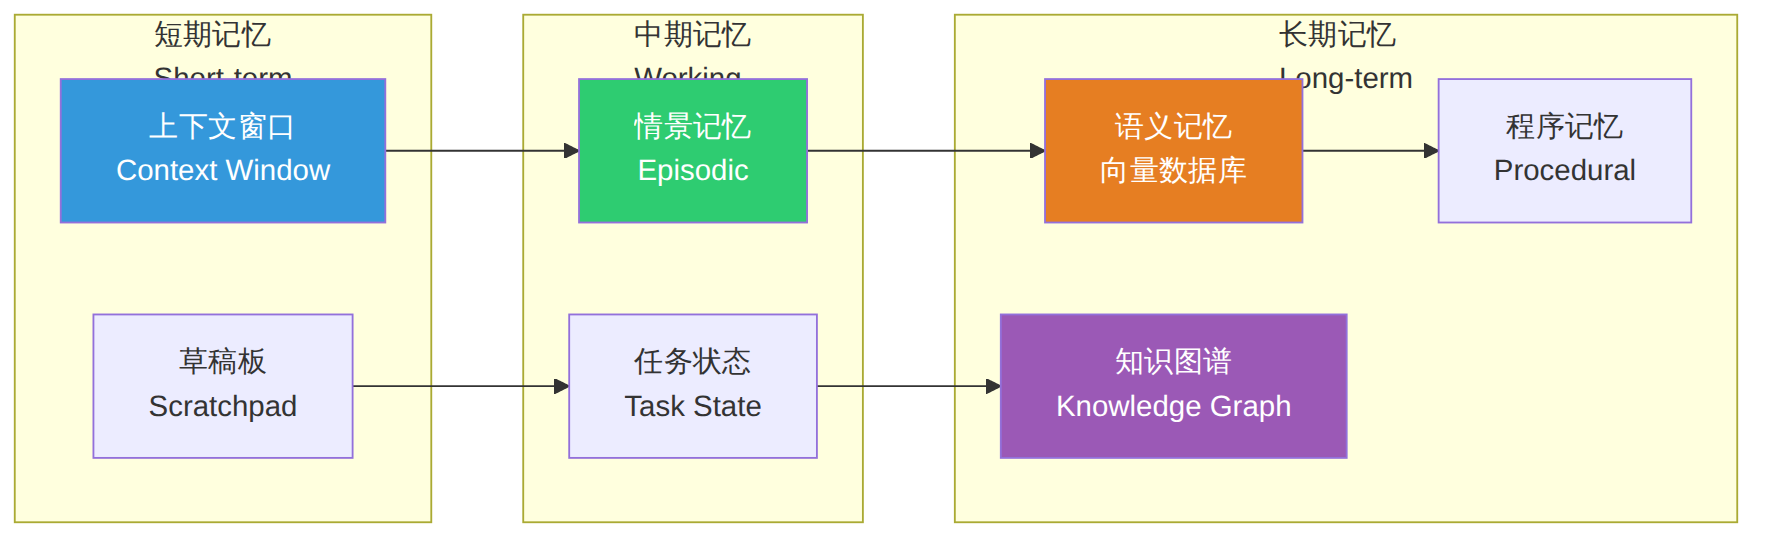
自主Agent要处理长周期任务,必须突破"上下文窗口"限制。2026年的Agent记忆系统已从实验阶段进入工程化落地,核心方案包括:
Mem0是当前最流行的开源Agent记忆层,GitHub星标超过25K。其架构分为三层:短期记忆(当前会话上下文)、情景记忆(历史交互片段)、语义记忆(结构化知识图谱)。Mem0通过自动提取对话中的关键实体和关系,将非结构化对话转化为可检索的结构化记忆。实测表明,集成Mem0的Agent在多轮任务中的上下文保持能力提升40%,同时将Token消耗降低60%(从$2.4K/月降至$960/月)。
MemoryOS是北邮团队联合华为推出的首个"Agent记忆操作系统",将操作系统的段页式内存管理原理引入LLM记忆场景。其三级分层存储(热记忆/温记忆/冷记忆)配合四大核心模块(记忆写入、检索、遗忘、压缩),实现了对记忆的精细化管理。
Letta(原MemGPT)采用虚拟上下文管理策略,通过自动分页和缓存机制,使Agent能处理远超上下文窗口限制的长文档和长期任务。Letta特别适合需要处理海量文档的企业级RAG场景。
# Mem0 集成示例
from mem0 import Memory

memory = Memory()

# 存储交互记忆
memory.add(
    "用户偏好使用TypeScript和React进行前端开发",
    user_id="developer_001",
    metadata={"category": "tech_preference", "confidence": 0.95}
)

# Agent执行任务时检索相关记忆
relevant_memories = memory.search(
    "前端框架选择",
    user_id="developer_001",
    limit=5
)
# → ["用户偏好使用TypeScript和React",
#    "项目已配置Vite构建工具", ...]
自主Agent在生产环境中面临的核心挑战不是"能不能用",而是"安不安全"和"可不可控"。2026年涌现了一批专注于这两个领域的工具。
Microsoft Agent Governance Toolkit是2026年4月发布的开源Agent安全框架,提供策略执行、零信任身份、执行沙箱和可靠性保障四大能力。其核心设计是将Agent的所有操作纳入策略引擎管控——每个工具调用、每次文件访问、每条网络请求都需通过策略检查。例如,可配置"Agent只能访问test数据库"、"禁止发送邮件到外部域名"等细粒度规则。
NVIDIA OpenShell(含NemoClaw组件)为always-on型自主Agent提供安全运行时。其创新点是策略驱动的自我进化机制——Agent在安全边界内可自主优化行为策略,但任何超出预设范围的操作都会被自动拦截。
可观测性方面,Langfuse和AgentOps是两大主流选择。Langfuse提供Agent交互的完整Trace链路——从用户输入、LLM调用、工具执行到最终输出,每一步都可追踪、可回放、可评估。AgentOps则专注于Agent行为的异常检测——自动识别Agent循环、幻觉输出、工具调用失败等常见问题。两者的共同目标是让生产环境中的Agent行为可审计、可调试、可优化。
# Langfuse Agent Trace 集成
from langfuse.decorators import observe

@observe()
def autonomous_agent_task(task_description: str):
    # 自动记录完整的Agent执行链路
    plan = planning_module(task_description)      # → Langfuse span

    for step in plan.steps:
        result = tool_executor(step)               # → Langfuse span
        observation = environment.observe()          # → Langfuse span

        if observation.error:
            recovery = error_handler(observation)    # → Langfuse span

    return final_output

# Langfuse Dashboard 展示:
# Session → Task → Plan → Step1 → Tool1 → Observe → Step2 → ...
图表 1
图表 2
| 使用场景 | 首选工具 | 理由 |
|---|---|---|
| 企业开发团队(预算充足) | Devin 2.0 | 即开即用、并行Agent、$20低价 |
| Agent平台开发(需要定制) | OpenHands SDK | 模块化架构、模型无关、70K社区 |
| 学术研究/Benchmark | SWE-agent | 研究级精度、ACI创新、SWE-bench原生 |
| 个人开发者日常编程 | Claude Code | 终端原生、代码理解强、Hook灵活 |
| 企业CI/CD集成 | Codex CLI | 云端沙箱、OpenAI生态、GPT-5.5加持 |
| 非技术用户自动化 | Manus | 浏览器交互、零代码门槛 |
| 需要记忆的长期Agent | Mem0 + 任意框架 | 记忆中间件、框架无关、降低Token成本 |
| 安全敏感环境 | OpenHands + AGT | 开源可控 + Microsoft策略引擎 |
环境隔离是底线。自主Agent能执行任意Shell命令意味着它能做任何事——包括删除文件、发送邮件、访问数据库。必须使用Docker容器或MicroVM进行沙箱隔离,并通过Microsoft Agent Governance Toolkit等工具设置操作边界。Northflank的测试显示,gVisor沙箱在安全性和性能之间取得了最佳平衡。
可观测性不是可选。Agent在执行复杂任务时可能陷入循环、产生幻觉输出、调用不存在的工具。没有完整的Trace链路,排障将无从下手。Langfuse的开源版本即可满足大多数场景,AgentOps则提供更智能的异常检测。
记忆系统决定Agent上限。一个能记住用户偏好、项目上下文、历史错误的Agent,其任务完成率比无记忆Agent高40%以上。Mem0是目前最成熟的开源方案,Letta则适合需要处理超长上下文的场景。
成本控制需前置设计。自主Agent可能在一个任务上消耗大量Token——特别是陷入循环或处理复杂错误时。务必设置每任务Token上限和费用预警,Mem0的记忆压缩功能可将长期运行成本降低60%。
[!tip] 51学通信知识星球 星主:爱卫生(微信:gprshome201101)——公众号「51学通信」创办者,19 年通信行业运维与讲师经验,著有《GPRS网络信令实例详解》《EPC原理与实践》《5G核心网原理与实践》三本纸质书(各大电商平台有售)。 星球定位:深耕 5G 核心网、IMS、NFV/AI、云原生等 ICT 领域,主打运维岗位与信令分析。 当前规模:5200 篇主题 / 990 个回答,198 元/年。 加入福利:加入星球后请加爱卫生微信,拉您进知识星球年度陪伴与答疑群——不限量回复您的各种问题,另有群内分享。 AI 加持:51学通信知识星球已作为 skill 接入 WorkBuddy,使用 deepseek-4-flash 在海量星球帖子中精准找贴、找视频、找 FAQ 和案例,做总结、找文档和 PPT 等场景全覆盖。
