2026年上半年,自主智能体(Autonomous Agent)领域发生了质变:从"能跑Demo"跃迁到"能干真活"。OpenHands于5月发布Agent Control Plane,标志着Agent从单工具演化为企业级操作系统;Live-SWE-Agent首次实现Agent在运行时自我进化;Perplexity Computer编排19个大模型完成端到端任务;而Google Project Mariner的关停则释放出明确信号——浏览器Agent正在从独立产品形态融入更底层的工作流引擎。本文聚焦六类自主智能体的实战表现,覆盖编码、研究、浏览器自动化和记忆系统四个场景,给出可落地的技术选型建议。
在展开具体工具分析之前,必须理解2026年自主智能体的三股结构性变化:
趋势一:从"全能Agent"到"专精Agent"的回归。 Manus AI和Perplexity Computer试图打造通用型自主Agent,但在实际生产中,真正产生价值的是垂直领域深度优化的专精Agent——编码Agent(OpenHands、SWE-Agent)、浏览器Agent(Browser Use、Stagehand)、研究Agent(Perplexity Deep Research)。通用Agent适合演示,专精Agent适合付费。
趋势二:Agent Memory成为基础设施。 Mem0和Cognee两个开源记忆系统的崛起表明,Agent的核心瓶颈不再是推理能力,而是持续记忆和知识管理。没有记忆层的Agent,每次对话都从零开始,这在2026年已不可接受。
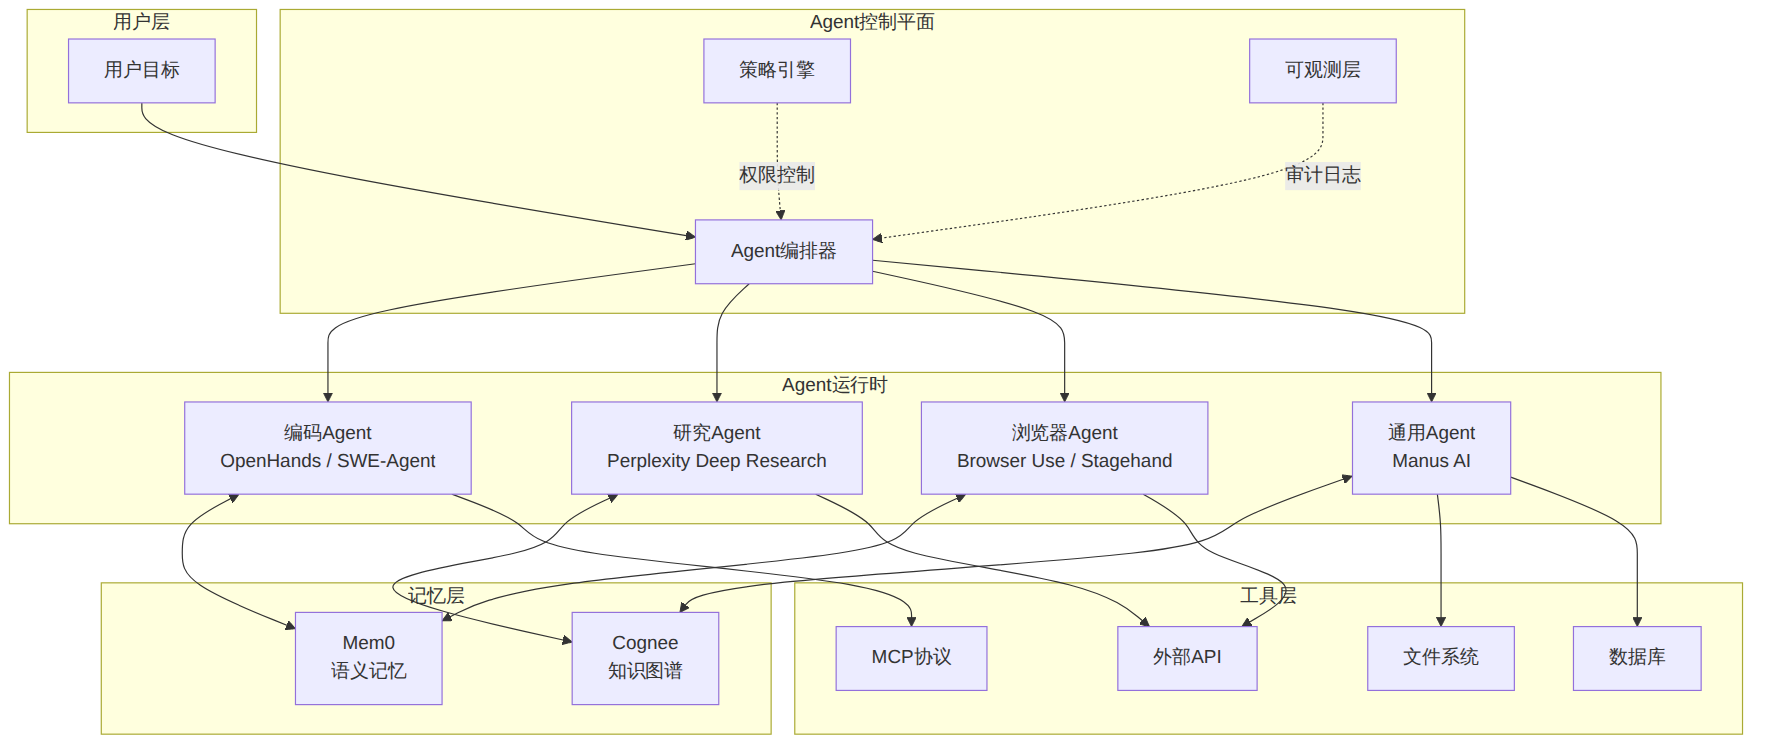
趋势三:Control Plane取代Orchestrator。 OpenHands Agent Control Plane的发布代表了一个新范式:企业不需要更多的Agent,而需要一个管理Agent的基础设施层。编排、权限、可观测性成为关键词。
| 维度 | OpenHands ACP | Live-SWE-Agent | Manus AI | Perplexity Computer | Browser Use | Mem0 |
|---|---|---|---|---|---|---|
| 类型 | 编码Agent平台 | 自进化编码Agent | 通用自主Agent | 多模型研究Agent | 浏览器自动化 | 记忆基础设施 |
| 开源 | 是(60K+ Stars) | 是 | 否 | 否 | 是(65K+ Stars) | 是 |
| 定价 | 开源免费/企业版 | 免费 | $39/月起 | $200/月 | 免费 | 开源免费/托管版 |
| 核心能力 | Agent生命周期管理 | 运行时自我改进 | 多步骤任务执行 | 19模型编排 | LLM驱动浏览器 | 持久化知识图谱 |
| SWE-bench | 53%+ | 49.3%→55%+ | N/A | N/A | N/A | N/A |
| 上手时间 | 30分钟 | 20分钟 | 5分钟 | 即时 | 15分钟 | 10分钟 |
| 适合场景 | 企业开发团队 | 持续集成流水线 | 非技术人员 | 深度研究 | Web自动化 | 所有Agent项目 |
| 变现潜力 | ★★★★★ | ★★★★ | ★★★ | ★★★ | ★★★★ | ★★★★★ |
2026年5月6日,OpenHands发布了Agent Control Plane(ACP),这是自主智能体领域今年最重要的基础设施更新。此前的Agent工具本质上是"一个人干一件事"——启动一个Agent,给它任务,等它完成。ACP改变了这个模式,将Agent视为需要被管理、监控和约束的一等公民。
架构设计: ACP的核心是一个四层架构:最底层是Agent Runtime(沙箱化的执行环境),其上是Agent Orchestrator(任务分配和调度),再上是Policy Engine(权限和安全策略),最顶层是Observability Layer(日志、指标和审计追踪)。这种设计借鉴了Kubernetes管理容器的思路,把Agent当作"可调度的计算单元"来管理。
┌─────────────────────────────────────────┐
│          Observability Layer             │
│  (Logging · Metrics · Audit Trail)      │
├─────────────────────────────────────────┤
│           Policy Engine                  │
│  (Least-Privilege · RBAC · Guardrails)  │
├─────────────────────────────────────────┤
│         Agent Orchestrator               │
│  (Task Routing · Load Balancing)        │
├─────────────────────────────────────────┤
│          Agent Runtime                   │
│  (Sandboxed Env · MCP · Tools)          │
└─────────────────────────────────────────┘
关键特性: ACP强制执行最小权限原则——Agent不会被授予比完成任务所需更多的权限。它还引入了"Agent身份"概念,每个Agent实例有独立的凭证和访问控制策略,解决了此前Agent继承用户全部权限导致的安全隐患。
实战价值: 对企业开发团队而言,ACP解决了"Agent sprawl"问题——当团队中有10个开发人员各自运行Agent时,谁来管理它们的权限边界?ACP提供了答案。对企业级部署来说,这是不可或缺的。
Live-SWE-Agent由OpenAutoCoder团队开发,是首个在运行时(而非离线训练时)能够自主改进自身策略的软件工程Agent。它的核心论文标题直指本质:"Can Software Engineering Agents Self-Evolve on the Fly?"
自我进化机制: 传统SWE-Agent在遇到新类型的Bug时表现会显著下降,因为它依赖预定义的修复策略。Live-SWE-Agent引入了"Live Knowledge Accumulation"机制:每次成功修复一个Issue后,Agent会自动提取修复模式(Pattern),将其存入一个动态知识库。下次遇到类似问题时,优先从知识库中检索已验证的策略,而非从头推理。
# Live-SWE-Agent核心逻辑示意(简化)
class LiveSWEAgent:
    def __init__(self):
        self.knowledge_store = LiveKnowledgeStore()
        self.base_agent = CodeAgent(backbone="claude-sonnet-4-5")

    def solve_issue(self, issue):
        # Step 1: 从知识库检索相似问题的修复模式
        patterns = self.knowledge_store.retrieve_similar(issue)

        # Step 2: 如果有高置信度模式,直接使用
        if patterns and patterns[0].confidence > 0.85:
            patch = self.base_agent.apply_pattern(patterns[0], issue)
        else:
            # Step 3: 否则走完整的推理链
            patch = self.base_agent.reason_and_fix(issue)

        # Step 4: 如果修复成功,提取并存储新模式
        if self.validate_patch(patch, issue):
            new_pattern = self.extract_pattern(issue, patch)
            self.knowledge_store.store(new_pattern)

        return patch
基准数据: 在SWE-bench Verified上,Live-SWE-Agent的初始通过率为49.3%,但随着处理的问题增多,通过率稳步上升至55%以上。这不是模型能力的提升,而是策略积累的效果。这种"越用越强"的特性在之前的编码Agent中从未出现过。
局限性: 自我进化的前提是有足够的问题样本。在冷启动阶段(前100个问题),Live-SWE-Agent的表现与标准SWE-Agent差异不大。只有在大规模使用场景(如持续集成流水线中持续运行)下,自我进化的优势才能充分发挥。
Manus AI由Butterfly Effect团队(即Monica AI的创建者)开发,2025年3月爆火后持续迭代至今。它定位为"通用目的自主AI Agent"——给它一个目标,它自己规划步骤、调用工具、交付结果。
架构亮点: Manus的核心是一个"虚拟计算机"——Agent运行在一个隔离的云环境中,拥有自己的浏览器、代码执行器和文件系统。用户通过自然语言下达任务后,Manus会: 1. 将任务分解为子步骤 2. 为每个子步骤选择合适的工具(浏览器搜索、代码执行、文件操作) 3. 顺序执行并动态调整计划 4. 将最终结果交付给用户
实际表现: Manus在三类任务上表现出色——信息调研("帮我分析竞争对手的定价策略")、内容生成("创建一份市场分析报告")和简单编程("写一个数据清洗脚本")。但在复杂的多轮交互任务("帮我重构整个项目的认证系统")中,成功率显著下降。
变现角度: Manus的核心用户群是非技术型知识工作者。$39/月的入门定价使它成为企业培训和个人效率工具的良好候选。但从训练营角度评估,Manus更适合作为"展示课"而非"实战课"——因为它是封闭系统,学习者无法深入理解内部机制。
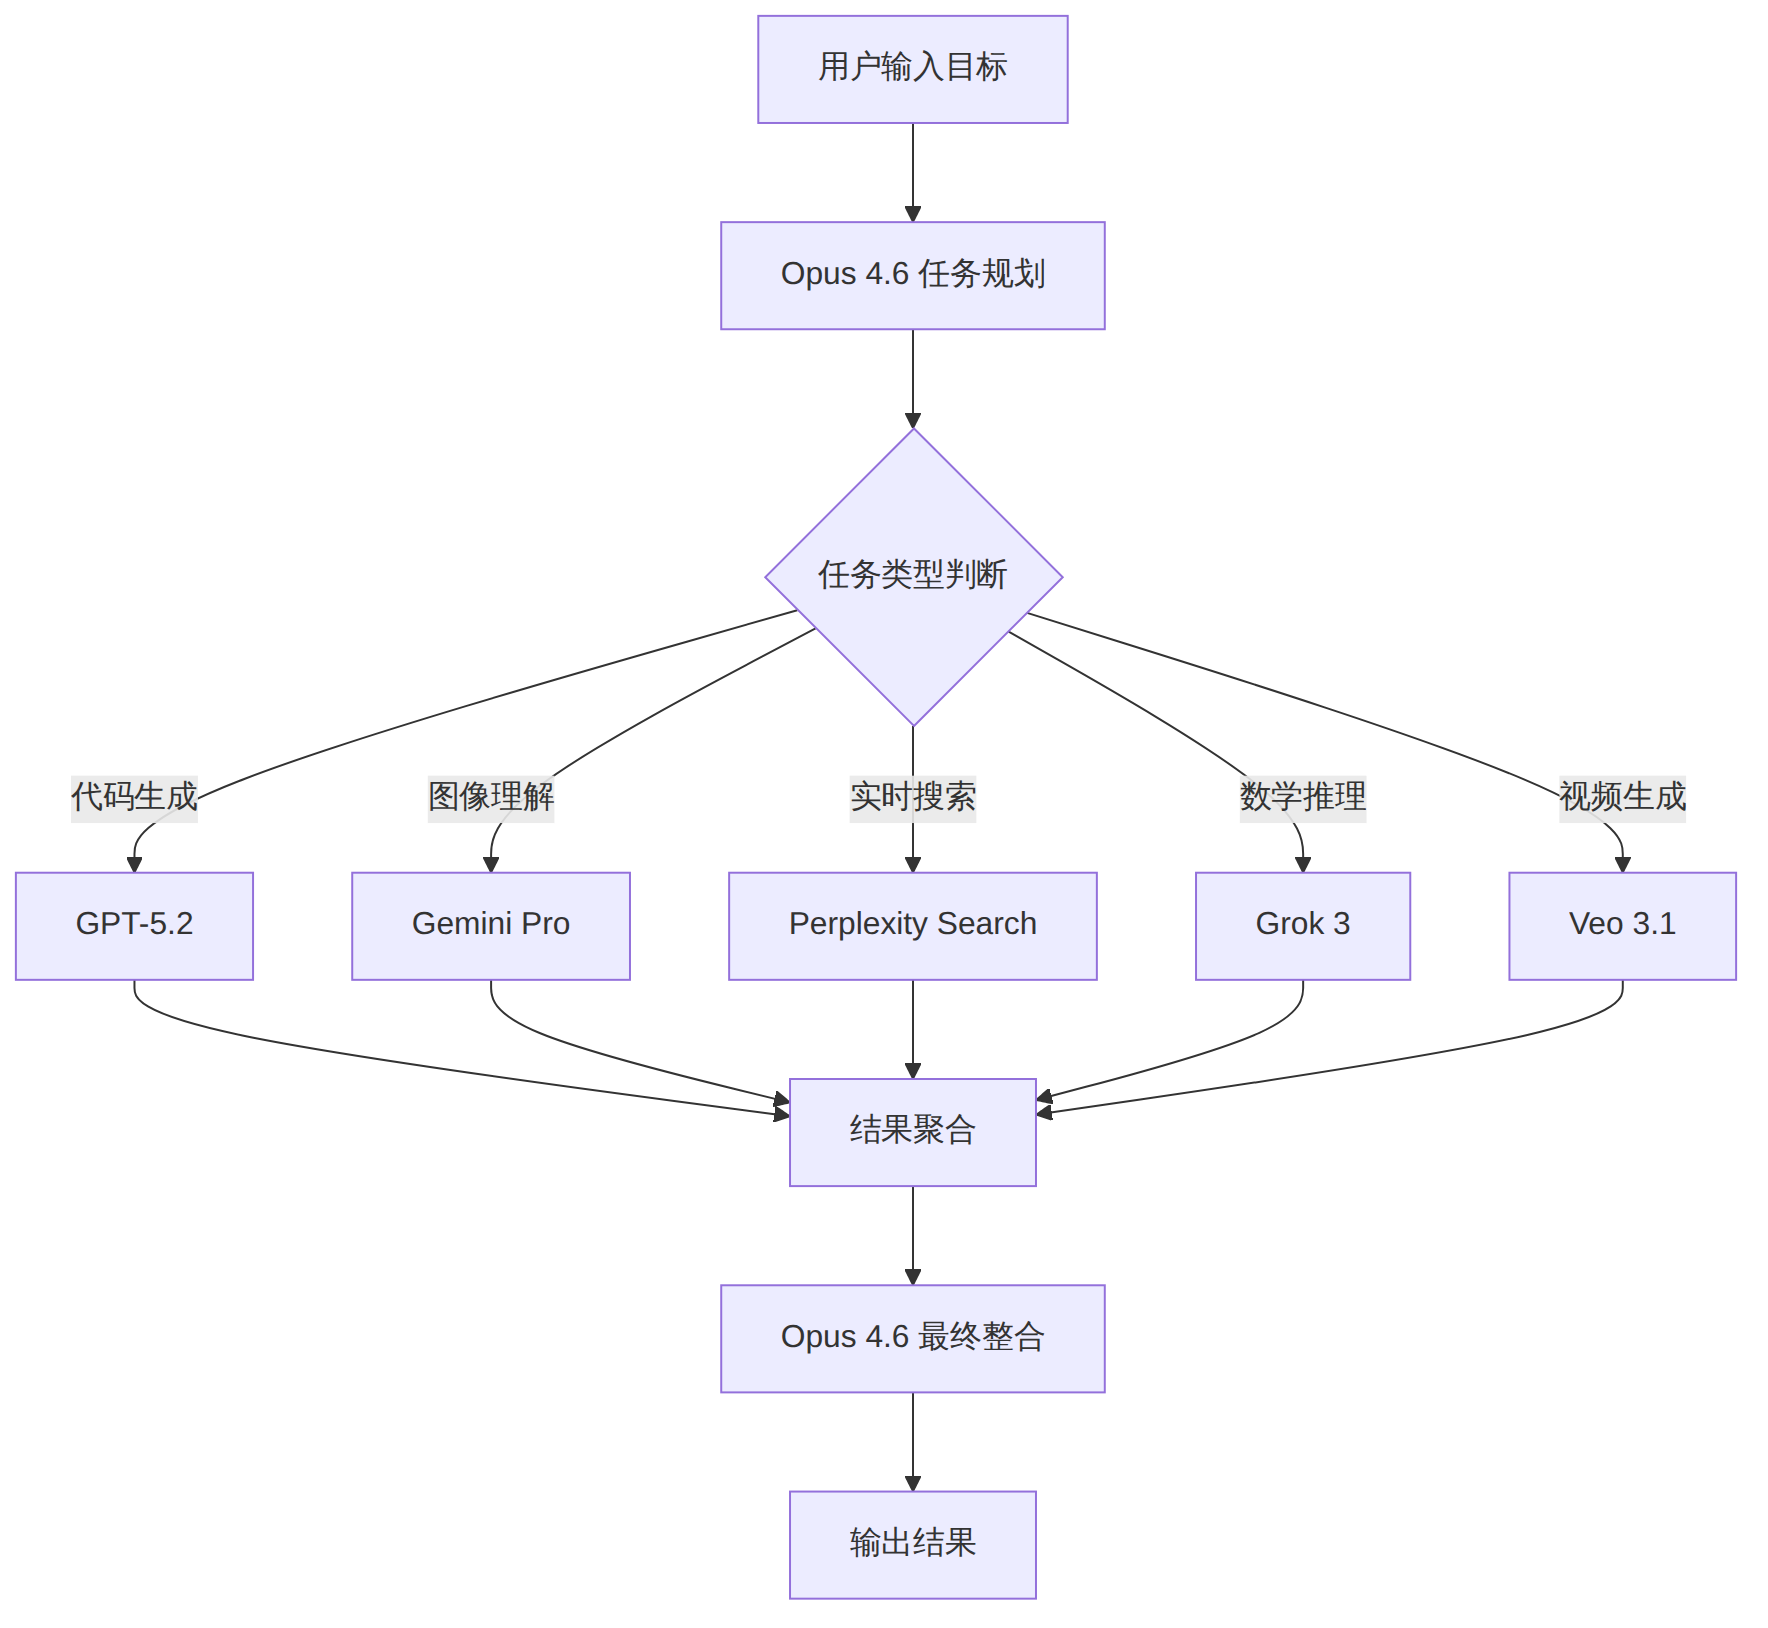
2026年2月25日,Perplexity发布了Computer,一个编排19个大模型的自主Agent系统。默认使用Claude Opus 4.6作为核心推理引擎,同时根据任务类型动态调用GPT-5.2、Gemini、Grok等模型处理特定子任务。
编排策略: Perplexity Computer的核心创新不是某个单一模型的能力,而是模型编排层。其工作流程为:
图表 1
实战案例: 一个典型的使用场景是市场研究——"分析2026年AI芯片市场竞争格局"。Computer会:用Perplexity Search收集最新数据;用Gemini Pro分析竞品产品页面的截图;用GPT-5.2生成财务分析代码;用Opus 4.6整合所有信息输出报告。整个过程约3-5分钟,质量接近初级分析师水平。
定价争议: $200/月的Max订阅是最大争议点。对于重度研究用户(投资分析师、咨询顾问、学术研究者),这个价格是合理的。但对于一般用户,Perplexity Deep Research($20/月)已能满足大部分需求,Computer的多模型编排并非必需。
浏览器Agent在2026年分化为两种路线:Browser Use代表"让LLM完全控制浏览器"的自主路线(65K+ GitHub Stars);Stagehand代表"AI辅助但人类主导"的协作路线。
Browser Use的自主路线: Browser Use将浏览器操作抽象为LLM可理解的action space——click(element)、type(text)、scroll(direction)、extract(schema)。LLM作为决策引擎,分析页面截图和DOM结构后选择操作。优势是灵活性极高,能处理任何网站;劣势是稳定性不够,页面结构的微小变化可能导致Agent迷路。
from browser_use import Agent
from langchain_anthropic import ChatAnthropic

agent = Agent(
    task="在京东搜索'机械键盘',按价格排序,提取前10个商品的名称和价格",
    llm=ChatAnthropic(model="claude-sonnet-4-5"),
    browser_config={"headless": True}
)
result = await agent.run()
# 输出结构化JSON: [{"name": "...", "price": "..."}, ...]
Stagehand的协作路线: Stagehand由Browserbase开发,提供了三个核心原语——act()(执行操作)、extract()(提取数据)、observe()(观察页面状态)。关键区别在于:Stagehand不试图让AI做所有决策,而是让开发者定义工作流骨架,AI只负责处理不确定的部分(如动态元素定位)。
Google Project Mariner关停的启示: Google在2026年5月4日关闭了Project Mariner(其浏览器Agent项目),将其能力融入Gemini Agent。这一决策反映了一个关键判断——浏览器Agent不应是独立产品,而应是更大工作流中的一个组件。这为Browser Use和Stagehand的发展方向提供了参考:纯浏览器Agent的天花板有限,必须与后端业务逻辑深度整合才能产生持久价值。
Agent Memory在2026年从"锦上添花"变为"必须拥有"。Mem0和Cognee是这一领域的两个代表项目,但设计哲学截然不同。
Mem0:向量记忆的工程化实践。 Mem0定位为"AI Agent的Universal Memory Layer"。它的工作原理是将对话和交互数据通过Embedding转化为向量,存储在向量数据库中,并在后续对话中进行语义检索。Mem0的优势在于工程成熟度——支持自动记忆提取、冲突消解和遗忘曲线。它已被集成到LangChain、CrewAI等主流框架中。
from mem0 import Memory

memory = Memory()

# 存储记忆
memory.add("用户偏好深色主题,不喜欢动画效果", user_id="user_123")

# 检索记忆
results = memory.search("这个用户的UI偏好是什么", user_id="user_123")
Cognee:知识图谱记忆的认知升维。 Cognee走了不同的路线——它不只存储向量,而是将信息构建为知识图谱(Knowledge Graph)。这使得Agent不只拥有"模糊的语义记忆",还拥有"精确的关系记忆"。
用户说:"我上周和客户张总讨论了AI项目预算"
         ↓
Mem0存储: ["用户讨论过AI项目预算"] (向量)
Cognee存储: User ──DISCUSSED_WITH──→ 张总
            User ──DISCUSSED_TOPIC──→ AI项目预算
            张总 ──ROLE──→ 客户
实战对比: 在简单场景(记住用户偏好),Mem0和Cognee差异不大。但在复杂场景(理解多方关系和事件因果链)中,Cognee的知识图谱结构显著优于Mem0的扁平向量检索。代价是Cognee的部署复杂度更高,需要图数据库(Neo4j或NetworkX)作为后端。
成本影响: 据Mem0团队的数据,引入记忆层后,Agent的上下文成本可降低约60%——因为不需要在每次对话中塞入全部历史信息,而是精准检索相关记忆。这对于高频调用的生产环境意义重大。
以下是一个整合上述工具的自主Agent系统参考架构:
图表 2
推荐组合: OpenHands ACP + Mem0 + Browser Use
推荐组合: Live-SWE-Agent + Cognee + Stagehand
推荐组合: Perplexity Computer($200/月)+ Cognee
推荐组合: Manus AI($39/月起)
判断一:自主Agent的"iPhone时刻"尚未到来。 尽管工具在快速成熟,但目前没有一个自主Agent能像智能手机一样"傻瓜式"地解决所有问题。每个场景仍需定制化配置。这恰恰是训练营和教育产品的机会——教人如何配置和使用Agent,比Agent本身更有市场。
判断二:记忆层是2026年下半年最大的投资机会。 从技术演进看,LLM推理能力已接近瓶颈(Opus 4.6、GPT-5.2的水平差距在缩小),真正的差异化在于Agent如何积累和使用知识。Mem0和Cognee代表的记忆基础设施,很可能成为Agent生态的"数据库层"。
判断三:Agent Control Plane是未来6个月的标准配置。 OpenHands ACP的发布设定了一个新标杆——任何不提供权限管理、审计追踪和Agent生命周期管理的Agent平台,都将难以在企业环境中生存。这意味着CrewAI、AutoGen等框架在2026年下半年必须跟进类似能力。
行动建议: 对于开发者,现在应该优先投资三个方向:(1)掌握至少一个编码Agent(OpenHands或SWE-Agent)的深度使用;(2)为你的Agent项目引入记忆层(从Mem0起步,复杂场景升级到Cognee);(3)关注MCP协议生态——它是Agent调用外部工具的事实标准,类似于REST API对于Web开发的地位。
[!tip] 51学通信知识星球 星主:爱卫生(微信:gprshome201101)——公众号「51学通信」创办者,19 年通信行业运维与讲师经验,著有《GPRS网络信令实例详解》《EPC原理与实践》《5G核心网原理与实践》三本纸质书(各大电商平台有售)。 星球定位:深耕 5G 核心网、IMS、NFV/AI、云原生等 ICT 领域,主打运维岗位与信令分析。 当前规模:5200 篇主题 / 990 个回答,198 元/年。 加入福利:加入星球后请加爱卫生微信,拉您进知识星球年度陪伴与答疑群——不限量回复您的各种问题,另有群内分享。 AI 加持:51学通信知识星球已作为 skill 接入 WorkBuddy,使用 deepseek-4-flash 在海量星球帖子中精准找贴、找视频、找 FAQ 和案例,做总结、找文档和 PPT 等场景全覆盖。
