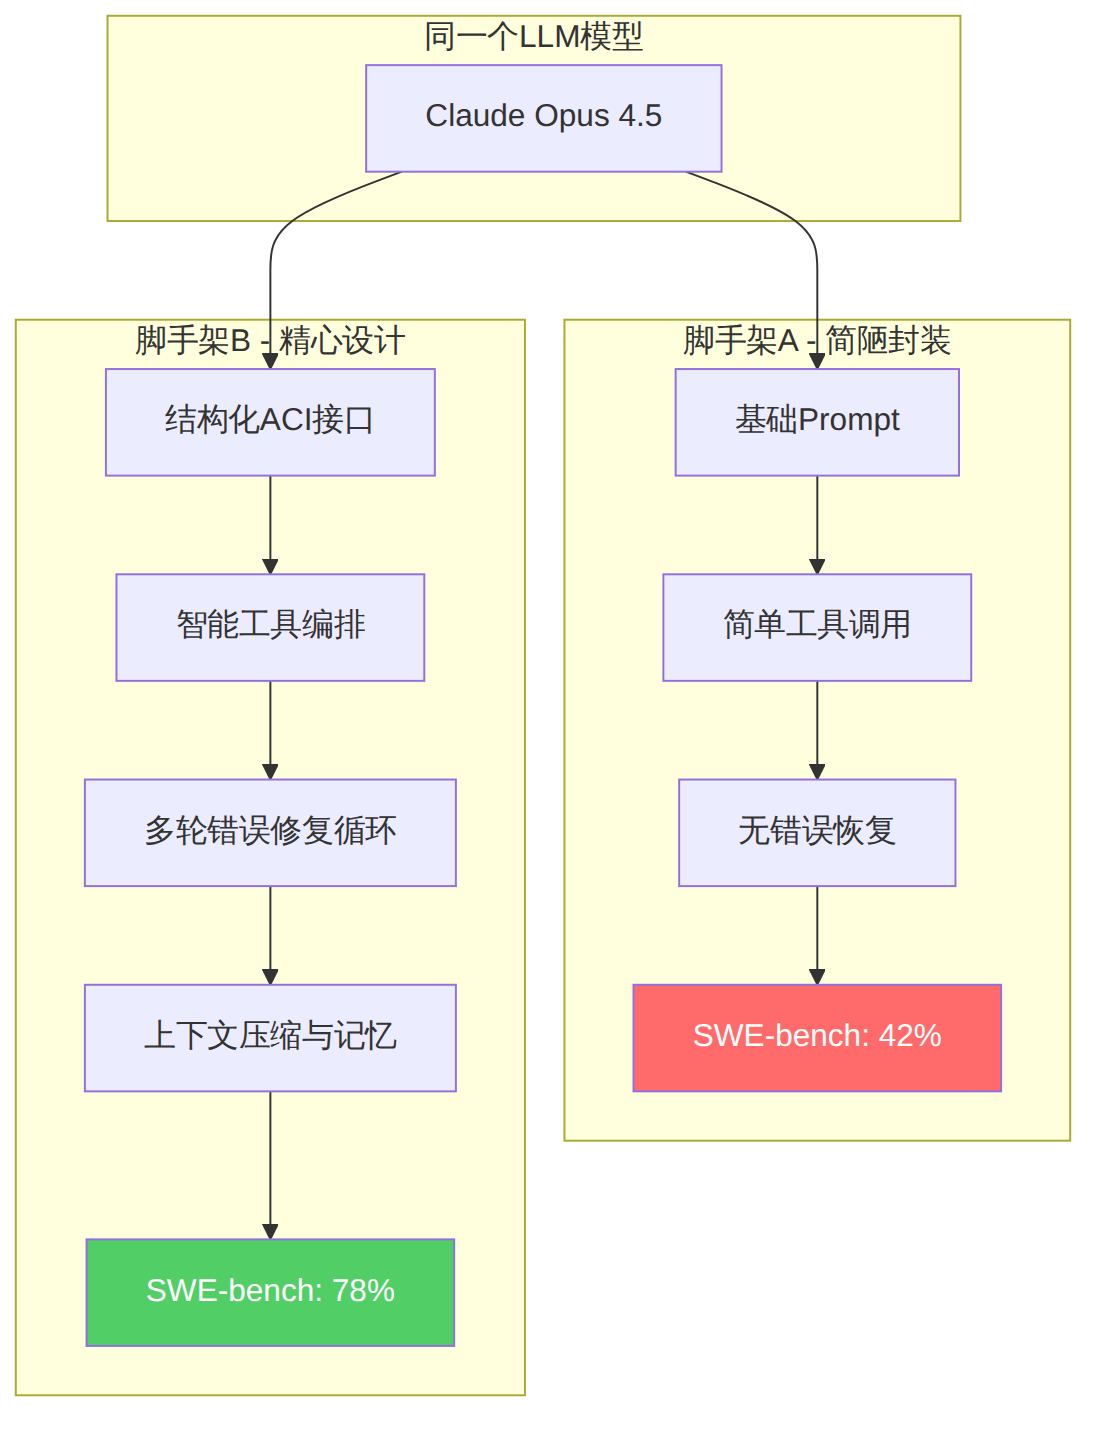
2026年SWE-bench排行榜揭示了一个颠覆性事实:同一个底层大模型,仅因Agent脚手架(Scaffold)不同,SWE-bench Verified得分从42%飙升至78%。这意味着,决定AI编码智能体能力的不是模型本身,而是包裹模型的执行框架——工具编排、上下文管理、错误恢复、交互接口等"脚手架"设计。本文深入拆解五大主流编码Agent(Devin、OpenHands、SWE-agent、Claude Code、Codex CLI)的架构差异,揭示脚手架效应背后的技术原理,并给出面向不同场景的选型指南。
2026年3月,Particula Tech发布的消融实验数据震撼了整个AI工程社区:使用完全相同的Claude Opus 4.5模型,在不同的Agent脚手架上运行,SWE-bench Verified得分从42%变化到78%。这不是模型能力的差异,而是框架设计的差异。
这个发现具有深远影响。许多团队在选择AI编码工具时,过度关注"用的是什么模型",却忽略了更关键的问题:模型被如何包装、如何与开发环境交互、如何管理上下文和错误。
图表 1
Augment的Auggie Agent运行Claude Opus 4.5时,比Claude Code官方运行同一个模型多解决了17个SWE-bench问题。这17个问题的差距,完全来自脚手架设计——工具定义的精确度、命令接口的友好度、上下文窗口的利用效率。
核心架构:ReAct循环 + Memory Files + 长效任务流
Devin由Cognition Labs开发,是第一个商业化全自主编码Agent。2026年估值已超百亿美元。其架构核心是一个增强版的ReAct(Reasoning + Acting)循环,围绕三大技术支柱构建:
| 组件 | 功能 | 技术细节 |
|---|---|---|
| Memory Files | 项目记忆持久化 | 将项目上下文、决策历史、代码规范存储为结构化文件,跨会话保持一致性 |
| Tool Use | 自主工具使用 | 浏览器、终端、编辑器、部署工具全链路自主操控 |
| Long-Running Task | 长效任务流 | 支持子会话调度、定时自提醒、多任务并行 |
Devin的SWE-bench得分经历了戏剧性变化:2024年3月首次发布时为13.86%(已是当时SOTA的7倍),到2026年5月已提升至约55-60%(使用自研模型+脚手架组合)。
关键代码架构片段(概念性):
# Devin核心执行循环(简化)
class DevinAgent:
    def run(self, task):
        memory = self.load_memory_files(task.repo)
        plan = self.reason(task, memory)  # 生成执行计划

        for step in plan:
            result = self.act(step)  # 执行:编辑/运行/测试
            if result.failed:
                result = self.self_debug(result.error)  # 自修复
            memory.update(result)  # 持久化记忆

        self.schedule_reminders()  # 长效任务调度
优缺点: - 优势:真正的端到端自主执行,从需求理解到部署上线全链路覆盖 - 劣势:闭源、价格昂贵($500/月起),自定义空间有限
核心架构:CodeAct范式 + 沙盒环境 + 多Agent支持
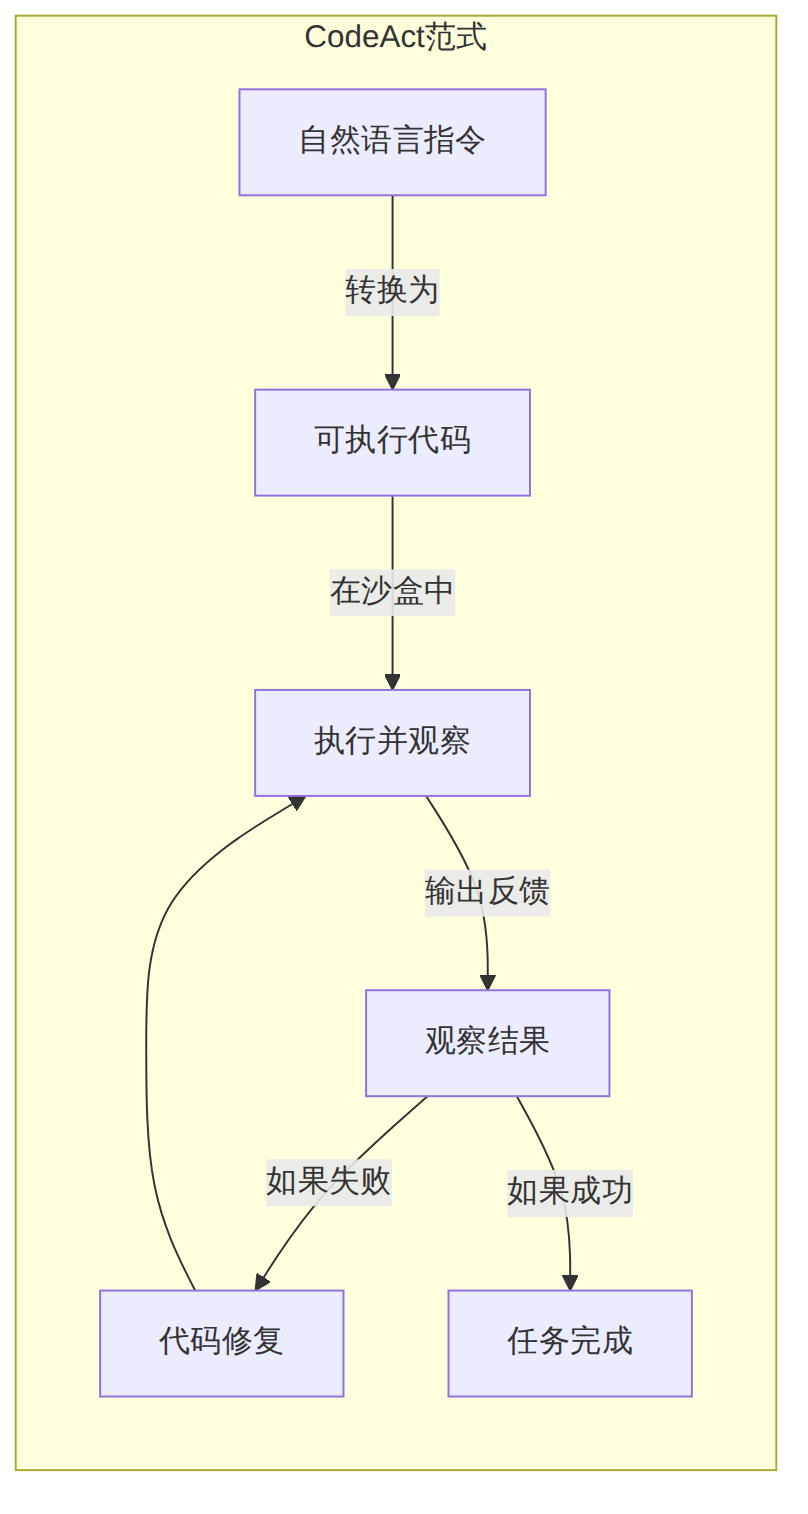
OpenHands由CMU团队主导开发,是开源社区对Devin的回应。其核心创新是CodeAct(Code as Actions)范式——将代码作为Agent的主要交互接口,而非自然语言。
图表 2
CodeAct 2.1版本的架构设计有三个关键层:
第一层:Controller(控制器) - 管理Agent的执行状态机:初始化→规划→执行→观察→反思 - 支持多Agent模式切换(CodeActAgent、PlannerAgent、VerifierAgent)
第二层:Runtime(运行时) - Docker沙盒隔离执行环境 - 每个任务获得独立的文件系统、浏览器实例、终端 - 通过WebSocket与Controller双向通信
第三层:Event Stream(事件流) - 所有交互通过事件流传递,实现完全可观测 - 支持人类干预(Human-in-the-loop)和回滚
# OpenHands CodeActAgent核心逻辑(简化)
class CodeActAgent:
    def step(self, state):
        # 1. 将历史交互压缩为代码上下文
        context = self.condense(state.history)

        # 2. LLM生成代码动作(而非自然语言动作)
        code_action = self.llm.generate_code(context, state.task)

        # 3. 在沙盒中执行代码
        observation = self.runtime.execute(code_action)

        # 4. 判断是否需要继续
        if self.is_done(observation):
            return AgentFinish(output=observation)
        return AgentAction(code=code_action, observation=observation)
2026年SWE-bench Verified表现:OpenHands + Claude Opus 4.7 约达到 72-75%,是开源脚手架中的顶级表现。
核心架构:Agent-Computer Interface(ACI)
SWE-agent由Princeton NLP团队开发,其学术贡献不在于得分多高,而在于提出了ACI(Agent-Computer Interface)这一概念框架。核心论点是:对LLM Agent来说,接口设计的优化比模型本身的提升更有效。
ACI设计原则包含四个维度:
| 维度 | 说明 | 示例 |
|---|---|---|
| 信息格式 | 命令输出的信息格式化 | 将git diff输出限制为仅修改行 |
| 操作粒度 | 提供适当粒度的操作 | find_file命令替代find | head管道 |
| 历史管理 | 交互历史的压缩与筛选 | 仅保留最近N条命令的完整输出 |
| 错误恢复 | 失败时的引导机制 | 自动提供可能的修复建议 |
SWE-agent的ACI设计让GPT-4从SWE-bench的1.96%(无脚手架基线)提升到约22%。这证明了接口设计的巨大价值。
# SWE-agent ACI配置示例
agent_config:
  commands:
    - name: find_file
      doc: "Find files matching a pattern in the repository"
      signature: "find_file <pattern> [<directory>]"
      # 简化搜索接口,避免LLM被海量find输出淹没

    - name: search_dir
      doc: "Search for a pattern in directory"
      signature: "search_dir <pattern> [<directory>]"
      # 定向搜索,返回精简结果

    - name: edit_file
      doc: "Edit a file with a search/replace block"
      # 结构化编辑,减少语法错误
关键洞察:SWE-agent的研究表明,为LLM设计专用接口(ACI)比为人类设计接口更高效。人类擅长从冗余信息中筛选,但LLM的上下文窗口是有限的,每一次多余的token都在浪费推理能力。
核心架构:终端Agent + 深度代码库理解 + MCP工具生态
Claude Code是Anthropic官方推出的终端编码Agent。与其他脚手架最大的区别在于:它与底层模型(Claude Opus 4.7)是同一团队开发的,实现了模型能力与脚手架的深度耦合。
这种耦合体现在三个层面:
1. 原生工具协议 Claude Code的工具定义(文件编辑、Bash执行、Grep搜索、Glob文件查找)是针对Claude模型的工具调用能力特别优化的。工具描述的措辞、参数结构、返回格式都经过反复迭代,确保模型能最准确地理解和使用。
2. 上下文管理策略 - Lazy Loading:v2.1.7起采用MCP工具定义的懒加载,避免一次性消耗上下文窗口 - 自动压缩:当对话接近上下文限制时,自动压缩历史消息 - 代码库索引:对项目建立本地索引,按需读取相关文件
3. MCP(Model Context Protocol)生态 Claude Code是MCP协议的最大受益者。通过MCP,可以连接外部工具服务器(数据库、浏览器、设计工具等),无限扩展Agent的能力边界。
# Claude Code工作流程
$ claude
> 帮我重构这个认证模块,把JWT改成session-based

# Claude Code内部执行:
# 1. Glob找到相关文件 → auth/*.ts, middleware/*.ts
# 2. Read读取文件内容 → 理解现有JWT逻辑
# 3. 规划重构步骤 → 识别所有JWT引用
# 4. Edit逐文件修改 → 替换JWT逻辑为session
# 5. Bash运行测试 → 验证重构正确性
# 6. 自动修复失败的测试
SWE-bench Verified最新成绩:Claude Code + Opus 4.7 达到 87.6%(2026年5月),是目前所有Agent脚手架中的最高分。但要注意:这个分数是模型+脚手架一体化优化的结果,单独使用其他模型在Claude Code上可能无法达到相同效果。
核心架构:Rust沙盒 + 多运行时 + Agent Skills
Codex CLI是OpenAI于2025年推出的开源终端编码Agent,用Rust编写,性能和安全隔离是其核心卖点。
三个差异化设计:
1. 多运行时沙盒模型
Codex CLI支持三种运行模式:
- suggest(建议模式):仅展示建议,不执行
- auto-edit(自动编辑模式):可编辑文件但不运行命令
- full-auto(全自主模式):可执行任意命令,在沙盒中运行
2. Agent Skills系统 这是Codex CLI的扩展机制——类似Claude Code的MCP,但采用不同的技术路径。Agent Skills是一个跨平台标准,允许社区贡献可复用的Agent技能包。
3. 持久化Agent模式 Codex CLI支持长时间运行的Agent会话,可以将任务拆分为子任务并行执行,并在失败时自动重试。
// Codex CLI架构示意
┌─────────────────────────────┐
│        Codex CLI (Rust)     │
│  ┌───────────────────────┐  │
│  │   Prompt Layer        │  │  ← 任务解析与规划
│  └───────────┬───────────┘  │
│  ┌───────────▼───────────┐  │
│  │   Tool Router         │  │  ← 工具路由与编排
│  └───────────┬───────────┘  │
│  ┌───────────▼───────────┐  │
│  │   Sandbox Manager     │  │  ← Docker/沙盒隔离
│  │  ┌──────┐ ┌────────┐  │  │
│  │  │ File │ │ Shell  │  │  │  ← 文件操作 & 命令执行
│  │  │ Edit │ │ Exec   │  │  │
│  │  └──────┘ └────────┘  │  │
│  └───────────────────────┘  │
│  ┌───────────────────────┐  │
│  │   Skills Registry     │  │  ← 可扩展技能包
│  └───────────────────────┘  │
└─────────────────────────────┘
SWE-bench表现:Codex CLI + GPT-5.2-Codex 在 TerminalBench 达到64%,SWE-bench Verified约65-70%。
同一个"文件搜索"功能,粗略的定义可能只有一句描述:
# 粗略工具定义
tools: [{ name: "search", description: "Search for files" }]
而精确的定义会包含参数说明、返回格式、使用时机:
# 精确工具定义(如Claude Code的Grep工具)
{
    "name": "grep",
    "description": "Search file contents with regex support. Use for finding specific code patterns.",
    "parameters": {
        "pattern": "Regex pattern (e.g., 'class.*Auth')",
        "path": "Directory to search",
        "output_mode": "'files_with_matches' | 'content' | 'count'",
        "-i": "Case insensitive",
        "-C": "Context lines"
    }
}
精确的工具定义让模型在正确的时机选择正确的工具,并传入正确的参数。这直接影响了任务成功率。
长上下文不等于好上下文。关键在于如何在有限的窗口内放入最有价值的信息:
| 策略 | 采用者 | 效果 |
|---|---|---|
| 全量输出保留 | 早期脚手架 | 上下文浪费严重,长任务容易溢出 |
| 智能截断 | SWE-agent | 保留关键行,减少噪音 |
| 懒加载+按需读取 | Claude Code | 最大化利用每个token的价值 |
| 代码压缩 | OpenHands | 将历史交互压缩为摘要 |
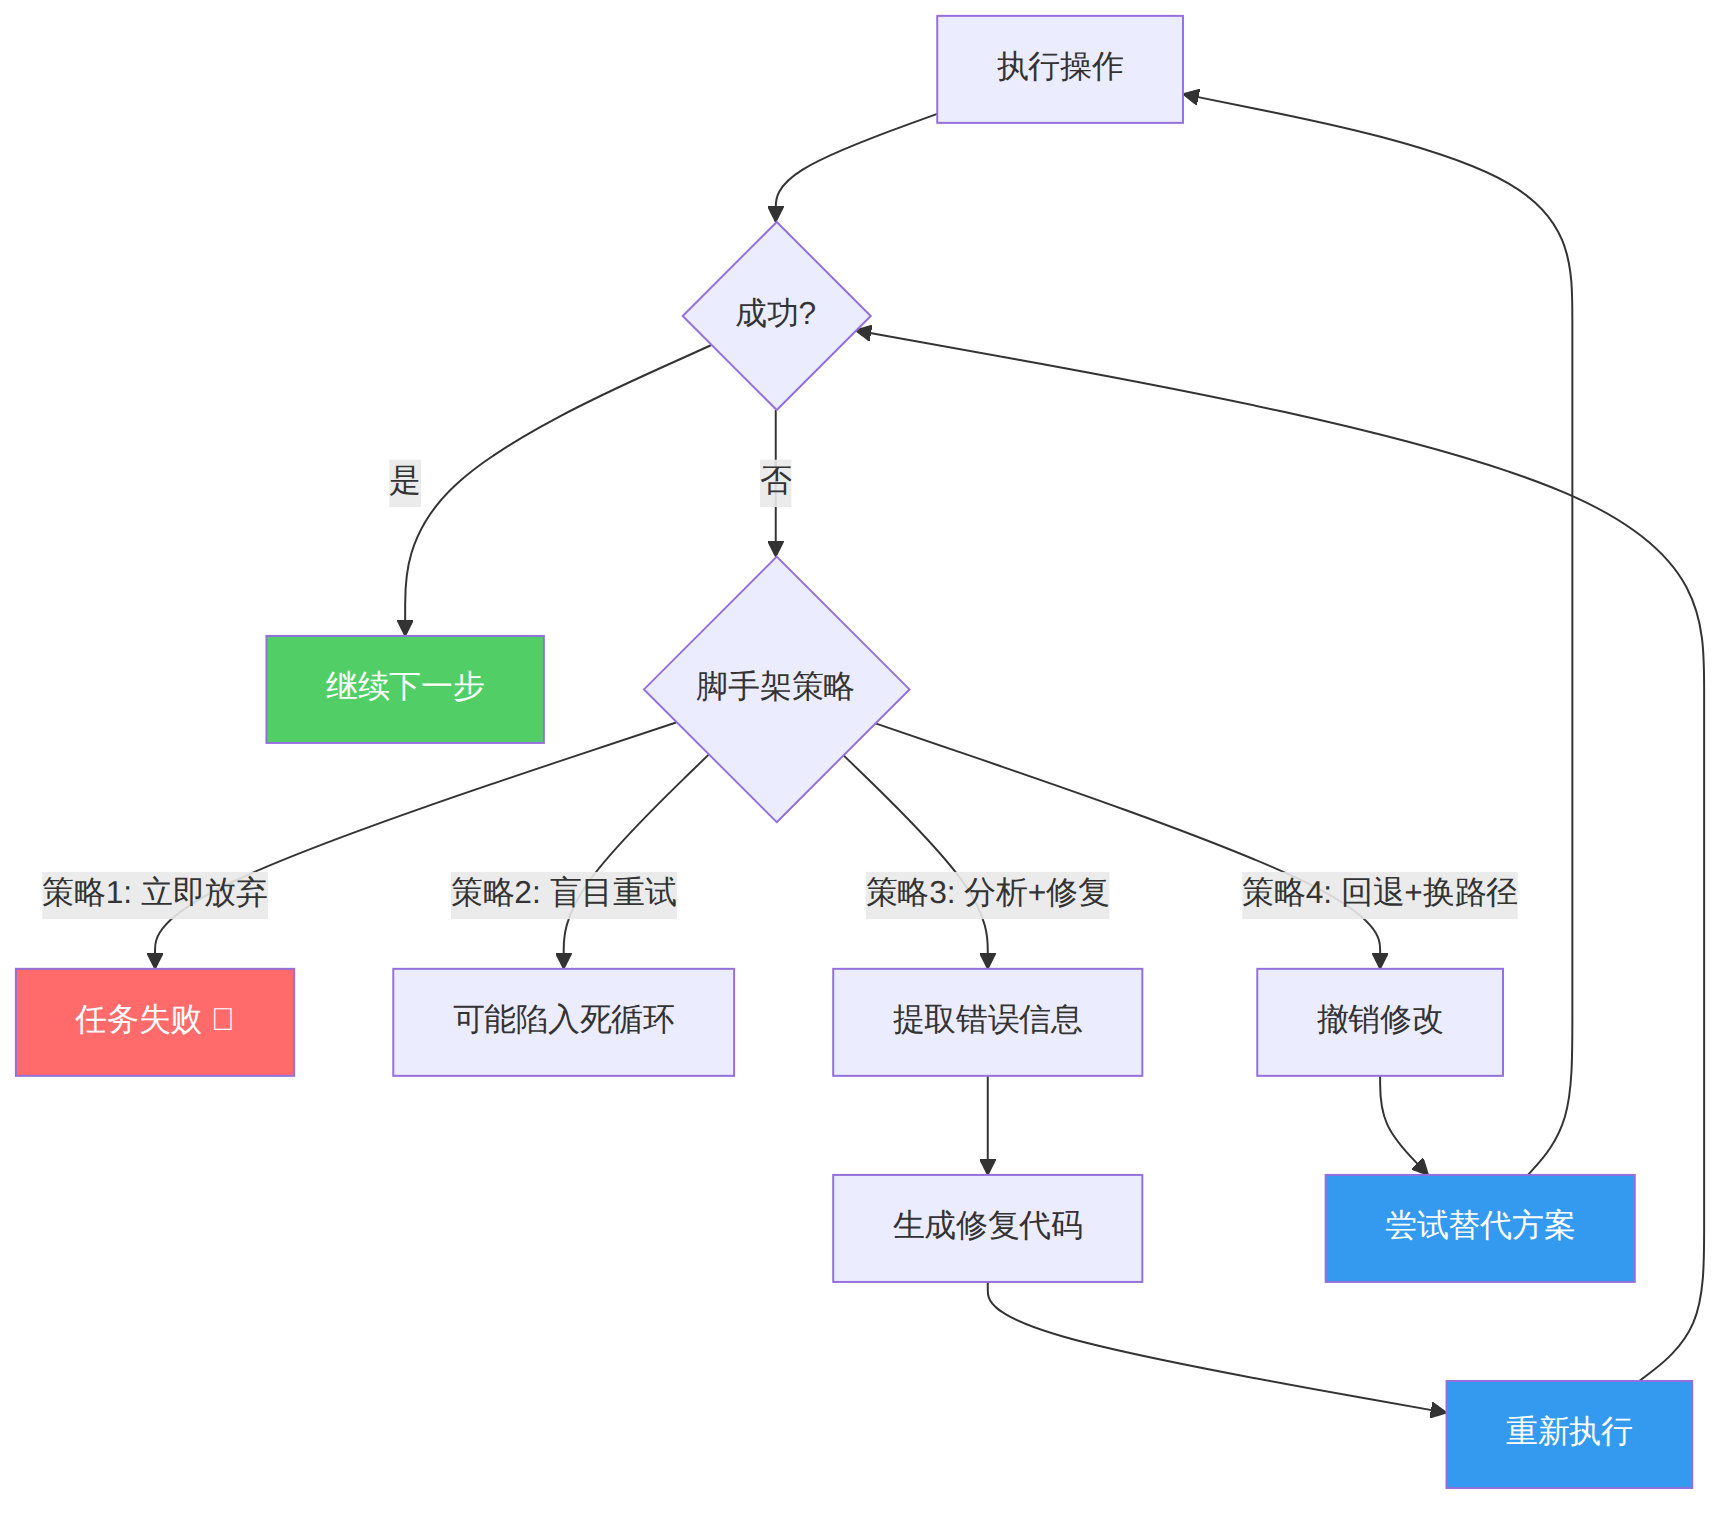
Agent执行过程中必然会遇到错误。脚手架如何处理错误,是区分高低分的关键:
图表 3
OpenHands的CodeActAgent采用策略3+4的组合:先尝试分析错误并修复,如果连续失败3次,则回退并切换执行路径。Claude Code则采用更精细的策略:根据错误类型(语法错误、运行时错误、逻辑错误)选择不同的修复路径。
SWE-agent论文的核心贡献是揭示了为Agent设计的接口(ACI)与为人类设计的接口(HCI)本质不同:
| 维度 | HCI(人类接口) | ACI(Agent接口) |
|---|---|---|
| 信息密度 | 偏好冗余(上下文丰富) | 偏好精简(减少token浪费) |
| 操作方式 | GUI点击+键盘 | 结构化命令+JSON参数 |
| 错误处理 | 弹窗+确认框 | 程序化错误码+重试逻辑 |
| 历史访问 | 滚动浏览 | 语义检索+压缩摘要 |
| 学习曲线 | 渐进式学习 | 即时可用(零学习成本) |
基于最新公开数据,SWE-bench Verified Top 10(2026年5月):
| 排名 | 模型 + 脚手架 | SWE-bench Verified | SWE-bench (Full) |
|---|---|---|---|
| 1 | Claude Opus 4.7 + Claude Code | 87.6% | 64.3% |
| 2 | GPT-5.5 + 自研脚手架 | ~84% | ~60% |
| 3 | Gemini 3.1 Pro + Auggie | ~80% | ~57% |
| 4 | Claude Opus 4.7 + OpenHands | ~75% | ~52% |
| 5 | Claude Sonnet 4.6 + Claude Code | ~73% | ~50% |
| 6 | GPT-5.2-Codex + Codex CLI | ~70% | ~48% |
| 7 | DeepSeek-V3 + 开源脚手架 | ~68% | ~45% |
| 8 | Kimi K2.6 + 自研脚手架 | ~65% | ~43% |
| 9 | Claude Opus 4.5 + OpenHands | ~63% | ~42% |
| 10 | GPT-5.0 + SWE-agent | ~58% | ~38% |
关键观察: - Claude Opus 4.7在不同脚手架下表现:Claude Code 87.6% vs OpenHands 75% vs 简陋脚手架 ~42%,差距高达45个百分点 - 同一模型(Claude Opus 4.5)从42%到63%,仅靠脚手架优化就提升了21个百分点 - 这意味着:选择正确的脚手架比选择更贵的模型更划算
| 维度 | Devin | OpenHands | SWE-agent | Claude Code | Codex CLI |
|---|---|---|---|---|---|
| 开源/闭源 | 闭源 | 开源(MIT) | 开源(MIT) | 开源(部分) | 开源 |
| 开发语言 | 自研 | Python | Python | TypeScript | Rust |
| 支持模型 | 自研模型 | 多模型 | 多模型 | Claude系列 | GPT系列 |
| 沙盒隔离 | Docker | Docker | Docker | 本地权限 | Rust沙盒 |
| 上手难度 | 极低(SaaS) | 中等 | 中等 | 低 | 低 |
| 自定义能力 | 低 | 高 | 中 | 中(通过MCP) | 高(Skills) |
| 成本 | $500+/月 | API费用 | API费用 | $20-200/月 | API费用 |
| 人类介入 | 可选 | 支持 | 不支持 | 核心设计 | 可选 |
| SWE-bench最高 | ~58% | ~75% | ~45% | 87.6% | ~70% |
| GitHub Stars | N/A | ~50K | ~15K | ~90K | ~75K |
| 适合场景 | 企业全自主 | 研究与定制 | 学术研究 | 日常开发 | 通用编码 |
| 方向 | 市场需求 | 竞争程度 | 变现空间 | 推荐指数 |
|---|---|---|---|---|
| Claude Code高级使用技巧 | ★★★★★ | ★★★ | ¥1999-3999/人 | ★★★★★ |
| Agent脚手架开发实战 | ★★★★ | ★★ | ¥2999-5999/人 | ★★★★ |
| SWE-bench刷分攻略 | ★★★ | ★ | ¥999-1999/人 | ★★★ |
| 多Agent协作系统搭建 | ★★★★ | ★★ | ¥3999-6999/人 | ★★★★ |
| 企业级Coding Agent部署 | ★★★★★ | ★★★ | ¥5000-10000/人 | ★★★★★ |
脚手架效应的商业价值在于:你可以用更便宜的模型+精心设计的脚手架,达到甚至超越昂贵模型+简陋脚手架的效果。
具体路径: - 垂直领域Agent脚手架:为特定行业(金融审计、法律文书、医疗编码)定制ACI接口,在开源脚手架基础上封装领域工具 - 脚手架优化SaaS:提供Agent脚手架的A/B测试平台,帮助团队找到最优工具定义和执行策略 - 混合模型路由:根据任务复杂度动态切换模型+脚手架组合,简单任务用Haiku+轻量脚手架,复杂任务用Opus+重量级脚手架
推荐:Claude Code + Opus 4.7
理由:模型与脚手架深度耦合,SWE-bench最高分,终端原生体验流畅。$200/月的Max方案对于高频使用者性价比极高。
推荐:OpenHands + 多模型配置
理由:开源可控,支持多Agent协作模式(编码Agent+审查Agent),可以接入团队内部的代码规范和CI/CD流程。
推荐:SWE-agent + 自定义ACI
理由:ACI设计理念清晰,配置灵活,适合研究接口设计对Agent性能的影响。NeurIPS 2024论文提供了完整的理论框架。
推荐:Devin + 人工审核
理由:唯一真正实现端到端自主的平台,适合将AI编码嵌入DevOps流程。但需要人工审核环节确保质量。
推荐:Codex CLI + GPT-5.2-Codex + 自定义Skills
理由:Rust高性能执行,Agent Skills可复用,适合处理大量结构化的编码任务(如API生成、测试编写、文档更新)。
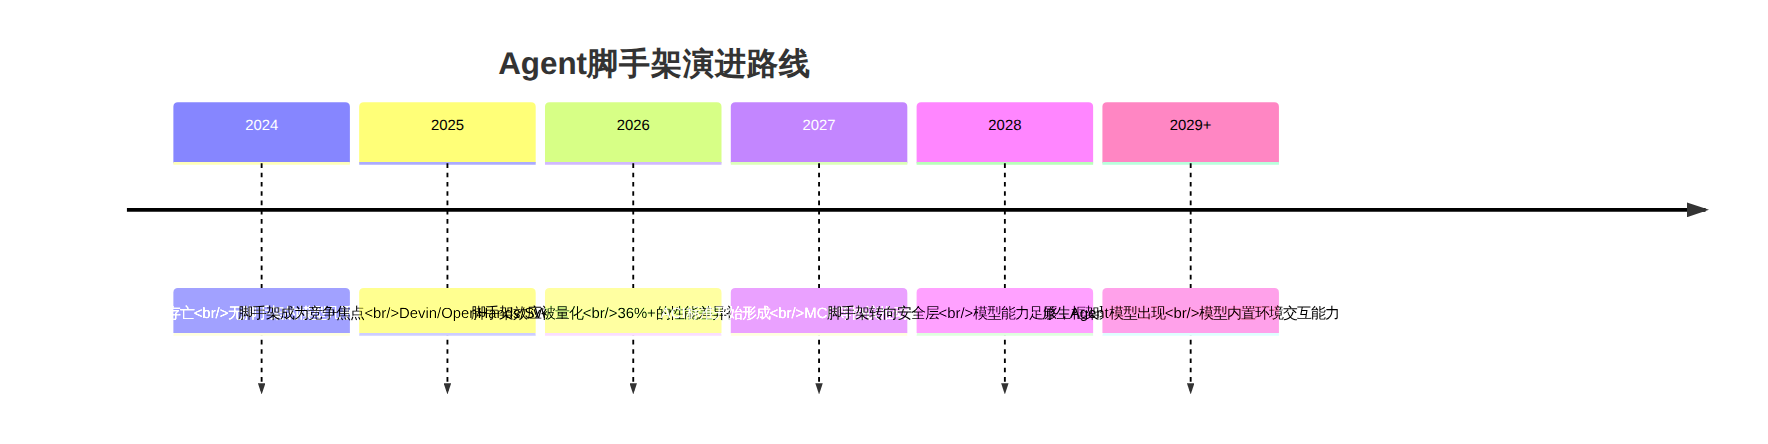
当前脚手架效应如此显著,根本原因是模型还不够强——模型需要"拐杖"来弥补工具使用、上下文管理、错误恢复方面的不足。但随着模型能力提升(特别是长上下文推理和工具调用能力),脚手架的重要性会如何变化?
短期(2026-2027):脚手架依然是决定性因素。模型的工具调用能力仍在快速进化,但距离"无需脚手架即可高效操作开发环境"还有差距。
中期(2027-2028):脚手架从"性能增强器"转变为"安全护栏"。模型足够聪明,脚手架主要确保执行安全(沙盒隔离、权限控制、审计追踪)。
长期(2028+):ACI标准化。正如人类与计算机的交互有POSIX标准一样,Agent与开发环境的交互将形成标准协议(MCP可能就是这个标准的雏形),脚手架的差异化空间收窄。
图表 4
[!tip] 51学通信知识星球 星主:爱卫生(微信:gprshome201101)——公众号「51学通信」创办者,19 年通信行业运维与讲师经验,著有《GPRS网络信令实例详解》《EPC原理与实践》《5G核心网原理与实践》三本纸质书(各大电商平台有售)。 星球定位:深耕 5G 核心网、IMS、NFV/AI、云原生等 ICT 领域,主打运维岗位与信令分析。 当前规模:5200 篇主题 / 990 个回答,198 元/年。 加入福利:加入星球后请加爱卫生微信,拉您进知识星球年度陪伴与答疑群——不限量回复您的各种问题,另有群内分享。 AI 加持:51学通信知识星球已作为 skill 接入 WorkBuddy,使用 deepseek-4-flash 在海量星球帖子中精准找贴、找视频、找 FAQ 和案例,做总结、找文档和 PPT 等场景全覆盖。
